
优化大数据表。表分区,和表分区视图
- --SQL Server 强大的分区技术(使用语句检测和优化数据库 (MSSQL个人笔记之数据库优化之路 三)
- /********************************************************************************
- *主题:SQL Server 强大的分区技术
- *说明:本文是个人学习的一些笔记和个人愚见
- * 有很多地方你可能觉得有异议,欢迎一起讨论
- *作者:Stephenzhou(阿蒙)
- *日期: 2012.07.26
- *Mail:szstephenzhou@163.com
- *另外:转载请著名出处。
- **********************************************************************************/
- /*
- 昨天已经在900W的测试数据上做了分区 并且查询出分区的内容
- 说到优化肯定是要设计到索引了,索引在第一章已经说了很多,在这里不做详解 今天就随便说下分区 索引和执行计划如果事件允许
- 的话我想再把追踪一起结合放到这个案例上来说说,以完成自己对MSSQL的资料的整理和感悟吧。
- */
- --继续上昨天的测试数据表如下:
- use Erp_System
- go
- if OBJECT_ID('consume') is not null
- drop table consume
- go
- create table consume (
- id varchar(50) ,
- Shopid int,
- GoodsId int,
- Amount float,
- ConsumeDate datetime,
- mark nvarchar(100)
- constraint [pk_cludered_id_date] primary key clustered (id asc,ConsumeDate asc,mark)
- )
- declare @myid uniqueidentifier
- declare @i int
- set @i=0;
- declare @id varchar(50);
- begin
- while @i<3000000
- begin
- set @myid=cast(newid() as nvarchar(100));
- set @id='10010xxxxxxx1'
- insert into consume values(@id,cast(rand()*10 as int),cast(rand()*50 as int),cast(rand()*1000 as int) ,GETDATE(),@myid);
- set @i=@i+1
- end;
- set @i=0
- while @i<3000000
- begin
- set @id='10010xxxxxxx2'
- set @myid=cast(newid() as nvarchar(100));
- insert into consume values(@id,cast(rand()*10 as int),cast(rand()*50 as int),cast(rand()*1000 as int) ,GETDATE(),@myid);
- set @i=@i+1
- end;
- set @i=0
- while @i<3000000
- begin
- set @id='10010xxxxxxx3'
- set @myid=cast(newid() as nvarchar(100));
- insert into consume values(@id,cast(rand()*10 as int),cast(rand()*50 as int),cast(rand()*1000 as int) ,GETDATE(),@myid);
- set @i=@i+1
- end;
- end;
- --以上在表中插入随机数据和日期一共900w条数据 方便大家做海量数据的测试,我的笔记本估计跑的很慢 所以要边做别写这个案例
- --时间有点稍长了点。 呵呵 继续
- ---有了数据后我在后面的写的时候就不做过多的解释 ,如果有童鞋不明白的地方可以翻看之前笔记二和笔记一
- use Erp_System
- go
- alter database Erp_System add filegroup GF_System01
- alter database Erp_System add filegroup GF_System02
- alter database Erp_System add filegroup GF_System03
- alter database Erp_System add filegroup GF_System04
- go
- alter database Erp_System add file
- (
- name =N'System_01_02', filename='E:\GroupFileData\System_01_02.ndf',
- size =5mb,maxsize=2gb ,filegrowth=5mb
- ) to filegroup GF_System01
- alter database Erp_System add file
- (
- name =N'System_03_05', filename='E:\GroupFileData\System_03_05.ndf',
- size =5mb,maxsize=2gb ,filegrowth=5mb
- ) to filegroup GF_System02
- alter database Erp_System add file
- (
- name =N'System_06_08', filename='E:\GroupFileData\System_06_08.ndf',
- size =5mb,maxsize=2gb ,filegrowth=5mb
- ) to filegroup GF_System03
- alter database Erp_System add file
- (
- name =N'System_09_10', filename='E:\GroupFileData\System_09_10.ndf',
- size =5mb,maxsize=2gb ,filegrowth=5mb
- ) to filegroup GF_System04
-- select top 1 * from consume
- create partition function Par_Shopid_Fuc(int)
- as range right for values(2,5,8);
- create partition scheme Shopid_Sec
- as partition Par_Shopid_Fuc
- to ( GF_System01,GF_System02,GF_System03,GF_System04);
- go
- if OBJECT_ID('consume_Shopid_Range') is not null
- drop table consume_Shopid_Range
- go
- create table consume_Shopid_Range (
- id varchar(50),
- Shopid int,
- GoodsId int,
- Amount float,
- ConsumeDate datetime,
- mark nvarchar(100)
- )on Shopid_Sec(Shopid)
- --导数据了
- insert into consume_Shopid_Range select * from consume
- --好了数据完全导入到consume_Shopid_Range表中了
- SET STATISTICS IO ON -- 显示有关由Transact-SQL 语句生成的磁盘活动量的信息
- select * from consume_Shopid_Range where Shopid=2
- select * from consume where Shopid=2
- /*
- (899690 行受影响)
- 表 'consume_Shopid_Range'。扫描计数 1,逻辑读取 41528 次,物理读取 1 次,预读 30970 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- (899690 行受影响)
- 表 'consume'。扫描计数 3,逻辑读取 268352 次,物理读取 3681 次,预读 260463 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- */
分析上面的查询消息 其中表 'consume_Shopid_Range'
执行的扫描1次;
从数据缓存读取的41528页;
从磁盘读取的1页;
为进行查询而放入缓存的30970页数
而原表consume同样的查询
执行的扫描3次;
从数据缓存读取的268352页;
从磁盘读取的3681页;
为进行查询而放入缓存的260463页数
这样分析下对比哪个的数据快就不言而喻了
具体的查询时间如下
- dbcc freeproccache --清空所有数据库的高速缓存
- select * from consume_Shopid_Range where Shopid=2

- dbcc freeproccache --清空所有数据库的高速缓存
- select * from consume where Shopid=2

效果出来了做了分区后查询时间为' 00:00:35' 而没有做分区的原来那张表的查询时间为 '00:01:21'
其中前面的操作都很明确了 现在再次详细的说下,原表consume 中有索引,而在consume_Shopid_Range 中没有索引 数据是从表consumecopy过来的,值是在这个表里应用了分区方案 Shopid_Sec,分区方案的详细介绍 看上一篇笔记,看到以上的查询消息就知道差距了,按住选择以上的两个查询 Ctrl +L 如下图

如上图可以看出差距了吧。做了分区的查询开销 12% ,原表consume的查询却是88%
看下图具体分析下查询计划
选择 select * from consume_Shopid_Range where Shopid=2 按住 Ctrl+L

如果对于一个SQL查询有多种写法,那么这四个值中的逻辑读(logical reads)决定了哪个是最优化的。
- --查询2是par_shopid分区函数的第几个分区
- select $partition.Par_Shopid_Fuc(2)
- -----------
- --2
- --(1 行受影响)
- --查询每个分区对应的记录数。
- select $partition.Par_Shopid_Fuc(Shopid) as partitionnumber,COUNT(1) recordcount from consume_Shopid_Range
- group by $partition.Par_Shopid_Fuc(Shopid)
- /*
- partitionnumber recordcount
- --------------- -----------
- 1 1799526
- 2 2699280
- 3 2701569
- 4 1799625
- */
- /*
- *为什么记录书不是一样的呢??看下之前的分区函数
- *
- * create partition function Par_Shopid_Fuc(int)
- * as range right for values(2,5,8);
- *分区的点为 2,5,8。 通过select distinct shopid from consume 可以得到
- shopid
- -----------
- 0
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- (10 行受影响)
- select $partition.Par_Shopid_Fuc(4)
- 也就是说shopid的记录是0-9一共十个.
- 其中 分区函数 as range right for values(2,5,8);已经说的很明白了数据的分割点是
- 小于2的shopid放在第一个分区中0,1
- 大于等于2小于 5的shopid放在第二个分区中也就是3,4
- 大于等于5小于 8的shopid记录放在第三个分区中 也就是5,6,7
- 大于等于8的shopid记录放在第四个分区中 也就是 8,9
- 忘记了 因为不相等的记录也不是他们的分配的决定的 也就是说他们之前的分配是随机的.
- 这样做就是说以后分区不能按照随机不能确定他的大小来分区
- 现在说下索引吧.
- 在分区表consume_Shopid_Range的Amount上建索引
- 如上的两个查询
- */
- create index IX_Amount
- ON consume_Shopid_Range(Amount) --分区表名
- ON Shopid_Sec(Shopid) --分区表方案
鼠标点击表和新建的IX_Amount属性如下图


为了形成对比 把分区表和原表对比下 把原表也一样建下这个索引然后看下计划如下
- create index IX_Amount
- ON consume(Amount)
然后看下这两条查询的计划
select * from consume_Shopid_Range where Amount=667
select * from consume where Amount=667

如图可以看出来两个居然差不多了是为什么呢??
具体分析下这两个执行计划:
两个索引关联查询。虽然如图所说的IX_Amount索引开销显示0%但是还是有所开销的 执行了一次 具体看下面 :

上面显示执行次数为1次也就是通过我们刚建的这个IX_Amount索引一次定位到了,然后通过下面
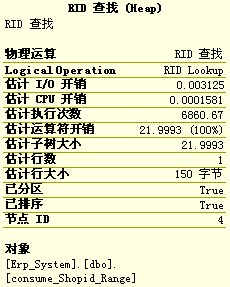
我们给上边的查询在 列上指定过滤条件(分区表),那么就得到了一个使用RID查找的执行计划。
- --拆分和合并区
- --一般用的很少但是还是要了解下
- alter partition function Par_Shopid_Fuc()
- split range(9)
- --合并分区
- alter partition function Par_Shopid_Fuc()
- merge range (9)
- --分区表中的数据迁移
- --1。从分区表赋值到数据到普通表
- create table consume_part01 (
- id varchar(50) ,
- Shopid int,
- GoodsId int,
- Amount float,
- ConsumeDate datetime,
- mark nvarchar(100)
- ) on GF_System01
- create table consume_part02 (
- id varchar(50) ,
- Shopid int,
- GoodsId int,
- Amount float,
- ConsumeDate datetime,
- mark nvarchar(100)
- ) on GF_System02
- --把第一个分区放到表 consume_part01中
- alter table consume_Shopid_Range switch partition 1 to consume_part01
- go
- alter table consume_Shopid_Range switch partition 2 to consume_part02
- go
- --2.把表中的数据拷贝到分区表中 要把分区表的索引要先删除不然的话就会错误提示。。说创建了相同的索引
- alter table consume_part01 drop constraint ck_Amount
- alter table consume_part01 add constraint ck_Amount check(Amount in (0,1,2))
- alter table consume_part01 switch to consume_Shopid_Range partition 1
- go
- /*
- 分区表中的字段有索引所提提示错误。。
- 消息 4947,级别 16,状态 1,第 1 行
- ALTER TABLE SWITCH 语句失败。对于目标表 'Erp_System.dbo.consume_Shopid_Range' 中的索引 'IX_Amount',在源表 'Erp_System.dbo.consume_part01' 中没有完全相同的索引。
- */
分区视图
分区视图和分区表的区别:分区表是一个独立的表,值是他的不通分区的数据保存在不通的文件组中,而分区视图实际上包括多个物理表,每个表包含一部分的数据 由
分区视图把这些表组合在一起,形成完整的数据。废话不多说 上测试数据
- create table consume_vewt01 (
- id varchar(50) ,
- Shopid int,
- GoodsId int,
- Amount float
- check(Amount in (0,1)),
- ConsumeDate datetime,
- mark nvarchar(100)
- )
- create table consume_vewt02 (
- id varchar(50) ,
- Shopid int,
- GoodsId int,
- Amount float check(Amount in (2,3,4)),
- ConsumeDate datetime,
- mark nvarchar(100)
- )
- create table consume_vewt03 (
- id varchar(50) ,
- Shopid int,
- GoodsId int,
- Amount float check(Amount in (5,6,7)),
- ConsumeDate datetime,
- mark nvarchar(100)
- )
- create table consume_vewt04 (
- id varchar(50) ,
- Shopid int,
- GoodsId int,
- Amount float check(Amount in (8,9)),
- ConsumeDate datetime,
- mark nvarchar(100)
- )
创建分区视图
- --创建分区视图
- use Erp_System
- go
- create view consumeview
- as
- select * from consume_vewt01
- union all
- select * from consume_vewt02
- union all
- select * from consume_vewt03
- union all
- select * from consume_vewt04
- go
值得说明的一点是
1.分区所有成员表必须定义主键而且一致 ,所有的数据类型和字段必须一致。
2.在插入数据的时候 ,必须包含所有列 即使有的为null或者defual值了 还是显示的写出来。
3.在定义表的时候需要写约束check 这样才操作分区视图的时候就会自动的关联到成员表中去了
- 在分区视图中增加数据
- insert into consumeview values('10010xxxxxxx3',2,13,2,'2012-07-26 11:55:40.170',' 264234B3-76E8-4833-9A9B-1B913815335C')
- insert into consumeview values('10010xxxxxxx3',2,13,2,'2012-07-26 11:55:40.170',' 我是中国人')
- insert into consumeview values('10010xxxxxxx3',2,13,2,'2012-07-26 11:55:40.170',' stephenzhou')
- select * from consumeview
- /*
- id Shopid GoodsId Amount ConsumeDate mark
- -------------------------------- ----------- ----------- ---------------------- ----------------------- ---------------------------------------
- 10010xxxxxxx3 2 13 2 2012-07-26 11:55:40.170 264234B3-76E8-4833-9A9B-1B913815335C
- 10010xxxxxxx3 2 13 2 2012-07-26 11:55:40.170 stephenzhou
- 10010xxxxxxx3 2 13 2 2012-07-26 11:55:40.170 我是中国人
- 10010xxxxxxx3 2 21 4 2012-07-26 11:55:40.170 stephenzhou
- 10010xxxxxxx3 2 13 7 2012-07-26 11:55:40.170 我是中国人
- (5 行受影响)
- 表 'consume_vewt04'。扫描计数 1,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt03'。扫描计数 1,逻辑读取 2 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt02'。扫描计数 1,逻辑读取 2 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt01'。扫描计数 1,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- */
- update consumeview set GoodsId=21 where ConsumeDate='2012-07-26 11:55:40.170' and Amount=4
- /*表 'consume_vewt04'。扫描计数 0,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt03'。扫描计数 0,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt02'。扫描计数 1,逻辑读取 2 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt01'。扫描计数 0,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- (1 行受影响)*/
- delete from consumeview where Amount =2 and mark=' stephenzhou'
- /*
- 表 'consume_vewt04'。扫描计数 0,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt03'。扫描计数 0,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt02'。扫描计数 1,逻辑读取 2 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- 表 'consume_vewt01'。扫描计数 0,逻辑读取 0 次,物理读取 0 次,预读 0 次,lob 逻辑读取 0 次,lob 物理读取 0 次,lob 预读 0 次。
- (1 行受影响)
- */
可以看到的时候每次在操作这个视图的都会去扫描四个成员表。。
好了 今天的实例应该也差不多了。可能有很多东西没有说的很全面 希望大家一起探讨。。。。

 浙公网安备 33010602011771号