
Python基础:第一篇Python语言的认识
目录
- Python 介绍
- Python和其他语言对比
- Python种类
- Python基础
- Python规则
- 解释器
- 注释
- 环境搭建
- pycharm工具使用
- Python基础语法
- 变量
- 输入、输出
- 条件语句
- 循环
- 运算符
- 数据类型
- int
- 布尔
- 字符串
- 列表
- 字典
- 元祖
一、python介绍
python的创始人为吉多·范罗苏姆(Guido van Rossum)。1989年的圣诞节期间,吉多·范罗苏姆为了在阿姆斯特丹打发时间,决心开发一个新的脚本解释程序,作为ABC语言的一种继承。
最新的TIOBE排行榜,Python赶超PHP占据第五!!!
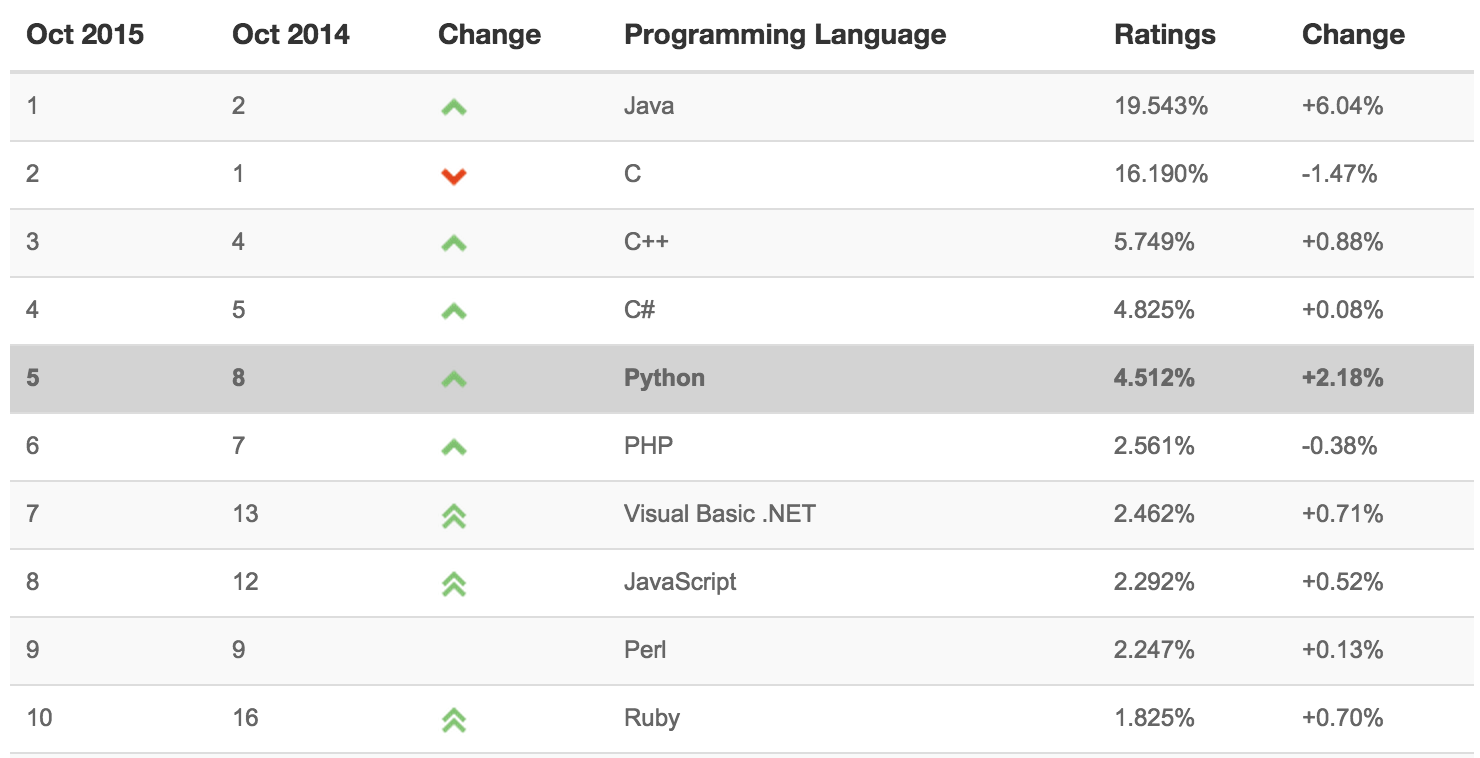
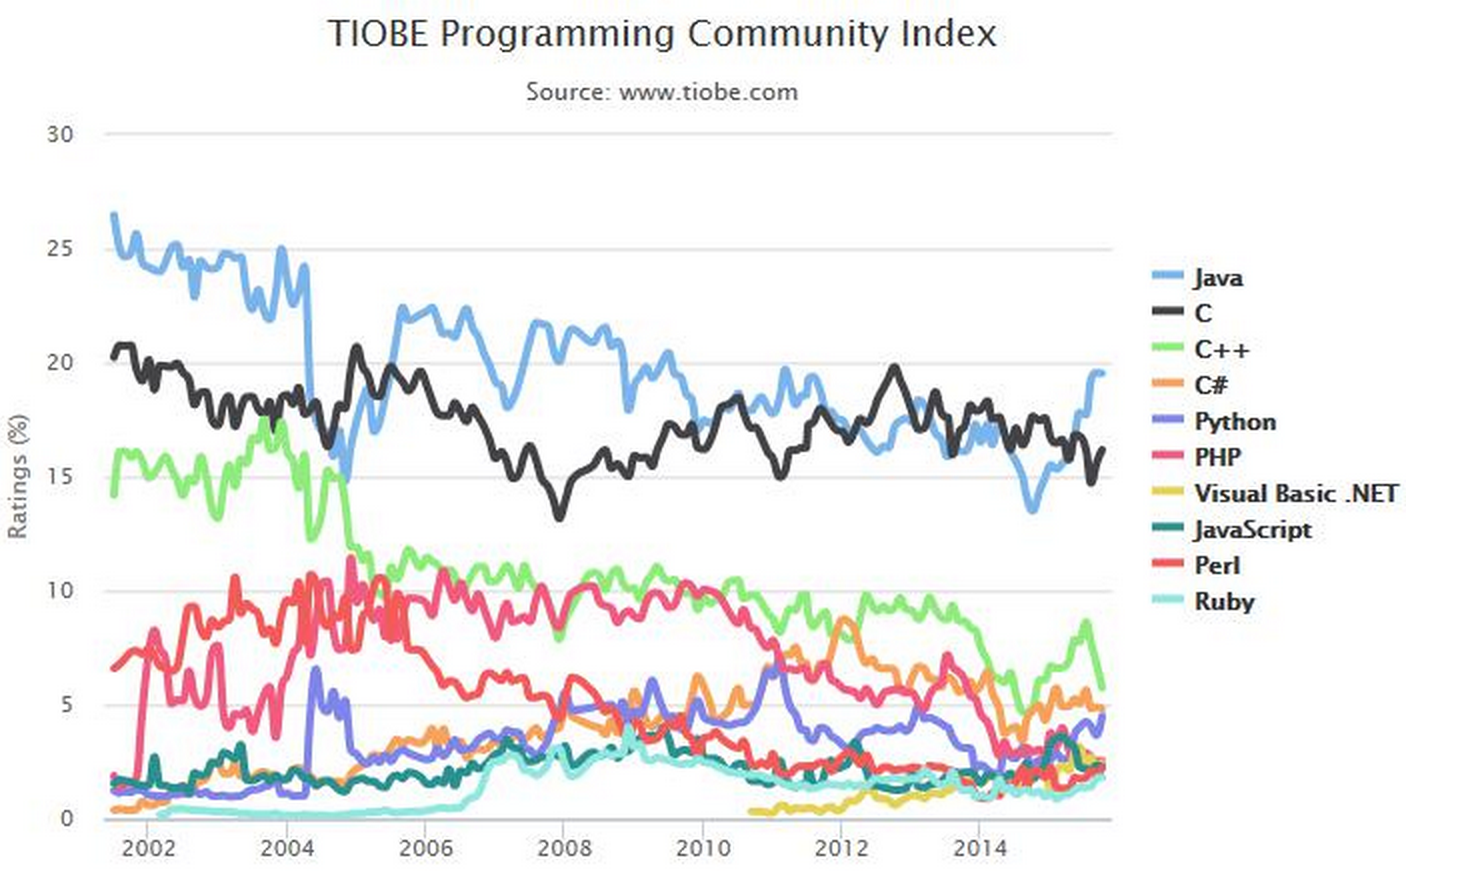
由上图可见,Python整体呈上升趋势,反映出Python应用越来越广泛并且也逐渐得到业内的认可!!!
Python可以应用于众多领域,如:数据分析、组件集成、网络服务、图像处理、数值计算和科学计算等众多领域。目前业内几乎所有大中型互联网企业都在使用Python,如:Youtube、Dropbox、BT、Quora(中国知乎)、豆瓣、知乎、Google、Yahoo!、Facebook、NASA、百度、腾讯、汽车之家、美团等。互联网公司广泛使用Python来做的事一般有:自动化运维、自动化测试、大数据分析、爬虫、Web 等。
注视:上述重点字体表示该公司主要使用Python语言开发
1.1 Python和其他语言对比
C语言: 代码编译得到 机器码 ,机器码在处理器上直接执行,每一条指令控制CPU工作
其他语言: 代码编译得到 字节码 ,虚拟机执行字节码并转换成机器码再后在处理器上执行
对于使用:Python的类库齐全并且使用简洁,如果要实现同样的功能,Python 10行代码可以解决,C可能就需要100行甚至更多.
对于速度:Python的运行速度相较与C,绝逼是慢了
Python 和 Java、C#对比
对于使用:Linux原装Python,其他语言没有;以上几门语言都有非常丰富的类库支持
对于速度:Python在速度上可能稍显逊色
1.2 Python的种类
- CPython : 代码 -> C字节码 -> 机器码 (一行一行)
Python的官方版本,使用C语言实现,使用最为广泛,CPython实现会将源文件(py文件)转换成字节码文件(pyc文件),然后运行在Python虚拟机上。
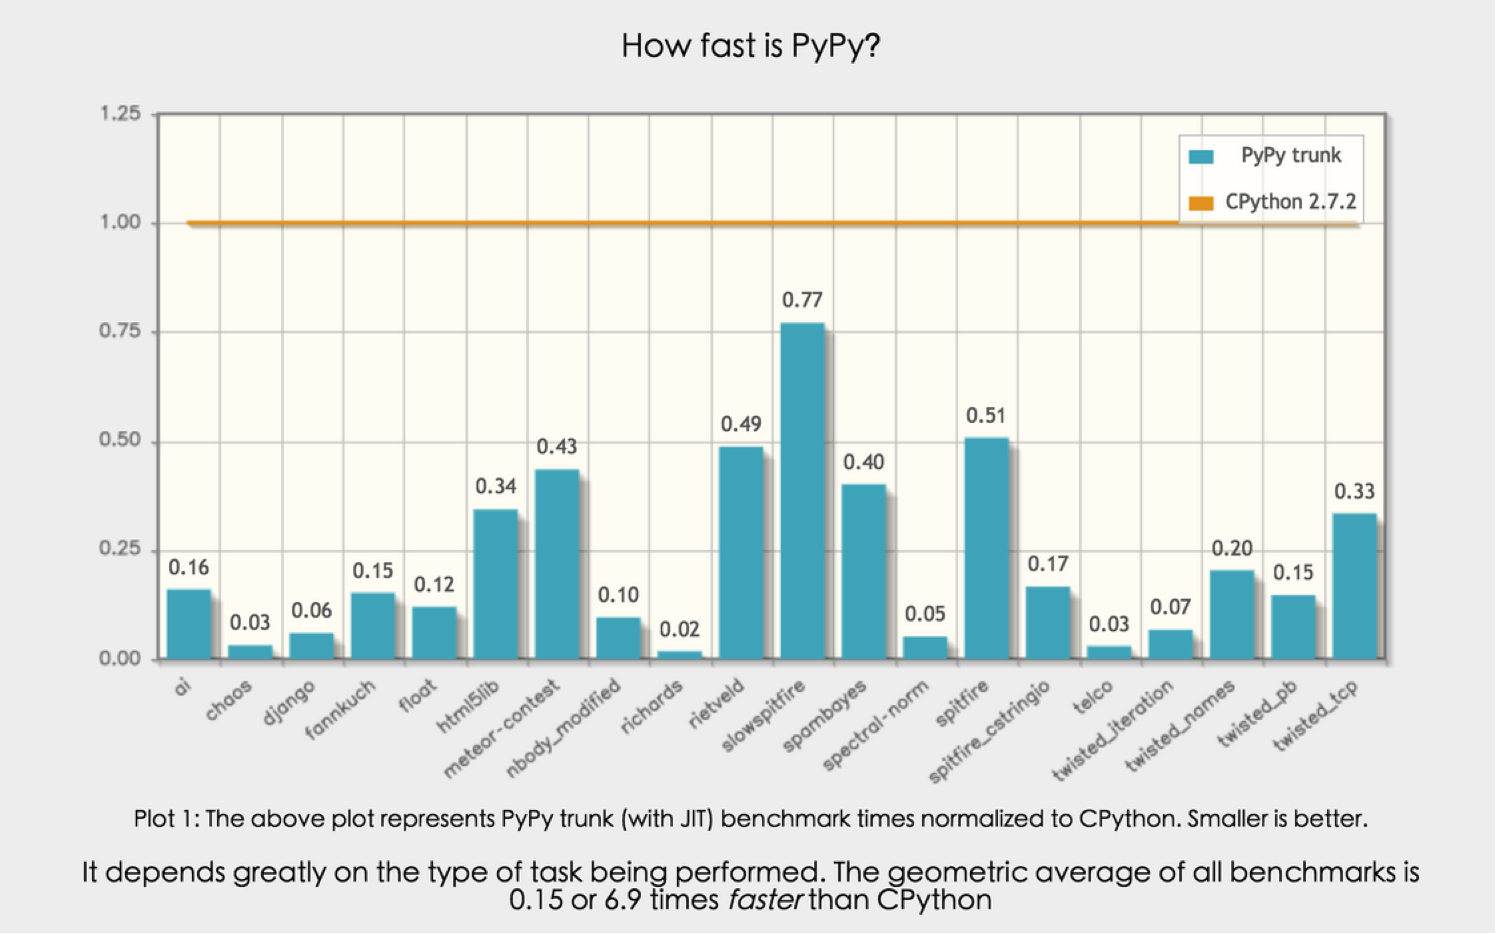
- pypy: 代码 -> C字节码 -> 机器码 全部转换完 -> 执行
Python实现的Python,将Python的字节码字节码再编译成机器码。
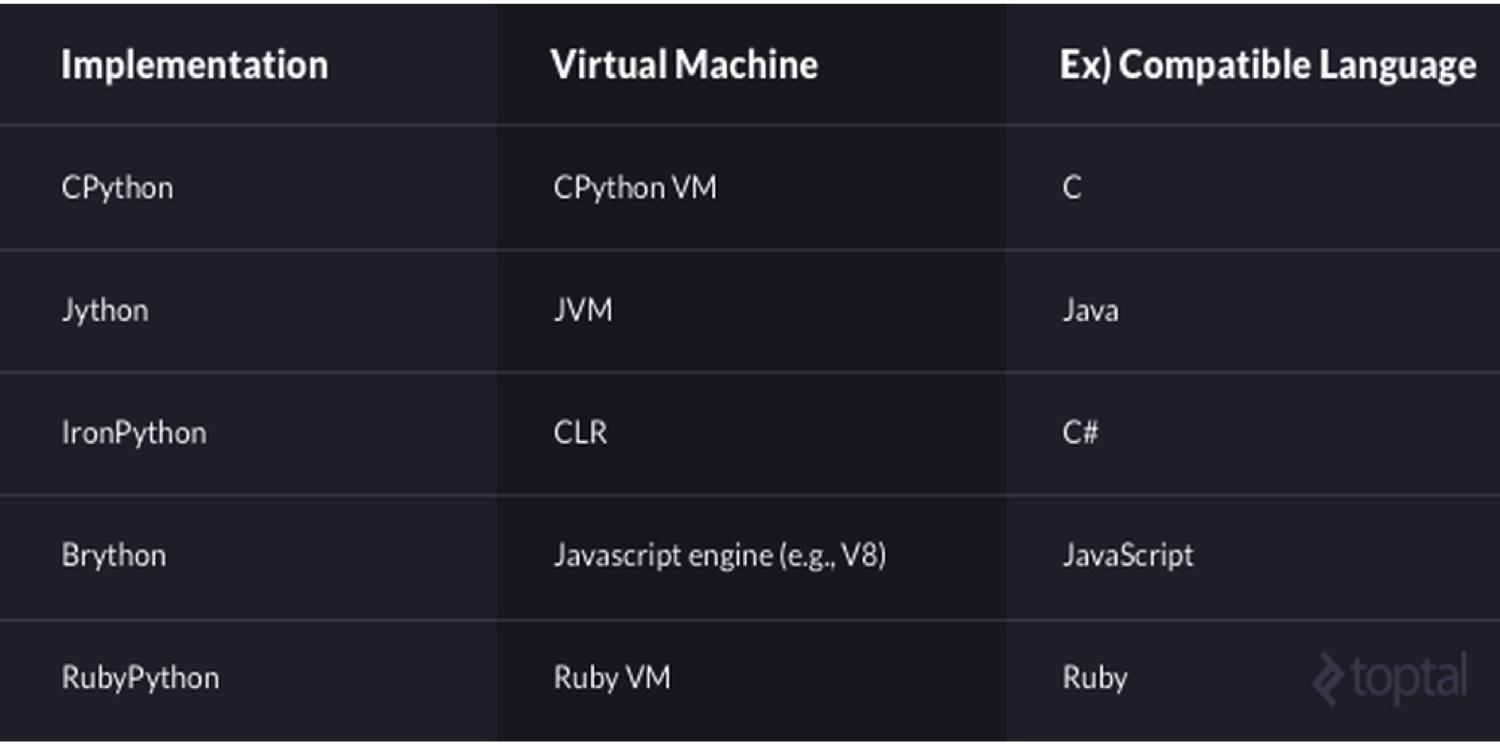
- 其他Python:代码 -> 其他字节码 -> 机器码
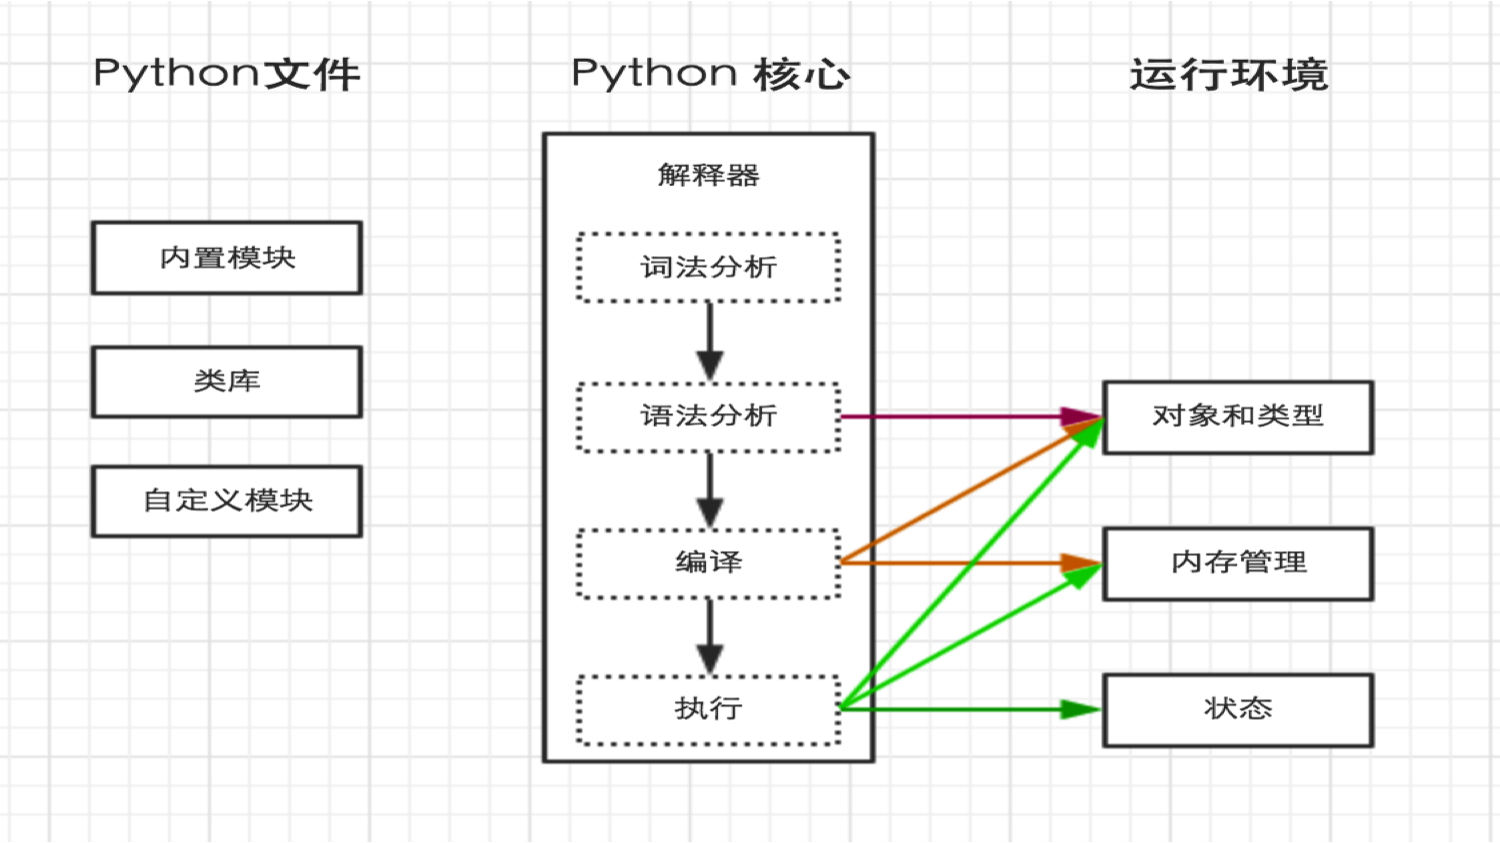
以上除PyPy之外,其他的Python的对应关系和执行流程如下:

PyPy,在Python的基础上对Python的字节码进一步处理,从而提升执行速度!
二、Python基础
2.1 Python环境
安装Python
windows:
1、下载安装包 https://www.python.org/downloads/2、安装 默认安装路径:C:\python273、配置环境变量 【右键计算机】--》【属性】--》【高级系统设置】--》【高级】--》【环境变量】--》【在第二个内容框中找到 变量名为Path 的一行,双击】 --> 【Python安装目录追加到变值值中,用 ; 分割】 如:原来的值;C:\python27,切记前面有分号Linux的yum依赖自带Python,为防止错误,此处更新其实就是再安装一个Python
查看默认Python版本
python -V
1、安装gcc,用于编译Python源码
yum install gcc
2、下载源码包,httpss://www.python.org/ftp/python/
3、解压并进入源码文件
4、编译安装
./configure
make all
make install
5、查看版本
/usr/local/bin/python2.7 -V
6、修改默认Python版本
mv /usr/bin/python /usr/bin/python2.6
ln -s /usr/local/bin/python2.7 /usr/bin/python
7、防止yum执行异常,修改yum使用的Python版本
vi /usr/bin/yum
将头部 #!/usr/bin/python 修改为 #!/usr/bin/python2.6
2.2 Python规则
在 /home/dev/ 目录下创建 hello.py 文件,内容如下:
print("hello world")
执行 hello.py 文件,即: python /home/dev/hello.py
python内部执行过程如下:
C:\Python35\python.exe D:\1.txt
# a. 打开文件,读取文件内容
# b. 词法分析,语法分析
# c. 字节
2.3 解释器
上一步中执行 python /home/dev/hello.py 时,明确的指出 hello.py 脚本由 python 解释器来执行。
如果想要类似于执行shell脚本一样执行python脚本,例: ./hello.py ,那么就需要在 hello.py 文件的头部指定解释器,如下:
#!/usr/bin/env python
如此一来,执行: ./hello.py 即可。
ps:执行前需给予 hello.py 执行权限,chmod 755 hello.py
2.4 Python编码
Python2.x:默认是ASCII编码
Python3.x:3.x之后默认是utf-8
所以为了避免兼容问题加# -*- coding:utf-8 -*-
ASCII(American Standard Code for Information Interchange,美国标准信息交换代码)是基于拉丁字母的一套电脑编码系统,主要用于显示现代英语和其他西欧语言,其最多只能用 8 位来表示(一个字节),即:2**8 = 256,所以,ASCII码最多只能表示 256 个符号。

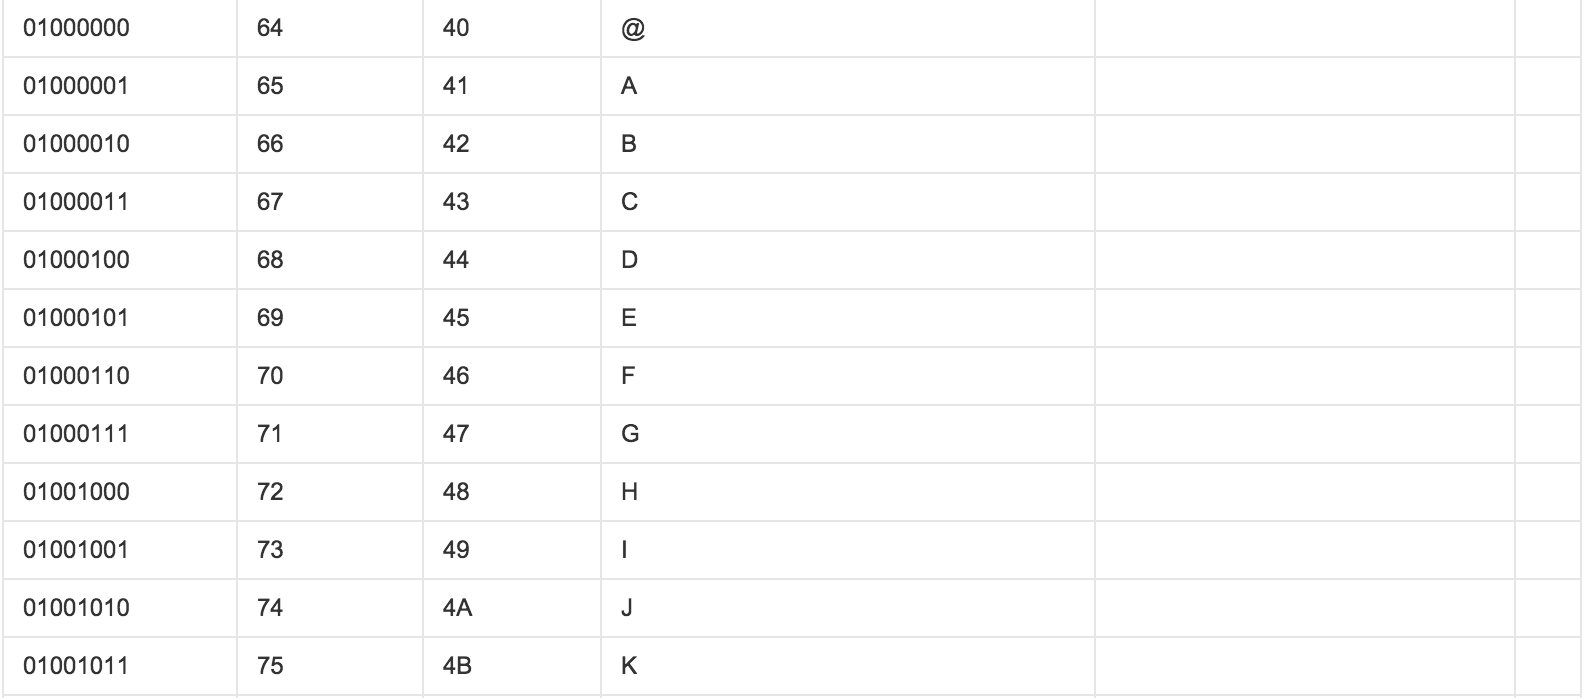
显然ASCII码无法将世界上的各种文字和符号全部表示,所以,就需要新出一种可以代表所有字符和符号的编码,即:Unicode
Unicode(统一码、万国码、单一码)是一种在计算机上使用的字符编码。Unicode 是为了解决传统的字符编码方案的局限而产生的,它为每种语言中的每个字符设定了统一并且唯一的二进制编码,规定虽有的字符和符号最少由 16 位来表示(2个字节),即:2 **16 = 65536,
注:此处说的的是最少2个字节,可能更多
UTF-8,是对Unicode编码的压缩和优化,他不再使用最少使用2个字节,而是将所有的字符和符号进行分类:ascii码中的内容用1个字节保存、欧洲的字符用2个字节保存,东亚的字符用3个字节保存...
所以,python解释器在加载 .py 文件中的代码时,会对内容进行编码(默认ascill),如果是如下代码的话:
报错:ascii码无法表示中文
2.5 注释
单行注视:# 被注释内容
多行注释:""" 被注释内容 """
2.6 pycharm工具使用
1.破解
http://www.cnblogs.com/nulige/p/6034222.html
2.使用
- new project
file->new project
- new 创建py文件
在py文件中右键, run xx.py
- 文件编码设置
File->Default settings->File Encoding

-
Python 模板设置
File->Default settings->Editor->File and Code Templates

三、Python基础语法
3.1变量
1、声明变量
|
1
2
3
4
|
#!/usr/bin/env python# -*- coding: utf-8 -*-name = [] |
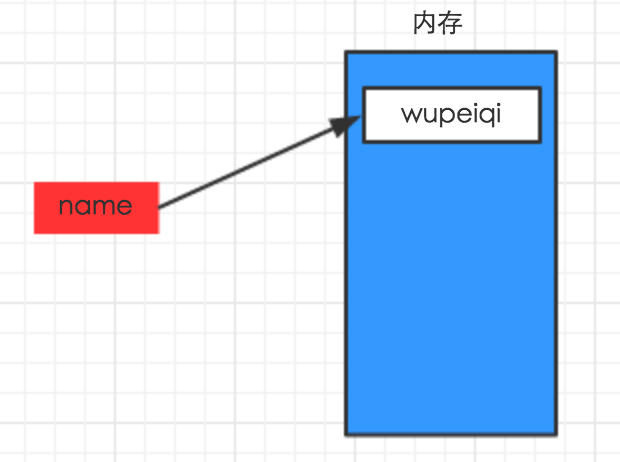
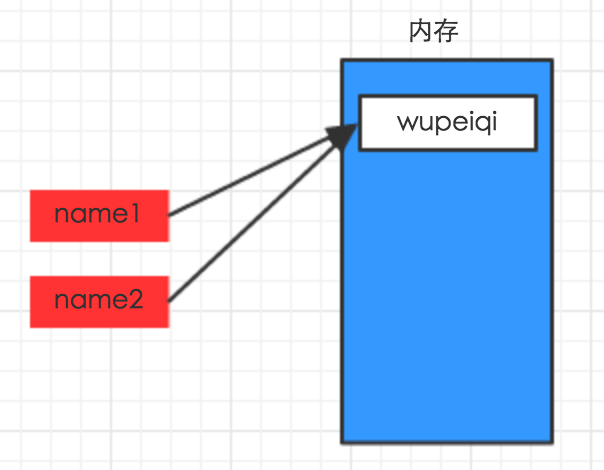
上述代码声明了一个变量,变量名为: name,变量name的值为:"wupeiqi"
变量的作用:昵称,其代指内存里某个地址中保存的内容
变量定义的规则:
- 变量名只能是 字母、数字或下划线的任意组合
- 变量名的第一个字符不能是数字
- 以下关键字不能声明为变量名
['and', 'as', 'assert', 'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except', 'exec', 'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is', 'lambda', 'not', 'or', 'pass', 'print', 'raise', 'return', 'try', 'while', 'with', 'yield']
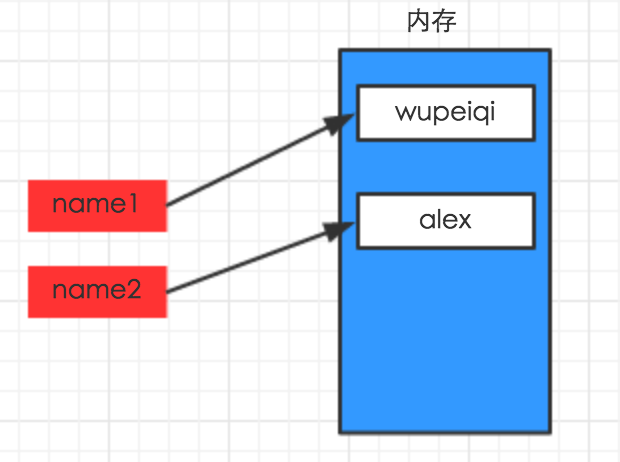
2、变量的赋值

#!/usr/bin/env python
# -*- coding: utf-8 -*-

name1 = "wupeiqi"
name2 = "alex"
#!/usr/bin/env python
# -*- coding: utf-8 -*-

name1 = "wupeiqi"
name2 = name1
name1 = 'hanhan'
3.2 输入
|
1
2
3
4
5
6
7
8
|
#!/usr/bin/env python# -*- coding: utf-8 -*-# 将用户输入的内容赋值给 name 变量name = input("请输入用户名:")# 打印输入的内容print(name) |
输入密码时,如果想要不可见,需要利用getpass 模块中的 getpass方法,即:
|
1
2
3
4
5
6
7
8
9
10
|
#!/usr/bin/env python# -*- coding: utf-8 -*-import getpass# 将用户输入的内容赋值给 name 变量pwd = getpass.getpass("请输入密码:")# 打印输入的内容print (pwd) |
3.3 流程控制和缩进
需求一、用户登陆验证
|
1
2
3
4
5
|
# 提示输入用户名和密码# 验证用户名和密码# 如果错误,则输出用户名或密码错误# 如果成功,则输出 欢迎,XXX! |
|
1
2
3
4
5
6
7
8
9
10
11
12
13
|
#!/usr/bin/env python# -*- coding: encoding -*-import getpassname = input('请输入用户名:')pwd = getpass.getpass('请输入密码:')if name == "alex" and pwd == "cmd": print (“登陆成功%s”%name)else: print (用户名和密码错误) |
需求二、根据用户输入内容输出其权限
|
1
2
3
4
5
6
|
# 根据用户输入内容打印其权限# alex --> 超级管理员# eric --> 普通管理员# tony --> 业务主管# 其他 --> 普通用户 |
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
|
#!/usr/bin/env python# -*- coding: encoding -*-name = input('请输入用户名:')if name == "alex": print ("超级管理员")elif name == "eric": print ("普通管理员")elif name == "tony": print ("业务主管")else: print ("普通用户") |
3.4 if 条件语句
1 if...else
if 条件:
成功
else:
失败
案例
import getpass
name = input("请输入姓名:")
pwd = getpass.getpass('请输入密码:')
if name == 'hanhan' and pwd == '123456':
print('欢迎登陆')
else:
print('退出)
2 if...elif..else
if 条件:
...
elif 条件:
...
else:
...
案例
username = input('>>>')
if username == 'alex':
print('普通管理')
elif username == 'oldboy':
print('超级管理')
elif username == '郭少龙':
print('人')
elif username == '刘一':
print('装逼犯')
else:
print('再见...')
print('end')
3.while循环
while 条件:
continue # 立即开始下次循环
break # 跳出所有循环
练习:
1、使用while循环输入 1 2 3 4 5 6 8 9 10
i=1
while i < 11:
    if i != 7:
        print(i)
    i+=1
2、求1-100的所有数的和
value = 0
i=1
while i < 101:
    value = value + i
    i+=1
print(value)
3、输出 1-100 内的所有奇数
while i < 101:
    if i % 2 == 0:
        print(i)
    i+=1
4、输出 1-100 内的所有偶数
while i < 101:
    if i % 2 != 0:
        print(i)
    i+=1
5、求1-2+3-4+5 ... 99的所有数的和
while i < 101:
    if i % 2 == 0:
        value-=i
    else:
        value+=i
    i+=1
print(value)
6、用户登陆(三次机会重试)
#!/usr/bin/Python
# -*- coding:utf-8 -*-
i = 0
while i < 3:
    name = input("UserName:")
    if name == 'hanjialong':
        pwd = input('Password')
        if pwd == '123456':
            print('欢迎登陆:%s'%name)
            break
    else:
        i+=1
        print('请重新输入还剩%d')
print('end')
4.for循环
for 条件:
continue #立即执行下一个循环
break #跳出当前while的所有循环
else: #while条件不成立执行
guess_num = 19
#range(开始,结束,步长) range(0,3)== 0,1,2,
for i in range(0,3):
    guess_num_inp = input('猜数字>>>')
#.isdigit()输入是否是一个数字
    if guess_num_inp.isdigit():
        if 'guess_num_inp' == guess_num:
            print('猜对了!!!!')
        else:
                print('猜的不对!!!')
    else:
        print('请输入数字!!!!')
else:
    print('没有机会了')
四、数据类型
4.1 运算符
算数运算符:

比较运算:

赋值运算:

逻辑运算:

成员运算:

身份运算:

位运算:

运算符优先级:

a.
i += 1
b.
if 1 == 1 or 1 > 2 and 1 == 4:
print('正确')
else:
print('错误')
c.
content = "aaaabbbccc"
if "a" in content:
print('包含敏感字符')
else:
print(content)
d. 整数 int
a = 123
a = int(123)
转换
age = "18"
new_age = int(age)
e. 布尔值
a = True
b = False
- 转换
- 数字转换,只有0是False,其他True
- 字符串, 只有""是False,其他True
- 待续...
f. 字符串
a = "alex"
a = str('alex')
转换
age = 19
new_age = str(age)
字符串的拼接
name = 'alex'
gender = '女'
new_str = name + gender
print(new_str)
字符串格式化
# 占位符,
# name = '我叫hanhan,性别:%s,我今年%s岁,我在说谎!'
# new_str = name %('男',19,)
# print(new_str)
name = '我叫hanhan,性别:%s,我今年%s岁,我在说谎!' %('男',19,)
print(name)
判断子序列是否在其中
content = "aaaaddddd"
if "a" in content:
print('包含敏感字符')
else:
print(content)
移除空白
val = " alex "
print(val)
# new_val = val.strip() # 左右
# new_val = val.lstrip()# 左边
# new_val = val.rstrip() # 右边
# print(new_val)
分割
user_info = "dddsb123 9"
# v = user_info.split('|')
# v = user_info.split('|',1)
# v = user_info.rsplit(' ',1)
# print(v)
长度(字符)
val = "李杰sb"
v = len(val)
print(v)
索引
val = "李杰sb"
v = val[0]
print(v)
val = input('>>>')
i = 0
while i < len(val):
print(val[i])
i += 1
切片
name = 'aaaa,bbbbxbbb,xxxx!'
print(name[0])
print(name[0:2])
print(name[5:9])
print(name[5:])
print(name[5:-2])
print(name[-2:])
- 移除空白:strip()、lstrip()、rstrip()
- 分割:参考http://www.runoob.com/python/att-string-split.html
- name.split(“str”,“num拆分个数”)
- 长度:len(name)
- 索引:name[0]
- 切片name[0:4]顾头不顾尾
4.2 列表
|
1
2
3
|
name_list =['alex', 'seven', 'eric']或name_list = list(['alex', 'seven', 'eric']) |
基本操作:
- in判断
in判断:
if 'al' in a:
pass
if 'al' in a[0]:
pass
- 索引list[1]
list1=["ceshi","han","hhh"]
list1[list1.index("ceshi")]="ba" - 切片
a = ['AA',BB','eric',123]
v = a[0::2]
print(v) - 追加:
a = ['CC','CC','eric',123]
a.append('xxoo')
print(a)
- 删除:
list1.remove("222") ,del list1[1] - 长度:list1.count(“jjj”)
- 循环
for cc in list1:
print(cc) - 包含:“alex” in list
- 更新
a = ['a1','a2','a3','eric',123]
a[1] = '阿斯顿发送到'
print(a)
- 插入:
a = ['a1','a2','a3','eric',123]
a.insert(0,'牛')
print(a) - 移除:
list1.pop
- 删除
a = ['a1','a2','a3','eric',123]
a.remove('eric')
del a[0]
print(a)
- for 循环
a = ['alex','eric','狗','eric',123]
for item in a:
print(item)
# break
# continue
4.3 元祖
|
1
2
3
|
ages =(11, 22, 33, 44, 55)或ages =tuple((11, 22, 33, 44, 55)) |
- 索引:tup[0]
- 切片
- 循环
- 长度
- 包含
4.4 字典(无序)
|
1
2
3
|
v = { |
常用操作:
- 索引
n = v['name']
print(n)
- 新增、修改
v['age'] = 19
# print(v)
- 删除:
del v['name']
print(v)
- 键、值、键值对
- 字典嵌套
user_dict = {'k1': 'v1','k2': {'kk1':'vv1','kk2':'vv2'},'k3': 123,'k4': ['alex','eric',['a','b','c'],'李杰',{'k11':'vv1'}],}
user_dict['k4'][2].append('123')
user_dict['k4'][4]['n'] = '过啥龙'
- 循环
for item in v.keys():
print(item)
for item in v.values():
print(item)
for key,val in v.items():
print(key,val)
- 长度
print(len(user_dict))
例子:
user_list = [
{'name':'alex','pwd':'123123','times':1},
{'name':'eric','pwd':'123123','times':1},
{'name':'tony','pwd':'123123','times':1},
]
user = input('用户名:')
pwd = input('密码:')
for item in user_list:
if user == item['name'] and pwd == item['pwd']:
print('登录成功')
break
五、初识文本的基本操作
- r,以只读方式打开文件
- w,打开一个文件只用于写入。如果该文件已存在则将其覆盖。如果该文件不存在,创建新文件。
- a,打开一个文件用于追加。如果该文件已存在,文件指针将会放在文件的结尾。也就是说,新的内容将会被写入到已有内容之后。如果该文件不存在,创建新文件进行写入。
- w+,打开一个文件用于读写。如果该文件已存在则将其覆盖。如果该文件不存在,创建新文件。
-
123456789
# 一次性加载所有内容到内存obj.read()# 一次性加载所有内容到内存,并根据行分割成字符串obj.readlines()# 每次仅读取一行数据forlineinobj:printline写文件的内容:
1obj.write('内容')关闭文件句柄:
1obj.close()

 浙公网安备 33010602011771号