
模块&包
模块&包
模块(module)的概念:
在计算机程序的开发过程中,随着程序代码越写越多,在一个文件里代码就会越来越长,越来越不容易维护。
为了编写可维护的代码,我们把很多函数分组,分别放到不同的文件里,这样,每个文件包含的代码就相对较少,很多编程语言都采用这种组织代码的方式。在Python中,一个.py文件就称之为一个模块(Module)。
使用模块有什么好处?
最大的好处是大大提高了代码的可维护性。
其次,编写代码不必从零开始。当一个模块编写完毕,就可以被其他地方引用。我们在编写程序的时候,也经常引用其他模块,包括Python内置的模块和来自第三方的模块。
所以,模块一共三种:
- python标准库
- 第三方模块
- 应用程序自定义模块
另外,使用模块还可以避免函数名和变量名冲突。相同名字的函数和变量完全可以分别存在不同的模块中,因此,我们自己在编写模块时,不必考虑名字会与其他模块冲突。但是也要注意,尽量不要与内置函数名字冲突。
模块导入方法
1 import 语句
import module1[, module2[,... moduleN]当我们使用import语句的时候,Python解释器是怎样找到对应的文件的呢?答案就是解释器有自己的搜索路径,存在sys.path里。
['D:\\pythontest\\glh10 模块', 'D:\\pythontest', 'D:\\python36\\python36.zip', 'D:\\python36\\DLLs', 'D:\\python36\\lib', 'D:\\python36', 'D:\\python36\\lib\\site-packages', 'D:\\PyCharm 2017.3.1\\helpers\\pycharm_matplotlib_backend']
2 from…import 语句
from modname import name1[, name2[, ... nameN]]这个声明不会把整个modulename模块导入到当前的命名空间中,只会将它里面的name1或name2单个引入到执行这个声明的模块的全局符号表。
3 From…import* 语句
from modname import *这提供了一个简单的方法来导入一个模块中的所有项目。然而这种声明不该被过多地使用。大多数情况, Python程序员不使用这种方法,因为引入的其它来源的命名,很可能覆盖了已有的定义。
4 运行本质
#1 import test
#2 from test import add 无论1还是2,首先通过sys.path找到test.py,然后执行test脚本(全部执行),区别是1会将test这个变量名加载到名字空间,而2只会将add这个变量名加载进来。
注意:模块可以包含可执行的语句和函数的定义,这些语句的目的是初始化模块,它们只在模块名第一次遇到导入import语句时才执行(import语句是可以在程序中的任意位置使用的,且针对同一个模块很可能import多次,为了防止你重复导入,python的优化手段是:第一次导入后就将模块名加载到内存了,后续的import语句仅是对已经加载大内存中的模块对象增加了一次引用,不会重新执行模块内的语句),如下:


#demo.py
import my_module #只在第一次导入时才执行my_module.py内代码,此处的显式效果是只打印一次'from the my_module.py',当然其他的顶级代码也都被执行了,只不过没有显示效果.
import my_module
import my_module
import my_module

'''
执行结果:
from the my_module.py
'''

demo.py
包(package)
如果不同的人编写的模块名相同怎么办?为了避免模块名冲突,Python又引入了按目录来组织模块的方法,称为包(Package)。
举个例子,一个abc.py的文件就是一个名字叫abc的模块,一个xyz.py的文件就是一个名字叫xyz的模块。
现在,假设我们的abc和xyz这两个模块名字与其他模块冲突了,于是我们可以通过包来组织模块,避免冲突。方法是选择一个顶层包名:
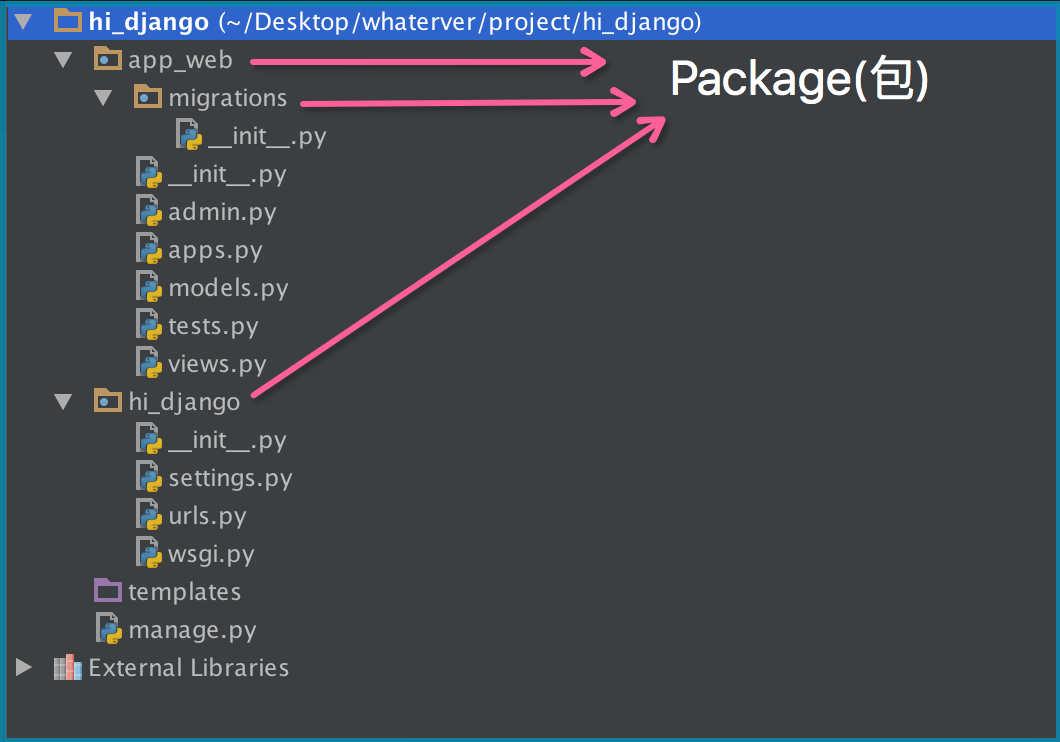
引入了包以后,只要顶层的包名不与别人冲突,那所有模块都不会与别人冲突。现在,view.py模块的名字就变成了hello_django.app01.views,类似的,manage.py的模块名则是hello_django.manage。
请注意,每一个包目录下面都会有一个__init__.py的文件,这个文件是必须存在的,否则,Python就把这个目录当成普通目录(文件夹),而不是一个包。__init__.py可以是空文件,也可以有Python代码,因为__init__.py本身就是一个模块,而它的模块名就是对应包的名字。
调用包就是执行包下的__init__.py文件
2. if __name__ == '__main__': 的用法。
如果我们是直接执行某个.py文件的时候,该文件中那么”__name__ == '__main__'“是True,但是我们如果从另外一个.py文件通过import导入该文件的时候,这时__name__的值就是我们这个py文件的名字而不是__main__。
这个功能还有一个用处:调试代码的时候,在”if __name__ == '__main__'“中加入一些我们的调试代码,我们可以让外部模块调用的时候不执行我们的调试代码,但是如果我们想排查问题的时候,直接执行该模块文件,调试代码能够正常运行!
注意:
##-------------cal.py
def add(x,y):

    return x+y
##-------------main.py
import cal      #from module import cal

def main():

    cal.add(1,2)

##--------------bin.py
from module import main

main.main()
# from module import cal 改成 from . import cal同样可以,这是因为bin.py是我们的执行脚本,
# sys.path里有bin.py的当前环境。即/Users/yuanhao/Desktop/whaterver/project/web这层路径,
# 无论import what ,  解释器都会按这个路径找。所以当执行到main.py时,import cal会找不到,因为
# sys.path里没有/Users/yuanhao/Desktop/whaterver/project/web/module这个路径,而
#  from  module/.  import cal 时,解释器就可以找到了。
time模块
三种时间表示
在Python中,通常有这几种方式来表示时间:
- 时间戳(timestamp) : 通常来说,时间戳表示的是从1970年1月1日00:00:00开始按秒计算的偏移量。我们运行“type(time.time())”,返回的是float类型。
- 格式化的时间字符串
- 元组(struct_time) : struct_time元组共有9个元素共九个元素:(年,月,日,时,分,秒,一年中第几周,一年中第几天,夏令时)
-
import time
## 1 时间戳 (Timestamp)
# print(time.time())   ##  获取自1970年1月1日凌晨 至今的时间  秒数
##  意义: 可做计算使用

### 2 结构化时间(struct_time)
# print(time.localtime()) # 获取到当前时间的 结构化时间 ## 默认参数为当前时间戳
# print(time.localtime(1520000000))

# t = time.localtime()
# print(t.tm_year)
# print(t.tm_wday)

## 获取世界标准时间 UTC
# print(time.gmtime())

### 将结构化时间转换为 时间戳  使用 mktime
# print(time.mktime(time.localtime()))

## 3 获取字符串时间  用于显示 (Format string)
  # 将结构化时间转换为 字符串时间 使用strftime
# print(time.strftime('%Y-%m-%d  %X',time.localtime()))
  # 将字符串时间转换为 结构化时间 使用 strptime
# print(time.strptime('2018:2:4 1:01:50','%Y:%m:%d %X'))

## 4 直接查看的命令
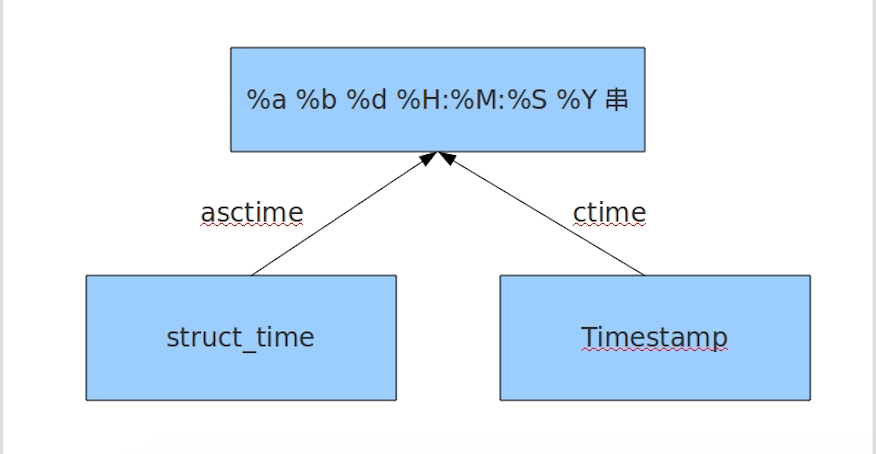
print(time.asctime())  ## 把结构化时间 转化为 字符串显示  ### Sun Feb  4 01:05:50 2018
print(time.ctime())   ##  把时间戳 转化为 字符串显示     ### Sun Feb  4 01:05:50 2018

## 5 datetime 模块   可看性更好
# import datetime
# print(datetime.datetime.now())   ### 2018-02-04 01:05:50.818323

random模块
## random 模块即一个随机模块
import random
print(random.random()) ## 随机获取0-1之间的随机浮点数
print(random.randint(1,3)) ##  随机获取[1,3]里面的随机整形数 即1,2,3
print(random.randrange(1,3))   ## 随机获取[1,3)里面的随机整形数 即1,2
print(random.choice([11,22,33]))  ## 随机获取列表中的 一个 随机元素, 可随机获取可迭代对象中的一个元素
print(random.sample(([11,22,33,44]),2)) ## 随机获取列表中的 三个 随机元素 (即可以指定个数),返回的是一个列表
print(random.uniform(1,3)) ##  随机获取1-3之间的随机浮点数 (即可以指定范围)

ret = [1,2,3,4,5]
random.shuffle(ret)
print(ret)       ###  随机打乱列表中的元素
 1 import random
 2
 3
 4 def v_code1():
 5     str1 = ''
 6     for i in range(6):
 7         num = random.randint(0, 9)
 8         str1 += str(num)
 9     return str1
10
11
12 def v_code():
13     str2 = ''
14     for i in range(6):
15         num = random.randint(0, 9)
16         alp = chr(random.randint(65, 90))
17         alp2 = chr(random.randint(97, 122))
18         s = random.choice([num, alp, alp2])
19     str2 += str(s)
20     return str2
def red1_packet(money, count):
    ret = random.sample(range(1, money*100), count-1)
    ret.extend([0, money*100])
    ret.sort()
    for i in range(count):
        yield '第%s个人抢到了%s元' % (i+1, (ret[i+1] - ret[i])/100)
    while 1:
        yield '就你这手速还抢红包'
OS模块
os模块是与操作系统交互的一个接口
os.getcwd() 获取当前工作目录,即当前python脚本工作的目录路径
os.chdir("dirname")  改变当前脚本工作目录;相当于shell下cd
os.curdir  返回当前目录: ('.')
os.pardir  获取当前目录的父目录字符串名:('..')
os.makedirs('dirname1/dirname2')    可生成多层递归目录
os.removedirs('dirname1')    若目录为空,则删除,并递归到上一级目录,如若也为空,则删除,依此类推
os.mkdir('dirname')    生成单级目录;相当于shell中mkdir dirname
os.rmdir('dirname')    删除单级空目录,若目录不为空则无法删除,报错;相当于shell中rmdir dirname
os.listdir('dirname')    列出指定目录下的所有文件和子目录,包括隐藏文件,并以列表方式打印
os.remove()  删除一个文件
os.rename("oldname","newname")  重命名文件/目录
os.stat('path/filename')  获取文件/目录信息
os.sep    输出操作系统特定的路径分隔符,win下为"\\",Linux下为"/"
os.linesep    输出当前平台使用的行终止符,win下为"\t\n",Linux下为"\n"
os.pathsep    输出用于分割文件路径的字符串 win下为;,Linux下为:
os.name    输出字符串指示当前使用平台。win->'nt'; Linux->'posix'

os.environ  获取系统环境变量
os.system("bash command")  运行shell命令,直接显示
os.popen("bash command).read()  运行shell命令,获取执行结果
os.path
os.path.abspath(path) 返回path规范化的绝对路径 os.path.split(path) 将path分割成目录和文件名二元组返回 os.path.dirname(path) 返回path的目录。其实就是os.path.split(path)的第一个元素 os.path.basename(path) 返回path最后的文件名。如何path以/或\结尾,那么就会返回空值。
                        即os.path.split(path)的第二个元素
os.path.exists(path)  如果path存在,返回True;如果path不存在,返回False
os.path.isabs(path)  如果path是绝对路径,返回True
os.path.isfile(path)  如果path是一个存在的文件,返回True。否则返回False
os.path.isdir(path)  如果path是一个存在的目录,则返回True。否则返回False
os.path.join(path1[, path2[, ...]])  将多个路径组合后返回,第一个绝对路径之前的参数将被忽略
os.path.getatime(path)  返回path所指向的文件或者目录的最后访问时间
os.path.getmtime(path)  返回path所指向的文件或者目录的最后修改时间
os.path.getsize(path) 返回path的大小
'''
sys模块
sys.argv           命令行参数List,第一个元素是程序本身路径
sys.exit(n)        退出程序,正常退出时exit(0)
sys.version        获取Python解释程序的版本信息
sys.maxint         最大的Int值 python2.7版本中有
sys.path           返回模块的搜索路径,初始化时使用PYTHONPATH环境变量的值
sys.platform       返回操作系统平台名称
import sys,time
for i in range(10):
    sys.stdout.write('#')
    time.sleep(1)
    sys.stdout.flush()
json & pickle模块
eval内置方法可以将一个字符串转成python对象,不过,eval方法是有局限性的,对于普通的数据类型,json.loads和eval都能用,但遇到特殊类型的时候,eval就不管用了,所以eval的重点还是通常用来执行一个字符串表达式,并返回表达式的值。
什么是序列化?
我们把对象(变量)从内存中变成可存储或传输的过程称之为序列化,在Python中叫pickling,在其他语言中也被称之为serialization,marshalling,flattening等等,都是一个意思。
序列化之后,就可以把序列化后的内容写入磁盘,或者通过网络传输到别的机器上。
反过来,把变量内容从序列化的对象重新读到内存里称之为反序列化,即unpickling。
json
如果我们要在不同的编程语言之间传递对象,就必须把对象序列化为标准格式,比如XML,但更好的方法是序列化为JSON,因为JSON表示出来就是一个字符串,可以被所有语言读取,也可以方便地存储到磁盘或者通过网络传输。JSON不仅是标准格式,并且比XML更快,而且可以直接在Web页面中读取,非常方便。
JSON表示的对象就是标准的JavaScript语言的对象,JSON和Python内置的数据类型对应如下:

注意:元组是作为一个列表被序列化的,所以在转回来的过程也只能转成一个列表:
import json
tu = (1, 2, 3)
print(tu, type(tu))  # (1, 2, 3) <class 'tuple'>
res = json.dumps(tu)
print(res, type(res))  # [1, 2, 3] <class 'str'>
ret = json.loads(res)
print(ret, type(ret))  # [1, 2, 3] <class 'list'>
#----------------------------序列化
import json

dic={'name':'alvin','age':23,'sex':'male'}
print(type(dic))#<class 'dict'>

j=json.dumps(dic)
print(type(j))#<class 'str'>


f=open('序列化对象','w')
f.write(j)  #-------------------等价于json.dump(dic,f)     #文件里的内容是人可读的,且不像pickel,可以连续dump,但是在load的时候会报错。
f.close() #-----------------------------反序列化<br> import json f=open('序列化对象') data=json.loads(f.read())# 等价于data=json.load(f)
import json
#dct="{'1':111}"#json 不认单引号
#dct=str({"1":111})#报错,因为生成的数据还是单引号:{'one': 1}

dct='{"1":"111"}'
print(json.loads(dct))

#conclusion:
#        无论数据是怎样创建的,只要满足json格式,就可以json.loads出来,不一定非要dumps的数据才能loads

注意点
import datetime


def json_encode_default(val):
    if isinstance(val, datetime.datetime):
        return val.strftime("%Y-%m-%d %X")

json.dumps(xxx, default=json_encode_default)
pickle
##----------------------------序列化
import pickle

dic={'name':'alvin','age':23,'sex':'male'}

print(type(dic))#<class 'dict'>

j=pickle.dumps(dic)
print(type(j))#<class 'bytes'>


f=open('序列化对象_pickle','wb')#注意是w是写入str,wb是写入bytes,j是'bytes'
f.write(j)  #-------------------等价于pickle.dump(dic,f)

f.close()
#-------------------------反序列化
import pickle
f=open('序列化对象_pickle','rb')

data=pickle.loads(f.read())#  等价于data=pickle.load(f)


print(data['age'])
import pickle

dic = {'k1': 'v1', 1: 2}
# print(pickle.dumps(dic))  # b'\x80\x03}q\x00(X\x02\x00\x00\x00k1q\x01X\x02\x00\x00\x00v1q\x02K\x01K\x02u.'
# with open('pickle_demo2', 'wb') as f:
#     pickle.dump(dic, f)  # 可连续dump后写入
#     pickle.dump(dic, f)
#     pickle.dump(dic, f)  # 文件里的内容是人看不出来的,想当于乱码

with open('pickle_demo2', 'rb') as f:
    while 1:
        try:
            print(pickle.load(f))  # 也可以正常的读
        except EOFError:
            break
Pickle的问题和所有其他编程语言特有的序列化问题一样,就是它只能用于Python,并且可能不同版本的Python彼此都不兼容,因此,只能用Pickle保存那些不重要的数据,不能成功地反序列化也没关系。
xml 多见于项目配置,优势和API接口:1.格式统一, 符合标准 2.容易与其他系统进行远程交互, 数据共享比较方便,缺点:较复杂
ini 配置多见于 Windows 应用程序  优势:结构是线性的,分析起来特别简单、方便;
csv:是最通用的一种文件格式,可以非常容易地被导入各种PC表格及数据库中 优势:简单的存储方式,可以减少存储信息的容量,有利于网络传输以及客户端的再处理
json:一种轻量级的数据交换格式,具有良好的可读和便于快速编写的特性 优势:数据格式比较简单, 易于读写, 格式都是压缩的, 占用带宽小
yaml:更为简单易读的序列化语言,优势:可读性好,和脚本语言的交互性好,有一个一致的信息模型
shelve模块
shelve模块比pickle模块简单,只有一个open函数,返回类似字典的对象,可读可写;key必须为字符串,而值可以是python所支持的数据类型。
 1 import shelve
 2 # python3 中对于shelve打开的文件,可读可写,python2中加了参数, flag='r' 就可以让文件只可读,不可写;
 3 #   本来python3中应该也可以,但貌似python3中缺失了一个对于管理文件读写的 文件,使得python3变得就算加了参数flag='r',
 4 #       依然是可读可写
 5 f = shelve.open('shelve_demo')
 6 f['key'] = [1, 2, 3]  # 写入
 7 f['key1'] = {'name': 'gou', 'age': 18}  # 写入
 8 print(f['key'])  # [1, 2, 3]
 9 print(f['key1'])  # {'name': 'gou', 'age': 18}
10 print(f.get('key1')['age'])  # 18
11 f['key3'] = 5  # 写入
12 print(f['key3'])  # 5
13 print(f.keys())  # KeysView(<shelve.DbfilenameShelf object at 0x0000021460480E10>)
14 print(f.pop('key3'))  # 可删除指定的key
xml模块
xml是实现不同语言或程序之间进行数据交换的协议,跟json差不多,但json使用起来更简单,不过,古时候,在json还没诞生的黑暗年代,大家只能选择用xml呀,至今很多传统公司如金融行业的很多系统的接口还主要是xml。
xml的格式如下,就是通过<>节点来区别数据结构的:
<?xml version="1.0"?>
<data>
    <country name="Liechtenstein">
        <rank updated="yes">2</rank>
        <year>2008</year>
        <gdppc>141100</gdppc>
        <neighbor name="Austria" direction="E"/>
        <neighbor name="Switzerland" direction="W"/>
    </country>
    <country name="Singapore">
        <rank updated="yes">5</rank>
        <year>2011</year>
        <gdppc>59900</gdppc>
        <neighbor name="Malaysia" direction="N"/>
    </country>
    <country name="Panama">
        <rank updated="yes">69</rank>
        <year>2011</year>
        <gdppc>13600</gdppc>
        <neighbor name="Costa Rica" direction="W"/>
        <neighbor name="Colombia" direction="E"/>
    </country>
</data>
xml协议在各个语言里的都 是支持的,在python中可以用以下模块操作xml:
import xml.etree.ElementTree as ET

tree = ET.parse("xmltest.xml")
root = tree.getroot()
print(root.tag)

#遍历xml文档
for child in root:
    print(child.tag, child.attrib)
    for i in child:
        print(i.tag,i.text)

#只遍历year 节点
for node in root.iter('year'):
    print(node.tag,node.text)
#---------------------------------------

import xml.etree.ElementTree as ET

tree = ET.parse("xmltest.xml")
root = tree.getroot()

#修改
for node in root.iter('year'):
    new_year = int(node.text) + 1
    node.text = str(new_year)
    node.set("updated","yes")

tree.write("xmltest.xml")


#删除node
for country in root.findall('country'):
   rank = int(country.find('rank').text)
   if rank > 50:
     root.remove(country)

tree.write('output.xml')
自己创建xml文档:
import xml.etree.ElementTree as ET


new_xml = ET.Element("namelist")
name = ET.SubElement(new_xml,"name",attrib={"enrolled":"yes"})
age = ET.SubElement(name,"age",attrib={"checked":"no"})
sex = ET.SubElement(name,"sex")
sex.text = '33'
name2 = ET.SubElement(new_xml,"name",attrib={"enrolled":"no"})
age = ET.SubElement(name2,"age")
age.text = '19'

et = ET.ElementTree(new_xml) #生成文档对象
et.write("test.xml", encoding="utf-8",xml_declaration=True)

ET.dump(new_xml) #打印生成的格式

创建xml文档
re模块
就其本质而言,正则表达式(或 RE)是一种小型的、高度专业化的编程语言,(在Python中)它内嵌在Python中,并通过 re 模块实现。正则表达式模式被编译成一系列的字节码,然后由用 C 编写的匹配引擎执行。
字符匹配(普通字符,元字符):
1 普通字符:大多数字符和字母都会和自身匹配
>>> re.findall('alvin','yuanaleSxalexwupeiqi')
['alvin']
2 元字符:. ^ $ * + ? { } [ ] | ( ) \
元字符之. ^ $ * + ? { }
 1 import re
 2
 3 ret=re.findall('a..in','helloalvin')
 4 print(ret)#['alvin']
 5
 6
 7 ret=re.findall('^a...n','alvinhelloawwwn')
 8 print(ret)#['alvin']
 9
10
11 ret=re.findall('a...n$','alvinhelloawwwn')
12 print(ret)#['awwwn']
13
14
15 ret=re.findall('a...n$','alvinhelloawwwn')
16 print(ret)#['awwwn']
17
18
19 ret=re.findall('abc*','abcccc')#贪婪匹配[0,+oo]
20 print(ret)#['abcccc']
21
22 ret=re.findall('abc+','abccc')#[1,+oo]
23 print(ret)#['abccc']
24
25 ret=re.findall('abc?','abccc')#[0,1]
26 print(ret)#['abc']
27
28
29 ret=re.findall('abc{1,4}','abccc')
30 print(ret)#['abccc'] 贪婪匹配
注意:前面的*,+,?等都是贪婪匹配,也就是尽可能匹配,后面加?号使其变成惰性匹配.
1 ret=re.findall('abc*?','abcccccc')
2 print(ret)#['ab']
元字符之字符集[]:
 1 #--------------------------------------------字符集[]
 2 ret=re.findall('a[bc]d','acd')
 3 print(ret)#['acd']
 4
 5 ret=re.findall('[a-z]','acd')
 6 print(ret)#['a', 'c', 'd']
 7
 8 ret=re.findall('[.*+]','a.cd+')
 9 print(ret)#['.', '+']
10
11 #在字符集里有功能的符号: - ^ \
12
13 ret=re.findall('[1-9]','45dha3')
14 print(ret)#['4', '5', '3']
15
16 ret=re.findall('[^ab]','45bdha3')
17 print(ret)#['4', '5', 'd', 'h', '3']
18
19 ret=re.findall('[\d]','45bdha3')
20 print(ret)#['4', '5', '3']
元字符之转义符\
反斜杠后边跟元字符去除特殊功能,比如\.
反斜杠后边跟普通字符实现特殊功能,比如\d
\d 匹配任何十进制数;它相当于类 [0-9]。
\D 匹配任何非数字字符;它相当于类 [^0-9]。
\s 匹配任何空白字符;它相当于类 [ \t\n\r\f\v]。
\S 匹配任何非空白字符;它相当于类 [^ \t\n\r\f\v]。
\w 匹配任何字母数字字符;它相当于类 [a-zA-Z0-9_]。
\W 匹配任何非字母数字字符;它相当于类 [^a-zA-Z0-9_]
\b 匹配一个特殊字符边界,比如空格 ,&,#等
ret=re.findall('I\b','I am LIST')
print(ret)#[]
ret=re.findall(r'I\b','I am LIST')
print(ret)#['I']
注意:
 1 #-----------------------------eg1:
 2 import re
 3 ret=re.findall('c\l','abc\le')
 4 print(ret)#[]
 5 ret=re.findall('c\\l','abc\le')
 6 print(ret)#[]
 7 ret=re.findall('c\\\\l','abc\le')
 8 print(ret)#['c\\l']
 9 ret=re.findall(r'c\\l','abc\le')
10 print(ret)#['c\\l']
11
12 #-----------------------------eg2:
13 #之所以选择\b是因为\b在ASCII表中是有意义的
14 m = re.findall('\bblow', 'blow')
15 print(m)
16 m = re.findall(r'\bblow', 'blow')
17 print(m)

元字符之分组():
m = re.findall(r'(ad)+', 'add')
print(m)

ret=re.search('(?P<id>\d{2})/(?P<name>\w{3})','23/com')
print(ret.group())#23/com
print(ret.group('id'))#23
元字符之|:
ret=re.search('(ab)|\d','rabhdg8sd')
print(ret.group())#ab
re模块下的常用方法:
 1 import re
 2 #1
 3 re.findall('a','alvin yuan')    #返回所有满足匹配条件的结果,放在列表里
 4 #2
 5 re.search('a','alvin yuan').group()  #函数会在字符串内查找模式匹配,只到找到第一个匹配然后返回一个包含匹配信息的对象,该对象可以
 6                                      # 通过调用group()方法得到匹配的字符串,如果字符串没有匹配,则返回None。
 7
 8 #3
 9 re.match('a','abc').group()     #同search,不过尽在字符串开始处进行匹配
10
11 #4
12 ret=re.split('[ab]','abcd')     #先按'a'分割得到''和'bcd',在对''和'bcd'分别按'b'分割
13 print(ret)#['', '', 'cd']
14
15 #5
16 ret=re.sub('\d','abc','alvin5yuan6',1)
17 print(ret)#alvinabcyuan6
18 ret=re.subn('\d','abc','alvin5yuan6')
19 print(ret)#('alvinabcyuanabc', 2)
20
21 #6
22 obj=re.compile('\d{3}')
23 ret=obj.search('abc123eeee')
24 print(ret.group())#123
import re
ret=re.finditer('\d','ds3sy4784a')
print(ret)        #<callable_iterator object at 0x10195f940>

print(next(ret).group())
print(next(ret).group())
注意:
import re

ret=re.findall('www.(baidu|oldboy).com','www.oldboy.com')
print(ret)#['oldboy']     这是因为findall会优先把匹配结果组里内容返回,如果想要匹配结果,取消权限即可

ret=re.findall('www.(?:baidu|oldboy).com','www.oldboy.com')
print(ret)#['www.oldboy.com']
注意:
import re

print(re.findall("<(?P<tag_name>\w+)>\w+</(?P=tag_name)>","<h1>hello</h1>"))
print(re.search("<(?P<tag_name>\w+)>\w+</(?P=tag_name)>","<h1>hello</h1>"))
print(re.search(r"<(\w+)>\w+</\1>","<h1>hello</h1>"))
1 #匹配出所有的整数
2 import re
3
4 #ret=re.findall(r"\d+{0}]","1-2*(60+(-40.35/5)-(-4*3))")
5 ret=re.findall(r"-?\d+\.\d*|(-?\d+)","1-2*(60+(-40.35/5)-(-4*3))")
6 ret.remove("")
7
8 print(ret)
collections模块
在内置数据类型(dict、list、set、tuple)的基础上,collections模块还提供了几个额外的数据类型:Counter、deque、defaultdict、namedtuple和OrderedDict等。
1.namedtuple: 生成可以使用名字来访问元素内容的tuple
2.deque: 双端队列,可以快速的从另外一侧追加和推出对象
3.Counter: 计数器,主要用来计数
4.OrderedDict: 有序字典
5.defaultdict: 带有默认值的字典
namedtuple
from collections import namedtuple

Point = namedtuple('Point', ['x', 'y'])  # 定义一个格式,里面的名称貌似没什么暖用
p = Point(1, 2)
print(p.x)
print(p.y)
deque
使用list存储数据时,按索引访问元素很快,但是插入和删除元素就很慢了,因为list是线性存储,数据量大的时候,插入和删除效率很低。
deque是为了高效实现插入和删除操作的双向列表,适合用于队列和栈:
>>> from collections import deque
>>> q = deque(['a', 'b', 'c'])
>>> q.append('x')
>>> q.appendleft('y')
>>> q
deque(['y', 'a', 'b', 'c', 'x'])
deque除了实现list的append()和pop()外,还支持appendleft()和popleft(),这样就可以非常高效地往头部添加或删除元素。
OrderedDict
使用dict时,Key是无序的。在对dict做迭代时,我们无法确定Key的顺序。
如果要保持Key的顺序,可以用OrderedDict:

>>> from collections import OrderedDict
>>> d = dict([('a', 1), ('b', 2), ('c', 3)])
>>> d # dict的Key是无序的
{'a': 1, 'c': 3, 'b': 2}
>>> od = OrderedDict([('a', 1), ('b', 2), ('c', 3)])
>>> od # OrderedDict的Key是有序的
OrderedDict([('a', 1), ('b', 2), ('c', 3)])
注意,OrderedDict的Key会按照插入的顺序排列,不是Key本身排序:
>>> od = OrderedDict()
>>> od['z'] = 1
>>> od['y'] = 2
>>> od['x'] = 3
>>> od.keys() # 按照插入的Key的顺序返回
['z', 'y', 'x']
defaultdict
有如下值集合 [11,22,33,44,55,66,77,88,99,90...],将所有大于 66 的值保存至字典的第一个key中,将小于 66 的值保存至第二个key的值中。
即: {'k1': 大于66 , 'k2': 小于66}
values = [11, 22, 33,44,55,66,77,88,99,90]

my_dict = {}

for value in  values:
    if value>66:
        if my_dict.has_key('k1'):
            my_dict['k1'].append(value)
        else:
            my_dict['k1'] = [value]
    else:
        if my_dict.has_key('k2'):
            my_dict['k2'].append(value)
        else:
            my_dict['k2'] = [value]
from collections import defaultdict

values = [11, 22, 33,44,55,66,77,88,99,90]

my_dict = defaultdict(list)

for value in  values:
    if value>66:
        my_dict['k1'].append(value)
    else:
        my_dict['k2'].append(value)
使用dict时,如果引用的Key不存在,就会抛出KeyError。如果希望key不存在时,返回一个默认值,就可以用defaultdict:
>>> from collections import defaultdict
>>> dd = defaultdict(lambda: 'N/A')
>>> dd['key1'] = 'abc'
>>> dd['key1'] # key1存在
'abc'
>>> dd['key2'] # key2不存在,返回默认值
'N/A'

# 普通字典的get方法也可以
Counter目的是用来跟踪值出现的次数。它是一个无序的容器类型,以字典的键值对形式存储,其中元素作为key,其计数作为value。计数值可以是任意的Interger(包括0和负数)。Counter类和其他语言的bags或multisets很相似。
创建
下面的代码说明了Counter类创建的四种方法:
计数值的访问与缺失的键
当所访问的键不存在时,返回0,而不是KeyError;否则返回它的计数。
>>> c = Counter("abcdefgab")
>>> c["a"]
2
>>> c["c"]
1
>>> c["h"]
0
计数器的更新(update和subtract)
可以使用一个iterable对象或者另一个Counter对象来更新键值。
计数器的更新包括增加和减少两种。其中,增加使用update()方法:
>>> c = Counter('which')
>>> c.update('witch')  # 使用另一个iterable对象更新
>>> c['h']
3
>>> d = Counter('watch')
>>> c.update(d)  # 使用另一个Counter对象更新
>>> c['h']
4
减少则使用subtract()方法:
键的修改和删除
当计数值为0时,并不意味着元素被删除,删除元素应当使用del。
elements()
返回一个迭代器。元素被重复了多少次,在该迭代器中就包含多少个该元素。元素排列无确定顺序,个数小于1的元素不被包含。
>>> c = Counter(a=4, b=2, c=0, d=-2)
>>> list(c.elements())
['a', 'a', 'a', 'a', 'b', 'b']
most_common([n])
返回一个TopN列表。如果n没有被指定,则返回所有元素。当多个元素计数值相同时,排列是无确定顺序的。
>>> c = Counter('abracadabra')
>>> c.most_common()
[('a', 5), ('r', 2), ('b', 2), ('c', 1), ('d', 1)]
>>> c.most_common(3)
[('a', 5), ('r', 2), ('b', 2)]
浅拷贝copy
>>> c = Counter("abcdcba")
>>> c
Counter({'a': 2, 'c': 2, 'b': 2, 'd': 1})
>>> d = c.copy()
>>> d
Counter({'a': 2, 'c': 2, 'b': 2, 'd': 1})
算术和集合操作
+、-、&、|操作也可以用于Counter。其中&和|操作分别返回两个Counter对象各元素的最小值和最大值。需要注意的是,得到的Counter对象将删除小于1的元素。
>>> c = Counter(a=3, b=1)
>>> d = Counter(a=1, b=2)
>>> c + d  # c[x] + d[x]
Counter({'a': 4, 'b': 3})
>>> c - d  # subtract(只保留正数计数的元素)
Counter({'a': 2})
>>> c & d  # 交集:  min(c[x], d[x])
Counter({'a': 1, 'b': 1})
>>> c | d  # 并集:  max(c[x], d[x])
Counter({'a': 3, 'b': 2})
其他常用操作
下面是一些Counter类的常用操作,来源于Python官方文档
logging模块
一 (简单应用)
import logging
logging.debug('debug message')
logging.info('info message')
logging.warning('warning message')
logging.error('error message')
logging.critical('critical message')
输出:
WARNING:root:warning message
ERROR:root:error message
CRITICAL:root:critical message
可见,默认情况下Python的logging模块将日志打印到了标准输出中,且只显示了大于等于WARNING级别的日志,这说明默认的日志级别设置为WARNING(日志级别等级CRITICAL > ERROR > WARNING > INFO > DEBUG > NOTSET),默认的日志格式为日志级别:Logger名称:用户输出消息。
二 灵活配置日志级别,日志格式,输出位置
import logging

# ---------------------------logging.basicConfig()--------------------------------

# logging.basicConfig(
#     level=logging.DEBUG,          # 定义级别
#     filename='logger.log',         # 存到文件里,后面为文件名 默认一追加a的方式
#     filemode='w',                 #  指定写的模式
#     format='%(filename)s %(asctime)s [%(lineno)d] %(message)s '     #  日志打印的格式
# )
#
# logging.debug('debug')          调用  从上往下 级别升高
# logging.info('info')
# logging.warning('warning')
# logging.error('erron')
# logging.critical('critical')
查看输出:
logging 模块.py 2018-03-03 01:08:21,731 [12] debug
logging 模块.py 2018-03-03 01:08:21,732 [13] info
logging 模块.py 2018-03-03 01:08:21,733 [14] warning
logging 模块.py 2018-03-03 01:08:21,733 [15] erron
logging 模块.py 2018-03-03 01:08:21,733 [16] critical

可见在logging.basicConfig()函数中可通过具体参数来更改logging模块默认行为,可用参数有
filename:用指定的文件名创建FiledHandler(后边会具体讲解handler的概念),这样日志会被存储在指定的文件中。
filemode:文件打开方式,在指定了filename时使用这个参数,默认值为“a”还可指定为“w”。
format:指定handler使用的日志显示格式。
datefmt:指定日期时间格式。
level:设置rootlogger(后边会讲解具体概念)的日志级别
stream:用指定的stream创建StreamHandler。可以指定输出到sys.stderr,sys.stdout或者文件(f=open('test.log','w')),默认为sys.stderr。若同时列出了filename和stream两个参数,则stream参数会被忽略。
format参数中可能用到的格式化串:
%(name)s Logger的名字
%(levelno)s 数字形式的日志级别
%(levelname)s 文本形式的日志级别
%(pathname)s 调用日志输出函数的模块的完整路径名,可能没有
%(filename)s 调用日志输出函数的模块的文件名
%(module)s 调用日志输出函数的模块名
%(funcName)s 调用日志输出函数的函数名
%(lineno)d 调用日志输出函数的语句所在的代码行
%(created)f 当前时间,用UNIX标准的表示时间的浮 点数表示
%(relativeCreated)d 输出日志信息时的,自Logger创建以 来的毫秒数
%(asctime)s 字符串形式的当前时间。默认格式是 “2003-07-08 16:49:45,896”。逗号后面的是毫秒
%(thread)d 线程ID。可能没有
%(threadName)s 线程名。可能没有
%(process)d 进程ID。可能没有
%(message)s用户输出的消息
三 logger对象
上述几个例子中我们了解到了logging.debug()、logging.info()、logging.warning()、logging.error()、logging.critical()(分别用以记录不同级别的日志信息),logging.basicConfig()(用默认日志格式(Formatter)为日志系统建立一个默认的流处理器(StreamHandler),设置基础配置(如日志级别等)并加到root logger(根Logger)中)这几个logging模块级别的函数,另外还有一个模块级别的函数是logging.getLogger([name])(返回一个logger对象,如果没有指定名字将返回root logger)
def logger():
    logger = logging.getLogger()                              # 创建一个logger对象
    logger.setLevel('DEBUG')                                  # 为logger对象指定级别
    fh = logging.FileHandler('logger_test')                   # 定义一个 可向文件内发送日志的对象
    ch = logging.StreamHandler()                                # 定义一个 可向屏幕内发送日志的对象
    fm = logging.Formatter('%(asctime)s %(message)s')        ## 为日志写格式
    fh.setFormatter(fm)                                         # 使 fh 对象获取存日志的格式
    ch.setFormatter(fm)                                             #  使 ch 对象获取在屏幕上显示日志的格式
    logger.addHandler(fh)                                       # 使 logger 对象获取 fh 的方法
    logger.addHandler(ch)                                        #   # 使 logger 对象获取ch 的方法
    return logger


logger = logger()                                          # 调用
logger.debug('debug')
logger.info('info')
logger.warning('warning')
logger.error('erron')
logger.critical('critical')
logging库提供了多个组件:Logger、Handler、Filter、Formatter。Logger对象提供应用程序可直接使用的接口,Handler发送日志到适当的目的地,Filter提供了过滤日志信息的方法,Formatter指定日志显示格式。
注意:
如果我们再创建两个logger对象:
##################################################
logger1 = logging.getLogger('mylogger')
logger1.setLevel(logging.DEBUG)

logger2 = logging.getLogger('mylogger')
logger2.setLevel(logging.INFO)

logger1.addHandler(fh)
logger1.addHandler(ch)

logger2.addHandler(fh)
logger2.addHandler(ch)

logger1.debug('logger1 debug message')
logger1.info('logger1 info message')
logger1.warning('logger1 warning message')
logger1.error('logger1 error message')
logger1.critical('logger1 critical message')

logger2.debug('logger2 debug message')
logger2.info('logger2 info message')
logger2.warning('logger2 warning message')
logger2.error('logger2 error message')
logger2.critical('logger2 critical message')
结果:

这里有两个个问题:
<1>我们明明通过logger1.setLevel(logging.DEBUG)将logger1的日志级别设置为了DEBUG,为何显示的时候没有显示出DEBUG级别的日志信息,而是从INFO级别的日志开始显示呢?
原来logger1和logger2对应的是同一个Logger实例,只要logging.getLogger(name)中名称参数name相同则返回的Logger实例就是同一个,且仅有一个,也即name与Logger实例一一对应。在logger2实例中通过logger2.setLevel(logging.INFO)设置mylogger的日志级别为logging.INFO,所以最后logger1的输出遵从了后来设置的日志级别。
<2>为什么logger1、logger2对应的每个输出分别显示两次?
这是因为我们通过logger = logging.getLogger()显示的创建了root Logger,而logger1 = logging.getLogger('mylogger')创建了root Logger的孩子(root.)mylogger,logger2同样。而孩子,孙子,重孙……既会将消息分发给他的handler进行处理也会传递给所有的祖先Logger处理。
ok,那么现在我们把
# logger.addHandler(fh)
# logger.addHandler(ch) 注释掉,我们再来看效果:
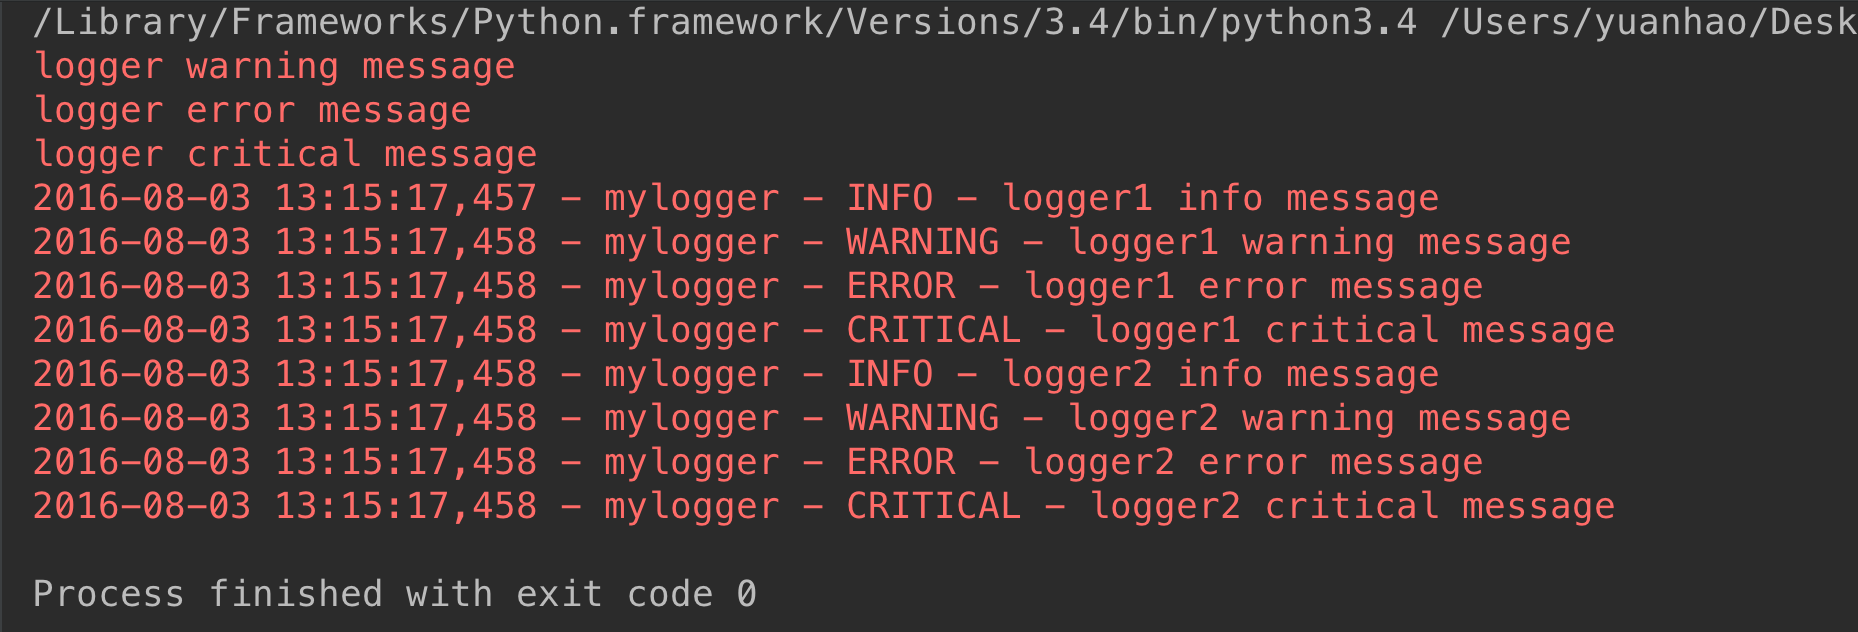
因为我们注释了logger对象显示的位置,所以才用了默认方式,即标准输出方式。因为它的父级没有设置文件显示方式,所以在这里只打印了一次。
孩子,孙子,重孙……可逐层继承来自祖先的日志级别、Handler、Filter设置,也可以通过Logger.setLevel(lel)、Logger.addHandler(hdlr)、Logger.removeHandler(hdlr)、Logger.addFilter(filt)、Logger.removeFilter(filt)。设置自己特别的日志级别、Handler、Filter。若不设置则使用继承来的值。
configparser模块
来看一个好多软件的常见文档格式如下:
 1 [DEFAULT]
 2 ServerAliveInterval = 45
 3 Compression = yes
 4 CompressionLevel = 9
 5 ForwardX11 = yes
 6
 7 [bitbucket.org]
 8 User = hg
 9
10 [topsecret.server.com]
11 Port = 50022
12 ForwardX11 = no
如果想用python生成一个这样的文档怎么做呢?
import configparser

config = configparser.ConfigParser()
config["DEFAULT"] = {'ServerAliveInterval': '45',
                      'Compression': 'yes',
                     'CompressionLevel': '9'}

config['bitbucket.org'] = {}
config['bitbucket.org']['User'] = 'hg'
config['topsecret.server.com'] = {}
topsecret = config['topsecret.server.com']
topsecret['Host Port'] = '50022'     # mutates the parser
topsecret['ForwardX11'] = 'no'  # same here
config['DEFAULT']['ForwardX11'] = 'yes'
with open('example.ini', 'w') as configfile:
   config.write(configfile)
import configparser

config = configparser.ConfigParser()

#---------------------------------------------查
print(config.sections())   #[]

config.read('example.ini')

print(config.sections())   #['bitbucket.org', 'topsecret.server.com']

print('bytebong.com' in config)# False

print(config['bitbucket.org']['User']) # hg

print(config['DEFAULT']['Compression']) #yes

print(config['topsecret.server.com']['ForwardX11'])  #no


for key in config['bitbucket.org']:
    print(key)


# user
# serveraliveinterval
# compression
# compressionlevel
# forwardx11


print(config.options('bitbucket.org'))#['user', 'serveraliveinterval', 'compression', 'compressionlevel', 'forwardx11']
print(config.items('bitbucket.org'))  #[('serveraliveinterval', '45'), ('compression', 'yes'), ('compressionlevel', '9'), ('forwardx11', 'yes'), ('user', 'hg')]

print(config.get('bitbucket.org','compression'))#yes


#---------------------------------------------删,改,增(config.write(open('i.cfg', "w")))


config.add_section('yuan')

config.remove_section('topsecret.server.com')
config.remove_option('bitbucket.org','user')

config.set('bitbucket.org','k1','11111')

config.write(open('i.cfg', "w"))

增删改查
hashlib模块
用于加密相关的操作,3.x里代替了md5模块和sha模块,主要提供 SHA1, SHA224, SHA256, SHA384, SHA512 ,MD5 算法
import hashlib

m=hashlib.md5()# m=hashlib.sha256()

m.update('hello'.encode('utf8'))
print(m.hexdigest())  #5d41402abc4b2a76b9719d911017c592

m.update('alvin'.encode('utf8'))

print(m.hexdigest())  #92a7e713c30abbb0319fa07da2a5c4af

m2=hashlib.md5()
m2.update('helloalvin'.encode('utf8'))
print(m2.hexdigest()) #92a7e713c30abbb0319fa07da2a5c4af
以上加密算法虽然依然非常厉害,但时候存在缺陷,即:通过撞库可以反解。所以,有必要对加密算法中添加自定义key再来做加密。(可通过加盐的方式避免,m = hashlib.m5('dsfewf'.encode(utf8)))
import hashlib

# ######## 256 ########

hash = hashlib.sha256('898oaFs09f'.encode('utf8'))
hash.update('alvin'.encode('utf8'))
print (hash.hexdigest())#e79e68f070cdedcfe63eaf1a2e92c83b4cfb1b5c6bc452d214c1b7e77cdfd1c7
python 还有一个 hmac 模块,它内部对我们创建 key 和 内容 再进行处理然后再加密:
import hmac
h = hmac.new('alvin'.encode('utf8'))
h.update('hello'.encode('utf8'))
print (h.hexdigest())#320df9832eab4c038b6c1d7ed73a5940
2个应用
1 利用动态加盐的方式登陆验证
2 验证2个文件是否一致

 浙公网安备 33010602011771号