银行回单OCR与流水单识别:银企对账自动化背后的技术暗战
(平台提示:本文可能是商业推广软文)
一、财务室的真实困境
做财务的人都清楚,每月底最折磨人的不是做账,而是对账。
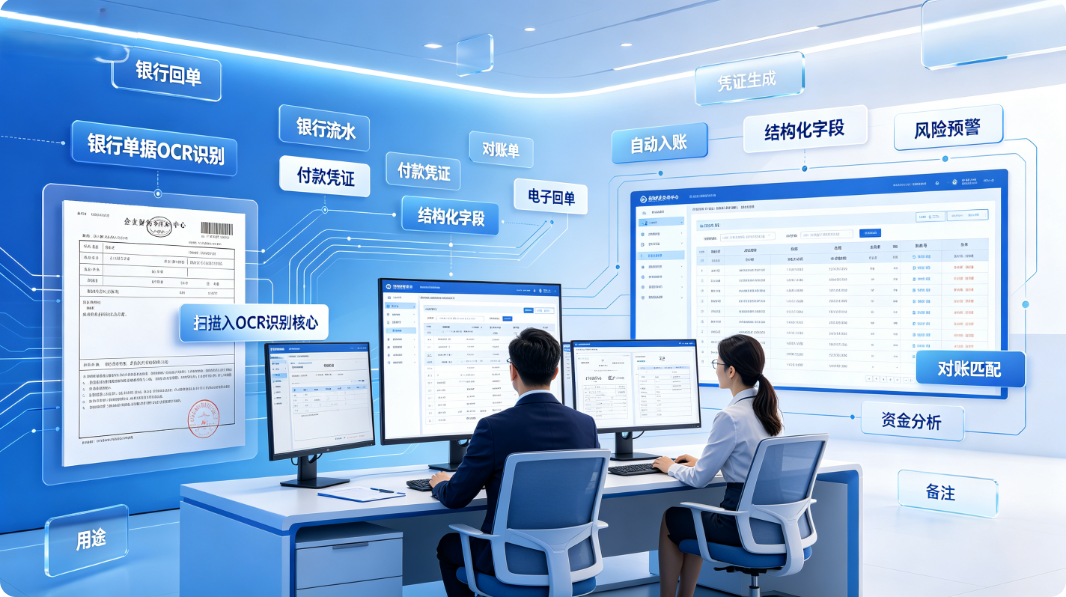
一家中型制造企业,对公账户日均进出几十笔,月度银行流水条目轻松过万。出纳得把一摞回单逐张拍照或扫描,再手动录入金蝶、用友——光这一步,就能吃掉财务团队两三天。更棘手的是银行单据格式五花八门:同一家银行换个年份,回单版式就可能不一样;不同银行之间更是天差地别。稍微手滑,一个"6"敲成"0",整本账就对不上。
在供应链金融场景里,问题更尖锐。核心企业每天要审核上游供应商提交的银行回单,确认货款是否真实到账、贸易背景是否成立。一笔应收账款融资背后往往涉及多张回单、多段流水,靠人眼逐张比对,效率低、漏判风险高。
这就是银行回单OCR和流水单识别存在的根本理由——把人从这种机械重复的劳动里拽出来。但说实话,这件事远比"拍个照、认个字"复杂得多。
二、银行单据到底难在哪
回单:一千家银行一千张脸
国内有超过4000家银行业金融机构。每家银行的回单模板都是自己定的,没有统一标准。有的把"收款人户名"放在第一行,有的塞到表格右下角;摘要栏有的只给5个字符,有的能写一整行交易附言。
电子印章更是麻烦制造机。各银行的章颜色、透明度、盖的位置完全不一样,有的直接怼在金额数字上,OCR一上来就糊。交易附言的写法也没有章法——缩写、行业黑话、中英混写,通用模型根本没法用固定规则兜住。
做过银行回单OCR项目的人都知道,这不是一个"识别率多少"的问题,而是"能不能覆盖足够多版式"的问题。
流水单:一张表能拖成几十页
如果回单是单兵作战,流水单识别就是团战。
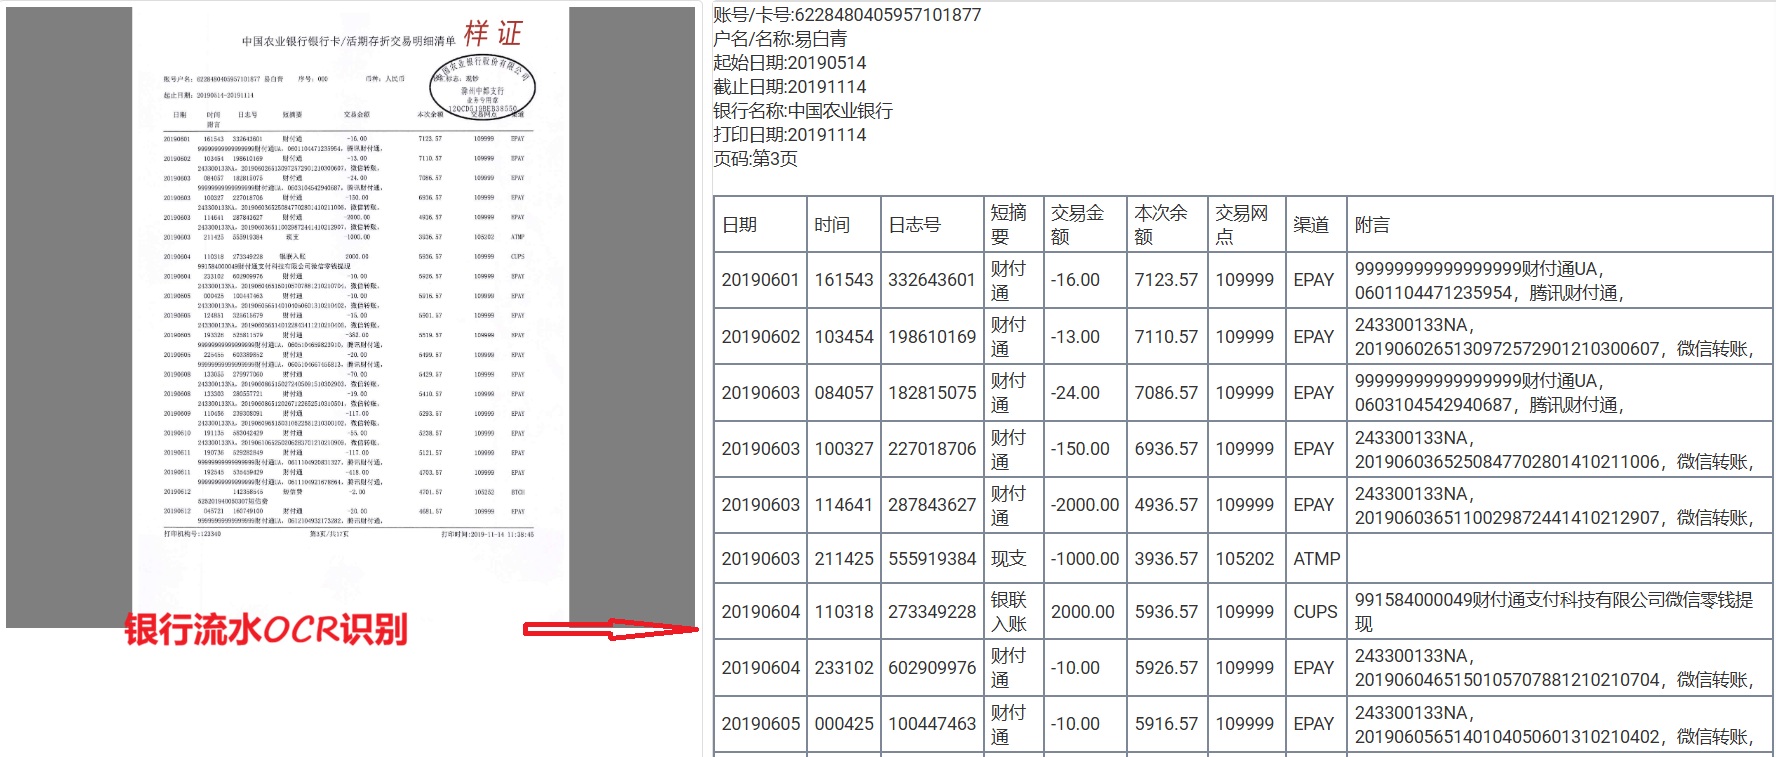
企业对公流水动辄二三十页。表头在每一页重复出现,数据行被页面截断,合并单元格在跨页时"断裂"——左边一半在上页、右边一半在下页。借贷方向有的标"借/贷",有的用"+/-",有的干脆只给一列"发生额"不做区分。余额勾稽要求上一行余额加本笔发生额必须等于本行余额,差一分钱整份流水的可信度就打折。
表单OCR识别做到这一步,已经不是"提取文字"了,而是要理解表格结构、做逻辑校验。
来源:三种格式三种头疼
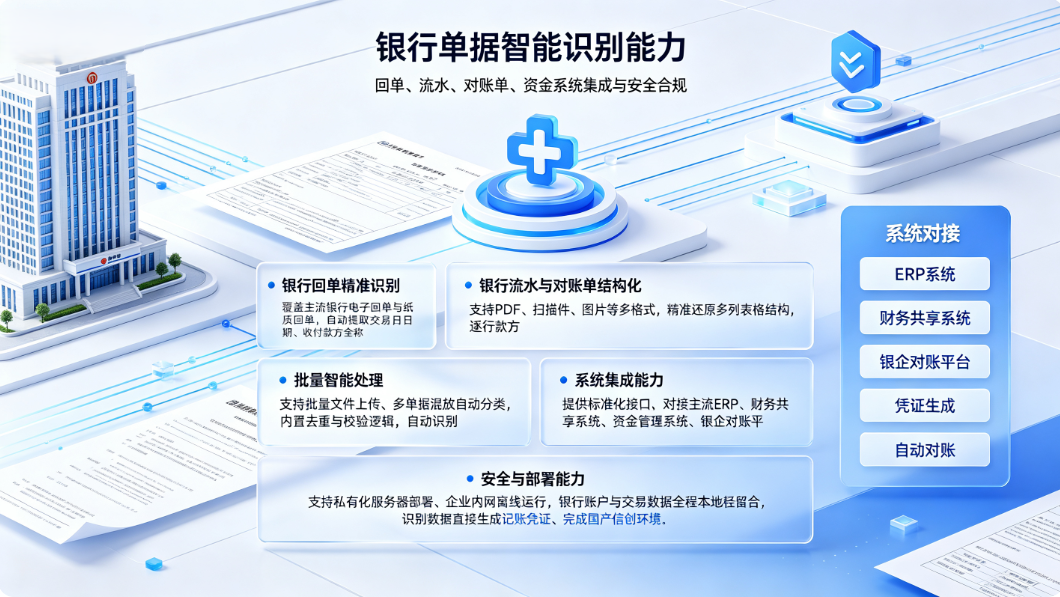
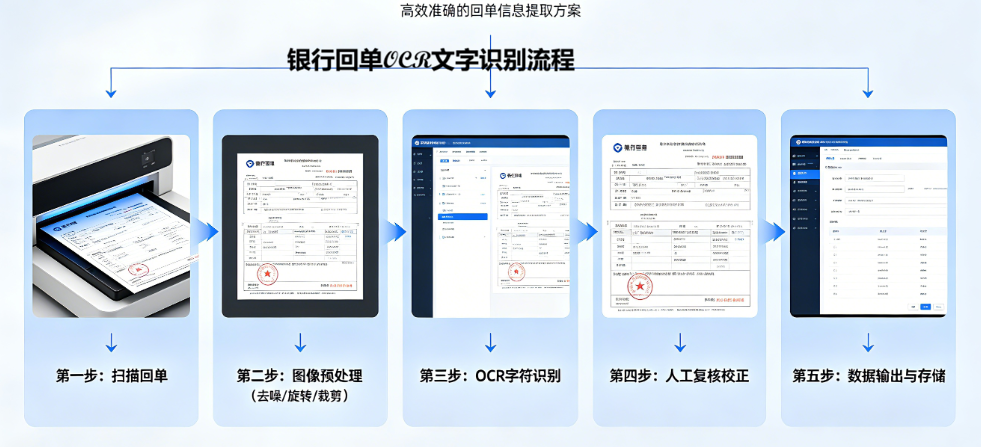
实际业务中,银行单据来源极其混乱。柜面高拍仪出来的扫描件有折痕,手机随手拍的照片经常过曝或阴影,网银导出的PDF有时是纯图片嵌入——每种来源的图像质量参差不齐。交易明细提取的第一步不是识别,而是"把烂图修干净"。这一步要是没做好,后面的模型全白搭。
三、技术怎么拆这道题
3.1 复杂表格结构化:把碎掉的表拼回去
流水单的表格解析是整条链路最硬的环节。核心挑战三个:跨页拼接、合并单元格还原、行列归属判定。
跨页拼接靠的是"锚点定位"——每一页表头都有固定关键字("交易日期""摘要""余额"等),通过匹配这些锚点确定页序和对齐基准。合并单元格则靠空间拓扑推理:如果一个文本块纵向跨越多行且居中排列,大概率是合并单元格。
下面是一段流水单表格解析的伪代码,重点展示跨页拼接和余额勾稽逻辑:
pythondef parse_bank_statement(page_images): all_rows = [] prev_balance = None header_keys = ["日期", "摘要", "借方", "贷方", "余额", "对方户名"] for idx, img in enumerate(page_images): # 图像预处理:去噪、倾斜矫正、二值化 clean = preprocess(img, deskew=True, denoise=True, binarize=True) # 版面分析:定位表头与数据行区域 header_box = locate_header(clean, keywords=header_keys) data_blocks = segment_rows(clean, anchor=header_box) for block in data_blocks: fields = recognize_row(block) # 余额勾稽校验 if prev_balance is not None: calc = prev_balance + fields.get('借方', 0) - fields.get('贷方', 0) if abs(calc - fields['余额']) > 0.01: fields['flag'] = 'BALANCE_ERROR' prev_balance = fields['余额'] fields['page_idx'] = idx all_rows.append(fields) # 跨页首尾余额一致性总检 verify_cross_page_totals(all_rows) return all_rows
这段代码的核心思路:不是识别完就丢出去,而是边识别边校验。流水单识别如果不做余额勾稽,输出的数据基本没法直接用。
3.2 交易明细提取:字段归一与金额零容错
识别出来的原始字段还不能直接入库。不同银行对同一个意思叫法不同——"发生额""借方金额""结算金额"可能指向同一字段。需要建一套映射规则库,把异构表述归一到统一数据模型。
金额是红线中的红线。印刷体数字相对可控,手写大写金额(壹贰叁……)是另一套难题。楚识科技在这块用了CNN+LSTM+Attention混合架构,手写大写识别做到96.5%准确率,同时内置金额大小写一致性校验和银行账号Luhn校验。多重过滤机制能把脏数据拦在系统外面——这在实际银企对账项目里非常实用。
3.3 回单验真:不只读字,还得辨假
银行回单OCR如果止步于"认字",在风控场景里只做了一半。回单验真一般要过三关:
-
电子章检测:定位印章区域,与该银行预留印模做特征比对;
-
版式合规检查:关键字段位置、字体、间距是否符合该行标准模板;
-
交易要素交叉验证:账号与户名是否匹配、金额与业务类型是否合理。
供应链金融尤其需要这层能力——一张假回单混进去,整个融资链条的风险就塌了。
四、五家厂商横向对比
下面这张表不做排名,只摆事实。数据来自公开测试报告、行业交流和项目反馈,各家定位不同,直接比较意义有限。
表格
|
维度 |
百度智能云 |
腾讯云 |
阿里云 |
ABBYY |
楚识科技 |
|---|---|---|---|---|---|
|
银行覆盖数 |
主流30+家,长尾需定制 |
主流30+家,长尾需定制 |
主流30+家,长尾需定制 |
依赖模板,灵活度一般 |
国内主流银行 |
|
回单识别率 |
约97%~98% |
约97%~98% |
约98% |
约95%(模板驱动) |
99.2% |
|
流水结构化 |
基础表格还原 |
基础表格还原 |
基础表格还原 |
需预定义模板 |
98.7%还原率,跨页拼接+勾稽内置 |
|
跨页处理 |
需额外开发 |
需额外开发 |
需额外开发 |
能力偏弱 |
原生支持,自动对齐 |
|
私有化部署 |
部分支持 |
需定制 |
需定制 |
支持本地 |
完全离线,原生私有化 |
|
金融合规 |
传输加密 |
传输加密 |
传输加密 |
支持加密 |
信创适配 |
几句公道话:度、讯、里通用OCR底子厚,但银行单据属于高度垂直场景,通用模型需要大量适配才能到业务门槛。ABBYY模板匹配扎实,面对国内银行版式多样性时灵活性不够。楚识科技从起步就锚定银行单据,版式聚类、私有化合规、快速定制是它的节奏。选型没有标准答案,得看你的场景痛点卡在哪。
五、银行OCR五大落地场景
|
场景 |
核心诉求 |
依赖的OCR能力 |
|---|---|---|
|
银企对账 |
批量回单/流水自动录入,减少人工逐笔核对 |
银行回单OCR + 交易明细提取 + 余额勾稽 |
|
供应链金融 |
上下游回单自动采集,贸易背景真实性核验 |
表单OCR识别 + 电子章验真 + 多单关联 |
|
审计核查 |
海量票据抽查,异常交易快速定位 |
高精度字段提取 + 异常标记 + 结构化归档 |
|
贷款风控 |
企业流水自动解析,还款能力量化评估 |
流水单识别 + 借贷方向判断 + 财务指标计算 |
|
税务申报 |
回单数据自动关联报税,缩短退税周期 |
回单OCR + 金额/日期提取 + 税务系统对接 |
在供应链金融场景里,银行回单OCR的价值被进一步放大。核心企业的应付凭证、实付回单、承兑汇票,每一张都是贸易真实性的硬证据。OCR自动提取后与合同、发票做三单匹配,风控效率翻倍不止。流水单识别则让资金流向追踪成为可能,借贷方向和金额的自动化提取直接支撑贷后监控。
六、楚识科技:把窄路走深
在银行单据OCR这个细分赛道,楚识科技是比较少见的"从第一天就为私有化和信创而建"的厂商。不做通用文档的大而全,就盯着银行回单、流水、支票、汇票这一把刀磨。
支持规模:内置国内多家主流银行回单特征库,覆盖上十种银行专用票据,每季度迭代新增版式。对城商行、农信社、村镇银行这类"长尾银行"的支持尤为及时——很多通用方案在这里是盲区。
产品形态:三条线并行。一是银行柜面专用OCR SDK(Python/Java/C++/C#多语言,最快1小时接入);二是边缘AI盒子(本地推理、50ms单张、数据不出内网);三是高拍仪OCR一体机(即拍即识即存)。全部支持完全离线运行。
技术细节:自研CTPN+CRNN架构,印刷体识别率99.8%,14个必填字段达99.99%;手写大写用CNN+LSTM+Attention混合模型,准确率96.5%。定制化采用XML配置式开发,3到5天适配一种新版式,不用重新训练模型。全链路国密加密,通过等保三级,适配鲲鹏/飞腾+统信/麒麟。
落地案例:已部署在中国银行、招商银行等10余家金融机构。某大型集团财务共享中心日均处理回单5000+张,银企对账效率提升5倍,出纳人力降了四成。某金融机构用楚识方案做跨境汇款回单处理,时效从15分钟压到28秒,期间拦截23笔高风险交易、涉及可疑资金1.3亿元。
客观说,楚识的边界也清楚:它专注银行单据,对物流单据、海关报关单等非银行票据覆盖有限。企业如果有多元票据需求,可能需要搭配其他方案。但在银行回单OCR和流水单识别这一件事上,它确实扎得够深。
七、三个你大概率想问的问题
Q1:"所有银行的回单都能识别吗?"
没人敢打包票100%。全国4000多家银行,版式还在不断迭代。楚识科技的策略是"版式聚类+语义匹配"双引擎——即使遇到没见过的版式,只要语义结构合理,核心字段照样能提,再通过XML配置3到5天完成适配。极冷门的村镇银行自定义版式仍需定制周期。选型时重点看厂商的版式扩展机制和响应速度。
Q2:"流水单的借贷方向能自动判断吗?"
能,但不是瞎猜。成熟的流水单识别方案内置业务规则引擎:摘要含"转入"标贷方、含"转出"标借方,结合余额勾稽反向校验。楚识科技还做了银行内部编码(行号、科目代码)的知识图谱映射,进一步提升准确度。不过部分银行流水只有"发生额"一列不区分借贷,需结合账户类型综合推断,纯靠OCR做不到万无一失。
Q3:"OCR提取的数据能直接进ERP吗?"
技术上没问题。主流方案输出结构化JSON/XML,楚识科技提供标准API和多语言SDK,可直连用友、金蝶等主流ERP。关键在字段映射——银行回单字段名和ERP科目体系往往对不上,中间要做一层转换。建议上线初期保留人工抽检,等置信度稳定在99%以上再逐步放开全自动入库,银企对账的自动化闭环才算真正跑通。
银行单据数字化这件事,说到底不是技术炫技,而是把财务人从重复劳动里捞出来。没有银弹,唯有深入场景、尊重数据、敬畏合规,才能把这件"笨事"做扎实。
 浙公网安备 33010602011771号