
Fluent Python2 【Chapter24_QA】
isidentifier() 函数是用于检查字符串是否是一个有效的 Python 标识符。Python 标识符是指用于标识变量、函数、类等命名的字符串。一个有效的标识符必须符合以下规则:
- 只能由字母(包括大小写字母)、数字和下划线组成。
- 第一个字符不能是数字。
- 不能使用 Python 中的关键字作为标识符。
如果字符串符合这些规则,则 isidentifier() 返回 True,否则返回 False。
下面是一个示例:
# 合法的标识符
print("foo".isidentifier())   # True
print("bar123".isidentifier())   # True
print("_baz".isidentifier())   # True
print("class_".isidentifier())   # True

# 非法的标识符
print("123".isidentifier())   # False,第一个字符是数字
print("$money".isidentifier())   # False,包含非法字符$
print("for".isidentifier())   # False,是 Python 的关键字
在上面的示例中,前四个字符串是有效的 Python 标识符,因此 isidentifier() 返回 True,而最后三个字符串不是有效的标识符,因此返回 False。
2. get_type_hints()
get_type_hints() 是 Python 的 typing 模块中的一个函数,用于获取函数的参数和返回值的类型提示。它的作用是在运行时动态地获取函数的参数和返回值的类型信息,通常用于类型注解检查、文档生成等场景。
通俗来说,get_type_hints() 可以帮助我们在运行时获取函数的参数和返回值的类型信息,而不需要手动解析函数的签名。
下面是一个示例:
from typing import List, Dict, get_type_hints

def greet(name: str, age: int) -> str:
    return f"Hello, {name}! You are {age} years old."

# 获取参数和返回值的类型提示
hints = get_type_hints(greet)
print("Parameter types:", hints)

# 使用参数和返回值的类型提示
name: str = "Alice"
age: int = 30
result: str = greet(name, age)
print("Result:", result)
3. NoReturn对象的概念和用法理解。【一个函数只有报错,或者返回异常[如无限循环、无限递归这种],这个时候】
NoReturn 是 Python 中 typing 模块提供的特殊类型之一。它表示一个函数永远不会正常返回,即函数总是会抛出异常或者无限循环等情况,不会返回任何值。
通俗来说,如果你有一个函数,在任何情况下都不会返回值,而是会抛出异常或者永远循环,那么你可以使用 NoReturn 类型提示来说明这一点。
下面是一个示例:
from typing import NoReturn

def infinite_loop() -> NoReturn:
    while True:
        pass

def raise_error() -> NoReturn:
    raise ValueError("An error occurred")

# 这里声明的函数的返回类型提示是 NoReturn,表示永远不会返回值
def func_with_no_return() -> NoReturn:
    if some_condition:
        infinite_loop()
    else:
        raise_error()
__qualname__是Python中一个特殊的属性,它提供了一种方便的方式来获取一个对象的限定名(qualified name)。限定名是指对象在完整的模块和类层次结构中的完整路径。
概念和作用
在Python中,每个对象都有一个名称,但是这个名称可能会在不同的上下文中重复。例如,在不同的模块或类中,可能会有多个同名的函数或变量。为了唯一标识一个对象,我们需要知道它的完整路径,包括模块名、类名等。这就是限定名的作用所在。
__qualname__属性为我们提供了一种简单的方式来获取对象的限定名,而不需要自己构造路径字符串。这在调试、日志记录和自省(introspection)等情况下非常有用。
通俗解释
假设你有一个大型的Python项目,其中有许多模块和类。现在,你想知道某个特定的函数或方法属于哪个模块和类。这时,你可以使用__qualname__属性来轻松查看它的完整路径。
举例说明
让我们通过一些示例来更好地理解__qualname__的用法:
- 函数
def my_function():
    pass

print(my_function.__qualname__)  # 输出: my_function
对于顶级函数,__qualname__只包含函数名。
- 嵌套函数
def outer():
    def inner():
        pass
    print(inner.__qualname__)  # 输出: outer.<locals>.inner

print(outer.__qualname__)  # 输出: outer
对于嵌套函数,__qualname__包含了外部函数的名称和局部命名空间。
- 方法
class MyClass:
    def method(self):
        pass

print(MyClass.method.__qualname__)  # 输出: MyClass.method
对于类方法,__qualname__包含了类名和方法名。
- 嵌套类
class Outer:
    class Inner:
        def method(self):
            pass

    print(Inner.method.__qualname__)  # 输出: Outer.Inner.method
    print(Inner.__qualname__)  # 输出: Outer.Inner

print(Outer.__qualname__)  # 输出: Outer
对于嵌套类中的方法和类本身,__qualname__包含了完整的模块和类层次结构。
__qualname__属性在调试、日志记录和自省等场景中非常有用。
它提供了一种简单的方式来获取对象的完整路径,而无需手动构造字符串。这使得代码更加清晰和可维护。
5. __init_subclass__的作用理解。(见名知意)
6. 对于如下代码:为什么要执行super().__init_subclass__(**kwargs)这一行代码?
class BaseClass:
    def __init_subclass__(subclass, **kwargs):
        super().__init_subclass__(**kwargs)
        print(f"New subclass {subclass.__name__} was created.")
        subclass.custom_attribute = 42

class SubClass(BaseClass):
    pass

# 输出: New subclass SubClass was created.

print(SubClass.custom_attribute)  # 输出: 42
在Python中, __init_subclass__ 是一个特殊的类方法,它会在一个类被继承时自动触发。
这个方法允许你在一个新的子类被创建时执行一些额外的初始化操作。
在你提供的代码示例中,super().__init_subclass__(**kwargs)这一行是为了调用基类(object)中的 __init_subclass__ 方法。
如果不调用这个方法, 就无法保证基类中定义的 __init_subclass__ 方法能够正常执行。
让我们来看一个具体的例子,说明为什么需要调用 super().__init_subclass__(**kwargs) 这一行。
首先,我们定义一个基类 Base,它有一个 __init_subclass__ 方法,用于在创建子类时打印一条消息:
class Base:
    def __init_subclass__(cls, **kwargs):
        print(f"Initializing subclass {cls.__name__}")
        super().__init_subclass__(**kwargs)
现在,我们创建两个子类,一个子类正确调用了 super().__init_subclass__(**kwargs),另一个则没有:
class GoodSub(Base):
    def __init_subclass__(cls, **kwargs):
        print(f"Initializing {cls.__name__}")
        super().__init_subclass__(**kwargs)

class BadSub(Base):
    def __init_subclass__(cls, **kwargs):
        print(f"Initializing {cls.__name__}")
当我们实例化这两个子类时,输出如下:
>>> GoodSub()
Initializing subclass GoodSub
Initializing GoodSub

>>> BadSub()
Initializing BadSub
你可以看到,对于 GoodSub 类,由于它正确地调用了 super().__init_subclass__(**kwargs),基类 Base 中的 __init_subclass__ 方法也被正确执行了,打印出了 "Initializing subclass GoodSub" 这条消息。
但是对于 BadSub 类,由于它没有调用 super().__init_subclass__(**kwargs),基类 Base 中的 __init_subclass__ 方法就没有被执行,因此没有打印出 "Initializing subclass BadSub" 这条消息。
这个例子说明,如果不调用 super().__init_subclass__(**kwargs),基类中定义的 __init_subclass__ 方法就不会被执行,这可能会导致一些必要的初始化操作被忽略,从而引发潜在的错误或异常行为。
因此,为了确保继承机制能够正常工作,并且基类中定义的 __init_subclass__ 方法能够被正确执行,在子类中定义 __init_subclass__ 方法时,务必要调用 super().__init_subclass__(**kwargs)。
7. 注释类型"NoReturn"的理解
NoReturn 是 Python 3.5 中引入的一种新的类型注解,主要用于标记那些永远不会返回的函数或方法。这种函数通常会抛出异常或进入无限循环,从而使程序永远无法执行函数之后的代码。
为什么需要 NoReturn?
在 Python 之前的版本中,这种永远不会返回的函数只能在类型注解中使用 None 来表示。但是这样做存在一些问题:
None通常表示函数可能返回None,容易造成歧义。- 如果函数确实返回
None,类型检查器就无法区分这两种情况了。
引入 NoReturn 可以更清晰地标记出这种永远不会返回的函数,避免了上述歧义问题。
NoReturn 在代码中的应用
NoReturn 通常应用于以下几种场景:
- 抛出异常的函数
这类函数通过抛出异常来终止执行,显然不会有任何返回值。例如:
from typing import NoReturn

def invalid_operation(value: int) -> NoReturn:
    if value < 0:
        raise ValueError("Value cannot be negative")
    raise RuntimeError("Invalid operation")
- 调用系统退出函数
如果函数调用了系统退出函数(如 sys.exit()),那么它也不会返回任何值。
- 进入无限循环
如果函数陷入了无限循环,那么它也永远不会返回。
- 递归调用导致栈溢出
对于一些编写不当的递归函数,递归调用可能会导致栈溢出,从而无法返回。
NoReturn 的使用示例
下面是一个使用 NoReturn 的示例:
import sys
from typing import NoReturn

def exit_program(status: int) -> NoReturn:
    """退出程序并返回指定的状态码"""
    sys.exit(status)

def divide(a: int, b: int) -> float:
    if b == 0:
        exit_program(1)  # 执行永不返回的函数
    return a / b

print(divide(10, 2))  # 输出: 5.0
print(divide(10, 0))  # 程序退出,无输出
在这个例子中:
exit_program函数调用了sys.exit(),因此它被标注为返回NoReturn。divide函数在除数为 0 时调用了exit_program。由于exit_program永不返回,divide函数在这种情况下也不会返回任何值。
使用 NoReturn 可以让代码更加清晰明了,同时也让类型检查器能够更好地检查类型错误。它提高了代码的可读性和可维护性。
8. 解释为什么有了not callable(constructor)后还需要检测constructor is type(None)?
class Field:
    def __init__(self, name: str, constructor: Callable) -> None:  # <2>
        if not callable(constructor) or constructor is type(None):  # <3> ??
            raise TypeError(f'{name!r} type hint must be callable')
        self.name = name
        self.constructor = constructor

    def __set__(self, instance: Any, value: Any) -> None:
        if value is ...:  # <4>
            value = self.constructor()
        else:
            try:
                value = self.constructor(value)  # <5>
            except (TypeError, ValueError) as e:  # <6>
                type_name = self.constructor.__name__
                msg = f'{value!r} is not compatible with {self.name}:{type_name}'
                raise TypeError(msg) from e
        instance.__dict__[self.name] = value  # <7>
虽然 None 不是可调用对象,所以 not callable(None) 为 True, 但是 type(None) 是可调用的,(callable(type(None)) 返回True) 因为它是一个类型对象,可以被用来实例化新的对象。
因此,仅检测 not callable(constructor) 是不够的,还需要单独检测 constructor is type(None) 的情况。
这样做是为了防止将 type(None) 作为 constructor 传入,因为这会导致一些潜在的问题。
例如,如果我们将 type(None) 作为 constructor,那么在调用 self.constructor() 时就会创建一个新的 NoneType 对象,而不是返回 None。这种情况通常是不符合预期的,因此需要单独处理。
9. 熟悉下字典dict.pop()的API使用
d = {'name': 'jordan', 'height': 198, 'jump': 120}

print(d.pop('jump1', 'wtf')) # 'jump1不在dict.keys()中,所以返回候补'wtf''
print(d)

print(d.pop('jump', ...)) # 'jump在dict.keys()中,所以直接返回其对应值120'
print(d)
返回结果
wtf
{'name': 'jordan', 'height': 198, 'jump': 120}
120
{'name': 'jordan', 'height': 198}
10. _fields(cls)不是类方法吗,为什么能够for name in self._fields()当作实例方法去调用?[from checkedlib.py]
from collections.abc import Callable  # <1>
from typing import Any, NoReturn, get_type_hints


class Field:
    def __init__(self, name: str, constructor: Callable) -> None:  # <2>
        if not callable(constructor) or constructor is type(None):  # <3>
            raise TypeError(f'{name!r} type hint must be callable')
        self.name = name
        self.constructor = constructor

    def __set__(self, instance: Any, value: Any) -> None:
        if value is ...:  # <4>
            value = self.constructor()
        else:
            try:
                value = self.constructor(value)  # <5>
            except (TypeError, ValueError) as e:  # <6>
                type_name = self.constructor.__name__
                msg = f'{value!r} is not compatible with {self.name}:{type_name}'
                raise TypeError(msg) from e
        instance.__dict__[self.name] = value  # <7>
class Checked:
    @classmethod
    def _fields(cls) -> dict[str, type]:  # <1>
        return get_type_hints(cls)

    def __init_subclass__(subclass) -> None:  # <2>
        super().__init_subclass__()           # <3>
        for name, constructor in subclass._fields().items():   # <4>
            setattr(subclass, name, Field(name, constructor))  # <5>

    def __init__(self, **kwargs: Any) -> None:
        for name in self._fields():  ???           # <6>
            value = kwargs.pop(name, ...)       # <7> 这里吐出来value, 是为了让输入的参数,绑定到实例上作为对应属性上做准备,你看下一步就是settattr()
            setattr(self, name, value)          # <8>
        if kwargs:                              # <9>
            self.__flag_unknown_attrs(*kwargs)  # <10>
很细很好的疑问。_fields() 确实是一个类方法,但在 __init__ 方法中,它是通过 self._fields() 来调用的。
这看起来似乎不正确,因为类方法应该使用 Person._fields() 这样的形式来调用。
事实上,在 Python 中,当我们在实例方法中调用类方法时,Python 会自动将实例 self 的类作为第一个参数传递给类方法。
因此,self._fields() 实际上等同于 Person._fields()。这是 Python 的一种语法糖,让我们可以在实例方法中直接调用类方法,而不需要显式地传递类作为第一个参数。
所以,在 __init__ 方法中,for name in self._fields(): 这一行代码实际上是在遍历 Person._fields() 返回的字典的键,即字段名。
总结一下:
- 在实例方法中调用类方法
self._fields()是合法的,Python 会自动将实例的类作为第一个参数传递给类方法。
11. 追问:
在Checked类中,为什么如下代码还要写super().__init_subclass__呢?
其实Checked类没有继承其他父类,它默认的父类是object,难道object里面也有__init_subclass__这个方法吗?
def __init_subclass__(subclass) -> None: # <2>
  super().__init_subclass__()  # 这里的super调用的Checked的父类obejct, 而不是subclass的父类,请注意
  ......
非常好的问题。即便 Checked 类没有直接继承任何其他类,它默认继承自 object 类,而 object 类确实有一个 __init_subclass__ 方法,这是一种良好的编程风格。
在 Python 3 中,__init_subclass__ 是一个特殊的类方法,它会在一个新的子类被创建时自动调用。
它的主要目的是允许元类或父类在子类被创建时执行一些初始化操作或修改子类的行为。
object 类中的 __init_subclass__ 方法是一个空操作,它什么也不做。源码如下:
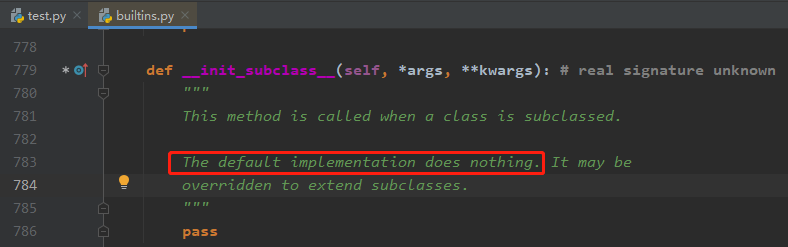
但是,如果我们在自己的类中重写了 __init_subclass__ 方法,就需要调用 super().__init_subclass__() 来确保父类的 __init_subclass__ 方法也能被正确执行。
在 Checked 类中,我们重写了 __init_subclass__ 方法,用于在创建子类时自动添加 Field 实例作为类属性。
因此,我们需要调用 super().__init_subclass__() 来确保 object 类的 __init_subclass__ 方法也能正常执行。
虽然在这个特定的例子中,object 类的 __init_subclass__ 方法是一个空操作,但是遵循这个习惯是一个好的做法。
这样可以确保即使在将来 object 类的实现发生变化,或者 Checked 类继承自其他具有 __init_subclass__ 方法的父类时,代码仍然能正常工作。
总的来说,调用 super().__init_subclass__() 是一种良好的编程实践,它可以确保父类的初始化代码能够正确执行,并且使代码更加健壮和可维护。
即使在没有直接继承任何其他类的情况下,也应该遵循这个习惯。
12. 追问:[from checkedlib.py]
我不太理解:"如果 name 是一个有效的字段名,那么通过 getattr(cls, name) 获取该字段对应的 Field 实例,然后调用 Field.__set__(self, value) 方法来设置该字段的值。"??
为什么getattr()能够获取该字段的Field实例,getattr()到底输入输出分别是什么,请举例说明
from collections.abc import Callable  # <1>
from typing import Any, NoReturn, get_type_hints


class Field:
    def __init__(self, name: str, constructor: Callable) -> None:  # <2>
        if not callable(constructor) or constructor is type(None):  # <3>
            raise TypeError(f'{name!r} type hint must be callable')
        self.name = name
        self.constructor = constructor

    def __set__(self, instance: Any, value: Any) -> None:
        if value is ...:  # <4>
            value = self.constructor()
        else:
            try:
                value = self.constructor(value)  # <5>
            except (TypeError, ValueError) as e:  # <6>
                type_name = self.constructor.__name__
                msg = f'{value!r} is not compatible with {self.name}:{type_name}'
                raise TypeError(msg) from e
        instance.__dict__[self.name] = value  # <7>
# end::CHECKED_FIELD[]

# tag::CHECKED_TOP[]
class Checked:
    @classmethod
    def _fields(cls) -> dict[str, type]:  # <1>
        return get_type_hints(cls)

    def __init_subclass__(subclass) -> None:  # <2>
        super().__init_subclass__()           # <3>
        for name, constructor in subclass._fields().items():   # <4>
            setattr(subclass, name, Field(name, constructor))  # <5>

    def __init__(self, **kwargs: Any) -> None:
        for name in self._fields():             # <6>
            value = kwargs.pop(name, ...)       # <7>
            setattr(self, name, value)          # <8>
        if kwargs:                              # <9>
            self.__flag_unknown_attrs(*kwargs)  # <10>

    # end::CHECKED_TOP[]

    # tag::CHECKED_BOTTOM[]
    def __setattr__(self, name: str, value: Any) -> None:  # <1>
        if name in self._fields():              # <2>
            cls = self.__class__
            descriptor = getattr(cls, name)  # ??
            descriptor.__set__(self, value)     # <3>
        else:                                   # <4>
            self.__flag_unknown_attrs(name)
一个非常好的问题,让我来详细解释一下 getattr(cls, name) 是如何获取该字段对应的 Field 实例的。
在这段代码中,cls 指的是当前实例所属的类,而 name 是字段名。getattr(cls, name) 的作用是从 cls 中获取名为 name 的属性的值。
让我们用一个具体的例子来说明:
class Person(Checked):
    name: str
    age: int

person = Person(name='Alice', age=30)
person.age = 35
当执行 person.age = 35 时,会触发 Person.__setattr__('age', 35)。
在 __setattr__ 方法中,我们有以下代码:
if name in self._fields():
    cls = self.__class__
    descriptor = getattr(cls, name)
    descriptor.__set__(self, value)
在这个例子中:
self是person实例。name是字符串'age'。self._fields()返回一个字典{'name': str, 'age': int}。cls是Person类本身。getattr(cls, name)实际上是getattr(Person, 'age')。
现在,让我们回顾一下 Person 类是如何被创建的:
class Person(Checked):
    name: str
    age: int
在 Checked 类的 __init_subclass__ 方法中,我们有以下代码:
def __init_subclass__(subclass) -> None:
    super().__init_subclass__()
    for name, constructor in subclass._fields().items():
        setattr(subclass, name, Field(name, constructor))
这段代码会在创建 Person 类时,为每个字段 name 设置一个 Field 实例作为类属性。
也就是说, Person 类中会有两个属性 name 和 age, 它们的值分别是 Field('name', str) 和 Field('age', int)。
因此,当我们执行 getattr(Person, 'age') 时,它会返回 Person 类中名为 'age' 的属性的值,也就是 Field('age', int) 这个实例。
最后,我们调用 descriptor.__set__(self, value),其中 descriptor 就是 Field('age', int) 实例,它会执行 Field.__set__ 方法来正确地设置 person 实例的 age 属性。
总结一下,
getattr(cls, name) 的作用是从 cls 中获取名为 name 的属性的值。
在这个例子中,由于我们在创建 Person 类时,为每个字段都设置了一个 Field 实例作为类属性,
因此 getattr(cls, name) 实际上返回了该字段对应的 Field 实例。
这使得我们可以调用 Field.__set__ 方法来正确地设置实例属性的值。
13. 追问
请问对于如下代码,
_asdict()方法中,为什么后面要写if isinstance(attr, Field)?请举出个例子,能用到这个语句的时候
from collections.abc import Callable  # <1>
from typing import Any, NoReturn, get_type_hints


class Field:
    def __init__(self, name: str, constructor: Callable) -> None:  # <2>
        if not callable(constructor) or constructor is type(None):  # <3>
            raise TypeError(f'{name!r} type hint must be callable')
        self.name = name
        self.constructor = constructor

    def __set__(self, instance: Any, value: Any) -> None:
        if value is ...:  # <4>
            value = self.constructor()
        else:
            try:
                value = self.constructor(value)  # <5>
            except (TypeError, ValueError) as e:  # <6>
                type_name = self.constructor.__name__
                msg = f'{value!r} is not compatible with {self.name}:{type_name}'
                raise TypeError(msg) from e
        instance.__dict__[self.name] = value  # <7>
# end::CHECKED_FIELD[]

# tag::CHECKED_TOP[]
class Checked:
    @classmethod
    def _fields(cls) -> dict[str, type]:  # <1>
        return get_type_hints(cls)

    def __init_subclass__(subclass) -> None:  # <2>
        super().__init_subclass__()           # <3>
        for name, constructor in subclass._fields().items():   # <4>
            setattr(subclass, name, Field(name, constructor))  # <5>

    def __init__(self, **kwargs: Any) -> None:
        for name in self._fields():             # <6>
            value = kwargs.pop(name, ...)       # <7>
            setattr(self, name, value)          # <8>
        if kwargs:                              # <9>
            self.__flag_unknown_attrs(*kwargs)  # <10>

    # end::CHECKED_TOP[]

    # tag::CHECKED_BOTTOM[]
    def __setattr__(self, name: str, value: Any) -> None:  # <1>
        if name in self._fields():              # <2>
            cls = self.__class__
            descriptor = getattr(cls, name)
            descriptor.__set__(self, value)     # <3>
        else:                                   # <4>
            self.__flag_unknown_attrs(name)

    def __flag_unknown_attrs(self, *names: str) -> NoReturn:  # <5>
        plural = 's' if len(names) > 1 else ''
        extra = ', '.join(f'{name!r}' for name in names)
        cls_name = repr(self.__class__.__name__)
        raise AttributeError(f'{cls_name} object has no attribute{plural} {extra}')

    def _asdict(self) -> dict[str, Any]:  # <6>
        return {
            name: getattr(self, name)
            for name, attr in self.__class__.__dict__.items()
            if isinstance(attr, Field) # ???作用理解
        }

    def __repr__(self) -> str:  # <7> # ???作用理解
        kwargs = ', '.join(
            f'{key}={value!r}' for key, value in self._asdict().items()
        )
        return f'{self.__class__.__name__}({kwargs})'
if isinstance(attr, Field) 这个条件语句的作用是过滤出当前类中所有属性值为 Field 实例的属性。它是在 _asdict 方法中用来生成一个字典,其中键为属性名,值为对应属性的值。
让我们通过一个具体的例子来说明为什么需要这个条件语句。
假设我们有一个 Person 类继承自 Checked,它有两个字段 name 和 age,以及一个普通的方法 greet。
class Person(Checked):
    name: str
    age: int

    def greet(self):
        return f"Hello, my name is {self.name}"
在创建 Person 类的过程中,Checked 类的 __init_subclass__ 方法会为 name 和 age 字段分别创建一个 Field 实例作为类属性。
同时,greet 方法也会作为一个普通的函数对象存在于 Person 类的 __dict__ 中。
现在,如果我们调用 person._asdict(),其目的是获取一个包含所有字段及其值的字典。
如果没有 if isinstance(attr, Field) 这个条件语句,_asdict 方法会将 Person 类中所有的属性都包括进来,包括 greet 方法。
person = Person(name='Alice', age=30)
print(person._asdict())  # 输出: {'name': 'Alice', 'age': 30, 'greet': <function Person.greet at 0x7f9b0c0d8dc0>}
显然,这个结果并不符合我们的预期,因为我们只想获取字段的值,而不包括方法或其他属性。
通过添加 if isinstance(attr, Field) 这个条件语句,_asdict 方法只会包括那些值为 Field 实例的属性,也就是 name 和 age 字段。
print(person._asdict()) # 输出: {'name': 'Alice', 'age': 30}
这样,我们就可以正确地获取实例的所有字段及其值,而不会受到其他属性的干扰。
总的来说,if isinstance(attr, Field) 这个条件语句是为了过滤出当前类中所有属性值为 Field 实例的属性,从而确保 _asdict 方法只返回字段及其值的字典表示。
这种过滤机制可以避免将不相关的属性包括在内,使得结果更加精确和符合预期。
14. 追问:13问的上述代码中,__repr__方法的具体作用理解
    def __repr__(self) -> str:  # <7> # ???作用理解
        kwargs = ', '.join(
            f'{key}={value!r}' for key, value in self._asdict().items()
        )
        return f'{self.__class__.__name__}({kwargs})'
__repr__ 方法是 Python 中用于生成对象的字符串表示形式的特殊方法。
当您在控制台中输入一个对象时,或者将对象传递给 repr() 函数时,Python 会自动调用该对象的 __repr__ 方法,并将返回值作为对象的字符串表示形式。
在这个例子中,__repr__ 方法的作用是为继承自 Checked 类的实例生成一个易于阅读和调试的字符串表示形式。
让我们来看一个具体的例子:
class Person(Checked):
    name: str
    age: int

person = Person(name='Alice', age=30)
print(repr(person))
如果没有自定义的 __repr__ 方法,打印 repr(person) 的结果可能看起来像这样:
<__main__.Person object at 0x7f9b0c0d8e80>
这种表示形式虽然包含了对象的类型和内存地址,但是对于理解对象的实际内容并不太有帮助。
现在,让我们来看一下自定义的 __repr__ 方法是如何工作的:
def __repr__(self) -> str:
    kwargs = ', '.join(
        f'{key}={value!r}' for key, value in self._asdict().items()
    )
    return f'{self.__class__.__name__}({kwargs})'
- 首先,它调用
self._asdict()方法获取一个包含所有字段及其值的字典。 - 然后,它使用一个生成器表达式,将每个键值对转换为
key=value的字符串形式,其中value部分使用了!r转换为可打印的字符串表示形式。 - 接着,它使用
join方法将所有这些字符串连接起来,用逗号分隔。 - 最后,它返回一个字符串,其格式为
<类名>(<键值对字符串>)。
对于我们之前的 Person 实例,打印 repr(person) 的结果将是:
Person(name='Alice', age=30) # 这样阅读起来就可读性很高了,比较友好
这种表示形式清楚地显示了对象的类型、字段名称以及每个字段的值,对于调试和理解对象的状态非常有用。
总的来说,__repr__ 方法的作用是提供一种更加易读和信息丰富的字符串表示形式,以便更好地理解和调试对象的状态。
它通过利用 _asdict 方法获取字段信息,并将其格式化为一个友好的字符串,从而增强了对象的可读性和可调试性。
15. 综合上述信息,我想问下为什么
Person类只要继承了Checked后就能够写成如下带注释的形式?而不会报错
class Person(Checked):
    name: str
    age: int
而不是按照我的直觉,写成传统的如下形式?
class Person(Checked):

    def __init__(self, name:str, age:int):
        self.name = name
        self.age = age
一个非常好的问题。事实上,Person类可以以注释的形式定义name和age属性,而不需要显式地编写__init__方法,这归功于Python的一个特性,叫做类型注释(Type Hints)。
在Python 3中,我们可以使用类型注释来指定变量、函数参数和返回值的类型。虽然这些类型注释不会直接影响程序的运行,但它们可以提供很多好处,比如:
- 代码可读性:类型注释使代码更具可读性,开发人员可以更容易地理解每个变量、参数和返回值的预期类型。
- 类型检查:Python开发者社区提供了一些静态类型检查工具,如
mypy和pylint,可以根据类型注释进行静态分析,检查代码中潜在的类型错误。 - IDE支持:大多数现代IDE和文本编辑器都支持类型注释,可以提供更好的自动补全、重构和导航功能。
现在,回到您的问题。之所以Person类可以以注释的形式定义name和age属性,是因为我们使用了Checked这个元类。在Checked类的__init_subclass__方法中,我们有这样一段代码:
def __init_subclass__(subclass) -> None:
    super().__init_subclass__()
    for name, constructor in subclass._fields().items():
        setattr(subclass, name, Field(name, constructor))
这段代码会自动为subclass(即Person类)中的每个类型注释创建一个对应的Field实例,并将其作为类属性添加到subclass中。
所以,当我们定义class Person(Checked): name: str age: int时,Checked元类会自动为name和age创建Field实例,并将它们作为类属性添加到Person类中。
这些Field实例会在实例化Person对象时自动处理属性的初始化和类型检查。我们不需要显式地编写__init__方法,因为Checked类的__init_subclass__方法已经为我们处理了实例化的过程。
总的来说,通过利用类型注释和元类编程,Checked类为我们提供了一种更加简洁和类型安全的方式来定义带有字段的类,而无需显式编写__init__方法。
这不仅提高了代码的可读性,还增强了类型安全性,并利用了Python的一些高级特性。
16. 还是综合上述的所有代码,为什么class Field的__set__方法中,为何
要这样写raise TypeError(msg) from e? from e是为何?另外为什么是TypeError, 而不是ValueError(msg)呢?
class Field:
    def __init__(self, name: str, constructor: Callable) -> None:  # <2>
        if not callable(constructor) or constructor is type(None):  # <3>
            raise TypeError(f'{name!r} type hint must be callable')
        self.name = name
        self.constructor = constructor

    def __set__(self, instance: Any, value: Any) -> None:
        if value is ...:  # <4>
            value = self.constructor()
        else:
            try:
                value = self.constructor(value)  # <5>
            except (TypeError, ValueError) as e:  # <6>
                type_name = self.constructor.__name__
                msg = f'{value!r} is not compatible with {self.name}:{type_name}'
                raise TypeError(msg) from e  # ???
        instance.__dict__[self.name] = value  # <7>
这是一个很好的问题,让我们逐一解释一下:
raise TypeError(msg) from e中的from e部分:
在Python 3中,raise ... from ...语法被引入,用于在重新引发异常时,将原始异常信息附加到新异常上。这样做的目的是为了更好地诊断和调试异常。
在Field.__set__方法中,我们尝试使用self.constructor(value)来构造一个新值。如果self.constructor在处理value时引发了TypeError或ValueError,我们会捕获这个异常,
并使用raise TypeError(msg) from e重新引发一个新的TypeError。from e的作用是将原始异常e的跟踪信息附加到新的TypeError上,以便更好地诊断问题的根源。
- 为什么使用
TypeError而不是ValueError?
Field.__set__方法的目的是确保实例属性的值符合该字段的类型提示(type hint)。如果self.constructor(value)引发了TypeError或ValueError,这通常意味着value的类型或值不符合self.constructor的预期。
TypeError通常表示传递给函数或操作的参数类型不正确。而ValueError则表示传递的参数值不被允许。
在这种情况下,使用TypeError更合适,因为我们实际上是在检查value的类型是否与字段的类型提示相符。如果不符合,就认为是一个类型错误。
如果换成使用ValueError(msg)的话,虽然也可以工作,但语义上就不太准确了,因为我们主要关注的是类型问题,而不是值本身的合法性。
总的来说,raise TypeError(msg) from e这一行代码的作用是:捕获self.constructor(value)可能引发的TypeError或ValueError异常,
并重新引发一个新的TypeError异常,同时保留原始异常的跟踪信息,以便更好地诊断和调试问题。使用TypeError而不是ValueError是因为我们主要关注的是值的类型是否符合预期,而不是值本身的合法性。
17. 追问:为什么如下代码要写成repr(self.__class__.__name__)? 直接写成self.__class__.name__呢?
def __flag_unknown_attrs__(self, *names: str) -> NoReturn:
    plural = 's' if len(names) > 1 else ''
    extra = ', '.join(f'{name!r}' for name in names)
    cls_name = repr(self.__class__.__name__)
    raise AttributeError(f'{cls_name} object has no attribute{plural} {extra}')
在Python中, __name__ 是一个特殊的属性,它返回类或函数的名称作为一个字符串。而 repr(obj) 函数会返回一个对象的字符串表示形式,该字符串应该是一个有效的Python表达式,可以用来重新构造该对象。
在这个特定的代码中,使用 repr(self.__class__.__name__) 而不是直接使用 self.__class__.__name__ 是为了确保在任何情况下,类名的字符串表示形式都是合法的Python标识符。
想象一下,如果某个继承自 Checked 类的子类的名称包含了一些特殊字符,比如空格或者连字符等,那么直接使用 self.__class__.__name__ 可能会导致生成的错误消息字符串不是一个有效的Python语法。
例如,如果有一个名为 "My Class" 的类,直接使用 self.__class__.__name__ 会生成类似 "My Class object has no attribute..." 这样的错误消息,这在Python中是无效的语法。
但是,如果使用 repr(self.__class__.__name__)则会生成 "'My Class'" 这样的字符串表示形式,这是一个有效的Python字符串常量,可以被Python正确解析。
因此,通过使用 repr 函数,无论类名包含什么字符,生成的错误消息字符串都会是一个合法的Python表达式,可以确保在任何情况下都能正确显示错误信息。
这种做法体现了一种谨慎和安全的编程实践,即使在极端或异常情况下,代码也能保持健壮和正确的行为。虽然在大多数情况下,直接使用 self.__class__.__name__ 也可以工作,但使用 repr 函数可以更好地处理边缘情况,提高代码的鲁棒性。
示例1: 类名为普通标识符
假设我们有一个名为 Person 的类,继承自 Checked:
class Person(Checked):
    name: str
    age: int

person = Person()

# 尝试访问不存在的属性
person.unknown_attr
在这种情况下,使用 self.__class__.__name__ 和 repr(self.__class__.__name__) 都可以正常工作:
- 使用
self.__class__.__name__:
def __flag_unknown_attrs(self, *names: str) -> NoReturn:
    plural = 's' if len(names) > 1 else ''
    extra = ', '.join(f'{name!r}' for name in names)
    cls_name = self.__class__.__name__
    raise AttributeError(f'{cls_name} object has no attribute{plural} {extra}')
输出:
AttributeError: Person object has no attribute 'unknown_attr'
- 使用
repr(self.__class__.__name__):
def __flag_unknown_attrs(self, *names: str) -> NoReturn:
    plural = 's' if len(names) > 1 else ''
    extra = ', '.join(f'{name!r}' for name in names)
    cls_name = repr(self.__class__.__name__)
    raise AttributeError(f'{cls_name} object has no attribute{plural} {extra}')
输出:
AttributeError: 'Person' object has no attribute 'unknown_attr'
在这个例子中,两种方式的输出都是合法的Python语法,并且能够正确地显示错误信息。
18. 在如下代码中,为什么checked()函数中要有这么一行?cls._fields = classmethod(_fields),不转化成类方法就不行吗? [from checkdeco.py]
from collections.abc import Callable  # <1>
from typing import Any, NoReturn, get_type_hints


class Field:
    def __init__(self, name: str, constructor: Callable) -> None:  # <2>
        if not callable(constructor) or constructor is type(None):
            raise TypeError(f'{name!r} type hint must be callable')
        self.name = name
        self.constructor = constructor

    def __set__(self, instance: Any, value: Any) -> None:  # <3>
        if value is ...:  # <4>
            value = self.constructor()
        else:
            try:
                value = self.constructor(value)  # <5>
            except (TypeError, ValueError) as e:
                type_name = self.constructor.__name__
                msg = (
                    f'{value!r} is not compatible with {self.name}:{type_name}'
                )
                raise TypeError(msg) from e
        instance.__dict__[self.name] = value  # <6>


def checked(cls: type) -> type:  # <1>
    for name, constructor in _fields(cls).items():  # <2>
        setattr(cls, name, Field(name, constructor))  # <3>

    cls._fields = classmethod(_fields)  # type: ignore  # <4>  ???

    instance_methods = (  # <5>
        __init__,
        __repr__,
        __setattr__,
        _asdict,
        __flag_unknown_attrs,
    )
    for method in instance_methods:  # <6>
        setattr(cls, method.__name__, method)

    return cls  # <7>


def _fields(cls: type) -> dict[str, type]:
    return get_type_hints(cls)


def __init__(self: Any, **kwargs: Any) -> None:
    for name in self._fields():
        value = kwargs.pop(name, ...)
        setattr(self, name, value)
    if kwargs:
        self.__flag_unknown_attrs(*kwargs)


def __setattr__(self: Any, name: str, value: Any) -> None:
    if name in self._fields():
        cls = self.__class__
        descriptor = getattr(cls, name)
        descriptor.__set__(self, value)
    else:
        self.__flag_unknown_attrs(name)


def __flag_unknown_attrs(self: Any, *names: str) -> NoReturn:
    plural = 's' if len(names) > 1 else ''
    extra = ', '.join(f'{name!r}' for name in names)
    cls_name = repr(self.__class__.__name__)
    raise AttributeError(f'{cls_name} has no attribute{plural} {extra}')


def _asdict(self: Any) -> dict[str, Any]:
    return {
        name: getattr(self, name)
        for name, attr in self.__class__.__dict__.items()
        if isinstance(attr, Field)
    }


def __repr__(self: Any) -> str:
    kwargs = ', '.join(
        f'{key}={value!r}' for key, value in self._asdict().items()
    )
19. 在如下代码中,为什么要有这行 if '__slots__' not in cls_dict: ??? [from metaclass/checklib.py]
class CheckedMeta(type):

    def __new__(meta_cls, cls_name, bases, cls_dict):  # <1>
        if '__slots__' not in cls_dict:  # <2>
            slots = []
            type_hints = cls_dict.get('__annotations__', {})  # <3>
            for name, constructor in type_hints.items():   # <4>
                field = Field(name, constructor)  # <5>
                cls_dict[name] = field  # <6>
                slots.append(field.storage_name)  # <7>

            cls_dict['__slots__'] = slots  # <8>

        return super().__new__(
                meta_cls, cls_name, bases, cls_dict)  # <9>
好的,我用代码举例说明为什么需要检查 __slots__ 的存在以避免无限递归。
假设我们有以下代码:
class CheckedMeta(type):
    def __new__(meta_cls, cls_name, bases, cls_dict):
        # 不检查 __slots__ 的存在
        slots = []
        type_hints = cls_dict.get('__annotations__', {})
        for name, constructor in type_hints.items():
            field = Field(name, constructor)
            cls_dict[name] = field
            slots.append(field.storage_name)

        cls_dict['__slots__'] = slots

        return super().__new__(meta_cls, cls_name, bases, cls_dict)

class MyClass(metaclass=CheckedMeta):
    __slots__ = ('x', 'y')  # 类本身已经定义了 __slots__
    x: int
    y: str
在这个例子中,我们自定义了一个 CheckedMeta 元类,它会自动为一个类添加 __slots__ 属性。然而,在元类的 __new__ 方法中,我们没有检查 __slots__ 是否已经存在。
当解释器尝试创建 MyClass 时,会发生以下情况:
- 解释器发现
MyClass使用了自定义元类CheckedMeta - 解释器调用
CheckedMeta.__new__方法来创建MyClass - 在
CheckedMeta.__new__中,由于没有检查__slots__的存在,它会为MyClass添加一个新的__slots__ [见下面补充追问] - 由于
MyClass已经定义了__slots__,当解释器尝试为它添加新的__slots__时,它会再次调用CheckedMeta.__new__方法 CheckedMeta.__new__方法再次为MyClass添加一个新的__slots__- 重复第 4 步和第 5 步,导致无限递归,程序崩溃
为了避免这种情况,我们需要在 CheckedMeta.__new__ 方法中检查 __slots__ 是否已经存在:
class CheckedMeta(type):
    def __new__(meta_cls, cls_name, bases, cls_dict):
        if '__slots__' not in cls_dict:  # 检查 __slots__ 的存在
            slots = []
            type_hints = cls_dict.get('__annotations__', {})
            for name, constructor in type_hints.items():
                field = Field(name, constructor)
                cls_dict[name] = field
                slots.append(field.storage_name)

            cls_dict['__slots__'] = slots

        return super().__new__(meta_cls, cls_name, bases, cls_dict)
现在,当解释器尝试创建 MyClass 时,由于 MyClass 已经定义了 __slots__,CheckedMeta.__new__ 方法会跳过对 __slots__ 的处理,从而避免了无限递归。
通过这个例子,你可以看到,如果不检查 __slots__ 的存在,就会导致无限递归,从而导致程序崩溃。检查 __slots__ 的存在是非常重要的,可以避免这种无限递归的情况发生。
20. 追问:为什么由于 MyClass 已经定义了 __slots__,当解释器尝试为它添加新的 __slots__ 时,它会再次调用 CheckedMeta.__new__ 方法??
让我详细解释一下为什么定义了__slots__会导致再次调用元类的__new__方法。
当一个类定义了__slots__属性时,Python解释器会做一些特殊处理。
具体来说,在创建该类的实例时,解释器会首先调用该类对应的元类(默认为type)的__new__方法来创建该类对象本身。
在我们的例子中,MyClass使用了自定义元类CheckedMeta。因此,当Python解释器尝试创建MyClass类对象时,它会调用CheckedMeta.__new__方法。
在CheckedMeta.__new__方法中,我们没有检查__slots__的存在,就直接为MyClass添加了一个新的__slots__属性。
然而,由于MyClass本身已经定义了__slots__,这会导致Python解释器认为该类的__slots__发生了改变。
当一个类的__slots__发生改变时,Python解释器必须重新创建该类对象,以确保__slots__的正确性。
为了创建新的类对象,解释器会再次调用该类对应的元类的__new__方法,也就是我们的CheckedMeta.__new__方法。
这就形成了一个无限递归循环:
- 解释器调用
CheckedMeta.__new__创建MyClass对象 CheckedMeta.__new__为MyClass添加新的__slots__- 由于
MyClass已经定义了__slots__,解释器认为__slots__发生了改变 - 解释器再次调用
CheckedMeta.__new__重新创建MyClass对象 - 重复步骤2、3、4,形成无限递归
这个无限递归循环会一直持续下去,直到程序耗尽资源崩溃。
所以,为了避免这种情况,我们需要在CheckedMeta.__new__方法中检查__slots__是否已经存在。
如果已经存在,就不应该再次为该类添加__slots__,从而避免无限递归。
21. 在如下代码中,为什么有slots = () 就能够实现skip CheckedMeta.__new__ processing,??
class Checked(metaclass=CheckedMeta):
    __slots__ = ()  # skip CheckedMeta.__new__ processing  ?????

    @classmethod
    def _fields(cls) -> dict[str, type]:
        return get_type_hints(cls)

    def __init__(self, **kwargs: Any) -> None:
        for name in self._fields():
            value = kwargs.pop(name, ...)
            setattr(self, name, value)
        if kwargs:
            self.__flag_unknown_attrs(*kwargs)

    def __flag_unknown_attrs(self, *names: str) -> NoReturn:
        plural = 's' if len(names) > 1 else ''
        extra = ', '.join(f'{name!r}' for name in names)
        cls_name = repr(self.__class__.__name__)
        raise AttributeError(f'{cls_name} object has no attribute{plural} {extra}')

    def _asdict(self) -> dict[str, Any]:
        return {
            name: getattr(self, name)
            for name, attr in self.__class__.__dict__.items()
            if isinstance(attr, Field)
        }

    def __repr__(self) -> str:
        kwargs = ', '.join(
            f'{key}={value!r}' for key, value in self._asdict().items()
        )
        return f'{self.__class__.__name__}({kwargs})'
在这段代码中, __slots__ = () 确实可以跳过 CheckedMeta.__new__ 方法的执行。
这是因为在元类的 __new__ 方法中,它会检查类字典(cls_dict)中是否存在 __slots__ 键:
class CheckedMeta(type):
    def __new__(meta_cls, cls_name, bases, cls_dict):
        if '__slots__' not in cls_dict:  # 检查__slots__的存在
            # ... 处理__slots__的代码
        # ...
如果 __slots__ 已经存在于类字典中,那么元类的 __new__ 方法就不会执行处理 __slots__ 的代码部分。
当我们在 Checked 类中定义 __slots__ = ()时,它会将一个空元组赋值给 __slots__ 属性,这个属性就会存在于类字典中。
因此,当 Python 解释器尝试创建 Checked 类时,它会检测到 __slots__ 已经存在,从而跳过 CheckedMeta.__new__ 方法中处理 __slots__ 的代码部分。
通过这种方式,我们可以避免元类对 Checked 类的 __slots__ 进行任何修改。这在某些情况下是有用的,比如当你想手动控制 __slots__ 的内容时。
需要注意的是,虽然 __slots__ = () 可以跳过 CheckedMeta.__new__ 方法中的 __slots__ 处理,但它并不会完全阻止元类的执行。
元类的其他部分,比如最后一行 return super().__new__(meta_cls, cls_name, bases, cls_dict) 仍然会执行。
所以,__slots__ = () 这行代码的作用是:在使用 CheckedMeta 元类时,保留手动控制 __slots__ 的能力,而不受元类的自动处理影响。但是,元类的其他部分仍然会对类进行定制。
22. 为什么__init_subclass__ 不能配置 __slots__?
好的, 我会尽量通俗易懂地解释为什么__init_subclass__不能配置__slots__。
首先,我们需要理解__init_subclass__和__slots__分别是什么。
__init_subclass__是一个特殊的类方法,在创建新的子类时被调用。它允许开发者在子类创建时执行一些自定义操作。
而__slots__是一个特殊的类属性,用于限制该类的实例属性,提高内存利用率。
那么,为什么__init_subclass__不能配置__slots__呢? 原因在于它们的执行时机不同。
想象一下,你经营一家餐馆,你需要为新员工发放工作服。__init_subclass__就相当于你在面试新员工时,先问一些问题,了解他们的情况。而__slots__则相当于在新员工正式入职后,根据他们的职位发放对应的工作服。
很明显,你必须先让新员工入职,才能为他们发放工作服。如果你在面试环节就想为他们配置工作服,那是行不通的,因为他们还没有正式成为你的员工。
同理,__init_subclass__是在创建新的子类时执行的, 而__slots__则是在创建该类的实例时才会生效。
如果你试图在__init_subclass__中配置__slots__,它会被无视,因为在那个阶段,Python还没有处理到__slots__。
让我们看一个具体的例子:
class Base:
    def __init_subclass__(cls, **kwargs):
        super().__init_subclass__(**kwargs)
        cls.__slots__ = ('x', 'y')  # 这行代码不会生效

class Derived(Base):
    x: int
    y: str

d = Derived()
d.z = 3  # 这行代码不会报错
在这个例子中,我们尝试在__init_subclass__中配置__slots__。然而,当我们创建Derived类的实例时,并为其添加一个z属性,Python并没有抛出任何错误。这说明__slots__根本没有生效。
原因就在于,__init_subclass__执行的时机太早了,它在创建子类时就已经执行,而__slots__则要等到创建实例时才会生效。所以,__init_subclass__中对__slots__的配置根本不会被Python所采纳。
如果你想正确配置__slots__,应该在类定义中直接设置,或者使用元类在类创建时动态添加__slots__。只有这样,__slots__才能在创建实例时生效。
总之,__init_subclass__和__slots__的执行时机不同,导致了前者无法配置后者的原因。要正确配置__slots__,必须在类创建的更晚阶段进行。
23. 类里面的.__dict__属性和实例的.__dict__属性有什么异同?
类的__dict__属性和实例的__dict__属性虽然都是字典,但有一些重要的区别:
类的__dict__属性:
- 存储该类的所有属性(包括方法)。
- 在创建类时就会被定义和填充。
- 对于所有该类的实例,它是共享的。也就是说,所有实例都可以访问和修改类的
__dict__。 - 可以通过
ClassName.__dict__访问。
实例的__dict__属性:
- 用于存储该实例的数据属性。
- 在创建实例时才会被定义和填充。
- 每个实例都有自己独立的
__dict__。 - 可以通过
instance.__dict__访问。 - 如果实例的类定义了
__slots__属性,则实例不会有__dict__属性(除非显式添加__dict__到__slots__中)。
让我们通过一个具体例子来说明它们的异同:
class MyClass:
    x = 1  # 类属性

    def __init__(self):
        self.y = 2  # 实例属性

print(MyClass.__dict__)
# Output: {'__module__': '__main__', 'x': 1, '__init__': <function MyClass.__init__ at 0x7f9e1c8d5820>, '__dict__': <attribute '__dict__' of 'MyClass' objects>, '__weakref__': <attribute '__weakref__' of 'MyClass' objects>, '__doc__': None}

obj = MyClass()
print(obj.__dict__)
# Output: {'y': 2}
在上面的例子中:
MyClass.__dict__包含了类的所有属性,包括类属性x和方法__init__。obj.__dict__只包含实例属性y。
我们还可以通过修改__dict__来添加新的属性:
MyClass.z = 3  # 添加类属性
obj.__dict__['a'] = 4  # 添加实例属性

print(MyClass.__dict__)
# Output: {'__module__': '__main__', 'x': 1, '__init__': <function MyClass.__init__ at 0x7f9e1c8d5820>, '__dict__': <attribute '__dict__' of 'MyClass' objects>, '__weakref__': <attribute '__weakref__' of 'MyClass' objects>, '__doc__': None, 'z': 3}

print(obj.__dict__)
# Output: {'y': 2, 'a': 4}
总的来说,
类的__dict__存储类属性和方法,是所有实例共享的;
而实例的__dict__存储该实例的数据属性,每个实例都有自己独立的__dict__。
如果类定义了__slots__,实例就不会有自己的__dict__(除非__dict__被显式添加到__slots__中)。
24. 追问:类的__dict__存储类属性和方法, 是所有实例共享的?如何通过代码证明
一个很好的问题。我们可以通过以下代码来证明类的__dict__存储的类属性和方法确实是所有实例共享的:
class MyClass:
    x = 1

    def __init__(self):
        self.y = 2

    def my_method(self):
        pass

obj1 = MyClass()
obj2 = MyClass()

print(id(obj1.__dict__))
print(id(obj2.__dict__))
# 输出两个不同的ID,证明每个实例的__dict__是独立的

print(id(MyClass.__dict__))
# 记录下类的__dict__的ID

print(id(obj1.__class__.__dict__))
print(id(obj2.__class__.__dict__))
# 输出两次,与类的__dict__ID相同,证明所有实例共享同一个类的__dict__
输出:
140135911796224
140135911802880
140134971398008
140134971398008
140134971398008
在这段代码中:
- 我们定义了一个
MyClass类,包含一个类属性x、一个实例属性y和一个方法my_method。 - 创建两个实例
obj1和obj2。 - 分别打印
obj1.__dict__和obj2.__dict__的ID,结果显示它们的ID不同,说明每个实例的__dict__是独立的。 - 打印
MyClass.__dict__的ID,记录下来。 - 分别打印
obj1.__class__.__dict__和obj2.__class__.__dict__的ID, 结果与MyClass.__dict__的ID相同,证明它们共享同一个类的__dict__。
从输出可以看出,虽然每个实例的__dict__是独立的,但它们共享同一个类的__dict__。也就是说,类的__dict__存储的类属性和方法是所有实例共享的。
这样做的好处是可以节省内存。如果每个实例都有自己独立的类属性和方法副本,会浪费大量内存空间。通过共享类的__dict__,所有实例可以访问相同的类属性和方法,从而提高了内存利用率。
25. 为什么instance 为None的时候就要返回None, 这样做的目的是为了什么?
from collections.abc import Callable
from typing import Any, NoReturn, get_type_hints

class Field:
    def __init__(self, name: str, constructor: Callable) -> None:
        if not callable(constructor) or constructor is type(None):
            raise TypeError(f'{name!r} type hint must be callable')
        self.name = name
        self.storage_name = '_' + name  # <1>
        self.constructor = constructor

    def __get__(self, instance, owner=None):
        if instance is None:  # <2>  ???
            return self
        return getattr(instance, self.storage_name)  # <3>

    def __set__(self, instance: Any, value: Any) -> None:
        if value is ...:
            value = self.constructor()
        else:
            try:
                value = self.constructor(value)
            except (TypeError, ValueError) as e:
                type_name = self.constructor.__name__
                msg = f'{value!r} is not compatible with {self.name}:{type_name}'
                raise TypeError(msg) from e
        setattr(instance, self.storage_name, value)  # <4>


class CheckedMeta(type):

    def __new__(meta_cls, cls_name, bases, cls_dict):  # <1>
        if '__slots__' not in cls_dict:  # <2>
            slots = []
            type_hints = cls_dict.get('__annotations__', {})  # <3>
            for name, constructor in type_hints.items():   # <4>
                field = Field(name, constructor)  # <5>
                cls_dict[name] = field  # <6>
                slots.append(field.storage_name)  # <7>

            cls_dict['__slots__'] = slots  # <8>

        return super().__new__(
                meta_cls, cls_name, bases, cls_dict)  # <9>


class Checked(metaclass=CheckedMeta):
    __slots__ = ()  # skip CheckedMeta.__new__ processing

    @classmethod
    def _fields(cls) -> dict[str, type]:
        return get_type_hints(cls)

    def __init__(self, **kwargs: Any) -> None:
        for name in self._fields():
            value = kwargs.pop(name, ...)
            setattr(self, name, value)
        if kwargs:
            self.__flag_unknown_attrs(*kwargs)

    def __flag_unknown_attrs(self, *names: str) -> NoReturn:
        plural = 's' if len(names) > 1 else ''
        extra = ', '.join(f'{name!r}' for name in names)
        cls_name = repr(self.__class__.__name__)
        raise AttributeError(f'{cls_name} object has no attribute{plural} {extra}')

    def _asdict(self) -> dict[str, Any]:
        return {
            name: getattr(self, name)
            for name, attr in self.__class__.__dict__.items()
            if isinstance(attr, Field)
        }

    def __repr__(self) -> str:
        kwargs = ', '.join(
            f'{key}={value!r}' for key, value in self._asdict().items()
        )
        return f'{self.__class__.__name__}({kwargs})'
在描述符的 __get__ 方法中,当 instance 为 None 时返回自身(self)是一种特殊的行为,目的是为了支持类属性访问。
在 Python 中,访问实例属性和类属性的语法是不同的:
- 访问实例属性:
instance.attr - 访问类属性:
Class.attr
当通过 instance.attr 的方式访问实例属性时,Python 会自动传递 instance 作为第一个参数。
但是当通过 Class.attr 的方式访问类属性时,Python 并不会传递实例,而是传递 None 作为第一个参数。
因此,在描述符的 __get__ 方法中,当 instance 为 None 时,表示正在访问类属性。这时,如果直接返回描述符实例本身(self),就可以支持类属性访问。
例如,如果我们有以下代码:
class MyClass:
    attr = Field('attr', int)

print(MyClass.attr)  # 访问类属性
obj = MyClass()
print(obj.attr)  # 访问实例属性
当执行 MyClass.attr 时,Python 会调用 Field.__get__(None, MyClass)。由于 instance 为 None,描述符返回自身(self)。这就允许我们直接访问类属性,得到 Field 实例。
而当执行 obj.attr 时,Python 会调用 Field.__get__(obj, MyClass)。由于 instance 不为 None,描述符会返回存储在实例字典中的实际值。
通过这种方式,同一个描述符可以支持类属性访问和实例属性访问,从而使代码更加简洁和一致。如果不返回 self,就无法支持类属性访问,只能访问实例属性。
所以,在描述符的 __get__ 方法中,if instance is None: return self 这一行代码的目的就是为了支持类属性访问的特殊情况。
26. 关于__init_subclass__的调用时机理解
class Parent:
    def __init_subclass__(cls):
        print(f"Parent.__init_subclass__() called for {cls}")


class Child(Parent): # <1> [继承关系]定义子类时候,此时此刻会调用__init_subclass__
    pass

# 当 Child 类被定义时,__init_subclass__ 并未被调用
# Child()

# 当 Child 类的实例被创建时,__init_subclass__ 并未被调用
# child = Child()

# 当 Child 类继承自另一个子类时,__init_subclass__ 被调用 【还可以被子类的子类,多层衍生类调用】
class GrandChild(Child): # <2>
    pass

# 当 GrandChild 类被定义时,__init_subclass__ 并未被被调用
# GrandChild()
返回结果如下:
Parent.__init_subclass__() called for <class '__main__.Child'> # 对应<1>

Parent.__init_subclass__() called for <class '__main__.GrandChild'> # 对应<2>
26. 24.8.3 元类求解时间实验 [很绕很多细节,一定要理解这个evaldemo_meta.py执行返回结果顺序] [from buliderlib.py, metalib.py, evaldemo_meta.py]
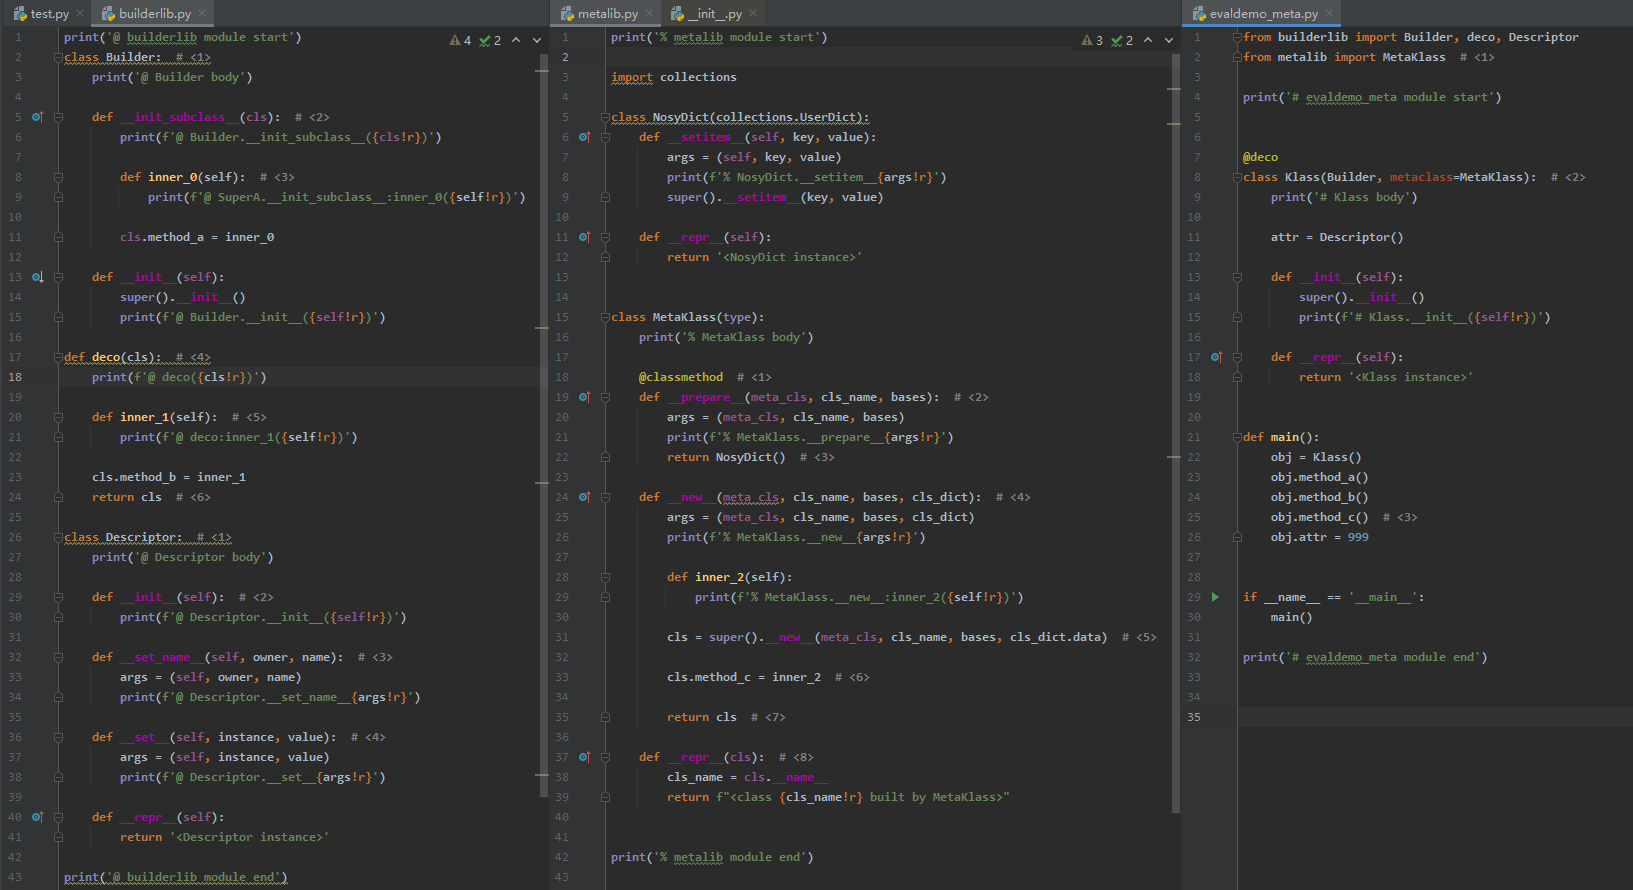
执行后的输出顺序如下:
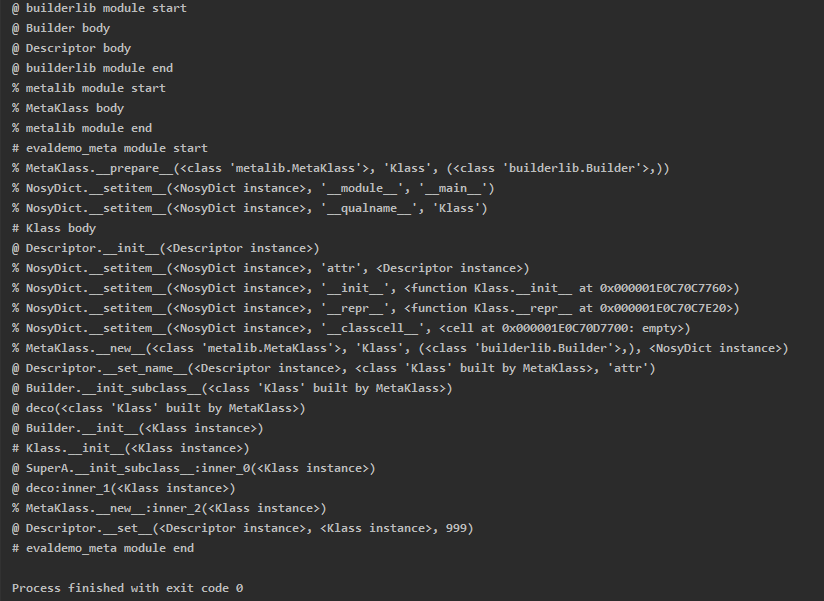
下面详细逐个解释, 该返回内容和顺序的由来.
@ builderlib module start
@ Builder body
@ Descriptor body
@ builderlib module end
- 执行
builderlib.py模块,打印语句'@ builderlib module start'。 - 定义
Builder类时,执行print('@ Builder body')语句。 - 定义
Descriptor类时,执行print('@ Descriptor body')语句。 builderlib.py模块执行结束,打印语句'@ builderlib module end'。
% metalib module start
% MetaKlass body
% metalib module end
- 执行
metalib.py模块,打印语句'% metalib module start'。 - 定义
MetaKlass类时,执行print('% MetaKlass body')语句。 metalib.py模块执行结束,打印语句'% metalib module end'。
# evaldemo_meta module start
执行evaldemo_meta.py模块, 打印语句'# evaldemo_meta module start'。
前面的输出语句都比较容易理解, 关键是从这里开始往后输出的语句的理解.
先要记住一个总体执行顺序: Metaclass[元类] --> Builder[继承] --> deco[装饰器]
还有就是先定义子类Klass, 然后再创建该子类的实例. [定义和创建是分成2个阶段]
% MetaKlass.__prepare__(<class 'metalib.MetaKlass'>, 'Klass', (<class 'builderlib.Builder'>,))
- 这一行输出是由
MetaKlass的__prepare__方法触发的[最先执行元类的这个方法]。当定义Klass类时,Python会先调用元类(MetaKlass)的__prepare__方法,用于准备类的命名空间(即属性字典)。 - 因此,这一行输出的原因是
MetaKlass的__prepare__方法中的print语句执行。
% NosyDict.__setitem__(<NosyDict instance>, '__module__', '__main__')  # 这两行输出,可以理解通用性的输出内容.
% NosyDict.__setitem__(<NosyDict instance>, '__qualname__', 'Klass')
- 这两行输出是由
MetaKlass的__prepare__方法返回的NosyDict实例触发的。 - 在定义
Klass类时,Python会将类的一些特殊属性(__module__和__qualname__)设置到命名空间(即NosyDict实例)中, 因此会调用NosyDict实例的__setitem__方法,并打印相应的语句。
# Klass body
这一行输出是在定义Klass类体时执行的print语句。
@ Descriptor.__init__(<Descriptor instance>)
这一行输出是由创建Descriptor实例时触发的。在Klass类体中, 定义了一个名为attr的Descriptor实例,因此会调用Descriptor类的__init__方法,并打印相应的语句。
% NosyDict.__setitem__(<NosyDict instance>, 'attr', <Descriptor instance>)
% NosyDict.__setitem__(<NosyDict instance>, '__init__', <function Klass.__init__ at 0x000001E0C70C7760>)
% NosyDict.__setitem__(<NosyDict instance>, '__repr__', <function Klass.__repr__ at 0x000001E0C70C7E20>)
% NosyDict.__setitem__(<NosyDict instance>, '__classcell__', <cell at 0x000001E0C70D7700: empty>)  # 这一行也可以理解为, 通用性的输出内容
- 这几行输出也是由
NosyDict实例的__setitem__方法触发的。 - 在定义
Klass类时,Python会将类的属性和方法设置到命名空间(即NosyDict实例)中, 因此会调用NosyDict实例的__setitem__方法, 并打印相应的语句。
% MetaKlass.__new__(<class 'metalib.MetaKlass'>, 'Klass', (<class 'builderlib.Builder'>,), <NosyDict instance>)
@ Descriptor.__set_name__(<Descriptor instance>, <class 'Klass' built by MetaKlass>, 'attr')
@ Builder.__init_subclass__(<class 'Klass' built by MetaKlass>)
这个顺序的原因如下:
% MetaKlass.__new__(...)这一行是在定义Klass类时, Python调用元类MetaKlass的__new__方法来创建Klass类对象时触发的输出。- 在
MetaKlass的__new__方法内部,它会执行以下步骤: a. 先调用超类(type)的__new__方法来真正创建Klass类对象。 b. 然后处理Klass类定义体中的语句,包括执行attr = Descriptor()语句。 - 当执行
attr = Descriptor()语句时,会创建一个Descriptor实例, 并将其绑定到Klass类的attr属性上。为了正确绑定,Python会自动调用Descriptor实例的__set_name__方法, 传入Klass类对象和属性名'attr'作为参数,因此触发了@ Descriptor.__set_name__(...)输出。 - 接下来,由于
Klass类继承自Builder类,Python会自动调用Builder类的__init_subclass__方法, 并将newly创建的Klass类对象作为参数传入,因此触发了@ Builder.__init_subclass__(...)输出。
所以,输出的顺序是:
- 首先调用
MetaKlass.__new__方法来创建Klass类对象。 - 在
__new__方法内部,处理Klass类定义体中的语句,触发Descriptor.__set_name__输出。 - 由于
Klass继承自Builder,自动触发Builder.__init_subclass__输出。
这个顺序反映了Python在创建Klass类对象的过程中,执行各种方法和语句的顺序。
@ deco(<class 'Klass' built by MetaKlass>)
- 这一行输出是由
deco函数触发的。 - 由于
Klass类使用了@deco装饰器,因此在定义Klass类后, Python会自动调用deco函数,并将Klass类作为参数传入,因此会打印相应的语句。
@ Builder.__init__(<Klass instance>)  # 对应代码 obj = Klass() 产生的输出
# Klass.__init__(<Klass instance>)
- 这两行输出是由创建
Klass实例时触发的。 - 当创建
Klass实例时,Python会先调用Builder类的__init__方法,打印相应的语句;然后调用Klass类的__init__方法,也会打印相应的语句。
@ SuperA.__init_subclass__:inner_0(<Klass instance>) # 对应代码 obj.method_a() 产生的输出
- 这一行输出是由
Builder类的__init_subclass__方法中定义的inner_0函数触发的。 - 在创建
Klass实例时,会自动调用inner_0函数,并打印相应的语句。
@ deco:inner_1(<Klass instance>) # 对应代码 obj.method_b() 产生的输出
- 这一行输出是由
deco函数中定义的inner_1函数触发的。 - 由于
Klass类使用了@deco装饰器,因此在创建Klass实例时,也会自动调用inner_1函数,并打印相应的语句。
% MetaKlass.__new__:inner_2(<Klass instance>) # 对应代码 obj.method_c() 产生的输出
- 这一行输出是由
MetaKlass的__new__方法中定义的inner_2函数触发的。 - 在创建
Klass实例时,也会自动调用inner_2函数,并打印相应的语句。
@ Descriptor.__set__(<Descriptor instance>, <Klass instance>, 999) # 对应代码 obj.attr = 999 产生的输出
- 这一行输出是由对
Klass实例的attr属性赋值时触发的。 - 由于
attr是一个Descriptor实例,因此在对其赋值时,会自动调用Descriptor类的__set__方法,并打印相应的语句。
# evaldemo_meta module end
这一行输出只是表示evaldemo_meta.py模块执行结束。到此, 所有输出就完毕了.
27. 如何理解__setattr__的拦截/阻断作用
拦截的意思是,当你尝试设置一个对象的属性时,Python 不会直接在对象的 __dict__ 中添加或修改这个属性,
而是会首先调用 __setattr__ 方法。这样,你就有机会在属性实际被赋值之前进行检查、修改值或者执行其他逻辑。
下面是一个简单的例子,展示了如何使用 __setattr__ 来拦截属性的赋值操作:
class Person:
    def __setattr__(self, name, value):
        if name == 'age' and not (0 <= value <= 120):                # 这个if语句两行就起到了拦截的作用, 本来是直接要执行super().__setattr__(name, value)
            raise ValueError("Age must be between 0 and 120")
        super().__setattr__(name, value)

# 创建 Person 类的实例
person = Person()

# 尝试设置合法的年龄
person.age = 25  # 这会成功,因为 25 在 0 到 120 之间

# 尝试设置非法的年龄
try:
    person.age = 125  # 这会引发 ValueError,因为 125 不在 0 到 120 之间
except ValueError as e:
    print(e)  # 输出: Age must be between 0 and 120
在这个例子中,Person 类的 __setattr__ 方法拦截了对 age 属性的所有赋值操作,并检查了赋的值是否在 0 到 120 之间。
如果是非法值,它会抛出一个 ValueError。如果是合法值,它会通过 super().__setattr__(name, value) 调用父类的 __setattr__ 方法,这将实际执行赋值操作。
这种方法的好处是,它可以确保对象的属性值符合特定的规则或约束,从而维护对象的状态的一致性和合法性。
然而,它也可能带来性能开销,因为每次属性赋值都会调用 __setattr__ 方法。因此,如果自定义的 __setattr__ 方法中包含复杂的逻辑,它可能会影响对象的性能。
这就是为什么在某些情况下,如果可以使用 __slots__ 来限制属性赋值,可能会更有效率。
28. 如何理解如下这段话的第二点? [from 24.9 一点背景]
我们使用 __init_subclass__ 实现的 checkedlib.py 非常成
功,全公司都在用。任何时刻,生产服务器中都有上百万个
Checked 子类的实例驻留内存。
经过论证,我们发现使用 __slots__ 能减少云托管费用,原因有
以下两点。
1. 内存用量较少,各个 Checked 实例无须单独维护
__dict__。
2. 删除 __setattr__ 之后,性能更高。当初定义这个方法是为
了阻断预期之外的属性,但是实例化以及调用
Field.__set__ 之前所有的属性设置操作都触发该方法。
假设我们有一个类 Checked,我们希望通过 __setattr__ 方法来防止设置未预期的属性。这个类可能看起来像这样:
class Checked:
    def __setattr__(self, name, value):
        if name not in self.__dict__ and not hasattr(self, name):
            raise AttributeError(f"Attribute '{name}' is not allowed")
        super().__setattr__(name, value)
在这个类中,__setattr__ 方法会在每次尝试设置属性时被调用。它会检查这个属性是否已经存在于对象的 __dict__ 中,或者对象是否有这个属性。
如果都没有,它会抛出一个 AttributeError,从而防止设置未预期的属性。
现在,假设我们有一个 Field 类,它有一个 __set__ 方法,用于设置字段的值:
class Field:
    def __set__(self, instance, value):
        # 设置字段值的逻辑
        pass
如果我们有一个 Checked 的子类,它有一个 Field 类型的属性 field,
那么在实例化这个子类并设置 field 属性时,__setattr__ 方法会被调用两次:
一次是在设置 field 属性本身时,另一次是在调用 Field.__set__ 方法时。(后面追问详细解释)
class CheckedSubclass(Checked):
    field = Field()

instance = CheckedSubclass()
instance.field = value  # 这会调用两次__setattr__
这种情况下,__setattr__ 方法的额外调用是不必要的,因为它只是在检查是否允许设置 field 属性,而这个检查在第一次调用时已经完成了。
这会导致性能开销,因为我们每次设置属性时都要进行额外的检查。
通过使用 __slots__,我们可以避免这种性能开销。__slots__ 允许我们定义允许设置的属性名称,
这样 Python 解释器就可以直接为这些属性分配空间,而不需要使用 __dict__。
这意味着我们不再需要 __setattr__ 方法来防止设置未预期的属性,因为未列在 __slots__ 中的属性赋值会直接抛出 AttributeError。
class Checked:
    __slots__ = ('field')def __init__(self):
        self.field = None
在这个例子中,我们通过 __slots__ 明确地告诉 Python 解释器,Checked 类的实例只能有一个名为 field 的属性。
这样,我们就不再需要 __setattr__ 方法来防止设置未预期的属性,从而避免了不必要的性能开销。
总的来说,通过使用 __slots__ 并移除 __setattr__ 方法,我们可以减少在设置属性时的性能开销,
这对于有大量实例的类来说尤其重要,因为它可以显著减少在云托管环境中的费用。
29. 追问: 如何理解__setattr__ 方法会被调用两次:
一次是在设置 field 属性本身时,另一次是在调用 Field.__set__ 方法时。?
在 Python 中,当你对一个对象的属性进行赋值时,例如 instance.field = value,这个过程通常会触发对象的 __setattr__ 方法。如果你在类中自定义了 __setattr__ 方法,那么这个自定义方法将被调用。
现在,假设我们有一个 Field 类,它定义了一个 __set__ 方法,这个方法用于处理属性赋值。通常,这样的类设计是为了封装属性的设置逻辑,例如进行类型检查、范围验证等。
class Field:
    def __set__(self, instance, value):
        # 这里是属性赋值的逻辑
        pass
当我们有一个类 Checked,它自定义了 __setattr__ 方法,并且它有一个 Field 类型的属性时,情况就变得更加复杂了。例如:
class Checked:
    def __setattr__(self, name, value):
        print(f"Setting {name} to {value}")
        super().__setattr__(name, value)

class Field:
    def __set__(self, instance, value):
        print(f"Field __set__ called with value {value}")
        # 实际的设置逻辑
        instance.__dict__[name] = value

# 假设我们有一个 Checked 的子类,它有一个 Field 属性
class CheckedSubclass(Checked):
    field = Field()

# 现在实例化这个子类并设置 field 属性
instance = CheckedSubclass()
instance.field = 'value'
在这个例子中,当我们执行 instance.field = 'value' 时,会发生以下几步:
-
instance.field = 'value'这行代码首先会调用Checked类的__setattr__方法。这是因为我们对instance的field属性进行了赋值。 -
在
Checked类的__setattr__方法中,会调用super().__setattr__(name, value),这实际上是调用了父类的__setattr__方法,最终会调用object类的__setattr__方法,这个方法会将属性值存储在对象的__dict__中。 -
接着,
Field类的__set__方法会被调用。这是因为field属性本身是一个Field对象,我们对它进行了赋值,触发了它的__set__方法。 -
在
Field类的__set__方法中,我们通常会看到类似instance.__dict__[name] = value的代码,这实际上是对instance对象的__dict__进行了直接的赋值操作。
所以,__setattr__ 方法被调用了两次:
一次是在我们对 instance.field 进行赋值时,另一次是在 Field 类的 __set__ 方法内部对 instance.__dict__ 进行赋值时。
通过使用 __slots__,我们可以避免这种情况,因为 __slots__ 限制了对象可以拥有的属性,这样 Python 解释器就可以直接为这些属性分配空间,而不需要使用 __dict__。
这意味着我们不再需要自定义 __setattr__ 方法来防止设置未预期的属性,因为未列在 __slots__ 中的属性赋值会直接抛出 AttributeError。
这样,我们就可以避免 __setattr__ 方法的额外调用,从而提高性能。
30. 还有我不太理解你之前给的代码,
这个if语句if name not in self.__dict__ and not hasattr(self, name): 为什么已经判断了name not in self.__dict__, 还需要再判断not hasattr(self, name)? 这两个条件难道不是一样的么?
class Checked:
    def __setattr__(self, name, value):
        if name not in self.__dict__ and not hasattr(self, name):  # ???
            raise AttributeError(f"Attribute '{name}' is not allowed")
        super().__setattr__(name, value)
在 __setattr__ 方法中,if name not in self.__dict__ and not hasattr(self, name): 这行代码的确看起来有些多余,因为通常情况下,name not in self.__dict__ 和 not hasattr(self, name) 的检查结果应该是相同的。
hasattr 函数用于检查对象是否有指定的属性,它内部会尝试获取属性的值,如果属性不存在,则会抛出一个 AttributeError 异常。
而 name not in self.__dict__ 直接检查了对象的 __dict__ 字典中是否包含指定的属性名。
在大多数情况下,如果您在对象的 __dict__ 中没有找到某个属性名,那么 hasattr 也应该返回 False,因为 __dict__ 存储了对象的所有属性。
但是,有一种情况例外,那就是属性是通过描述符(descriptor)实现的,比如 property 或类定义中的 getter、setter 和 deleter。
描述符的属性不会直接存储在 __dict__ 中,而是通过描述符协议(__get__、__set__ 和 __delete__ 方法)来访问。
因此,hasattr 在检查属性是否存在时,会考虑到描述符的情况,而直接检查 __dict__ 则不会。这就是为什么在某些情况下,即使 __dict__ 中没有属性,hasattr 也可能返回 True。
如下这个里可以很好说明这个问题
class Descriptor:
    def __get__(self, instance, owner):
        print("__get__ called")

class MyClass:
    descriptor = Descriptor()

obj = MyClass()

print("__dict__:", obj.__dict__)  # 输出 {}
print("hasattr:", hasattr(obj, 'descriptor'))  # 输出 True
输出结果:
__dict__: {}
__get__ called
hasattr: True
在这个例子中,descriptor 属性并不存在于 obj 的 __dict__ 中,但它是通过描述符 Descriptor 实现的,因此 hasattr 返回 True。
class CheckedSubclass(Checked): field = Field()
instance = CheckedSubclass()instance.field = value # 这会调用两次__setattr__

 浙公网安备 33010602011771号