
RDD编程练习
一、filter,map,flatmap练习:
1.读文本文件生成RDD lines:
lines=sc.textFile("file:///usr/local/spark/mycode/rdd/word.txt")

2.将一行一行的文本分割成单词 words:
words = lines.flatMap(lambda line:line.split()).collect()

3.全部转换为小写:
words1=sc.parallelize(words)
sc.parallelize(words).pipe("tr 'A-Z' 'a-z'").collect()

4.去掉长度小于3的单词:
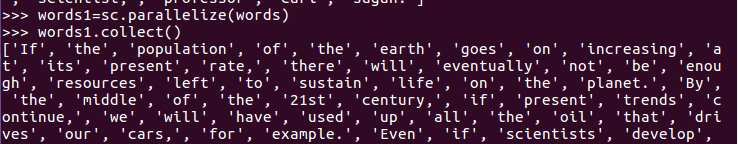
words1=sc.parallelize(words)
words1.collect()
words1.filter(lambda word:len(word)>3).collect()
5.去掉停用词:
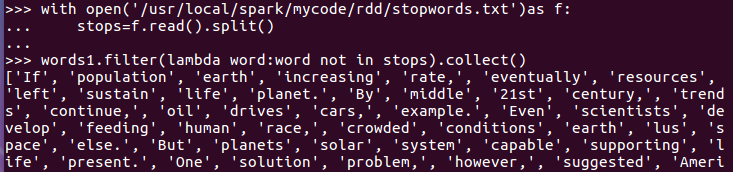
with open('/usr/local/spark/mycode/rdd/stopwords.txt')as f:
stops=f.read().split()
words1.filter(lambda word:word not in stops).collect()
二、groupByKey练习
6.练习一的生成单词键值对:
words = sc.parallelize([("Hadoop",1),("is",1),("good",1),("Spark",1),("is"),("fast",1),("Spark",1),("is",1),("better",1)])

7.对单词进行分组:
words1 = words.groupByKey()

8.查看分组结果:
words1.foreach(print)

学生科目成绩文件练习:
0.数据文件上传:
lines = sc.textFile('file:///usr/local/spark/mycode/rdd/chapter4-data01.txt')

1.读大学计算机系的成绩数据集生成RDD:
lines.take(5)

2.按学生汇总全部科目的成绩:
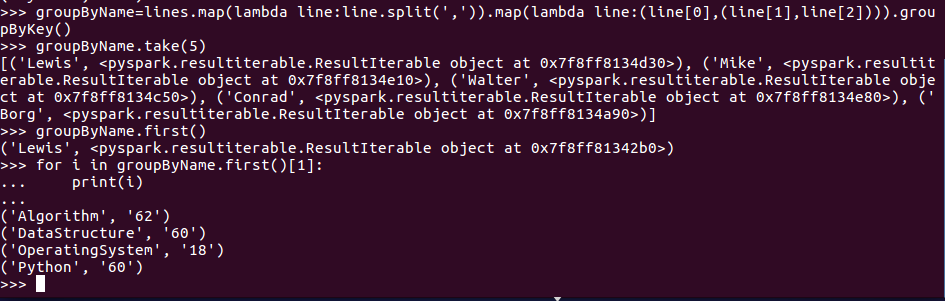
groupByName=lines.map(lambda line:line.split(',')).map(lambda line:(line[0],(line[1],line[2]))).groupByKey()
groupByName.take(5)
groupByName.first()
for i in groupByName.first()[1]:
print(i)
3.按科目汇总学生的成绩:
groupByCourse=lines.map(lambda line:line.split(',')).map(lambda line:(line[1],(line[0],line[2]))).groupByKey()
groupByCourse.first()
for i in groupByCourse.first()[1]:
print(i)


 浙公网安备 33010602011771号