
Cloudflare Python Workers 终于 GA:把 Python 塞进 WebAssembly 扔到全球边缘,我看到的甜点与坑
Cloudflare Python Workers 终于 GA:把 Python 塞进 WebAssembly 扔到全球边缘,我看到的甜点与坑
【关键词:#Cloudflare Workers #Python Serverless #边缘计算】
2026 年 9 月 21 日,Cloudflare 把 Python Workers 从 preview 拉到 GA——两年的预览期正式结束。我盯这个特性看了很久,它的实质是把 Pyodide(CPython 编译到 WebAssembly 的运行时)直接跑进 Cloudflare 边缘网络(300+ 城市)。不是"Cloudflare 也支持 Python 了"那么简单。甜点、坑、适用人群,下面分开讲。
01|为什么我盯了两年
边缘计算这两年最大的痛点:Lambda 只能在某区域跑,冷启动还要几秒。Cloudflare Workers 一直靠 V8 isolate(Chrome V8 引擎里的轻量沙箱,每个请求一个独立执行环境)把冷启动压到 50ms,但只支持 JS/TS。Python 程序员想在边缘跑代码,要么忍受 Lambda 的延迟,要么把 Python 编成 WASM 自己部署——两条路都不甜。
Cloudflare 在 2024 年开始 preview Python Workers,走的路线是 Pyodide + WebAssembly:让 CPython 直接跑在 V8 isolate 里,不走容器。这样三件事成立:
- 冷启动约 1 秒(带 Wasm 内存快照),比 Lambda 快一个量级,比 JS Worker 慢但 Python 业务够用。
- 部署到 300+ 边缘节点,请求在最近的节点执行,延迟结构上和传统 CDN 一致。
- 能直接调用 Workers AI(Cloudflare 边缘内置的 Llama、Embedding、图像识别模型),不用跳外部 API。
GA 意味着两件事:生产可用 + SLA 保证。Preview 阶段能用但没 SLA 兜底,GA 之后可以放核心业务。
02|它怎么工作的(一张图讲清楚)
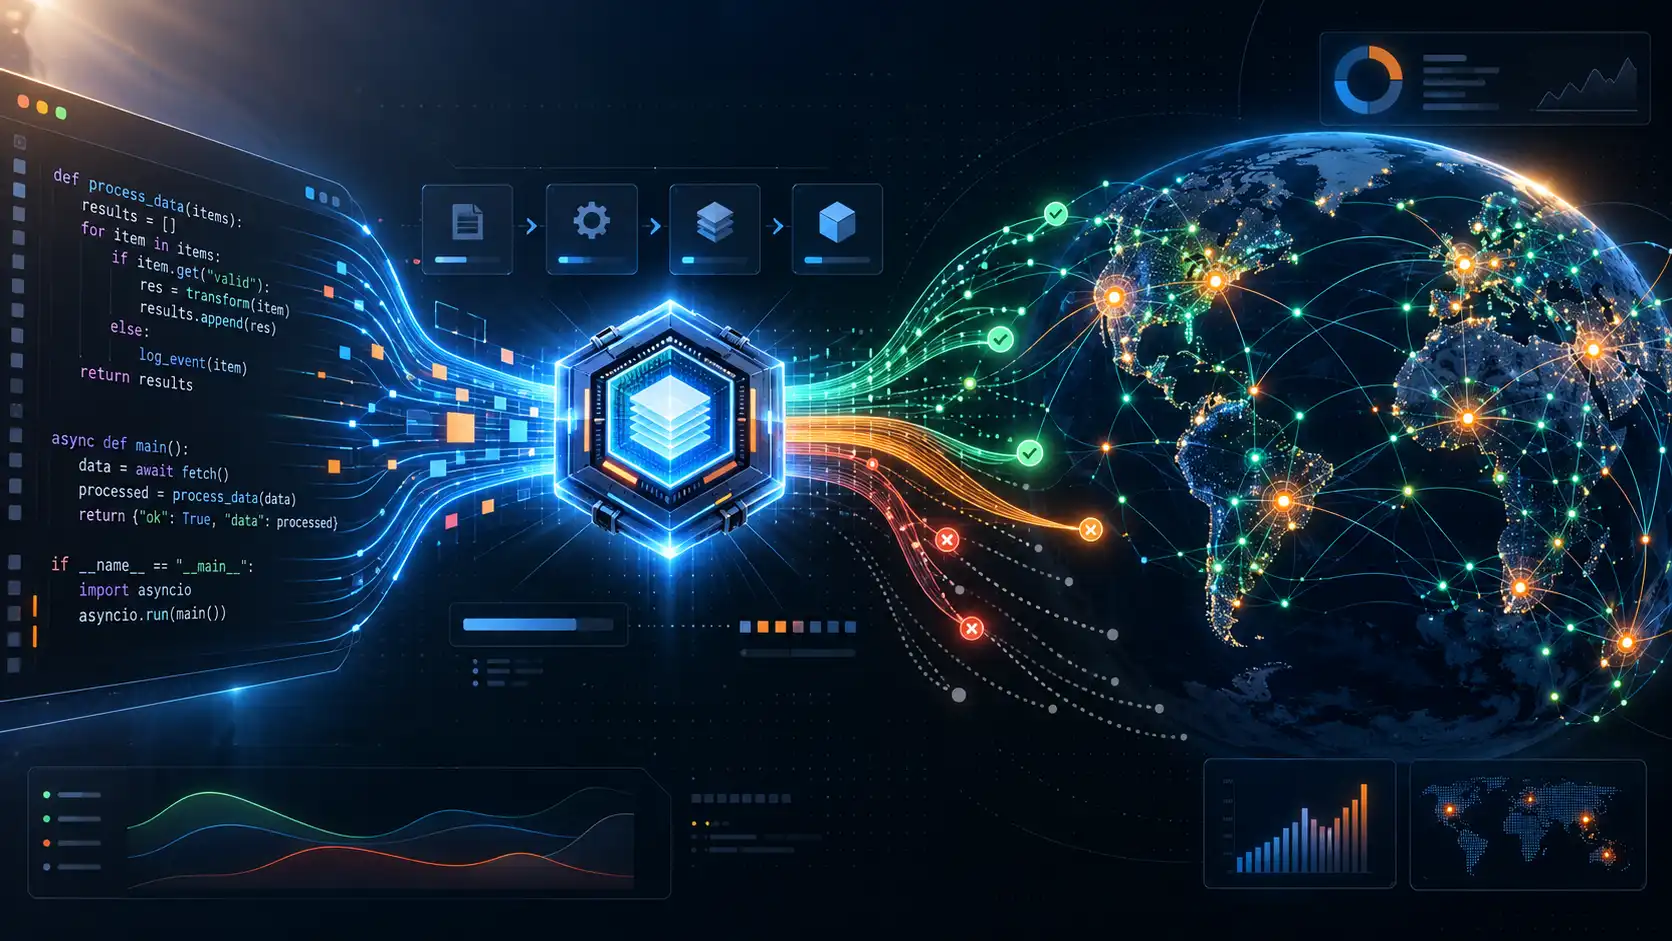
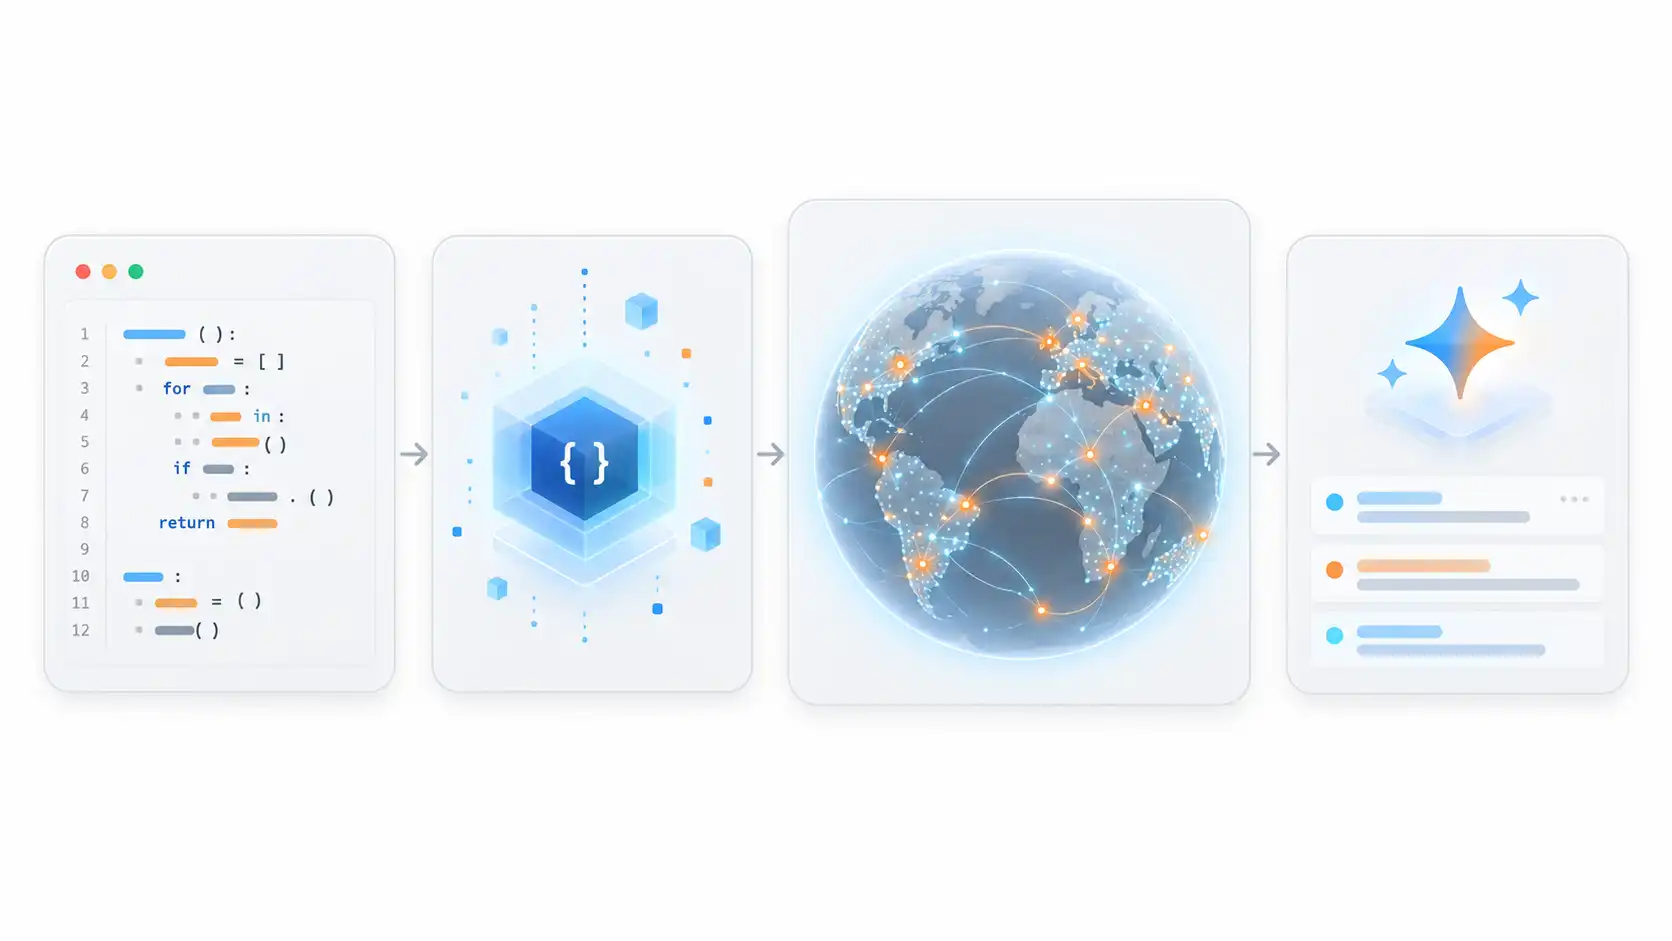
整个链路压缩成四步:
- 写代码:本地写
worker.py,用wrangler deploy部署。 - 打包:Cloudflare 把 .py 文件 + 依赖用 Pyodide 编成 WebAssembly 模块。
- 分发:WASM 模块推到 300+ 边缘节点的 isolate 池里。
- 执行:请求进来时,最近的节点拉起 isolate 跑你的 Python 函数,返回结果。
用一张图把这四步串起来:
三个关键技术细节别跳过:
- Pyodide 是核心——开源的 CPython → WASM 项目,Cloudflare 直接拿来当 Python 运行时,不用自己造轮子。
- V8 isolate 而不是容器——这是 Cloudflare 的招牌,每个请求一个隔离环境,启动几乎零开销,不会出现"邻居抢 CPU"那种传统云函数的问题。
- WASM 内存快照——Cloudflare 把常用 import 提前编译好缓存下来,下次启动直接复用,把冷启动从几秒压到 1 秒。
03|凭什么选它(甜点清单)
把 Cloudflare Python Workers 和 AWS Lambda、Cloudflare JS Worker 放一起对比,甜点集中在四件事:
- 边缘就近执行:300+ 城市,全球任意位置请求都在最近的节点跑完。Lambda 只能在某区域跑,Python Workers 是真的"去中心化"——对 API 网关、Webhook、地理路由这种延迟敏感的应用有结构性优势。
- AI 边缘推理的天然搭档:Workers AI 内置 Llama 3.1、Embedding、图像识别等模型,Python Worker 里直接
env.AI.run()调。这意味着写一个 Python Worker 就能跑完整的 RAG(检索增强生成)、文本分类、图像处理流水线,零外部依赖。 - 免 egress 流量费:免费额度 10 万次/天。Lambda 流量单独计费(egress 是出站流量费),对高流量 API 是真金白银的差距。
- Cloudflare 生态全家桶:KV(键值存储)、D1(SQLite)、R2(对象存储)、Durable Objects(有状态对象)、Queues(消息队列)—— 一个 Worker 就能攒出完整后端,不用拼凑 S3 + RDS + SQS + Lambda。
04|踩坑前必看(硬限制清单)
甜点之外,硬限制是真的硬。下面六条,按工程师最容易先撞上的顺序排:
- C 扩展必须用 PyEmscripten 重编:带 C/C++/Rust 扩展的包(polars、pyarrow、duckdb、geopandas)默认跑不起来,除非维护者发布 PyEmscripten(Cloudflare 推的 PEP 783 新 wheel 标准)的 WASM wheel。cibuildwheel 已经在支持,但生态还在慢慢填。
- 标准库被阉割:curses、dbm、fcntl、tkinter、venv 完全不可用;
threading/multiprocessing能 import 但 WebAssembly 单线程跑不起来。 - 异步-only 运行时:
requests这种同步库直接卡死事件循环,必须用httpx/aiohttp——这也是 FastAPI/Starlette 比 Flask 更搭的原因。 - 没有持久文件系统:只有内存临时文件系统,持久化靠 R2 / KV / D1。
- 内存快照的坑:部署时 top-level import 不能有副作用(不能 I/O、不能启动后台线程、不能 PRNG 播种),否则副作用会被"冻"进快照,部署后行为诡异。
- 冷启动 ~1 秒:比 JS Worker 的 50ms 慢一截,重度延迟敏感场景慎选。
外加一个不容忽视的运行时硬限:CPU 时间 免费 10s / 付费 5min。长任务别指望它。
05|官方演示:30 秒搭一个会说话的 AI Worker
光讲不动手,等于没讲。我从 Cloudflare 官方仓库 cloudflare/python-workers-examples 里挑了最有代表性的 workers-ai/ 例子——用 FastAPI 写一个 Python Worker,调用 Workers AI 大模型回答问题。整个流程跑一遍,甜点和坑都立刻有感觉。
第一步:装 pywrangler(GA 之后 Cloudflare 把 Python Worker 的 CLI 从 wrangler 拆出来,用 uv 装)
uv tool install pywrangler
第二步:写 src/entry.py
from fastapi import FastAPI, Request
from workers import asgi

app = FastAPI()

@app.get("/")
async def root(request: Request):
    env = request.scope["env"]
    result = await env.AI.run(
        "@cf/openai/gpt-oss-120b",
        {
            "instructions": "You are a friendly assistant.",
            "input": "What is the origin of the phrase Hello, World?",
        },
    )
    return result

Default = asgi.entrypoint(app)
第三步:配 wrangler.toml
name = "hello-python-worker"
main = "src/entry.py"
compatibility_flags = ["python_workers"]
compatibility_date = "2026-07-21"

[ai]
binding = "AI"
第四步:本地起 + 部署
uv run pywrangler dev       # 本地起 http://localhost:8787
uv run pywrangler deploy    # 推到 Cloudflare 边缘
跑起来访问根路径,Workers AI 会调 @cf/openai/gpt-oss-120b 大模型返回 Hello World 的来历——请求落在离你最近的边缘节点,Python 写、AI 推理也跑在边缘、没有外部 OpenAI key 依赖。
这段官方示例把第 03 节的甜点全兑现了:
- FastAPI 写法跟本地开发一模一样——不用学新框架,迁移成本接近零
- AI 推理直接走
env.AI.run(),不用自己申请 OpenAI key asgi.entrypoint(app)一行把 FastAPI 桥到 Workers runtime——这就是官方推荐的 Hybrid 模式- 部署到边缘后,300+ 节点任意位置就近执行,egress 流量免费
但你也立刻能看到第 04 节的坑:
- 顶层 import 不能有副作用(如果加了 logging 配置 / 启动后台线程就会被打进快照)
- 必须用异步(
async def),requests.get()那种同步调用直接卡死 - 模型 ID 写死在
@cf/openai/gpt-oss-120b这种 Cloudflare 命名空间里——想换 OpenAI / Anthropic 还是得走外部 API
仓库里还有 D1 / R2 / KV / Durable Objects 的完整 examples,建议一次性 clone 下来跑一遍,30 分钟就能把 Cloudflare Python Workers 的能力边界摸清楚。
06|Python Workers 在架构里的位置
我会用 Python Workers 跑的场景:
- 边缘 AI 推理 / RAG 检索增强
- API 网关、请求改写、A/B 切流
- Webhook 接收 + 数据清洗 + 入库
- 短链服务、表单处理、图片缩略图
- Cloudflare 生态内的胶水代码
留给 Lambda 或别的工具的场景:
- 重度 C 扩展的科学计算(polars / pyarrow 生态还不成熟)
- 长任务(CPU 上限免费 10s / 付费 5min)
- 同步阻塞型库(requests、psycopg2 同步版)
- 重型 ML 训练(边缘不是用来炼丹的)
- 已有 Lambda 体系且迁移成本高的存量业务
Cloudflare Python Workers 把"Python 生态 + 边缘低延迟 + Workers AI"三件事拼成了完整闭环——这是 2026 年边缘计算最值得关注的进展之一。问题是 C 扩展生态还在填坑、冷启动比 JS Worker 慢、标准库被阉割,这些限制把它的位置圈在"轻量边缘逻辑 + AI 推理"那块,跟 Lambda 是分工不是替代。
已经在用 Cloudflare Workers 的,Python Workers 直接用——同样在边缘、同样免 egress 费,多了熟悉的 Python 写法。AWS 体系里的业务,先把 Lambda 跑好——Python Workers 在边缘做补充,不替换主链路。
跑边缘 AI 推理、API 网关、Webhook 接收这类轻量任务,Python Workers 是 2026 年值得入坑的选项;跑科学计算、长任务或重 ML 训练,等 Polars / PyArrow 的 WASM wheel 落地、PEP 783 普及之后再考虑主链路使用。
【广告】 我目前在用的云主机商家,对个人项目、小型服务、自托管场景都还不错,按小时计费、亚洲节点、中文支持、按流量付钱——nube.sh/invite/0406418696GYIL,感兴趣的可以自己去看看对比下。
工具版本:Cloudflare Python Workers GA(2026-09-21 发布)
测试环境:Cloudflare Workers 控制台 + 本地 wrangler 4.x
测试时间:2026 年 9 月
测试者:猫咪不吃愚(科技从业者 / 程序员 / 运动爱好者)
*本文为作者关于 Cloudflare Python Workers GA 的解读与个人判断,事实基于 Cloudflare Python Workers 官方文档、官方示例仓库 cloudflare/python-workers-examples、MindPattern、Architecting on Cloudflare 等公开资料。

 浙公网安备 33010602011771号