

图形剖分专题


我公司正在开发一个高校三维系统,该系统为GIS+MIS。我们负责GIS部分,二次开发平台选用Supermap Objects。
提到超图,在GIS行业口碑甚佳,有中科院这个强大的技术背景,很多公司(包括我们)都对其实力深信不疑。
在GIS二维上,超图稳定的性能以及良好的扩展性给我以舒爽之感,我在这个平台上开发的一套框架在继承其控件的良好性能基础上大幅的提高了开发效率,使我们的程序在可扩展性、可维护性、可复用性等多个方面表现优越,这个框架的具体情况会在本系列的下一个专题中详细阐述。然而,超图的GIS三维,唉!
为了更好的说明本专题的“深远”意义,我还是介绍一下超图的GIS三维吧。
GIS三维就是在三个地理坐标轴上展现地理信息,这将是GIS行业的必然归宿,它更加贴合人的经验、习惯,当硬件技术不再成为瓶颈时,GIS三维将成为主流。显然国内的各个GIS厂商已经意识到了这一点,灵图走的更远一些,由于没有用它做过实际的开发,所以没有什么发言权,但就其demo和介绍来看,效果还是不错的。超图的三维功能就相对弱了一些,这里是看在其GIS二维的面子上嘴下留情了。
超图的GIS三维就其效果,还是可以唬人一气的,但是在大场景上,你可不要轻易的乱动,否则后果自负。超图宣称其三维系统基于OpenGL,但在不同的显卡上其工作效率基本一致,并且性能低下,应该是采用了纯软件模式,假如能够使用硬件加速的话,那么部署起来也会增加工作量;在展现方式上,这里的三维说白了就是原地拔高,在数据库中的每一行记录(一个面对象)中,会有两个字段分别表示base和top,到了三维控件中将来自二维控件的一个面转变为一个以base为底部高程、top为顶部高程、面对象为上下表面的一个直棱柱对象(soGeoRegionCylinder),在其普通三维图层中只能存在这一种对象,很显然,局限性很大。比如学校中的某个教学楼屋顶是尖的,就无法用一个直棱柱对象来表现了,要想模拟这样的效果,就需要多个直棱柱对象相互组合,用近似的方法拼接出来,这样就增加了大量的小直棱柱,进一步影响系统的性能,至于贴图的方式和性能这些小问题,我就不提了,我来说说最不能让人忍受的地方。
在我们在做的系统中,会涉及到对各种管线进行管理,这些管线会在三维空间中到处乱窜,很显然用直棱柱的形式是痴心妄想,好在超图的三维控件提供了一个在所有图层之上的跟踪层,在这个跟踪层上可以绘制一些类库提供的三维对象,当然三维线对象位于其中。将三维管线绘制出来,效果还不错,但是,灾难性的,它无法选中,超图的选中方法是鼠标命中某个对象的外接长方体,然而一条三维线可能横跨几公里,会拐好几个弯,这样的一个外接长方体可能会包括整个学校!三维线会有成百上千上万条,外接长方体相互交叉,如果想用鼠标选中某条三维线,那就是个蜀道难。
基于以上的局限性,最后项目组决定由我来尝试开发一个以Managed DirectX9为三维支撑,与超图类库紧密集成的三维控件,换句话说就是把超图的数据在托管DirectX上显示。这样会有很多好处,首先在性能上由于是自己开发控制起来较有把握;如果开发成功会成为这个项目的一个副产品,具有一定的商业价值等等。
在GIS二维中,主要存在点、线、面三种对象,点、线到三维的变换比较容易,面对象则相对复杂。大家知道在D3D中要想表现一个面需要用一系列的三角形将其拼接出来,因此要想在D3D中显示GIS二维的面对象,需要首先将面对象转变为一系列的三角形,然后按照D3D的数据结构进行组织,继而显示出来,这样摆在我面前的第一个问题就是任意多边形的三角剖分。在GIS二维系统中,什么样的多边形都可能出现,凸多边形、凹多边形、有洞多边形、自相交多边形、分离多边形(这个是我自己起的名字)等等,因此这个问题注定是复杂而富有挑战的,经过两个星期左右的奋战,在查阅了大量文献后,创造了一种新的剖分算法,我会在本专题中详细阐述这种新的算法,分析它的优劣。我的实现是建立在超图对象基础之上的,在行文过程中,我会适当的介绍一些超图对象,以帮助园友更好的理解算法。
很多人都有这样的习惯,当要做一件自己没有接触过的事情时,先不着急下手从零做起,而是通过各种渠道去了解这个问题是否已经有人思考过,并且是否已经很好的解决了,或者能否给自己一些启迪。这是个好习惯,但是在参考别人的解决方案时要保持一个旁观者的心态,并时刻注意哪一部分对我有用,有多少用,他这样做的好处是什么,这样做的不足又是什么,我所处理的问题是否和他面对的完全一致,出入在什么地方,切不可拿来主义!
我就有这样的习惯,下面是对我在刚接触任意平面多边形三角剖分这个问题时找到的一些解决方案的分析,其中不乏经典。
一、三角剖分的定义
谈到三角剖分,不得不先摆一下它的定义:[1]
1. 产生的三角形不相重叠;
2. 不产生新的顶点。
这样的一个定义并不必那么教条,达到这样的目标是好的,但如果考虑到其它的一些因素,比如说通用性、复杂度、性能等等,可以适当的违反一些,三角剖分的目的就是一个:用三角形拟合多边形。
一般来说第一条是不该违反的,毕竟产生的三角形有重叠部分就可以将其进一步分解成无重叠。但第二条遵守起来就不那么容易了,就在摆出这个定义的同一篇文章,也就是参考文献1,它给出的算法就可能产生额外的顶点。
在本专题下一篇文章中我将会阐述我提出的新算法,你将发现,通过这样的算法进行处理,产生的不规则三角形网严格遵守第一条,但严重违反第二条!但是这个算法有一个好处,就是从更广泛的意义上做到了对任意多边形的处理。如果你读过本专题的首页,会发现我提出了一种新的多边形:分离多边形。分离多边形是由不相交的多个多边形组合为一个逻辑主体,以一个整体的形式对外表示。对于这样的多边形该算法仍然能够很好的工作,在算法看来,它与其它多边形没有什么区别,其实,算法并不关心多边形的类别,哪个顶点是凹的,哪个顶点是凸的。呵呵,提到自己的算法多少有些激动,话多了些,回到本篇的主题,关注一下别人的算法,回望经典。
二、Delaunay三角剖分


谈到三角剖分,这个名字你不得不熟悉,这就是经典。
Delaunay三角剖分与Voronoi图互为偶图,也就是一一对应,这里我们先了解一下Voronoi图。
这里给出它的数学定义:[2](可以不看)
令P = {P1,P2,…,Pn}为平面域(R^2)上n个离散点的集合,一个完整的Voronoi图应该由多个Voronoi多边形组成,第i个Voronoi多边形的数学表达形式如下:
Vi = { x ∈R^2 : ||x – Pi|| <= ||x – Pj|| , j=1 ,…,n; j ≠ i }
式中,i = 1,2,…,n ,||x – Pi||表示平面域上点x和节点Pi之间的欧氏距离。从上式可知,Voronoi多边形Vi内任意点x到节点Pi的距离比到点集P中任何其他节点的距离更近,因此Vi由节点Pi和每个相邻节点的垂直平分线所形成的开式半平面的交集组成,故Vi必为凸多边形。
这段数学表述看懂了吗,如果看懂了,恭喜你,你很棒,如果还有些含糊,也没什么,其实Voronoi图就是由每个节点到相邻节点的垂直平分线组成的多边形构成的一个多边形集合,还有些迷糊,没关系,接着往下看,这里给出一个8节点的Voronoi图,其中的实线部分正是各个多边形。

一般情况下,Voronoi图的一个顶点同时属于三个Voronoi多边形,每个Voronoi多边形内有且仅有一个节点。连接三个共点的Voronoi多边形分别对应的三个节点则形成一个Delaunay三角形,所有这样的三角形的集合就是著名的Delaunay三角剖分。上图中的虚线部分就是与该Voronoi图对偶的Delaunay三角剖分。
Delaunay剖分出来的三角形网具有以下特征:[3]
1. Delaunay三角网是唯一的;
2. 三角网的外边界构成了点集P的凸多边形“外壳”;
3. 没有任何点在三角形的外接圆内部,反之,如果一个三角网满足此条件,那么它就是Delaunay三角网;
4. 如果将三角网中的每个三角形的最小角进行升序排列,则Delaunay三角网的排列得到的数值最大,从这个意义上讲,Delaunay三角网是“最接近于规则化的”的三角网。
从上面的算法和特征可以看出该剖分算法对于带洞多边形等非简单多边形不适用,会产生一些多余的三角形,假如上图中外面的一圈五个顶点构成带洞多边形的外环,而内部的三个顶点构成内环,则会多剖分出来一个三角形,为了让该算法更普适一些,很多人做出了努力,如[2][4]等等。
由于这个算法普适性差,优化算法较为晦涩,所以望而生畏了,由于我看的是论文,这种行文方式令我大为不爽,可能没有很好的领会作者的精妙思想,在此强烈呼吁各位论文作者,在完成论文后,能否用通俗易懂的话来表达一下你们的思想,一定要那么学究吗?
跑题了~
Delaunay剖分出来的三角形网具有很好的特性,但这些对于我这个应用来说并不那么重要,我的目标是让D3D帮我渲染出多边形,至于什么唯不唯一、规不规则并无大碍。
该算法的优点于我并不重要,而缺点于我却至关重要,因此结论是不选用该方法。
三、其它三角剖分
对于简单多边形,有基于凹凸顶点判定的方法,就是判定多边形的每一个顶点是凹点还是凸点,发现凹点后,判断凹点之后两边能否形成三角形,如不行则继续寻找凹点;如果可以形成三角形,记录下三角形并将其移去,继续寻找凹点,直到分解完毕或没有凹点,没有凹点的凸多边形可由任意一点引线段将凸多边形分割。这种方法适用范围有限并且有特例不能分解,特例如下图。[5]

当然基于凹凸顶点判定的方法不是仅此一种,但在我找到的论文中就发现了这一个,还是作为反例出现的。
其它的对于非简单多边形的剖分算法基本上思路是一致的,就是连接内外环,化非简单多边形为简单多边形[1][5],然后再用其它的方法来处理简单多边形,例如基于凹凸顶点判定等等,以下两幅图给出了一个大致的思路。


四、总结
说了这么多,其实只是涉及到了这个领域的冰山一小小角,我看到的算法都或多或少的与我的需求有出入,于是就开始构思一种概念简单,实现方便,性能优良,适用度广的剖分方法,幸而我找到了这样的一种方法,并且在实际运用中表现不俗,从下一篇开始我将详细的阐述这个算法。
五、参考文献:
1. 徐春蕾, 李思昆 . 一种适用任意平面多边形的三角剖分算法[J] . 国防科技大学学报 . 第22卷第2期
2. 丁永祥,夏巨湛,王英,肖景容 . 任意多边形的Delaunay三角剖分[J] . 计算机学报. 第17卷第4期
3. http://baike.baidu.com/view/501103.htm
4. 涂治红, 桑农 . 用VC语言实现任意多边形的Delaunay完全三角剖分算法. 计算机与数字工程. 第33卷
5. 陈向平, 应道宁. 任意多边形三角剖分算法[J]. 浙江大学学报. 第六期第22卷. 1988年11月
上一篇文章大致的介绍了一下三角剖分领域的经典,从这一篇开始我将把新提出的算法慢慢的展现在各位面前,用一种不同以往论文式的口吻为大家讲述。
也许你没有接触过这个领域,也许你现在的工作与此领域风马牛,也许你认为这个领域与你注定没有交集。告诉你,一个月前,如果我看到这篇文章也会有同样的想法。我相信,这篇貌似很专业的随笔会让每一位看客都知道我在说什么,并且会给各位一些启迪,更重要的是我将在后续的文章中向大家展示如何将自己的想法用面向对象的方式实现出来,让它实实在在在你面前,让它实实在在为你工作。
下面是一段利用本算法对带洞多边形三角剖分的视频录像,大家先留个印象,等看完本文后再看这个视频会有助于理解。

任意平面多边形,最怕就是任意二字。对于某种特殊的多边形,例如凸多边形,算法往往很容易想出,选出任意一个点分别连接与其不相邻的点不就得了。很遗憾,在我遇到的问题中,凸多边形确实是有的,但是更多的是千奇百怪的多边形,因为这些多边形是用户输入的,我无法预期。在进行了如上篇随笔的分析后,发明一种新算法的要求迫在眉睫。
这种新的算法被我有幸找到,继而才有了这些文字。新的算法由寻找辅助线、寻找相交点、寻找三角形三个大块组成。
一、寻找辅助线
在网上进行了很长时间的搜索,终于在一个论坛的回复中我找到了灵感,决定从这里切入问题,这个切入点正是扫描线(下图的水平绿线)。

在这里我先描述一下扫描线:扫描线是水平的,其纵坐标取多边形某个顶点的纵坐标,因而在上图的多边形中会有八条扫描线,图中显示的是第一条。假定一个多边形顶点数为N,那么扫描线的条数是小于等于N的,在最坏情况下达到N,如果两个或者更多个顶点的纵坐标相同,那么扫描线的数量就会减少一些。寻找这些扫描线的时间复杂度为O(N),遍历一遍顶点就可以了嘛。
细心的你一定发现了左边这条竖直的绿线,我称之为左辅助线,它可有大作用!该线的选定方法是找出所有顶点中的最小横坐标,并将其向左移动一些(这个值任意),它的作用是什么呢,想想看,一会儿再告诉你答案。寻找这条左辅助线的时间复杂度也是O(N)。
二、寻找相交点
上面所作的一切虽然很重要,但只是一个前奏,现在就让我们缓步进入主旋律吧。
这里揭晓左辅助线的作用:左辅助线一定在多边形外,所以让各行扫描线从左辅助线出发,起点一定在多边形外,这样如果扫描线和多边形相交,第一次一定是进入多边形,第二次一定是走出多边形,第三次一定又是进入多边形,第四次……,总之就是第奇数个相交点为进入多边形点,而偶数个相交点为走出多边形点,相交点的个数一定是偶数个(如下图,第四条扫描线共有四个交点)。
各行的交点要保留下来以备下一步使用。建立一张二维表,为每一条扫描线建立一个新行,而每一行中保存该扫描线与多边形的各个交点。这里有一个问题需要注意,由于扫描线是在遍历各个顶点的时候找到的,而各个顶点的纵坐标不可能会降序或升序排列,所以我们有必要将扫描线数组进行一次排序,让他们自上而下排列于二维表中,这步排序时间复杂度为O(N*logN),至此我们的算法时间复杂度已经上升为O(N*logN)。

细心的你又发现了,不对不对,这第一条扫描线不就只有一个交点吗,没错,对它有特殊的处理。
每条扫描线一定会穿过至少一个多边形顶点,原因在于扫描线的选取方法。穿过的这个顶点,实际上是扫描线和两条边线的交点,这是显而易见的,也就是说在求两条连续边与扫描线的交点时得到的是同一个点,当遇到这样的情况后,需要有一些特殊的处理。你会发现,当出现这种情况时,会有两种可能:一种是扫描线经过该点后并没有进入多边形,而是打了个擦边球,又从多边形出去了,上图中最上面的一个点正是这种;另一种是扫描线通过该顶点后从多边形外进入了多边形,上图中第二行最左边的一个点正是这种。这当然要区别对待,如果是第一种情况,我们把它想象为扫描线进入了多边形并同时走出了多边形,我们将该点加入到二维表中两次,而第二种情况我们认为它就是个普通的点,只加入一次即可。至于他们是怎样通过计算区别开来的我们放到《第六回:寻找交点,离胜利就剩一步 之 开找》中再详细讲述。
值得注意的是,上文说的打擦边球同样会有第三行中间那个点的情况,它打了个擦边球没有走出多边形,所以更准确的:第一种情况是扫描线通过多边形某顶点后没有改变与多边形的位置关系(内外);第二种情况是扫描线通过多边形某顶点后改变了与多边形的位置关系。
每条扫描线都要与多边形的所有边求一次交,用得到的交点填充二维表,由于边的条数与多边形顶点数相同,所以该步所需时间复杂度O(N^2)。完成该步后我们得到了一张填充了所有交点的二维表,并且时间复杂度达到了O(N^2)。
二维表的情况我们会在《第六回:寻找交点,离胜利就剩一步 之 纽带》中详细介绍。
三、寻找三角形
终于,我们到达了高潮部分,我们之前的一切努力在这里将化为期望的结果。
在构建上面提到的二维表时,你想到它的作用了么,为什么要是这样的一种结构,每行偶数个交点有什么隐含的意义。再往前想,我们为什么要建立扫描线,它的引入又有什么意义。
二维表中,每行的各个交点都是无序的存放于数组中的,为了我们的分析,我们需要将其每一行的交点都按照横坐标从左到右进行一次排序,每一行中交点数在最坏情况下会达到N,因为可能某条扫描线跟所有边都交个遍,对这一行排序时间复杂度为O(N*logN),又由于有N行,所以这一步时间复杂度为O(N^2 * logN),至此该算法时间复杂度上升为O(N^2*logN)。
二维表中每一行都有偶数个交点,而所有位于偶数索引的交点都是进入点,所有位于奇数索引的交点都是走出点,这在上文已经交代过了(第一个交点索引为0),现在我们再提出一个点对儿的概念,也即相邻的两个点构成这样的一个点对儿,点对儿中的这段扫描线一定在多边形内。这样相邻的两条扫描线相对应的两个点对儿就会包围出一部分多边形区域,这个区域的形状一定是梯形,把所有这样的区域全部找出来就会填充整个多边形,梯形再转变为三角形那就是易如反掌了。在寻找梯形的过程中,需要遍历所有的扫描线,在遍历每条扫描线时需要遍历该扫描线中的每个交点,所以这步处理需要的时间复杂度为O(n^2)。

当然在寻找梯形的过程中还会有一些需要特殊处理的情况,我们将在《第七回:寻找三角形,夺取红旗》中详细讲述。
该算法简单易懂,O(N^2*logN)的时间复杂度尚可接受,核心代码大概为300行,在实际应用中的表现还是可圈可点的。下面的几篇文章会就本篇的各个方面深入展开,实现方式运用了很多面向对象的技巧,下一篇文章将详细讲解录像中各个步骤显示的实现方法。
清明小憩之后,我们再续前文。
上篇文章中有一段剖分带洞多边形的录像,在绘制好任意多边形后,点击一些按钮可以查看整个剖分的各个步骤,本篇就详细讲述这个步骤显示功能的实现方式。
每个人在设计类结构时都会有自己的习惯,我的方式是在一片空白时去构想我将要实现功能的各个参与者,它们各自担任的角色以及负责的功能,在这个过程中还不需要考虑接口,更不用考虑代码,只是考虑某个参与者是否有必要并且明确它所承担的责任。我发现将每个参与者拟人化是很有益处的,如果将其拟成某种固有属性与其承担责任非常相近的具体物件则更有帮助,这个过程我称之为形象化,一个著名的例子当属网络爬虫。当你将每个参与者形象化之后,你将发现现在的程序不再是一块块死气沉沉的代码,而变成了一组生机勃勃的团队,他们的目标与分工都是如此明确。
这种方式还可以再进一步,形象化时可以将某些参与者弄的憨态可掬一些,当它上场时它的某些行为很可能就惹得你忍俊不禁,这对提升一个开发者的激情很有好处,对厘清某个复杂的逻辑也颇有裨益,在《第七回:寻找三角形,夺取红旗》中你将看到我的爬虫是怎样在辨别果壳与果核的过程中帮我找到一个个梯形的。
一、设计类结构
在设计本文主题——步骤显示功能的结构时,正是运用了这种形象化的设计方式。首先在一张空白的纸上我画上了一个管理所有显示步骤的集合类ShowStepCollection,该类的角色好似一个看管学校的大爷,如果想找某个显示步骤,不要试图去直接访问,问问大爷就可以找到,当然如果你要添加一个显示步骤也要通过这位大爷,大爷会为他安排好一切。这个类将步骤显示功能封装到了背后,在程序中如果希望访问显示步骤都要到这里来,可以认为该类是一个门面。
下面要考虑的就是这个集合类中要存储的东西,看看上篇文章中的录像你会发现步骤的显示是以每条扫描线进行分组的,所以在此集合类中要有一个显示步骤组ShowStepGroup的集合,而每个步骤组中再包含具体的显示步骤ShowStep,经过这样一系列的包装,显示步骤的存储就算完成了,下面给出了类图。

显示步骤多种多样,比如显示左辅助线、显示扫描线、显示交点、显示三角形等等,而他们各自的处理方式显然不同,这样需要用到面向对象的一个最基本的特性——多态,因而ShowStep是一个抽象类。在上面的设计过程中,体现了针对抽象编程的设计原则。
二、设计接口
类结构搭建好后,下一步就是让他们协调工作起来,而协调的媒介正是接口。
ShowStepCollection需要添加显示步骤组以及添加显示步骤,所以需要addGroup和add两个函数,为了能够访问各个步骤组,需要Count、Item属性以及一个用于遍历的GetEnumerator,该函数实现了IEnumerable的相应接口,还有一个用来撤销所有步骤显示的clear函数。
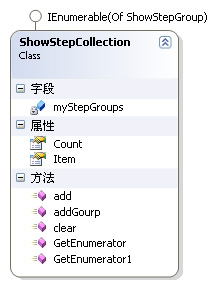


ShowStepGroup是存储具体显示步骤的地方,所以需要添加显示步骤的add函数,以及与ShowStepCollection功能一致的Count、Item属性和GetEnumerator、clear方法。ShowStepCollection的add函数正是调用ShowStepGroup的add函数来完成添加具体步骤功能的。
ShowStep作为抽象类具有两个抽象函数,show和clear,分别用来显示和撤销显示。
三、代码(略过)
这里的显示全部利用超图组件,因而涉及到显示的部分会传入一个大家很不熟悉的参数: map As AxSuperMapLib.AxSuperMap,这没关系,如果要是画在一个windows窗体上传入的就该是该窗体的Graphics了,当然具体到代码会有些不同。
 ShowStepCollection


 ShowStepGroupShowStep
下面给出ShowStep的子类ShowTriangle的代码,其它子类大同小异
ShowTriangle四、操纵显示步骤
经过上面的三个过程,显示步骤的存储、绘制等功能已经完成,也就是说静态的结构已经搭建完毕,下面就要让这些步骤以一种合适的方式动起来。这时你有一些选择的余地,一种方式是将步骤切换、步骤组切换等逻辑分别写到ShowStepGroup以及ShowStepCollection中去,这样做之所以会被想到正是受到封装思想的影响,封装的思想是什么,自己的数据自己消费,由于各个步骤组是步骤集合ShowStepCollection的数据,所以很自然的就会想到在该类内部添加一些方法,来操纵这些组,同样的想法也会出现在步骤组中。这样的想法不好吗,这种对数据的封装不对吗,我要说的是这不涉及对错,只是在这里不太适合,有更好的方式让问题更简单。那为什么不适合呢?
为了显示各个步骤,步骤集合ShowStepCollection需要做一些事情,ShowStepGroup也需要做一些事情,但从整体来看二者做的是同一件事情的不同部分,一个负责组切换、一个负责步骤切换,但两者之间并非泾渭分明,会有相互的影响,最明显的是当组切换时,步骤得回到新组的第一个。因而这样设计会增加二者的耦合度,并且违反了最小知识、单一职能等设计原则,扩展性极差,实现难度较高。
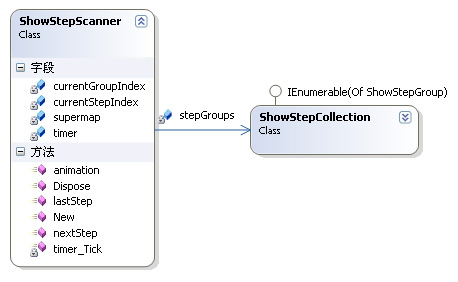
我的做法是设计一个专门的类ShowStepScanner来负责控制步骤的显示,无论是组切换还是步骤切换都在这一个类里完成,将分散在ShowStepCollection和ShowStepGroup中的控制逻辑抽取出来,合在一起放到这个类的相关方法中。下面是该类的类图以及代码。
 ShowStepScanner
从类图和代码中可以看到,nextStep负责前进一步,通过控制组索引和步骤索引来实现下一步骤的显示,lastStep则是回退一步,animation则通过一个定时器实现了自动显示步骤的功能,如果没有将控制显示的逻辑从那两个类中提取出来,这些功能的实现是很困难的。
一个完整的步骤显示功能实现过程展现于此,在这其中有一些我自己开发中经常用到的技巧:为有待实现功能的各参与者进行功能划分;根据参与者的特点将其形象化,在可能的情况下添加一些趣味在里面;如果某项工作的逻辑较为分散将其抽取出来组织成一个新的实体,这其实就是添加了一个参与者。经过上述过程的反复迭代,最后会形成一个结构清晰、逻辑缜密、组织良好的类结构,为后续的编码甚至维护提供有力的保障。
上篇文章介绍了步骤显示功能的具体实现方式,并且给出了我对面向对象设计的一些建议。本篇将会介绍在本三角剖分算法中涉及到的数学知识,并向您展示在引入新的数学工具后实现的便捷。
新的算法由寻找辅助线、寻找相交点、寻找三角形三个大块组成,这几大块的大致思路已经在《第二回:漫谈新思路,是我们自己干的时候了》中有所交代。其中,寻找相交点需要进行大量的数学运算,而关键的数学运算是计算射线与线段的交点。
一、老工具
计算射线与线段的交点可以有很多方法,比如使用解析几何。我大概的描述一下使用解析几何的做法:先找到射线与线段所在的两条直线,得到两条直线的函数,联立为二元一次方程组,解出结果得到两条直线的交点,再判断交点是否在射线上以及交点是否在线段上。
这种做法原不原始尚不讨论,单就其运算的繁复就已经大打折扣,当然使用这种做法有一个好处:一个耐心的高中生就可搞定,省却了看这篇文章的时间
二、新工具
隆重推出新的数学工具:向量。我好似看到一堆鸡蛋、西红柿朝我飞来,向量还算新?高中就学过!没错,但是在这里我会引入一些新的用法,从而使这种数学工具焕发新的青春。
在这里我假设大家已经了解向量的概念,基本的运算法则,在以后的系列中我会详细讲解向量。
由于是解决平面三角剖分问题,所以使用的向量是二维的,因而这里不会涉及到向量叉乘的问题,但是点乘会经常涉及,垂直向量点乘为零的性质也会经常用到。
在本篇文章中粗体小写字母代表的是向量,斜体字母代表的是标量,大写字母代表的是点。下面是二维向量类和二维点类的代码:
Vector2Point2 在上面的代码中,重载了一系列的运算符,各自功用不难理解,不过是为了方便编程罢了。Point2的Equals方法不是简单的比较两个点的坐标,而是将待比较的两个点连成一个向量,根据向量的长短来进行比较,当向量足够短时就认定两个点相同。Vector2的perp方法返回一个与该向量长度相同,逆时针旋转至垂直的新向量,说着挺玄,看看代码其实就是简单的将横纵坐标交换,然后将原来的y反向,别看它的定义如此简单,后面可有大用途,在我看来该方法的引入使向量大大进化,运算方法更加灵活,向引入该方法的数学家(可惜不知道是谁)致敬!在本篇文章中a的perp以符号~a表示。
三、用向量描述直线
大家知道,向量是没有位置的,所以要表现一条直线需要一个点和一个向量,而点和向量所决定的直线为A + ct ,其中t的取值为(-∞,+∞),当取其中某个值时确定一个点,特别的,当t为零时,为向量的起始点A,当t为1时,为向量的终止点A + c,当t小于零时为向量反方向上的某个点,详情如下图

你是否有什么惊奇的发现,看到这个t的取值图有没有眉头微释,没错,得到了t你就找到了点,而t落在的区间就决定了它与射线、线段的关系:t>0时点落在射线上,t∈[0,1]时点落在线段上,哈哈,就是这么简单,当你找到了点,它的位置就尽在掌握,岂一个爽字了得。
四、射线与线段的交点
上面给出了向量描述直线的方法,求射线与线段的交点实质上就是求它们所在直线的交点,显然的,当A + ct = M + eu时正是交点,如下图:

整理一下上面的等式,得到ct = (M–A) + eu(一),这里的M–A就是一个从M开始到A结束的向量,当然由于上面的代码中已经给出了二维点的减号重载,程序里直接将两个点相减就可以了。
下面的任务就是求出t和u,继而得到交点了,这里需要一些技巧,还记得上文中提到的perp吗?
在上述等式的两边同时乘以e的perp,也即~e,由于(~e)•e = 0,所以上面的等式就恒等变形为ct•(~e) = (M–A)•(~e),继而t = (M–A)• (~e) / c•(~e),这些都是已知量了,t也就求出来了,将t代入(一)式,u也即求出,当然也可如法炮制在(一)式两边同时乘以个~c。t和u都求出后,发现t>1,故而两直线的交点落在了蓝色射线上,但是没有落在AB线段上,而0<u<1,故而该交点落在了线段MN上,怎么样,简单!
另外,当考虑某条射线和一系列线段相交时将求出的各个t记录下来,经过将t排序可以按照射线的方向将各个交点排序,这在《第七回:寻找三角形,夺取红旗》中会用到。
射线与线段的交点通过引入向量这一数学工具用一种较为简便的方式解决了,在程序中只需三行就可以得到t和u,继而找到交点的位置,配之操作符的种种重载,代码犹如数学公式,一目了然,优雅之至!在《第六回:寻找交点,离胜利就剩一步 之 开找》中你将见到这段代码。向量知识博大而精深,这篇小文只是九牛之一毛,但对于该算法已经够用了。下一篇将详细讲述数据结构的设计,用一种较为合适的方式来存储运算过程中得到的各种数据以及最后的运算结果。
在所有的数据结构书籍中一定会有这样一个公式:程序 = 算法 + 数据结构,显然这二者是每个程序员的必修课。由于对它们的研究比较深入,各种经典结构及算法已经基本定型,所以无论是在.NET还是在Java中都被封装成非常好用的类,这样就大幅提高了开发效率,并且降低了编程门槛,这都是好事。但是万不可因为它们非常容易使用就只知其然不知其所以然,一定的了解还是必要的,毕竟经典的数据结构在某些时候未必会完全符合要求,我们需要进行包装甚至是重头搭建,还好本算法使用的数据结构不那么复杂,适当的包装一下就可以了。
一、 DirectX中的两个缓冲
如果你不是DirectX菜鸟,可以直接跳过这一段,本段是对DirectX中顶点缓冲(Vertex Buffer)和索引缓冲(Index Buffer)的概要介绍。
在DirectX中,一切都是三角形(当然如果你非拿线段来质问我就太矫情了),所有的物体都是由大量的三角形拟合而成,这也正是本专题存在的前提。
如果是我们来设计DirectX中的数据结构会怎样做呢?最直观的,把每个三角形的三个顶点按照顺序(DirectX中是逆时针)构成一个三元组,再把所有这些三元组组成一个大数组不就可以了。没错,DirectX正是这样做的,只不过并没有什么三元组,而是把所有的顶点一股脑的装进那个大数组,每相邻的三个为一组表示一个三角形罢了。
上面所说的方案是DirectX支持的一种,这个大数组就是顶点缓冲,它无可挑剔的直观,但是它的缺点也是致命的:浪费了大量的存储空间。浪费在什么地方了呢?很多三角形是共用顶点的!每个顶点所占用的空间可是不菲呀,重复的那几遍毫无意义。
很自然的,我们想到,如果把顶点缓冲当做一个没有顺序关系,没有重复的顶点池,把每个三角形顶点在这个池中的索引拿出来放到另一个数组中,像前面一样把索引三个一组的排列来表示一个三角形,会不会更好呢?

这种顶点缓冲与索引缓冲的应用,与享元模式何其相似来尔!
二、 设计数据结构
由于该算法三角剖分出来的结果是要为DirectX提供数据的,所以我们的数据结构要能很好的与DirectX数据结构交互,因此参照DirectX数据结构设计是很自然的,况且根据前面的分析,该种设计方式也是很合理的。
VertexBufferIndexBuffer顶点缓冲中的Point2OnLine是上篇文章Point2的子类,含有一些其它属性,在这里不必关心。由于我们面对的问题是平面多边形的三角剖分,所以所有顶点不必具有三个分量,可以认为z值始终为零。
三、 例说二缓冲
下面我们就从一个具体的例子来详细说明两个缓冲是如何配合的。

第一步:绘制一个多边形
第二步:利用扫描线在多边形上找到所有被扫描线扫到的点(整体思路请看《第二回:漫谈新思路,是我们自己干的时候了》)
第三步:上一步找到的点已经被组织到顶点缓冲,顺序是无所谓的,但是不可以重复,上文已经说过了
第四步:第一个三角形ABD的索引按照顺序(逆时针)添加到索引缓冲
第五步:所有五个三角形的顶点索引按照顺序添加到索引缓冲
上面的步骤中第二步和第三步是交替进行的,找到一个点后就将该点加入到顶点缓冲中,具体过程请看《第六回:寻找交点,离胜利就剩一步 之 开找》,第四第五步的详细过程请看《第七回:寻找三角形,夺取红旗》。
终于,一切准备工作已经完成,用于算法调试的步骤显示在《第三回:实现步骤显示,一步一步看得见》已经实现 ,数学基础在《第四回:掌握数学工具,没个好帮手怎么行》已经打下,本文又给数据存储做好了准备,下一篇文章我们将进入整个算法的最核心地带,讲述交点的寻找历程。