
详解十大排序
声明:资料参考
一.概述
| 分类 | 名称 | 时间复杂度 | 空间复杂度 | 稳定性 | |||
|---|---|---|---|---|---|---|---|
| 平均情况 | 最好情况 | 最坏情况 | 辅助存储 | ||||
| 比较类 | 插入排序 | 直接插入排序 | O(n^2) | O(n) | O(n^2) | O(1) | 稳定 |
| 希尔排序 | O(n^3/2) | O(n) | O(n^2) | O(1) | 不稳定 | ||
| 选择排序 | 直接选择排序 | O(n^2) | O(n^2) | O(n^2) | O(1) | 不稳定 | |
| 堆排序 | O(nlogn) | O(nlogn) | O(nlogn) | O(1) | 不稳定 | ||
| 交换排序 | 冒泡排序 | O(n^2) | O(n) | O(n^2) | O(1) | 稳定 | |
| 快速排序 | O(nlogn) | O(nlogn) | O(n^2) | O(logn) | 不稳定 | ||
| 归并排序 | O(nlogn) | O(nlogn) | O(nlogn) | O(n) | 稳定 | ||
| 非比较类 | 计数排序 | O(n+k) | O(n+k) | O(n+k) | O(max(n,k)) | 稳定 | |
| 基数排序 | O(n*k) | O(n*k) | O(n*k) | O(n*k) | 稳定 | ||
| 桶排序 | O(n+k) | O(n+k) | O(n^2) | O(n+k) | 稳定 | ||
排序算法是最基本的算法之一。
排序算法可以分为内部排序和外部排序,内部排序是数据记录在内存中进行排序,而外部排序是因排序的数据很大,一次不能容纳全部的排序记录,在排序过程中需要访问外存。常见的内部排序算法有:插入排序、希尔排序、选择排序、冒泡排序、归并排序、快速排序、堆排序、基数排序等。
二.冒泡排序
冒泡排序是一种基础的交换排序算法,其核心思想是通过相邻元素的比较和交换,将较大的元素逐步"冒泡"到数组末尾。以下是C++实现的关键要点:
算法原理:
- 从数组首元素开始,依次比较相邻的两个元素
- 如果前一个元素大于后一个元素(升序排序时),则交换它们的位置
- 每轮遍历会将当前未排序部分的最大元素移动到正确位置
动图演示: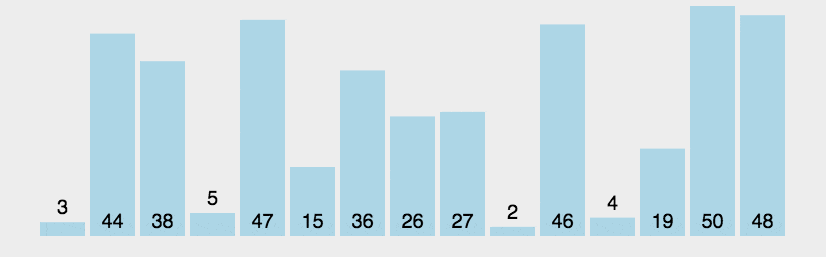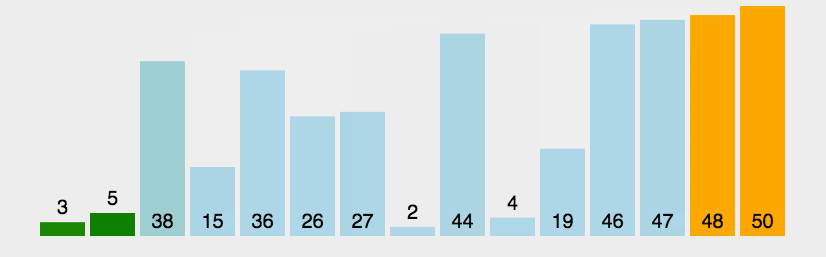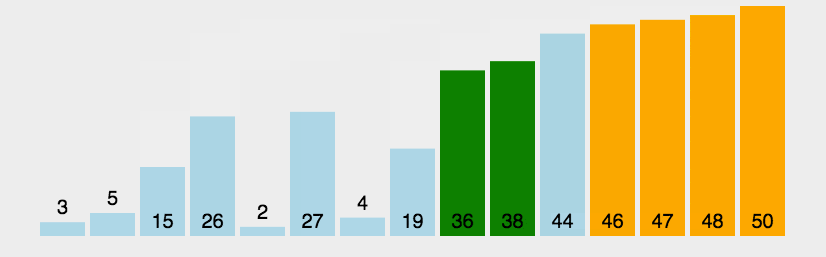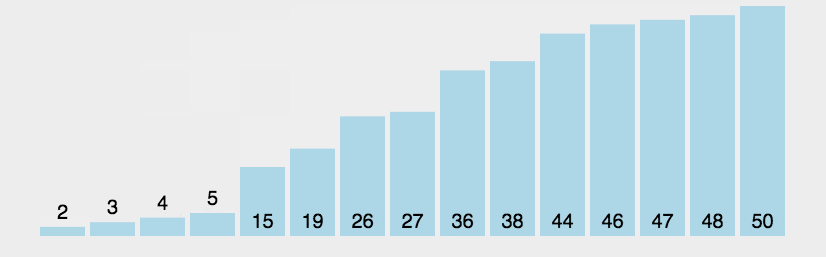

时间复杂度:
- 最优情况(已排序数组):O(n)
- 最差情况(逆序数组):O(n²)
- 平均时间复杂度:O(n²)
C++实现代码:
void bubbleSort(int arr[], int n) {
    for (int i = 0; i < n-1; i++) {
        for (int j = 0; j < n-i-1; j++) {
            if (arr[j] > arr[j+1]) {
                swap(arr[j], arr[j+1]);
            }
        }
    }
}- 优化技巧:
- 添加标志位检测提前完成排序的情况
- 记录最后交换位置减少比较范围
- 双向冒泡(鸡尾酒排序)提高效率
- 特点:
- 稳定排序算法(相同元素不改变相对位置)
- 原地排序(空间复杂度O(1))
- 适合小规模数据或教学演示
该算法虽然效率不高,但因其简单直观的特点,常被用作算法入门教学案例68。实际开发中更推荐使用快速排序等高效算法处理大规模数据。
三.直接选择排序
直接选择排序(Straight Selection Sort)是一种基于比较的简单排序算法,其核心思想是通过多次遍历未排序序列,每次选择最小(或最大)元素交换到已排序序列的末尾。以下是具体介绍:
算法原理
- 划分区域
将数组分为 已排序区(左侧)和 未排序区(右侧),初始时已排序区为空。 - 选择最小元素
遍历未排序区,定位最小元素的下标 minindex。 - 交换位置
将最小元素与未排序区的首个元素交换,将其纳入已排序区。 - 重复步骤
缩小未排序区范围,重复上述过程直到所有元素有序。
动图演示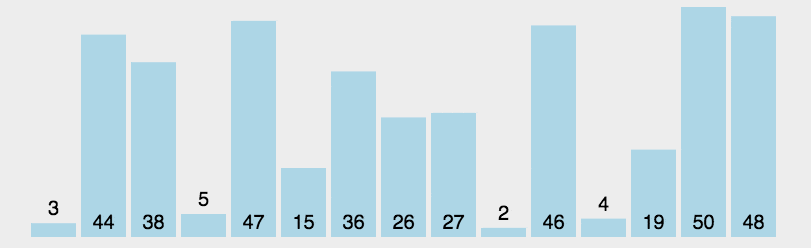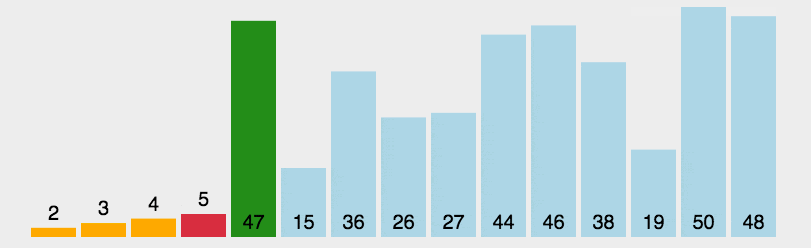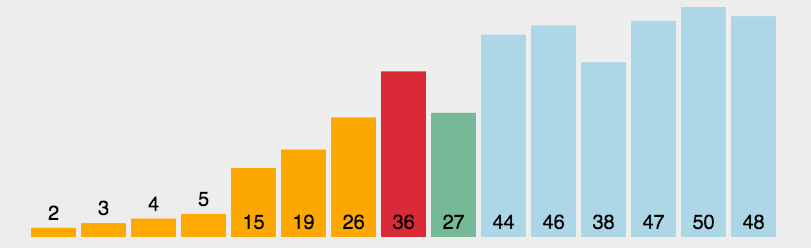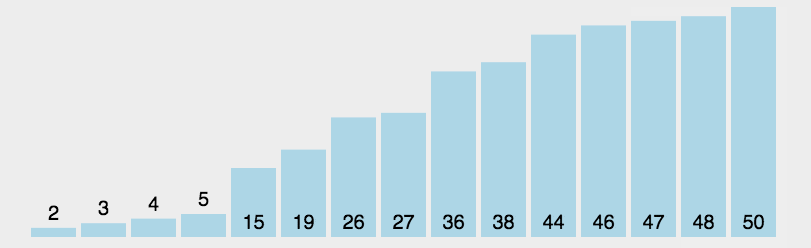
示例(升序排序):
初始序列:[8, 3, 2, 1, 7]
第1轮:最小元素1 → 与8交换 → [1, 3, 2, 8, 7]
第2轮:最小元素2 → 与3交换 → [1, 2, 3, 8, 7]
第3轮:最小元素3 → 已在位  → [1, 2, 3, 8, 7]
第4轮:最小元素7 → 与8交换 → [1, 2, 3, 7, 8]
C++实现代码
void selectionSort(int arr[], int n) {
    for (int i = 0; i < n-1; i++) {
        int minIndex = i;  // 记录最小元素下标
        // 在未排序区查找最小值
        for (int j = i+1; j < n; j++) {
            if (arr[j] < arr[minIndex])
                minIndex = j;
        }
        // 将最小值交换到已排序区末尾
        swap(arr[i], arr[minIndex]);
    }
}
算法特性
| 特性 | 说明 |
|---|---|
| 时间复杂度 | 固定为 O(O^2) |
| 空间复杂度 | Q(1)(原地排序,仅需常数级额外空间) |
| 稳定性 | 不稳定(交换可能破坏相等元素的相对顺序) |
| 适用场景 | 数据量较小,或对内存限制严格的场景 |
四.直接插入排序
直接插入排序(Straight Insertion Sort)是一种简单直观的排序算法,其核心思想是将未排序区的元素逐个插入到已排序区的正确位置,类似于整理扑克牌的过程。以下是详细说明:
算法原理
-
分区逻辑
- 已排序区(左侧):初始仅包含第一个元素(认为单个元素已有序)
- 未排序区(右侧):从第二个元素到末尾
-
操作步骤
- 步骤1:取出未排序区首元素(称为“待插入元素”)
- 步骤2:从后向前扫描已排序区,寻找合适插入位置
- 步骤3:将大于待插入元素的元素后移,腾出空位后插入
动图演示: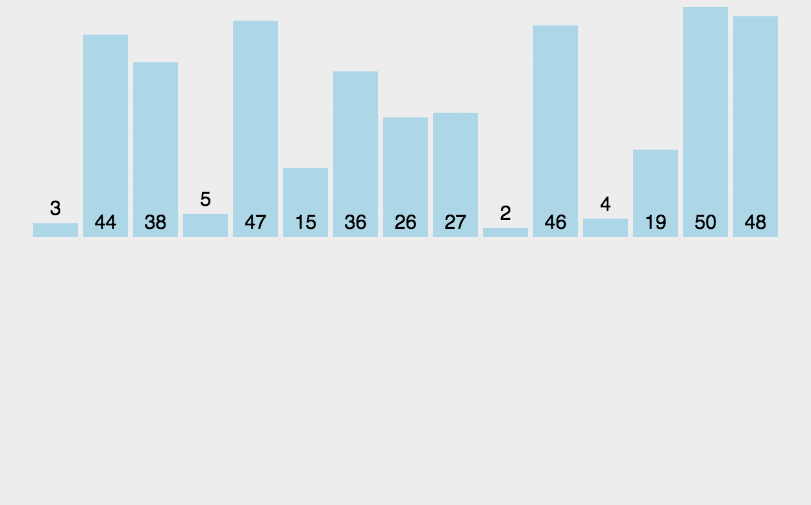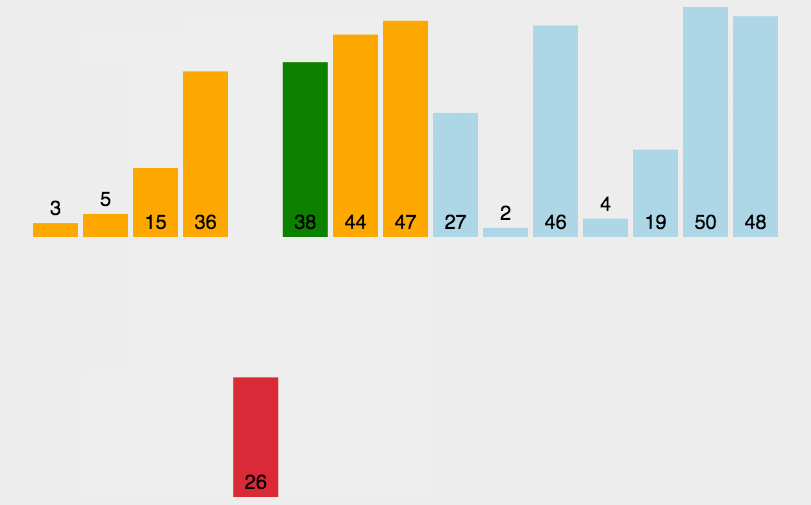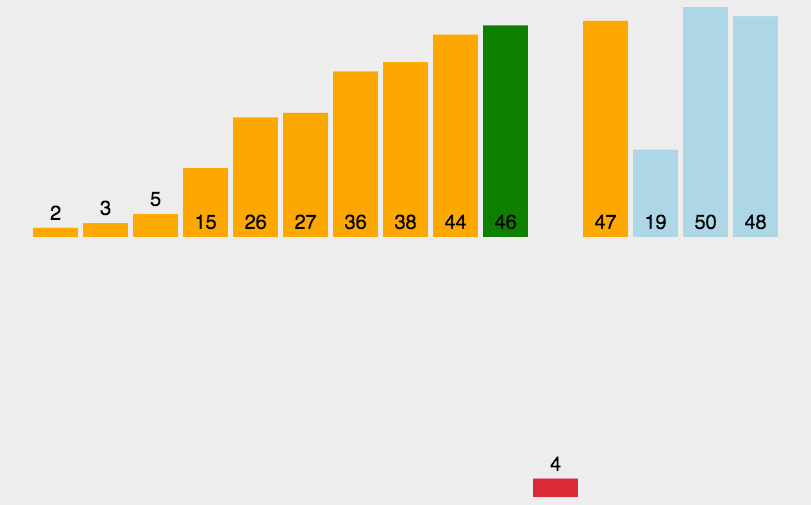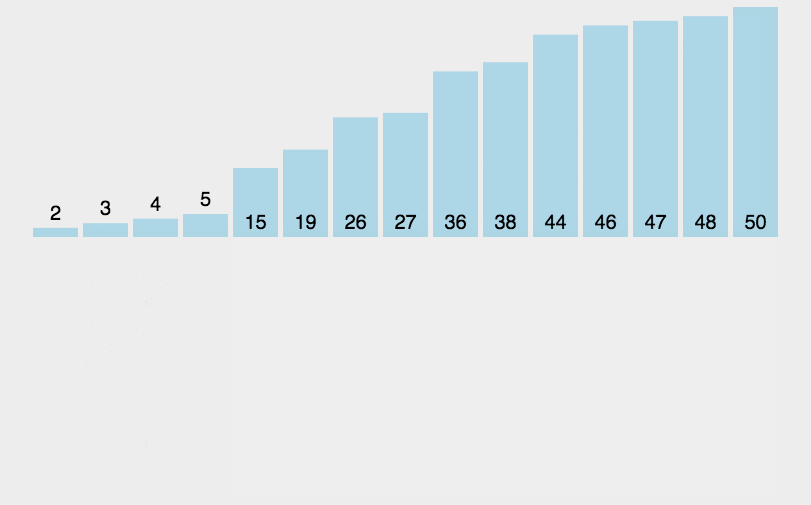
示例(升序排序):
初始序列:[5, 2, 4, 6, 1]
第1轮:2插入5前 → [2, 5, 4, 6, 1]
第2轮:4插入2和5间 → [2, 4, 5, 6, 1]
第3轮:6无需移动 → [2, 4, 5, 6, 1]
第4轮:1插入最前 → [1, 2, 4, 5, 6]
C++实现
void insertionSort(int arr[], int n) {
    for (int i = 1; i < n; i++) {  // 从第2个元素开始
        int key = arr[i];          // 待插入元素
        int j = i - 1;
        // 后移大于key的元素
        while (j >= 0 && arr[j] > key) {
            arr[j + 1] = arr[j];
            j--;
        }
        arr[j + 1] = key;  // 插入到正确位置
    }
}关键特性
| 特性 | 说明 |
|---|---|
| 时间复杂度 | 最优(已有序):O(n);最差(逆序):O(n^2);平均:O(n^2) |
| 空间复杂度 | O(1)(原地排序) |
| 稳定性 | 稳定(相等元素不改变相对顺序) |
| 适用场景 | 小规模数据、基本有序的数组(如日志按时间插入) |
五.希尔排序
希尔排序是插入排序的高效改进版本,由Donald Shell于1959年提出,又称为缩小增量排序(Diminishing Increment Sort)。它通过将原始列表分割成多个子序列进行插入排序,逐步减小间隔直至完成整体排序。
核心思想与工作原理
-
增量序列(Gap Sequence)
- 定义一个递减的增量序列 g1,g2,...,gk(满足g1>g2>...>gk=1)
- 常用增量序列:
- Shell原始序列:n/2,n/4,...,1(性能一般)
- Hibbard序列:2k−1,...,7,3,1(时间复杂度 O(n3/2))
- Knuth序列:3,4,1(3k−1)/2,...,13,4,1(推荐)
-
分组插入排序
- 步骤1:选定当前增量gap
- 步骤2:将数组分成gap 个子序列(元素间距为gap)
- 步骤3:对每个子序列进行直接插入排序
- 步骤4:缩小gap 并重复,直至gap=1
动图演示
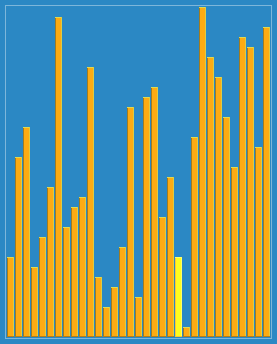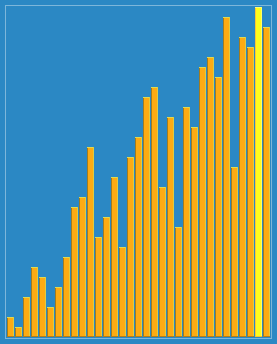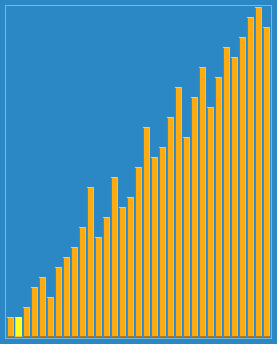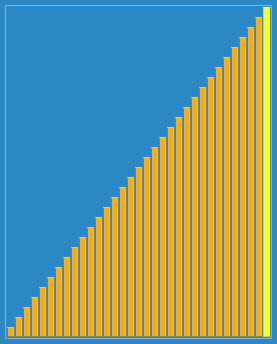
示例(Knuth序列,增量=[4,1]):
初始序列:[9, 8, 7, 6, 5, 4, 3, 2, 1]
增量=4 → 分组:
  [9,5,1] → 排序后 [1,5,9]
  [8,4]   → 排序后 [4,8]
  [7,3]   → 排序后 [3,7]
  [6,2]   → 排序后 [2,6]
重组序列:[1,4,3,2,5,8,7,6,9]
增量=1 → 全数组插入排序 → [1,2,3,4,5,6,7,8,9]
C++实现(Knuth序列)
void shellSort(int arr[], int n) {
    // 计算初始增量(Knuth序列:h = 3*h + 1)
    int h = 1;
    while (h < n/3)
        h = 3*h + 1;  // 1, 4, 13, 40...
    // 逐步缩小增量至1
    while (h >= 1) {
        // 对每个子序列进行插入排序
        for (int i = h; i < n; i++) {
            int key = arr[i];
            int j = i;
            // 元素间距为h的子序列插入排序
            while (j >= h && arr[j - h] > key) {
                arr[j] = arr[j - h];
                j -= h;
            }
            arr[j] = key;
        }
        h /= 3;  // 缩小增量
    }
}三、关键特性分析
| 特性 | 说明 |
|---|---|
| 时间复杂度 | 取决于增量序列: - 最优:O(nlogn)(Hibbard/Knuth序列) - 最差:O(n^2)(Shell序列) |
| 空间复杂度 | O(1)(原地排序) |
| 稳定性 | 不稳定(分组交换可能破坏相等元素顺序) |
| 适用场景 | 中等规模数据、内存敏感环境(嵌入式系统) |
六.归并排序
归并排序是计算机科学中最经典和最优雅的算法之一,由约翰·冯·诺依曼于1945年提出。它采用分治法(Divide and Conquer)策略,将排序问题分解为更小的子问题,最终合并结果。归并排序以稳定的性能著称,时间复杂度恒为O(n log n)。
算法核心思想
1. 分治策略
- 分解(Divide):将数组递归地分成两个长度近似相等的子数组
- 解决(Conquer):递归地对子数组进行排序
- 合并(Combine):将两个已排序的子数组合并为一个有序数组
2. 合并操作的核心原理
合并过程是该排序算法的灵魂:
左子数组:[2, 8, 15, 18]   ← i指针
右子数组:[5, 9, 12, 17]   ← j指针
结果数组:[]                ← k指针

步骤:
1. 比较左首(2)和右首(5) → 取2 → [2]
2. 比较左次(8)和右首(5) → 取5 → [2,5]
3. 比较左次(8)和右次(9) → 取8 → [2,5,8]
4. 比较左三(15)和右次(9) → 取9 → [2,5,8,9]
... 最终得到 [2,5,8,9,12,15,17,18]
动图演示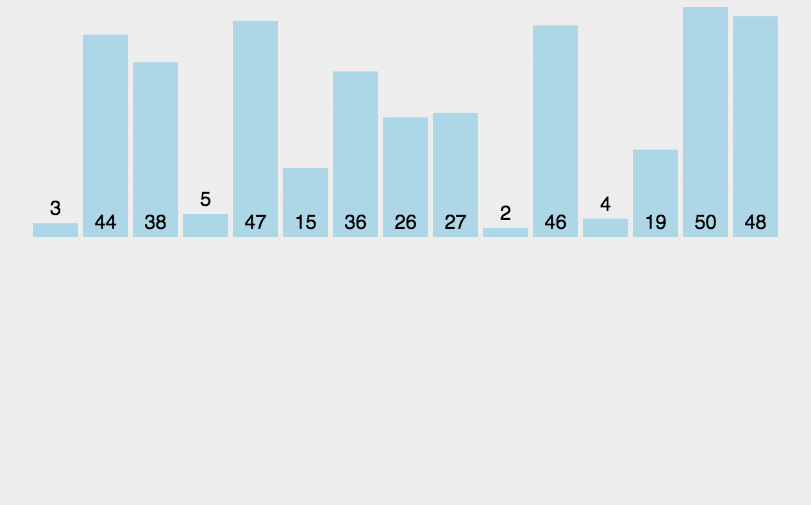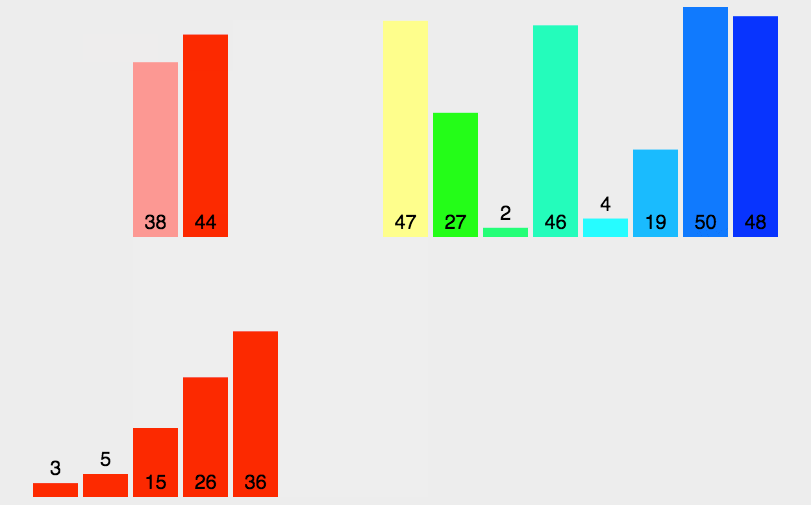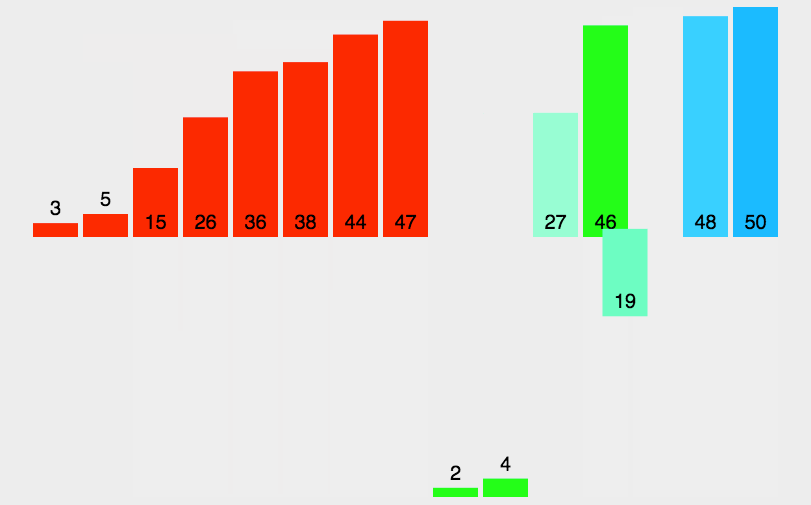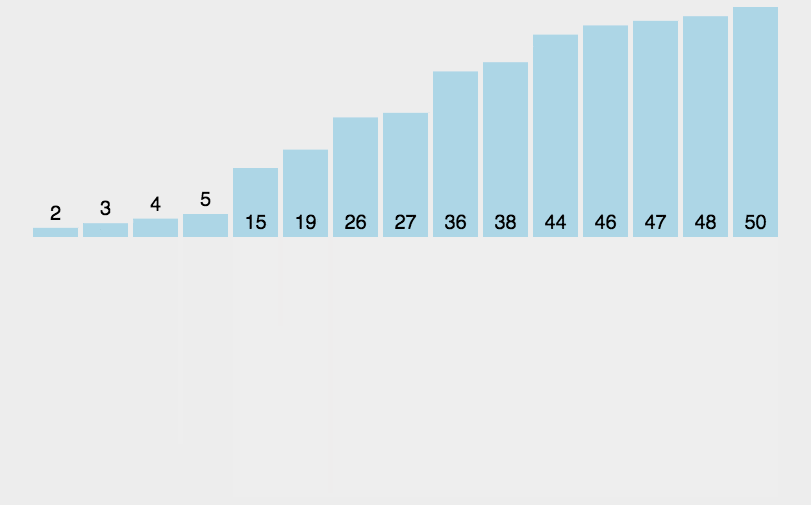
算法实现
void merge(int arr[], int left, int mid, int right) {
    int n1 = mid - left + 1;    // 左子数组大小
    int n2 = right - mid;       // 右子数组大小
    // 创建临时数组
    int L[n1], R[n2];
    for (int i = 0; i < n1; i++) L[i] = arr[left + i];
    for (int j = 0; j < n2; j++) R[j] = arr[mid + 1 + j];
    // 合并临时数组
    int i = 0, j = 0, k = left;
    while (i < n1 && j < n2) {
        if (L[i] <= R[j]) arr[k++] = L[i++];  // 稳定性关键:<=
        else arr[k++] = R[j++];
    }
    // 复制剩余元素
    while (i < n1) arr[k++] = L[i++];
    while (j < n2) arr[k++] = R[j++];
}
void mergeSort(int arr[], int left, int right) {
    if (left < right) {
        int mid = left + (right - left) / 2;  // 防溢出
        mergeSort(arr, left, mid);     // 递归左半部
        mergeSort(arr, mid + 1, right); // 递归右半部
        merge(arr, left, mid, right);   // 合并结果
    }
}
// 调用示例
int main() {
    int arr[] = {12, 11, 13, 5, 6, 7};
    int n = sizeof(arr)/sizeof(arr[0]);
    mergeSort(arr, 0, n-1);
}
关键特性分析
| 特性 | 说明 |
|---|---|
| 时间复杂度 | 最优/最差/平均:O(nlogn) (递归树深度logn,每层合并O(n)) |
| 空间复杂度 | O(n) (需额外存储空间) |
| 稳定性 | 稳定 (合并时使用<=保证相等元素顺序不变) |
| 适用场景 | 大规模数据排序、链表排序、外部排序、需要稳定性的场景 |
七.快速排序
快速排序是20世纪最重要的算法发明之一,由Tony Hoare于1959年提出。它采用分治策略,通过递归地将数据分解为较小和较大的子序列来实现排序,其平均时间复杂度为O(n log n),被誉为"排序算法之王"。
核心思想与分区过程
1. 算法三要素
- 基准值(Pivot)选择:通常选择第一个/最后一个/随机元素
- 分区(Partition):将数组分为两个子数组
- 递归:对子数组重复上述过程
2. Lomuto分区方案(易于理解)
3. Hoare分区方案(原始版本,效率更高)
动图演示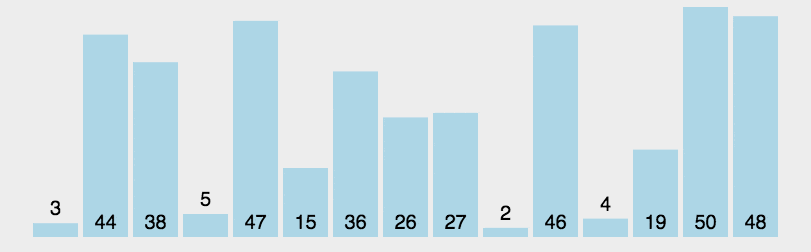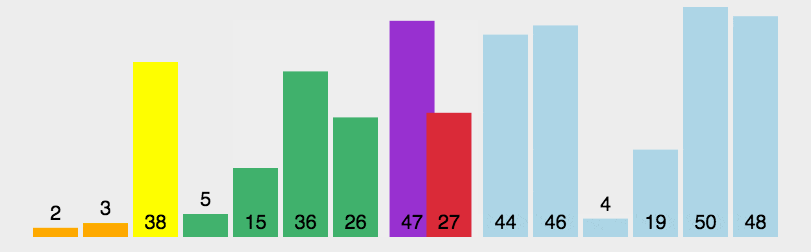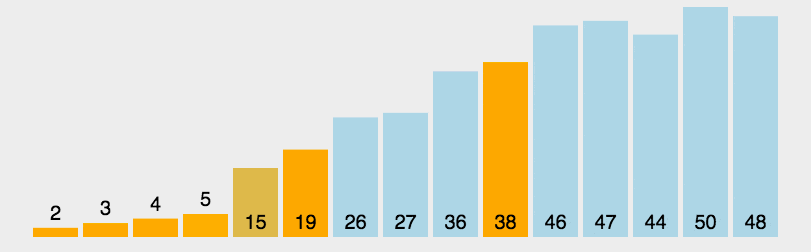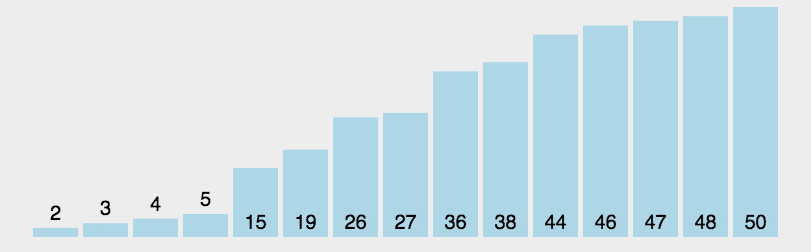
完整C++实现
#pragma once
#include <vector>
#include <algorithm>
// Lomuto分区方案
int partition(std::vector<int>& arr, int low, int high) {
    int pivot = arr[high];
    int i = low - 1;
    for (int j = low; j < high; j++) {
        if (arr[j] < pivot) {
            i++;
            std::swap(arr[i], arr[j]);
        }
    }
    std::swap(arr[i+1], arr[high]);
    return i + 1;
}
// 快速排序主函数
void quickSort(std::vector<int>& arr, int low, int high) {
    if (low < high) {
        int pi = partition(arr, low, high);
        quickSort(arr, low, pi - 1);
        quickSort(arr, pi + 1, high);
    }
}关键特性分析
| 特性 | 说明 |
|---|---|
| 时间复杂度 | 最优/平均:O(nlogn) 最差(已排序数组):O(n^2) |
| 空间复杂度 | O(logn)(递归栈空间) |
| 稳定性 | 不稳定(交换会改变相等元素顺序) |
| 适用场景 | 通用排序、内存敏感环境、需要平均性能最优的情况 |
八.堆排序
堆排序是一种基于二叉堆(Binary Heap)数据结构的比较型排序算法,由J. W. J. Williams于1964年提出。它结合了插入排序和归并排序的优点,具有O(n log n)的时间复杂度和O(1)的空间复杂度。
核心概念
1. 二叉堆特性
- 完全二叉树:除最后一层外所有层都被填满,最后一层从左到右填充
- 堆序性质:
- 大顶堆:父节点值 ≥ 子节点值(用于升序排序)
- 小顶堆:父节点值 ≤ 子节点值(用于降序排序)
2. 数组表示
// 索引关系:
Parent(i) = (i-1)/2
LeftChild(i) = 2*i + 1
RightChild(i) = 2*i + 2算法步骤
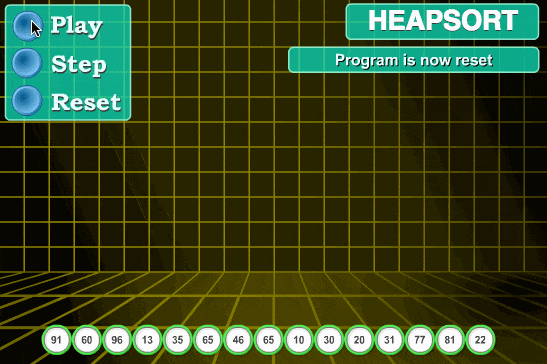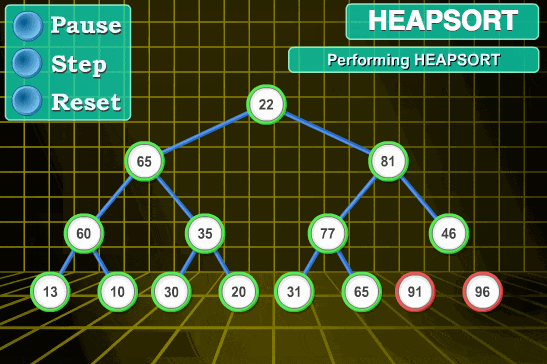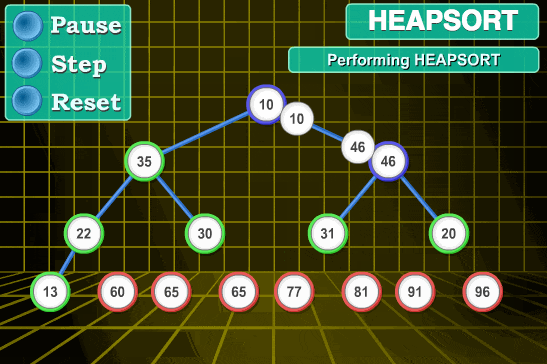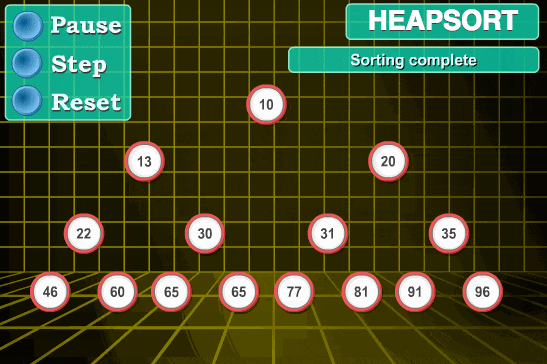
- 构建最大堆:将无序数组转为大顶堆
- 堆排序:
- 交换堆顶(最大值)与末尾元素
- 减小堆尺寸,重新堆化
- 重复直到堆尺寸为1
动图演示
 编辑
C++实现
#include <iostream>
#include <vector>
using namespace std;
// 堆化函数(大顶堆)
void heapify(vector<int>& arr, int n, int i) {
    int largest = i;       // 初始化最大值为根节点
    int left = 2*i + 1;    // 左子节点索引
    int right = 2*i + 2;   // 右子节点索引
    // 比较左子节点
    if (left < n && arr[left] > arr[largest])
        largest = left;
    // 比较右子节点
    if (right < n && arr[right] > arr[largest])
        largest = right;
    // 如果最大值不是根节点
    if (largest != i) {
        swap(arr[i], arr[largest]); // 交换
        heapify(arr, n, largest);   // 递归堆化子树
    }
}
// 堆排序主函数
void heapSort(vector<int>& arr) {
    int n = arr.size();
    // 构建最大堆(从最后一个非叶子节点开始)
    for (int i = n/2 - 1; i >= 0; i--)
        heapify(arr, n, i);
    // 逐个提取元素
    for (int i = n-1; i > 0; i--) {
        swap(arr[0], arr[i]);  // 移动当前根到末尾
        heapify(arr, i, 0);    // 在减少的堆上重新堆化
    }
}
// 测试代码
int main() {
    vector<int> arr = {12, 11, 13, 5, 6, 7};
    cout << "原始数组: ";
    for (int num : arr) cout << num << " ";
    heapSort(arr);
    cout << "\n排序后数组: ";
    for (int num : arr) cout << num << " ";
    return 0;
}四、时间复杂度分析
| 操作 | 时间复杂度 | 说明 |
|---|---|---|
| 建堆过程 | O(n) | 看似O(n log n)实际可证明为O(n) |
| 堆调整过程 | O(log n) | 树的高度 |
| 整体排序 | O(n log n) | 执行n次堆调整操作 |
空间复杂度:O(1)(原地排序)
算法特性
| 特性 | 说明 |
|---|---|
| 稳定性 | 不稳定(交换操作可能改变相等元素的顺序) |
| 适用性 | 大数据量、内存受限环境 |
| 优点 | 时间复杂度稳定O(n log n)、空间效率高(原地排序) |
| 缺点 | 缓存不友好(跳跃访问内存)、不适合链表结构 |
九.计数排序
计数排序(Counting Sort)是一种非基于比较的整数排序算法,通过统计元素频次实现线性时间复杂度排序,适用于数据范围有限且为整数的场景。以下是其核心要点:
核心原理
-
统计频次
扫描数组,统计每个元素出现的次数,存储在计数数组count中,其中count[i]表示值为i的元素出现次数。 -
累加计数
对计数数组进行前缀和操作,使count[i]表示小于等于i的元素总数,确定元素在有序序列中的位置。 -
反向填充
从原数组末尾开始,根据count数组将元素放入输出数组的指定位置,并更新count值以保证稳定性(相等元素的原始顺序不变)。
动图演示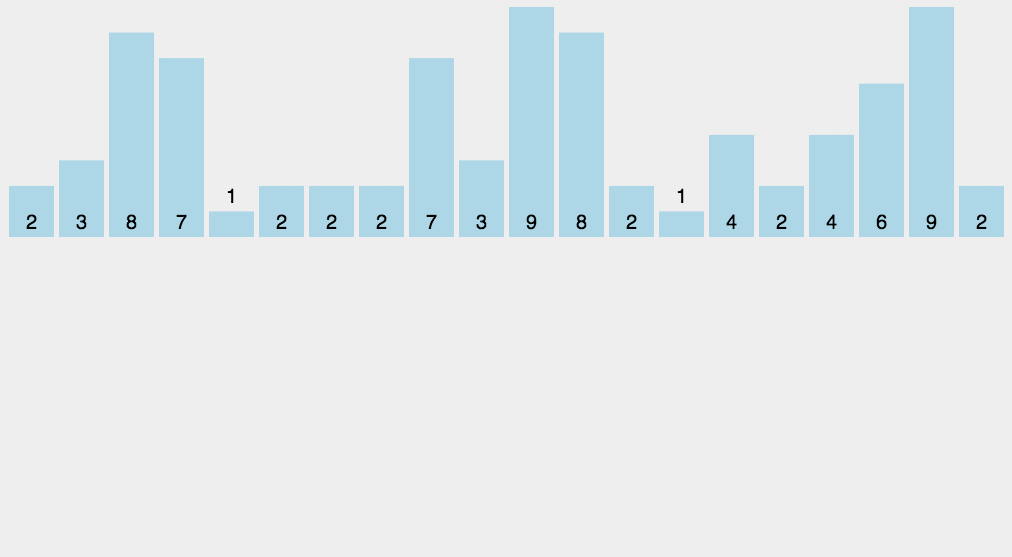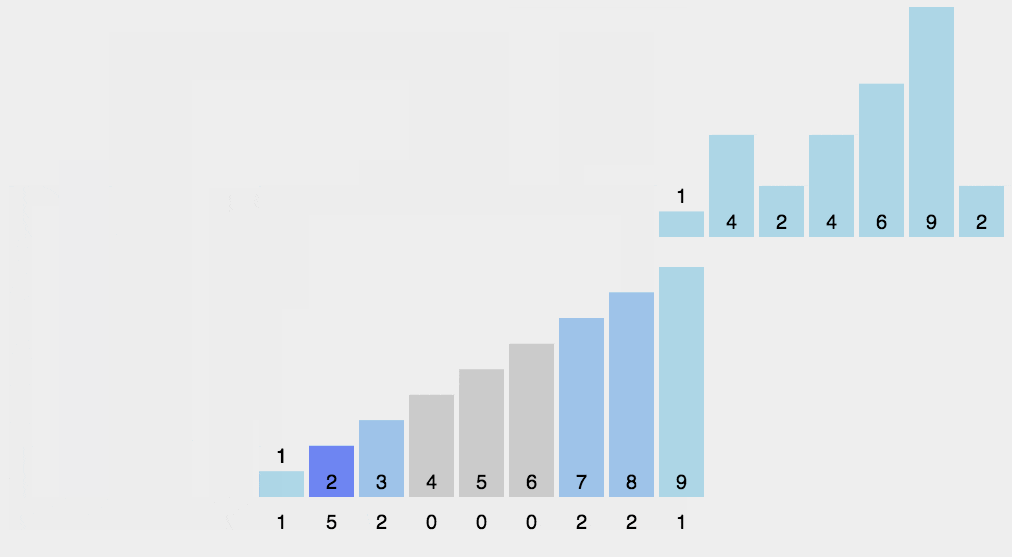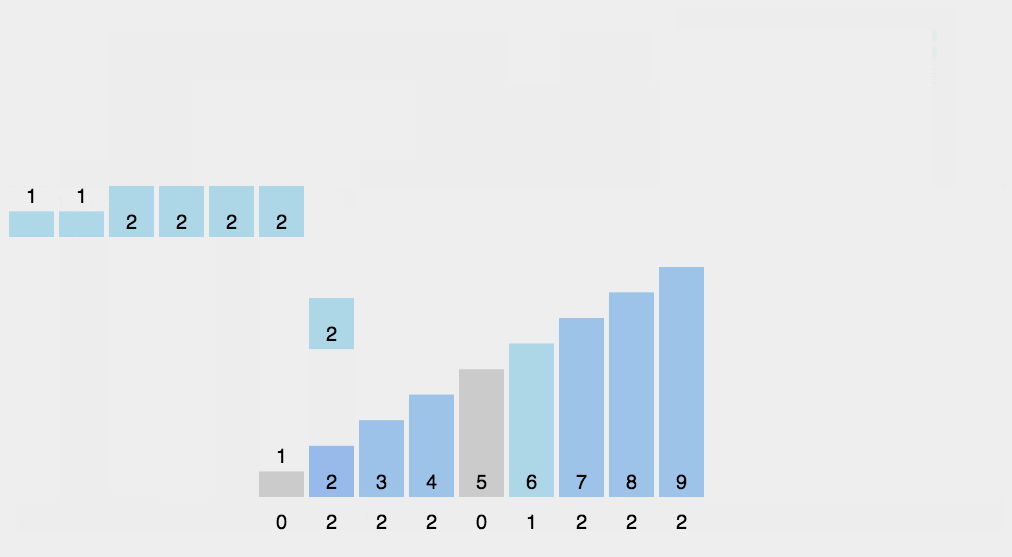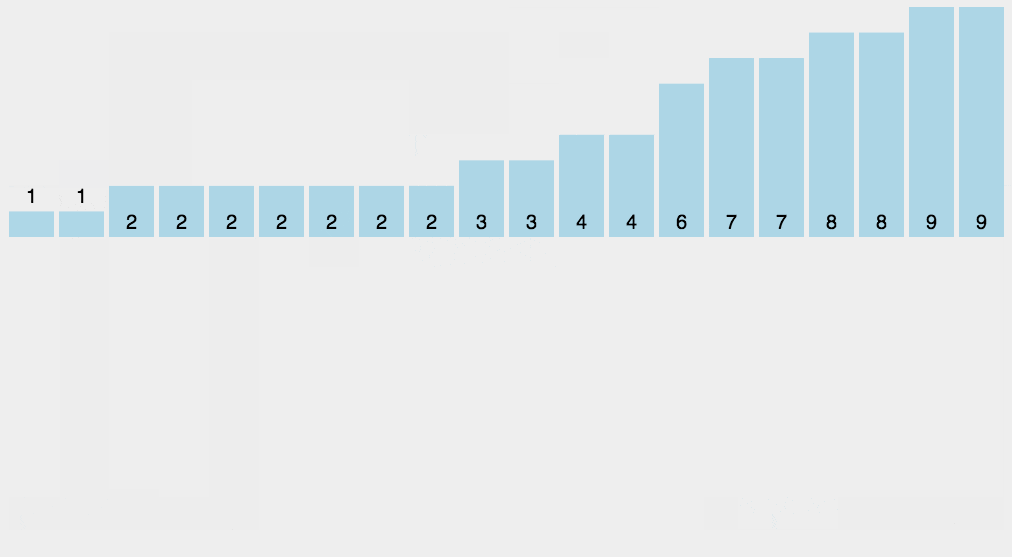
时间复杂度与空间复杂度
| 指标 | 值 | 说明 |
|---|---|---|
| 时间复杂度 | O(n+k) | n 为元素数量,k 为数据范围(最大值-最小值) |
| 空间复杂度 | O(n+k) | 需额外空间存储计数数组和输出数组 |
| 稳定性 | 稳定 | 反向填充保证相等元素的原始顺序 |
适用场景与限制
- 适用场景
- 整数排序,且数据范围
k远小于数据量n(如年龄、分数统计) - 需要稳定排序且空间充足时
- 整数排序,且数据范围
- 限制
- 仅适用于整数(或可映射到整数的数据)
- 数据范围
k过大时空间消耗高,效率低于比较排序(如 k>n log n)
C++代码实现
#include <vector>
#include <algorithm>
void countingSort(std::vector<int>& arr) {
    if (arr.empty()) return;
    // 1. 确定数据范围 [min, max]
    int min_val = *std::min_element(arr.begin(), arr.end());
    int max_val = *std::max_element(arr.begin(), arr.end());
    int range = max_val - min_val + 1;
    // 2. 统计频次
    std::vector<int> count(range, 0);
    for (int num : arr)
        count[num - min_val]++;
    // 3. 累加计数(前缀和)
    for (int i = 1; i < range; i++)
        count[i] += count[i - 1];
    // 4. 反向填充输出数组
    std::vector<int> output(arr.size());
    for (int i = arr.size() - 1; i >= 0; i--) {
        int pos = count[arr[i] - min_val] - 1; // 计算位置
        output[pos] = arr[i];
        count[arr[i] - min_val]--; // 更新计数
    }
    arr = output; // 写回原数组
}十.桶排序
桶排序是一种基于分治思想的非比较型排序算法,通过数据分桶、桶内排序和多桶合并实现高效排序。以下是其核心要点:
核心原理
-
数据分桶
- 创建有限数量的桶(通常设为数据范围除以桶数),每个桶对应一定数据区间
- 通过映射函数
f(x)将元素分配到对应桶中(如f(x)=x/10)
-
桶内排序
- 对每个非空桶单独排序(常用插入/快速排序或递归桶排序)
- 桶内元素较少时可直接采用简单排序算法
-
合并结果
- 按桶编号顺序(0→K)依次输出所有桶内元素
- 合并过程保持桶内元素的相对顺序
时间复杂度与空间复杂度
| 指标 | 值 | 说明 |
|---|---|---|
| 最优时间复杂度 | O(n) | 数据均匀分布且桶内使用线性排序时 |
| 平均时间复杂度 | O(n+k) | n为元素数,k为桶数(需满足 k≈n) |
| 最差时间复杂度 | O(n^2) | 所有元素集中在一个桶内时退化 |
| 空间复杂度 | O(n+k) | 需存储桶结构和排序结果空间 |
稳定性:稳定(映射和合并过程保持元素原始顺序)
适用场景与限制
-
适用场景
- 数据均匀分布(如[0,1)区间的随机实数)
- 数据范围已知且有限(如年龄统计、分数排序)
- 外部排序(数据量超过内存容量时)
-
限制
- 数据分布不均匀时性能严重下降
- 需要预知数据范围以合理设置桶数
- 整数或可映射到整数的数据类型
C++实现示例
#include <vector>
#include <algorithm>
#include <cmath>
void bucketSort(std::vector<float>& arr) {
    if (arr.empty()) return;
    // 1. 初始化桶(数量=√n)
    int bucketNum = sqrt(arr.size());
    std::vector<std::vector<float>> buckets(bucketNum + 1);
    // 2. 计算数据范围
    float max_val = *max_element(arr.begin(), arr.end());
    float min_val = *min_element(arr.begin(), arr.end());
    float range = (max_val - min_val) / bucketNum;
    // 3. 元素分桶
    for (float num : arr) {
        int index = (num - min_val) / range;  // 映射函数
        buckets[index].push_back(num);
    }
    // 4. 桶内排序(使用快速排序)
    for (auto& bucket : buckets) {
        std::sort(bucket.begin(), bucket.end());
    }
    // 5. 合并结果
    int idx = 0;
    for (const auto& bucket : buckets) {
        for (float num : bucket) {
            arr[idx++] = num;
        }
    }
}
十一.基数排序
基数排序是一种基于关键字各位值的非比较型整数排序算法,通过逐位分配与收集实现线性时间复杂度排序,适用于固定长度或可映射为整数的数据类型。
核心原理
-
按位分配
- 从最低位(LSD)或最高位(MSD)开始,根据当前位的值(0-9)将元素分配到对应的10个桶中。
- 示例:数字53的个位为3,分配到3号桶;十位为5,分配到5号桶。
-
按序收集
- 按桶编号顺序(0→9)收集桶内元素,形成新的序列。
- 稳定性保证:同桶内元素保持原始顺序(先进先出)。
-
高位迭代
- 重复上述过程,直至处理完最高位(LSD)或最低位(MSD),最终得到有序序列。
动图演示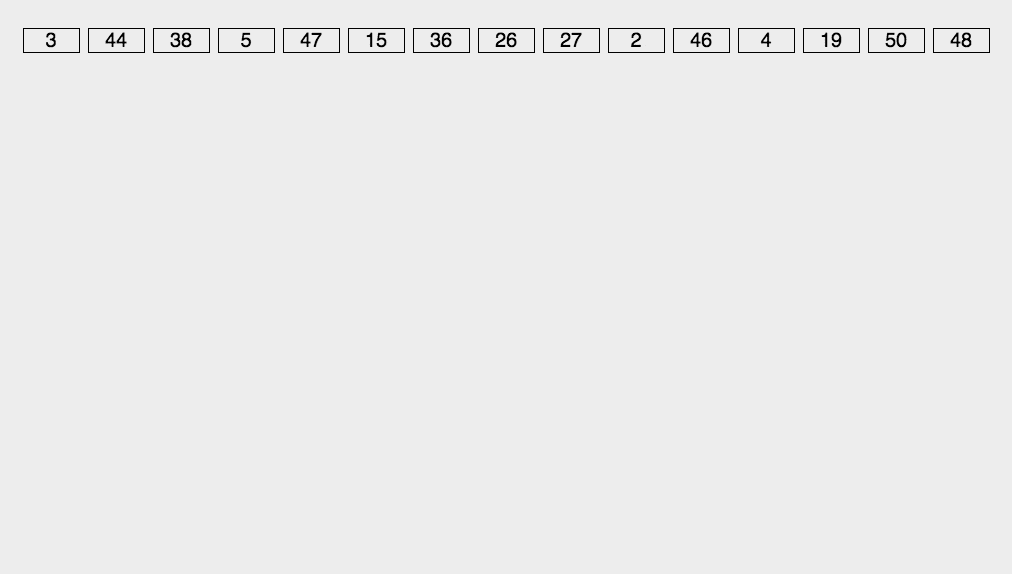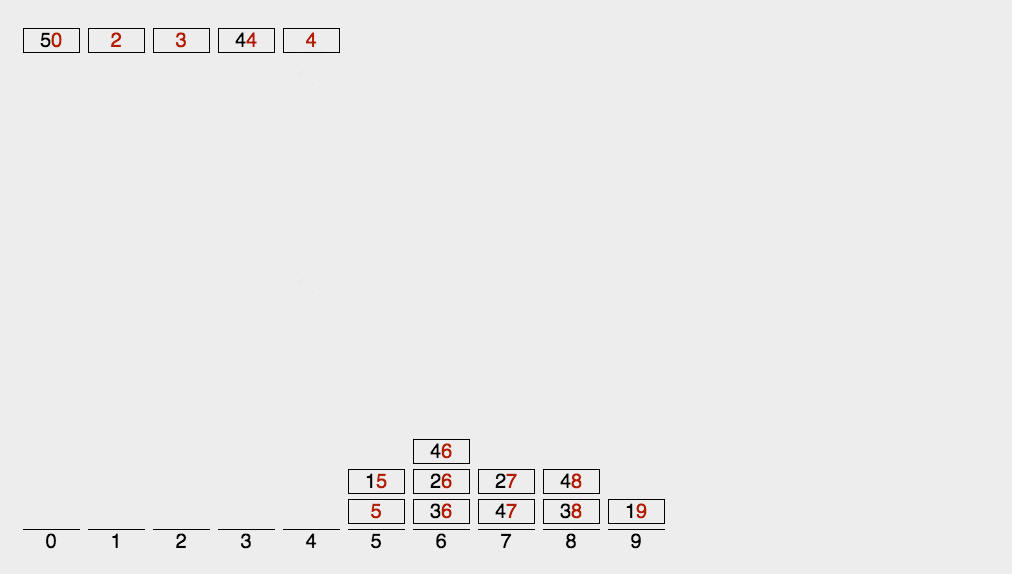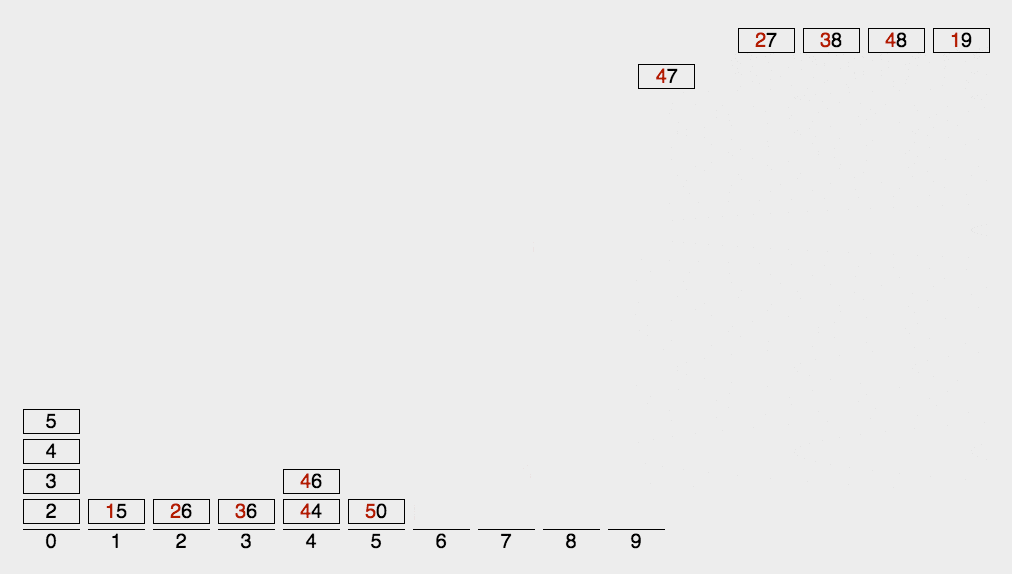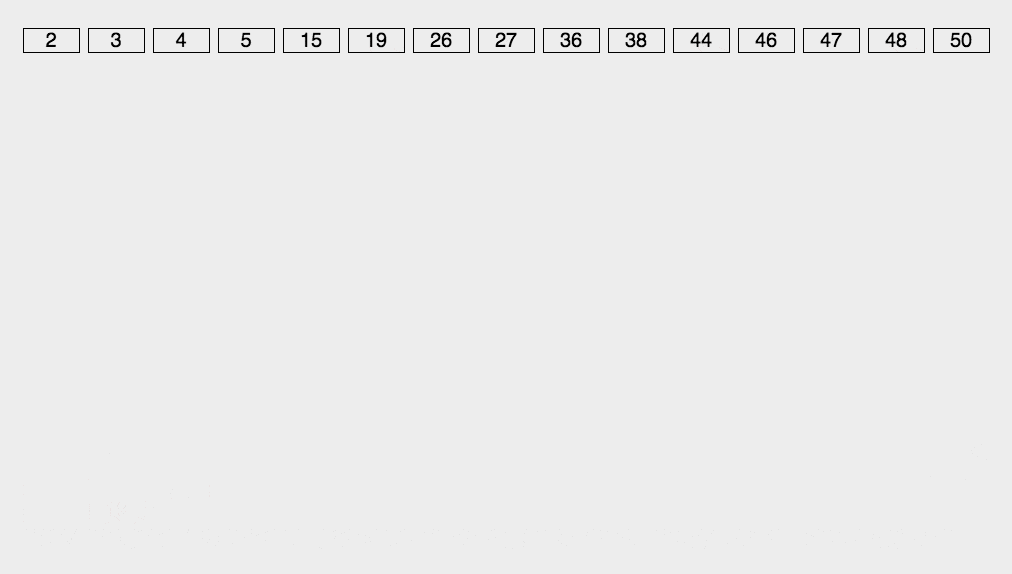
时间复杂度与空间复杂度
| 指标 | 值 | 说明 |
|---|---|---|
| 时间复杂度 | O(n×k) | n 为元素数量,k 为最大位数 |
| 空间复杂度 | O(n+10) | 需额外存储桶(10个桶)和临时数组 |
| 稳定性 | 稳定 | 分配收集过程不改变相同元素的相对顺序 |
适用场景与限制
-
适用场景
- 固定长度整数(如身份证号、电话号码)
- 字符串排序(需统一长度或高位补零)
- 数据范围大但位数较少时(如百万级数据最大位数为6)
-
限制
- 仅适用于可逐位分解的数据类型(整数、定长字符串)
- 数据位数差异大时需高位补零,可能增加计算开销
LSD实现示例(C++)
#include <vector>
#include <algorithm>
// 获取数组中最大值
int getMax(std::vector<int>& arr) {
    return *std::max_element(arr.begin(), arr.end());
}
// 基数排序核心
void radixSort(std::vector<int>& arr) {
    int max_val = getMax(arr);
    for (int exp = 1; max_val / exp > 0; exp *= 10) {  // 从个位到最高位
        std::vector<int> output(arr.size());
        std::vector<int> count(10, 0);  // 10个桶的计数器
        // 统计当前位各数字出现次数
        for (int num : arr)
            count[(num / exp) % 10]++;
        // 计算累计位置(确定元素输出索引)
        for (int i = 1; i < 10; i++)
            count[i] += count[i - 1]
        // 反向填充保证稳定性
        for (int i = arr.size() - 1; i >= 0; i--) {
            int digit = (arr[i] / exp) % 10;
            output[count[digit] - 1] = arr[i];
            count[digit]--;
        }
        arr = output;
    }
}LSD vs MSD
| 特性 | LSD(最低位优先) | MSD(最高位优先) |
|---|---|---|
| 实现难度 | 简单(统一位数处理) | 复杂(需递归处理子桶) |
| 适用性 | 更通用(适合整数和定长字符串) | 适合变长字符串(如单词字典序) |
| 性能 | 稳定O(n*k) | 最差可能退化为O(n^2) |
总结:
| 算法 | 最佳场景 | 限制条件 |
|---|---|---|
| 冒泡排序 | 小规模数据或基本有序序列 | 数据量大时效率低 |
| 选择排序 | 内存敏感的小数据量排序 | 不稳定,数据量大时效率低 |
| 插入排序 | 小规模数据或部分有序序列 | 大规模数据效率低 |
| 希尔排序 | 中等规模数据 | 时间复杂度依赖增量序列 |
| 归并排序 | 大数据外部排序、稳定排序需求 | 空间复杂度高 |
| 快速排序 | 通用随机数据、缓存友好场景 | 最坏情况退化为O(n²) |
| 堆排序 | 内存敏感的大数据排序 | 不稳定,缓存局部性差 |
| 计数排序 | 小范围整数排序(如年龄、分数) | 仅限整数,数据范围大时空间消耗高 |
| 桶排序 | 均匀分布的浮点数排序(如[0,1)区间) | 数据倾斜时性能下降 |
| 基数排序 | 固定长度整数/字符串排序(如身份证号) | 仅适用于可逐位分解的数据类型 |
- 冒泡排序
相邻元素交换,大元素逐渐后移(如气泡上浮)。 - 选择排序
每次选择最小/大元素放入已排序序列末尾 。 - 插入排序
将未排序元素插入已排序序列的合适位置 。 - 希尔排序
分组插入排序,逐步缩小间隔增量 。 - 归并排序
分治法:拆分→排序→合并有序子序列 。 - 快速排序
分治法:选基准→分区→递归排序子序列 。 - 堆排序
构建大/小顶堆,交换堆顶与末尾元素并调整 。 - 计数排序
统计元素频次→累加计数→反向填充 。 - 桶排序
数据分桶→桶内排序→按序合并 。 - 基数排序
按位分配桶(LSD/MSD)→按序收集→高位迭代 。
资料只下载了图片,其他的都是作者自己打的,能点个赞吗?球球了。

 浙公网安备 33010602011771号