
C++二分详解
 二分查找是一种高效的搜索算法,适用于有序数组。其核心思想是通过每次将搜索范围缩小一半来快速定位目标元素,时间复杂度为O(logn)。文章详细介绍了二分查找的基本原理、C++实现(包括迭代和递归版本)、标准库函数(binary_search、lower_bound等)以及常见变体应用(如查找边界值)。同时通过多个编程例题(搜索插入位置、寻找峰值等)展示了二分查找的实际应用场景和解题思路。文章还探讨了二分查找的局限性、浮点数二分和二分答案等进阶用法,帮助读者全面掌握这一重要算法。
二分查找的基本概念
二分查找(Binary Search)是一种高效的搜索算法,其核心思想是将搜索范围每次缩小一半,直到找到目标元素或确定目标元素不存在。这种算法要求被搜索的数据必须是有序的(例如升序排列)。与线性查找(逐个检查元素)相比,二分查找的时间复杂度为 O (log n),这使得它在处理大量数据时效率极高。
底层逻辑与工作原理
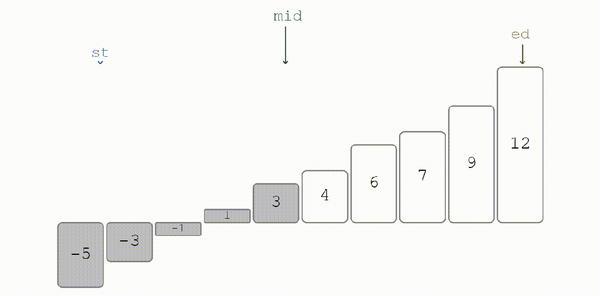
二分查找的工作流程如下:
- 确定搜索范围:初始时,搜索范围是整个有序数组。
- 选择中间元素:计算当前搜索范围的中间位置,并获取该位置的元素。
- 比较中间元素与目标值:
- 如果中间元素等于目标值,则搜索成功,返回中间元素的位置。
- 如果中间元素大于目标值,由于数组有序,目标值只能存在于左半部分,因此将搜索范围缩小到左半部分。
- 如果中间元素小于目标值,目标值只能存在于右半部分,因此将搜索范围缩小到右半部分。
- 重复步骤 2-3:直到找到目标值或搜索范围为空(即左边界大于右边界)。
图例:

C++ 实现示例
下面是使用普通静态数组实现的二分查找代码:
#include <iostream>
// 二分查找函数 - 迭代实现
int binarySearch(const int arr[], int size, int target) {
    int left = 0;                   // 左边界
    int right = size - 1;           // 右边界
    while (left <= right) {
        int mid = left + (right - left) / 2;  // 计算中间位置,避免整数溢出
        if (arr[mid] == target) {
            return mid;             // 找到目标值,返回索引
        } else if (arr[mid] > target) {
            right = mid - 1;        // 目标在左半部分
        } else {
            left = mid + 1;         // 目标在右半部分
        }
    }
    return -1;                      // 未找到目标值
}
int main() {
    // 有序静态数组示例
    int arr[] = {2, 4, 6, 8, 10, 12, 14, 16};
    int size = sizeof(arr) / sizeof(arr[0]);  // 计算数组大小
    int target = 10;
    int result = binarySearch(arr, size, target);
    if (result != -1) {
        std::cout << "元素 " << target << " 在数组中的索引是: " << result << std::endl;
    } else {
        std::cout << "元素 " << target << " 不在数组中" << std::endl;
    }
    return 0;
}
关键点解析
-
避免整数溢出:计算中间位置时使用
mid = left + (right - left) / 2而非mid = (left + right) / 2,可以防止当left和right都很大时发生整数溢出。 -
循环条件:使用
left <= right作为循环条件,确保当搜索范围缩小到只剩一个元素时仍能正确检查。 -
边界更新:每次迭代后,通过调整
left或right将搜索范围缩小一半。 -
静态数组处理:
- 静态数组需要显式传递数组大小
- 使用
sizeof(arr) / sizeof(arr[0])计算数组元素个数 - 不支持动态扩展,需要预先确定数组大小
递归实现
// 二分查找函数 - 递归实现
int binarySearchRecursive(const int arr[], int left, int right, int target) {
    if (left > right) {
        return -1;  // 搜索范围为空,未找到
    }
    int mid = left + (right - left) / 2;
    if (arr[mid] == target) {
        return mid;  // 找到目标值
    } else if (arr[mid] > target) {
        return binarySearchRecursive(arr, left, mid - 1, target);  // 搜索左半部分
    } else {
        return binarySearchRecursive(arr, mid + 1, right, target);  // 搜索右半部分
    }
}
适用场景
二分查找适用于以下情况:
- 数据有序:必须是有序数组或类似结构。
- 静态数据:数据不经常变动,因为插入和删除操作可能破坏有序性,需要额外维护成本。
- 大量数据:当数据量很大时,二分查找的效率优势明显。
常见应用
- 在数据库索引中快速查找记录
- 在配置文件中查找特定参数
- 数值计算中的根查找问题
- 游戏开发中的碰撞检测优化
局限性
- 要求数据有序,维护有序性可能有额外开销
- 只适用于随机访问的数据结构(如数组),不适用于链表等顺序访问结构
- 对于小规模数据,线性查找可能更简单直接
通过理解二分查找的底层逻辑并掌握其实现,你可以在处理有序数据时高效地定位目标元素,大幅提升程序性能。
C++ 标准库中的二分查找函数
C++ 标准库提供了几个与二分查找相关的函数,这些函数位于<algorithm>头文件中,使用这些函数可以更方便地实现二分查找相关操作。
1. std::binary_search
该函数用于判断一个元素是否存在于有序序列中,返回一个布尔值。
#include <iostream>
#include <algorithm>
int main() {
int arr[] = {2, 4, 6, 8, 10, 12, 14, 16};
int size = sizeof(arr) / sizeof(arr[0]);
int target = 10;
// 使用std::binary_search查找元素
bool found = std::binary_search(arr, arr + size, target);
if (found) {
std::cout << "元素 " << target << " 存在于数组中" << std::endl;
} else {
std::cout << "元素 " << target << " 不存在于数组中" << std::endl;
}
return 0;
}2. std::lower_bound
该函数用于查找有序序列中第一个不小于(即大于或等于)给定值的元素的迭代器。如果所有元素都小于给定值,则返回尾后迭代器。
#include <iostream>
#include <algorithm>
int main() {
    int arr[] = {2, 4, 6, 8, 10, 12, 14, 16};
    int size = sizeof(arr) / sizeof(arr[0]);
    int target = 9;
    // 使用std::lower_bound查找第一个不小于target的元素
    int* it = std::lower_bound(arr, arr + size, target);
    if (it != arr + size) {
        std::cout << "第一个不小于 " << target << " 的元素是: " << *it << std::endl;
        std::cout << "其索引是: " << (it - arr) << std::endl;
    } else {
        std::cout << "所有元素都小于 " << target << std::endl;
    }
    return 0;
}
3. std::upper_bound
该函数用于查找有序序列中第一个大于给定值的元素的迭代器。如果所有元素都不大于给定值,则返回尾后迭代器。
#include <iostream>
#include <algorithm>
int main() {
    int arr[] = {2, 4, 6, 8, 10, 12, 14, 16};
    int size = sizeof(arr) / sizeof(arr[0]);
    int target = 10;
    // 使用std::upper_bound查找第一个大于target的元素
    int* it = std::upper_bound(arr, arr + size, target);
    if (it != arr + size) {
        std::cout << "第一个大于 " << target << " 的元素是: " << *it << std::endl;
        std::cout << "其索引是: " << (it - arr) << std::endl;
    } else {
        std::cout << "没有元素大于 " << target << std::endl;
    }
    return 0;
}
4. std::equal_range
该函数返回一个std::pair,其中first是std::lower_bound的结果,second是std::upper_bound的结果,用于确定有序序列中所有等于给定值的元素范围。
#include <iostream>
#include <algorithm>
int main() {
    int arr[] = {2, 4, 6, 8, 10, 10, 12, 14, 16};
    int size = sizeof(arr) / sizeof(arr[0]);
    int target = 10;
    // 使用std::equal_range查找所有等于target的元素范围
    auto range = std::equal_range(arr, arr + size, target);
    if (range.first != range.second) {
        std::cout << "找到 " << (range.second - range.first)
                  << " 个等于 " << target << " 的元素" << std::endl;
        std::cout << "范围是从索引 " << (range.first - arr)
                  << " 到 " << (range.second - arr - 1) << std::endl;
    } else {
        std::cout << "没有找到等于 " << target << " 的元素" << std::endl;
    }
    return 0;
}
二分查找例题与解题思路
例题 1:搜索插入位置
题目描述:给定一个排序数组和一个目标值,在数组中找到目标值,并返回其索引。如果目标值不存在于数组中,返回它将会被按顺序插入的位置。
解题思路:这道题本质上就是二分查找,只是在未找到目标值时,返回的插入位置是第一个大于目标值的位置(即std::lower_bound的结果)。
代码实现:
#include <iostream>
int searchInsert(int nums[], int size, int target) {
    int left = 0;
    int right = size - 1;
    while (left <= right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] == target) {
            return mid;
        } else if (nums[mid] > target) {
            right = mid - 1;
        } else {
            left = mid + 1;
        }
    }
    // 未找到目标值时,left即为插入位置
    return left;
}
int main() {
    int nums[] = {1, 3, 5, 6};
    int size = sizeof(nums) / sizeof(nums[0]);
    int target = 5;
    std::cout << "目标值 " << target << " 的插入位置是: " << searchInsert(nums, size, target) << std::endl;
    target = 2;
    std::cout << "目标值 " << target << " 的插入位置是: " << searchInsert(nums, size, target) << std::endl;
    return 0;
}
例题 2:第一个错误的版本
题目描述:你是产品经理,目前正在带领一个团队开发新的产品。不幸的是,你的产品的最新版本没有通过质量检测。由于每个版本都是基于之前的版本开发的,所以错误的版本之后的所有版本都是错的。假设你有n个版本[1, 2, ..., n],你想找出导致之后所有版本出错的第一个错误的版本。你可以通过调用bool isBadVersion(version)接口来判断版本号version是否在单元测试中出错。实现一个函数来查找第一个错误的版本。你应该尽量减少对调用 API 的次数。
解题思路:这是一个典型的二分查找应用,目标是找到第一个满足条件的元素(即第一个错误的版本)。我们可以使用二分查找来缩小搜索范围,直到找到该元素。
代码实现:
// 假设这是题目提供的API
bool isBadVersion(int version);
int firstBadVersion(int n) {
    int left = 1;
    int right = n;
    while (left < right) {
        int mid = left + (right - left) / 2;
        if (isBadVersion(mid)) {
            // mid是错误版本,第一个错误版本可能是mid或更早
            right = mid;
        } else {
            // mid不是错误版本,第一个错误版本在mid之后
            left = mid + 1;
        }
    }
    // 循环结束时,left和right指向同一个位置,即为第一个错误版本
    return left;
}
例题 3:寻找峰值
题目描述:峰值元素是指其值大于左右相邻值的元素。给定一个输入数组nums,其中nums[i] ≠ nums[i+1],找到峰值元素并返回其索引。数组可能包含多个峰值,在这种情况下,返回任何一个峰值所在位置即可。你可以假设nums[-1] = nums[n] = -∞。
解题思路:虽然数组不是完全有序的,但我们可以利用二分查找的思想。如果中间元素大于其右侧元素,那么峰值一定在左侧(包括中间元素);否则峰值一定在右侧。这样每次可以将搜索范围缩小一半。
代码实现:
#include <iostream>
int findPeakElement(int nums[], int size) {
    int left = 0;
    int right = size - 1;
    while (left < right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] > nums[mid + 1]) {
            // 峰值在左侧(包括mid)
            right = mid;
        } else {
            // 峰值在右侧
            left = mid + 1;
        }
    }
    // 循环结束时,left和right指向同一个位置,即为峰值
    return left;
}
int main() {
    int nums[] = {1, 2, 3, 1};
    int size = sizeof(nums) / sizeof(nums[0]);
    std::cout << "峰值元素的索引是: " << findPeakElement(nums, size) << std::endl;
    int nums2[] = {1, 2, 1, 3, 5, 6, 4};
    int size2 = sizeof(nums2) / sizeof(nums2[0]);
    std::cout << "峰值元素的索引是: " << findPeakElement(nums2, size2) << std::endl;
    return 0;
}
例题 4:搜索旋转排序数组
题目描述:整数数组nums按升序排列,数组中的值互不相同。在传递给函数之前,nums在预先未知的某个点上进行了旋转(例如,[0,1,2,4,5,6,7]经旋转后可能变为[4,5,6,7,0,1,2])。给你旋转后的数组nums和一个整数target,如果nums中存在这个目标值target,则返回它的索引,否则返回-1。
解题思路:虽然数组被旋转了,但我们可以观察到,数组的一部分仍然是有序的。因此,在每次二分查找时,我们可以先判断哪一部分是有序的,然后检查目标值是否在这个有序部分内。如果是,则在有序部分继续查找;否则在另一部分查找。
代码实现:
#include <iostream>
int search(int nums[], int size, int target) {
int left = 0;
int right = size - 1;
while (left <= right) {
int mid = left + (right - left) / 2;
if (nums[mid] == target) {
return mid;
}
// 判断左半部分是否有序
if (nums[left] <= nums[mid]) {
// 目标值在左半部分的有序区间内
if (nums[left] <= target && target < nums[mid]) {
right = mid - 1;
} else {
left = mid + 1;
}
}
// 右半部分有序
else {
// 目标值在右半部分的有序区间内
if (nums[mid] < target && target <= nums[right]) {
left = mid + 1;
} else {
right = mid - 1;
}
}
}
return -1;
}
int main() {
int nums[] = {4, 5, 6, 7, 0, 1, 2};
int size = sizeof(nums) / sizeof(nums[0]);
int target = 0;
std::cout << "目标值 " << target << " 的索引是: " << search(nums, size, target) << std::endl;
target = 3;
std::cout << "目标值 " << target << " 的索引是: " << search(nums, size, target) << std::endl;
return 0;
}
二分查找的变体与扩展
1. 查找左边界和右边界
在某些情况下,我们需要找到目标值在有序数组中的第一个出现位置(左边界)或最后一个出现位置(右边界)。
查找左边界:
int leftBound(const int nums[], int size, int target) {
    int left = 0;
    int right = size;  // 注意这里的右边界
    while (left < right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] >= target) {
            right = mid;
        } else {
            left = mid + 1;
        }
    }
    // 检查是否越界或目标值不存在
    if (left >= size || nums[left] != target) {
        return -1;
    }
    return left;
}查找右边界:
int rightBound(const int nums[], int size, int target) {
    int left = 0;
    int right = size;  // 注意这里的右边界
    while (left < right) {
        int mid = left + (right - left) / 2;

        if (nums[mid] <= target) {
            left = mid + 1;
        } else {
            right = mid;
        }
    }
    // 检查是否越界或目标值不存在
    if (left == 0 || nums[left - 1] != target) {
        return -1;
    }
    return left - 1;  // 注意这里返回left-1
}
2. 浮点数二分查找
当需要在浮点数范围内进行二分查找时,通常不需要严格判断相等,而是设置一个足够小的误差范围eps。
#include <cmath>
#include <stdexcept>
double sqrt(double x) {
    if (x < 0) {
        throw std::invalid_argument("Cannot compute square root of a negative number");
    }
    double left = 0.0;
    double right = std::max(x, 1.0);  // 处理x在0到1之间的情况
    double eps = 1e-10;  // 设置精度
    while (right - left > eps) {
        double mid = (left + right) / 2;
        if (mid * mid > x) {
            right = mid;
        } else {
            left = mid;
        }
    }
    return (left + right) / 2;
}
3. 二分答案
二分答案是一种将优化问题转化为判定问题的思想,通常用于求解满足某种条件的最大值或最小值。
例题:给定一个非负整数数组和一个整数m,你需要将这个数组分成m个非空的连续子数组。设计一个算法使得这m个子数组各自和的最大值最小。
解题思路:我们可以二分查找这个最小的最大值。对于一个候选值mid,判断是否可以将数组分成m个连续子数组,使得每个子数组的和不超过mid。如果可以,则尝试更小的候选值;否则尝试更大的候选值。
代码实现:
#include <iostream>
#include <numeric>
bool canSplit(const int nums[], int size, int m, int sumLimit) {
    int count = 1;
    int currentSum = 0;
    for (int i = 0; i < size; ++i) {
        if (currentSum + nums[i] > sumLimit) {
            count++;
            currentSum = nums[i];
            if (count > m) {
                return false;
            }
        } else {
            currentSum += nums[i];
        }
    }
    return true;
}
int splitArray(const int nums[], int size, int m) {
    int left = 0;
    for (int i = 0; i < size; ++i) {
        if (nums[i] > left) {
            left = nums[i];
        }
    }
    int right = std::accumulate(nums, nums + size, 0);
    while (left < right) {
        int mid = left + (right - left) / 2;
        if (canSplit(nums, size, m, mid)) {
            right = mid;
        } else {
            left = mid + 1;
        }
    }
    return left;
}
二分查找的应用领域
二分查找作为一种高效的算法,广泛应用于各种领域:
-
数据库系统:在数据库索引(如 B 树、B + 树)中使用二分查找快速定位记录。
-
搜索引擎:在倒排索引中查找关键词对应的文档列表。
-
数值计算:求解方程的根、优化问题等。
-
游戏开发:在碰撞检测、资源加载等场景中优化查找效率。
-
网络编程:在路由表查找、IP 地址匹配等操作中提高效率。
-
版本控制系统:如 Git 中的二分查找用于快速定位引入问题的提交。
-
数据压缩:在霍夫曼编码等算法中查找最优解。
-
人工智能:在超参数优化中使用二分查找确定最佳参数值。
总结
二分查找是一种高效的搜索算法,其核心思想是通过每次将搜索范围缩小一半来快速定位目标元素。掌握二分查找需要理解以下关键点:
- 有序性:二分查找要求数据必须是有序的。
- 边界处理:正确设置左右边界和循环条件,避免死循环和越界。
- 中间值计算:使用
mid = left + (right - left) / 2避免整数溢出。 - 变体应用:能够处理查找左边界、右边界、旋转数组等变体问题。
- 二分答案:将优化问题转化为判定问题,利用二分查找求解。
通过大量练习不同类型的二分查找题目,可以熟练掌握这种算法,并在实际应用中灵活运用,提高程序的性能和效率。无论是使用vector还是普通静态数组,二分查找的核心思想和实现逻辑都是一致的,只是在处理数组大小时略有不同。

 浙公网安备 33010602011771号