
SparkCore:累加器和广播变量
累加器
累加器(分布式共享只写变量):用来把 Executor 端变量信息聚合到 Driver 端。在 Driver 程序中定义的变量,在 Executor 端的每个 Task 都会得到这个变量的一份新的副本,每个 Task 更新这些副本的值之后,会传回 Driver 端进行 merge。
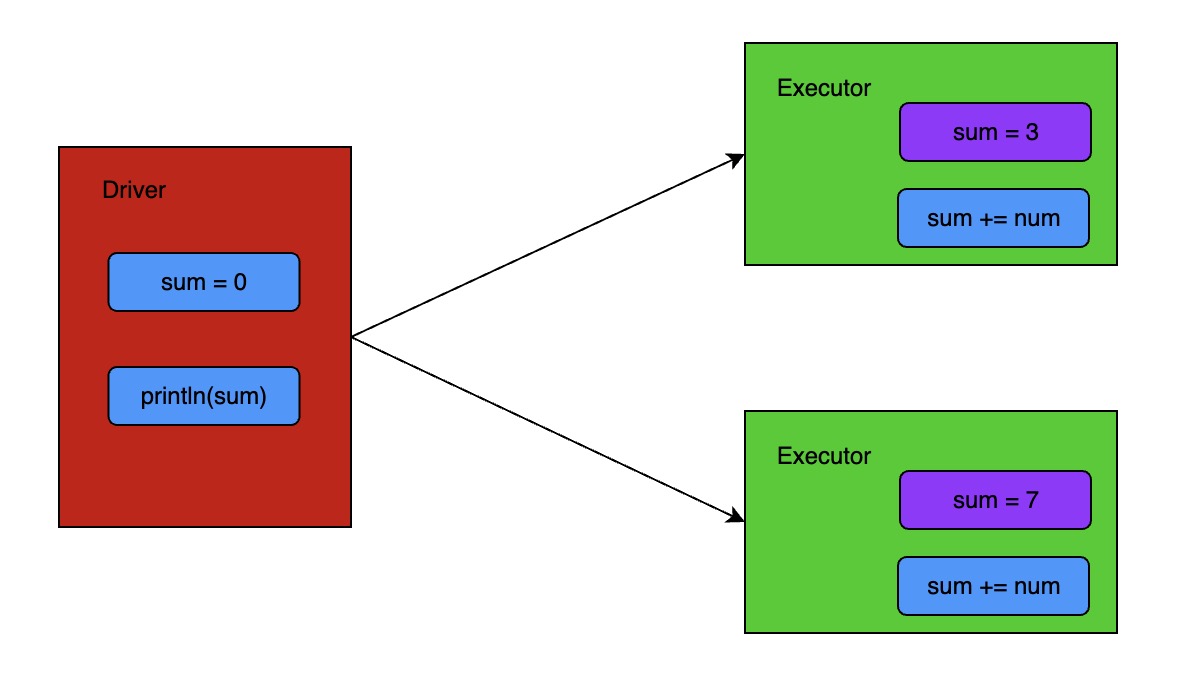
对 list(1,2,3,4) 进行普通的累加,Driver 端会将任务分给 Executor 端,Executor 端会对自己的数据进行累加,但是并不会将累加完的结果返回给 Driver 端。所以 Driver 端输出的结果为 0。
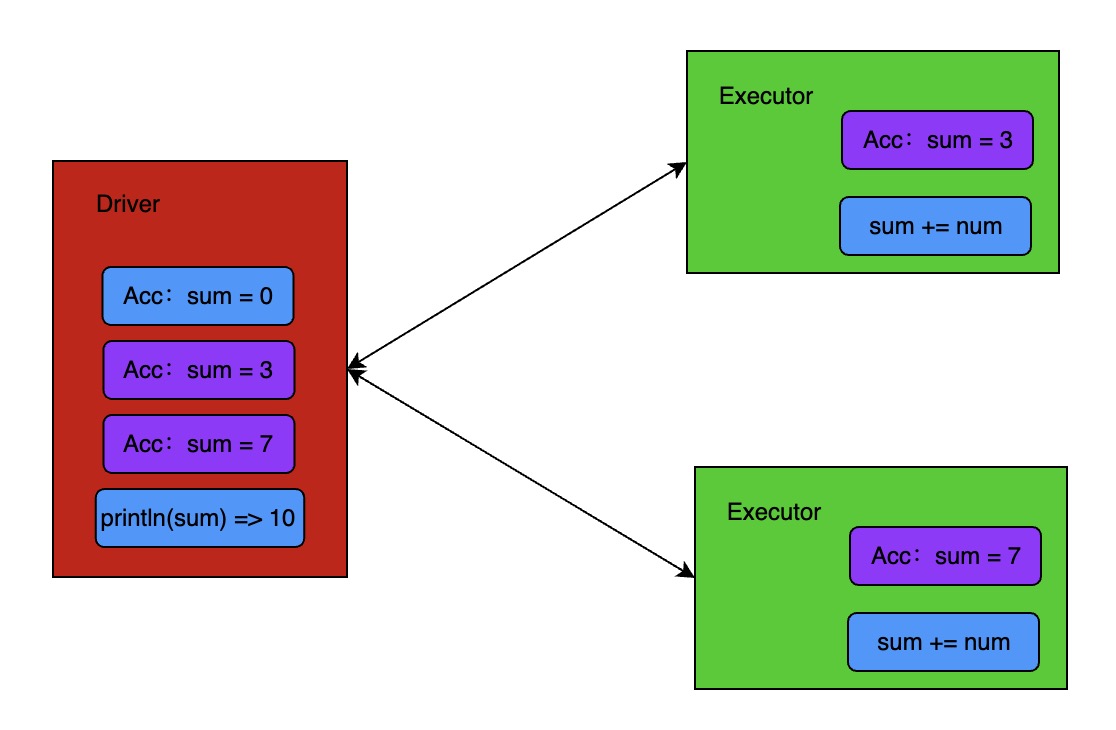
而将 sum 变量声明为累加器数据结构,Executor 端执行完累加之后会自动将结果返回给 Driver 端进行 merge.
val rdd: RDD[Int] = sc.makeRDD(List(1, 2, 3, 4))
// 获取系统累加器
val sum: LongAccumulator = sc.longAccumulator("sum")
rdd.foreach(
  number => {
    sum.add(number)
  }
)
println(sum.value)

// 如果将foreach改成map,会出现少加现象。
// 少加:转换算子中调用累加器,如果没有行动算子的话,就不会执行。
rdd.map(
  number => {
    sum.add(number)
    number
  }
)
println(sum.value)

// 如果执行两次collect,会出现多加现象,因为累加器是全局共享的。
val mapRdd = rdd.map(
  number => {
    sum.add(number)
    number
  }
)
mapRdd.collect()
mapRdd.collect()
println(sum.value)
自定义累加器
object Acc {
  def main(args: Array[String]): Unit = {
    val sparkConf = new SparkConf().setMaster("local[*]").setAppName("acc")
    val sc = new SparkContext(sparkConf)

    val rdd: RDD[String] = sc.makeRDD(List("hello", "hello", "spark"))
    val accumulator: MyAccumulator = new MyAccumulator()
    // 向Spark注册
    sc.register(accumulator, "accumulator")
    rdd.foreach(
      word => {
        accumulator.add(word)
      }
    )
    println(accumulator.value)

    sc.stop()
  }


  // 继承AccumulatorV2,定义泛型。
  // IN:累加器输入的数据类型 String
  // OUT:累加器返回的数据类型 mutable.Map[String, Long]
  class MyAccumulator extends AccumulatorV2[String, mutable.Map[String, Long]] {

    private var map = mutable.Map[String, Long]()

    // 判断是否为初始状态
    override def isZero: Boolean = {
      map.isEmpty
    }

    override def copy(): AccumulatorV2[String, mutable.Map[String, Long]] = {
      new MyAccumulator()
    }

    override def reset(): Unit = {
      map.clear()
    }

    // 获取累加器需要计算的值
    override def add(word: String): Unit = {
      val newCnt = map.getOrElse(word, 0L) + 1
      map.update(word, newCnt)
    }

    // Driver 合并多个累加器
    override def merge(other: AccumulatorV2[String, mutable.Map[String, Long]]): Unit = {
      val map1 = this.map
      val map2 = other.value
      map2.foreach{
        case (word, count) => {
          val newCount = map1.getOrElse(word, 0L) + count
          map1.update(word, newCount)
        }
      }
    }

    // 累加器结果
    override def value: mutable.Map[String, Long] = map
  }
}
广播变量
广播变量用来高效分发较大的对象。向所有工作节点发送一个较大只读值,以供一个或者多个 Spark 操作使用。
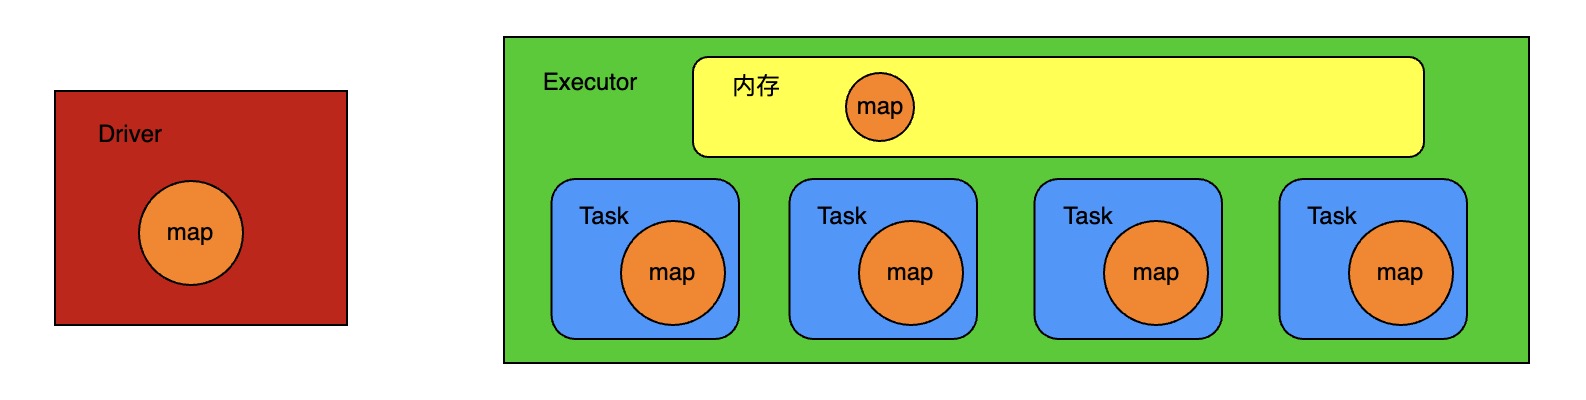
- 闭包数据,都是以 Task 为单位发送的,每个任务中包含闭包数据。这样会导致一个 Executor 中含有大量重复的数据,并且占用大量的内存。
- Executor 其实就是一个 JVM,所以在启动的时候,会自动分配内存,将任务中的闭包数据放置在 Executor 内存中,达到共享的目的。
- Spark 中的广播变量就可以将闭包数据保存到 Executor 的内存中。
- Spark 中的广播变量不能够更改:分布式共享只读变量。
val rdd1: RDD[(String, Int)] = sc.makeRDD(List(
  ("a", 1), ("b", 2), ("c", 3)
))
val rdd2: RDD[(String, Int)] = sc.makeRDD(List(
  ("a", 4), ("b", 5), ("c", 6)
))
// join 会导致数据量几何增长,并且会影响shuffle的性能,不推荐使用。
val joinRdd: RDD[(String, (Int, Int))] = rdd1.join(rdd2)
joinRdd.collect().foreach(println)

val map = mutable.Map(("a", 4), ("b", 5), ("c", 6))
// 封装广播变量
val bc: Broadcast[mutable.Map[String, Int]] = sc.broadcast(map)
rdd1.map{
  case (word, count) => {
    val tmp: Int = bc.value.getOrElse(word, 0)
    (word, (count, tmp))
  }
}.collect().foreach(println)

 浙公网安备 33010602011771号