

Delphi 寻址指针
指针就像跳跃指令,可以随意地从数据结构的一部分跳转到另一部分。将它们引入高级语言,无疑是一种倒退,或许永远无法挽回。——安东尼·霍尔
指针可能是最容易被误解、最令人恐惧的数据类型之一。这就是为什么许多程序员都喜欢避免使用它们。
但指针很重要。即使在那些不明确支持指针,或者难以使用指针的语言中,指针也是幕后的重要因素。我认为理解它们非常重要。理解指针的方法有很多种。
本文面向所有在理解或使用指针方面存在问题的用户。本文探讨了我对 Delphi for Win32 中指针的理解,虽然可能并非完全准确(例如,一个程序的内存并非是一个大块,但在大多数情况下,最好将其视为一个大块)。在我看来,这样一来,指针就更容易理解了。
记忆
您可能已经知道我在这一段中写了什么,但无论如何阅读它可能是有益的,因为它展示了我对事物的看法,可能与您自己的看法略有不同。
指针是用于指向其他变量的变量。要解释指针,首先需要理解内存地址和变量的概念。为此,我首先要粗略地解释一下计算机内存。
简而言之,计算机内存可以看作是一排很长的字节。一个字节是一个小的存储单元,可以包含256 个单独的值(0到255)。在当前的 32 位 Delphi 中,内存(除了少数例外)可以看作是一个最大大小为2 GB(2 31字节)的数组。这些字节包含什么取决于如何解释内容,即如何使用它们。值97可以表示值为97的字节,也可以表示字符'a'。如果组合多个字节,则可以存储更大的值。在2字节中可以存储256*256 个不同的值,等等。
内存中的字节可以通过编号来寻址,从0开始,最大到2147483647(假设您有2GB 的内存——即使您没有,Windows 也会尝试使其看起来好像您有)。这个巨大数组中字节的索引称为其地址。
也可以说:字节是内存中最小的可寻址部分。
实际上,内存要复杂得多。例如,有些计算机的字节数不是8位,这意味着它们可以容纳少于或多于256 个值,但运行 Delphi for Win32 的计算机则不然。内存由硬件和软件管理,并非所有内存都真实存在(不过,内存管理器会通过将部分内存交换到硬盘或从硬盘交换回来,来避免程序察觉),但在本文中,将内存视为一个巨大的单字节块会有所帮助,这些块被划分用于多个程序。
变量
变量是巨大的“数组”中由一个或多个字节组成的一个位置,你可以从中读取或写入。它由其名称标识,也可以由其类型、值和地址标识。
如果您声明一个变量,编译器会预留一块适当大小的内存。该变量的存储位置由编译器和运行时代码决定。您永远不应该假设变量的具体位置。
变量的类型定义了内存位置的使用方式。它定义了变量的大小,即占用的字节数,以及变量的结构。例如,下图显示了一段内存的示意图。它显示了从地址 开始的 4 个字节。这些字节分别$00012344包含值$4D、$65和。$6D$00
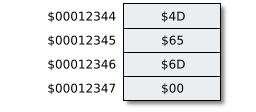
请注意,虽然我像$00012344大多数图表一样使用了地址,但这些地址完全是虚构的,仅用于区分不同的内存位置。它们并不反映真实的内存地址,因为真实的内存地址取决于很多因素,并且无法预测。
类型决定了这些字节的使用方式。例如,它可以是一个Integer带有值的7169357 ($006D654D),或者一个array[0..3] of AnsiChar构成 C 风格字符串 的'Mem',或者其他类型,例如一个集合变量、多个单字节、一条小记录、一个Single、 的一部分Double等等。换句话说,在了解存储于内存中的变量类型之前,无法得知该内存块的含义。
变量的地址是其第一个字节的地址。在上图中,假设变量的类型为Integer,则其地址为$00012344。
未初始化的变量
变量的内存可以重复使用。通常,为变量预留的内存仅在程序可以访问它们期间保留。例如,函数或过程(我喜欢将两者都称为例程)的局部变量仅在例程运行时有效。对象的字段(也是变量)也仅在对象“存在”期间有效。
如果你声明一个变量,编译器会为该变量保留所需数量的字节。但这些字节的内容很可能是之前在其他函数或过程中使用时已经存在的内容。换句话说,未初始化变量的值是undefined(但不一定是undetermined)。以下是一个简单的控制台程序的示例:
程序 未初始化变量;

{$APPTYPE 控制台}

过程 测试;
var
  A : Integer ;
开始
  Writeln (A ); //尚未初始化
  A  :=  12345 ;
  Writeln (A ); //已初始化:12345
结束;

开始
  测试;
  Readln ;
结束。
显示的第一个值(未初始化变量 A 的值)取决于为 A 保留的内存位置的现有内容。在我的例子中,它2147319808 ($7FFD8000)每次都显示该值,但在您的计算机上可能完全不同。该值未定义,因为它未初始化。在更复杂的程序中,尤其是(但不限于)涉及指针时,这经常导致程序崩溃或出现意外结果。赋值语句使用值 初始化 A 12345 ($00003039),因此这是显示的第二个值。
指针
指针也是变量。但它们不包含数字或字符,而是包含内存位置的地址。如果将内存视为一个数组,那么指针可以看作是数组中的一个条目,它包含数组中另一个条目的索引。
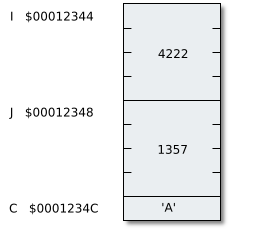
假设我有以下声明和初始化:
变量
  I : 整数;
  J : 整数;
  C : AnsiChar ;
开始
  我 :=  4222 ;
  J  :=  1357 ;
  C  :=  'A' ;
我们假设它产生以下内存布局:
现在,在这段代码之后,假设P是一个指针,
P := @ I ;
我有以下情况:
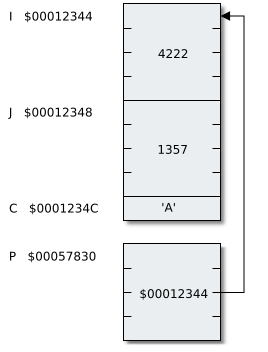
在前面的图中,我总是显示每个字节。这通常没有必要,所以上面的图也可以显示为:
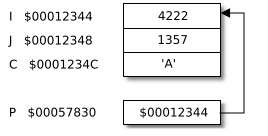
这不再反映实际大小(C 看起来I和或一样大J),但它足以理解指针发生了什么。
零
你不应该跟随
NULL指针,因为混乱和疯狂在它的尽头等待着你。——亨利·斯宾塞
Nil是一个特殊的指针值。它可以赋值给任何类型的指针。它代表空指针(nil是拉丁语nihil的缩写,表示无或零;也有人认为NIL表示Not In List)。这意味着该指针具有已定义的状态,但并不意味着你应该尝试访问该值(在 C 语言中,nil称为NULL—— 参见上面的引用)。
Nil永远不会指向有效内存,但由于它是一个定义明确的值,许多例程可以对其进行测试(例如使用函数Assigned())。无法测试任何其他值是否有效。过时或未初始化的指针看起来与有效指针(见下文)并无区别。无法区分它们。程序逻辑必须始终确保指针要么有效,要么…… nil。
在 Delphi 中,nil的值为0,即它指向内存中的第一个字节。显然,这是一个 Delphi 代码永远不会访问的字节。但通常不应依赖于nil,0除非您完全了解幕后发生了什么。 的值nil在后续版本中可能会因某种原因而发生变化。
类型指针
在上面的简单示例中,P是 类型Pointer。这意味着P包含一个地址,但您不知道该地址处的变量应该包含什么。这就是为什么指针通常需要指定类型,即指针被解释为指向应该包含特定类型的内存位置。
假设我们有另一个指针 Q:
var
  Q :  ^整数;
Q是 类型^Integer,应该读作“指向整数的指针”(我被告知^Integer代表 ↑ Integer)。这意味着它不是,而是指向一个内存位置,该位置应被用作 。如果使用地址运算符或功能等效的伪函数将Integer的地址赋给 ,则JQ@Addr
Q := @ J ; // Q := 地址(J);
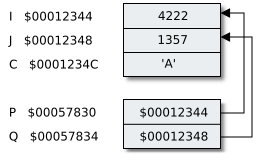
然后Q指向地址处的位置$00012348(它引用由 标识的内存位置J)。但由于Q是一个类型指针Q,编译器会将指向的内存位置视为Integer。Integer是的基类型Q。
尽管您几乎看不到Addr使用伪函数,但它相当于@。@缺点是,当应用于复杂表达式时,运算符应用于哪个部分并不总是很明显。Addr使用函数的语法,歧义性要小得多,因为目标括在括号中():
P := @PMyRec ^.整数^ [ 6 ] ; Q :=地址( PMyRec ^.整数^ [ 6 ] ) ;
使用指针赋值与直接赋值给变量略有不同。通常,你只需要使用指针即可。如果赋值给普通变量,则应像这样写:
J := 98765 ;
这会将整数存储98765 (hex $000181CD)在内存位置中。但是,要使用 访问该内存位置Q,必须使用运算符间接^进行 操作:
Q ^ := 98765 ;
这称为解除引用。您必须沿着假想的“箭头”到达 指向的位置Q(换句话说,就是Integer的地址$00012348),并将其存储在那里。
^需要说明的是,如果代码没有运算符也能清晰表达,语法允许省略运算符。不过,为了清晰起见,我个人总是会写上它。
为正在使用的指针定义类型通常很有用。例如,^Integer不是一个有效的参数类型声明,因此您必须预定义一个类型:
类型
  PInteger  =  ^ Integer ;

程序 Abracadabra ( I :  PInteger ) ;
事实上,PInteger类型 和一些其他常见的指针类型已经在 Delphi 运行时库中定义(例如,unitsSystem和SysUtils)。指针类型的名称通常以大写字母开头,P后跟其指向的类型。如果基类型的前缀是大写字母T,则T通常会省略 。示例:
类型
  PByte  =  ^ Byte ;
  PDouble  =  ^ Double ;
  PRect  =  ^ TRect ;
  PPoint  =  ^ TPoint ;
匿名变量
在前面的例子中,变量是在需要的地方声明的。有时你并不知道是否需要某个变量,或者需要多少个变量。使用指针,你可以拥有所谓的匿名变量。你可以要求运行时为你保留一块内存,并使用伪函数返回指向该内存的指针New():
var
  PI :  P 整数;
开始
  新的(PI );
New()是一个编译器伪函数。它为 的基类型预留内存PI,然后指向PI该内存块(即将地址存储在 中PI)。该变量没有名称,因此是匿名的。它只能通过指针间接访问。现在,您可以使用 为其赋值、将其传递给例程,并在不需要时将其删除Dispose(PI):
  PI ^  :=  12345 ;
  ListBox1 . Add ( IntToStr ( PI ^ )) ;
  // 大量代码
  Dispose ( PI ) ;
end ;
除了Newand Dispose,你也可以更深入地使用GetMemand FreeMem。但是NewandDispose有一些优势。它们已经知道指针的类型,并且如果需要的话,还可以初始化和终止内存位置。因此,建议尽可能使用Newand Dispose,而不是GetMemand FreeMem。
始终确保每个New()最终都跟随着Dispose()相同指针值和类型的,否则某些变量可能无法正确完成。
这比直接声明变量好在哪里可能并不明显,但在某些情况下这很有用,通常是在你不知道需要多少个变量的时候。想象一下链表中的节点(见下文),或者一个TList.TList存储指针,如果你想要一个值列表Double,你只需将New()每个值存储在 中TList:
var
  P :  PDouble ;
开始
  而 HasValues ( SomeThing ) 开始
  New ( P ) ; P ^ := ReadValue ( SomeThing ) ;
    MyList . Add ( P ) ; //等等...
当然Dispose(),当列表不再使用时,您将必须在稍后的阶段对每个值进行处理。
使用匿名变量,很容易证明类型指针可以决定内存的使用方式。两个不同类型的指针指向同一块内存,会显示不同的值:
程序 InterpretMem ;

{$APPTYPE 控制台}

var
  PI :  PInteger ;
  PC :  PAnsiChar ;
开始
  New ( PI ) ;
  PI ^  :=  $006D654D ;      // 字节 $4D $65 $6D $00
  PC  :=  PAnsiChar ( PI ) ;  // 现在两者指向同一地址。Writeln
  ( PI ^ ) ;//         写入整数。Writeln
  ( PC ^ ) ;//         写入一个字符 ($4D)。Writeln
  ( PC ) ;//          将$4D $65 $6D $00 解释为 C 风格字符串。Dispose
  ( PI ) ;Readln ;结束。
PI将值 填充到内存位置$006D654D (7169357)。如图所示(注意,这些地址纯属虚构):
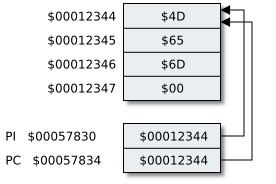
PC然后指向相同的内存位置(由于指针的基类型不同,因此不能将一个指针赋值给另一个指针——必须进行类型转换)。但是PC是一个指向 的指针AnsiChar,因此如果取PC^,则会得到AnsiChar,即 ASCII 值为 的字符$4D,或者'M'。
PC不过,这是一种特殊情况,因为类型PAnsiChar(尽管它实际上只是指向 的指针AnsiChar)的处理方式与大多数其他指针类型略有不同。我在另一篇文章中对此进行了解释。PC如果没有解除引用, 通常会被视为指向以零字符 结尾的文本的指针#0,并且将显示由字节(即 )Writeln(PC)组成的文本。$4D $65 $6D $00'Mem'
在思考指针,尤其是复杂的指针情况时,我通常会准备一张纸和一支钢笔或铅笔,以便绘制本文中看到的那种图表。我也会给变量指定地址(它们不必是 32 位的,像30000、40000、40004和40008这样的地址50000就足以追踪变量的去向)。
糟糕的指针
如果使用得当,指针是非常实用且灵活的工具。但一旦出错,就可能造成大麻烦。这也是许多人尽量避免使用指针的另一个原因。以下列出了一些最常见的错误。
未初始化的指针
指针是变量,和任何变量一样,它们应该被初始化,要么通过为它们分配另一个指针值,要么通过使用New或GetMem或一些这样的:
var
  P1 :  PInteger ;
  P2 :  PInteger ;
  P3 :  PInteger ;
  I :  Integer ;
开始
  I  :=  0 ;
  P1  :=  @ I ;   // OK: 使用 @ 运算符
  P2  :=  P1 ;   // OK: 分配其他指针
  New ( P3 ) ;    // OK: New
  Dispose ( P3 ) ;
结束;
如果您只是声明一个PInteger,但没有初始化它,指针可能包含一些随机字节,即它指向内存中某个随机位置。
如果你开始访问内存中随机的位置,可能会发生一些糟糕的事情。如果该内存不在为应用程序保留的内存空间内,则很可能会引发访问冲突,导致程序崩溃。但如果该内存是程序的一部分,并且你对其进行了写入,则可能会覆盖可能无法更改的数据。如果稍后程序的其他部分使用了这些数据,程序生成的结果可能会出错。这类错误可能极难发现。
所以实际上,如果你遇到了杀毒软件或其他类型的明显崩溃,你其实可以庆幸(除非它毁了你的硬盘)。你的程序崩溃了,这很糟糕,但这类错误很容易调试和纠正。但是,如果你产生了错误的数据和糟糕的结果,问题可能会更严重,你甚至可能没有注意到,或者要到很晚才会注意到。这就是为什么你必须极其谨慎地使用指针。务必仔细检查是否存在未初始化的指针。
访问未初始化的指针是未定义行为。我特别喜欢“鼻腔恶魔”这个术语,它来自 comp.std.c Usenet 新闻组的一篇文章,其中有人写道:“当编译器遇到[给定的未定义构造]时,它可以合法地让恶魔从你的鼻子里飞出来。”
过时的指针
过期指针是指曾经有效,但现已失效的指针。当指针指向的内存被释放并重用时,就会发生这种情况。
指针失效的一个常见原因是,内存被释放(处置),但指向该内存的指针在此之后仍在使用。为了防止这种情况,一些程序员总是在nil内存释放后将指针设置为 。他们会在访问内存之前添加 nil 的测试。换句话说,nil 被用作某种标志,将指针标记为无效。这是一种方法,但并非总是最佳方法。
另一个常见的错误是,当多个指针指向同一块内存时,如果使用其中一个指针释放它,即使你使用了nil那个指针,其他指针仍然会指向这块被释放的内存的地址。如果幸运的话,你会得到一个“无效指针”的错误,但具体会发生什么,目前尚不清楚。
第三个类似的问题是将指针指向易失性数据,即随时可能消失的数据。例如,一个很大的错误是函数返回指向例程的本地数据的指针。一旦例程结束,该数据就消失了,不再存在。一个经典(但我知道这很愚蠢)的例子:
函数 VersionData :  PAnsiChar ;
var
  V :  AnsiChar的数组[ 0 .. 11 ]  ;开始CalculateVersion ( V ) ;结果:= V ;结束;
V将被放置在处理器堆栈中。这是一块内存,每个正在运行的函数都会重用它存储局部变量和参数,并且它还包含敏感数据,例如函数调用的返回地址。结果现在指向V(PAnsiChar也可以直接指向一个数组,参见我提到的文章)。一旦VersionData结束,堆栈就会被下一个运行的例程修改,因此之前计算的任何内容CalculateVersion都会消失,指针现在指向堆栈特定部分的新内容。
类似的问题是将 PChar 指向字符串,但这在关于 PChars 的文章中也讨论过。指向动态数组元素也属于同一类,因为如果数组太小并且使用了 SetLength ,动态数组可能会被完全移动。
使用错误的基类型
指针可以指向任何内存位置,并且两个不同类型的指针可以指向同一位置,这意味着你可以用不同的方式访问同一内存位置。使用指向字节的指针 (^Byte),你可以更改整数或其他类型的单个字节。
但您也可以覆盖或覆盖读取。例如,如果您访问一个只应包含指向整数的指针的字节的位置,则可能会覆盖 4 个字节,不仅是保留的字节,还包括连续的 3 个位置,因为编译器会将这 4 个字节视为整数。此外,如果您从字节位置读取,则可能会读取过多:
var
  PI :  P 整数;
  I 、 J : 整数;
  B : 字节;
开始
  PI  :  = PInteger ( @B ) ;我:= PI ^; J := B ;结尾;
J将会有正确的值,因为编译器会添加代码,Integer通过在整数中填充零字节来将单字节扩展为(4字节)。但I事实并非如此。它将包含该字节及其后的 3 个字节,共同构成一个未定义的值。
指针还允许您设置变量的值,而无需赋值给变量本身。这在调试过程中可能会造成很多麻烦。您知道变量包含错误的值,但却无法在代码中找到赋值的位置,因为该值是通过指针设置的。
业主和孤儿
指针不仅可以有不同的基类型,还可以有不同的所有权语义。如果您使用New或GetMem或其他用于更特殊任务的例程分配内存,那么您就是该内存的所有者。如果您想保留该内存,最好将指针存放在一个安全的地方。指针是您访问该内存的唯一途径,如果地址丢失,您将无法再访问或释放该内存。一条规则是,分配内存的人也应该释放它,因此您有责任确保这一点始终可行。设计良好的程序总是会考虑到这一点。
理解所有权非常重要。拥有内存的人必须始终释放它。你可以委托他人执行此任务,但必须确保正确完成。
一种常见的错误是使用指针分配内存,然后重复使用该指针分配更多内存,或将其指向其他内存。指针最初包含第一个块的地址,现在将包含最新块的地址,而旧地址将永远丢失。没有任何有效的方法可以找到该内存的分配位置。该内存被孤立了。没有人可以访问它,也没有人可以再管理它。这将导致所谓的内存泄漏。
下面是一个简单的例子(经作者许可),取自 Borland 的新闻组:
var
bitdata : 字节数组 ;pbBitmap :指针;开始SetLength (bitdata ,nBufSize );GetMem (pbBitmap ,nBufSize );pbBitmap := Addr (bitdata );VbMediaGetCurrentFrame (VBDev ,@ bmpinfo.bmiHeader ,@ pbBitmap ,nBufSize );
实际上,这段代码确实做了一些令人困惑的事情。SetLength为 分配了字节bitdata。出于某种原因,程序员随后使用GetMem为 分配了相同数量的字节pbBitmap。但随后他立即将 pbBitmap 设置为另一个地址,这使得他刚刚分配的内存GetMem无法被任何代码访问(pbBitmap曾经是访问它的唯一方法,现在不再指向它了)。换句话说,我们发生了内存泄漏。
事实上,还有一些其他错误。bitdata是一个动态数组,获取 的地址时bitdata只会获取指针的地址,而不是缓冲区首字节的地址(请参阅下文“动态数组”)。此外,由于pbBitmap已经是一个指针,因此在函数调用中使用 @ 运算符是错误的。
更好的代码应该是:
var
bitdata : 字节数组 ;pbBitmap :指针;如果nBufSize > 0则开始SetLength (bitdata ,nBufSize );pbBitmap := Addr (bitdata [ 0 ] );VbMediaGetCurrentFrame (VBDev ,@ bmpinfo.bmiHeader ,pbBitmap ,nBufSize );结束;
甚至:
var
bitdata : 字节数组 ;如果nBufSize > 0则开始SetLength ( bitdata ,nBufSize ) ;VbMediaGetCurrentFrame ( VBDev ,@ bmpinfo.bmiHeader ,@ bitdata [ 0 ] ,nBufSize ) ;结束;
这看起来是一个微不足道的问题,但在更复杂的代码中,这种情况很容易发生。
请注意,指针不必拥有内存。指针通常用于迭代数组(见下文),或访问结构体的某些部分。如果您没有为它们分配内存,则无需保留它们。它们仅用作临时的一次性变量。
指针运算和数组
你可以拥有软件质量,也可以拥有指针算法,但不能同时拥有两者。——伯特兰·迈耶
Delphi 允许对指针进行一些简单的操作。当然,你可以对指针赋值,并比较它们是否相等(if P1 = P2 then)或不等,也可以使用Inc和来对指针进行递增和递减Dec。巧妙之处在于,这些递增和递减操作会根据指针基类型的大小进行缩放。以下是一个例子(注意,我将指针设置为一个假地址。只要我不使用它访问任何东西,就不会发生任何不好的事情):
程序 PointerArithmetic ;

{$APPTYPE 控制台}

使用
  SysUtils ;

过程 WritePointer ( P :  PDouble ) ;
开始
  Writeln ( Format ( '%8p' ,  [ P ]) ) ;
结束;

变量
  P :  PDouble ;

开始
  P  :=  Pointer ( $50000 ) ;
  WritePointer ( P ) ;
  Inc ( P ) ;     // 00050008 = 00050000 + 1 * SizeOf(Double)
  WritePointer ( P ) ;
  Inc ( P ,  6 ) ;  // 00050038 = 00050000 + 7 * SizeOf(Double)
  WritePointer ( P ) ;
  Dec ( P ,  4 ) ;  // 00050018 = 00050000 + 3 * SizeOf(Double)
  WritePointer ( P ) ;
  Readln ;
结束.
输出为:
00050000
00050008
00050038
00050018
这样做的目的是提供对此类数组的顺序访问。由于(一维)数组包含相同类型的连续项(即,如果一个元素位于 address N,则下一个元素位于 address N + SizeOf(element)),因此在循环中使用它来访问数组的项是有意义的。从数组的基地址开始,您可以从该基地址访问第一个元素。在循环的下一次迭代中,递增指针以访问数组的下一个元素,依此类推,依此类推:
程序 IterateArray ;
{$APPTYPE 控制台}
var
Fractions : Double数组[ 1..8 ] ;I :整数;PD :^ Double ;
开始
//用随机值填充数组。
随机化;
for I := Low ( Fractions ) to High ( Fractions ) do
Fractions [ I ] := 10 0.0 * Random ;
// 使用指针访问。PD
: = @ Fractions [ Low ( Fractions )] ;
for I := Low ( Fractions ) to High ( Fractions ) do
begin
Write ( PD ^: 9 : 5 ) ;
Inc ( PD ) ; // 指向下一个项目
end ;
Writeln ;
//常规访问,使用索引。for I := Low ( Fractions ) to High ( Fractions ) do Write ( Fractions [ I ] : 9 : 5 ) ; Writeln ;
阅读;
结束。
塔玛拉瀑布 (Tamaraw Falls), 海豚湾, 东民都洛岛, 菲律宾
至少在较旧的处理器上,增加指针可能比将索引乘以基类型的大小并在每次迭代时将其添加到数组的基地址稍微快一些。
实际上,这样做的效果远不如你预期。首先,现代处理器有专门的方法处理使用索引的最常见情况,因此无需更新指针。其次,如果这样做更有利,编译器通常会使用版本号来优化对指针的索引访问。而在上面,使用稍微优化的访问方式所带来的好处,在很大程度上被执行 Write() 所需的时间所掩盖。
正如您在上面的程序中看到的,您很容易忘记在循环内增加指针。您必须要么使用for-to-do“无论如何”命令,要么使用其他方法或计数器来终止循环(然后您还必须手动减少并比较循环)。换句话说,使用指针的代码通常更难维护。由于它无论如何都不会更快,除非在非常紧凑的循环中,所以我非常谨慎地在 Delphi 中使用这种访问方式。只有在您分析了代码并发现指针访问有益且必要的情况下,才可以这样做。
指向数组的指针
但有时你只需要一个指针来访问内存。Windows API 函数通常将数据返回到缓冲区中,而缓冲区中包含一定大小的数组。即便如此,将缓冲区强制转换为指向数组的指针可能比使用 Inc 或 Dec 更简单。例如:
type
  PIntegerArray  =  ^ TIntegerArray ;
  TIntegerArray  = 整数数组[ 0 .. 65535 ]  ; var Buffer :整数数组; PInt : PInteger ; PArr : PIntegerArray ; ... // 使用指针运算:PInt : = @ Buffer [ 0 ] ;对于I : = 0到Count - 1执行begin Writeln ( PInt ^ ) ; Inc ( PInt ) ; end ;


  // 使用数组指针和索引:
  PArr  :=  PIntegerArray ( @ Buffer [ 0 ]) ;
  for  I  :=  0  to  Count  -  1  do
    Writeln ( PArr ^ [ I ]) ;
  ...
end ;
德尔福 2009
PChar在 Delphi 2009 及更高版本中,指针运算(与PAnsiChar和类型一样PWideChar)现在也适用于其他指针类型。何时何地可以使用此功能由新的编译器指令控制$POINTERMATH。
指针运算通常是关闭的,但可以使用 为一段代码打开它{$POINTERMATH ON},然后使用 再次关闭它{$POINTERMATH OFF}。对于在指针运算(指针数学)打开的情况下编译的指针类型,通常可以进行指针运算。
目前,除了PChar、PAnsiChar和之外PWideChar,唯一默认启用指针运算的类型是PByte类型。但是,如果启用 ,例如 ,PInteger可以大大简化上面的代码:
{$POINTERMATH ON}
var
  Buffer :  Integer数组 ;PInt : PInteger ; ... // 使用新的指针算法:PInt := @ Buffer [ 0 ] ;对于I := 0到Count - 1 do Writeln ( PInt [ I ]) ; ... end ; {$POINTERMATH OFF}
因此,不再需要声明特殊TIntegerArray和PIntegerArray类型才能将类型作为数组访问。或者,也PInt[I]可以(PInt + I)^使用 语法,结果相同。
显然,在Delphi 2009中,新的指针算法对于泛型类型的指针尚无法正常工作。无论参数类型实例化为哪种类型,索引都不会SizeOf(T)像预期的那样按比例缩放。
参考
Delphi 中的许多类型实际上是指针,但却假装不是。我喜欢将这些类型称为“引用”。例如动态数组、字符串、对象和接口。这些类型在幕后都是指针,但具有一些额外的语义,并且通常还包含一些隐藏的内容。
引用与指针的区别是:
- 引用是不可变的。你不能增加或减少引用的值。引用指向某些结构,但永远不会指向它们本身,例如上面例子中指向数组的指针。
- 引用不使用指针语法。这隐藏了它们实际上是指针的事实,使得许多不了解这一点的人难以理解,因此他们用它们做了一些他们最好不要做的事情。
不要将这些引用与 C++ 的引用类型混淆。它们在很多方面都不同。
动态数组
在 Delphi 4 之前,动态数组并非 Delphi 语言的特性,但它作为一个概念存在。动态数组是通过指针分配和管理的一块内存。动态数组可以增长或收缩。这意味着,它会分配新所需大小的内存,将旧内存块中需要保留的内容复制到新内存块,释放旧内存块,然后将指针指向新内存块。
Delphi 中的动态数组类型(例如array of Integer)也执行相同的操作。但是运行时库添加了专门的代码来管理每次访问和赋值。在指针指向的地址下方的内存位置,还有两个字段:已分配元素的数量和引用计数。
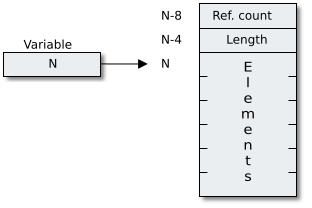
如果如上图所示,N是动态数组变量中的地址,则引用计数位于地址N-8,分配的元素数(长度指示器)位于N-4。第一个元素位于地址N。
对于每个添加的引用(例如赋值、参数传递等),引用计数都会增加,而对于每个删除的引用(例如当变量超出范围时,或者当包含动态数组引用的对象被释放时,或者当包含动态数组引用的变量被重新分配给 nil 或另一个数组时),引用计数都会减少。
在低级例程(例如Move或FillChar)或其他访问整个数组的例程(例如 )中访问动态数组TStream.Write通常是错误的。对于普通数组(通常称为静态数组,以区别于动态数组),变量与内存块相同。对于动态数组,情况并非如此(参见图)。因此,如果例程想要以内存块的形式访问数组的元素,则不应引用动态数组变量,而应引用数组的第一个元素。
var
Items : Integer数组 ;... // 错误:传递了 Items 变量的地址MyStream .Write ( Items , Length ( Ite ms ) * SizeOf ( Integer ) ) ;... // 正确:传递了第一个元素的地址MyStream .Write ( Items [ 0 ] , Length ( Ite ms ) * SizeOf ( Integer )) ;
对于静态数组,第一个元素的地址与数组本身的地址相同,换句话说,即使数组是静态数组,传递参数Items[0]也同样有效。如果您习惯于始终传递数组的第一个元素,那么无论数组是动态的还是静态的,都不会出错。Items
注意,上文中Stream.Write使用了无类型var参数,它们也是引用。下文将对此进行讨论。
多维动态数组
上面讨论了一维动态数组。但动态数组也可以是多维的。至少从语法上来说是这样,因为实际上它们并非如此。多维动态数组实际上是一个指向其他一维数组的指针的一维数组。
假设我们有这些声明:
类型
TMultiIntegerArray = 整数数组的数组 ;
var
MyIntegers : TMultiIntegerArray ;
现在它看起来像一个多维数组,并且确实可以像 一样访问MyIntegers[0, 3]。但实际上,该类型的声明应该这样读(这里我对语法做了一些改动):
类型
TMultiIntegerArray = 数组 (整数数组);
或者,更明确一点,这实际上与以下内容相同:
类型
TSingleIntegerArray = 整数数组 ;TMultiIntegerArray = TSingleIntegerArray数组;
如您所见,TMultiIntegerArray实际上是TSingleIntegerArray指针的一维数组。这意味着TMultiIntegerArray并非以按行和列排列的内存块形式存储,而是一个不规则数组,即每个条目只是指向另一个数组的指针,并且每个子数组的大小可以不同。因此,
设置长度(MyIntegers , 10,20 );
(它将分配10 TSingleIntegerArray个子数组,每个子数组包含20 个整数,因此从表面上看,这是一个矩形数组),您可以访问和更改每个子数组:
SetLength ( MyIntegers ,  10 ) ;
SetLength ( MyIntegers [ 0 ] ,  40 ) ;
SetLength ( MyIntegers [ 1 ] ,  31 ) ;
// 等等...
字符串
数组索引应该从0还是1开始?我的妥协方案是0.5,但我认为,它没有经过深思熟虑就被否决了。—— Stan Kelly-Bootle
字符串在很多方面与动态数组相同。它们也采用引用计数,具有类似的内部结构,引用计数和长度指示符存储在字符串数据的下方(偏移量相同)。
区别在于语法和语义。您不能将字符串设置为nil,而是将其设置为''(空字符串)以清除它。字符串也可以是常量(引用计数为-1,这对于运行时例程来说是一个特殊值:它们不会尝试增加或减少它,也不会释放该字符串)。第一个元素位于索引1,这与动态数组不同,动态数组的第一个元素始终位于索引0。
在我的关于 PChars 和字符串的文章中可以找到有关字符串的更多信息。
对象
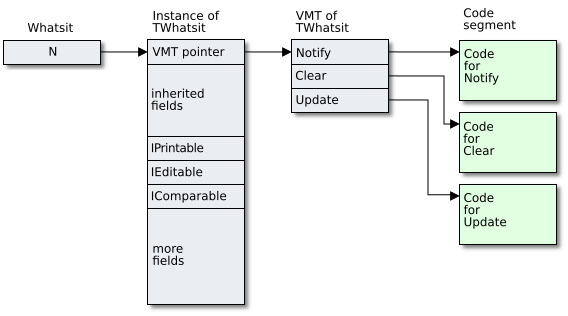
在桌面编译器中,对象(或者更准确地说,类实例)没有编译器生成的生命周期管理。它们的内部结构很简单。每个类实例在偏移量 0(即引用指向的地址)处包含一个指向所谓虚拟内存表 (VMT) 的指针。该表包含指向类的每个虚方法的指针。在表的负偏移量处,会显示大量关于该类的其他信息。本文不会深入探讨这些信息。每个类(而不是每个对象!)都有一个虚拟内存表 (VMT)。
在移动编译器(例如 Android 或 iOS)中,对象确实有一个编译器生成的生命周期管理,称为 ARC。这里我不会讨论它,只想说它的生命周期管理与接口的生命周期管理非常相似。
实现接口的类也具有类似的指向表的指针,这些表包含指向实现接口的方法的指针,每个实现的接口对应一个指针。这些表在负偏移处还包含一些额外信息。这些指针存储在对象中的哪个偏移处取决于祖先类中已经存在的字段。编译器知道这一点。
在 VMT 指针和任何接口表指针之后,存储对象的字段,就像在记录中一样。
RTTI 数据和其他关于类的信息是通过跟踪对象的引用(该引用也指向 VMT 指针)来获取的,然后顺着该指针找到 VMT。这样,编译器就知道在哪里找到其余数据了,通常也是通过包含指向其他结构体的指针的复杂结构体,有时甚至是递归的。
下面是一个例子。假设以下声明:
类型
  TWhatsit  = 类(TAncestor , IPrintable , IEditable , IComparable )
  public
    // 其他字段和方法声明
    过程 Notify (Aspect : TAspect ); 覆盖;
    过程 Clear ; 覆盖;
    过程 Edit ;
    过程 ClearLine (Line : Integer );
    函数 Update (Region : Integer ): Boolean ; 虚拟;
    // 等...
  结束;

  var
    Whatsit :  TWhatsit ;

  开始
    Whatsit  :=  TWhatsit .创建;
那么对象布局将会是这样的:
Turbo Pascal 对象
虽然它们在 Delphi 1.0 发布时就被弃用了,但我还是想提一下旧的 Turbo-Pascal 风格object类型(用object关键字 而不是class关键字声明)。现在仍然有一些库在使用它们。
这些 TP 对象类型或多或少类似于带有方法的记录,但具有继承和属性(属性是在 Delphi 中添加的,而 Turbo Pascal 没有)。其布局类似于记录。对象的开头没有固有的 VMT 指针。只有当对象具有虚拟或动态方法时,才会为 VMT 指针添加一个新的(隐藏)字段(此 VMT 指针可以在后代对象中添加,因此它不一定位于偏移量 0 处)。
类型的另一个区别class是,TP 样式object类型不是引用类型,并且它们不一定分配在堆上。与记录类似,它们可以用作值类型,也可以与指针一起使用。对于这些类型,New伪过程接受第二个参数、构造函数调用和Dispose析构函数调用。此类型没有类似 的TObject基类,与 C++ 语言中的类和结构体类型非常相似。这也意味着,当它们用作值类型时,它们会像在 C++ 中一样受到对象切片的影响。
一个简单的例子:
类型
  POldStyle  =  ^ TOldStyle ;
  TOldStyle  = 对象
    ...
    构造函数 Init (Value : Integer );  // Turbo Pascal 中构造函数的典型名称
    析构函数 Done ; 虚拟;         // Turbo Pascal 中析构函数的典型名称
    过程 Add (Extra : Integer );
  结束;

...

var
  TurboObj :  POldStyle ;
开始
  New ( TurboObj ,  Init ( 17 )) ;
  TurboObj ^. Add ( 33 ) ;
  ...
  Dispose ( TurboObj ,  Done ) ;
结束.
尽管旧式 TP 风格的对象早已被弃用,但它们仍然可以工作(但它们可能存在一些 bug,而且这些弃用类型中的 bug 似乎并非 Delphi 开发团队的首要任务),即使在 64 位编译器中也是如此。除非您已经有使用它们的代码,否则我不建议使用它们。要么使用带有方法的记录,要么使用合适的类类型。文档还指出:对象类型仅支持向后兼容。不建议使用它们。
要了解有关这些类型的更多信息,请阅读内置帮助中的文档,或在线阅读Delphi docwiki中的文档。
接口
接口实际上是方法的集合。在内部,它们是指向指向代码指针数组的指针。假设我们有以下声明:
类型
  IEditable  = 接口
    过程 Edit ;
    过程 ClearLine (Line : Integer );
    函数 Update (Region : Integer ): Boolean ;
  结束;

  TWhatsit  = 类(TAncestor , IPrintable , IEditable , IComparable )
  公共
    程序 通知(Aspect : TAspect ); 覆盖;
    程序 清除; 覆盖;
    程序 编辑;
    程序 ClearLine (Line : Integer );
    函数 更新(Region : Integer ): 布尔值; 虚拟;
    //等...
  结束;

var
  MyEditable :  IEditable ;

开始
  MyEditable  :=  TWhatsit .创建;
那么接口、实现对象、实现类和方法之间的关系如下所示:
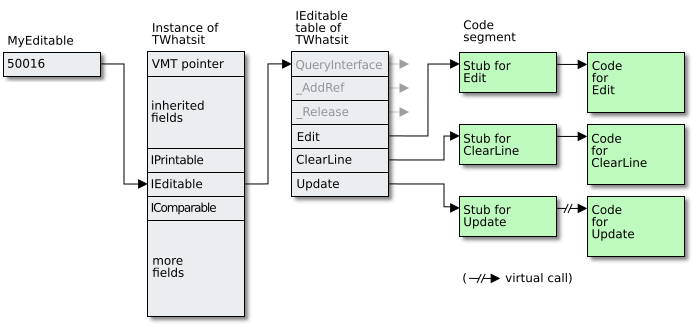
变量MyEditable指向IEditable由 创建的对象中的指针TWhatsit.Create。请注意,MyEditable并非指向对象的起始位置,而是指向对象的偏移量。IEditable对象中的指针随后指向一个指针表,接口中的每个方法对应一个指针表。每个条目都指向一段存根代码。这段代码通过从传递的指针中减去对象中指针的偏移量,将Self指针(实际上是 的值MyEditable)调整为IEditable指向对象的起始位置,然后调用真正的方法。类实现的每个接口的每个方法的实现都有一个存根。
举个例子:假设实例位于地址50000IEditable ,而by实现的指针TWhatsit位于每个实例的偏移量16MyEditable处。则将包含50016。然后,IEditable位于50016的指针指向该类中实现的该接口的表(例如,位于地址30000),然后指向存根(例如,位于地址60000)。存根将看到值(作为Self参数传递)50016,减去偏移量16并得到50000。这是实现对象的地址。然后,存根调用该真实方法,并将50000作为Self参数传递。
QueryInterface在图中,为了清楚起见,我省略了和_AddRef的存根_Release。
你知道为什么我有时喜欢用铅笔和纸吗? ;-)
参考参数
引用参数通常被称为var参数,但out参数也是引用参数。
引用参数是指传递给例程的不是实际参数的值,而是其地址的参数。例如:
过程 SetBit ( var  Int :  Integer ;  Bit :  Integer ) ;
开始
  Int  :=  Int 或 ( 1  shl  Bit ) ;
结束;
这在功能上等同于以下内容:
过程 SetBit ( Int : PInteger ; Bit : Integer ) ;
开始
  Int ^  :=  Int ^ 或 ( 1  shl  Bit ) ;
结束;
不过,还是存在一些差异:
- 您不使用指针语法。使用参数名称会自动取消引用该参数,换句话说,使用参数名称意味着访问目标,而不是指针。
- 引用参数无法修改。使用参数名称和目标,无法赋值给指针,也无法对其进行递增或递减。
- 除非使用强制类型转换技巧,否则必须传递具有地址(即实际内存位置)的对象。因此,对于 Integer 类型的引用参数,例如,您不能传递
17、98765或Abs(MyInteger)。它必须是变量(包括数组元素、记录或对象的字段等)。 TEdit实际参数必须与声明参数的类型相同,例如,如果将参数声明为 a ,则不能传递 aTObject。为了避免这种情况,只能使用无类型引用参数(见下文)。
从语法上讲,使用引用参数似乎比使用指针参数更简单。但需要注意一些特殊情况。要传递指针,必须将间接层级增加一级。换句话说,如果你有一个P指向整数的指针,要传递该指针,你必须在语法上这样传递P^:
var
  Int :  Integer ;
  Ptr :  PInteger ;
  Arr :  Integer数组 ;开始// 未显示 Int、Ptr 和 Arr的初始化... SetBit ( Ptr ^, 3 ) ; // 传递了 Ptr SetBit ( Arr [ 2 ] , 11 ) ; // 传递了 @Arr[2] SetBit ( Int , 7 ) ; // 传递了 @Int
非类型化参数
无类型参数也是引用参数,但它们可以是var、const或out。您可以传递任何类型,这使得编写几乎可以接受任何大小或类型的例程变得更加容易,但这意味着您必须有一种方式将类型作为另一个参数传递,或者例程本身的类型无关紧要。要访问参数,您必须对其进行强制类型转换。
在内部,无类型参数也作为指针传递。以下是两个示例。第一个示例是一个通用例程,它用一定范围的字节填充任何缓冲区,也就是说,传入缓冲区的变量类型无关紧要:
// 类型无关紧要的例程示例
过程 FillBytes ( var  Buffer ;  Count :  Integer ;
  Values :  Byte数组 ) ; var P : PByte ; I : Integer ; LenValues : Integer ;开始LenValues := Length ( Values ) ;如果LenValues > 0则开始P := @ Buffer ; //将缓冲区视为字节数组。I := 0 ;当Count > 0时开始P ^ := Values [ I ] ; I := ( I + 1 ) mod LenValues ; Inc ( P ) ; Dec ( Count ) ;结束;结束;结束;
TIntegerList第二个是泛型的后代的方法TTypedList:
函数 TIntegerList . Add ( const  Value ) :  Integer ;
开始
  Grow ( 1 ) ;
  Result  :=  Count  -  1 ;
  // FInternalArray:整数数组;
  FInternalArray [ Result ]  :=  Integer ( Value ) ;
结束;
如你所见,要使用指针,你必须获取参数的地址,尽管实际上参数本身就是你想要的指针。同样,间接层级少了一级。
要访问引用的目标,只需将其用作普通引用参数,但必须转换为类型,这样编译器才知道如何取消引用指针。
我已经提到了间接层级。如果你想用 初始化动态数组,就可以看到这一点FillBytes。为此,你传递的不是变量,而是数组的第一个元素。实际上,你也可以传递静态数组的第一个元素来实现相同的效果。所以,如果你要将数组传递给非类型化引用参数,在我看来,最好的选择始终是传递第一个元素,而不是数组本身,除非你真的想弄乱动态数组的数组指针。
过程类型
过程类型实际上是保存指向过程或函数的类型指针的变量。有以下几种类型:
- 普通过程类型
- 方法类型(事件)
- 匿名方法
这些类型的实现方式截然不同,请勿混淆。它们都是引用类型,尽管可以(有时必须)将@运算符与第一种类型(即普通过程类型)一起使用。
普通过程类型
这些引用全局(即非方法)过程和函数。如果您必须在相似的上下文中调用不同的函数,这将非常有用。例如,(非泛型)TList.Sort方法 (in System.Classes) 被传递了一个TListSortCompare过程类型参数,该参数用于比较列表中的两个项(作为指针传递)。这允许以不同的方式比较项,因此可以对列表进行不同的排序。
我将尝试用另一个例子来解释它们:
程序 过程类型;

{$APPTYPE 控制台}

使用
  SysUtils 、 Math ;

类型
  TOperation  = 函数(Left , Right : Integer ): Integer ;

// 现在使用类型:
function  MapOperation ( const  A ,  B :  array  of  Integer ;  Operation :  TOperation ) :  TArray < Integer >;
var
  I :  Integer ;
begin
  SetLength ( Result ,  Math . Min ( Length ( A ) ,  Length ( B ))) ;
  for  I  :=  0  to  High ( Result )  do
    Result [ I ]  :=  Operation ( A [ I ] ,  B [ I ]) ;  // 调用传递的函数
end ;

// 用于打印数组的实用函数
。procedure PrintArray ( const A :Integer数组);var I :Integer ;begin for I in A do Write (I ,' ' );Writeln ;end ;


//以下函数将映射到前一个函数的 Operation 参数。procedure Addition  ( Left , Right : Integer ) : Integer ; begin Result := Left + Right ; end ;


程序 减法(左, 右: 整数): 整数;
开始
  结果 := 左 - 右;
结束;

var
  添加、 替换: TArray < Integer >;

开始
  // 将 Addition 作为操作参数传递:项目将成对添加。Adds
  :  =  MapOperation ([ 1 ,  2 ,  3 ,  4 ] ,  [ 5 ,  6 ,  7 ,  8 ] ,  Addition ) ;
  PrintArray ( Adds ) ;

  // 将 Subtraction 作为 Operation 参数传递:项目将成对减去。
  Subs  :=  MapOperation ([ 1 ,  2 ,  3 ,  4 ] ,  [ 5 ,  6 ,  7 ,  8 ] ,  Subtraction