
2.5D/3D封装原理解析:GPU+HBM如何集成在一起?
AI 生成文本,请理性甄别
你刷到的每一张 AI 旗舰显卡,宣传页都写着「XX 亿晶体管」「XX TB/s 显存带宽」。
但我猜很多人没细想过一个问题:
这颗芯片,压根就不是"一块"芯片。
拆开看(别真拆,拆了不保修),里面是一整个"小区":GPU 本体是两栋楼拼的,旁边还环绕着 8 栋"高层住宅",每栋楼里摞了 16 层内存,楼下还埋着一套四通八达的"地下管廊"。
把这几样东西焊到一块儿的技术,叫先进封装。
今天就把这层窗户纸捅破:2.5D、3D 封装到底是怎么把 GPU 和 HBM 揉到一起的。看完你会发现,芯片行业的军备竞赛,早就从"谁的晶体管多"变成了"谁家楼盖得妙"。
01 摩尔定律跑不动了,芯片开始「拼积木」
先说一个反常识的事实:芯片不是想做多大就做多大的。
光刻机曝光有个物理极限,一次能"印"出来的芯片面积有上限,行业黑话叫 reticle(曝光极限),大约 858 平方毫米。
知识卡:reticle 可以理解成印刷厂的"最大纸面"。一张纸再大也就 A0,你想印一整面墙?对不起,只能拼页贴。芯片也一样,单颗 die 顶天了就这么大。
更要命的是良率。
芯片是在一整片晶圆上"印"出来的,上面随便落一粒灰尘,整颗芯片就可能报废。芯片面积翻倍,废品率不是翻倍,是指数级暴涨——跟"考试蒙选择题,蒙的题越多,总有一题蒙错"是一个道理。
所以你想想看:
① 单颗芯片做不大(reticle 卡死)→
② 做大了良率崩(成本卡死)→
③ 摩尔定律还在放缓(工艺卡死)。
三条路同时被堵,怎么办?
做不大一整块,那就拼。
把一颗大芯片拆成几颗小芯片(行话叫 Chiplet,芯粒),各自生产、各自测试,合格了再拼到一起。单颗小、良率高、成本可控,还能像点菜一样混搭——CPU 用最贵的 3nm,接口电路用便宜的 28nm,各取所需。
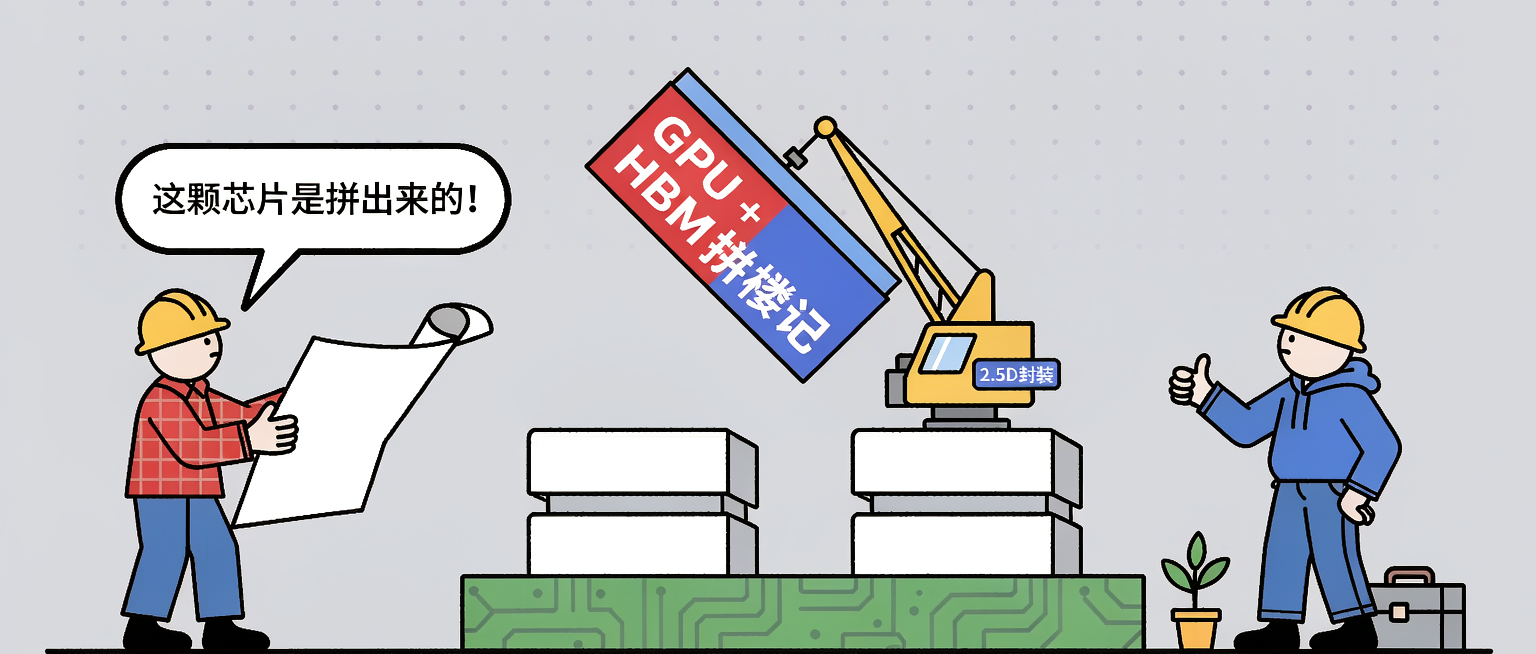
英伟达的 Blackwell,2080 亿个晶体管,就是两颗 die 拼出来的,中间用一条 10TB/s 的"内部高速路"连着。
但新问题来了:芯片拆开了,GPU 和内存之间的数据要怎么跑出每秒 20TB 的速度?
这就轮到封装登场了。
02 2.5D 封装:GPU 和内存当邻居,楼下修「地下管廊」
先看核心矛盾。
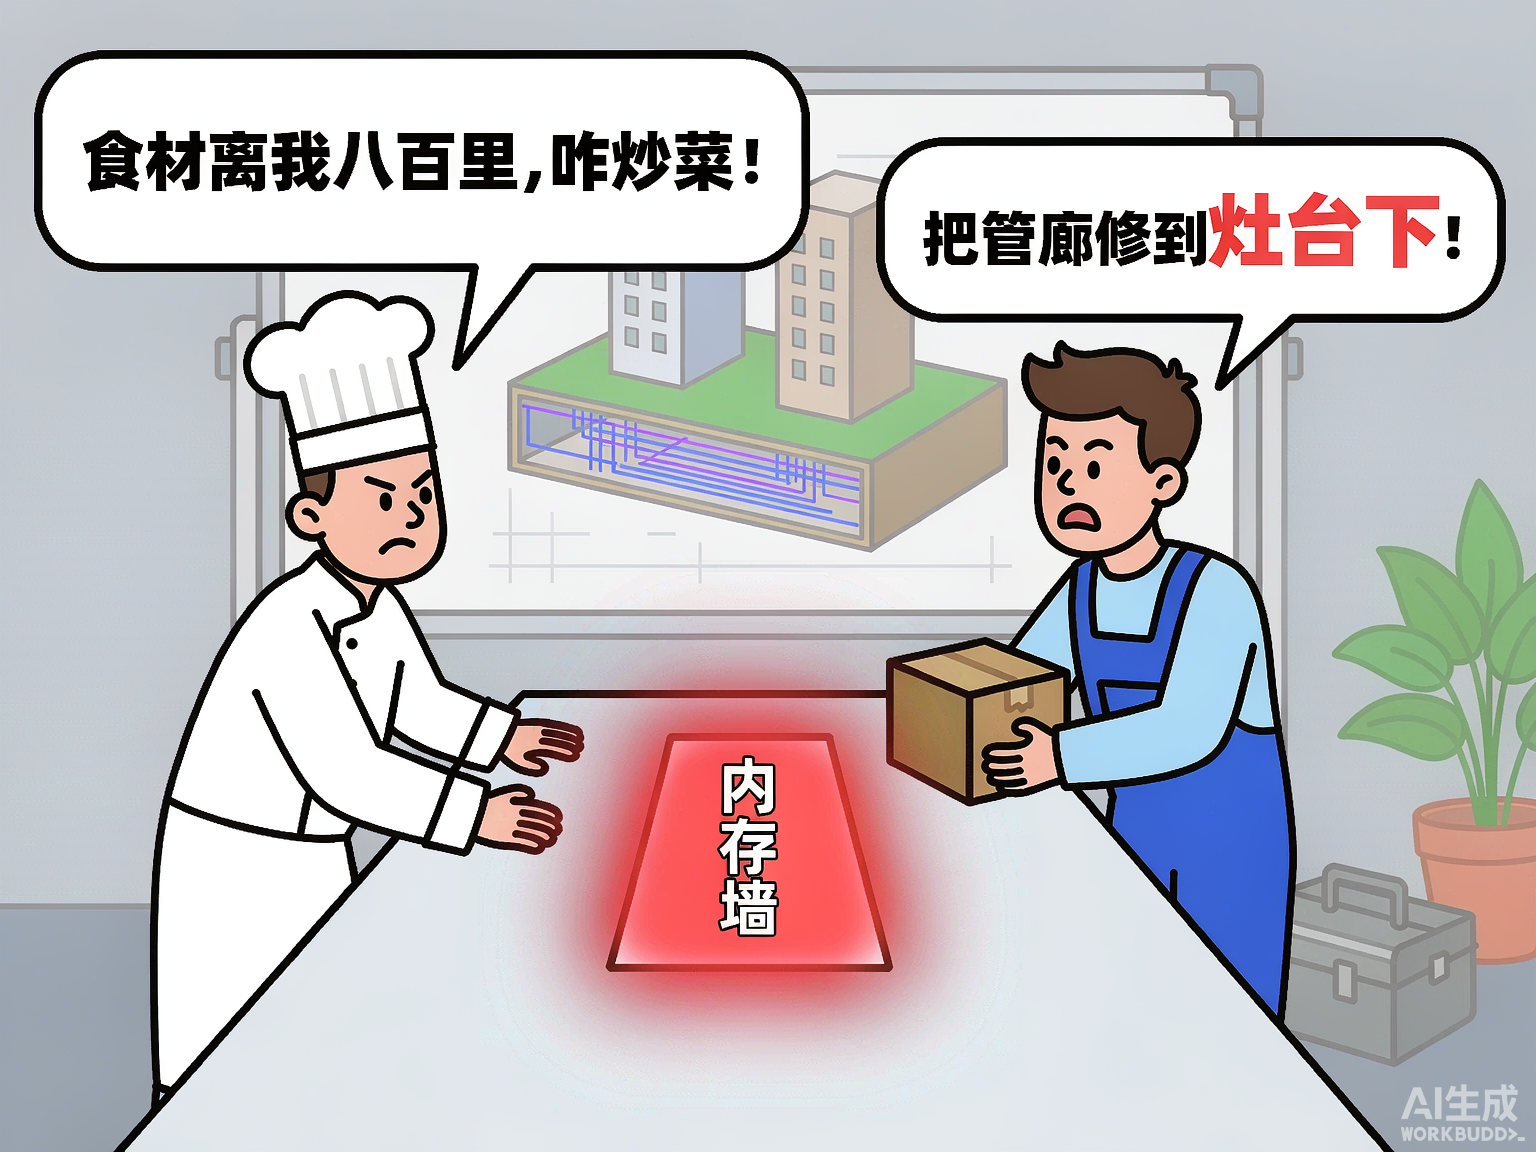
GPU 是顶级大厨,内存是食材仓库。大厨颠勺再快,食材一勺一勺从城郊仓库递过来,他也只能干瞪眼——这就是 AI 芯片最头疼的「内存墙」:算力每年翻着涨,内存带宽却在后面喘。
解决方案粗暴又优雅:把仓库搬到灶台边上。
传统内存插在电路板(PCB)上,离 GPU 隔着好几厘米。对每秒要搬运几十 TB 数据的 AI 芯片来说,这几厘米就是半个地球的距离。
于是工程师干了一件事:把 GPU 芯片和 HBM 内存芯片并排放在同一块基板上,近到什么程度?毫米级,下楼扔个垃圾的功夫就到了。
但并排放只是第一步,芯片之间怎么连线?
直接在 PCB 上拉线?太粗太稀疏,跑不出高速。工程师的答案是:在芯片们脚下垫一块特殊的硅片,叫中介层(interposer)。
知识卡:interposer(中介层)就像小区的地下综合管廊——水、电、燃气、网络线全埋在地下统一走线,楼上每栋楼(每颗芯片)打个洞直接接。 GPU 和 HBM 之间的万兆数据流,全从这层"管廊"里跑,又密又快还互不干扰。
注意一个细节:这块中介层是硅做的,里面要打上成千上万根垂直过孔——这就是 TSV(硅通孔)。
知识卡:TSV 可以理解成摩天大楼的电梯井——从顶楼直通地下车库的垂直通道。有了它,信号才能"拐直角弯":从上面的芯片钻下去,穿过中介层,再钻上来到隔壁芯片。
芯片贴在中介层上,靠什么导电?靠 micro-bump(微凸点)——芯片背面长满的一颗颗微型焊点。
知识卡:micro-bump 就像毛衣上的纽扣和扣眼,一颗对一颗,按上就通电。只是这纽扣小到离谱:直径只有几十微米,比头发丝还细,一颗芯片底下密密麻麻排着几万颗。
现在你可以对上号了,这套「并排放 + 中介层 + TSV + 微凸点」的组合拳,就是江湖人称的 2.5D 封装,台积电的招牌工艺叫 CoWoS。
为什么叫"2.5D"而不是 3D?
因为芯片们还是平铺在同一层,没有摞起来——这算 2D;但脚下的中介层里有 TSV 这种"立体结构"——又沾了点 3D 的边。
不上不下,2.5D,起名的人还挺实诚。
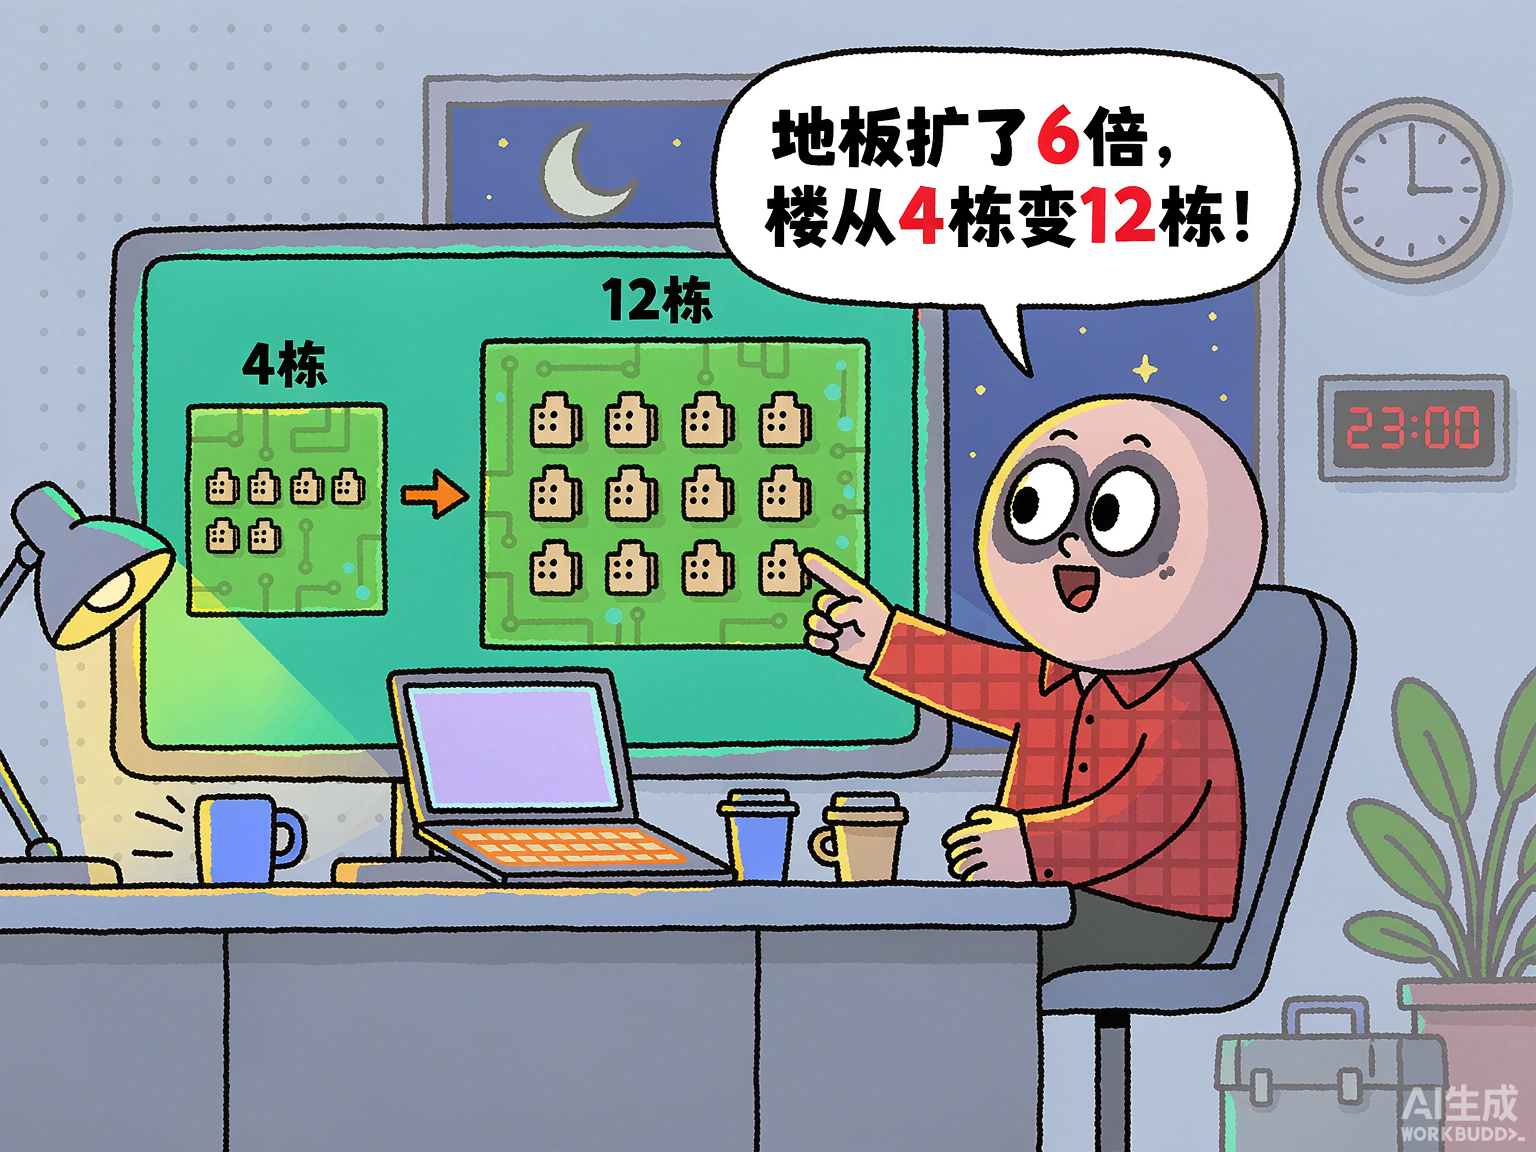
这套工艺有多能打?十年前 CoWoS 刚出来,那块"地板"只有 1.5 倍曝光极限大,摆 4 颗 HBM;到 2026 年 Rubin 这代,地板面积扩到 9 倍曝光极限,能塞 12 颗 HBM4。相当于小区从 4 栋楼扩到 12 栋,管廊照样四通八达。
03 3D 封装:不并排了,直接「摞着住」
2.5D 是当邻居,3D 就是干脆住上下楼——芯片垂直堆叠。
而 3D 封装最成功的作品,你天天在新闻里见:就是 HBM 本尊。
打开一栋 HBM"住宅楼"(抱歉,还是拆了,反正图是官方的):最底下是 base die(基础裸片),相当于一楼大厅加物业,负责对外联络;往上摞 8 层、12 层、最新的 HBM4 直接摞到 16 层 DRAM,像千层饼一样。
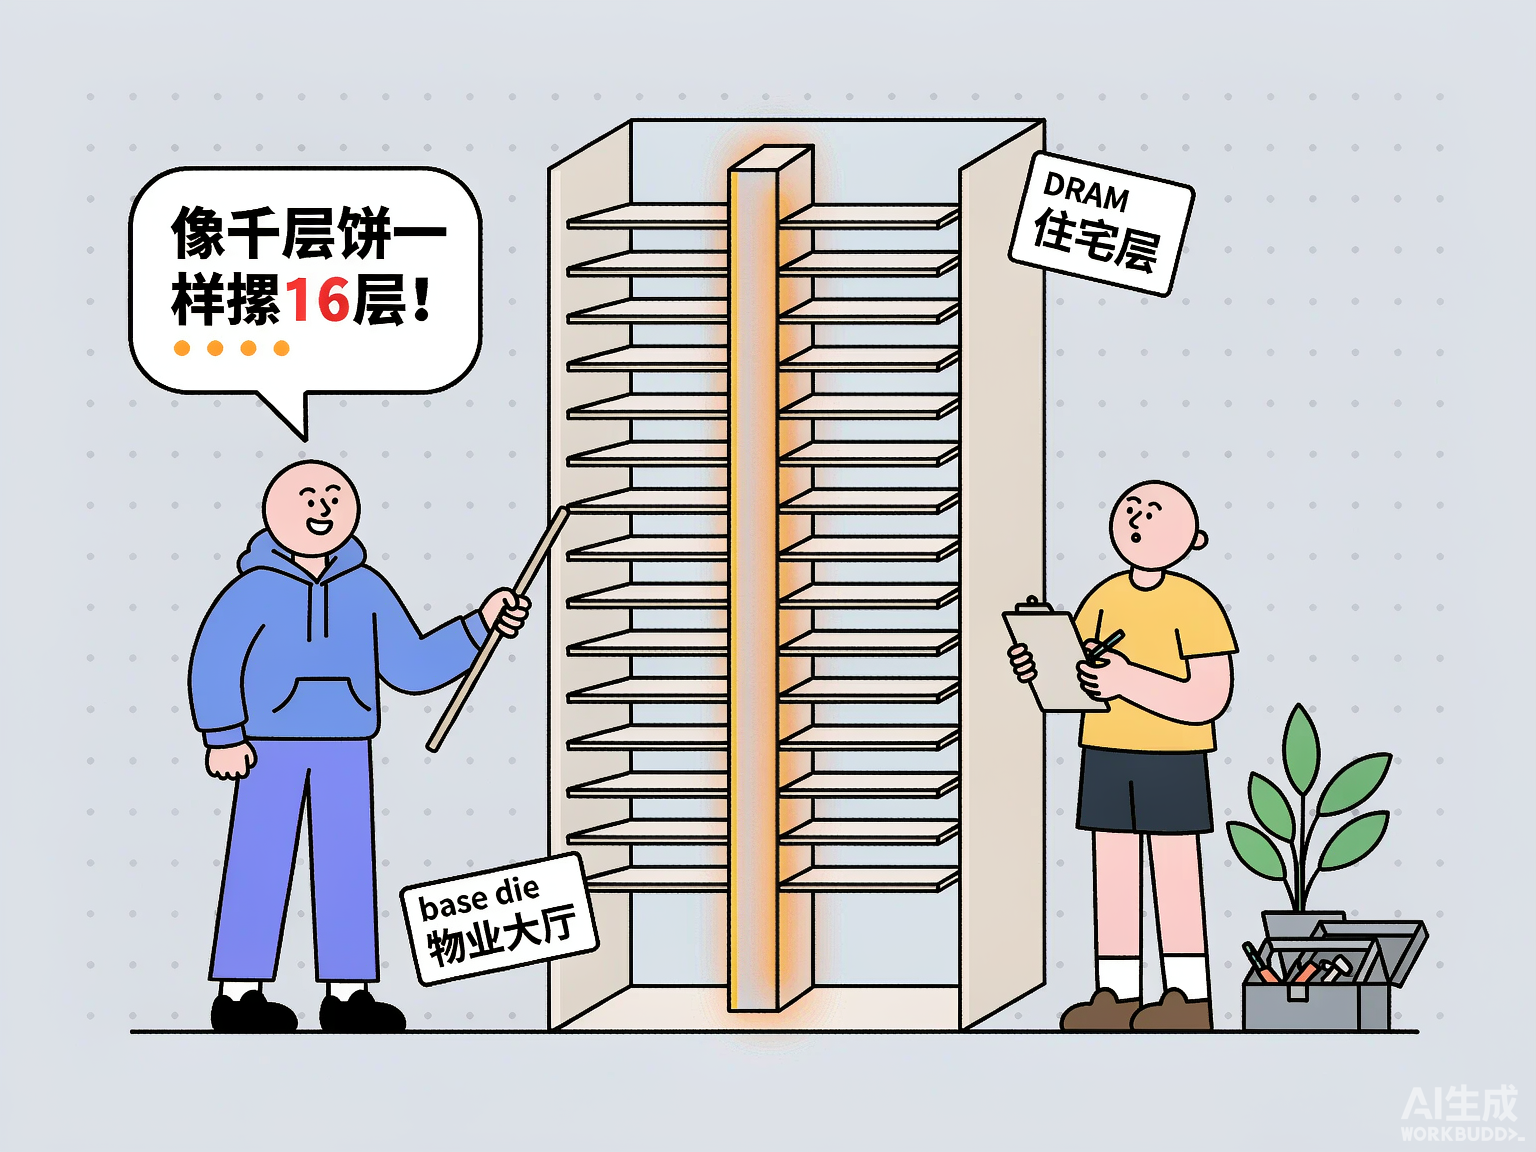
知识卡:为什么要摞?因为 DRAM 工艺和 CPU/GPU 工艺不兼容,没法直接做在一颗芯片里。那就分层盖楼:内存归内存,逻辑归逻辑,用 TSV 电梯井垂直打通。占地小、容量大、距离近,一举三得。
层与层之间怎么连?还是老朋友:每层芯片的 TSV 打穿自己,层间垫 micro-bump,纽扣对扣眼。
但 3D 封装的天花板,是 micro-bump 的物理极限:纽扣做得再小,也有个头。目前微凸点间距做到 10 微米级就到头了,想再密?
工程师掏出了终极大招:Hybrid Bonding。
知识卡:micro-bump 是「插头对插座」,Hybrid Bonding 是「直接焊死」——两层芯片的铜触点在原子层面直接长在一起,中间不留焊料、不留缝隙。间距可以压到 1 微米以下,密度直接翻十倍。台积电的 SoIC、AMD 的 3D V-Cache,用的就是这类技术,缓存堆到 CPU 头顶上。
从"插头插座"到"分子级焊接",3D 封装的故事才刚开场。
04 一颗旗舰 GPU 的诞生:一场全球供应链的「拼盘」
原理讲完了,说点扎心的现实。
先进封装,现在是全球掐得最狠的战略资源,没有之一。
你以为是台积电想扩产就能扩?CoWoS 产能 2025 年底月产约 7.5 万片,2026 年计划干到 13 万片——接近翻倍。但其中六成,被英伟达一家包场。
HBM 那边更是神仙打架。SK 海力士靠 HBM 咸鱼翻身,HBM 一项已经占到它 DRAM 收入的一半——几年前这个比例还是 8%。三星在后面猛追,美光卡位补刀。
到 2026 年的 Rubin 这一代:
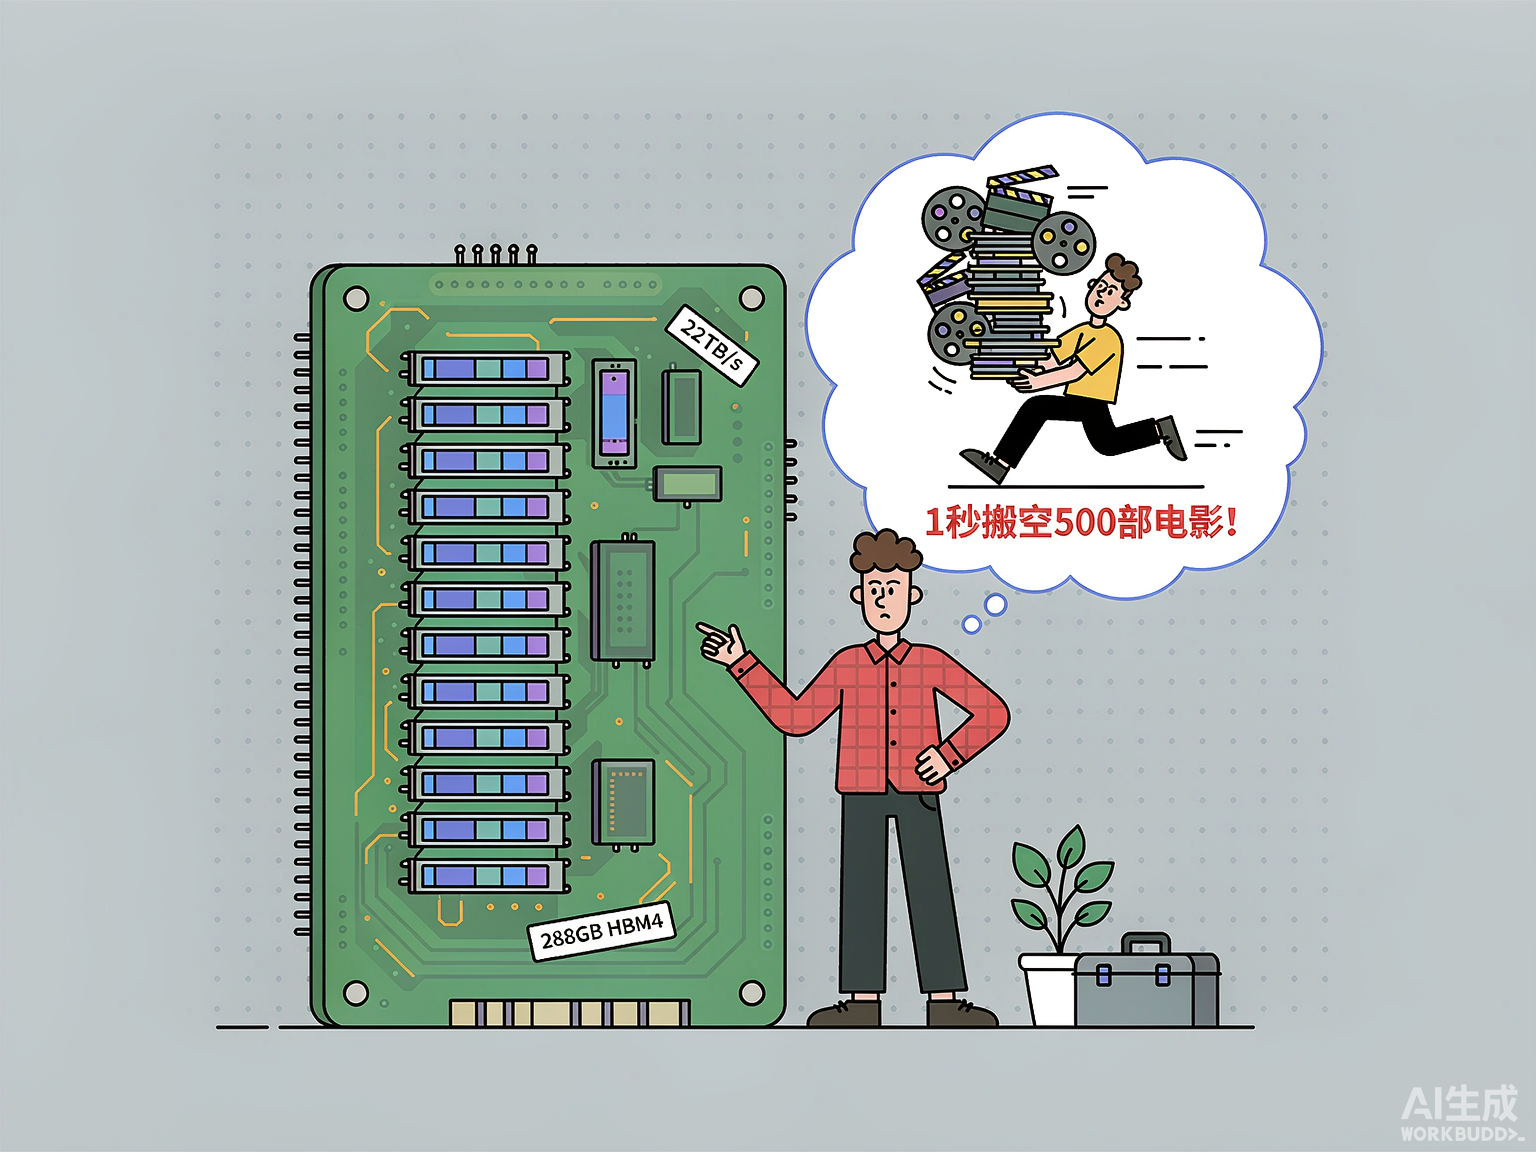
- 单颗 GPU 配 288GB HBM4(16 层堆叠 ×8 栋楼)
- 带宽干到 22TB/s——相当于 1 秒搬空 500 部高清电影
- HBM4 接口位宽从 1024-bit 翻到 2048-bit,单栈带宽直接翻倍
- 连 HBM 的 base die 都升级用了台积电 12nm 逻辑工艺——内存公司开始找晶圆代工厂"精装修"了
所以你再看那句行业黑话——「封装决定算力上限」——现在明白啥意思了吧?
晶体管密度卷到头了,接下来拼的就是:谁家管廊修得密、楼摞得高、电梯井打得直。
灵魂拷问时间
看完这篇,下次再有人跟你聊 AI 芯片,你可以甩出三个问题,问倒一大片:
① 他知不知道旗舰 GPU 是"拼"出来的?——分不清 die、芯粒和封装的,多半连参数表都没读懂。
② 他能不能讲明白 2.5D 和 3D 差在哪?——一个是"邻居共用地下管廊",一个是"上下楼共享电梯井",一句话的事,讲不出来就是背名词。
③ 他知不知道 HBM 为什么必须堆 16 层?——工艺不兼容 + 容量要大 + 带宽要近,三个约束逼出来的工程最优解,不是营销话术。
看懂封装,才算看懂了这轮 AI 军备竞赛的真实打法:
芯片的性能神话,一半写在晶体管里,另一半埋在那一层没人正眼瞧过的"管廊"里。
下次再有人吹"一颗芯片吊打全场",你就问他一句:你这颗"芯片",到底是几块拼的?
AI 生成文本,请理性甄别
