
很多人想象中的智算中心,还停留在"一排排机柜、嗡嗡的风扇、防静电服的运维员"。这种理解基本等于把一座城市定义成"一堆房子"。传统数据中心是给 CPU 住的公寓:存数据、跑网站、处理交易,单柜功率 6-8kW,安静克制。智算中心则是给 GPU 住的钢铁厂:不存钱,只烧钱,用电费换模型权重。
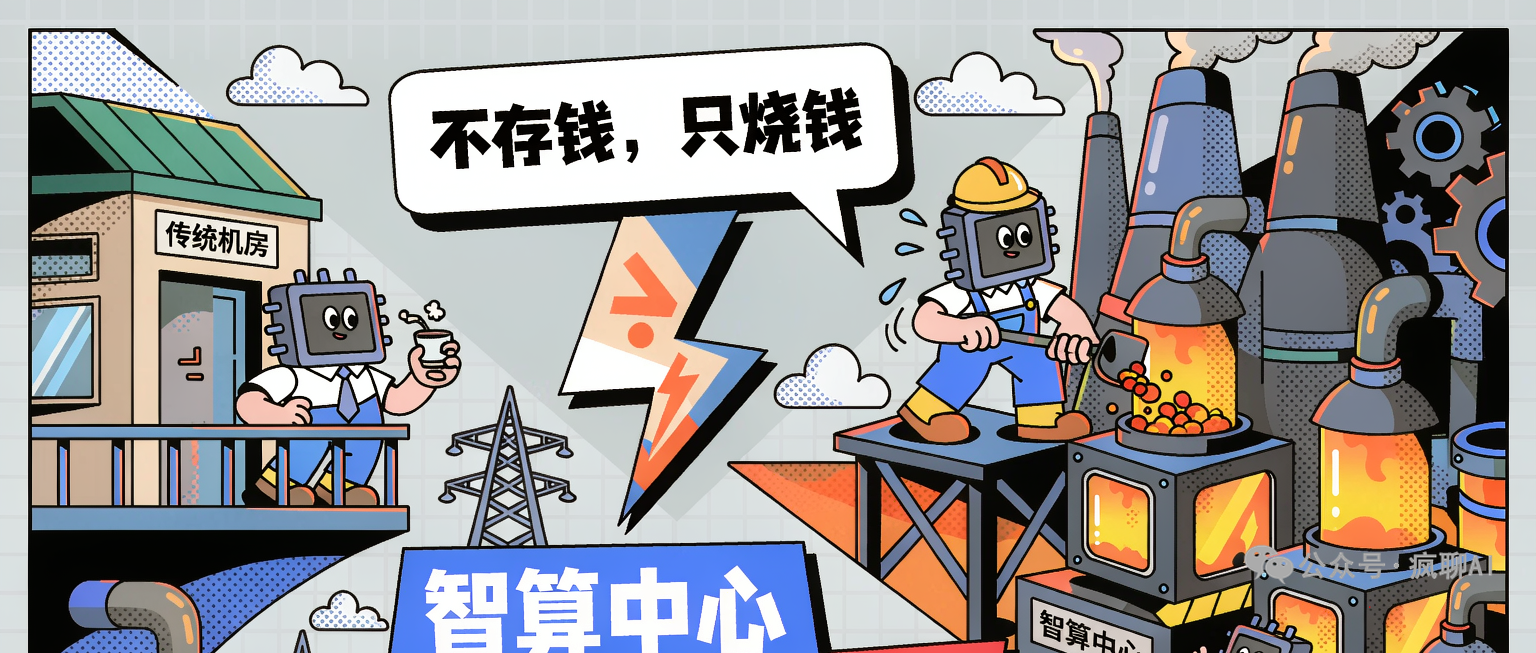
先看一组对照,你就明白"多买几台服务器凑一凑"的想法会死得有多难看。
| 对比项 | 传统数据中心 | 智算中心 |
|---|---|---|
| 核心器件 | CPU 为主 | GPU/AI 加速卡为主,CPU 当管家 |
| 单柜功率 | 6-8kW | 40kW 起步,高密可达 100kW 以上 |
| 制冷方式 | 风冷为主,精密空调 | 冷板式/浸没式液冷成主流 |
| 网络形态 | 以太网够用 | IB/RoCE,卷到 400G、800G |
| PUE 目标 | 1.4-1.5 常见 | 政策口径已压到 1.25 以下 |
表里每一行,都对应一场被迫重写的技术栈。我们从最贵的那层说起。
一、算力层:一群吞电的怪物
智算中心的核心是 GPU 服务器,主流形态是 8 卡:一台机箱塞 8 张 GPU 卡,配两颗 CPU 和若干 NVMe 固态盘。单台功耗动辄 6-10kW,一个 42U 机柜通常只放得下 4-6 台——不是四十台,是几台就把柜子吃满。密度一上来,供电、布线、承重全被拖下水。CPU 退居二线当管家,是因为两者追求不同:**CPU 追求低延迟,把单件事做到极致;GPU 追求高吞吐,把总产出做到极致。**训练大模型不需要大厨慢慢雕花,需要一千个切菜工同时切土豆。
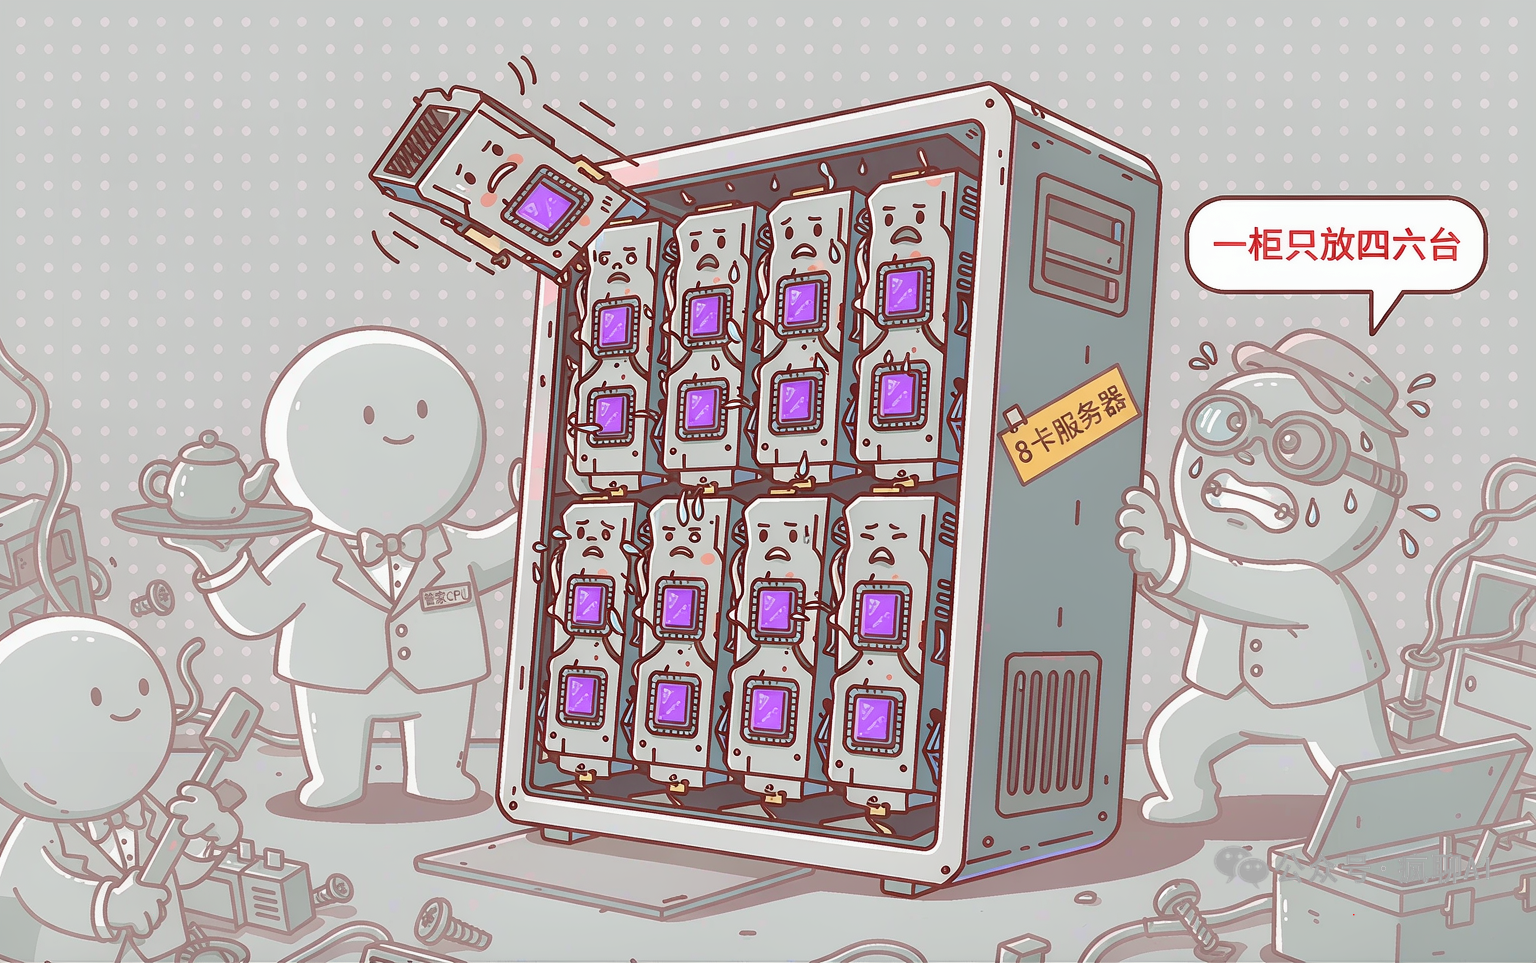
GPU 与 CPU:CPU 像学校里什么都懂、但一次只能处理一件复杂事务的教导主任;GPU 像操场上几千个只会做加减法的小学生,单拎出来很笨,一声令下却能同时做完几千道题。AI 训练是海量矩阵乘法,天生适合人海战术,于是 GPU 当主角,CPU 退居二线做管家。
二、供电系统:GPU 面前,电网才是甲方
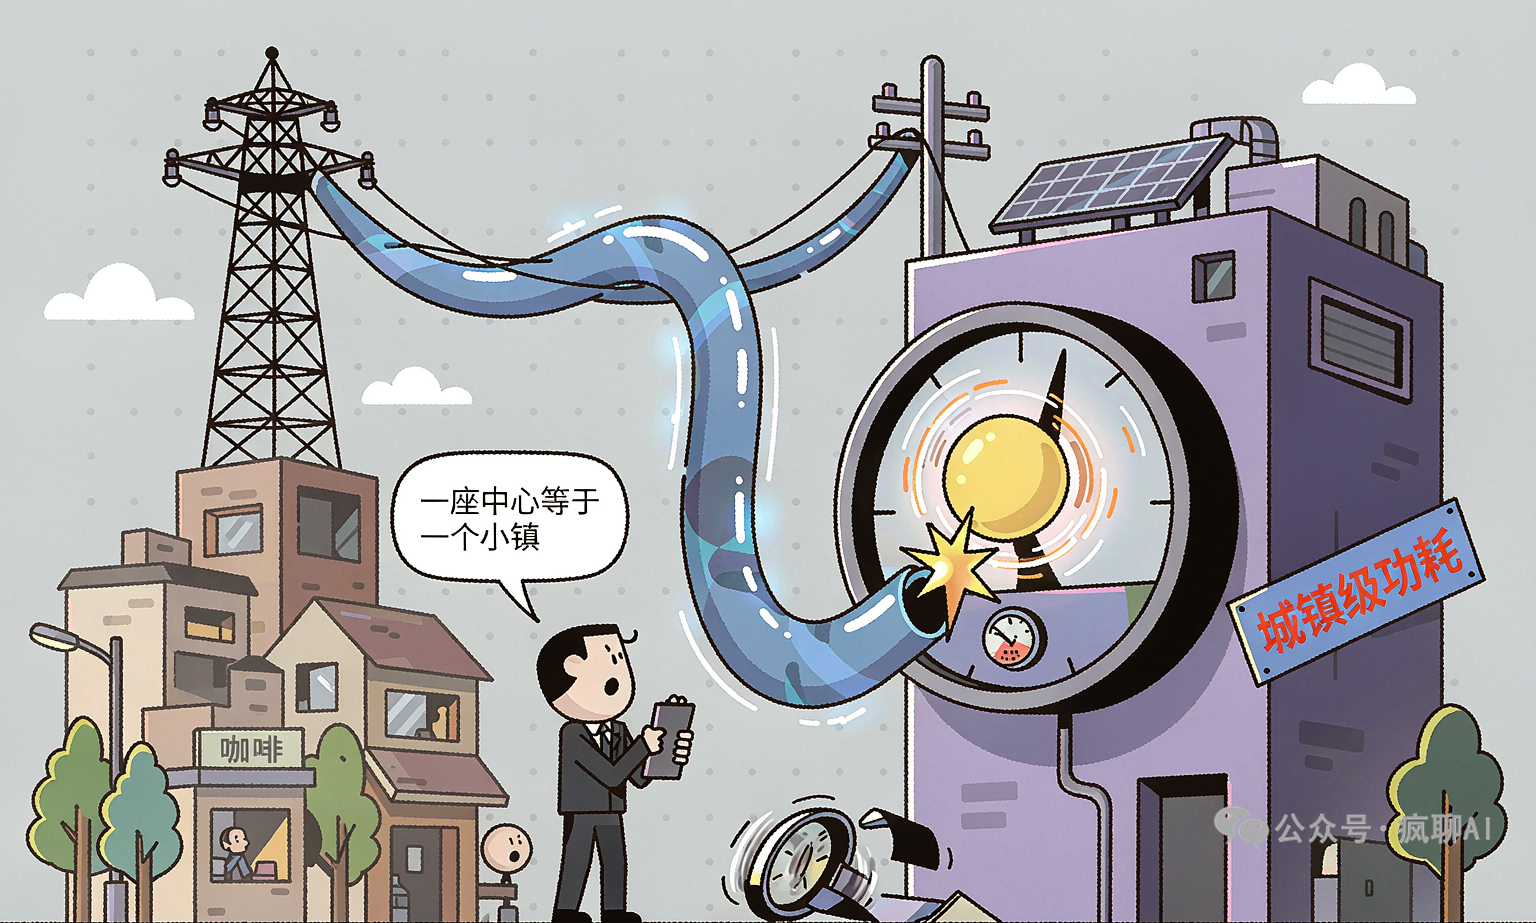
一座中型智算中心的功耗相当于一个小型城镇。电从市电进来,经变压器降压、配电柜分流,最后钻进机柜;真正的生死线在 UPS 与柴油发电机:前者零延迟顶住停电后的头几十秒,后者轰鸣着启动,接手往后十几个小时。少任何一环,一次电网抖动就能让训练了几周的任务当场猝死。
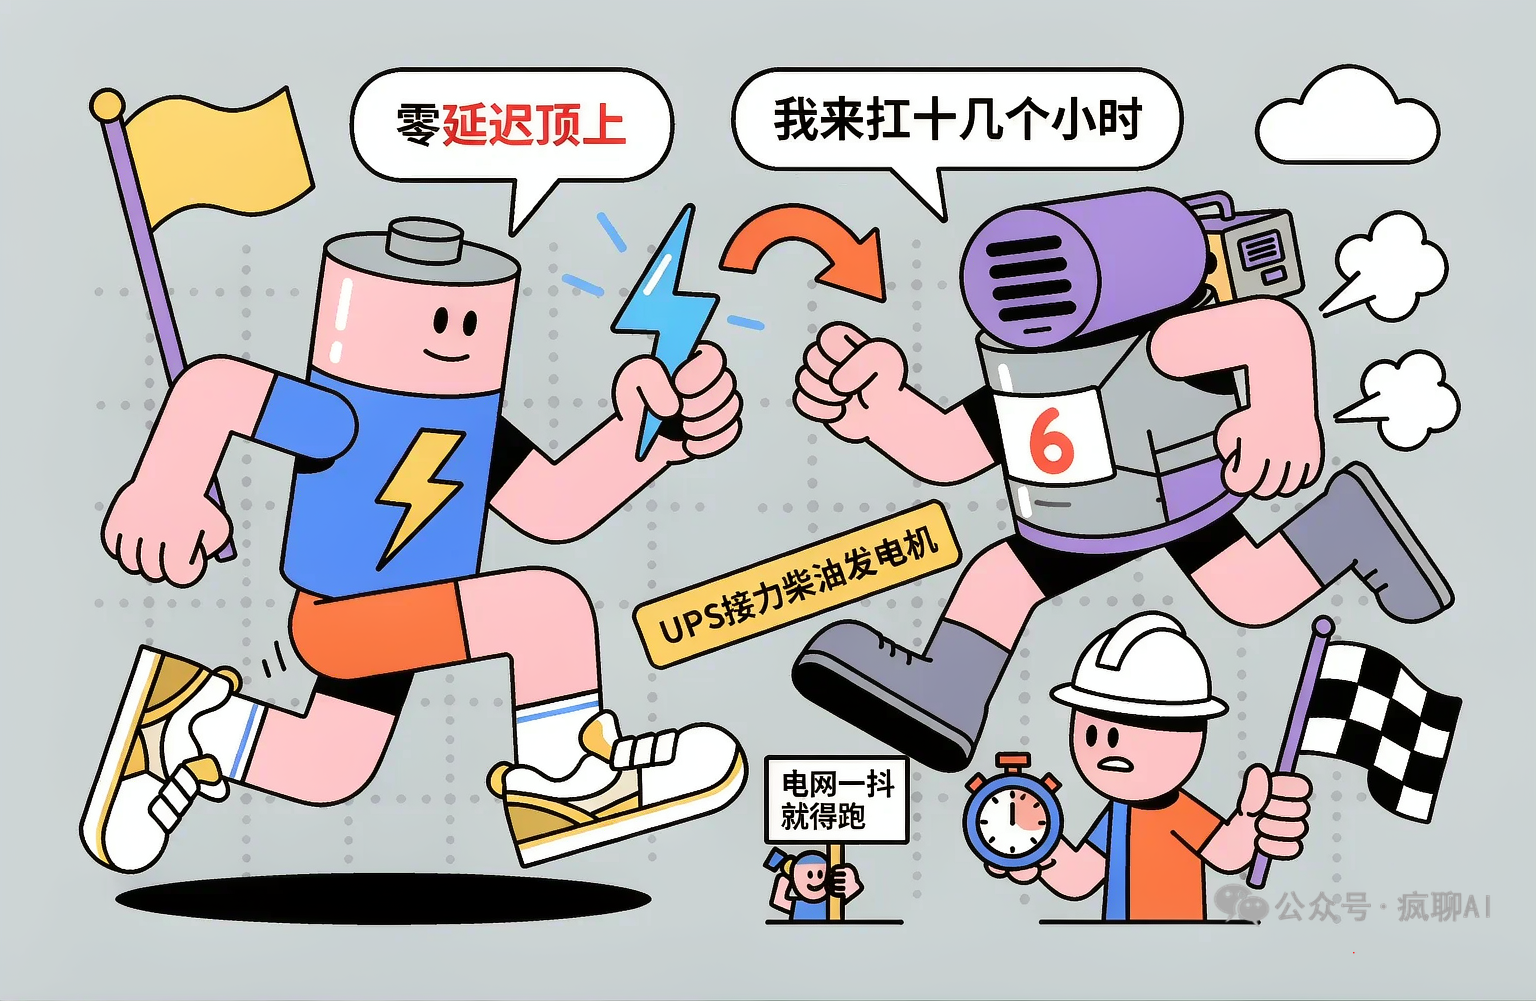
UPS 与柴油发电机:UPS 是短跑冠军,靠电池组在停电瞬间无缝顶上;柴油发电机是马拉松选手,启动要几十秒,但能扛一整夜。两者接力,才配得上"永不断电"四个字。类比餐厅:断电瞬间先亮应急灯稳住客人,同时把后厨的备用发电机拉起来。
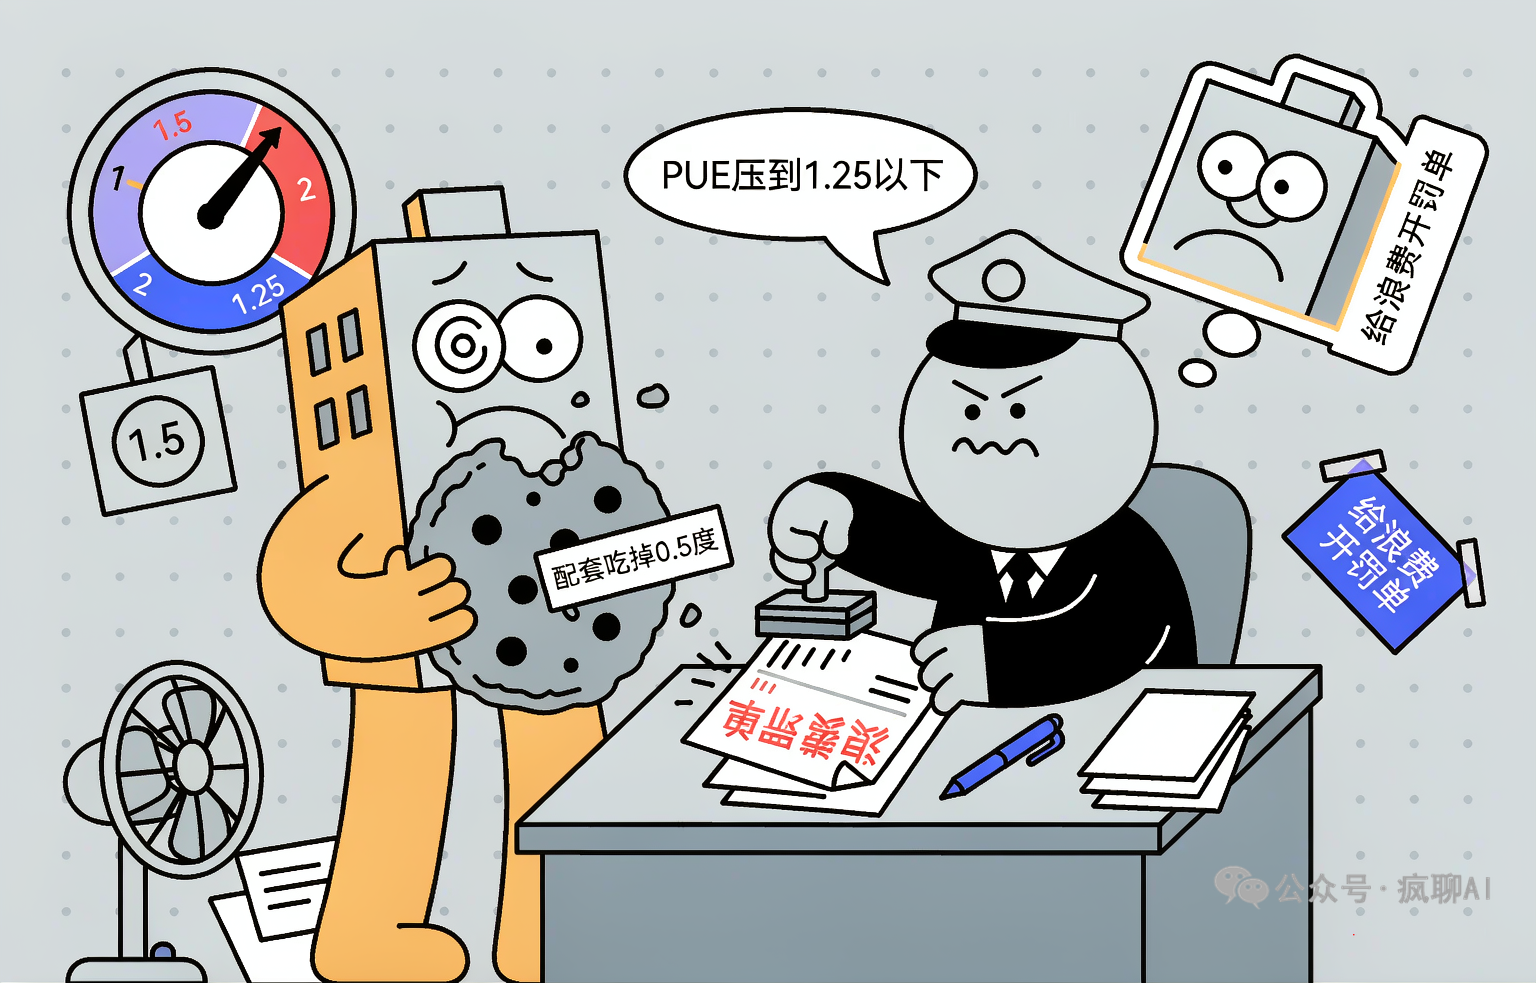
PUE(电源使用效率):PUE = 数据中心总耗电 ÷ IT 设备耗电,理想值 1.0。现实里空调、风扇、变压器都在偷电,PUE 1.5 意味着服务器每用 1 度电,配套设施还要吃掉 0.5 度。国内在"东数西算"等政策口径中,已要求新建大型数据中心 PUE 压到 1.25 以下——本质上是在给浪费开罚单。
真正让工程师崩溃的,是功率密度的量级跳跃:从 6-8kW 到 40kW 起步,高密集群超 100kW,宣传甚至喊到 130kW。很多老旧机房改造失败,不是买不起 GPU,而是那栋楼的电力配额根本批不下来。智算中心的第一道门槛,从来不在芯片,在电网。
三、制冷系统:风扇已经吹不动 GPU 了
电进来之后,几乎全部变成热量。GPU 不懂什么叫省着用,满载时就是一块贴在主板上的电暖器,还全年无休。传统风冷把机房吹成巨型空调房,但机柜功率超过约 20-30kW 就走到尽头:所需风量大到人站不稳,噪音堪比机场跑道,能耗还失控。于是液冷登场——它既把 PUE 压得更低,也让 GPU 不容易降频:否则训练时间悄悄变长,账单悄悄变贵,看上去没人受伤,除了你的钱包。
液冷:用液体代替空气搬热量,两条主流路线。冷板式——把带水路的金属板贴在 GPU 和 CPU 上,其余部件仍吹风,成本低、兼容老机房,是当前主流;浸没式——把整台服务器泡在不导电的冷却液里,像把主机丢进鱼缸,效率更高,维护起来像半只脚踏进化工厂。液体导热远强于空气,好比用流水冲烫手的锅,远比吹气有效。
四、网络系统:三张网,各管一摊
GPU 是工人,网络就是工人之间的传送带。大模型训练讲究同步:几千张卡各自算完,必须交换对齐才能迈出下一步。任何一条链路慢半拍,其余几千张卡就得集体陪它干等——这不是某个工人偷懒,而是整条产线停产。带宽和延迟,直接决定卡的利用率。
智算中心通常铺三张物理隔离的网:计算网专管 GPU 之间传梯度,走 InfiniBand 或 RoCE,带宽从 100G、200G 卷到 400G、800G;存储网负责把训练数据搬到 GPU 嘴边,多用高带宽以太网;带外管理网最不起眼却最要命,只管远程开关机、刷固件、收告警。分开布置,就是怕训练流量把管理通道挤爆,让机器"还活着,却叫不应"。最经典的黑色幽默是:买了几千张卡,利用率却只有三到五成,罪魁不是 GPU,而是没调优的通信——法拉利开在乡间土路上。
InfiniBand 与 RoCE:两者都是让服务器之间高速搬数据的技术,追求高带宽与极低延迟。InfiniBand 像学校里专修的教师通道,快且稳,但要用专属设备,价格不菲;RoCE 像在普通校园网里划出的 VIP 车道,便宜通用,却需要精细调教。类比:前者是救护车专用道,后者是给快递车开的公交专用道。
五、存储系统:喂饱 GPU 的粮仓
GPU 再快,喂不进数据也只能空转成烤箱。训练数据集动辄几十 TB 到 PB 级,而且不是一份文件慢慢读,是几千张卡同时发疯般抓取样本。传统存储阵列在这种并发面前,像早高峰只开两个收费口的收费站——车是真的多,口是真的窄。
并行文件系统(如 Lustre、GPFS):把大文件切成很多块,分散存放在几十上百台存储服务器上,读取时大家一起出货。类比食堂:普通存储是只有一个打饭窗口的食堂,几千人排长龙;并行文件系统则同时敞开几百个窗口,人人立刻端走自己那盘菜。它专治"数据喂不上"。
实际部署还要分层:热层跑全闪 NVMe,承接高并发读取,最快也最贵;冷层用对象存储甚至磁带库做归档容灾。还有件苦活叫检查点(Checkpoint):模型参数得定期整份落盘,否则某张卡一挂,几天的训练成果就地清零。一次写下几百 GB 甚至 TB 级,写得慢,全集群都得陪它散步。
六、软件与调度层:让几千张卡别打架
集群管理系统负责给每台机器装系统、配网络、拉起训练框架,并盯着每张 GPU 的温度、显存与故障;之上是算力调度平台,决定哪个任务用哪批卡、用多久、能否被打断。
算力调度平台:可以理解为 GPU 集群的"排课系统"。它把任务当课程、把 GPU 当教室:谁能并行、谁优先、能否插队、挂了要不要自动重排,全由它说了算。类比学校教务处——它不讲课,却决定全校这张课表能不能转起来。
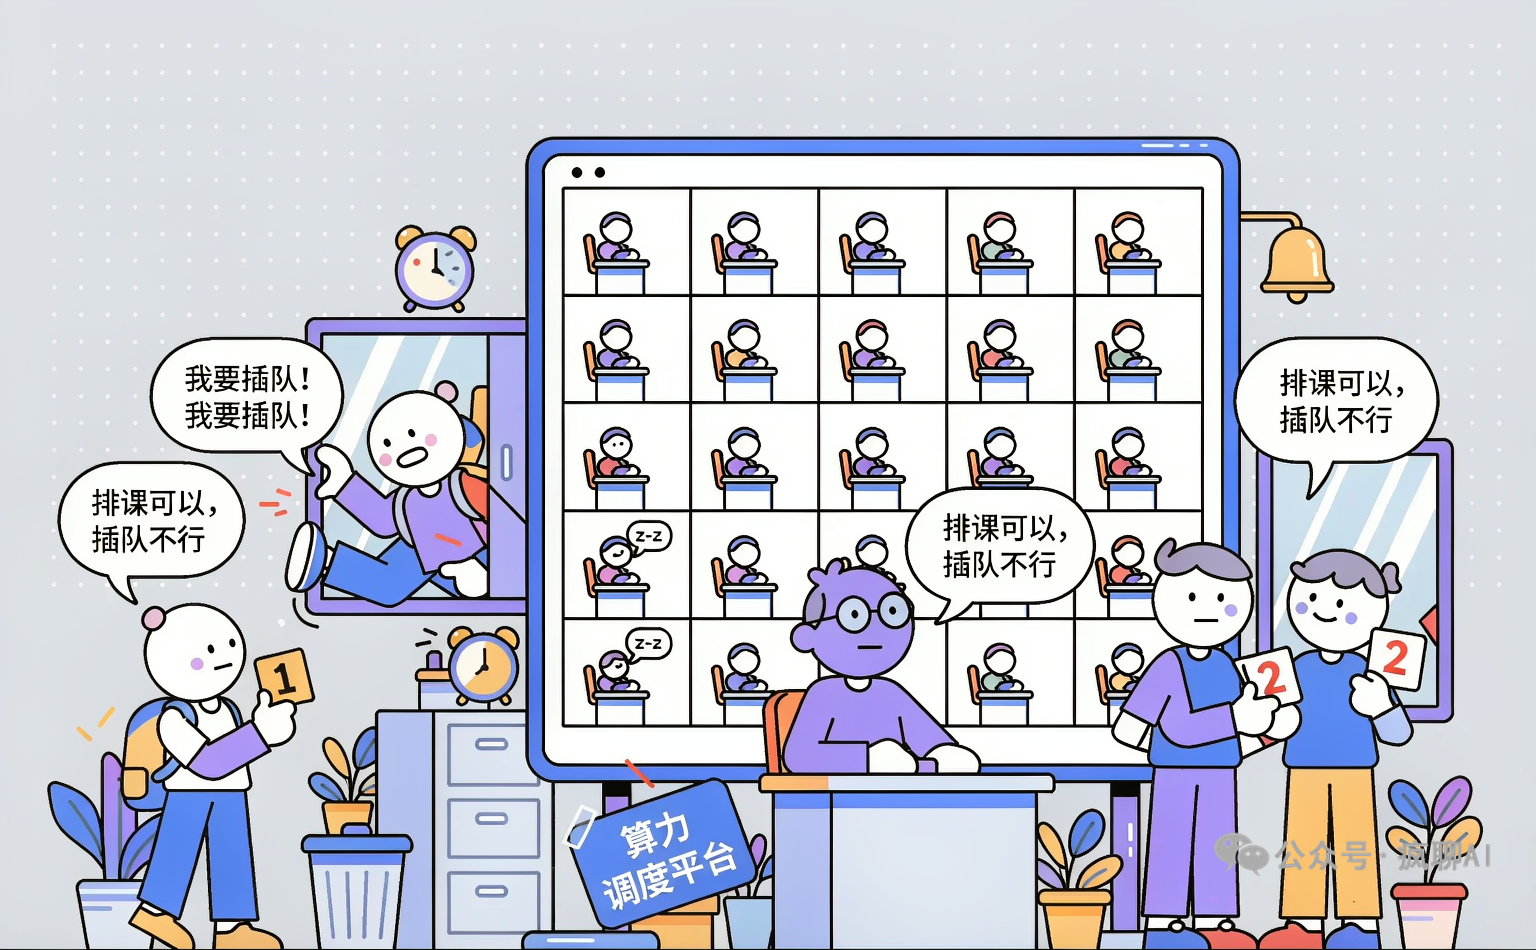
它最现实的功能是切分与排队:没有配额、抢占和虚拟化切分,一个小实验就能独占整机,让几千张卡陪它熬夜。而真正的黑色幽默在于,很多集群最稀缺的不是卡,是愿意排队还心平气和的人。再往上的 AI 平台层把"一堆 GPU"包装成"一种服务"——硬件决定智算中心的下限,软件决定它的上限。
七、建筑、消防与安防:不性感但致命
最先被忽略的是地基。装满 GPU 服务器与液冷管路的机柜远超传统机柜的重量,楼板承重必须重算,不少老旧机房改造就卡死在这一关。选址还要看防雷、防洪和电网接入条件——把几十亿的设备建在泄洪区,是一种非常昂贵的幽默。
消防同样特殊:机房里不能随便喷水,主流做法是极早期烟雾探测加气体灭火(IG541、七氟丙烷),把氧气压到不支持燃烧的水平。安防是层层门禁、生物识别、监控与审计日志,物理世界锁门,数字世界锁权限。至于运维,除 7×24 值班和备件库,最敏感的神经永远是漏液检测。
八、结语:一座把电力炼成智能的工厂
把这些串起来,智算中心的本质朴素得近乎冷酷:**它是一座把电力转换成智能的工厂。**电网把电送来,供电系统稳压整流,制冷系统运走废热,网络让几千张 GPU 像一个大脑那样协同,存储持续投喂数据,软件把它们组织成有效劳动,最后由模型吐出"智能"。
所以智算中心绝不等于"放了很多 GPU 的机房":从 6-8kW 到 40-130kW 的密度革命,逼着供电、制冷、网络、存储、软件全栈重写。真正稀缺的,从来不是某一张卡,而是把电、冷、网、算、管五件事同时做对的系统能力。
下次听说某地又建成一座智算中心,不妨问三个问题:**它的电从哪来?它的热量去哪了?GPU 平均利用率是多少?**三个都答不上来的,大概率只是把一堆电暖器,锁进了一间很贵的房子里。
对智算中心建设与运营有兴趣可以通过关注图片右下角水印公号与小编联系,小编公司提供智算建设与运营服务。
