
计算机系统基础/ICS 笔记
第一章 计算机系统概述
计算机基本工作原理
冯诺依曼结构基本思想(⭐⭐⭐)
基本思想的五个方面,考到了记得抄。
冯诺依曼机基本结构(⭐⭐⭐)
那个图会认就行。
程序和指令的执行过程(⭐⭐⭐)
取指令,更新 PC,取数译码,送结果的循环。
程序的开发与运行
程序设计语言和翻译程序(⭐⭐⭐)
机器语言,汇编语言,高级语言。
汇编程序,解释程序,编译程序。
从源程序到可执行文件(⭐⭐⭐)
预处理,编译,汇编,链接。
计算机系统的层次结构
计算机系统抽象层的转换(⭐⭐⭐)
用户程序,os,isa,微体系结构,电路差不多就是这个顺序,isa 就是软硬件的交界处。
计算机系统的不同用户(了解)
软件分为系统软件和应用软件。
用户分为最终用户,系统管理员,应用程序员,系统程序员。
计算机系统性能评价(⭐⭐⭐)
就是套公式算一算就行了。
用基准程序进行性能评估(了解)
拿一个相同的程序在不同的机器上运行,控制变量。
amdahl 定律(了解)
简单的数学公式。这也能叫定律吗。
第二章 数据的机器级表示与处理
浮点数表示(⭐⭐⭐)
熟悉一下浮点数表示即可。
IEEE 754 标准表示小数:+/-1.xxxxxx * 2^Exponent
单精度浮点数,符号位 1 位,阶码 8 位,尾数 23 位。阶码从 0000 0001(-126) ~ 1111 1110(126),偏置常数 bias=127。这些是规格化数 normalized。
全 0 和全 1 表示特殊值。
- 阶码 0,尾数 0,表示 0
- 浮点数中,除数为 0 的结果是 +/-inf,不认为是溢出异常
- 阶码全 1,尾数 0,根据符号不同表示 +/-inf
- 有些结果是 nan(not a number),例如 0/0,和正负无穷相加
- 阶码全 1,尾数不为 0
- 阶码 0,尾数不为 0,叫做非规格化数 denormalized。
- 规格化数最小表示 2^-126,而 [0, 2^-126) 之间再平均划分 2^23 个区间,用来表示最小刻度之下的数字。
浮点数的精度例子
- 61.419998 和 61.420002 是两个可表示数,所以当输入 61.419999 的时候,会找到更近的哪个数字变过去 61.419998。
数据的基本运算
加减法(⭐⭐⭐)
主要关注四个标志位。
ZF 判断是否为 0,SF 判断最高位是否为 1,这两个简单。
OF 判断有符号数是否溢出(通过看运算数是否合理,比如正数+正数=正数),CF=Cin^Cout 判断无符号数是否溢出/借位。
乘除法(了解)
浮点数运算(⭐⭐⭐)
加减法,先把 2 的幂对齐,对齐方法就是若 Ex<=Ey,则 Ex'+=Ey-Ex,但是尾数就右移 Ey-Ex 位,小的向大的看齐。
我草太复杂了。
第三章 程序的转换及机器级表示
程序转换概述
生成机器代码的过程(⭐⭐⭐⭐⭐)
预处理-编译-汇编-链接。
Intel 格式和 AT&T 格式指令
二者表达相同的语义,但是语法稍有不同。
AT&T 格式特征:
- 寄存器名带%(如%ax、%bx)。
- 指令操作数顺序是 “源在前,目标在后”(比如addw %bx, %ax,是把bx的值加到ax里)。
- 指令后缀表示操作数长度(b字节、w字、l双字,如addw是 “字加法”)。
Intel 格式特征:
- 寄存器名不带%(如ax、bx)。
- 指令操作数顺序是 “目标在前,源在后”(比如add ax, bx,是把bx的值加到ax里)。
解读 AT&T 指令
以 "imull $(-16), (%eax, %ebx, 4), %eax" 为例:
- imull 分为 imul 和 l,表示有符号乘法,32 位;
- (%eax, %ebx, 4) 是内存寻址逻辑,%eax 是基址,%ebx 是变址,4 是比例因子,即找到 %eax + 4 * %ebx 的位置
- %eax 是目的,运算结果存放处
- 用PTR、BYTE等关键字指定操作数长度(如ADD WORD PTR [bx], ax)。
IA-32 指令系统概述
x86, IA-32, x64 的关系
x86 是 Intel 最早的一批处理器系列,只有 16 位,因为以 86 结尾所以称为 x86。IA-32 是扩展到 32 位的版本,兼容了 x86 的指令。x64 是 64 位版本。
ISA 和 ABI 的关系
CPU 只需要考虑 ISA 规范:ISA(指令集架构)是 CPU 的 “语言规范”(也就是指导电路怎么连接),定义了 CPU 能执行的指令格式、操作、寄存器使用等。比如 x86-64 架构的 CPU,只需要按照 x86-64 的 ISA 规范设计,能识别并执行mov、add等指令即可,不需要关心 ABI。
ABI 是软件层面的规范:ABI(应用程序二进制接口)是给编译器、操作系统、应用程序定的规则,规定了 “二进制程序之间怎么交互”(比如函数传参、内存布局、系统调用方式)。CPU 本身不直接参与 ABI 的实现,而是由软件(编译器、操作系统)遵循 ABI 来生成和运行二进制程序。
寄存器
IA-32 有 8 个通用寄存器,2 个专用寄存器,6 个段寄存器。其中 EAX, EBX, ECX, EDX 属于通用寄存器(General-Purpose Registers, GPRs),他们的低 16 位称为 AX, BX, CX, DX,这是为了兼容 x86 的寄存器。
EFLAGS 属于专用寄存器,叫标志寄存器,其有 32 位。数字系统中的 ZF, CF, OF, SF 在这 32 位中占 4 位。
寻址方式(⭐⭐⭐⭐⭐)
立即寻址——直接用立即数。
寄存器寻址——给出操作数的寄存器。
弄清楚几个概念,根据 P99 的表格熟悉一下。(SR) 某个段的开头,A 是直接给出位移量,(B) 位移量在 B 寄存器中,(I) 变址在 I 寄存器中,S 比例系数。
机器指令格式(⭐⭐⭐)
一个通用的机器指令格式。
IA-32 常用指令类型和操作(⭐⭐⭐⭐⭐)
传送指令
mov 和 lea 都必考。
定点算数运算指令
加减乘除之类的,稍微有点印象即可。CMP 指令是目的操作数减源操作数。
按位运算指令
逻辑和移位,同样是看一看。
控制转移指令(⭐⭐⭐⭐⭐,重中之重)
不过也是对着表格看看即可。
setcc 就是说把 jcc 对应的判断条件放在某个寄存器中。
call 指令:返回地址压栈,跳转到指定地址执行。
ret 指令:ret 逻辑上等价于 pop %eip(尽管汇编中不能直接操作 %eip)
浮点数运算指令(不作要求)
大概了解一下概念,一个是 x87 FPU,另一个是从 SSE 发展出的 MMX 指令集。x87 有 8 个 80 位寄存器,SSE 有 8 个 64 位寄存器(是 x87 的 8 个寄存器的低 64 位),MMX 有另外的 8 个 128 位寄存器。
指令不做要求。
C 语言程序的机器级表示
过程调用的机器级表示(⭐⭐⭐⭐⭐)
这里的核心就是参数传递,以及栈帧的建立。
ABI 规定:
- eax, ecx, edx 是被调用者可以随意使用的,故调用者如果需要其值需要自己保存好这份环境
- ebx, esi, edi 是被调用者要负责恢复环境的,故被调用者要负责保存并恢复这份环境
这就是模块化的原理,每个模块负责好自己的部分,由 ABI 来统筹每个模块。
题外话,这些寄存器都是有英文名的,记住英文名对于记忆功能有一定用处。
调用过程直接看书就好了,流程挺简单的,分为调用者准备,被调用者执行,调用者恢复现场三个部分。
小细节:栈帧的大小必须是 16 字节的倍数,这是栈帧对齐规则。
小细节:用户栈区是 0xbfffxxxx,只读代码段是 0x8048xxx,全局静态数据区是 0x8049xxx。
选择结构和循环结构的的机器表示(不单独考,用来读汇编)
都挺简单的,和正常的代码使用 goto 实现版本差不多。
复杂数据结构类型的分配和访问
数组的分配和访问(⭐⭐⭐⭐)
数组 a 的地址就是 a[0] 的地址,即 a=&a[0]。而 &a[i]=a+SIZE*i,SIZE 为该类型字节数。高维数组就是展开成 1 维存放。
static 型的就一定是全局的,而且在编译链接的时候就初始化好了,不管值是不是 0(这个区分放在 .data 还是 .bss)。
结构体元素在内存的存放与访问(⭐⭐⭐)
在栈中存放和静态内存中存放方法都是类似的。比如结构体有 { int id; char name[20]; },那么就先分配首地址 x,然后 [x, x+4) 是 int id 的,[x+4, x+24) 是 char name 的。按顺序放。
传参也可以通过指针或者值,只是后者需要花费一些栈空间。
联合体元素在内存的存放与访问(⭐⭐⭐)
联合体就是共享同一片内存的变量,然后按照最长的那个元素分配内存。
数据对齐(⭐⭐⭐⭐)
cpu 可以一次读若干个连续的字节,比如 8 个字节 64 位。那么为了高效读写数据,就可以尝试对齐的策略。
比如基础的按自身长度对齐的策略:
- char:无对齐要求(因为长度是 1 字节,任何地址都满足)。
- short(2 字节):地址必须是2 的倍数(如 0x2、0x4、0x6…)。
- int(4 字节)、float(4 字节):地址必须是4 的倍数(如 0x4、0x8、0xC…)。
- double、long long(8 字节):地址必须是8 的倍数(如 0x8、0x10…)。
如果做到这些,那么 cpu 每次读取 [8k, 8k+8) 地址的数据即可。
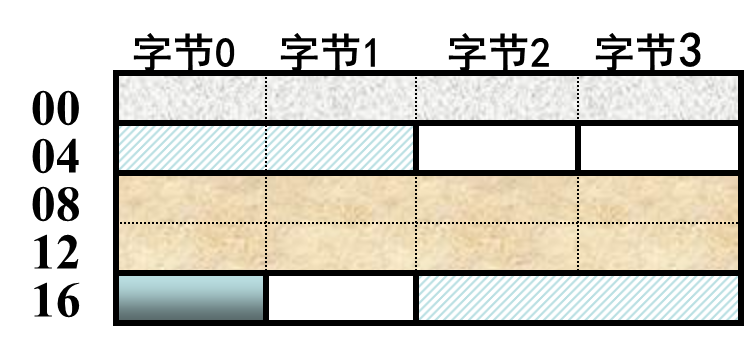
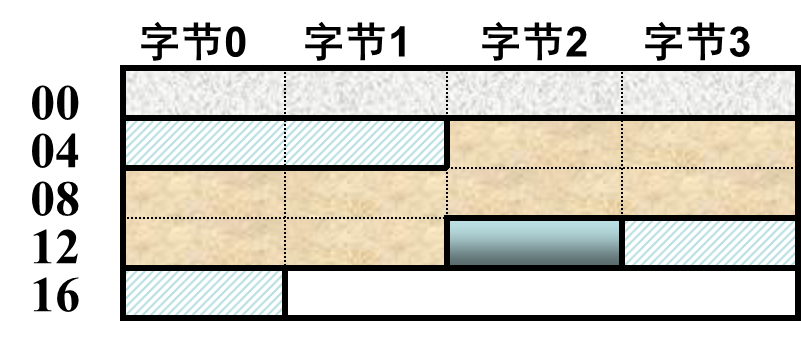
这个 trade-off 看起来还是很有趣的。
结构体数据对齐就三条核心:
- 整体对齐看最严格的成员(比如有 int、double,就按 double 的要求来);
- 成员存的时候要 “凑位置”,可能中间插空;
- 结构体整体大小得是对齐长度的整数倍,可能末尾插空。
缓冲区溢出攻击(了解)
就是在栈里面写出自己的栈帧,比如篡改上一个栈帧的返回地址从而实现攻击,此事在网络攻防实战一课中亦有记载。
x86-64
学累了,不学了。
一个月后更新:好消息,也不考。
第四章 程序的链接
编译、汇编和静态链接
编译和汇编(了解)
前面都重复过好几遍了。
可执行目标文件的生成(了解)
得到 可重定位目标文件(.o文件) 后,链接器将若干个文件链接起来可以合成一个可执行目标文件。而这个过程中主要有两个任务:
- 符号解析。将每一个符号的引用与一个确定的符号定义建立关联。链接器把所有符号放在可重定位目标文件的符号表中。
- 重定位。可重定位目标文件中的代码区和数据区都是从地址 0 开始的,链接器需要将不同模块中相同的节合并起来生成一个新的单独的节,并将合并后的代码区和数据区按照 abi 规范规定的虚拟地址空间划分(也称存储器映像)来重新确定位置。重新确定代码和数据的地址并更新指令中被引用符号地址的工作称为重定位。
目标文件格式(⭐⭐⭐⭐⭐)
难点在于有很多生词,不过就像 pwn 作业一样,碰到生词不需要一下子理解,先定性了解大概即可。
链接的发明是有效且简单的。最开始的程序员使用纸带穿孔的方式写代码,这种代码就是固定不能变化的,例如 jmp 5 这条指令,如果在 5 之前又加入一条指令,则这个 jmp 也要随着改变。这就很不方便。因此使用符号化的方式,jmp LC0,则改变 LC0 并不会导致大规模的程序改变;同时,这种方式还允许了主函数和 LC0 的分开变成,即模块化编程。那么新的问题就是,怎么把不同模块链接起来。
ELF 目标文件格式(⭐⭐⭐⭐⭐)
重点要懂得两种视图。
链接视图,ELF 文件由多个节构成,例如代码节(.data),只读数据节(.rodata)等。
执行视图由段构成,多个节合并后映射到一个段,例如 .data 和 .bss 都映射到可读写数据段。
此外 ELF 中还有两种头表,节头表和程序头表。节头表说明各种节的信息(例如开始位置,大小等),程序头表说明每个段的各种信息。
可重定位目标文件格式(⭐⭐⭐⭐⭐)
第一,ELF 头。有一些重要信息例如,e_ident 表示魔数 0x7,'E','L','F' 用来检测是否是 ELF 文件。e_entry 代表 ELF 程序的入口。
一个 ELF 文件的两个部分,但是看不懂。去看了看 b 站的网课,还得是有人教好学一些。
ELF 头一共有 52 个字节,前 16 个字节是 ELF 的魔数,用来标志文件类型,还有一些其它信息(包括节头表的节数,每节长度和起始位置)。
第二,节。节是 ELF 文件的主体信息。典型的 ELF 文件包含 .text, .bss, .data, .rodata, .symtab, .rel.text, .rel.data 后两个是 text 和 data 节的重定位信息。
第三,节头表。节头表则是每个节为 40 字节,描述了这个节的各种信息,例如起始地址,长度等。
可执行文件目标文件格式(⭐⭐⭐⭐⭐)
相比于上一种文件,这种文件可以执行,所以多了三个东西:
- e_entry 不为 0,而是第一条指令的地址
- 程序头表,节头表用于描述节,则程序头表用于描述段
- .init 节,用于初始化
- 少两个重定位节 .rel.data, .rel.text
可执行文件的存储器映像(⭐⭐⭐⭐⭐)
那张经典的图。

符号表和符号解析(⭐⭐⭐⭐⭐)
符号和符号表(⭐⭐⭐⭐⭐)
包含在符号表中的符号有三种类型:
- 全局符号,全局变量
- 外部符号,extern 定义的
- 本地符合,static 属性的
局部变量不在符号表,在栈中。
符号表在 .symtab 节中,每个符号都有自己的符号表,记录了例如符号名在 .strtab 节中的偏移等信息。
st_shndx 表示符号在什么节里面,如果是 ABS/UND/COMMON 就是在三个伪节里面。
符号解析(⭐⭐⭐⭐⭐)
符号解析将引用的符号和定义的符号中建立关联。
强符号:初始化的全局变量;弱符号:未初始化的全局变量。
局部变量和 static 的变量都不算,因为强弱符号是为了解决多重定义问题,而一个文件内是不能多重定义的;放到不同文件链接由于是 static,即 local 的,别人没法引用,也就不关心是否是重复定义。
按照强弱符号定义来处理多重定义问题:
- 强符号只能定义一次
- 一次强符号和多次弱符号,引用会引用强符号
- 多个弱符号,随便选
符号解析过程:
维护三个集合:
- E,里面是生成最终可执行文件的 .o 文件的集合
- U,当前为解析符号
- D,当前已定义符号
然后就一个个文件看过去,如果碰到一个符号,就用 D 解析,解析不了就放入 U;如果碰见一个符号定义,就加入 D,解析 U 中的符号。
注意静态库要放在最后,因为静态库是会扫描 U 中并尝试解析,如果放在前面,后面的 .o 文件中的引用静态库的东西就没法解析了。
与静态库的链接(⭐⭐⭐)
不排除考察执行过程。
重定位(⭐⭐⭐⭐⭐)
在符号解析的基础上,将所有 E 中的 .o 文件合并,确定符号的虚拟地址空间中的地址,在引用处进行重定位。
重定位主要包括两个工作:
- 节和符号的重定位。把节合并,确定节和定义符号的地址。
- 引用符号的重定位,根据 .rel.text 和 .rel.data 中进行。
重定位信息(⭐⭐⭐⭐⭐)
在 .rel.text 和 .rel.data 节中存放着需要重定位的符号的重定位信息,offset 和 info 分别表示偏移和符号索引和类型。
重定位过程(⭐⭐⭐⭐⭐)
假设 .rel.text 有一个表项:r_offset=0x7, r_sym=10, r_type=R_386_PC32。
这说明这个符号重定位的位置是 .text 节 +7,按照 PC32 的方式重定位,符号位于符号表的第 10 个。
R_386_PC32 方式重定位。符号地址 - 下一条指令地址 = 相对寻址距离,写入机器代码。
R_386_32 方式重定位。把对应的位置写成被引用符号的地址。
动态链接(⭐⭐⭐,不要求细节)
共享目标文件是一种特殊的可重定位目标文件,可以可执行目标文件被运行时,动态装入内存并链接,这个过程称为动态链接。
类 unix 系统为 .so 后缀,windows 系统中为 .dll 后缀。
动态链接的特性
共享性和动态性。
程序加载时的动态链接
就是在编译的时候,先说好我要用 blabla 共享库,然后编译出来的目标文件就有对应的符号表和重定位表信息。然后在加载器 loader 载入程序的时候,就会呼叫动态链接器把可执行文件和共享库进行链接。
程序运行时的动态链接
用 dlopen 加载和链接共享库。dlsym 就在共享库中找函数名。dlclose 用来关闭。
位置无关代码(了解)
就是共享库必须能存在于虚拟内存的任何位置,所以不能有绝对寻址。
四种情况需要解决:
- 模块内过程调用
- 模块内数据引用
- 模块间过程调用
- 模块间数据引用
模块内的问题显然 PC 相对解决。
模块间数据引用解决方法。假设我们 extern int b; 函数内 b=2,我们不知道 b 相对 b=2 的地址是多少,怎么办呢?可以在数据段开始设置一个表,记录不同变量的地址,比如在另一个文件中有 b,碰到定义的时候就把地址记录在这个表里面,然后在 b=2 这个位置就访问这个表。这个表被称为 全局偏移量表(GOT, Global Offset Table)
模块间过程调用一个道理。不过采用了延迟绑定技术。记录一个 过程链接表(Process Link Table, PLT),比如第一次用 printf,跳转到 printf@plt,PLT 指令的第一步是跳转到 GOT 中记录的地址,看看有没有东西,没东西的话就跳转到处理程序,调动动态链接器,找到 printf 的位置然后写回 GOT。
第六章 层次结构存储系统
存储器概述
存储器分类(了解)
按存取方式分类,有 随机存取存储器(RAM),顺序存取存储器(SAM)(例如磁带),直接存取存储器(DAM)(例如磁盘,先直接到磁道,再顺序定位扇区),相联存储器(例如 TLB,根据内容查询位置)
按信息更改性,读写和只读。
按断电信息是否保存,非易失性和易失性。
按功能,cache,主存,磁盘,海量后背存储器(例如磁带和光盘,用于离线存储超级大量数据)
主存的组成和基本操作(了解)
看得懂图就好了。
存储器的主要性能指标(了解)
写入时间,读出时间,存储周期。
各类存储元件的特点(了解)
SRAM 快但是占面积大,比较贵,用作 cache。DRAM 比 SRAM 慢一点,需要定时刷新,不过便宜一些,所以用作主存。
存储器的层次结构(了解)
看看图即可。
主存与 CPU 的连接及其读写技术(不要求)
主存芯片技术
主存与 CPU 的连接及其读写
总线是部件和 cpu 进行数据,地址,控制信号传输的线。
一个内存条上有多个 DRAM 芯片,可以插在一个内存条插槽里面。
“装入”指令和“存储”指令操作过程
比如读取,就是先把地址传到主存,然后把数据传到数据线,cpu从数据线拿数据。
硬盘存储器
硬盘存储器结构(了解)
磁盘是一个圆盘,上下的面都划分成了存储单元。某一面先划分成很多个同心圆,还有很多个扇形,两种划分叠加起来就形成很多小方格。
一个圆环称为磁道,一个扇形称为一个扇区。由于磁盘有很多个盘叠起来,每个盘都有上下两面,每一面都有一个磁头,因此有 2*盘数 的磁头数量。所有磁头的运动是相同的。
读写分为 寻道,旋转等待,读写 三步骤。
一个扇区不全是数据,比如温盘的一个扇段的前缀和后缀都是一些信息数据,中间 512B 才是数据。
磁盘性能指标(⭐⭐⭐,考访问时间)
记住响应时间和存取时间两个公式即可。
磁盘存储器的连接(了解)
扇区划分成逻辑块,数据交互以块为单位,用 dma 方式交互。
固态硬盘(不要求)
高速缓冲存储器(⭐⭐⭐⭐⭐,重中之重)
程序访问的局部性(⭐⭐⭐⭐)
时间局部性就是重复访问相同的单元,空间局部性就是访问地址相近的单元。
cache 的基本工作原理(⭐⭐⭐⭐⭐)
cache 分成很多行,每行至少有 3 个元素:tag,有效位,内存块数据。
平均访问时间 = 命中时间 + 缺失率 * 缺失损失时间
cache 行和主存的映射(⭐⭐⭐⭐⭐)
主存块和 cache 有三种映射方式,直接,全相联,组相联。
全相联可以认为是全部看成一组,直接可以认为是 1 路组相联。
总而言之,主存地址被分为:标记,cache组号,块内地址 三个部分。
cache 中主存块的替换算法(了解)
先进先出,最近少用(要一个硬件计数器),最不经常用(也要一个计数器),随即替换
cache 一致性问题(⭐⭐⭐,了解)
进行写操作的时候,是在 cache 里面和主存同时写?还是先在 cache 里面写,等要踢掉的时候再放回主存?这就是一致性问题。
全写法。直接在主存里面写,然后根据是否放入 cache 分为写分配法,非写分配法。就是 写&分配,或者 写&不分配。
回写法(需要引入一个 dirty 位),表示 cache 是否修改过。
影响 cache 性能的因素(不要求)
cache 和程序性能(⭐⭐⭐,看看例题)
主要就是分析命中率。
虚拟存储器(⭐⭐⭐⭐⭐,重中之重)
为了让进程以为自己在独占内存,设计虚拟存储器。
虚拟存储器的基本概念
指令中的地址称为虚拟地址,逻辑地址;主存中的是物理地址,实地址。
虚拟地址空间
那个图就不放了
虚拟存储器的实现(尤其关注页表,快表)
分页式存储器比较重要。
dram 和磁盘用回写法,因为数据传输代价比较大。
看得懂 296 和 297 的图就行。
分段式存储器。
程序不是有段表吗,虚拟地址就是所在段和段的偏移量。
段页式,先分段再分页。一个段可能占据多个页,一个页只能属于一个段。
存储保护(了解)
为了提供存储保护,硬件应该有的功能:
- 部分 cpu 状态只能由内核程序写,用户进程不能写,比如改变特权级指令
- 至少支持两种特权模式,用户态和内核态
- 提供特权级相互转换的机制
主要包括两种情况,访问权限保护和存储区域保护。
访问权限,看操作与权限是否符合,比如执行栈区的代码。
存储区域,看是否访问不该访问的区域。
IA-32 + Linux 中的地址转换(不要求)
第七章 异常控制流
进程和上下文切换
进程的概念(⭐⭐⭐)
程序是磁盘中的一个 ELF 文件,进程是程序运行的过程,一个程序可能同时被好几个进程运行。每个进程都认为自己是独占内存和 cpu 的,进程有进程描述符,类似文件描述符。
进程的逻辑控制流
进程的逻辑控制流根本来说,就是被执行的指令序列(也包括异常控制流)。上面提到,进程认为自己独占 cpu,但事实上并非,也就是 cpu 的物理控制流是若干个逻辑控制流的并,可能 A 执行到一半执行 B,执行完 B 再执行 A。这种现象属于并发,并行也属于并发。
进程的上下文切换(⭐⭐⭐)
上下文包括 用户级上下文 和 系统级上下文。
与第六章的关联是,用户级的地址空间 和 系统级的地址空间 一起构成了进程的整个 存储器映像。
还包括寄存器上下文(称为硬件上下文,相对来说上面就是软件上下文)。
切换进程的时候,上下文切换简要流程:
- 把 寄存器上下文 保存到 系统级上下文
- 把新进程的 系统级上下文 的 寄存器上下文 放到寄存器里面
- 执行新进程的逻辑控制流(把 PC 改一下就好了)
进程的存储器映射(不要求)
进程的存储器映射 是将 虚拟地址空间中的一个区域 与 硬盘上的一个对象建立关联。就是这张图
共享库的运行原理。当 进程1 想调用共享库,共享库从硬盘被载入主存后会占据几个页框;然后 进程2 在调用共享库的时候,就先看看主存中是否已经有对应的共享库了,如果有,就把自己虚拟地址空间中分配给共享库的虚页映射到相同的物理地址。
程序的加载和运行
说不考,直接跳。
异常和中断
当发生一些事情时,正常的指令执行就会被打断:
- 指令为 div 0
- 用户按下 Ctrl+C
- 向标准输出完成
- 等等
比如除以 0 做不了,那你这个程序肯定就有问题,要结束;用户按下 Ctrl+C,那你这个程序也要立刻结束。
这些事情发生在正常指令执行的预料之外,碰到这种状况就要用特殊的方式处理,进入异常控制流。
基本概念
异常:执行指令时触发的,同步事件
中断:I/O 设备向 CPU 发出请求时触发的,异步事件
如何理解同步:如果你反复执行同一段代码,在相同的数据下,异常总是发生在同一条指令上。它是代码执行的直接产物。
如何理解异步:中断可能在任何时刻发生。比如你正在运行一个复杂的计算函数,此时你点了一下鼠标。这个鼠标点击产生的电信号(中断)可能打断函数中的第一行,也可能打断第一百行,这取决于你点鼠标的时机。
大致处理流程见书 P333:
- 执行完指令发现 中断请求信号,或者执行指令时发现 异常事件
- 打断当前进程,使用对应的 异常或中断处理程序
- 顺利解决问题,则回到 原来的指令 或者 下一条
- 没解决,直接终止进程
异常分类(⭐⭐⭐⭐⭐,考就考这个)
分类 1,故障
访存的 “页故障”(page fault) 和除数为 0 都是故障。
这个归纳来说,是我本来想正常执行这个指令,结果意外发现这个指令执行不了。
页故障处理流程:
- vaddr 通过 MMU 进行地址转换,但是如果 有效位(v位) 不为 1,或者地址越界,地址越权,就产生 page fault
- 调用相应处理程序
- 如果是错误的访存,就返回 段故障(segmentation fault)
- 如果只是缺页的话,就载入页面,然后重新执行访存指令
分类 2,陷阱
系统调用指令 int $0x80 和 断点调试指令 int 3 都是陷阱指令。
归纳来说,就是我本身就想主动创造异常,因为有些东西在用户的权限下做不了,要呼叫操作系统增援。
主要就只是系统调用。
有一个很恶心的点,INT n 指令我们知道是陷阱,但是有些人称呼为“软中断”,恶心的没边了。
分类 3,终止
发生致命错误,比如访问 DRAM 的时候发生了“奇偶校验错误”。
这个“奇偶校验”就是说,为了防止这个宇宙射线导致内存比特反转,每 9 位就增加一个描述 前 8 位里面有 奇数还是偶数 个 1 的位。
中断的分类(了解)
外部请求,比如用户的 Ctrl+C。
响应流程:
- 执行完一条指令后,查看 中断请求引脚,如果有信号就进入 “中断响应周期”(就是“我要开始处理啦”)
- 将 PC(称为断点)和机器状态保存到栈中,并设置成 “关中断” 状态
- 读取 中断类型号(给不同种类的中断编号),跳转到对应的 中断服务程序
- 处理完成后,回到 “断点” 执行指令
这里的“关中断”有复杂的设计:
核心含义就是暂时“屏蔽”外界请求,“关中断”状态意味着 CPU 的 标志寄存器(EFLAGS) 中的 中断允许位(IF, Interrupt Flag) 被置为 0。
字面意思:在这种状态下,即使外部设备(如键盘、网卡、磁盘)向 CPU 发送新的硬件中断请求,CPU 也会视而不见,不予理睬。
例外:只有极少数优先级极高的“不可屏蔽中断”(NMI)和指令执行触发的“异常”能打破这种状态。
为什么要“关中断”?(保护现场的刚需)
设置“关中断”的主要目的是为了防止中断嵌套导致现场被破坏。在中断发生的瞬间,CPU 正在忙着做两件极其脆弱的事:
- 保存断点和状态:硬件正在把当前的 PC 和 PSW(机器状态字)压入内核栈。
- 寻找处理程序:根据中断向量号去查 IDT 表,准备跳转到中断服务程序(ISR)。
如果不关中断会怎样? 如果此时还没存完旧的现场,又来了一个新的中断,新的硬件动作会冲掉还没存好的 PC 和状态。这就像你刚要把重要文件存进保险柜,手还没松开,又有人往柜子里塞了一堆东西,最后导致你根本找不到原来的文件在哪。
“关中断”的生命周期,这种状态通常不是永久的,它的存续周期如下:
- 开始:在硬件进入中断响应周期、保存完断点后,自动关中断。
- 维持:进入中断服务程序(ISR)的前几条指令(通常是保护通用寄存器“现场”的阶段)依然处于关中断状态。
- 结束(两种情况):
- 低级系统:整个 ISR 执行完,直到执行 iret 指令返回时,硬件自动恢复之前的状态(重新开中断)。
- 支持嵌套的系统:在 ISR 内部,程序员手动执行一条“开中断”指令(如 sti),允许更高级别的中断打断当前的执行过程。
因此也引入了可屏蔽中断和不可屏蔽中断。不可屏蔽中断就是类似天塌了这种事,一定要优先最快解决,比如电源掉电了。
异常和中断的响应过程(⭐⭐⭐⭐,知道来抄)
前面已经简要描述了一下这个过程。而全文版就在书本 P338 页。
这个识别异常和中断事件的方法有点难以理解,不过 gemini 讲的不错:
我:异常事件和中断源的识别方法,软件识别和硬件识别是怎样?书看不太懂
Gemini:简单来说,当中断或异常发生后,CPU 必须立刻搞清楚两件事:“发生了什么事?”以及“该去哪找处理代码?”。
书上说的“识别方法”其实就是 CPU 确定中断向量号(Vector Number)的过程。我们可以把软件识别想象成“打电话询问”,硬件识别想象成“排队领号”。
- 软件识别(查询法 / Polling)
在一些简单的处理器中,所有中断共用同一个固定入口地址。
识别过程:
- 硬件检测到异常,强制 CPU 跳到一个通用的“总入口”。
- 内核在这个入口处跑一段查询程序(即软件逻辑)。
- 程序按优先级顺序依次读取每个设备的“状态寄存器”。
- “你是中断源吗?”“不是。”“你是吗?”“是的!”。
特点:
- 硬件省钱:不需要复杂的识别电路。
- 效率低:每次都要排查一遍,浪费 CPU 时间。
- 硬件识别(向量法 / Vectored Interrupts)
这是现代 CPU(如你图中的 IA-32)主要采用的方式。硬件在响应中断的瞬间,就已经把“身份信息”准备好了。
识别过程:
- 排队(仲裁):如果多个设备同时发信号,中断控制器(如 APIC)选出优先级最高的一个。
- 送号(中断向量):硬件通过数据总线直接把一个中断向量号(0-255 的数字)送给 CPU。
- 查表(硬件跳转):CPU 拿到号后,自动去内存里的中断向量表(IVT)或中断描述符表(IDT)中,以向量号为索引找到对应的处理程序入口地址。
特点:
- 硬件复杂:需要专门的中断控制器逻辑。
- 速度极快:硬件直接完成“识别+跳转”,无需执行查询指令。
IA-32 + Linux 中的异常和中断(不要求)
不要求,我就先不看了。
第 8 章 I/O 操作的实现
I/O 子系统(了解)
这个子系统致力于解决各种形式的输入输出问题,比如电脑的摄像头是如何将图像传给系统的。
高级语言的运行时系统提供了执行 I/O 的接口,比如 C 的 printf。这个高级接口自然也不是凭空产生的,而是通过调用下层的接口,而下层的接口再调用下下层,一共由很多层。
P355 页展示了子系统的层次结构。
书本写的太烂了,这是一个 I/O 流程:
// ==========================================
// 1. 用户态阶段:正在执行普通指令
// ==========================================
void user_process() {
    int a = 1;
    int b = 2;
    int c = a + b;  // <--- 假设指令在此执行完

    // [硬件时刻]:此时磁盘控制器拉高了中断请求线(IRQ)
    // CPU 检查到中断请求,且当前标志寄存器 IF=1 (开中断)
}

// ==========================================
// 2. 硬件响应阶段 (由 CPU 内部逻辑自动完成,无指令)
// ==========================================
/* - 硬件关中断:IF = 0
   - 硬件保存现场:
     push SS; push ESP; push EFLAGS; push CS; push EIP;
   - 硬件获取中断向量号:从中断控制器拿到号,比如 0x2E (磁盘中断)
   - 硬件跳转:根据 0x2E 查 IDT 表,跳转到 entry_0x2E
*/

// ==========================================
// 3. 通用中断处理程序 (汇编入口,IDT 直接指向这里)
// ==========================================
entry_0x2E:
    push %eax; push %ecx; push %edx; // 保存其他通用寄存器

    // 调用内核 C 语言分发函数
    call do_IRQ(0x2E);

// ==========================================
// 4. 内核分发器 (C 语言)
// ==========================================
void do_IRQ(int vector_number) {
    // 根据向量号 0x2E,在内核维护的一张表中找到对应的驱动程序函数
    // 类似于: irq_handler_t isr = irq_desc[vector_number].action;

    // 调用真正的“中断服务程序” (ISR)
    disk_driver_isr();
}

// ==========================================
// 5. 中断服务程序 (ISR,属于设备驱动层)
// ==========================================
void disk_driver_isr() {
    // 1. 读取磁盘控制器状态寄存器
    // 2. 将数据从磁盘缓冲区拷贝到内存缓冲区
    // 3. 唤醒之前阻塞在 read() 上的进程
}

// ==========================================
// 6. 恢复现场并返回
// ==========================================
/*
   (在 entry_0x2E 的末尾继续执行)
   pop %edx; pop %ecx; pop %eax;     // 恢复通用寄存器
   iret;                             // [硬件指令]:恢复 EIP/CS/EFLAGS,开中断
*/
用户空间的 I/O 软件
用户程序中的 I/O 函数(了解)
分两种,标准 I/O 库函数(如 printf) 和 系统级 I/O 函数(如 write)。
程序员一般用前者,优点在 P358 页。
文件的基本概念(了解)
在类 UNIX 系统中,一切皆文件。键盘可以视为读取字节序列的输入设备文件,显示器可以看成写入字节序列的输出设备文件。
系统级 I/O 函数(了解)
随便看看
C 标准 I/O 函数(⭐⭐⭐)
标准 I/O 库函数是基于系统级 I/O 函数实现,这节在讲具体怎么实现。
首先是一个 FILE 的结构体,定义书上有。然后就是这个具体实现方法是这样的,以 fread 为例:
- 首先文件自己由一个指针,表示 read 函数读到哪里了
- 但是 read 函数读到的并不是 fread 函数读到的,FILE 中有一个元素指向内存中的缓冲区,然后 FILE 还有元素表示 fread 读到这个缓冲区的哪里了
这里的设计哲学是说,read 会一下子读很长的文件(因为系统调用和设备驱动的开销太大了),但是 fread 有时候不需要那么多,很可能是少量多次,因此在缓冲区没有结束的时候都不需要再系统调用了。
fwrite 的方式也是类似的。但是要注意向 stdout 和 stderr 的写模式是不一样的。
stdout 是行缓冲,当写缓冲区满了,或者碰到 \n 了,或者被手动清空缓冲区的时候会输出。
stderr 是非缓冲,直接输出。
因此这个程序由出乎意料的结果:
write(1, "A", 2);
write(2, "B", 2);
会先输出 B 再输出 A。
用户程序中的 I/O 请求(了解)
用户程序的 I/O 看可以用 C 标准库的,也可以用系统级 I/O,或者 API 函数提供的 I/O(例如 windows 中的 ReadFile())。
I/O 硬件与软件的接口
I/O 设备(了解)
又称外设。
基于总线的互连结构(不要求)
I/O 接口的功能和结构(了解)
好复杂,不看了
I/O 端口及其编址(了解)
为了实现 cpu 可以执行 out "hello, world" 这样的指令,得把 I/O 设备编址
统一编址方式。
从程序运行视角来看,虚拟内存中的某一块是 I/O 设备。从硬件设计视角来看,物理地址某一块被认为是 I/O 设备,且一半是不存在真实的内存单元是这个地址。就是虚空创造了一些地址给 I/O。
独立编址方式。
用 in/out 进行操作。
I/O 控制方式(⭐⭐⭐)
第一类,程序直接控制 I/O 方式,称为查询或轮询,这个逻辑和异常的软件控制方式是一样的。就是 cpu 叫 IO 干活,IO 干完活之前 cpu 就一直等着,一直问“干完了吗干完了吗”。处于“忙等待”状态,有个笑话里不是说“快速等待”吗。

第二类,中断控制 I/O。就是说 cpu 让 IO 干活,而且让 IO 干完了说一声(发送异常),然后 cpu 就去干其它事了。
然后这一节还穿插了一些中断嵌套的内容。就是一个中断开始处理的时候,也是可能接收到中断的,但是中断之间亦有贵贱,只有更重要的中断能打断当前的中断,所以就设计了“硬件判优电路”“中断屏蔽字”“中断处理优先级”等概念。
还有就是同时收到多个中断怎么办?根据“中断响应优先级”看看谁最先被响应。
我草这也太傻逼了吧这也要分两个概念。
第三类,DMA 控制 IO 方法
直接用 DMA 硬件操作,不经过 cpu,就比较快。
内核空间 IO 软件(不考)
条果

 浙公网安备 33010602011771号