
训好的模型只能看不能用?零代码自动化AI模型私有化部署平台DLTM一键导出让算法真正“上岗”
一位工程师花两周调出满意的缺陷检测模型,却在交付时犯了难:算法跑在实验笔记本里,产线系统读不懂它的格式,边缘设备装不下它的环境。模型成了“展厅里的样品”——看得心动,用不起来。
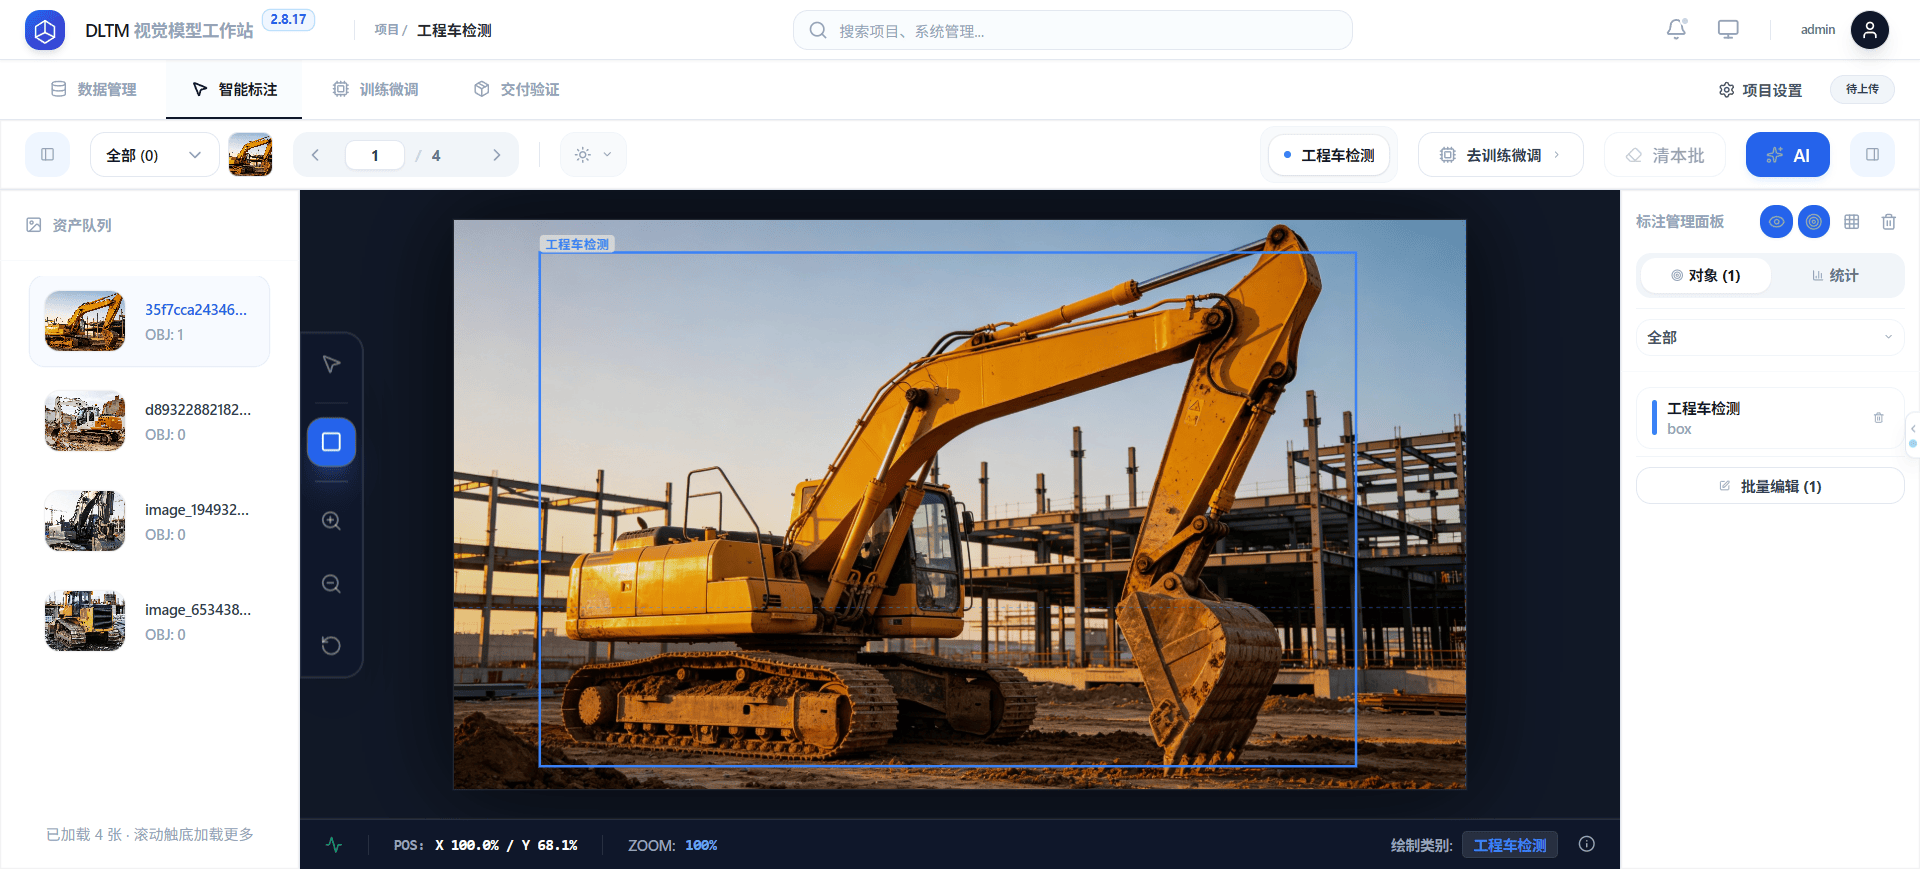
很多企业AI落地的最后一公里,断就断在“导出”这一步。自动化AI算法训练服务器DLTM把模型导出做成训推闭环里的标准出口,让训好的算法能真正走到业务现场。
一、自动训练聚焦“造得好”,导出负责“用得上”
企业AI算力工作站DLTM的自动训练专注于把数据高效转化为模型,而模型导出则承接成果、解决“如何离开训练环境”的问题。二者在同一工作台内无缝衔接:训练任务产出模型后,可直接进入导出流程,无需跨工具搬运、重新配置。这种“造完即出”的连续性,缩短了从实验成功到业务可用的距离,也减少了衔接中的版本错乱。
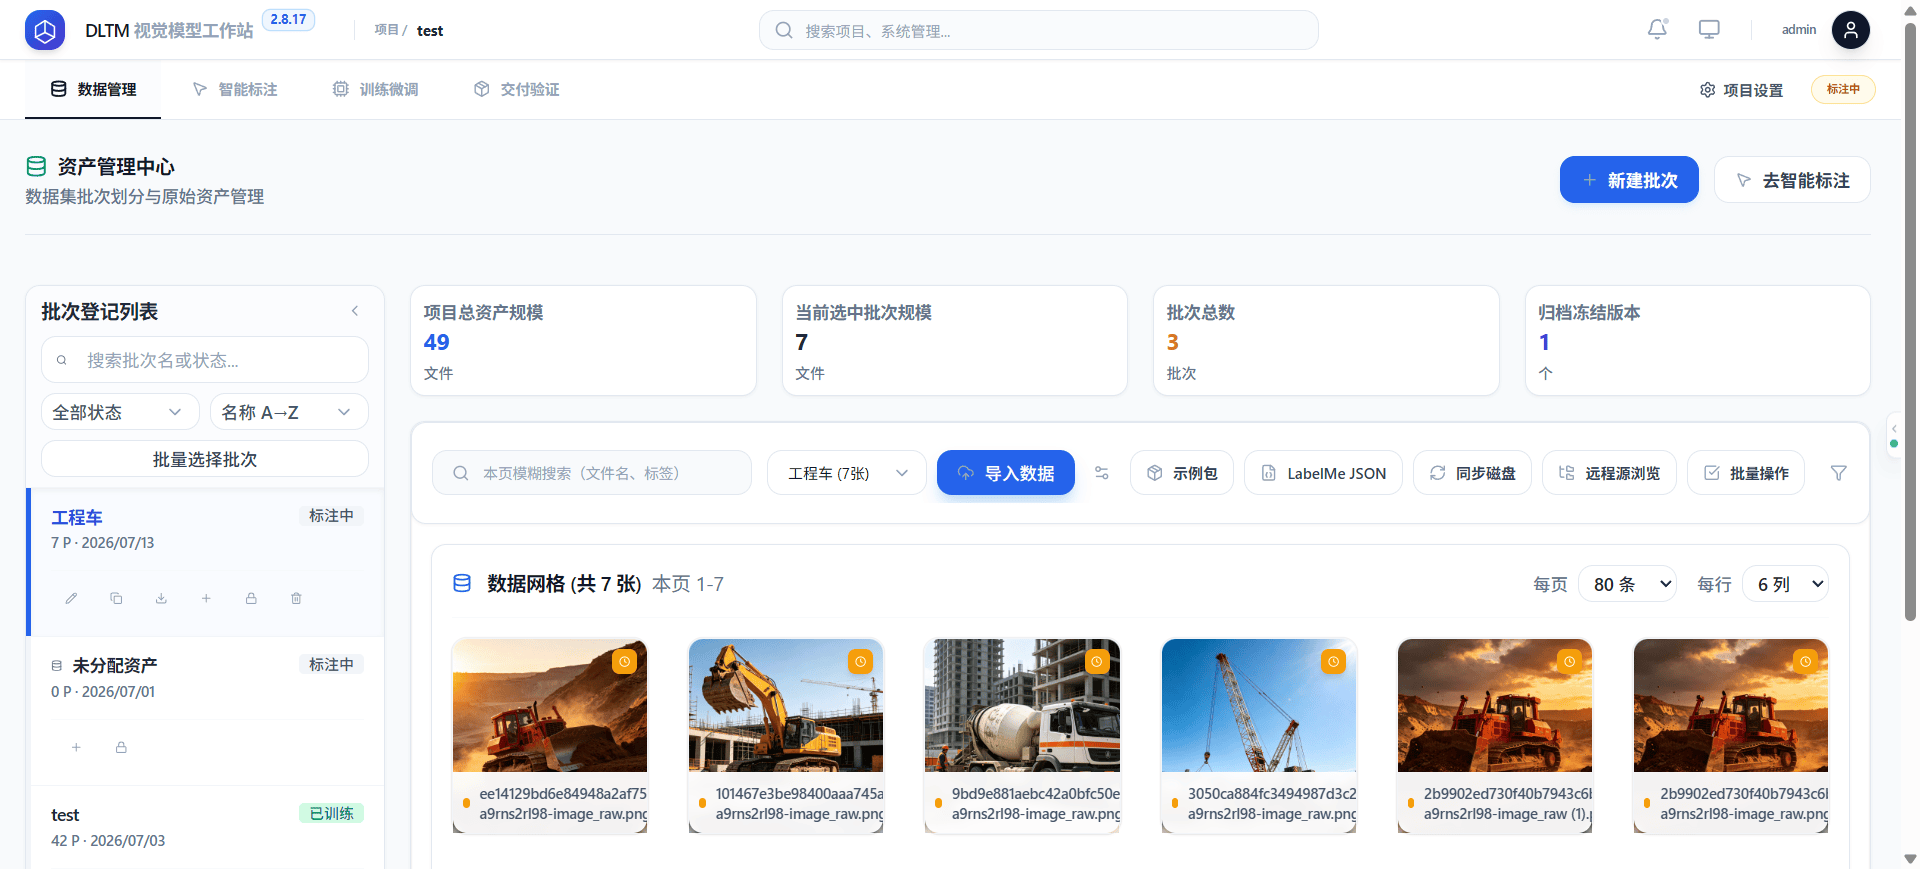
二、人工+AI标注保障导出模型的素材质量
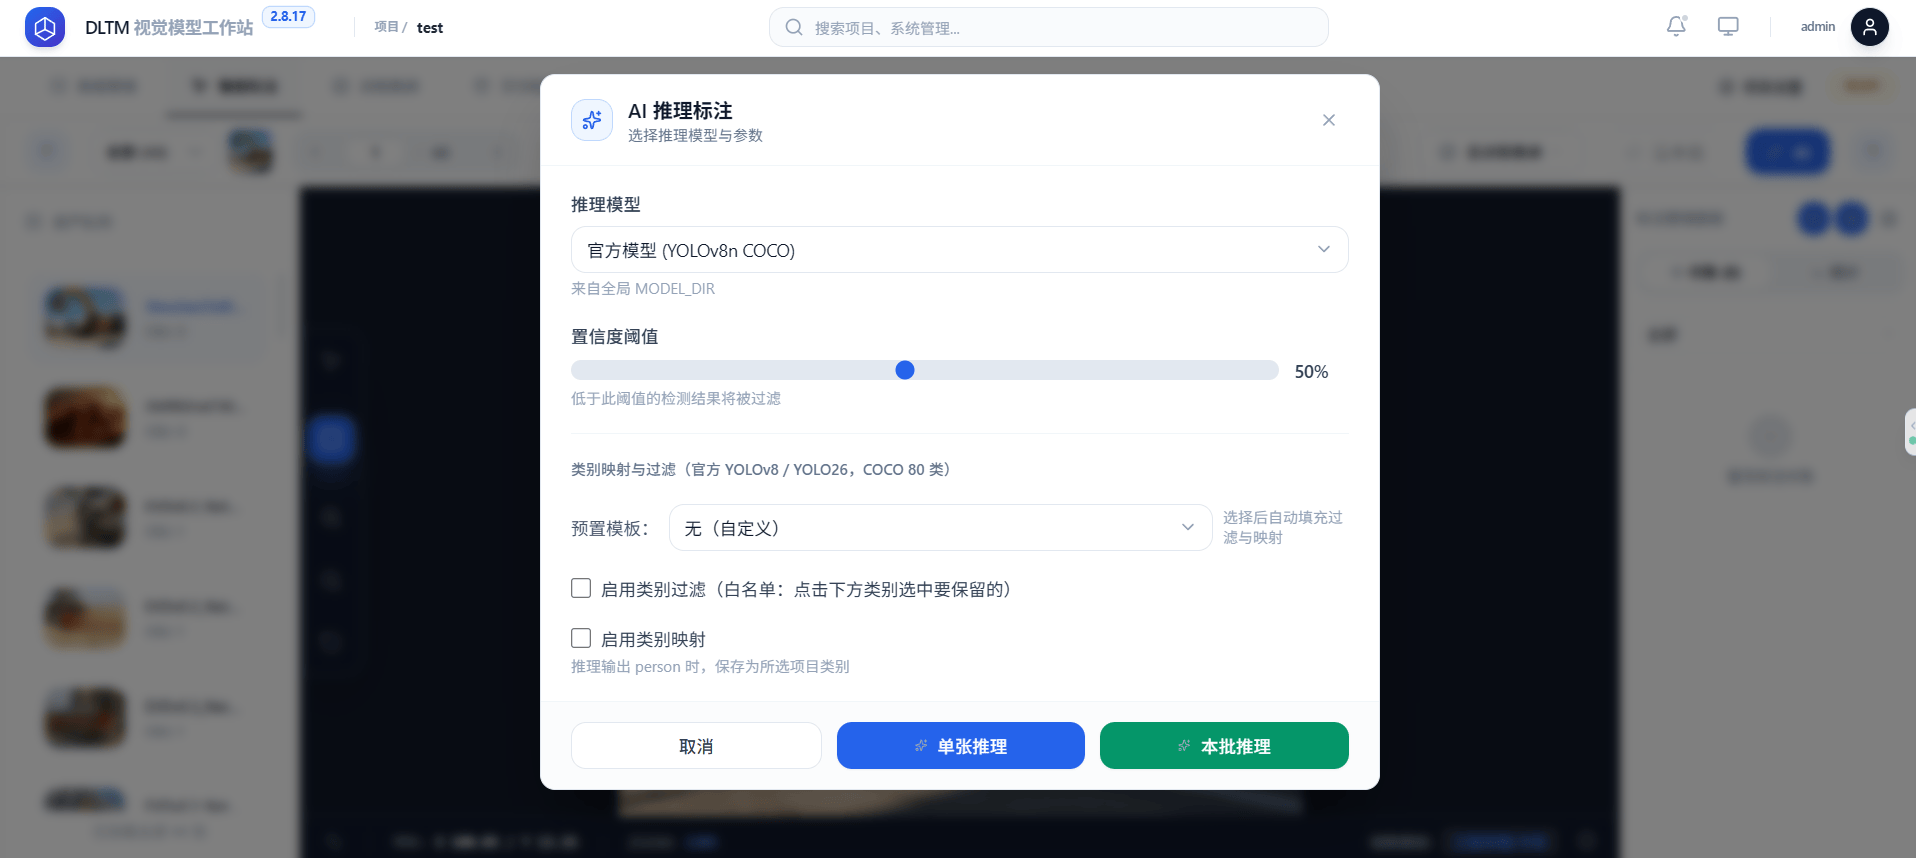
导出的模型好不好用,根子在前面的数据。企业私有化AI训练推理一体工作站DLTM的标注能力确保训练样本带着可信标签——AI预标提速、人工精修保真,使导出模型的基底扎实。
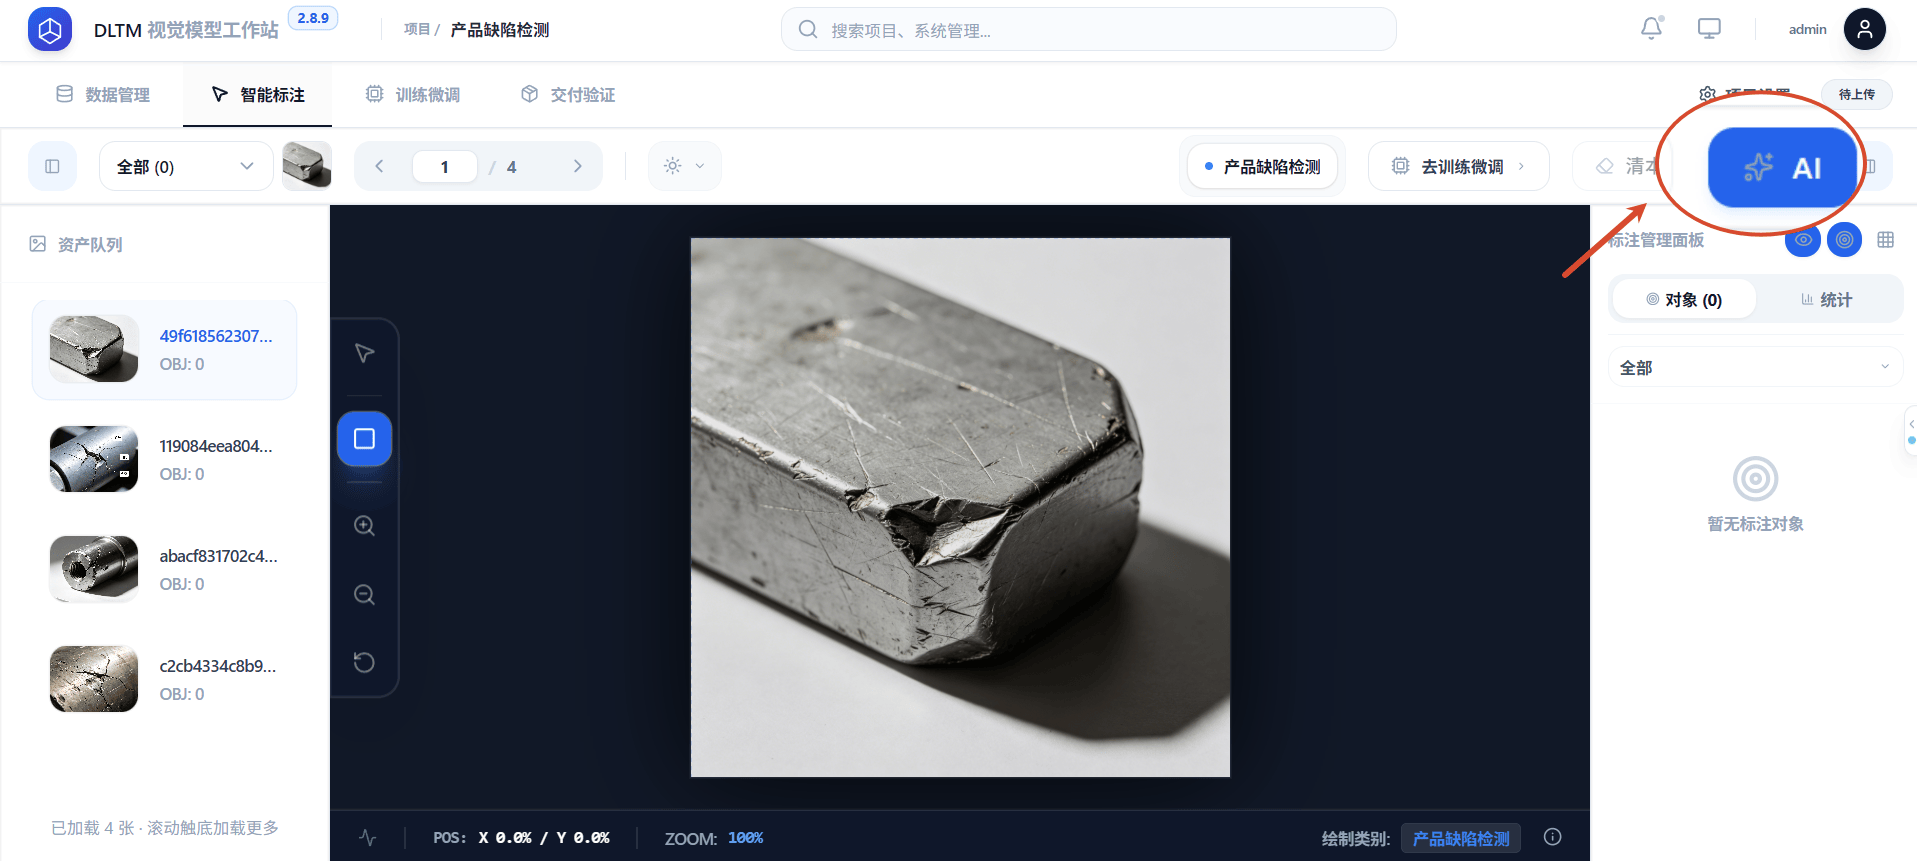
点击添加图片描述(最多60个字)
当模型走向应用侧,它背后是一整套可追溯的标注与训练记录,出问题能回查、能复现。导出不是孤立动作,而是前面所有质量动作的结晶。
三、推理验证为导出背书
企业AI算力工作站DLTM在导出前先用推理验证给模型“打分”,只放行通过检验的版本。导出的模型因此带着验证结论——它在哪些场景稳、边界在哪,下游一目了然。相比“盲导盲用”,这种带着质量背书的导出,让业务侧接手时更有底气,也减少了上线后的扯皮与返工。

四、模型导出:一次训练,多端复用
私有化/本地化AI模型训推工作站DLTM的模型导出能力,让同一份训练成果可以封装为适合不同运行环境的形态,供业务系统调用或分发到边缘侧。
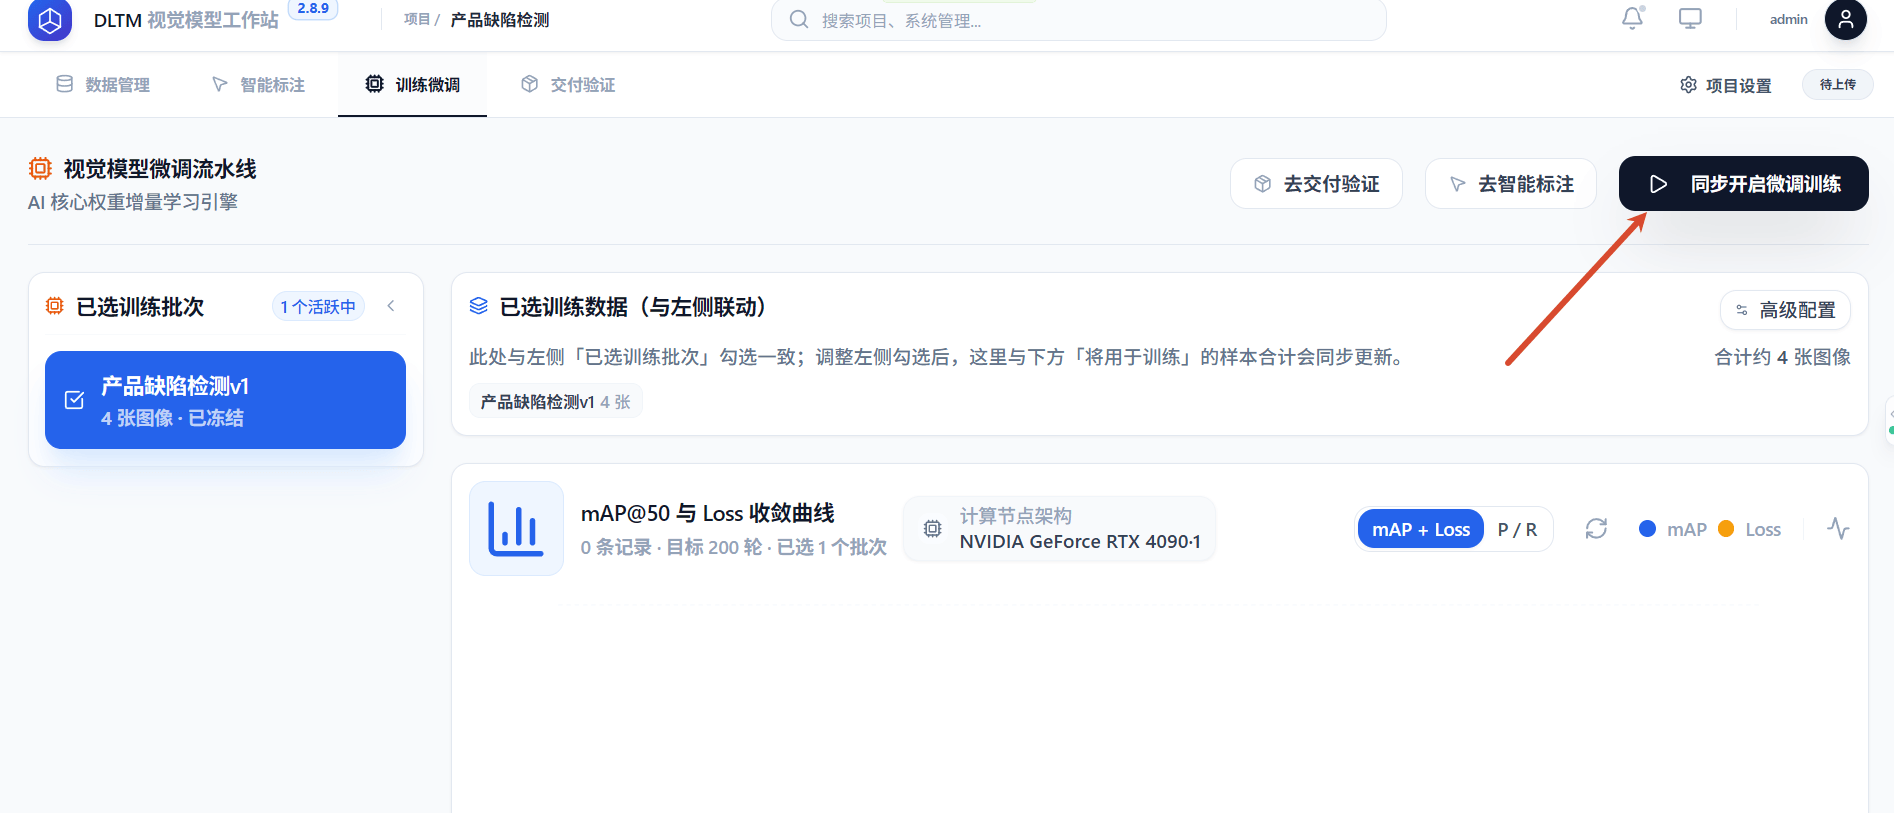
一次训练,多端复用,避免了“每个场景重训一遍”的重复投入。对需要在总部与多个分支、中心与边缘之间统一模型的组织,导出的灵活性直接决定了AI能力的辐射范围。
五、私有化部署中导出:物料自主可控
在企业AI算力工作站DLTM私有化部署下,模型导出完全由企业本地完成,导出的文件存于内网存储,分发到哪些设备由内部流程决定。没有外部平台经手模型物料,既符合数据不出域的要求,也让模型版本的管控更清晰。导出与部署在同一个可信边界内完成,从产出到上岗全程自主。
写在最后
一个走不进业务现场的模型,价值等于零。AI大模型训练工作站DLTM把模型导出从“收尾杂活”提升为训推闭环的关键出口,让训好的算法能带着验证结论、以可用形态交付到真实环境。当“造得好”和“用得上”被同一条链路打通,企业的AI投入才真正从演示视频,变成产线上的生产力。

 浙公网安备 33010602011771号