
模型上线前先“过堂”:自动化零代码本地大模型推理服务器DLTM推理验证拦住会“翻车”的模型
某零售连锁上线了自助结算的视觉模型,演示时识别流畅,可正式运行一周后,货架新包装频频被误判为“未结账”,损耗与投诉同步飙升。问题出在哪?模型在训练集上表现良好,却没在真实、复杂、长尾的场景下被认真检验过。AI大模型训练工作站DLTM把“推理验证”作为模型上岗前的强制关卡,正是为了避免这种“实验室很美、现场翻车”的尴尬。
一、自动训练产出模型,验证决定去留
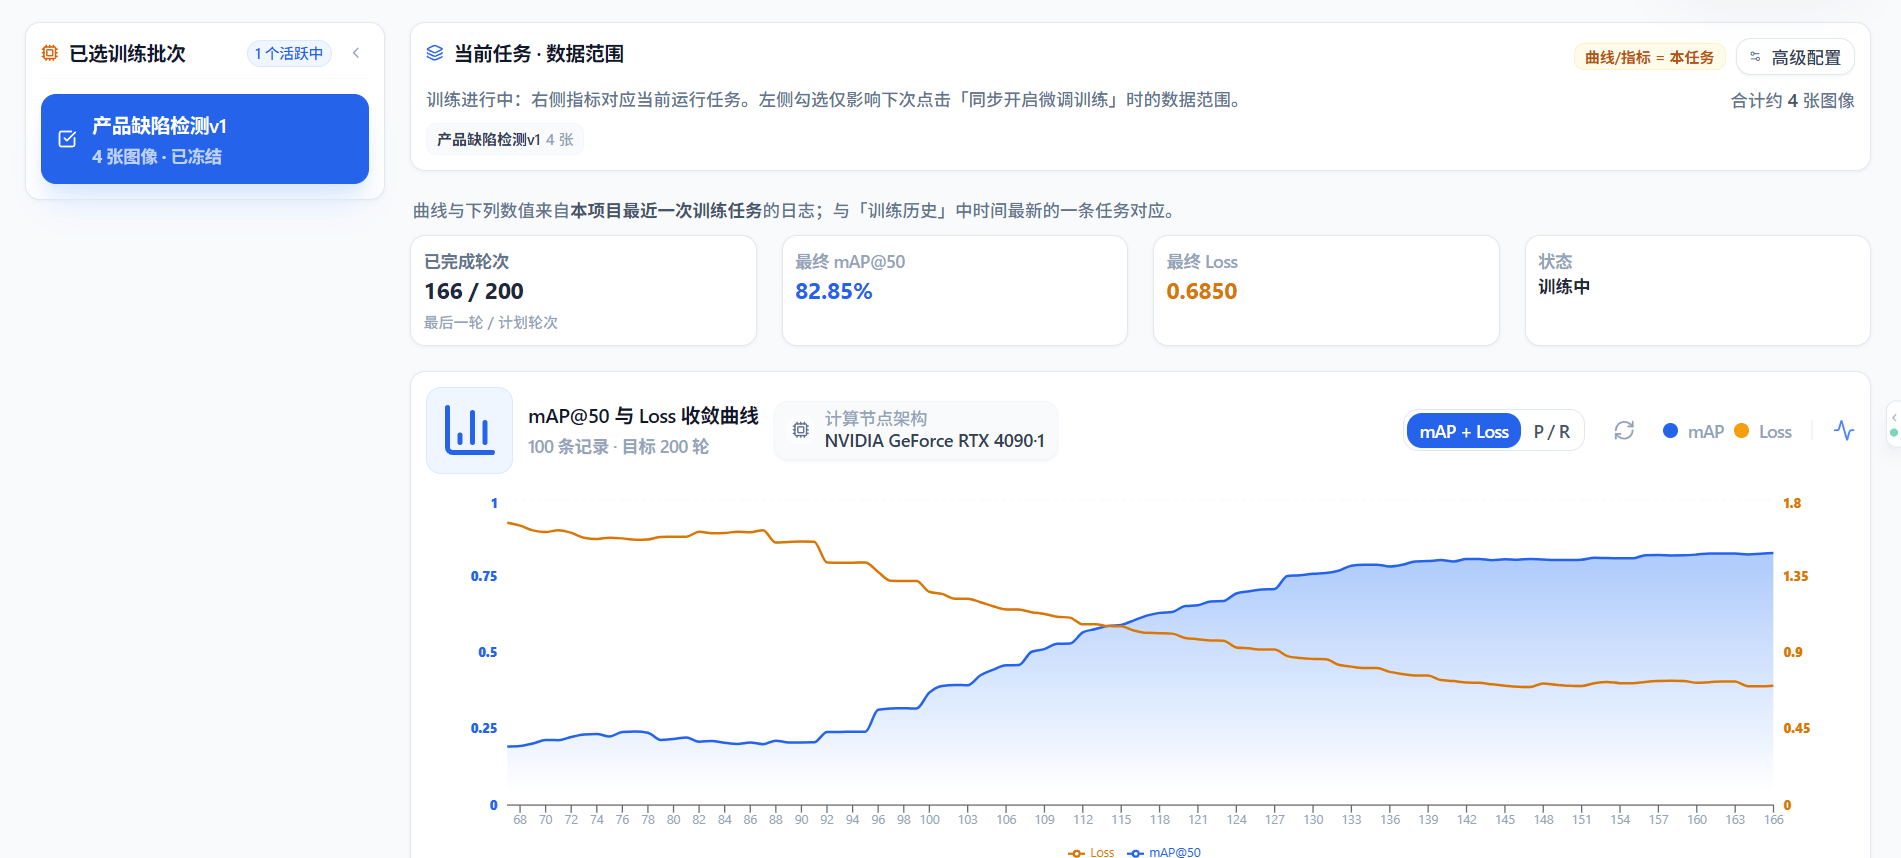
企业私有化AI训练推理一体工作站DLTM的自动训练负责把数据变成模型,但训练指标好不等于能用。系统把验证环节设计为训练之后的必经步骤:模型先要在验证集、真实样本上跑一轮,把漏检率、误报率、边界样本表现量化出来。
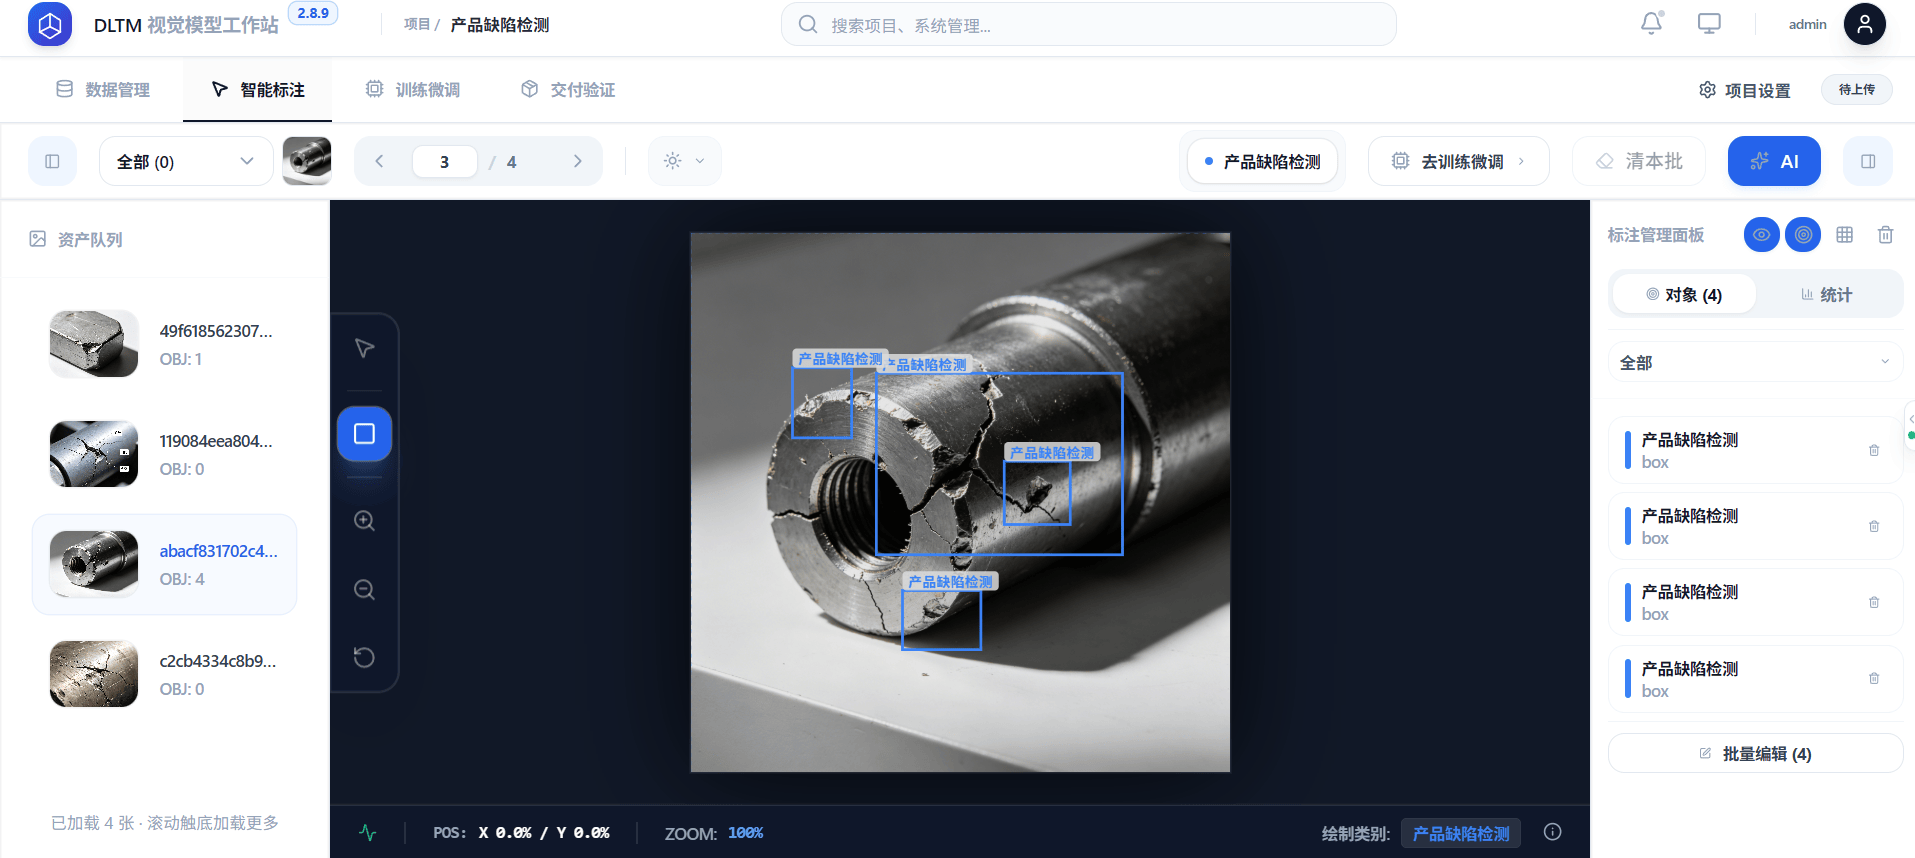
这个“先验证、再放行”的顺序,从流程上杜绝了“指标好看就直接上线”的冒进,让模型的去留有客观依据。
二、人工+AI标注为验证提供标尺
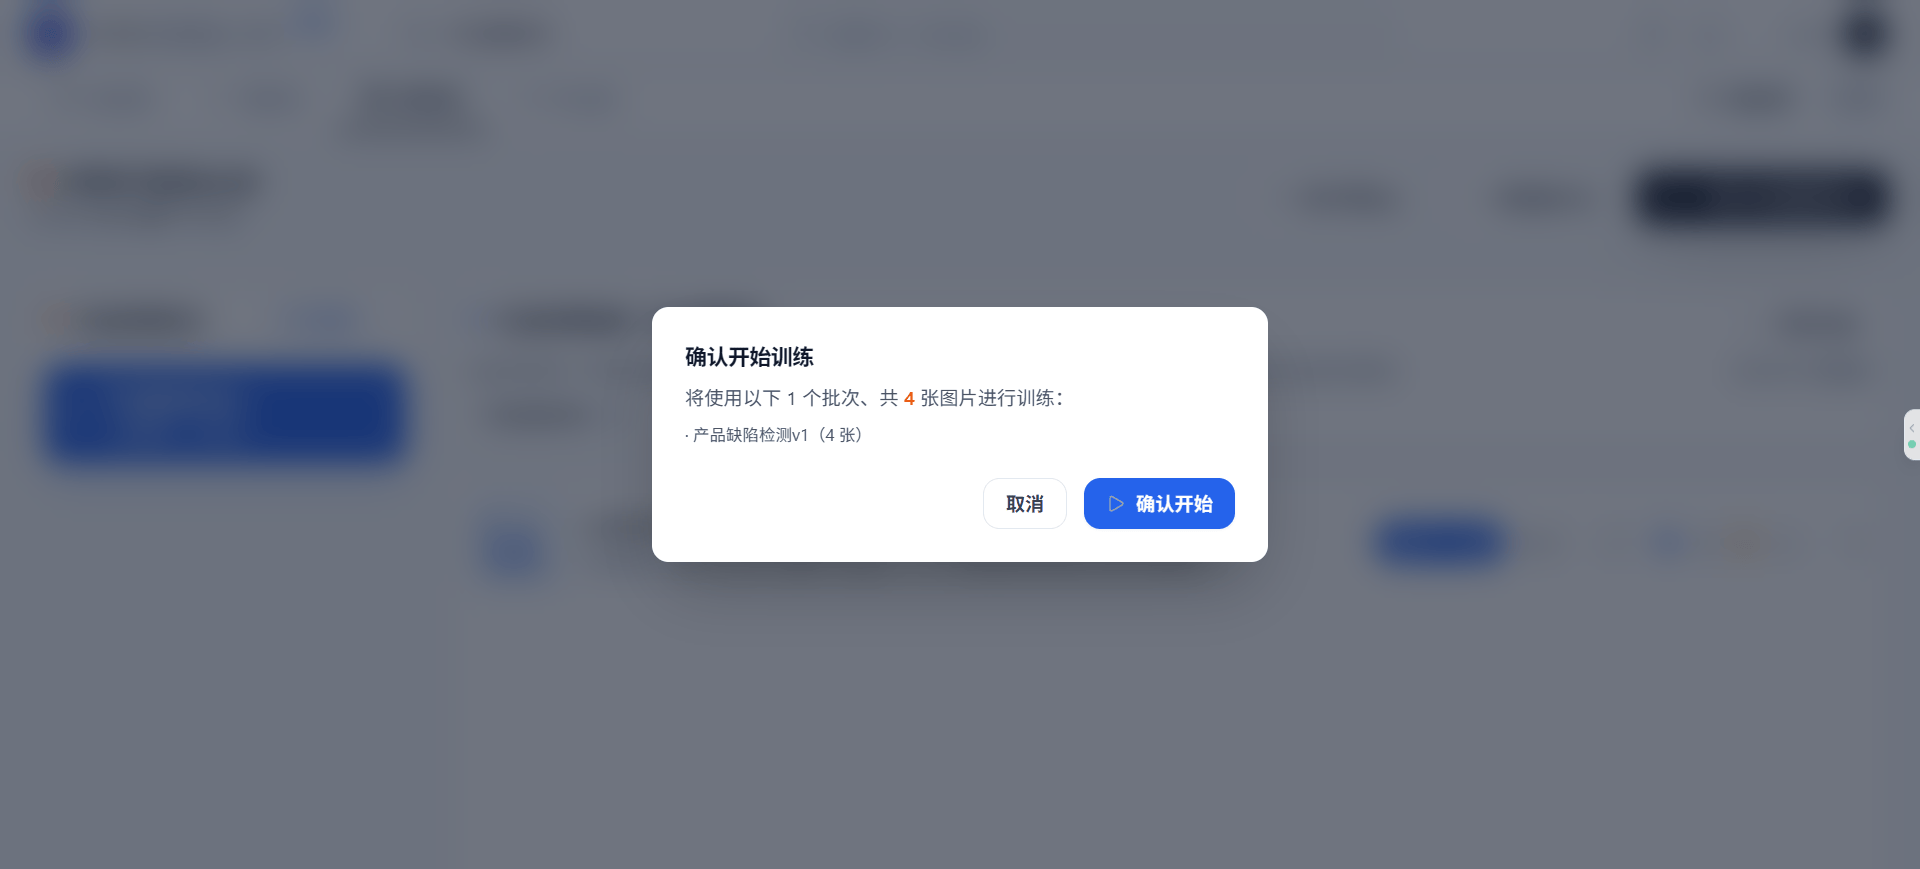
验证准不准,取决于用来衡量的样本标得对不对。自动化AI算法训练服务器DLTM的标注能力在此发挥作用:人工精修确保验证集标签可靠,AI预标则加速大批量验证样本的准备工作。当验证集本身带着可信标签,模型在上面的表现才有参考意义。标注质量,间接决定了验证这道闸门能否真正拦住问题模型。
三、推理验证:把“翻车”挡在部署前
企业AI算力工作站DLTM的推理验证,核心是用真实与边界样本对模型做实战压力测试。它呈现的不仅是总准确率,更包括各类别、各场景下的细分表现——哪类样本总被漏检、哪些边界条件容易误报,都被摊开来看。
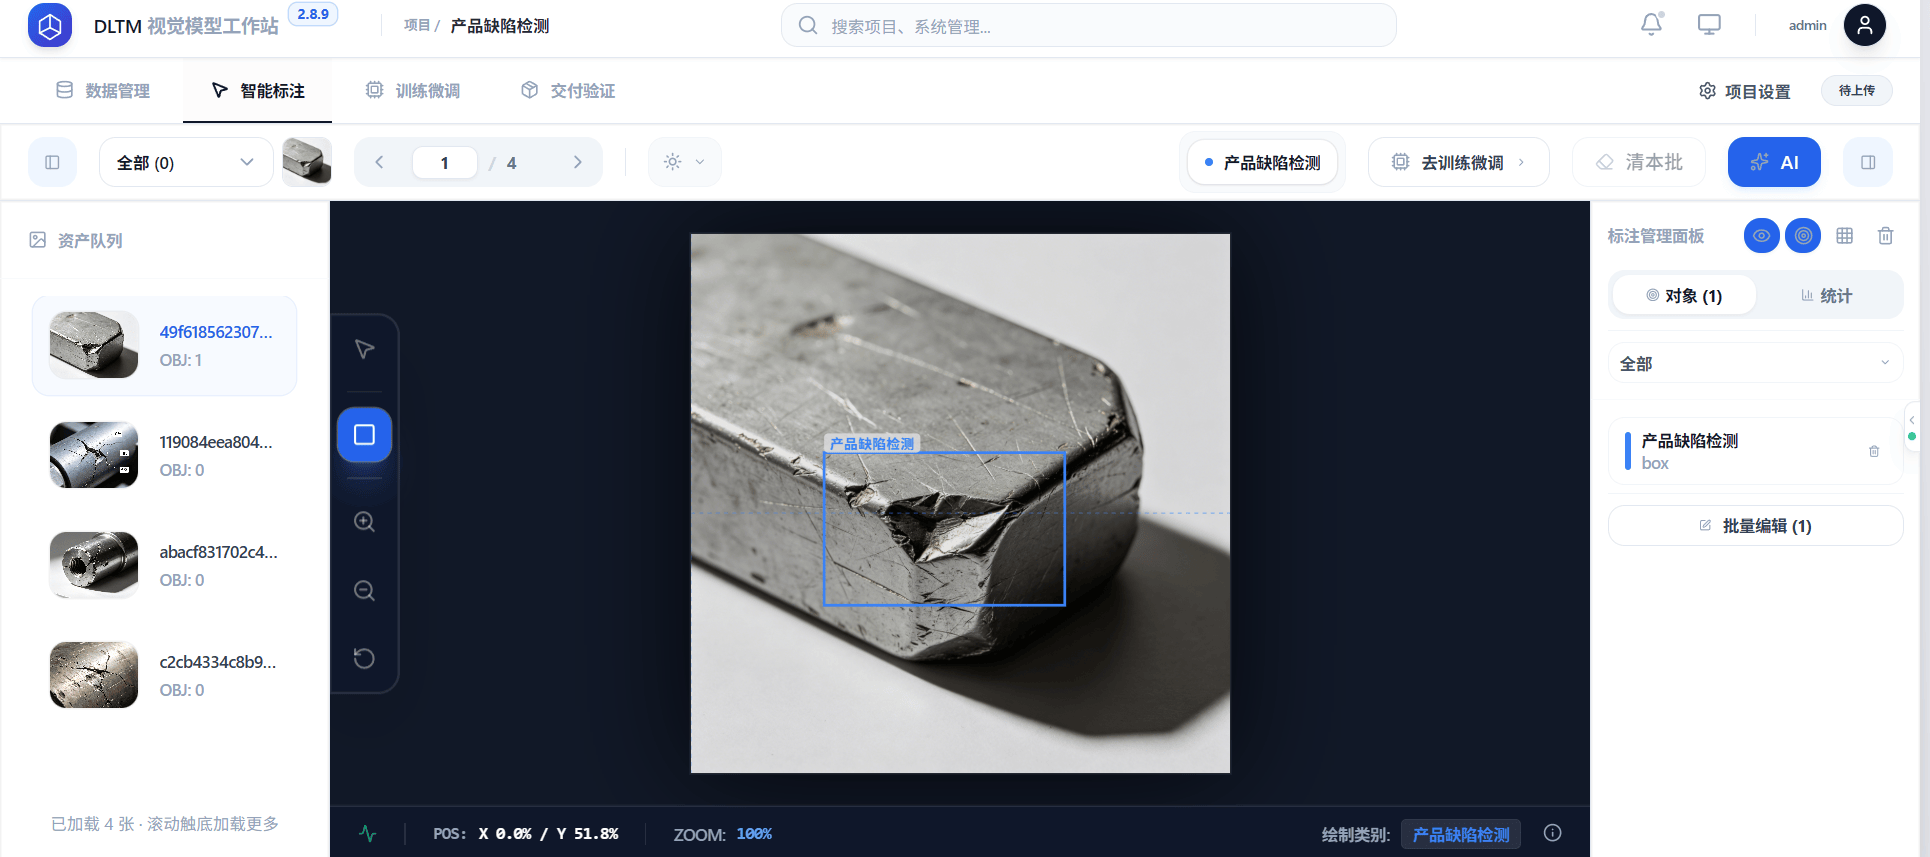
使用者在模型进入导出环节前就能定位短板,决定是补数据重训,还是调整阈值。验证因此成了性价比最高的纠错环节。
四、模型导出承接验证结论
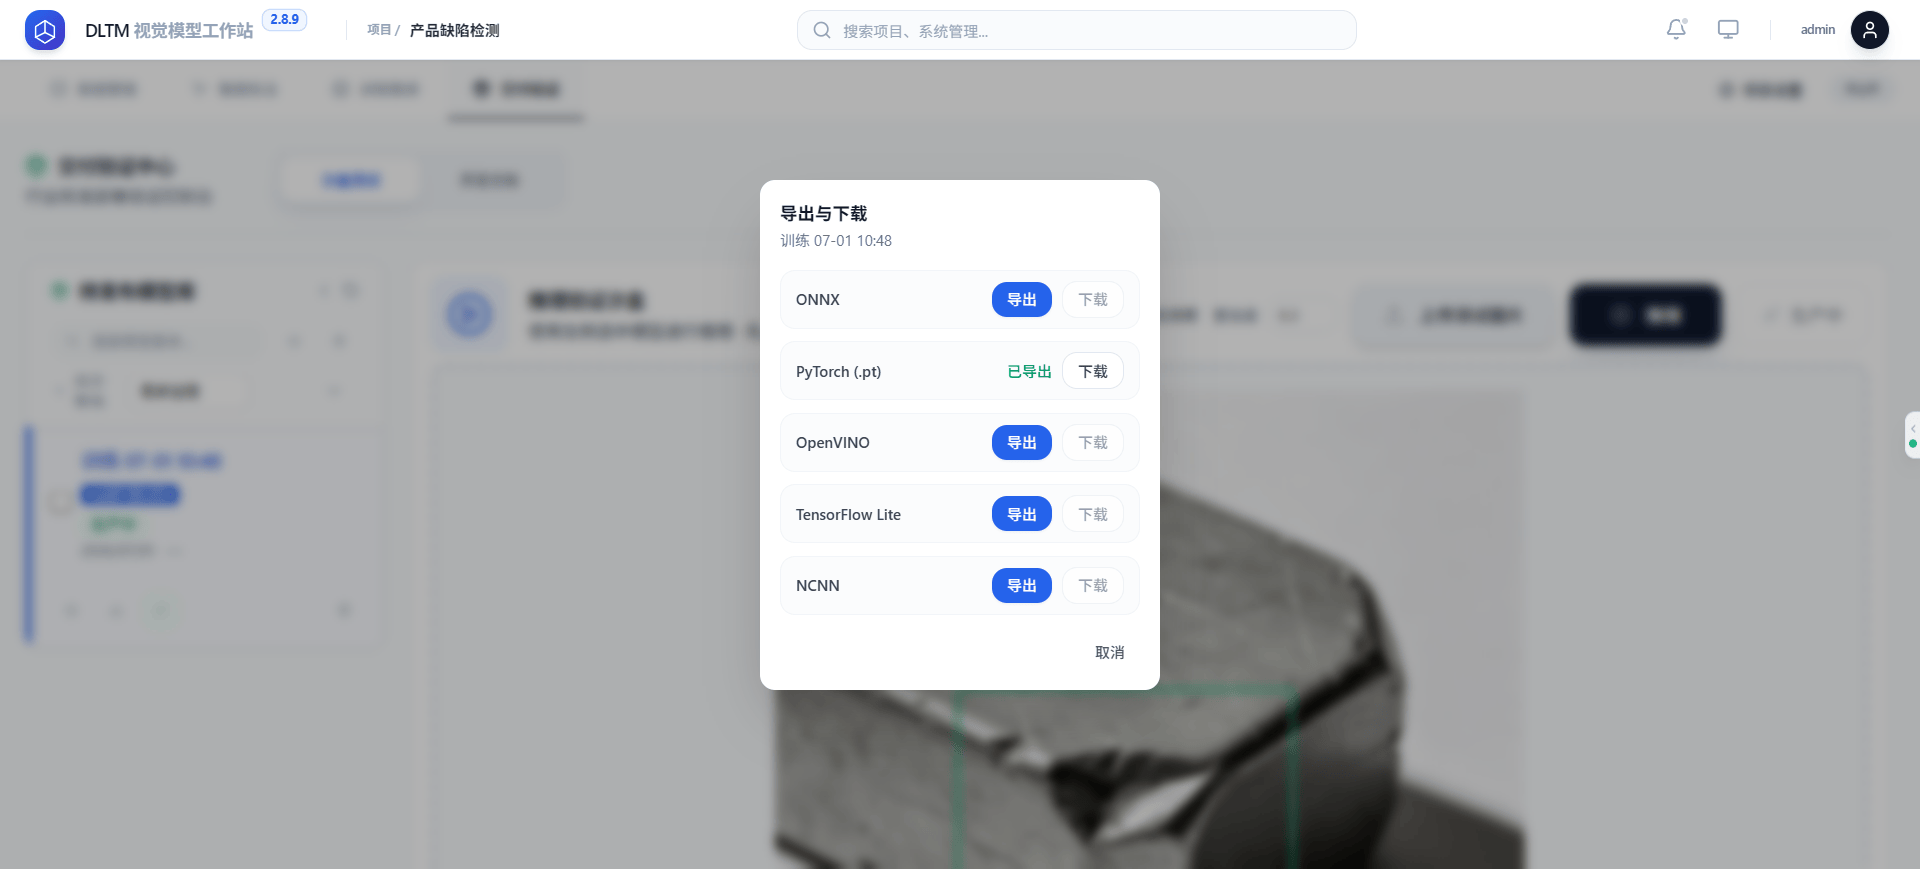
只有通过推理验证的模型,才被私有化/本地化AI模型训推工作站DLTM允许进入导出环节。导出不再是盲目打包,而是带着质量背书的交付。前序验证的价值,由此延续到应用侧。
五、私有化部署下的验证:敏感场景也能放心测
在企业级AI模型工作站DLTM私有化部署中,推理验证同样运行于内网,企业可用真实业务样本做测试而不必担心数据外泄。对金融、政务等既需要严格验证、又不可对外暴露数据的行业,这一点尤为关键。验证的严谨性与数据的私密性,在本地环境中同时成立。
写在最后
模型上线不是训练的终点,而是风险的起点。零代码自动化深度学习推理工作站DLTM把推理验证摆在与训练同等重要的位置,用真实样本给模型“过堂”,把漏检、误报、边界失效这些问题拦在部署之前。对企业来说,少一次现场翻车,远比多一个漂亮的训练曲线更有价值——验证这道闸,守的就是这份踏实。

 浙公网安备 33010602011771号