
不会写一行代码,也能训出自己的AI模型?自动化零代码本地大模型推理服务器DLTM自动训练能力拆解
提到“训练一个AI模型”,多数人的第一反应是黑底绿字的代码窗口、看不懂的损失曲线曲线和无穷无尽的调参。自动化AI算法训练服务器DLTM的自动训练模块想做的事很直接——把这些藏在高墙里的步骤,变成普通人点几下鼠标就能完成的标准动作。本文只聊自动训练这一环,看看它到底把哪些苦活累活替用户干掉了。
一、数据进来,流水线自己转起来
自动训练的第一层价值,是“流程自驱”。用户把标注好的数据集上传,平台会按预设的模板自动完成划分训练集/验证集、归一化、增强等前置步骤,不必再手写数据加载脚本。
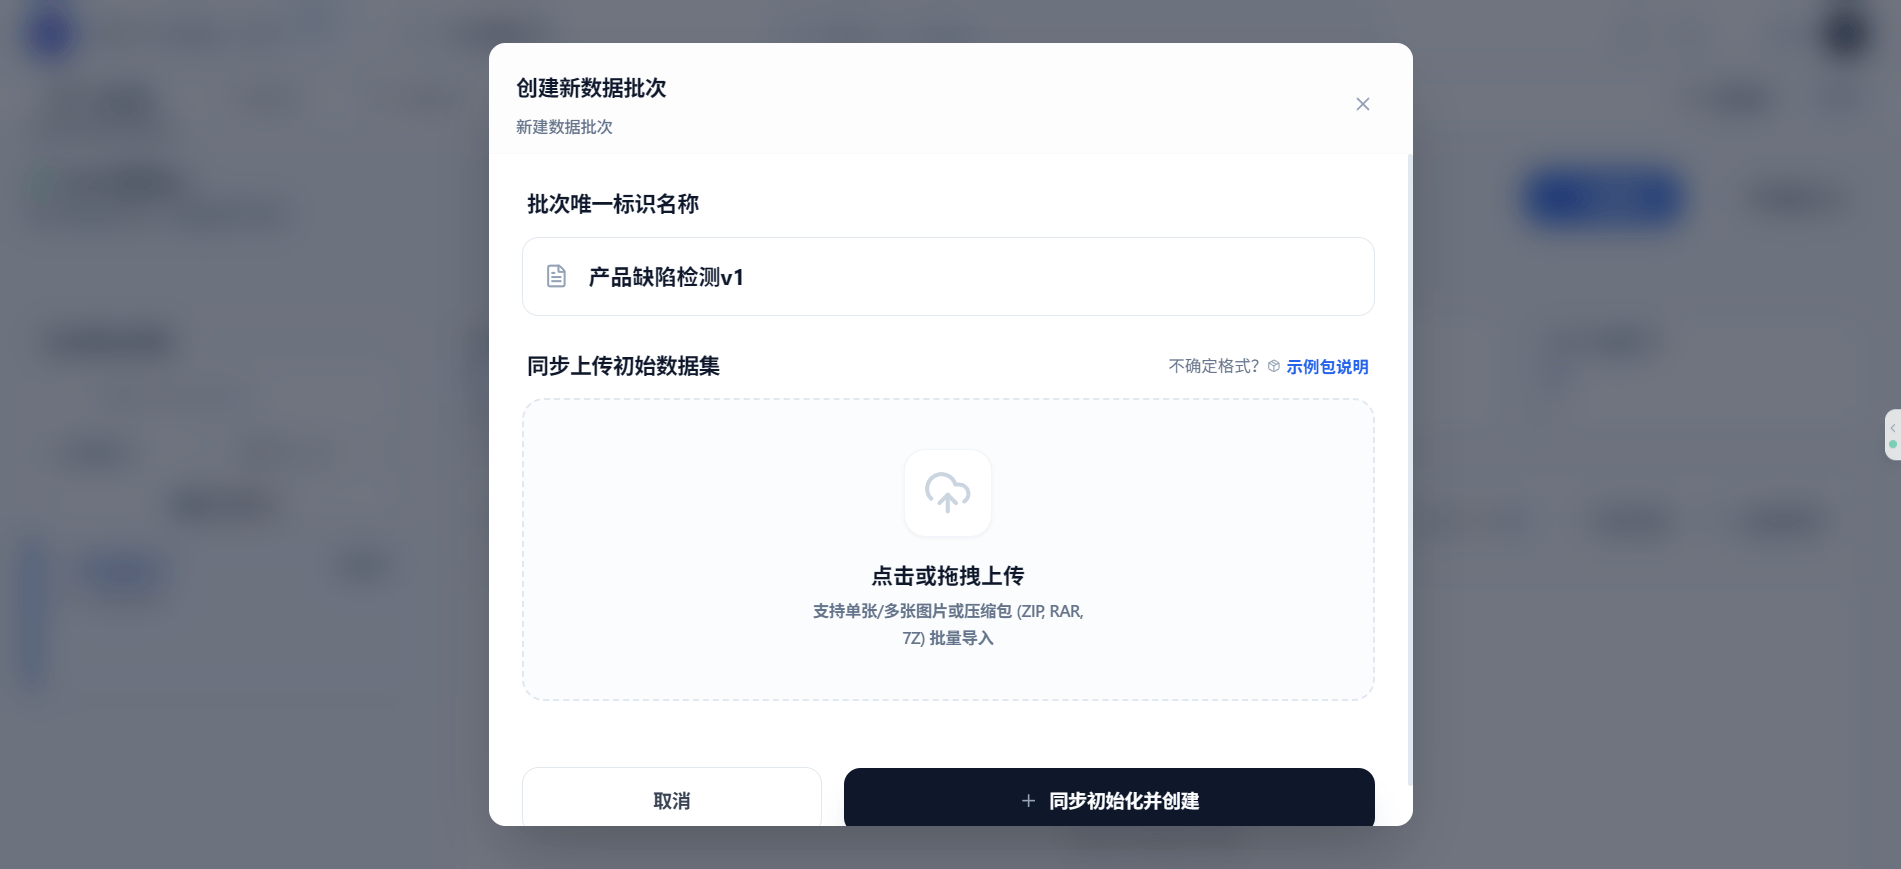
对没有工程背景的人,这等于把“环境准备”这道最容易劝退新手的关卡直接跨过去,把精力留给真正重要的业务判断。
二、训练策略不用自己拍脑袋
第二层价值是“策略托管”。该用哪种骨干网络、学习率怎么设、训练多少轮,过去全靠经验。AI大模型训练工作站DLTM把常用组合沉淀为可选项,甚至支持按任务类型(分类、检测、分割等)推荐默认方案,用户只要在几个合理档位里做选择。它不神化“自动”,而是把决策成本从“从头摸索”降到“从建议里挑”,让非专业人员也能跑出可用模型。
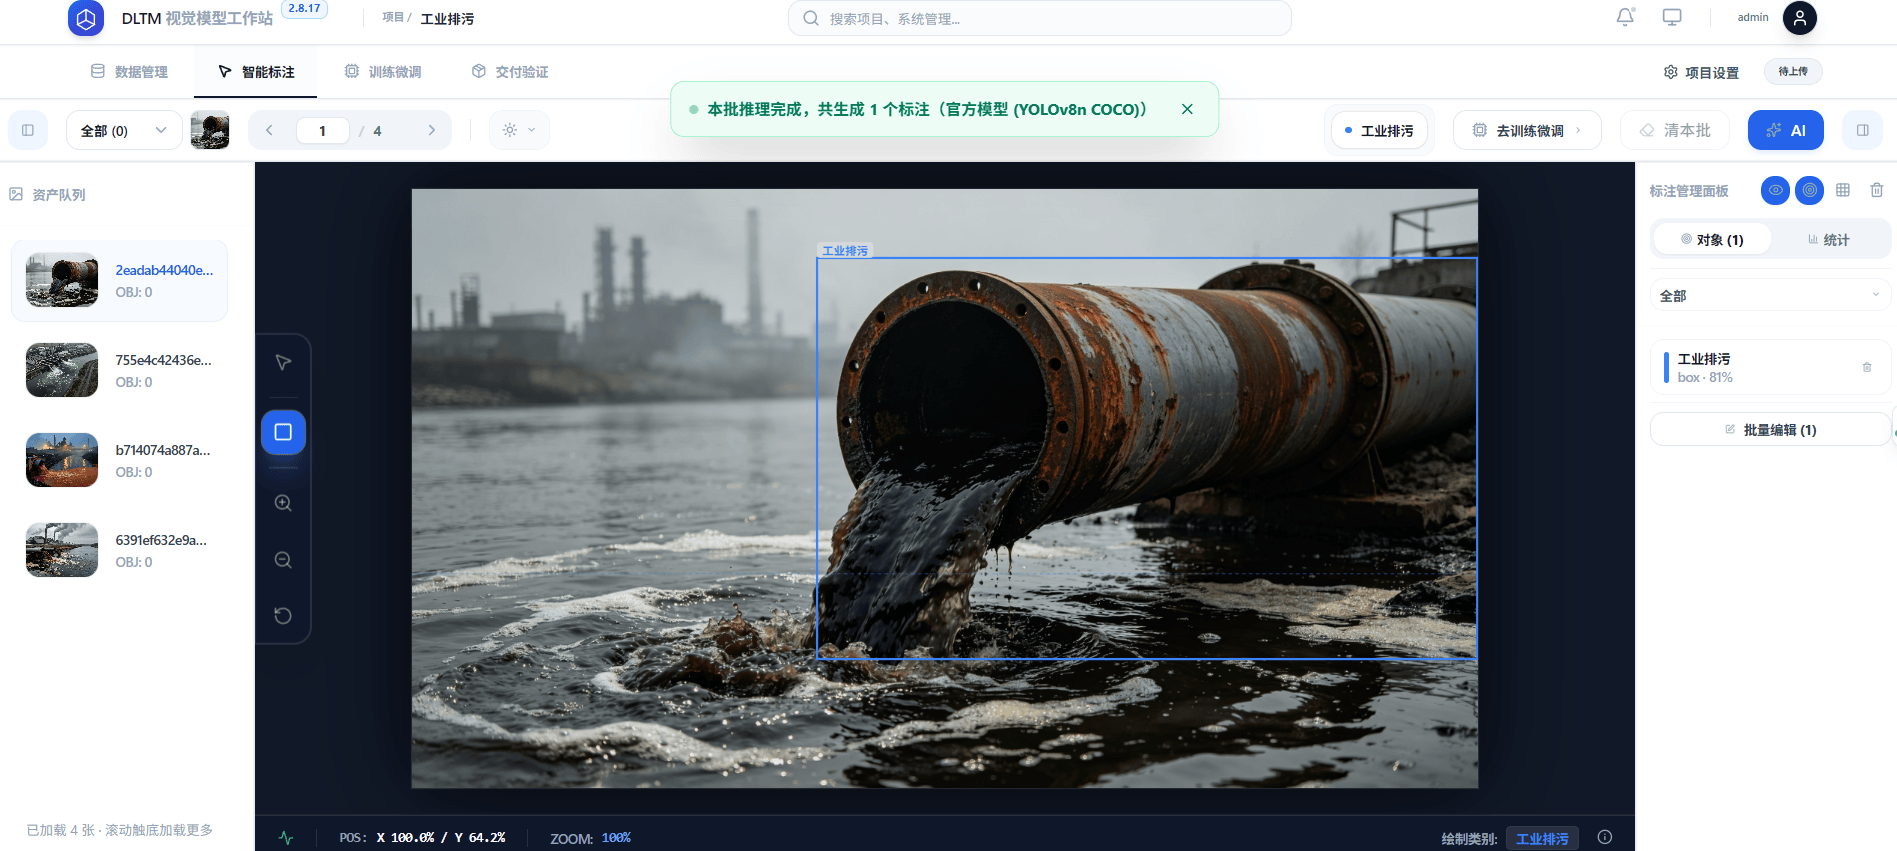
三、过程可视:训练不再是个黑箱
第三层价值是“过程透明”。训练任务跑起来后,平台实时呈现损失、精度等指标曲线,异常会自动提示。
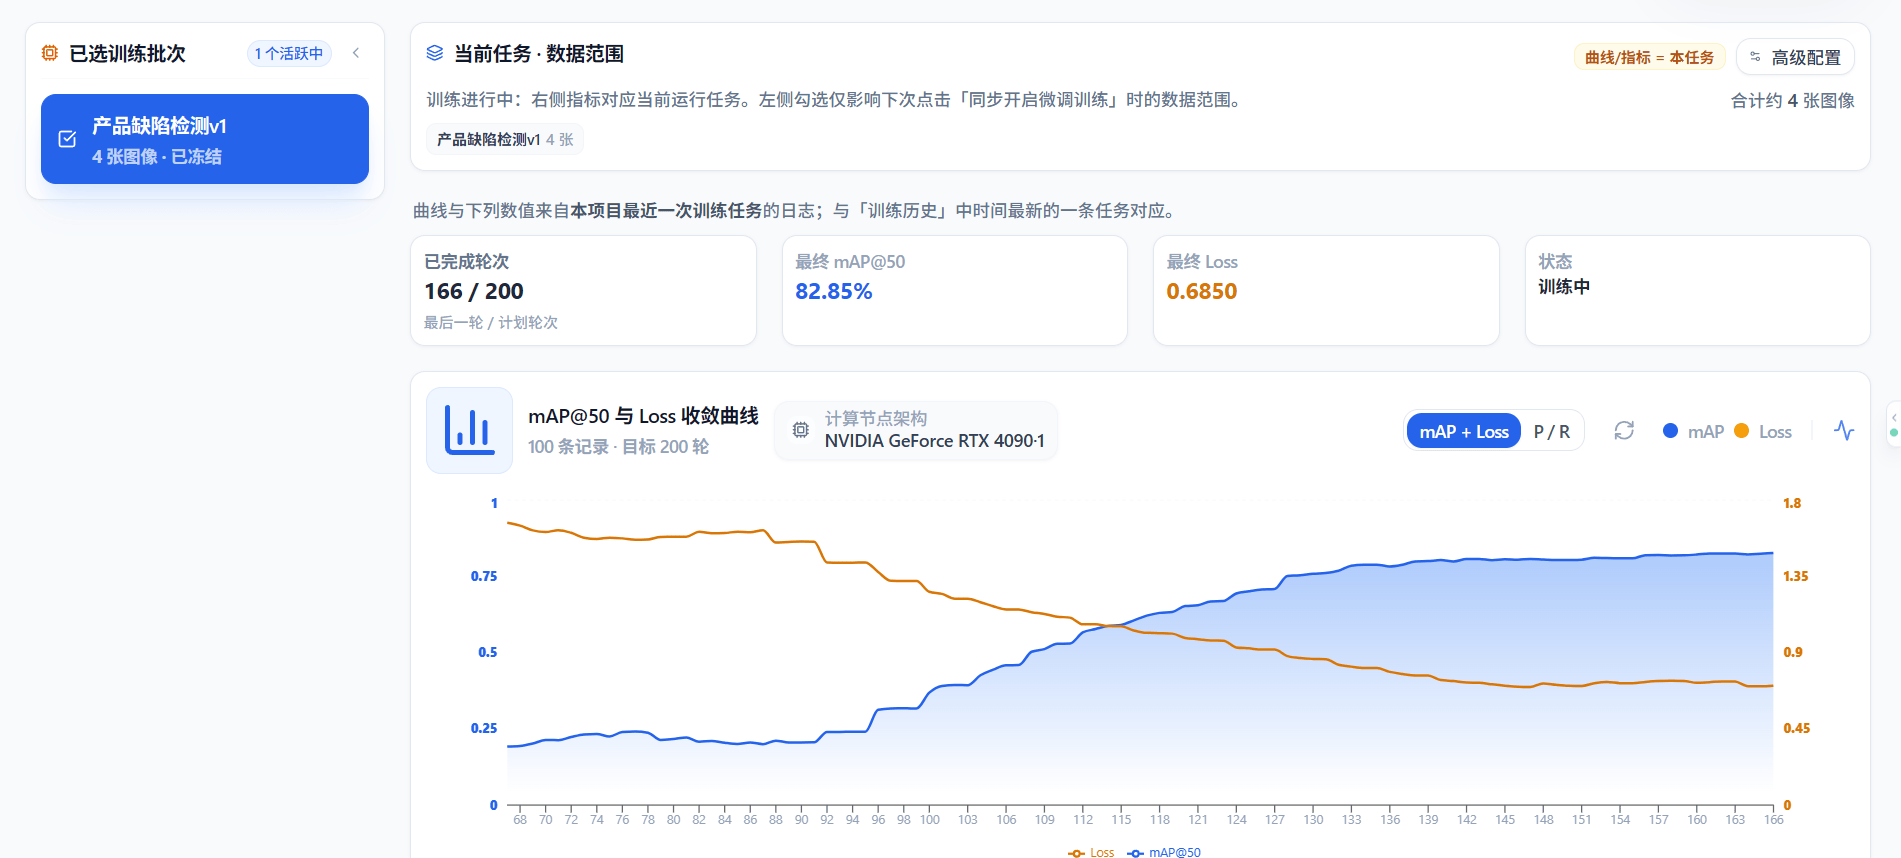
这让非专业人员也能直观判断“模型在学还是在不收敛”,而不是干等几天后拿到一个不知好坏的结果。可观测,是自动训练能被信任的前提,也是团队敢于把建模交给平台的基础。
四、自动训练的上限与边界
需要说清楚的是,自动训练解放的是“重复工程力”,不是“业务理解力”。选对任务目标、准备干净数据、定义清楚要解决的问题,仍要人来判断。
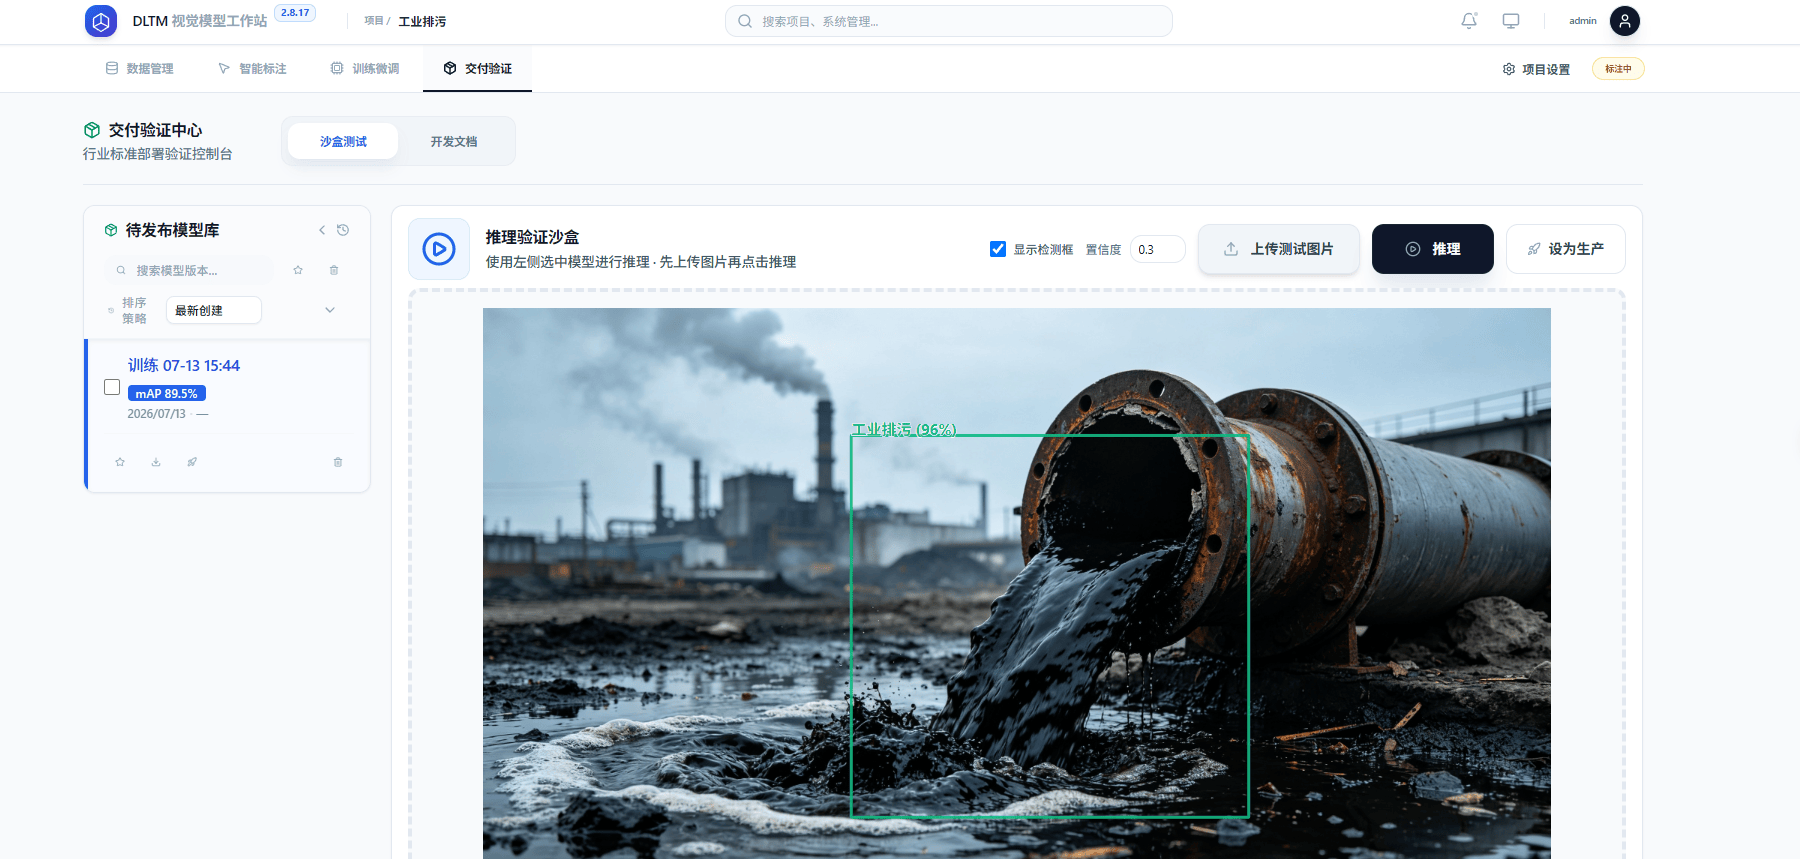
私有化本地化AI模型训推工作站DLTM把人从写代码里解放出来,是为了让人把精力放在更值钱的地方:想清楚到底要解决什么,而不是陷在环境报错里。
结尾
零代码自动训练的意义,不在于让所有人变成算法专家,而在于让算法专家的能力被复制给所有人。深度学习推理工作站DLTM把“训模型”这件事从手艺活,变成了可配置、可复用、可监控的流水线作业,这本身就是AI民主化的关键一步。

 浙公网安备 33010602011771号