
自动化零代码本地大模型推理服务器DLTM训推一体:让数据到模型到上线只走一条流水线
前面我们分别看了自动训练、人工与AI标注、推理验证、模型导出和私有化部署。把它们拆开看,每一环都能独立成事;但深度学习推理工作站DLTM真正的价值,在于把这五环拧成“一条流水线”——数据进来,模型出去,中间不必在多个工具间来回倒腾。这种训推一体的设计,解决的是AI项目最隐形的成本:切换与割裂。
一、割裂的工具链,才是AI落地的暗坑
很多团队的真实困境不是某一环不会做,而是环节之间“接不上”。标注用A工具,训练用B框架,验证靠手写脚本,导出再换C格式,部署又是一套新环境。
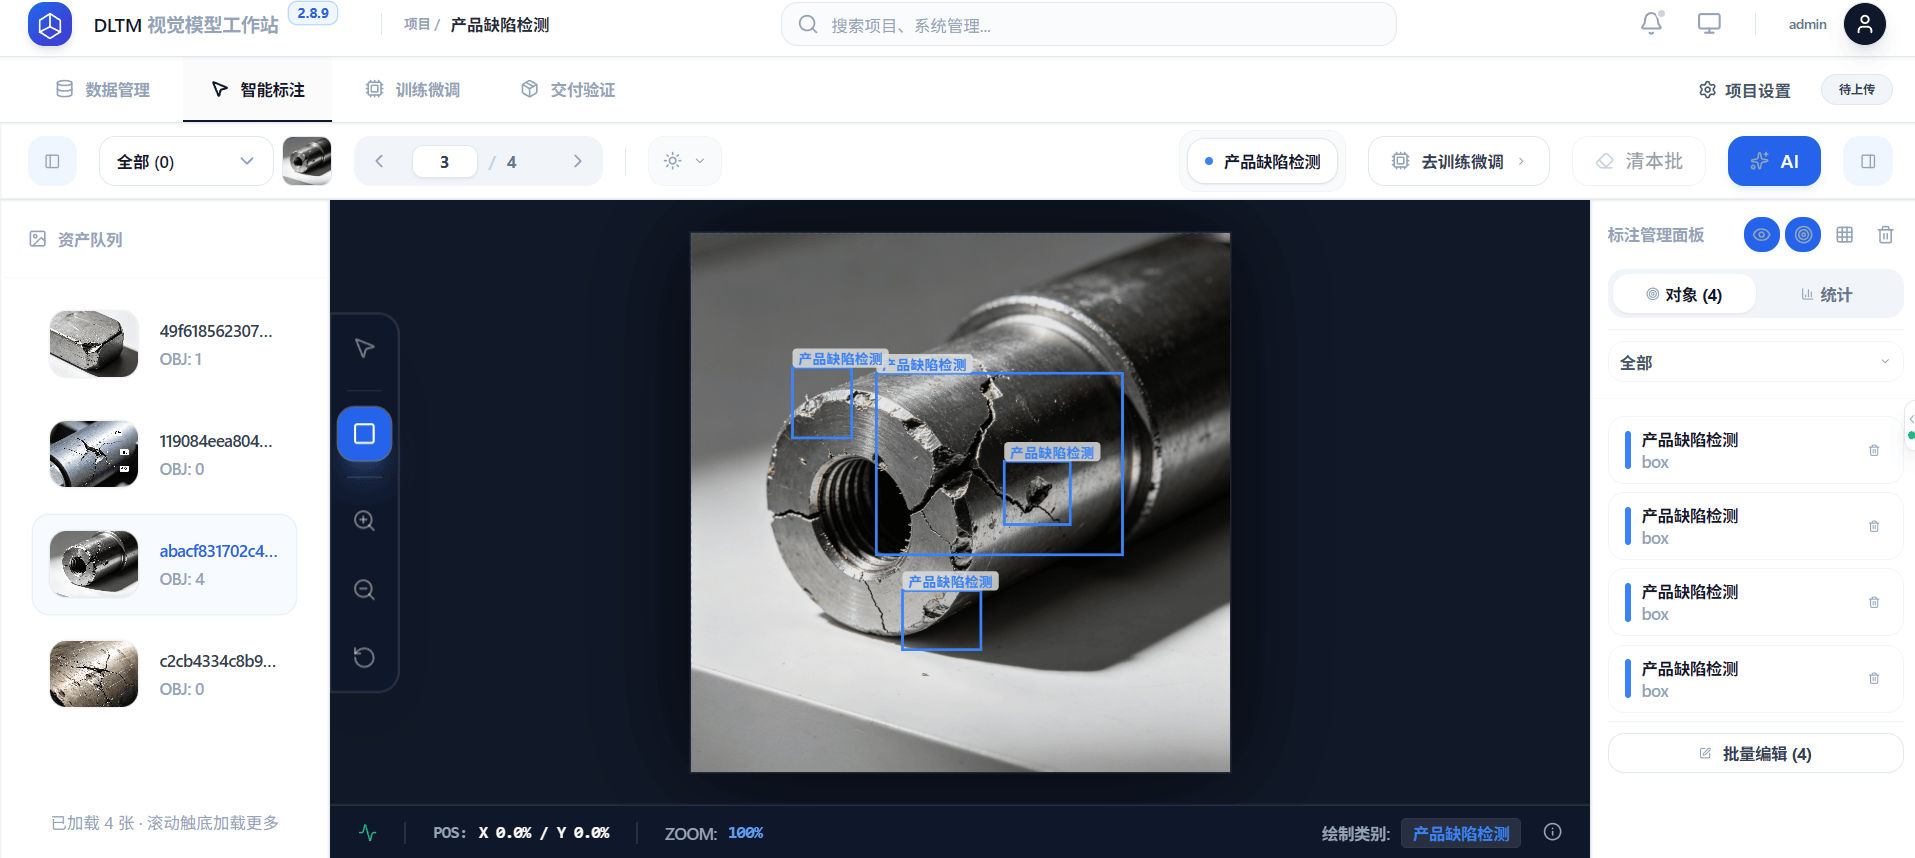
每次切换都伴随格式转换、环境配置和数据搬运,出错概率和沟通成本层层叠加。项目越推进,越像一个被打散的拼图。训推一体要做的,就是把这个拼图重新拼成一张图。
二、五环如何在一套系统里咬合
在AI大模型训练工作站DLTM中,五环的咬合靠的是统一的数据与任务主线。
- 标注产生的数据直接进入训练池;
- 训练结果一键进入验证;
- 验证不达标可原路回标注补样本;
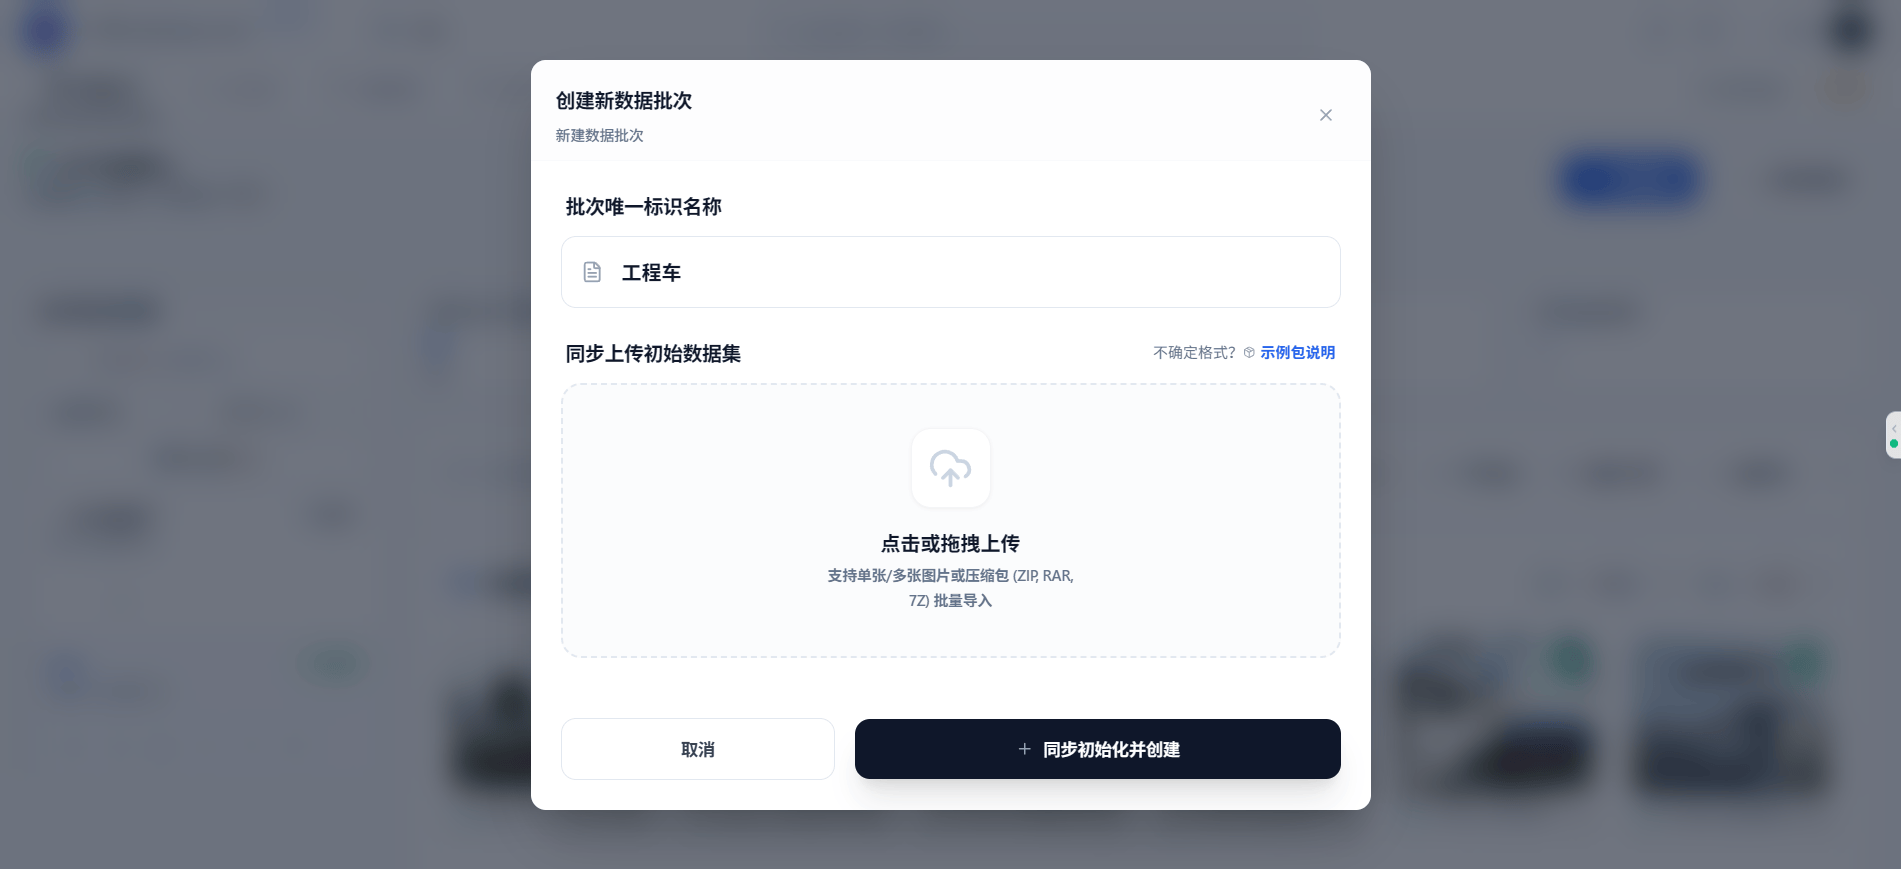
- 验证通过后一键导出;
- 导出物直接对接私有化或边缘部署。
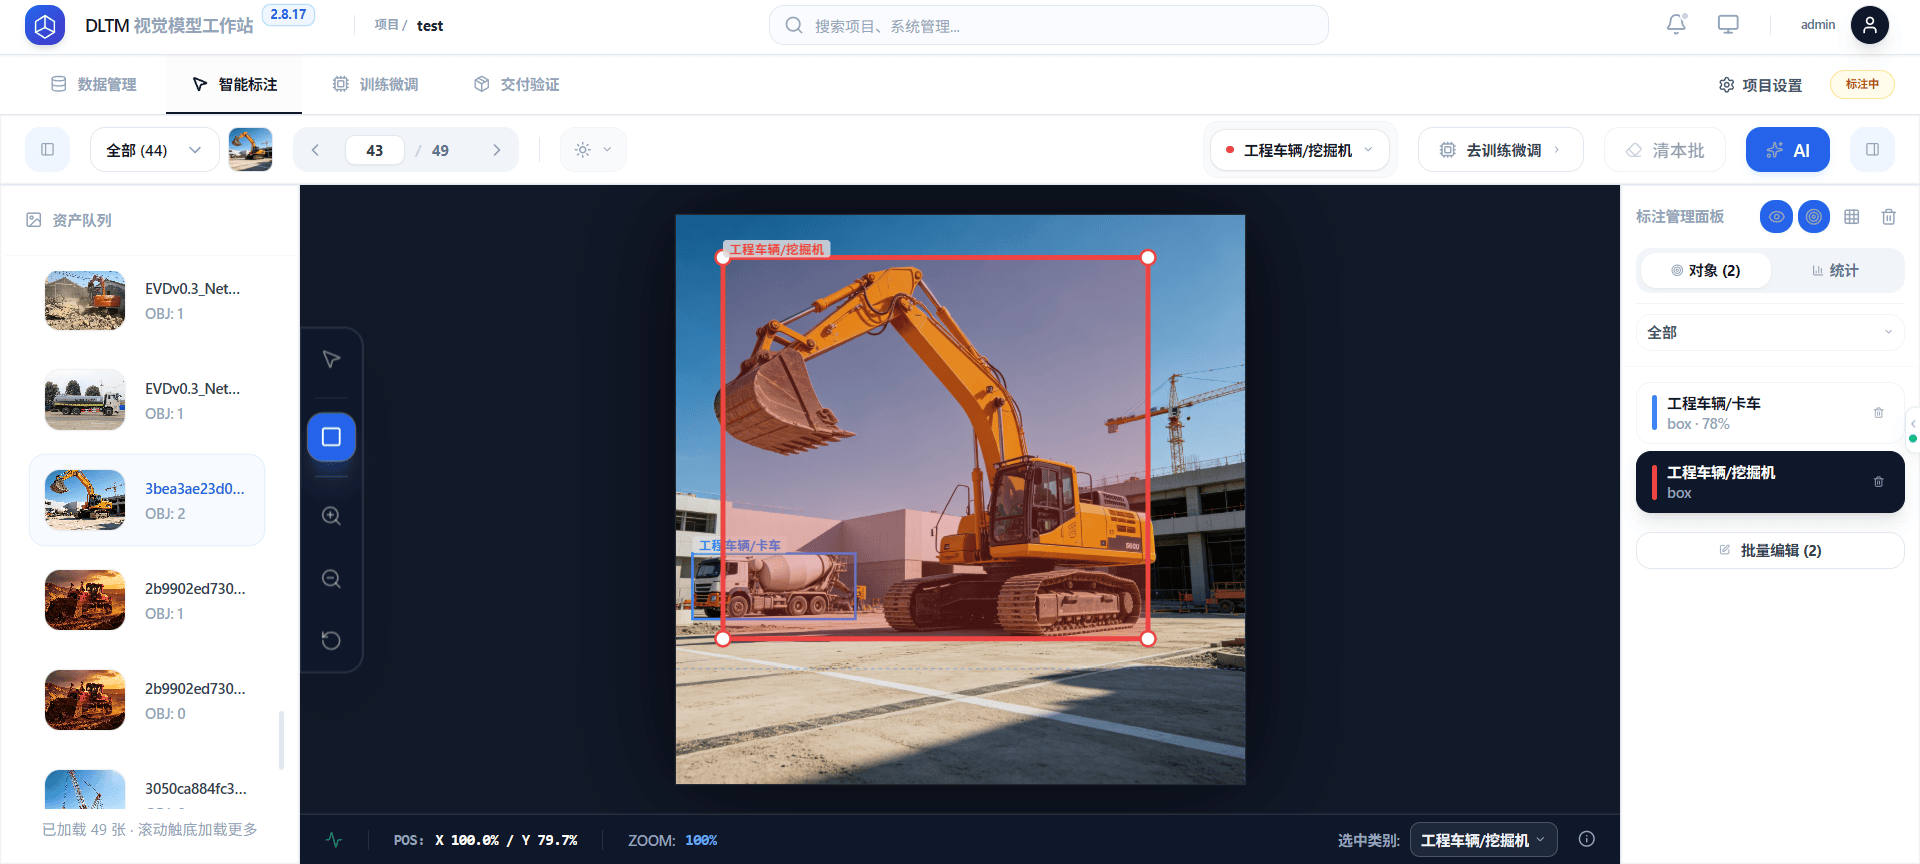
整条链路共享同一份数据、同一套权限、同一个操作界面,用户感受到的是“顺下去”,而不是“搬过去”。
三、闭环迭代:模型越用越准的秘密
企业AI算力工作站DLTM训推一体最被低估的能力,是让迭代变便宜。因为所有环节在同一系统里,当线上推理发现新问题时,业务方可以迅速把问题样本退回标注,重新训练、重新验证、重新导出,整个过程无需跨团队、跨工具协调。这种“发现—修正—再上线”的短闭环,使模型能跟着业务一起持续进化,而不是交付即定型。
四、统一界面降低协作摩擦
当算法、标注员、业务方和IT都在同一套系统里工作,沟通从“你导给我、我转给你”变成“在同一个任务里看同一份结果”。
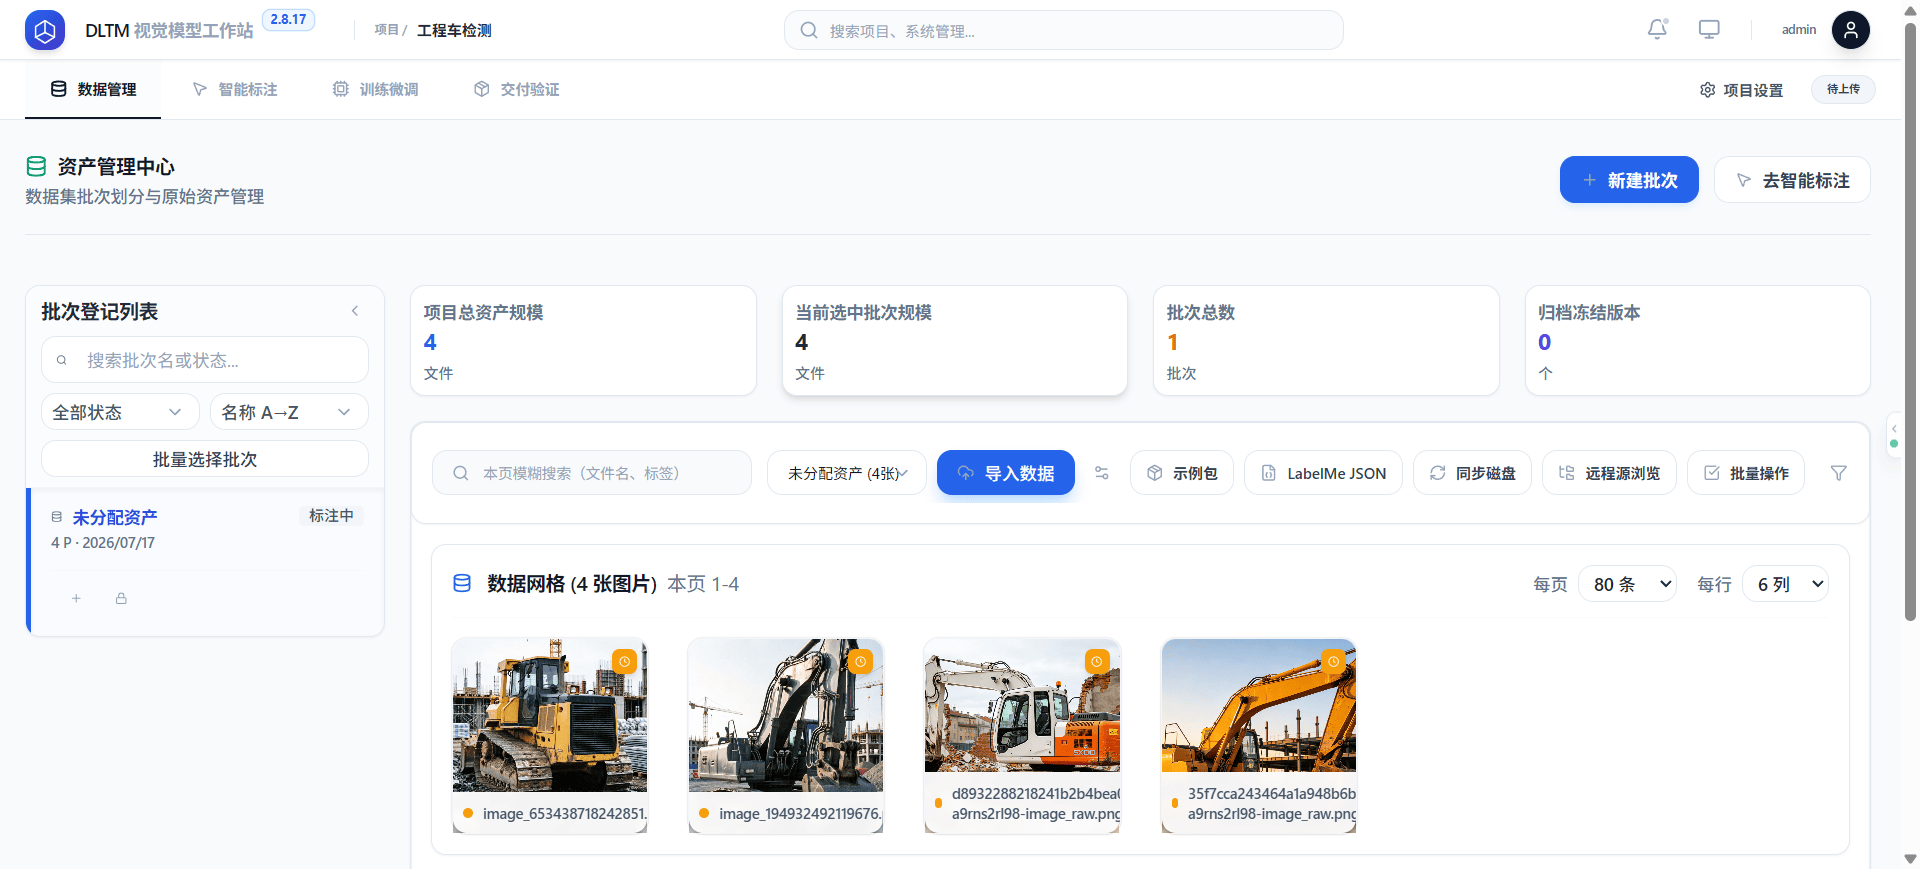
权限、版本、日志都在系统内可追溯,谁改了什么、模型为何变好变坏,一目了然。对组织而言,私有化本地化AI模型训推工作站DLTM训推一体不只是技术整合,更是协作方式的整合。
五、选训推一体,要看“通”而不只看“强”
评估这类工作站时,单看某一项能力多强容易误判。更该问的是:这五环之间通不通?数据要不要导出导入?部署要不要另接系统?私有化能不能覆盖全链路?
- 通,才意味着低摩擦;
- 不通,再强的单点也会在交接处漏掉效率。
企业私有化AI训练推理一体工作站DLTM的竞争力,正落在“通”这个字上。
结尾
AI落地的难,常常不在某个技术点,而在环节之间的缝隙。训推一体把缝隙填平,让数据到模型到上线成为一条顺滑的流水线。当团队不再为“接不上”头疼,AI才能真正沉进业务,而不是停在演示。

 浙公网安备 33010602011771号