
自动化零代码本地大模型推理服务器DLTM推理验证:模型上线前必须过的“质量关”
训练出一个指标好看的模型,和让这个模型在真实环境里稳稳干活,是两回事。很多AI项目折就折在“实验室里满分,上线后翻车”。自动化零代码本地大模型推理服务器DLTM把推理验证作为模型交付前的关键一环,目的就是在上线之前,先替业务方把这道“质量关”过一遍——确认模型不是只在训练集上聪明,而是在真实数据上也能靠得住。
一、为什么训练指标好,不等于能用
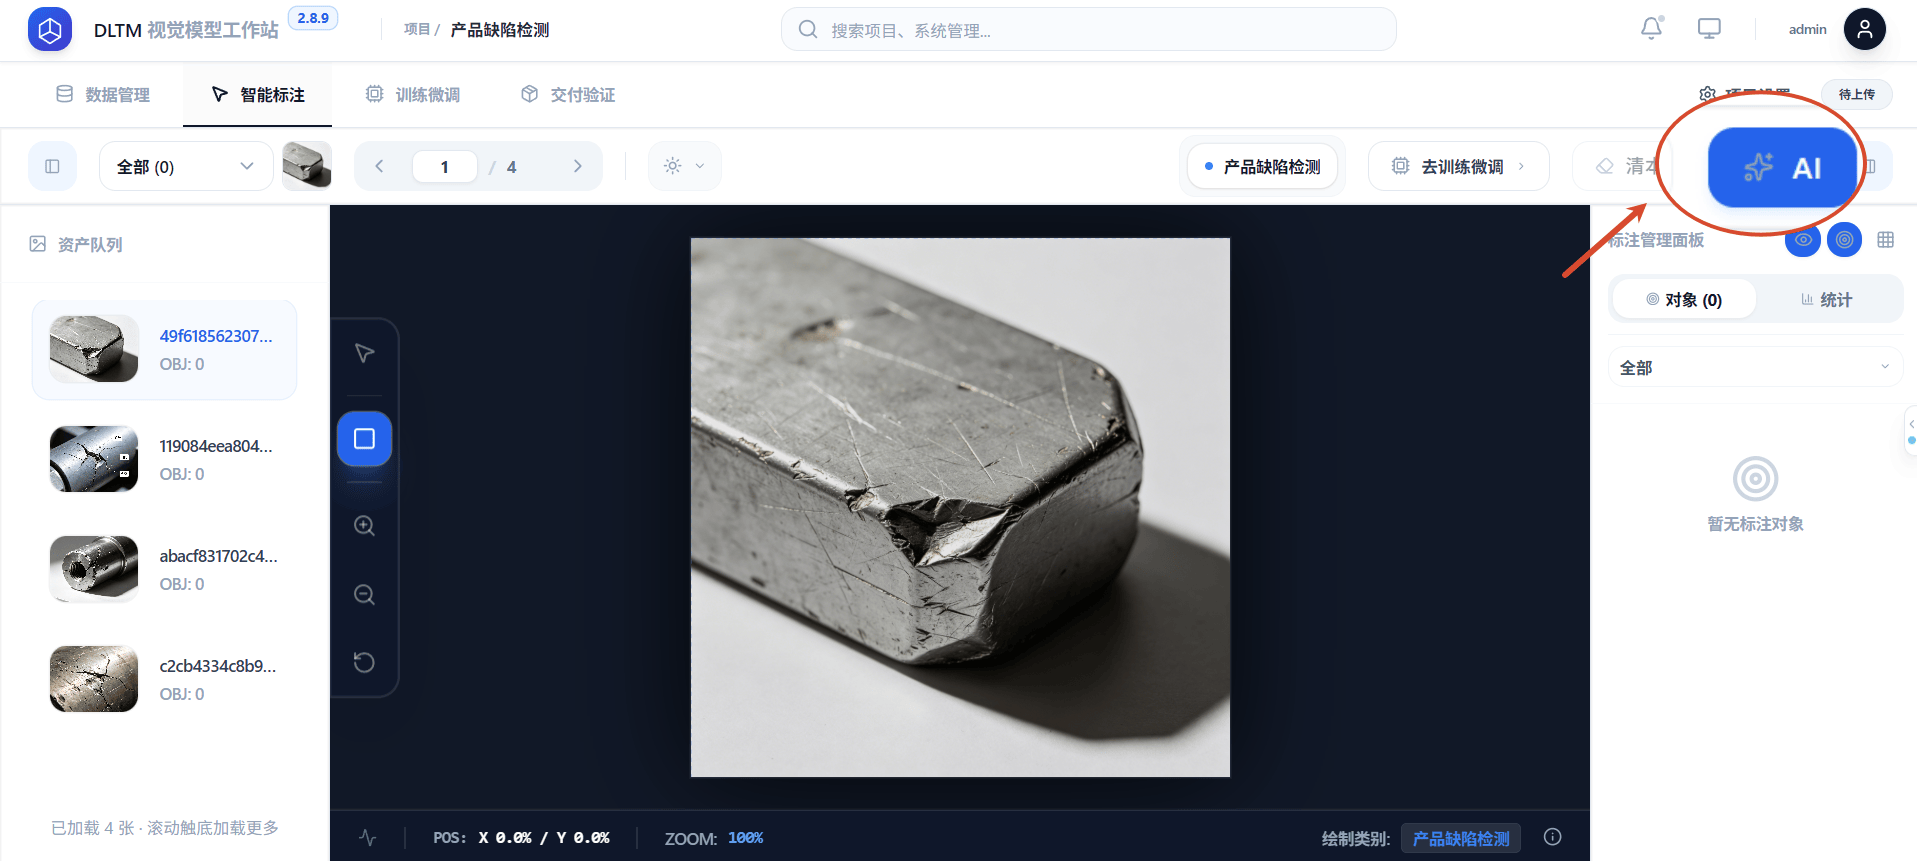
训练阶段的准确率,往往建立在相对“干净”的数据上。而真实场景里,光线会变差、角度会刁钻、会出现训练时没见过的干扰物。
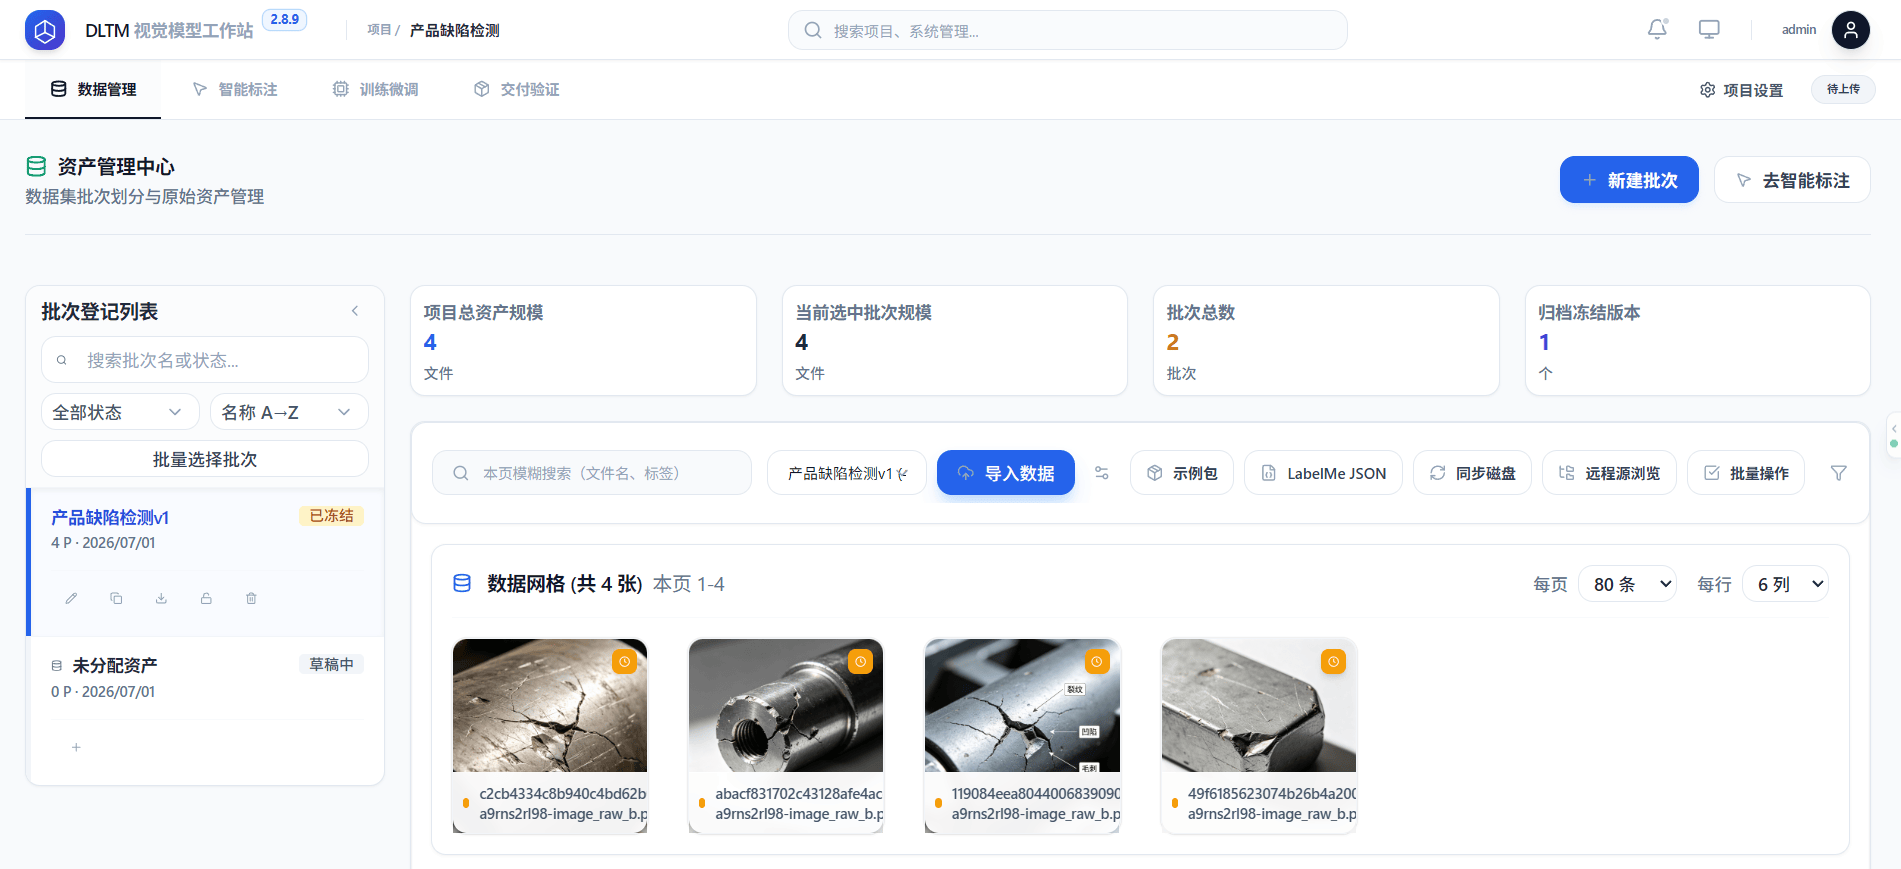
如果跳过独立验证直接上线,模型很可能在这些“长尾情况”上大量误判。推理验证要做的,就是用一批模型没见过、但贴近真实的数据,去检验它到底学得扎不扎实。
二、验证看什么:不止一个准确率
验证不能只盯一个总准确率。在自动化AI算法训练服务器DLTM的验证环节,更值得看的是细分指标:对不同类别的识别是否均衡,对难样本的召回是否够高,推理耗时是否满足业务节奏。
比如一个质检模型,漏掉不良品的代价往往远高于误报,这时“召回率”就比总准确率更关键。把指标拆开看,才能发现模型真正的短板。

三、用真实样本做“压力测试”
有效的推理验证,应该尽量贴近上线后的真实分布。这包括采集不同时间段、不同设备、不同环境下的样本,而不是随手挑几张“好看的图”。

AI模型私有化部署平台DLTM支持把业务方提供的真实片段直接灌入验证流程,让模型在接近实战的条件下暴露问题。越早暴露,修复成本越低。
四、验证不过,就别急着上线
推理验证最该被尊重的结论,是“不过就拦下”。当验证发现模型在关键场景上不达标,正确做法不是硬上,而是回到标注或训练环节补数据、调策略。私有化本地化AI模型训推工作站DLTM把验证结果和训练闭环打通,使得“验证—回炉—再验证”成为可重复的动作,而不是一次性走过场。
五、验证也是给业务方的“信任凭证”
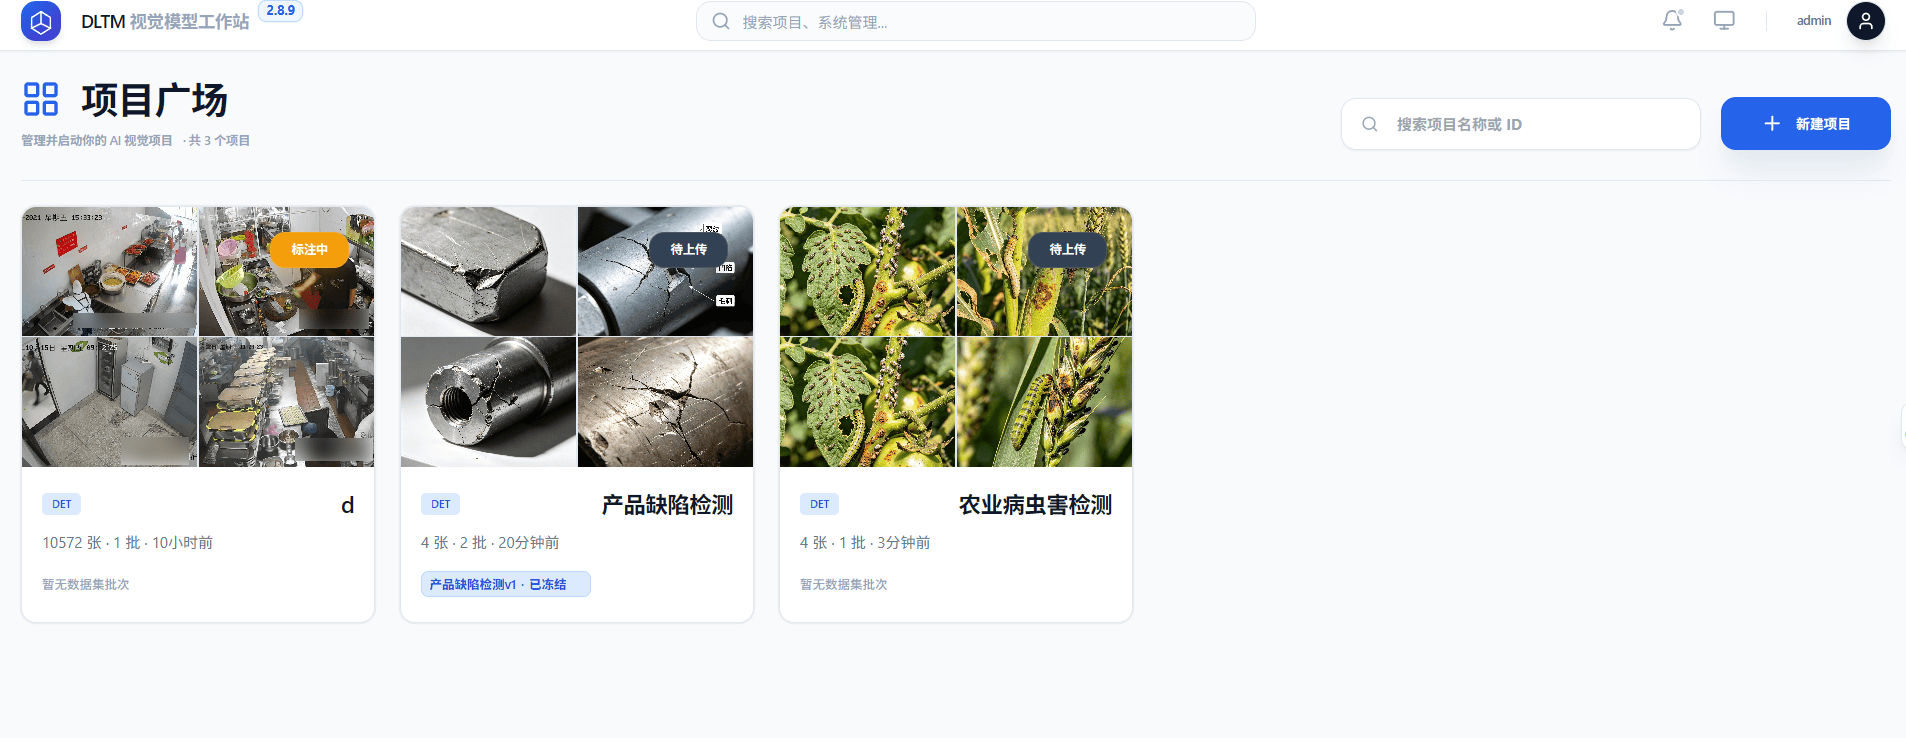
对不懂算法的业务方来说,验证报告是模型值不值得用的直观证据。一份清晰的推理验证结果,比任何口头承诺都更有说服力。
它回答的是最朴素的问题:这个模型在我关心的事情上,到底准不准、稳不稳、快不快。验证做到位,AI才真正从“Demo”走向“生产工具”。
结尾
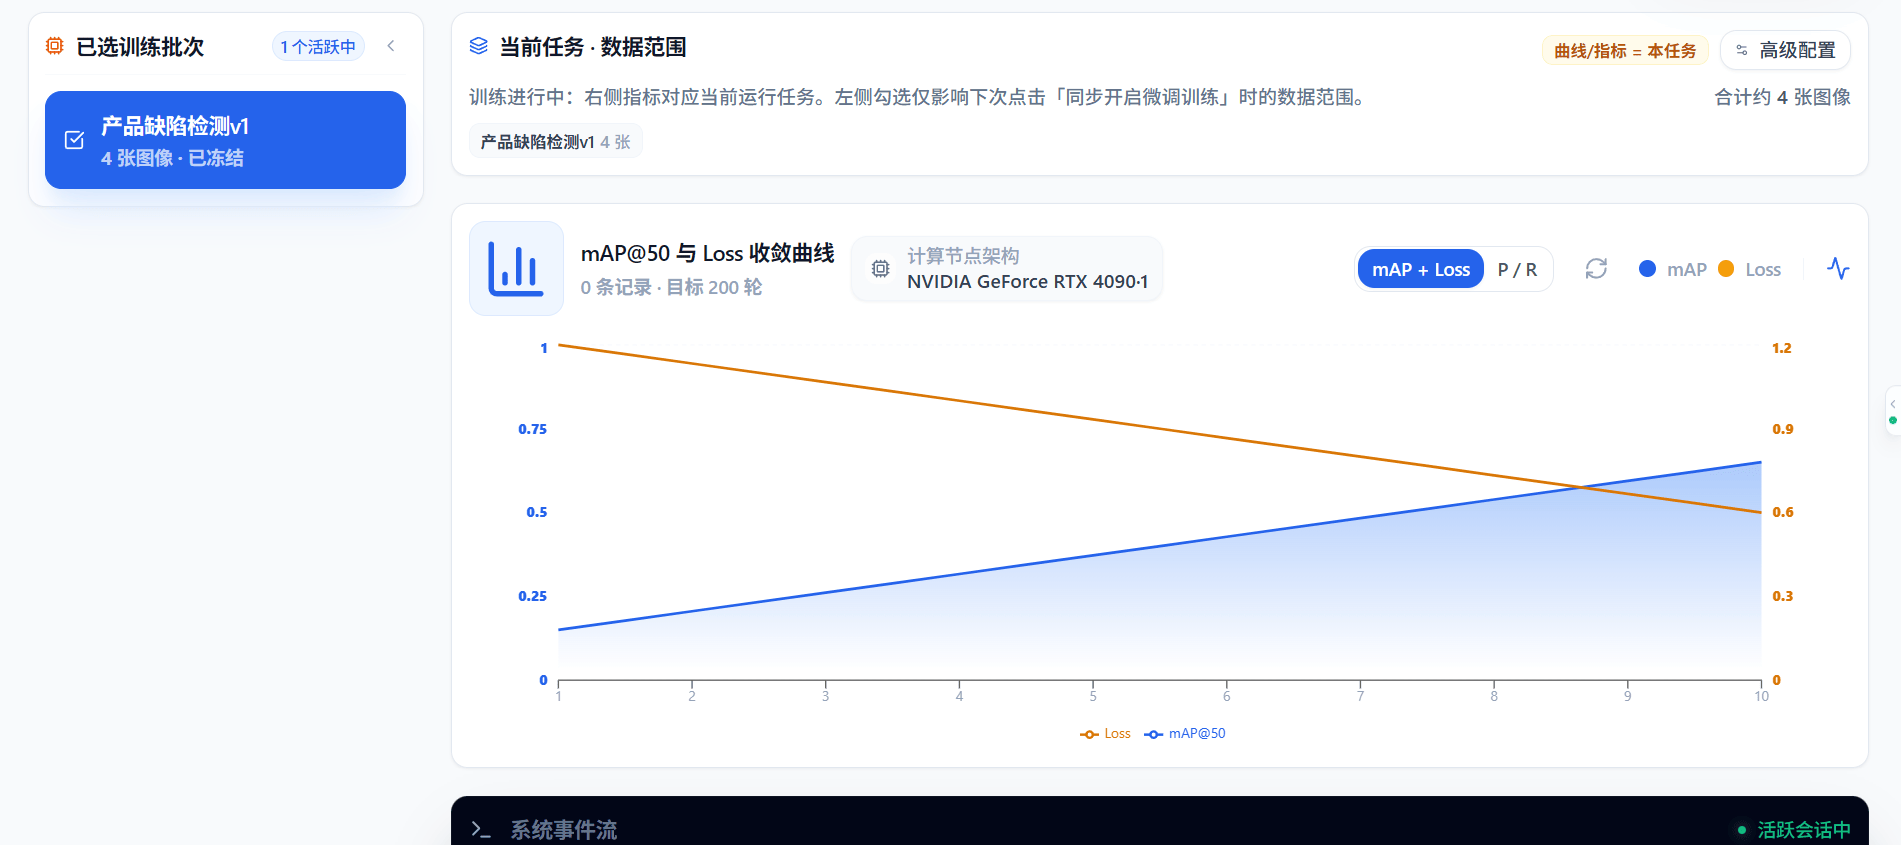
本地大模型推理服务器DLTM推理验证不是训练完成后的附加动作,而是模型能否被信任的临门一脚。跳过它,省下的是几天时间,赌上的却是整个项目的口碑。把好验证关,AI落地才不至于“上线即翻车”。

 浙公网安备 33010602011771号