
人工标注不是过时,而是本地大模型推理服务器DLTM自动训练里最关键的“老师”
在AI自动标注越来越聪明的今天,有人开始怀疑:人工标注是不是要被淘汰了?答案恰恰相反。对AI大模型训练工作站DLTM这类训推一体工作站来说,人工标注不是被绕过的环节,而是整个自动训练链条里最不可替代的“老师”。
- 模型再聪明,也需要由人先告诉它“什么是对的”;
- 尤其当场景专业、样本稀少、边界模糊时,人工标注的质量直接决定了模型能学到什么。

一、为什么模型离不开“人教”
监督学习本质上是在模仿人类给出的标准答案。如果标注本身就含糊、错位或自相矛盾,自动训练再自动化,学到的也是一套错误逻辑。
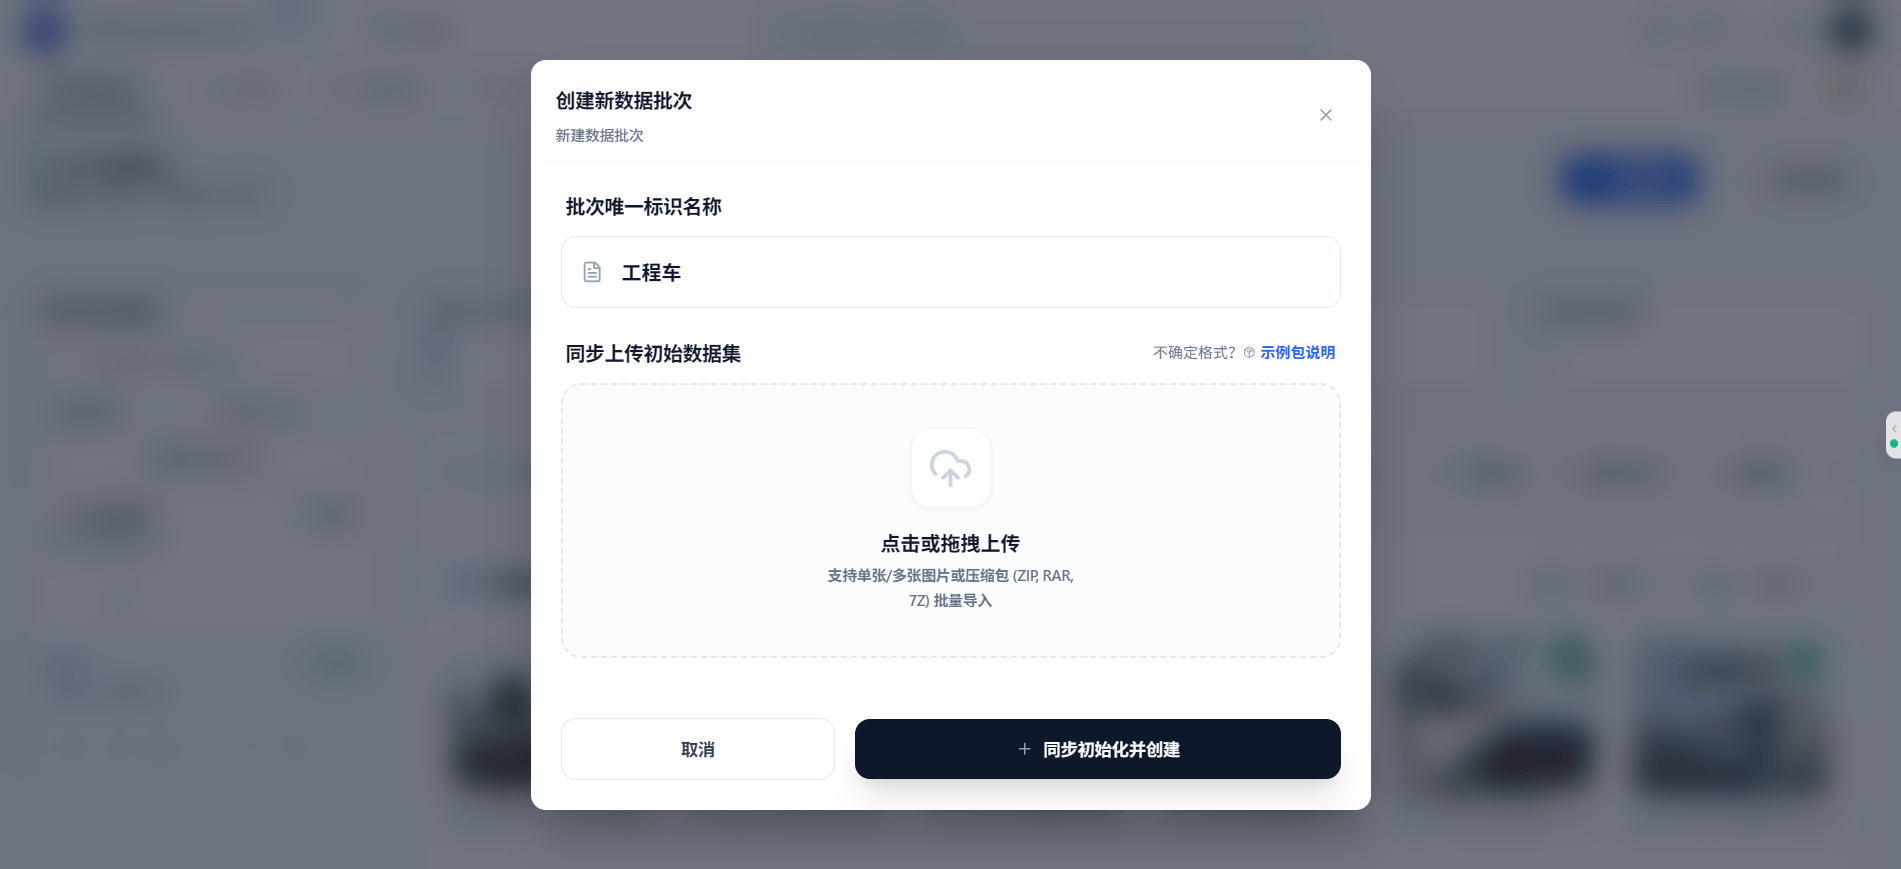
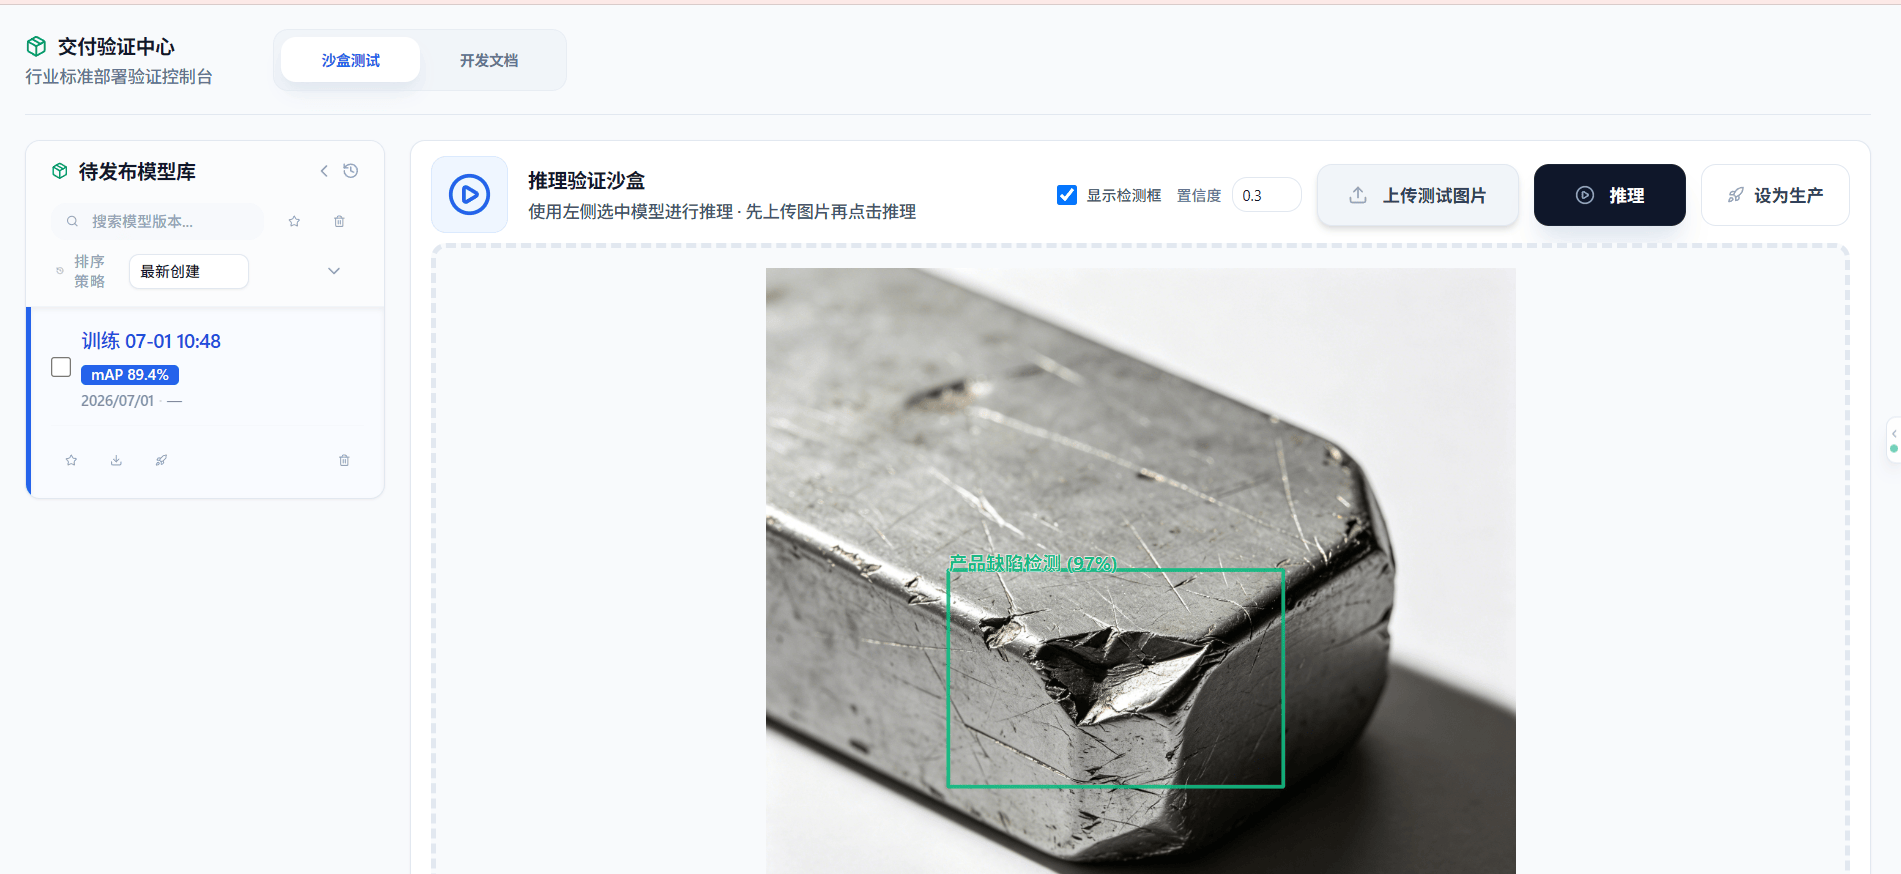
很多业务场景里,真正难的不是建模,而是把“老师傅的经验”翻译成机器能理解的标签。比如判断一张工业影像里的瑕疵等级,靠的是多年积累的手感,这种知识只有人能先沉淀成标注,机器才有样本可学。
二、人工标注如何在DLTM里形成闭环
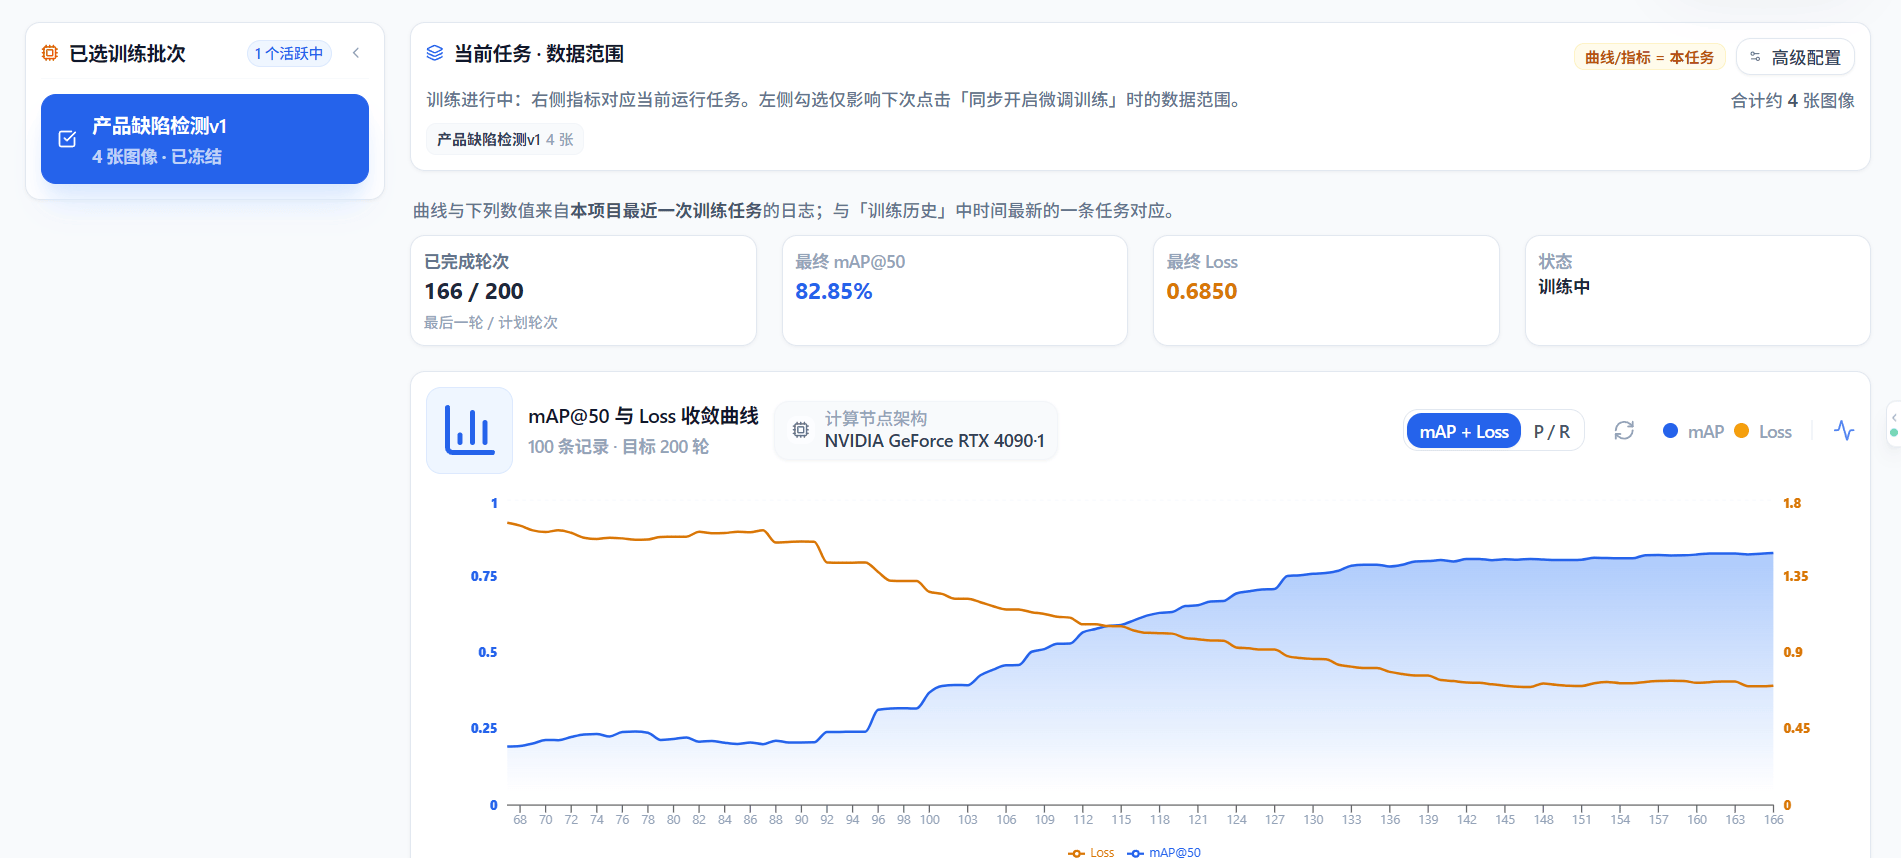
在自动化AI算法训练服务器DLTM中,人工标注不是孤立的一步,而是和训练紧密联动的闭环。标注好的数据进入自动训练,训练产出的模型反过来可以辅助后续标注;人工持续修正模型的误判样本,这些“难例”又被送回训练,形成越用越准的循环。这种“人标—机训—人纠”的节奏,比一次性标完再训练更接近真实落地。
三、标注规范:别让每个人标成“自己的标准”
人工标注最容易出的问题是标准不统一。同一张图,A标成“轻度”,B标成“中度”,模型就会无所适从。因此上线标注前,先定清楚标签定义、边界规则和争议处理方式,往往比急着开工更重要。深度学习推理工作站DLTM里可以沉淀标注规范文档与示例,让新加入的标注员也能快速对齐口径,减少返工。
结尾
把人工标注看成“过时环节”,是对AI训练过程的误解。真正成熟的训推一体工作流,是让人的判断和机器的算力各司其职——人负责定义对错,机器负责放大效率。两者合在一起,模型才学得明白,也用得放心。

 浙公网安备 33010602011771号