
自动化AI算法训练服务器DLTM零代码自动训练:把AI模型开发从“写代码”变成“点按钮”
过去,训练一个能用的AI模型,几乎被默认是算法工程师的专属工作。数据集要清洗、网络结构要设计、超参数要一调再调,整个流程里写满了Python脚本和命令行。
对很多业务团队来说,想用AI,第一步就被“会不会写代码”挡在了门外。自动化AI算法训练服务器DLTM这类零代码训推一体工作站的出现,正试图把这道门槛拆掉——让模型开发从“写代码”回归到“描述问题、上传数据、点按钮启动”。
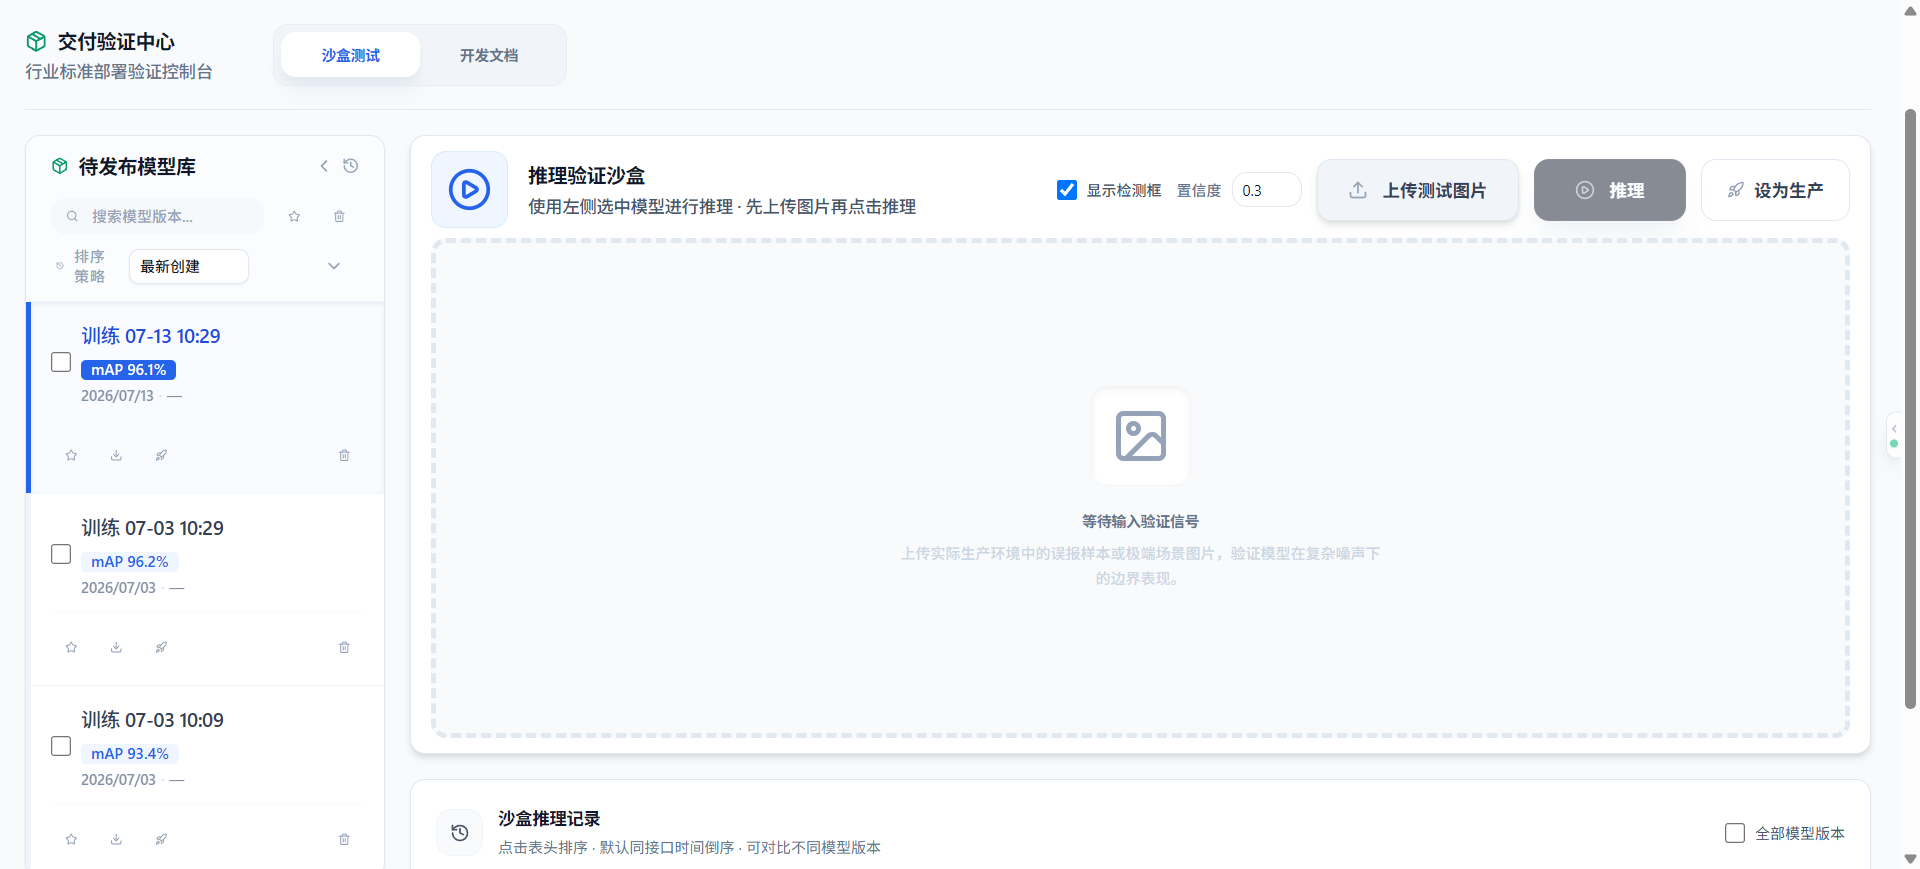
一、为什么传统模型训练让人望而却步
传统训练流程的难点,并不只在“写代码”本身。更麻烦的是环节之间的串联:
- 数据格式不对要重写预处理脚本;
- 训练效果不好要反复改网络、调学习率;
- 换一批数据又要从头走一遍。
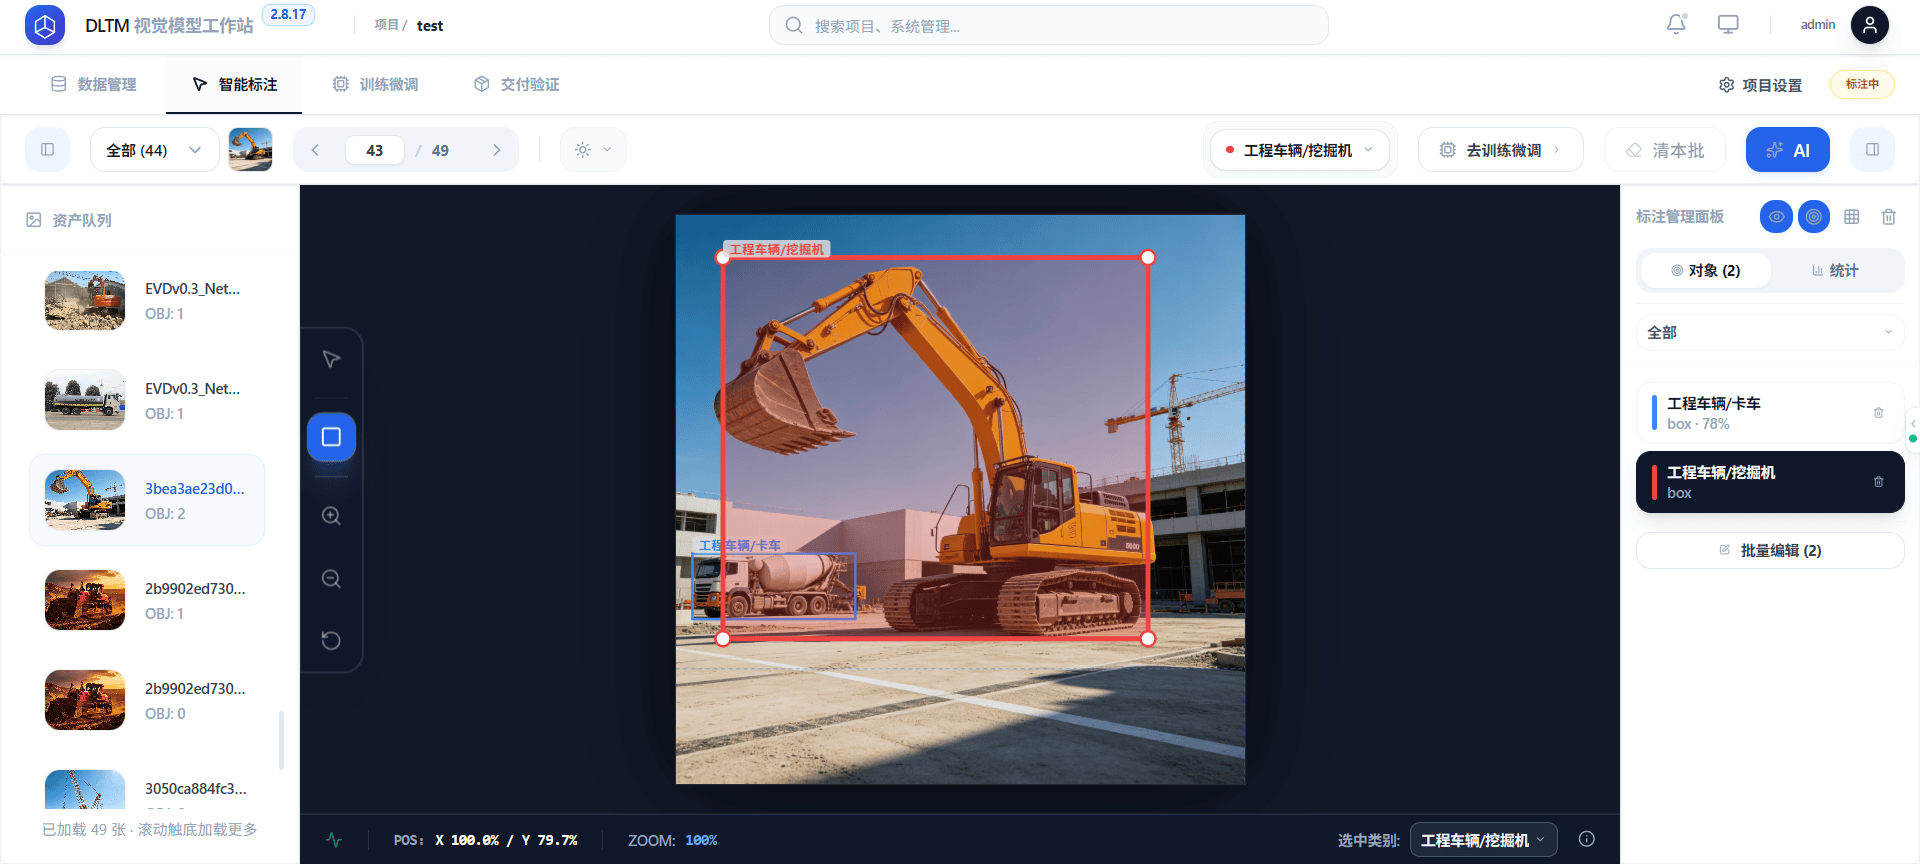
这种高度依赖个人经验和手工操作的方式,让模型开发周期被拉长到数周甚至数月,也注定只有少数团队玩得起。对中小型企业、政企单位和工厂车间而言,“养一个算法团队”本身就是一道成本鸿沟。
二、自动训练到底“自动”了哪些环节
所谓自动训练,核心是把那些重复、繁琐、靠经验的环节交给系统完成。典型包括:
- 自动完成数据的切分与校验,避免人工划分带来的偏差;
- 自动尝试多种基础模型与参数组合,从中挑选效果更优的一组;
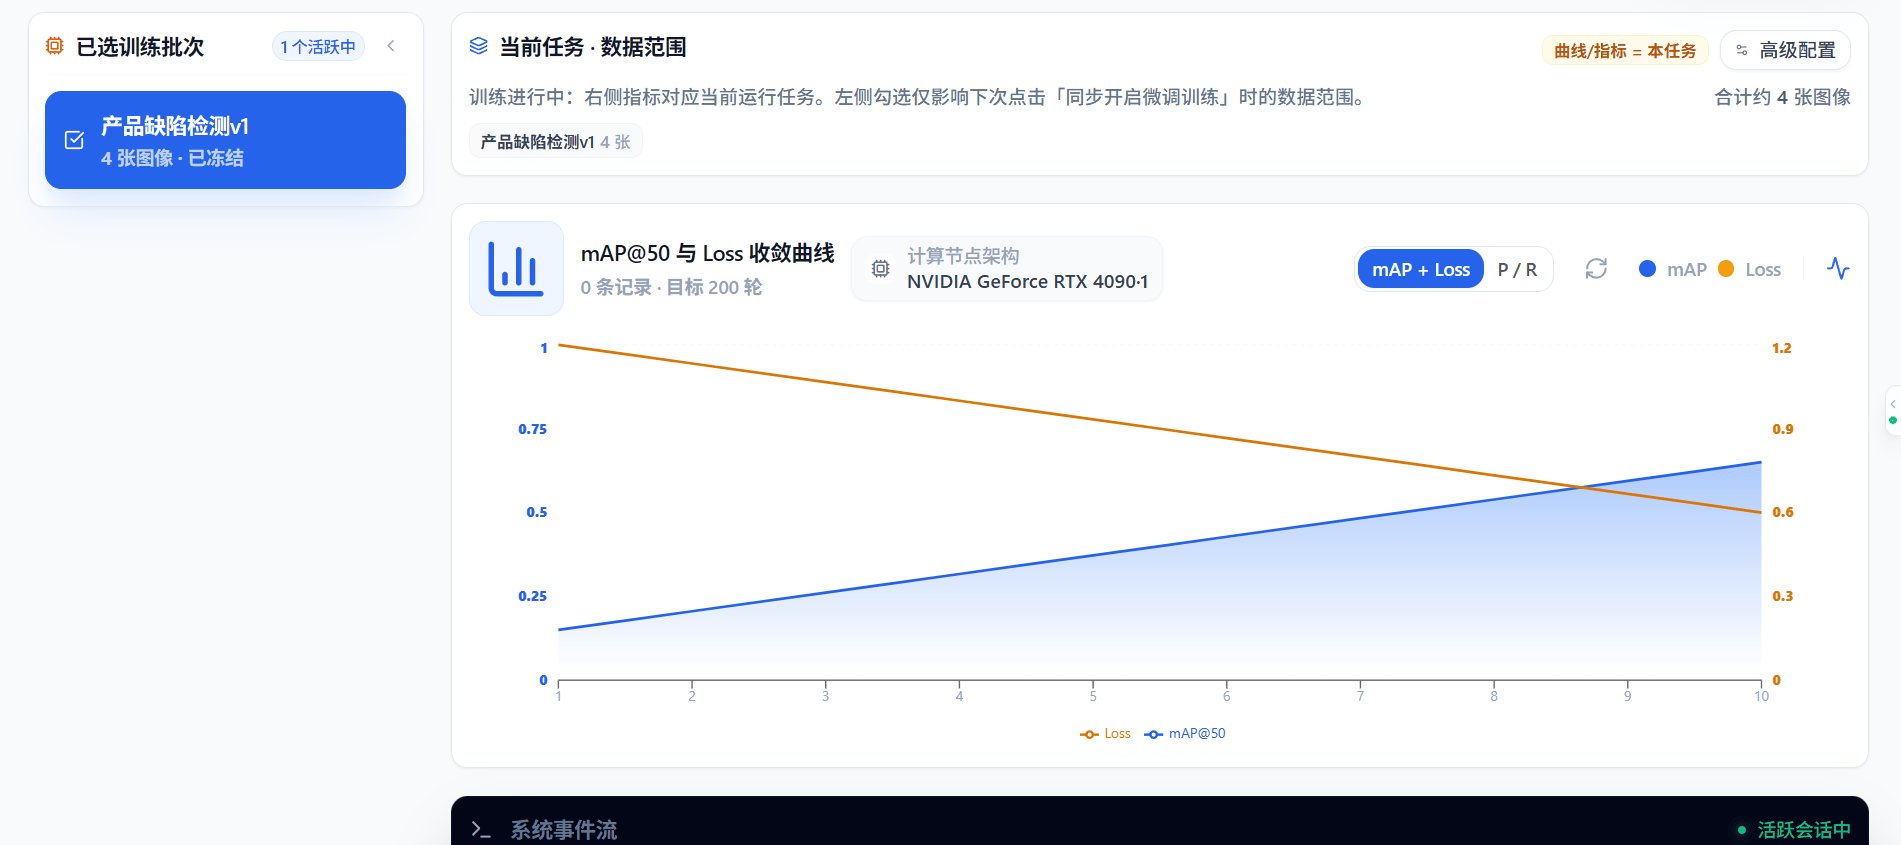
- 自动监控训练过程,在指标不再提升时及时停止,节省算力。
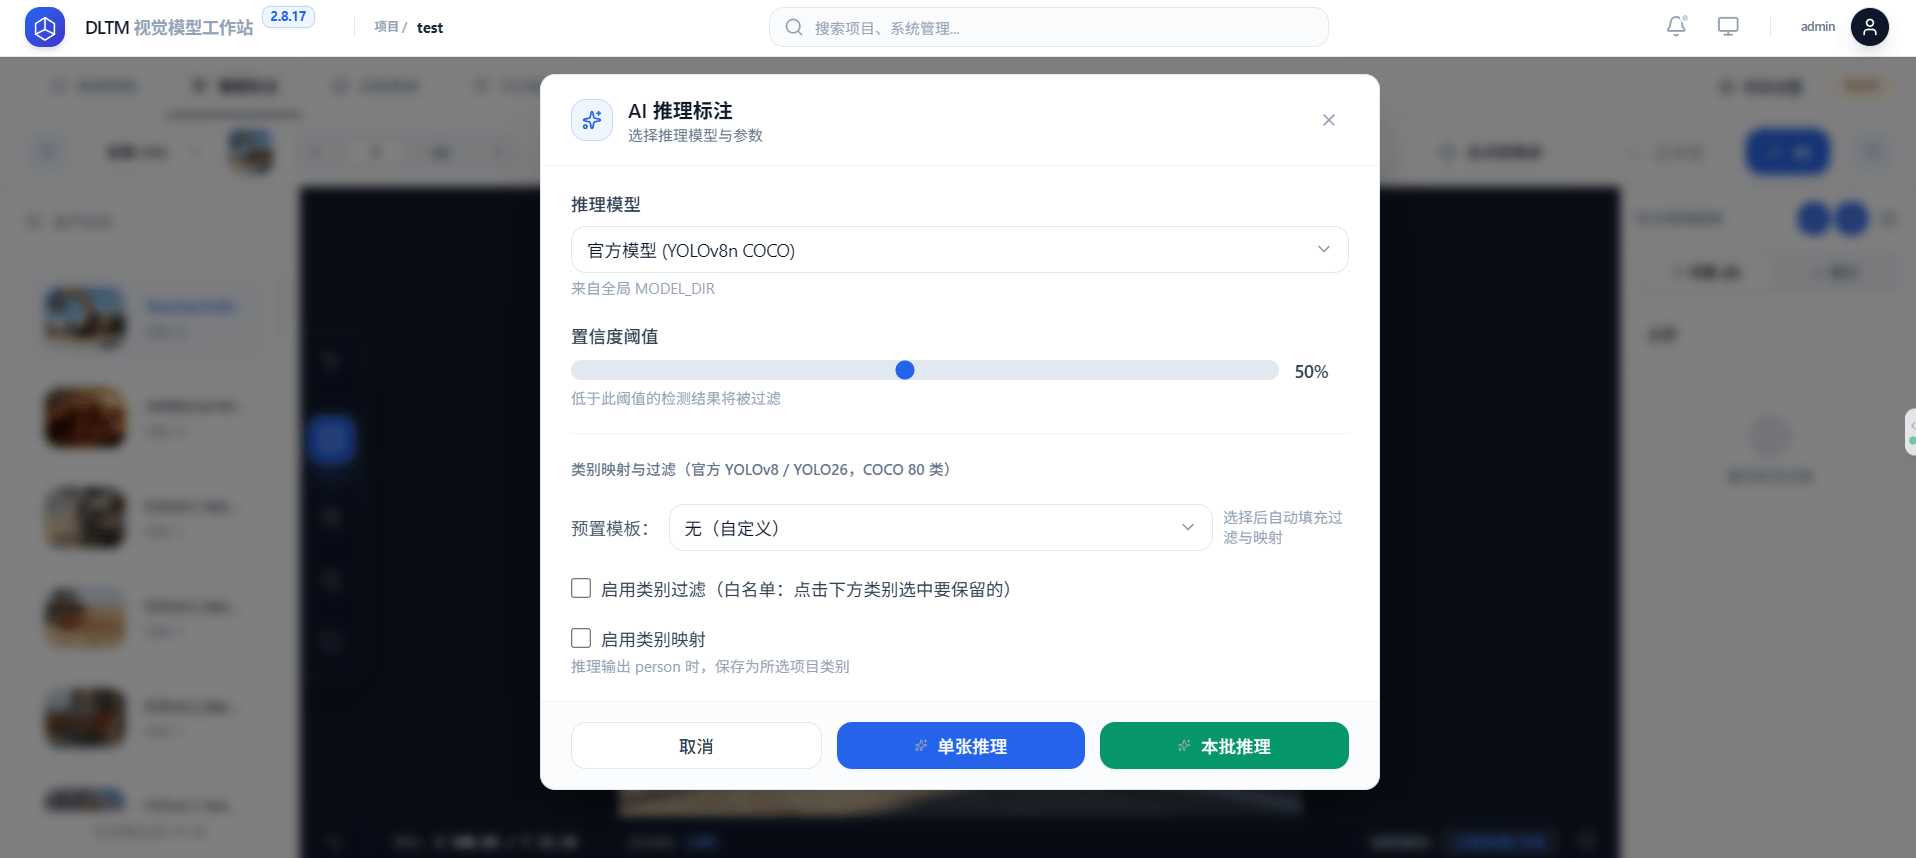
这些动作在深度学习推理工作站DLTM里被封装成后台流水线,用户看到的只是“任务已提交、结果已生成”。
三、零代码界面长什么样:三步走完训练
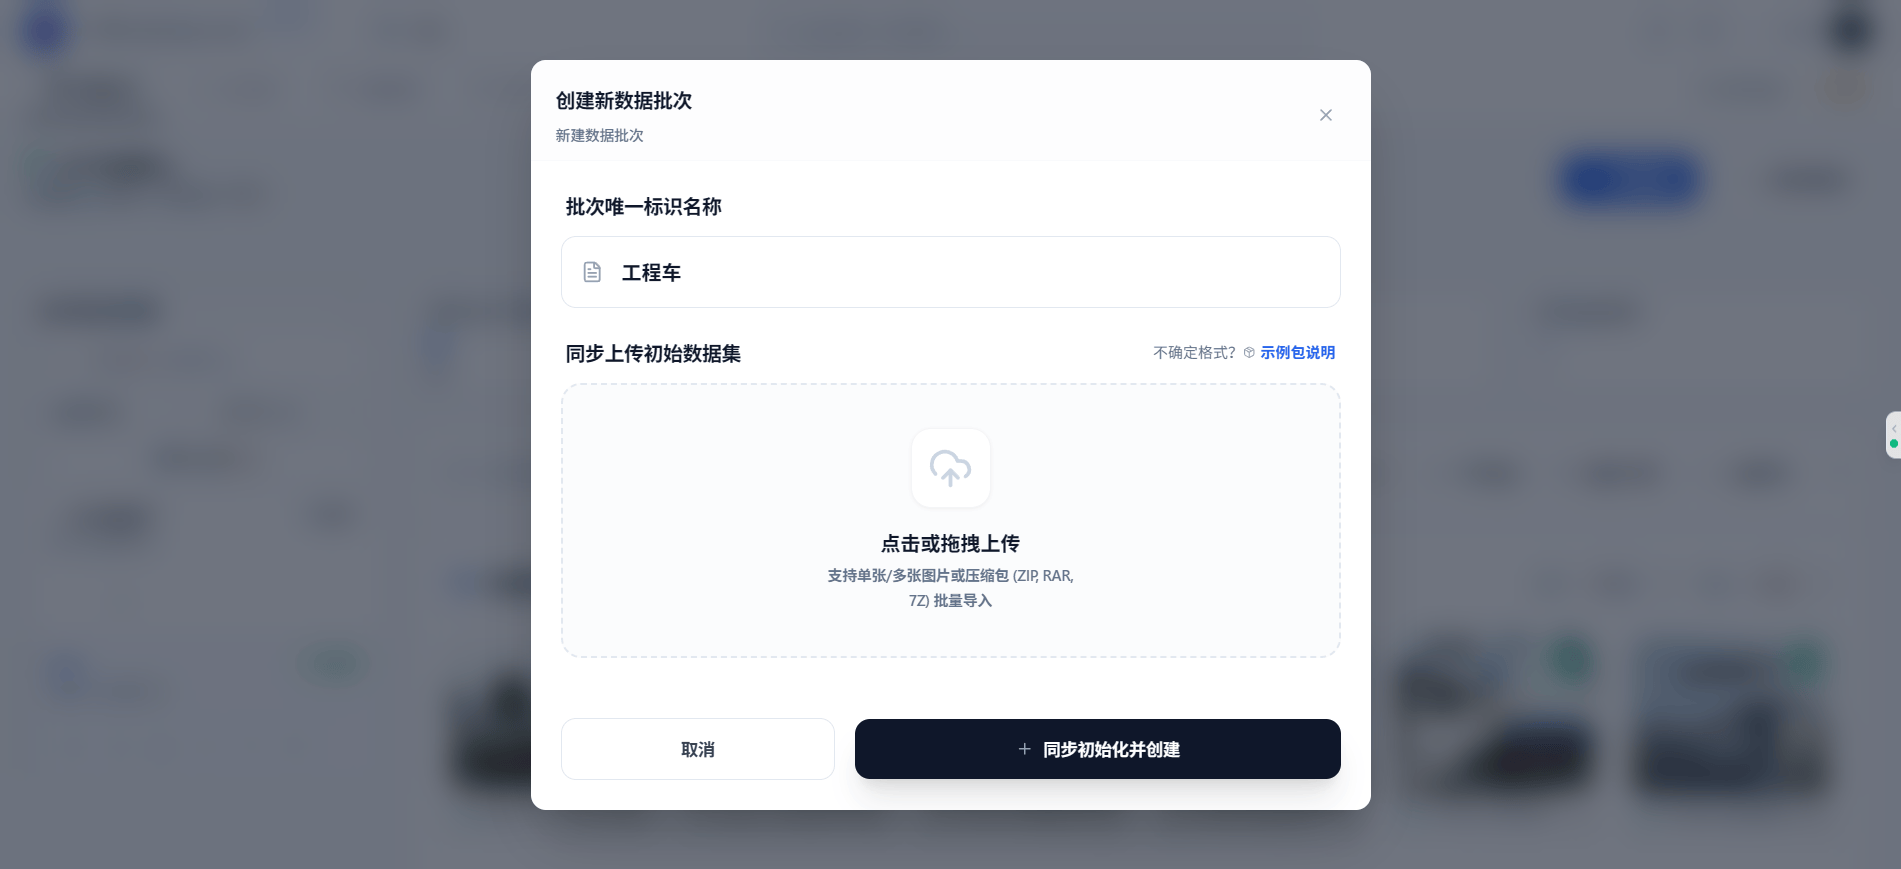
在企业私有化AI部署方案DLTM的零代码界面里,训练通常被简化成三步。
- 第一步,上传数据;
- 第二步,选择任务类型(如分类、检测等);
- 第三步,点击启动,系统在后台完成训练并给出可对比的结果。
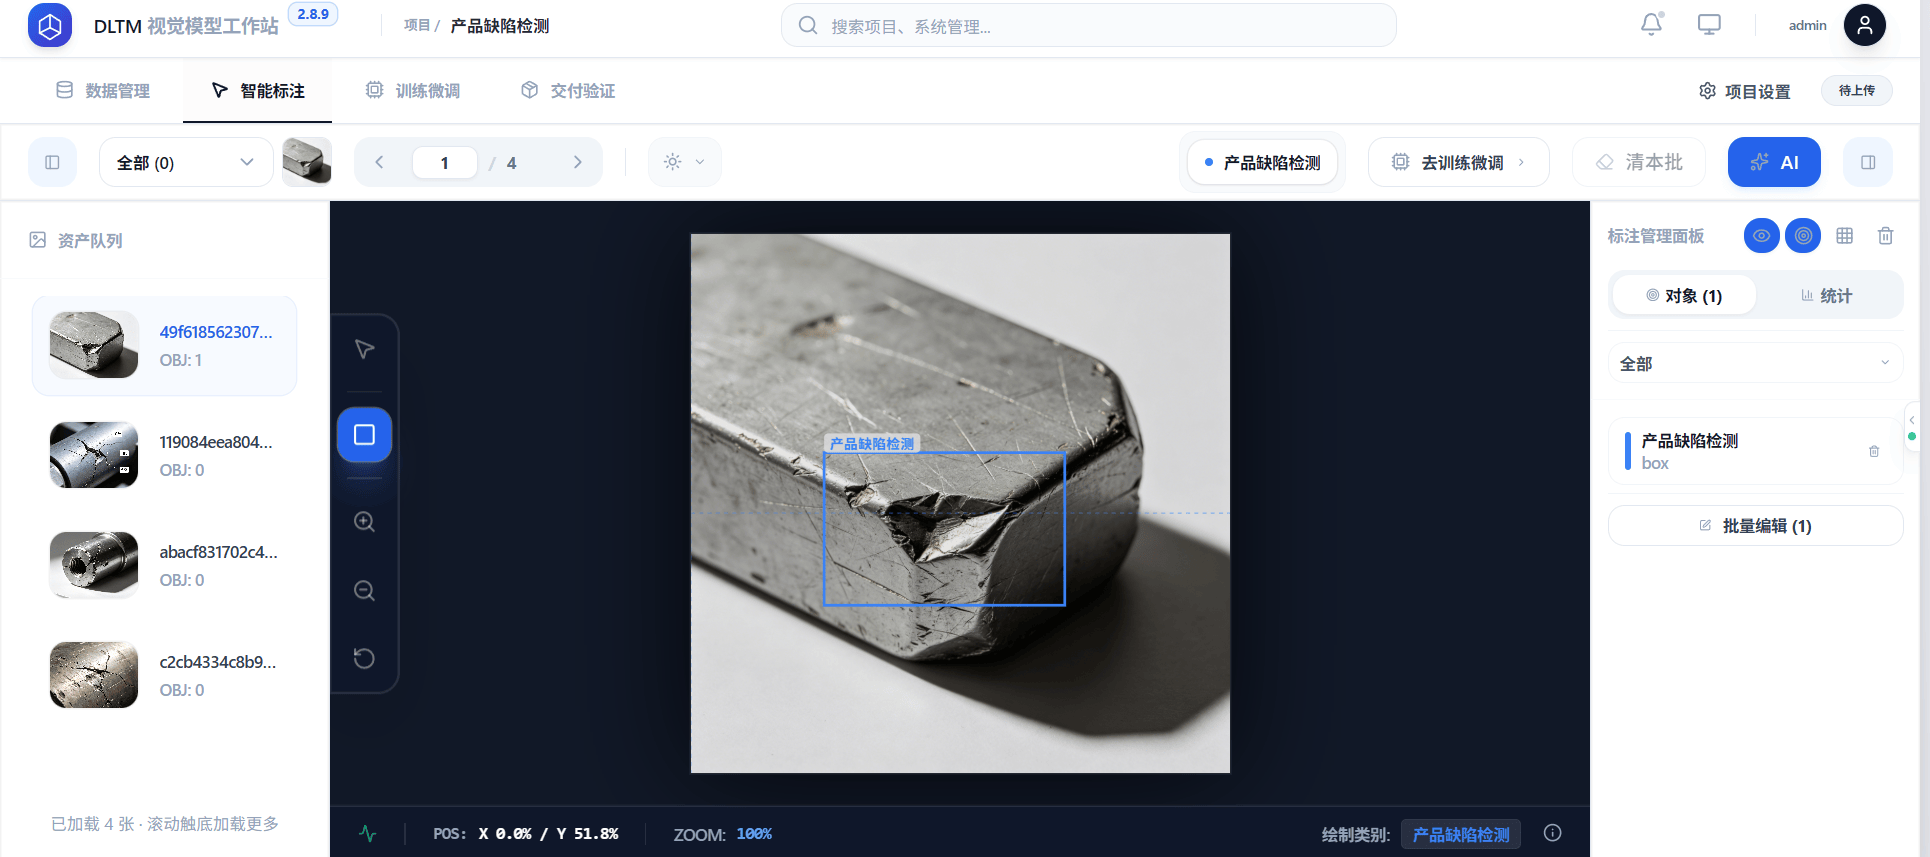
整个过程不需要用户写一行代码,也不要求理解反向传播或损失函数。对业务人员来说,这更像是在配置一个“智能工具”,而不是在做算法研究。
四、哪些团队最适合用自动训练
最受益的往往是“有数据、有需求、但没有算法人手”的团队。比如产线希望用视觉模型挑出不良品,行政希望用模型自动归类公文,门店希望用模型识别客流特征——这些场景数据就在手边,问题也很明确,缺的只是把数据变成模型的能力。自动训练把这部分能力产品化,让业务团队可以自己闭环,而不必每次都排队等IT或算法部门排期。
五、上线前,你仍需想清楚的几件事
零代码降低了技术门槛,但没有降低“想清楚问题”的门槛。训练前仍需明确:你的目标是什么指标,数据是否覆盖真实场景,标注是否足够可信。
私有化本地化AI模型训推工作站DLTM自动训练能帮你更快试错,但不能替你定义业务目标。把工具当加速器,而不是许愿机,才能真正让它产生价值。
结尾
自动训练的价值,不在于取代算法工程师,而在于把AI能力从少数人的手里,交到更多业务团队手里。当“训练模型”不再意味着写代码,AI落地的速度,才真正有可能追上业务变化的速度。

 浙公网安备 33010602011771号