
训完还要再部署?自动化AI算法训练服务器DLTM训推一体化闭环,让模型从训练到上线不再“断档”
企业花大力气训出一个模型,却卡在“怎么用起来”,是最常见的落地尴尬。训练在一套工具里完成,部署要另接推理服务,导出格式对不上、接口接不通,模型躺在服务器里出不了业务价值。企业级AI模型工作站DLTM用训推一体化闭环,把“训练完成”到“业务调用”之间的断档彻底抹平。
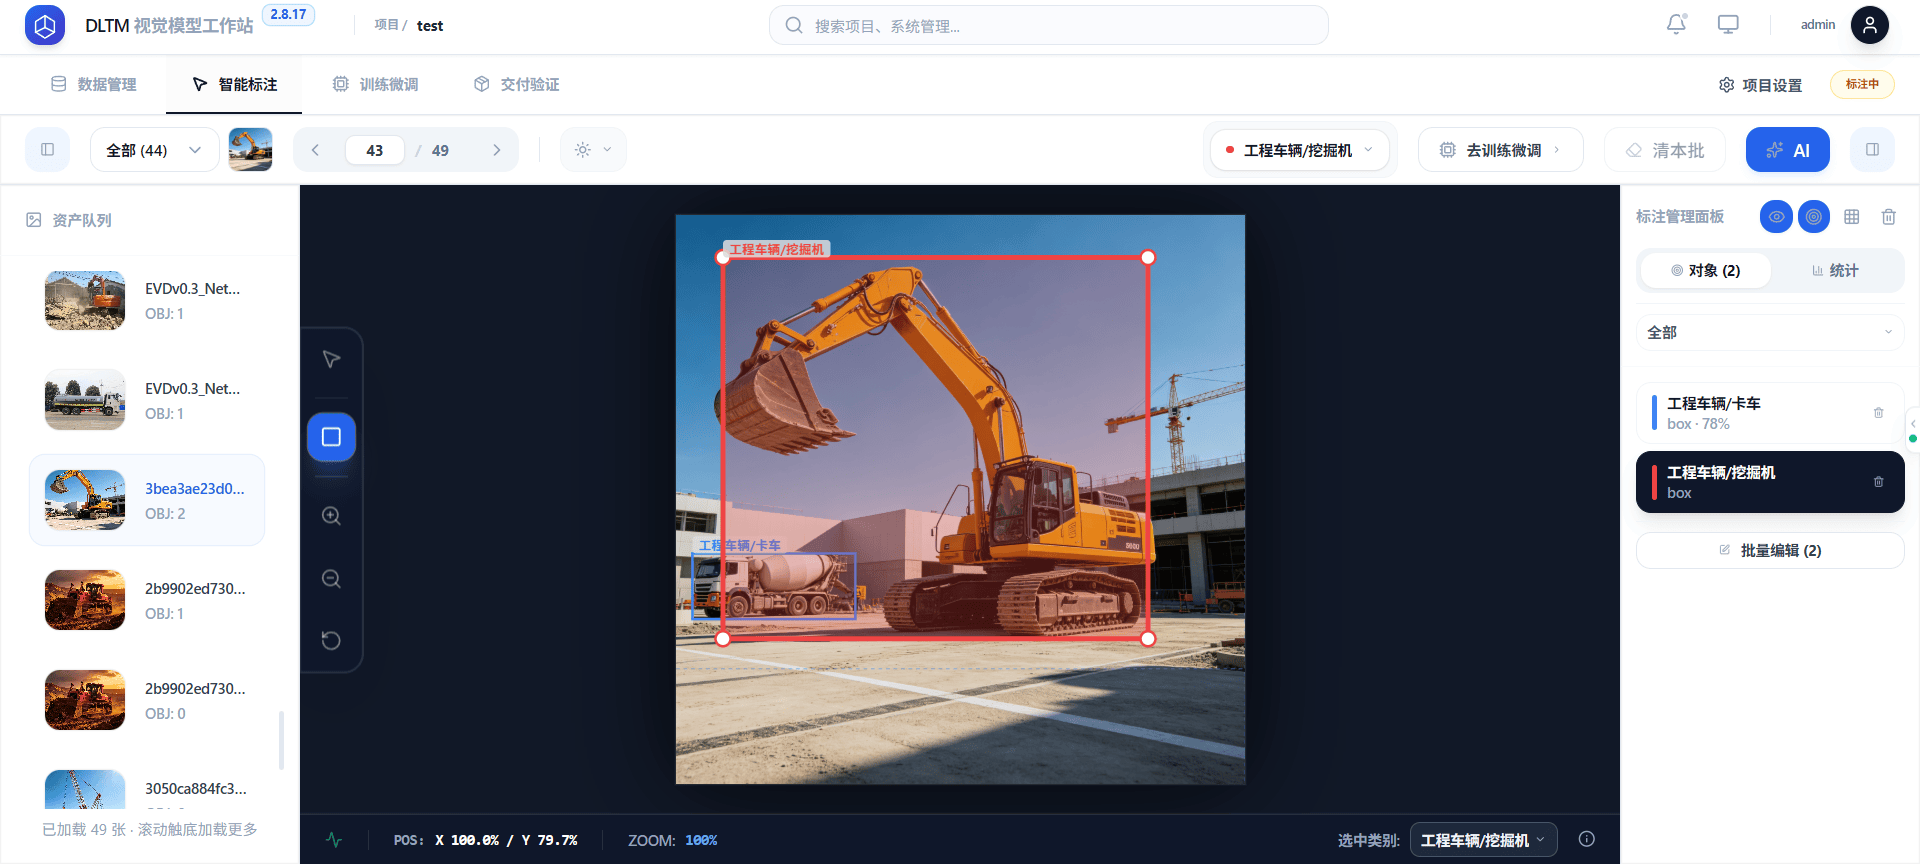
一、工具碎片化:训练到落地的“断崖”
传统AI开发里,数据存储、标注工具、训练框架、推理服务是四套独立软件,文件格式转换、数据迁移耗费大量人力。据行业实践估算,这类环节切换成本往往占到整个项目周期的30%—50%。
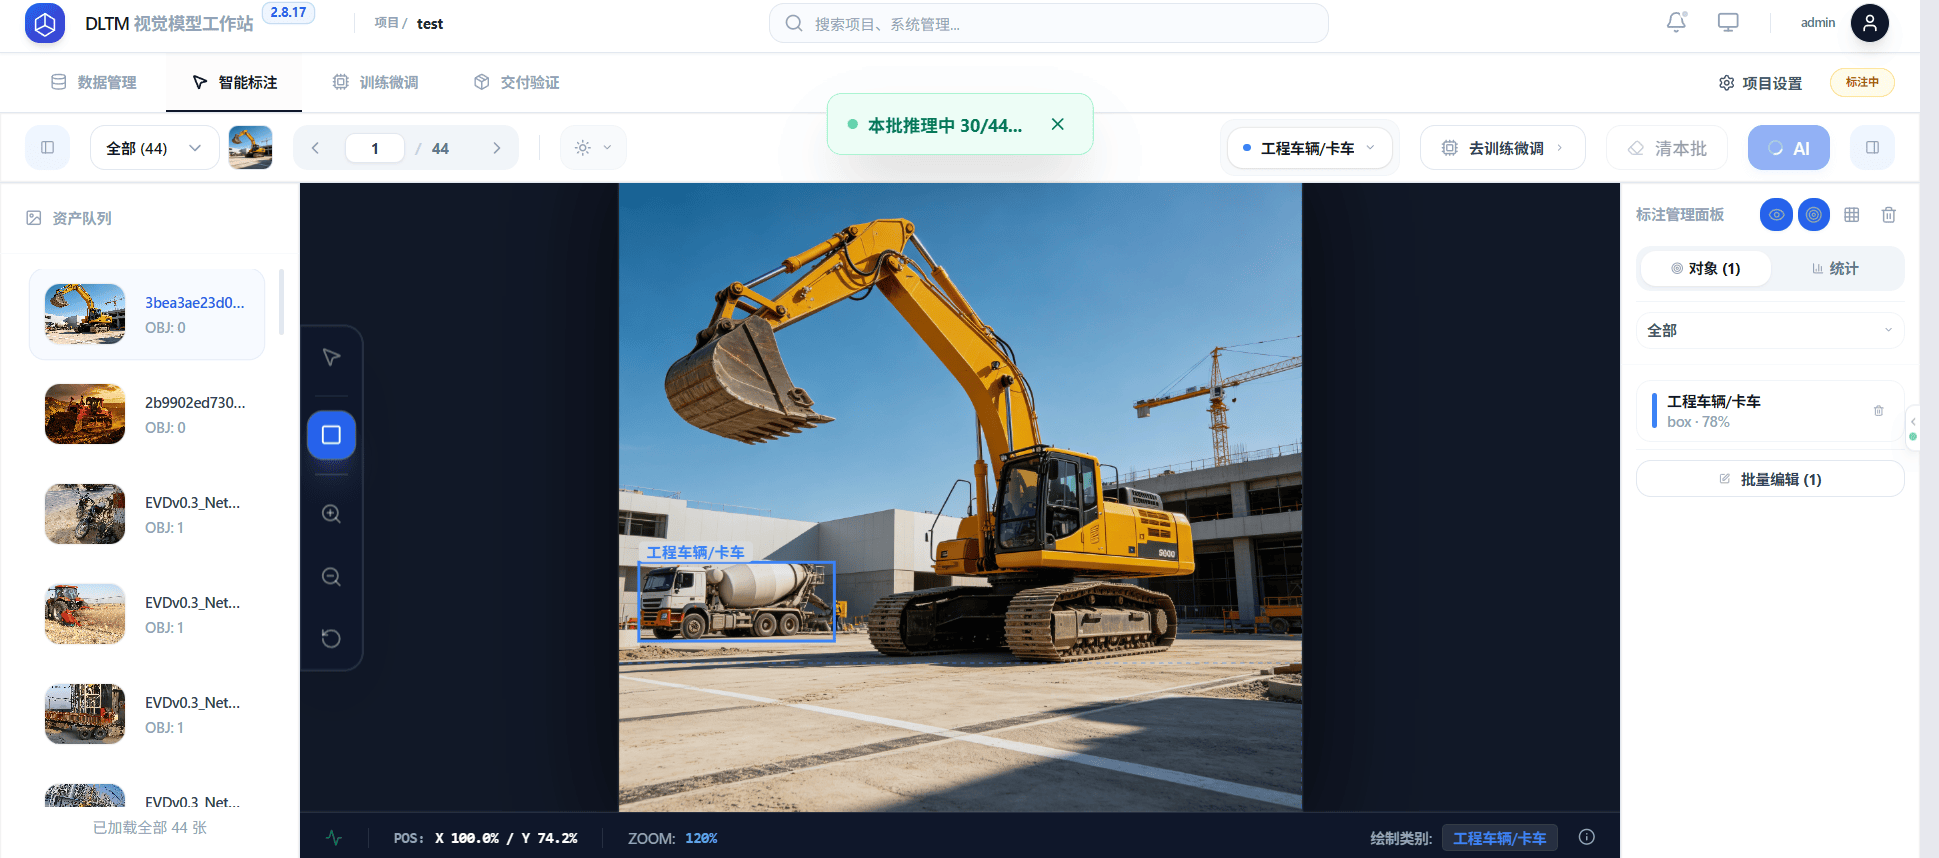
训练团队交出的模型文件,到了部署环节还要重新适配环境、改写调用逻辑,原本几天的活常常被拖成几周,模型还没上线业务场景可能已经变了两轮,投入打了折扣。
二、DLTM训推闭环:训练完直接测、直接导
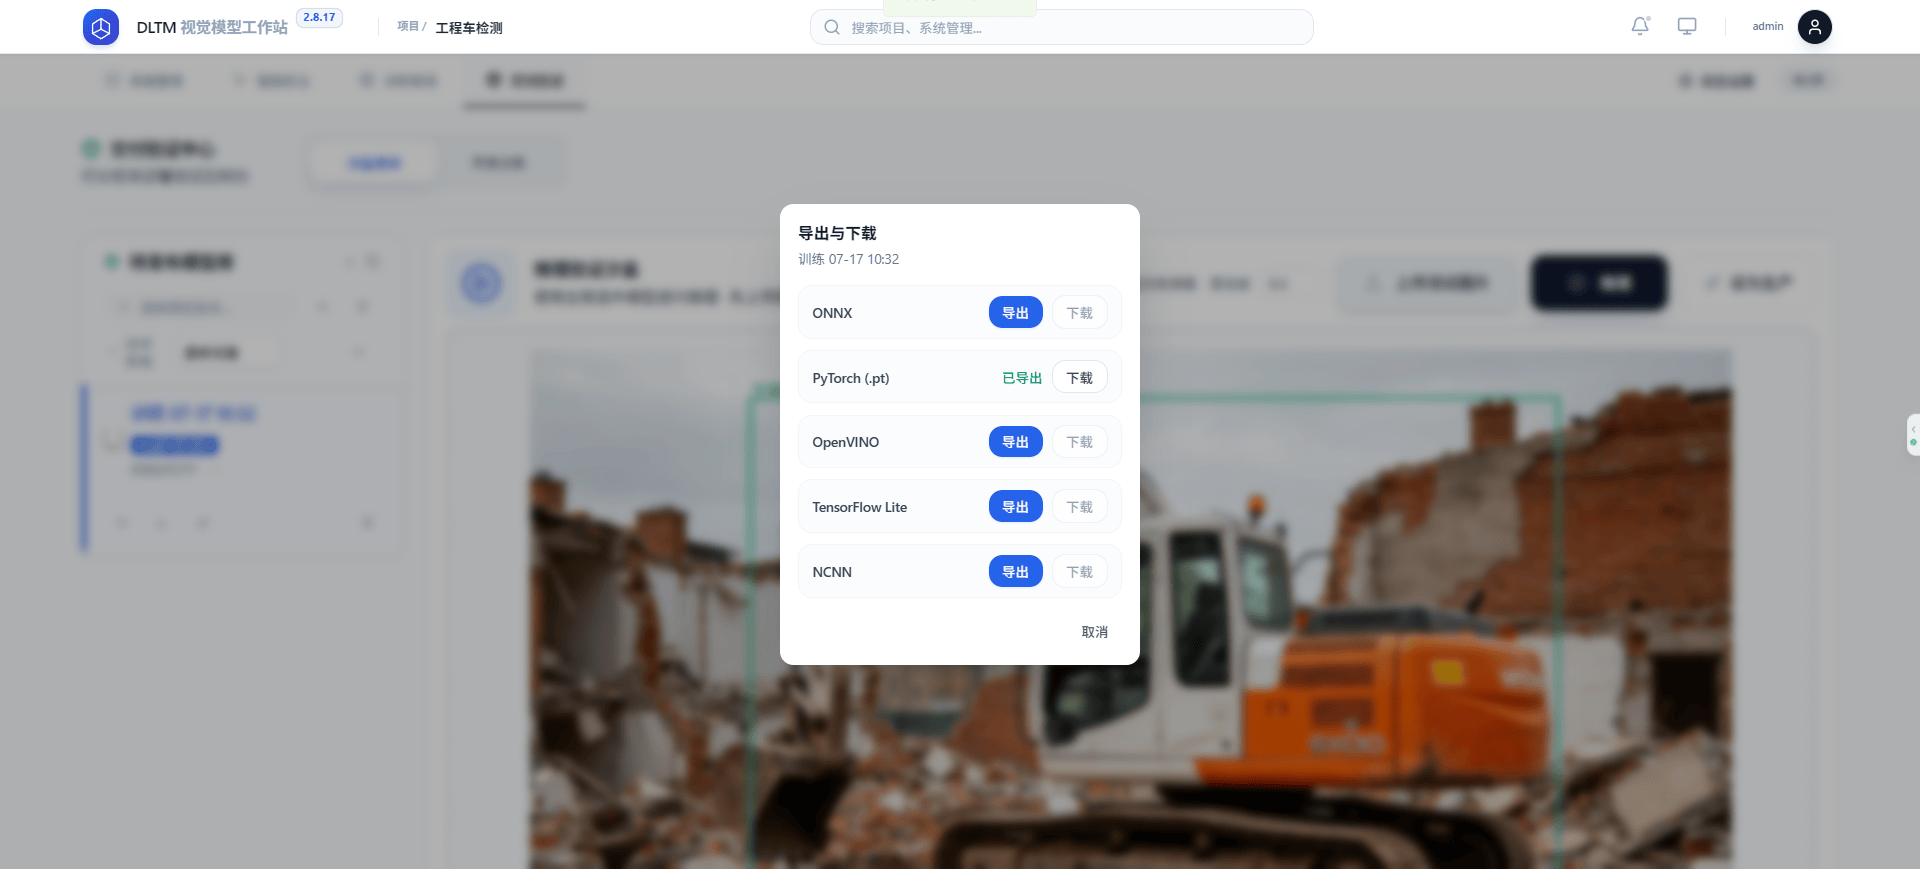
AI大模型训练工作站DLTM整合六大核心功能模块,打通从数据采集、智能标注、模型训练、推理测试到业务系统对接的全链路。训练完成后,用户可在线批量测试推理效果,确认识别准确率达标后,直接导出ONNX、PyTorch等通用模型文件。
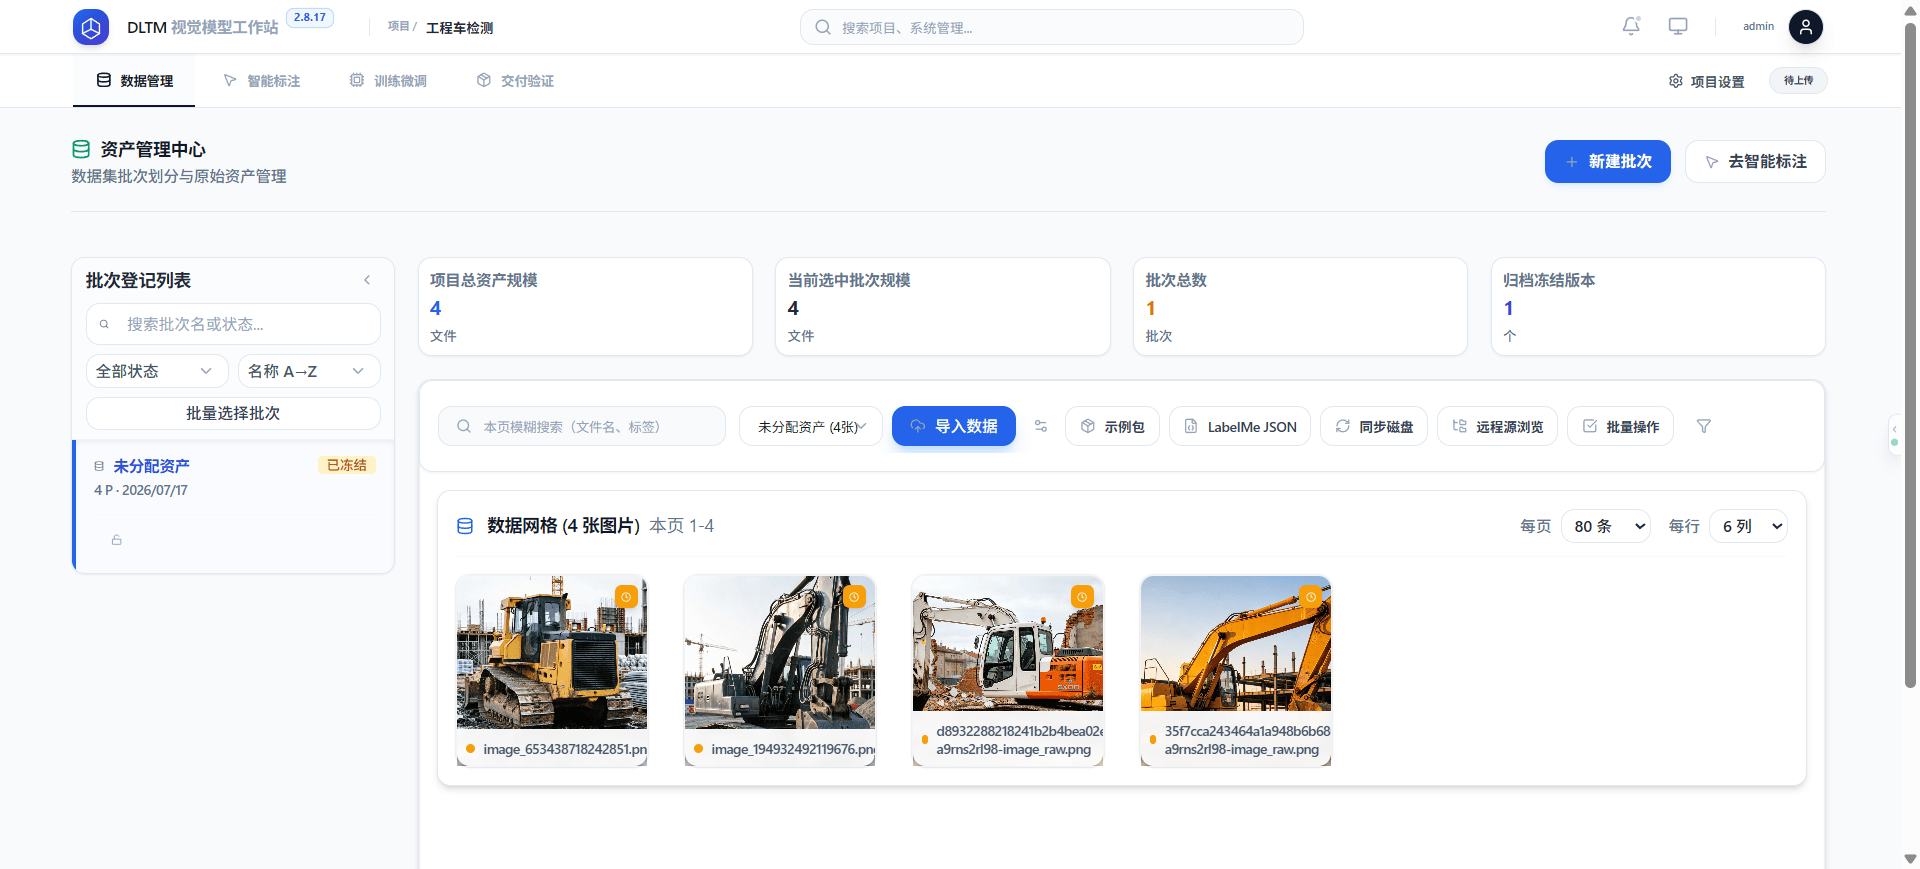
整套流程无需跨软件导出导入,模型在同一个平台内完成“训练—验证—导出”的闭环,交付周期被大幅压缩,业务人员当天就能看到模型跑在测试集上的效果。
三、多格式导出+开放API,对接现有系统
本地大模型推理服务器DLTM训练完成的模型支持ONNX、PyTorch多格式文件导出,并依托平台开放API接口,可无缝对接产线设备、安防监控、MES、ERP等现有信息化系统。
- 以制造业为例,训好的产品缺陷识别模型可部署到生产线,实现7×24小时自动检测,将人工质检成本降低80%以上;
- 安防场景里则可直连视频监控系统,把识别能力嵌入既有业务流程,无需对现有系统做大规模改造,落地阻力小。
四、算力智能调度,训推共用不打架
本地大模型推理服务器DLTM搭载算力智能调度机制,对硬件资源做统一编排。训练任务高峰时优先保障算力,推理调用时动态分配余量,避免训练占满显卡导致线上推理卡顿,也防止推理空闲时显卡空转。训推在同一个底座上协同,资源利用率进一步优化,保障项目持续高效迭代,不必为训练和推理各买一套机器,整体拥有成本明显更优。
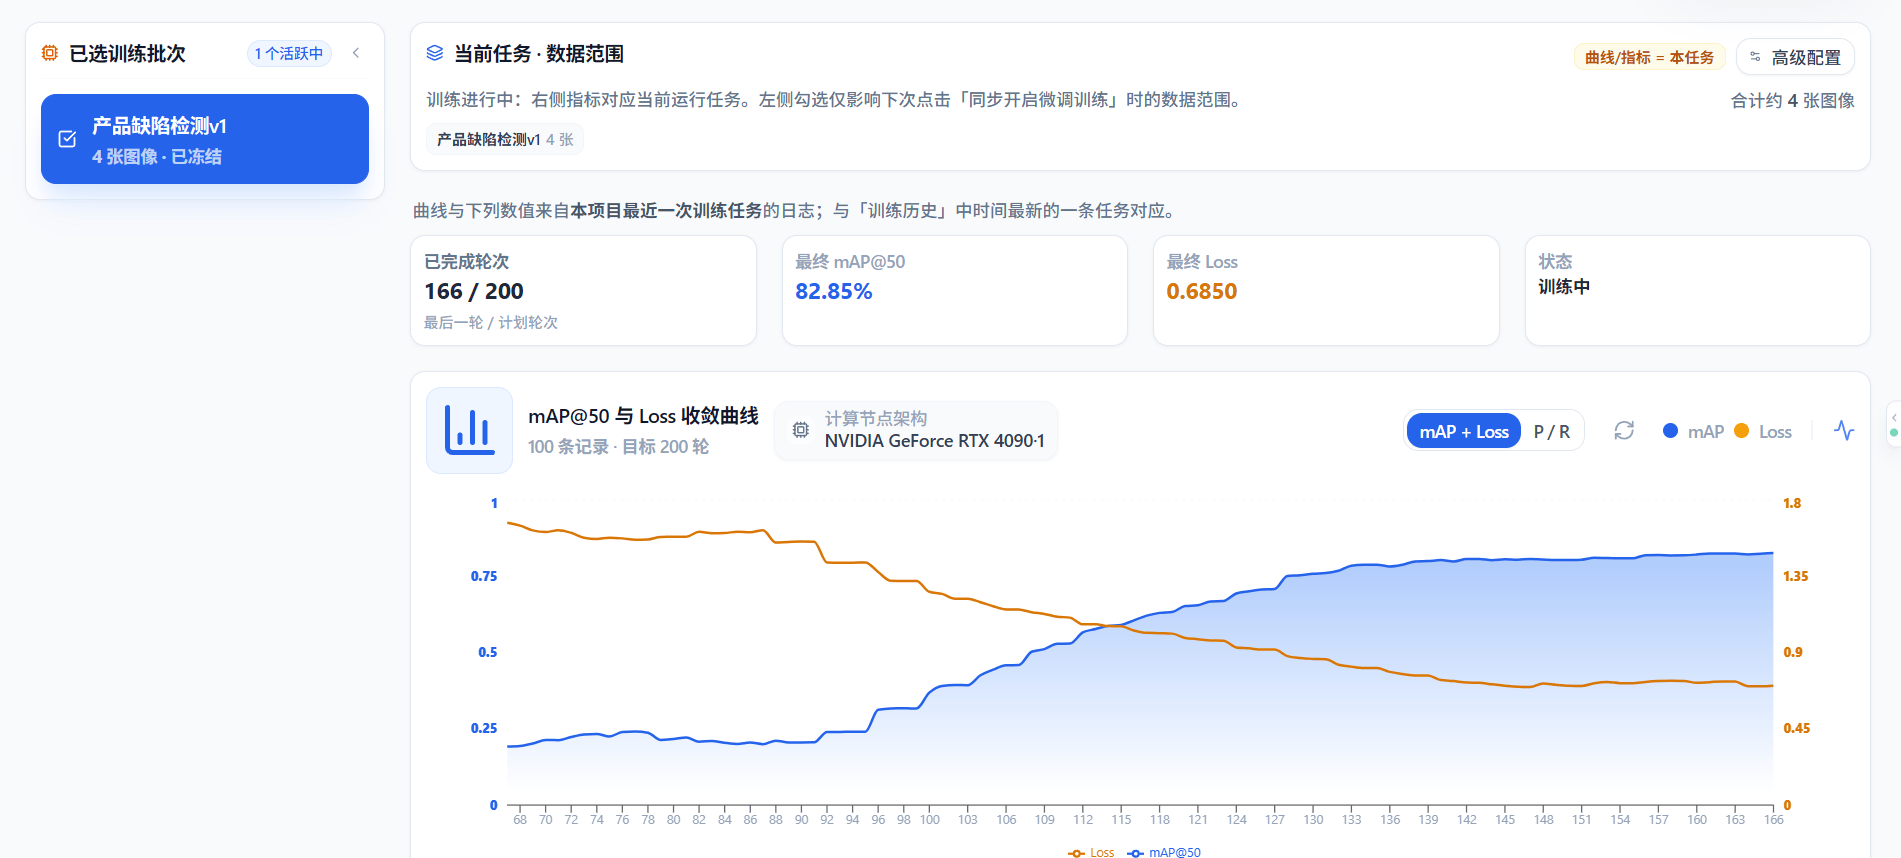
五、在线推理测试:上线前先看清效果
私有化本地化AI模型训推工作站DLTM不只在训练后导出模型,更提供在线批量推理测试。用户上传一批真实业务图片,平台即时返回识别结果,准确率、漏检与误检一目了然,确认达标再正式部署。
这一步把“模型好不好”从上线后的惊吓,提前到上线前的验证,避免把未达标模型直接推到产线造成误判。对质检、安防这类容错率低的场景,先在平台内跑通测试集,是控制落地风险的关键一关,也让业务部门对模型效果心里有底再上线。
训推一体化不是把两个功能塞进一个界面,而是让训练和推理共享同一份数据、同一套资源、同一个闭环。自动化AI算法训练服务器DLTM做的,是让企业训出的每一个模型,都能以最低成本、最短路径,真正跑在业务现场,把训练投入转成看得见的生产力,而不是停在演示视频里。

 浙公网安备 33010602011771号