
为什么模型训练必须“数据不出门”?AI大模型训练工作站DLTM全离线训推一体,把AI实验室搬进企业内网
对制造、金融、医疗、能源这些行业来说,训练数据就是企业的核心资产:产线缺陷样本、客户交易特征、设备运行参数,任何一条泄露都可能带来巨大损失。
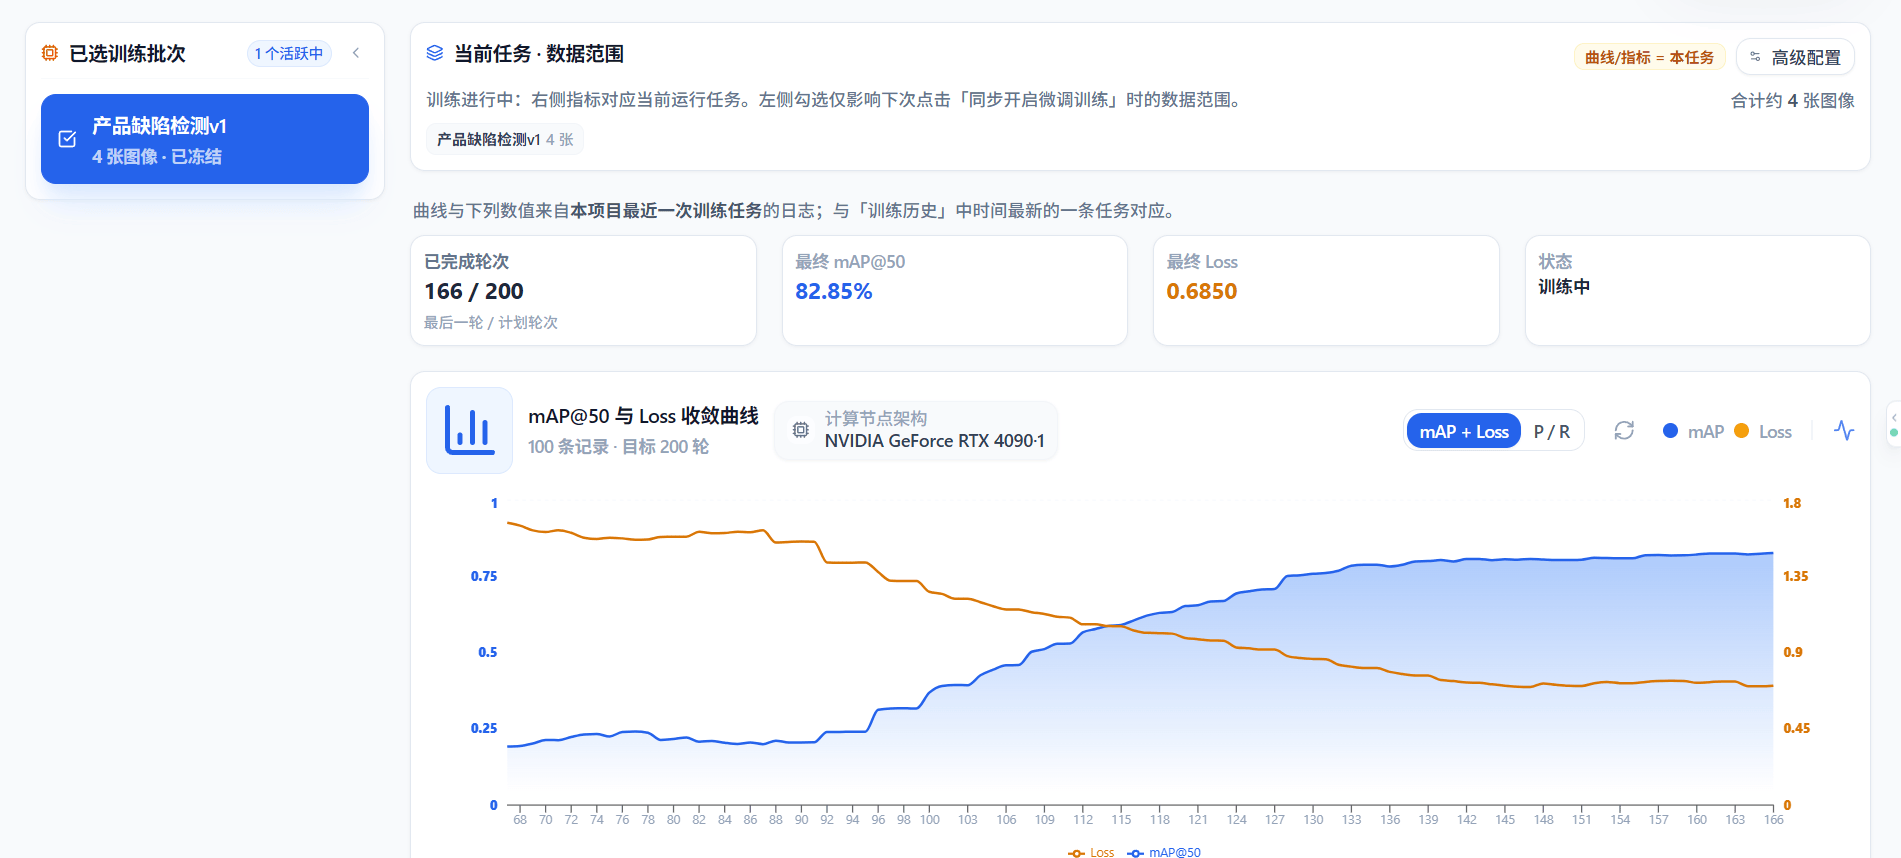
而传统AI训练普遍依赖云端算力,数据要上传、要流转、要经过第三方平台——模型还没训出来,风险已经先埋下了。企业私有化AI训练推理一体工作站DLTM给出的答案是:把整个AI实验室搬进企业内网,训练全程“数据不出门”。
第一关:训练数据全程内网闭环
自动化AI算法训练服务器DLTM采用本地私有化部署模式,搭建起数据采集、传输、存储、训练、访问全流程闭环的安全防护体系。
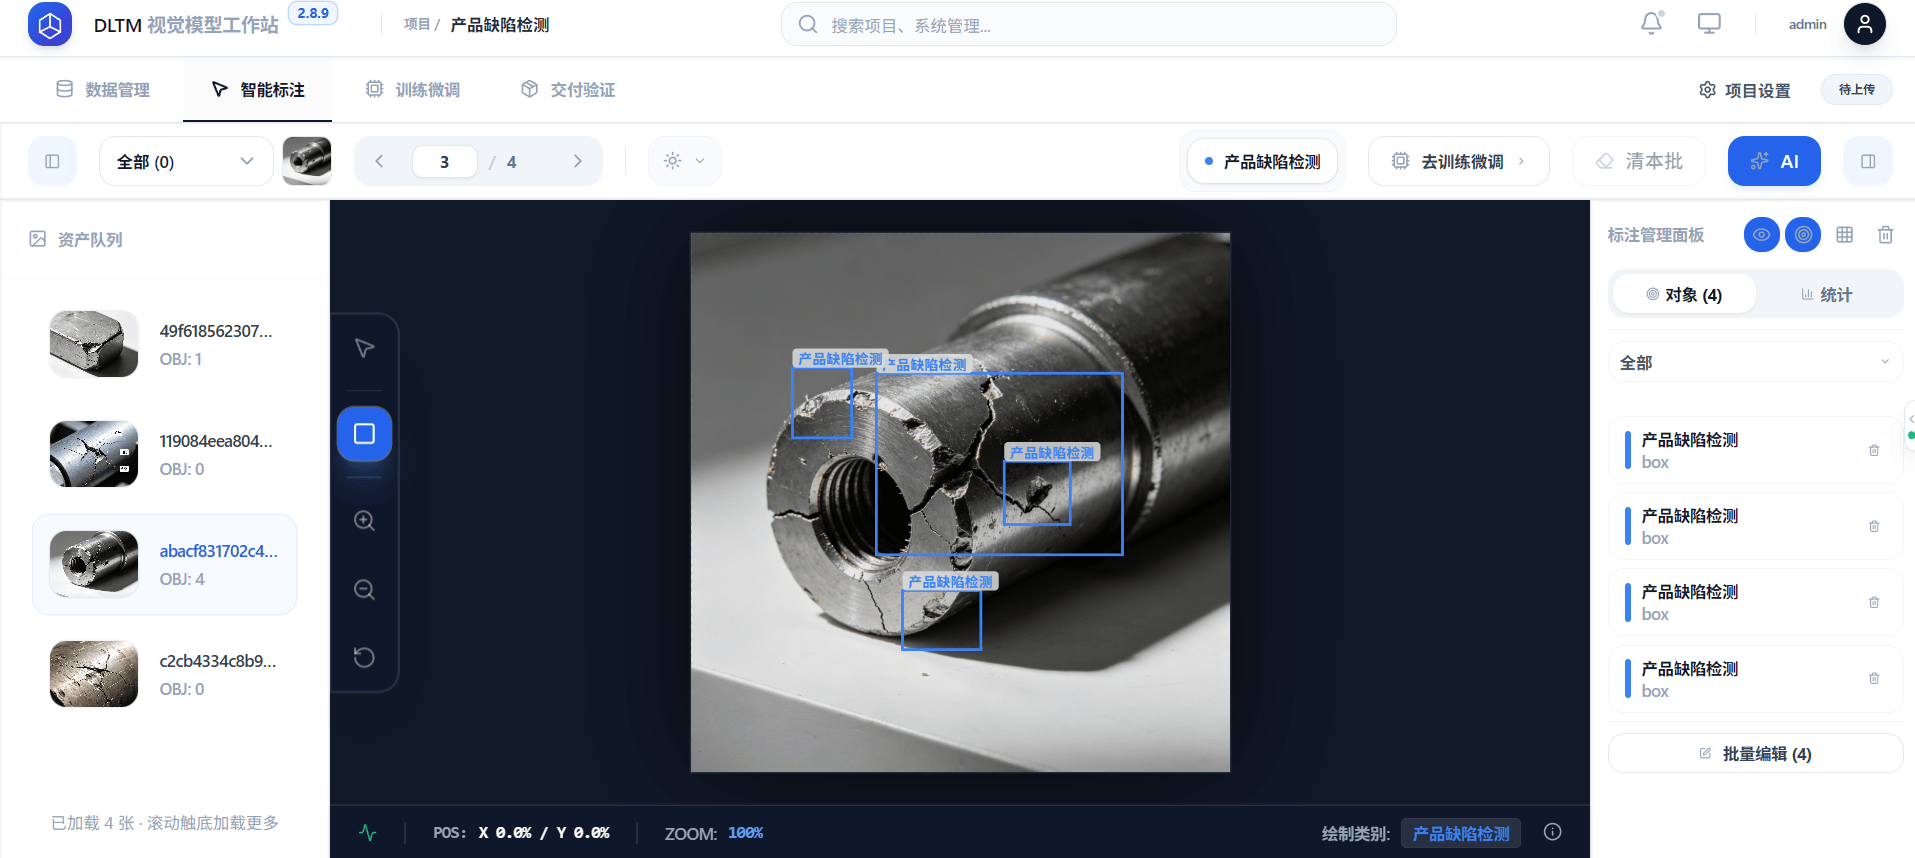
企业所有业务训练数据、自研AI模型文件、行业专属算法资料,全部留存于企业自有服务器之中,全程无需向外网流转,从源头斩断数据外泄渠道。数据在“家门口”训练,标注、调参、迭代全流程都在内网完成,安全性与可用性同时兼顾。
第二关:全离线也能训,断网照常跑
更关键的是,深度学习推理工作站DLTM支持完全离线独立运行。设备部署后即使脱离公网,也能完整开展数据标注、模型训练与推理应用,这对网络环境受限的工厂车间、偏远园区、涉密单位尤为重要。
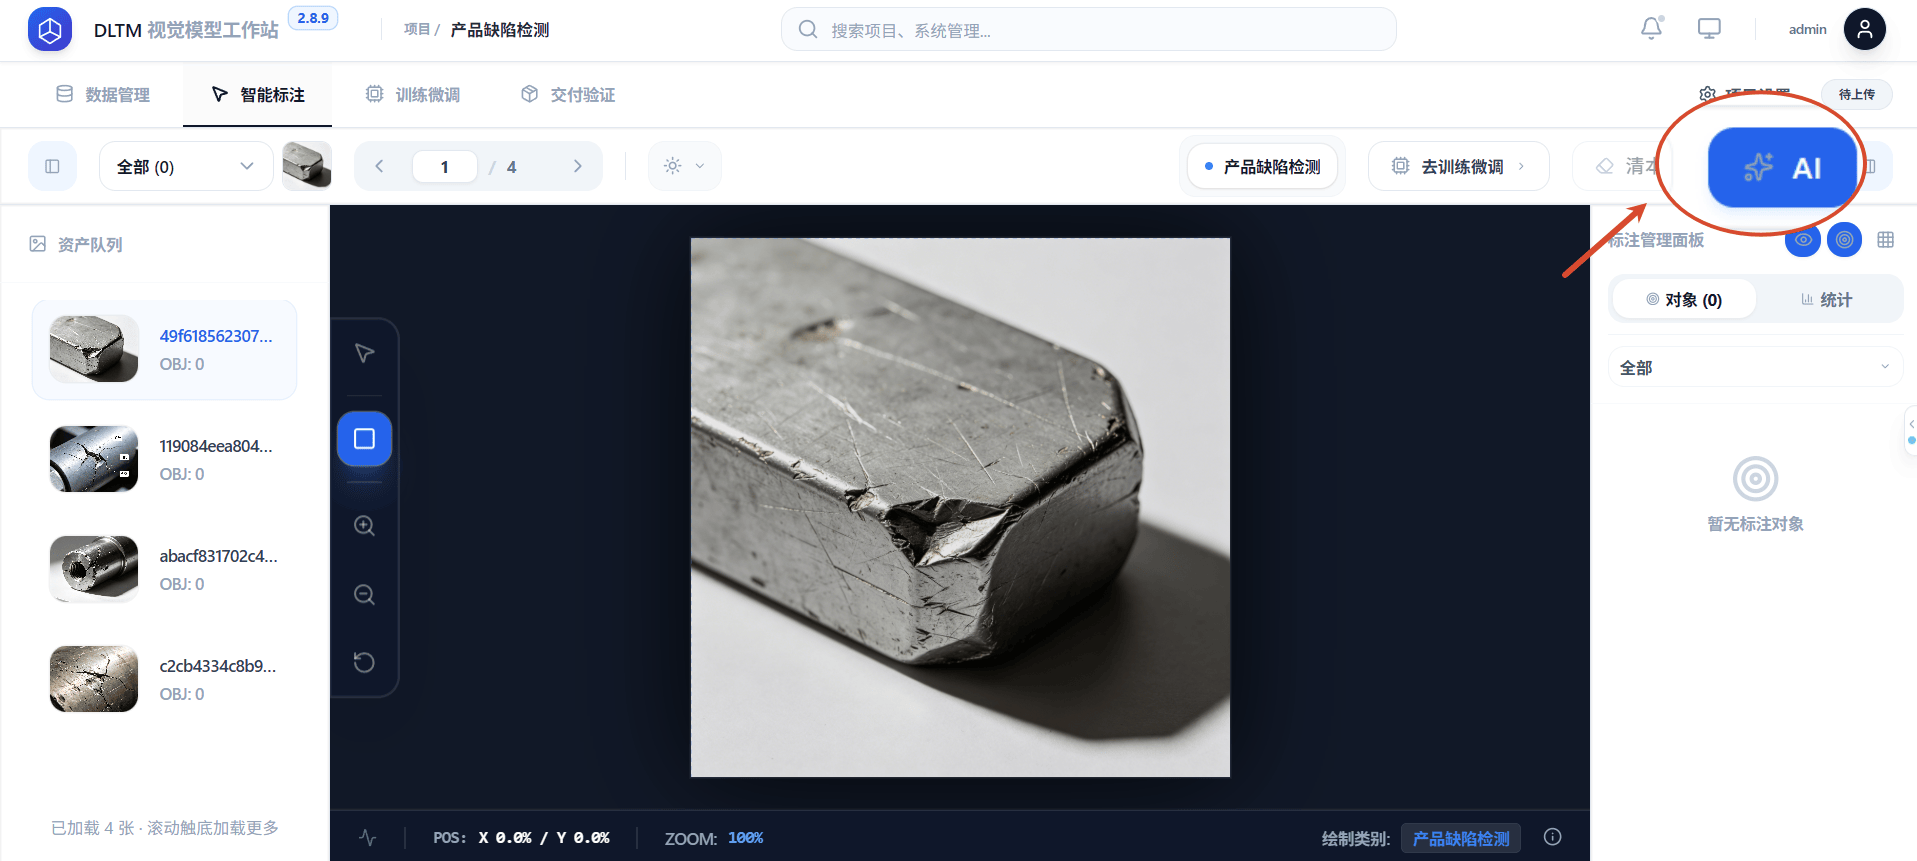
离线训练不依赖外部算力,也就意味着训练任务不会因网络波动、云服务波动而中断,企业掌握着训练的完全自主权。
第三关:部署不折腾,一键上线
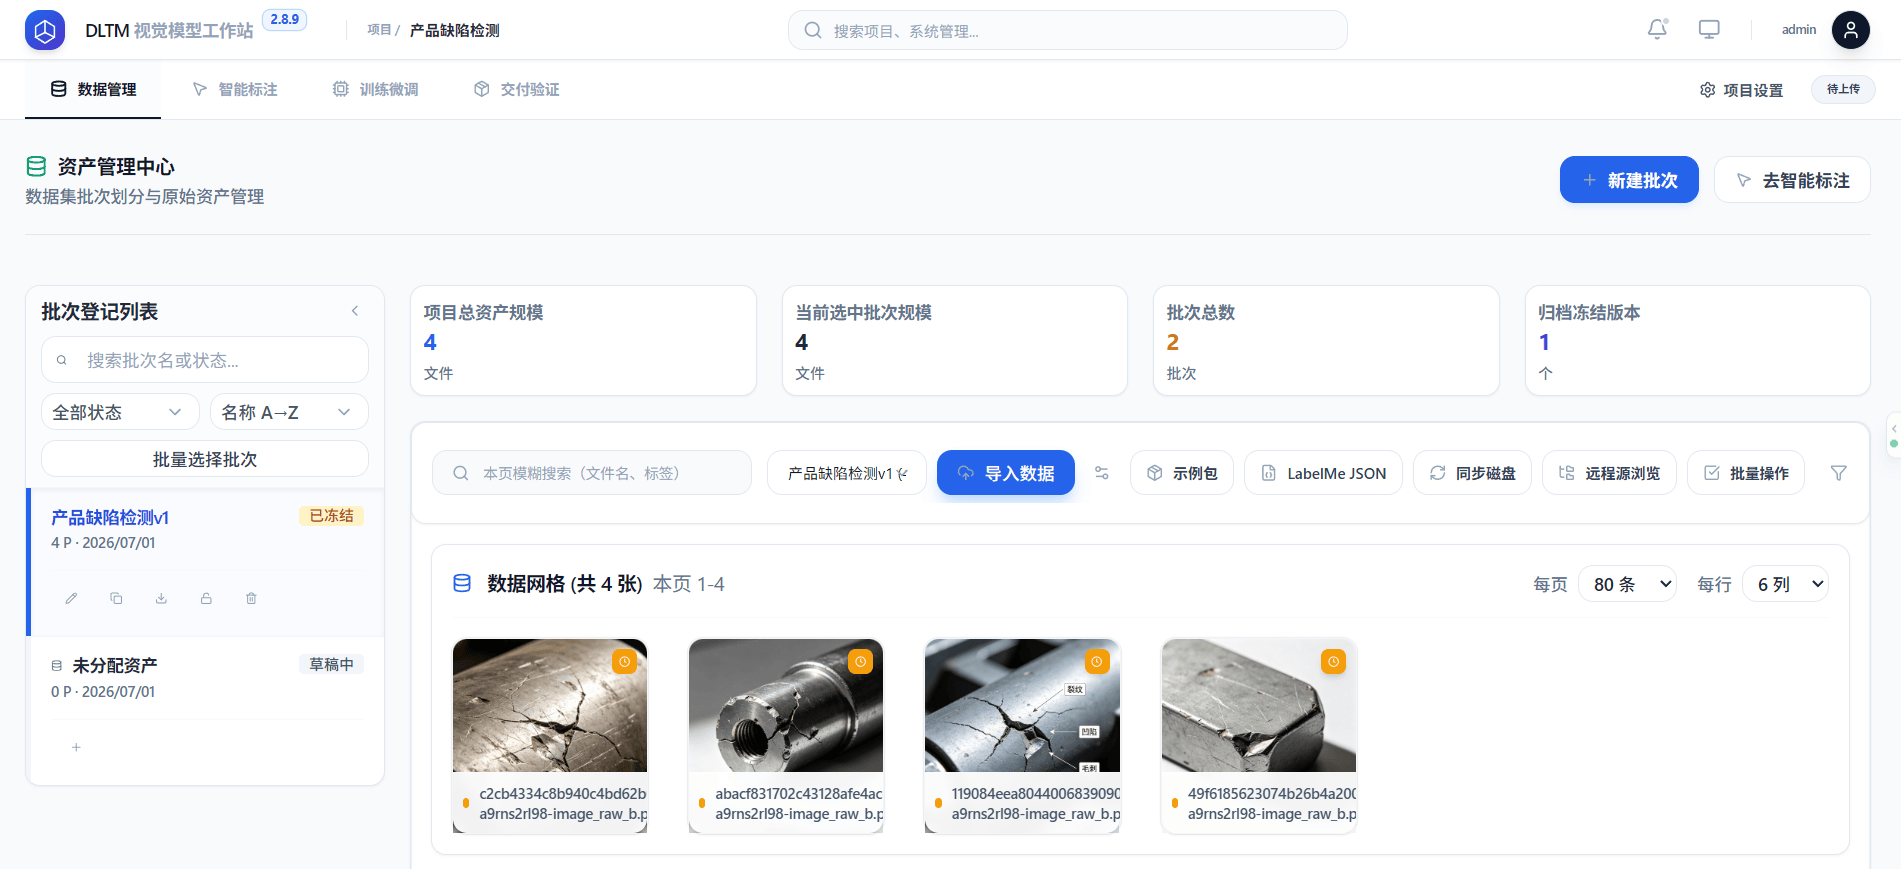
传统AI设备部署流程复杂、需专业IT运维团队支撑,而DLTM配备成熟的Docker一键部署脚本,可快速完成环境搭建与设备上线,普通技术人员即可完成安装配置。
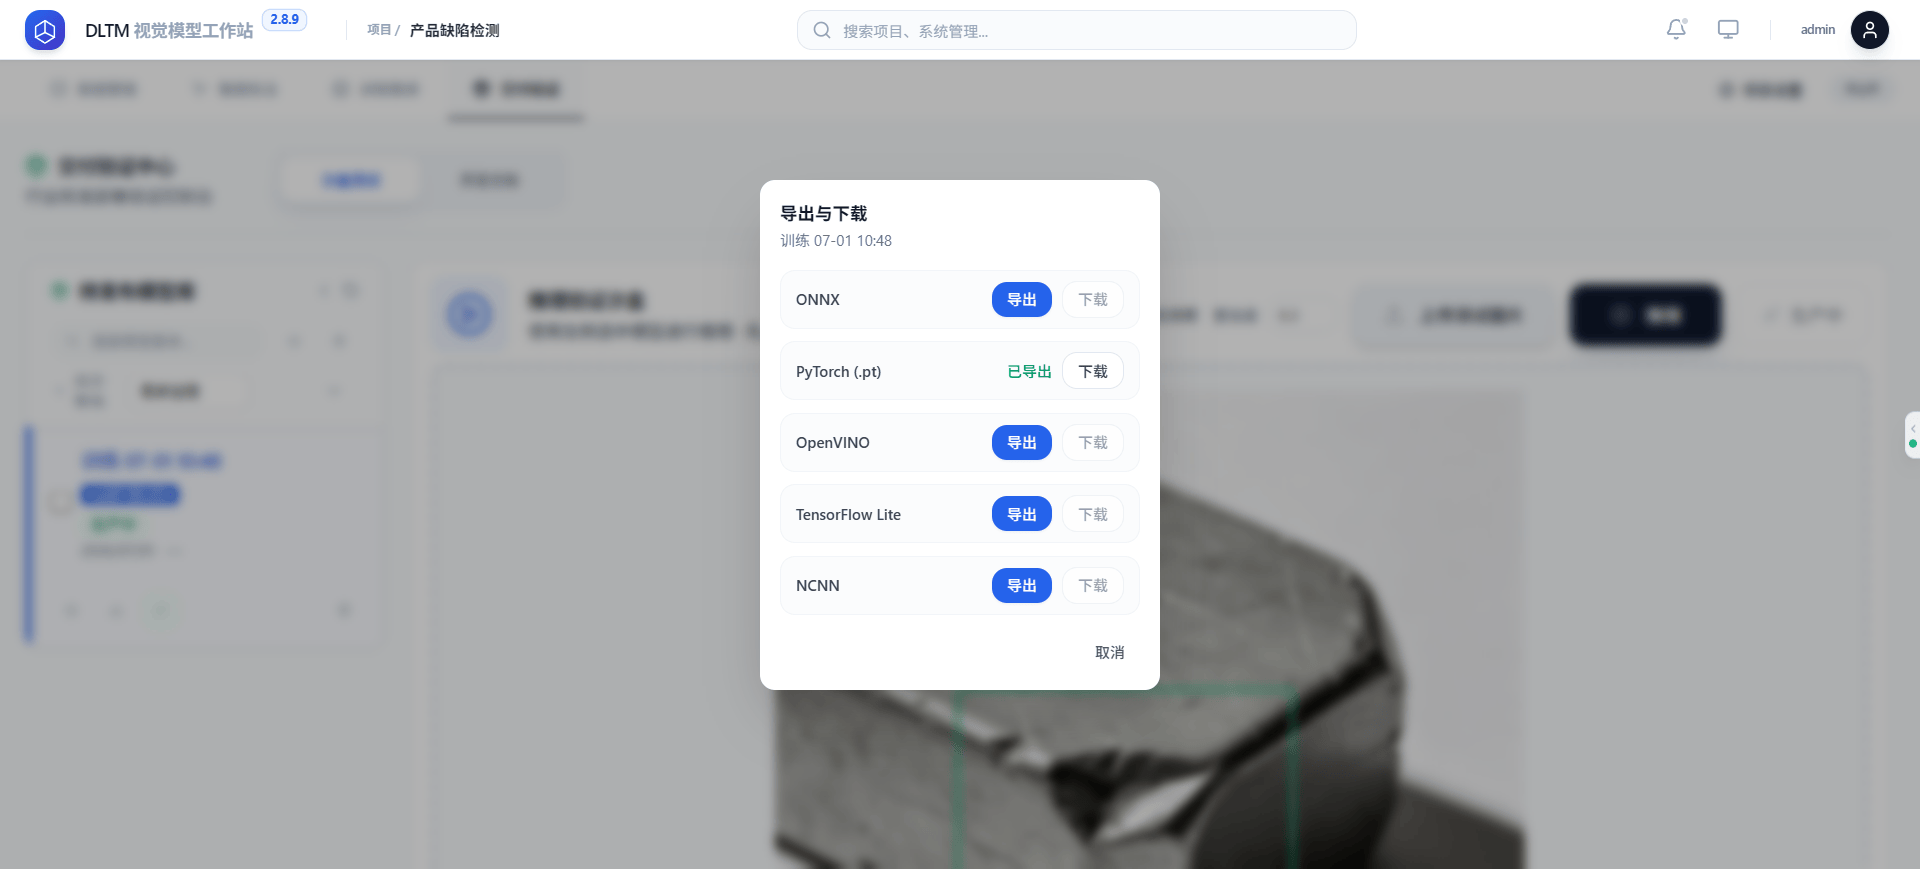
平台同时具备良好兼容性与拓展性:支持WebSocket实时通信,可无缝适配企业现有信息化架构;预留二次开发接口,满足个性化场景定制需求。从开箱到训出第一个模型,不再需要漫长的实施周期。
第四关:合规无忧,敏感行业敢用
对金融、能源、政务等强监管行业,数据合规是AI落地的硬门槛。AI模型私有化部署平台DLTM全本地化部署、数据全程内网闭环、不接入公有云的产品设计,从架构根源满足高保密场景要求。核心数据不出内网、训练过程自主可控,让“敢用AI”与“用得起AI”不再矛盾。
写在最后
安全,从来不该是放弃AI的理由。私有化本地化AI模型训推工作站DLTM用私有化部署+全离线训练,把数据主权牢牢留在企业手里——当训练不再依赖外部的云、外部的网、外部的人,企业才算真正拥有自己的AI能力。数据不出门,模型照样训得好,这才是敏感行业智能化最稳妥的打开方式。

 浙公网安备 33010602011771号