
不写代码也能看懂训练:DLTM可视化精度曲线与自动调参,把黑盒变白盒
传统AI训练像开盲盒:算法工程师敲一堆命令,业务人员只能等结果,至于模型训得怎么样、为什么准或不准,完全看不到。自动化AI算法训练服务器DLTM把训练做成“看得见的工程”——零代码可视化界面、精度曲线图表化、自动调参,让不懂反向传播的人也能判断训练好坏。本文讲清这套“白盒训练”怎么用。
一、零代码,业务人员自己当“算法工程师”
DLTM的核心优势之一是零代码。平台内置轻量化预训练基底,提供可视化标注与训练界面,企业内部运维、安保人员无需任何算法背景,也能自主完成模型搭建。工作人员针对自身场地需要监测的异常事件批量标注样本,平台自动完成训练与封装。六大产品优势(零代码、省人力、省时间、精度高、易操作、易部署)里,零代码是撬动其余五项的总开关。

DLTM由场景数据引擎、智能标注引擎、智能训练引擎、算法构建引擎四大引擎构成,训练只是其中一环。可视化训练让这环对业务人员透明,而非锁在算法团队手里——这也正是“易操作”优势落地的关键:训练不再是黑话堆砌,而是一张人人能看懂的曲线图。
二、精度曲线图表化:训练好坏一眼可见
私有化本地化AI模型训推工作站DLTM的智能训练引擎提供可视化训练,精度曲线图表化,训练结果可实时查看。业务人员不需要写一行Python,也能从曲线看出模型是否在收敛。
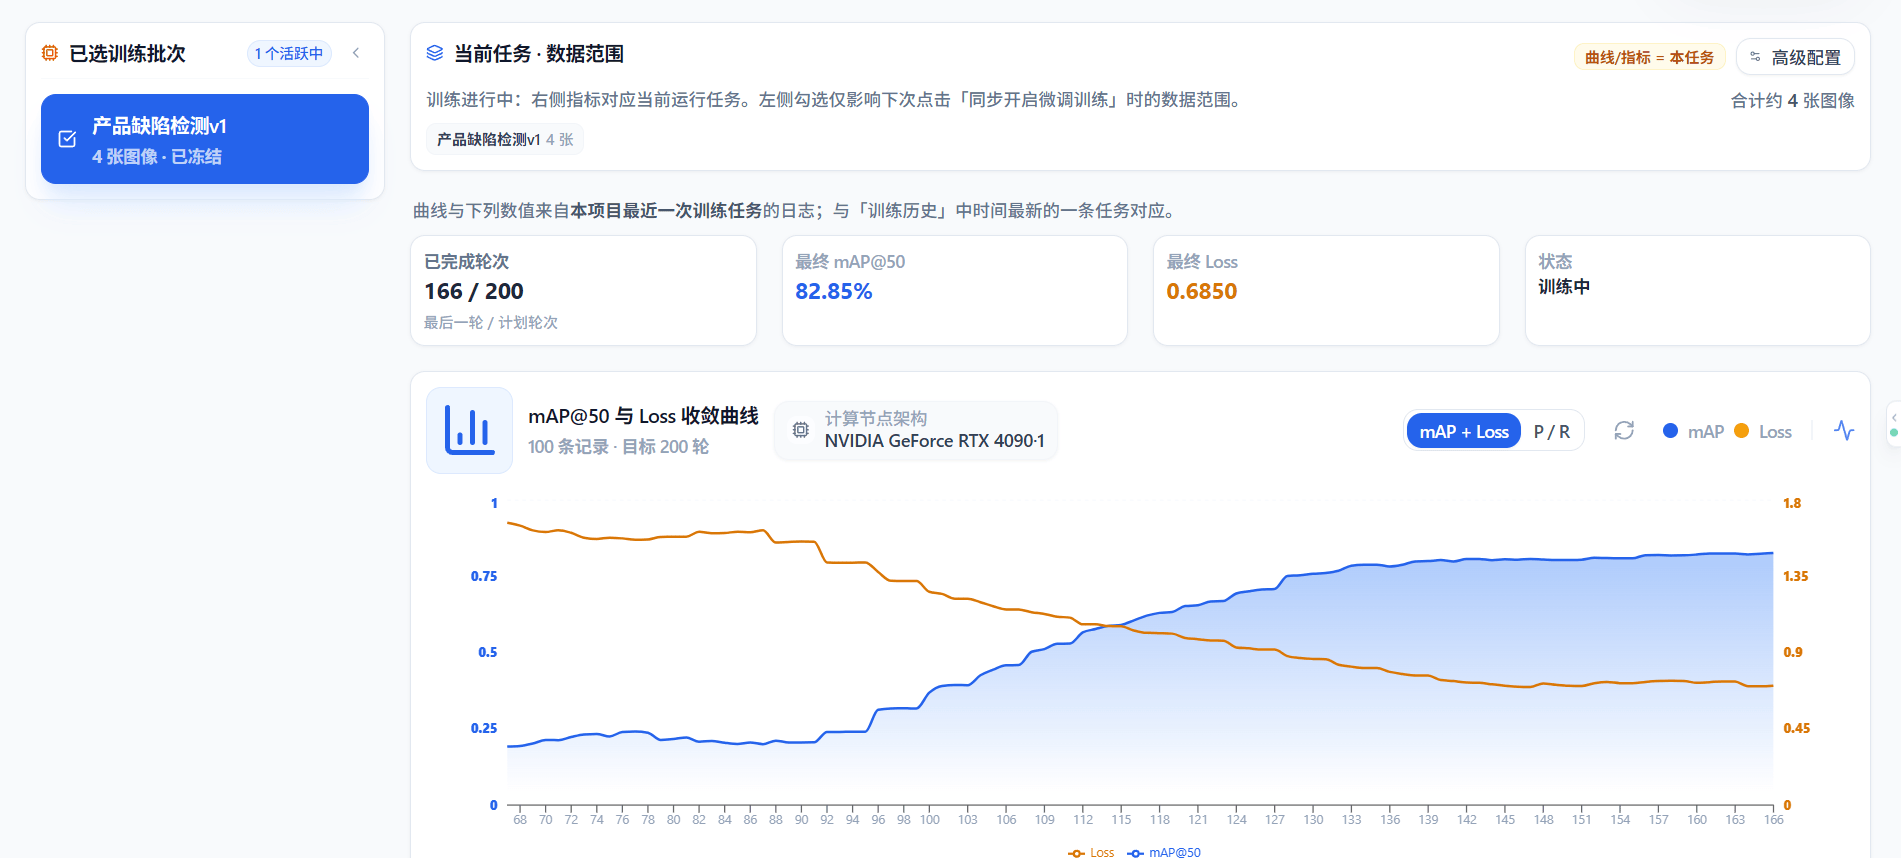
重点关注两个指标:交并比阈值0.5下的平均精度均值反映定位与识别整体精度(示例中可达93.67%),损失值反映训练收敛程度(如0.4892)。曲线平稳下降、稳步抬升,说明训练健康;曲线震荡或损失值不降,就要回头看数据。
三、自动调参:不用懂超参也能训
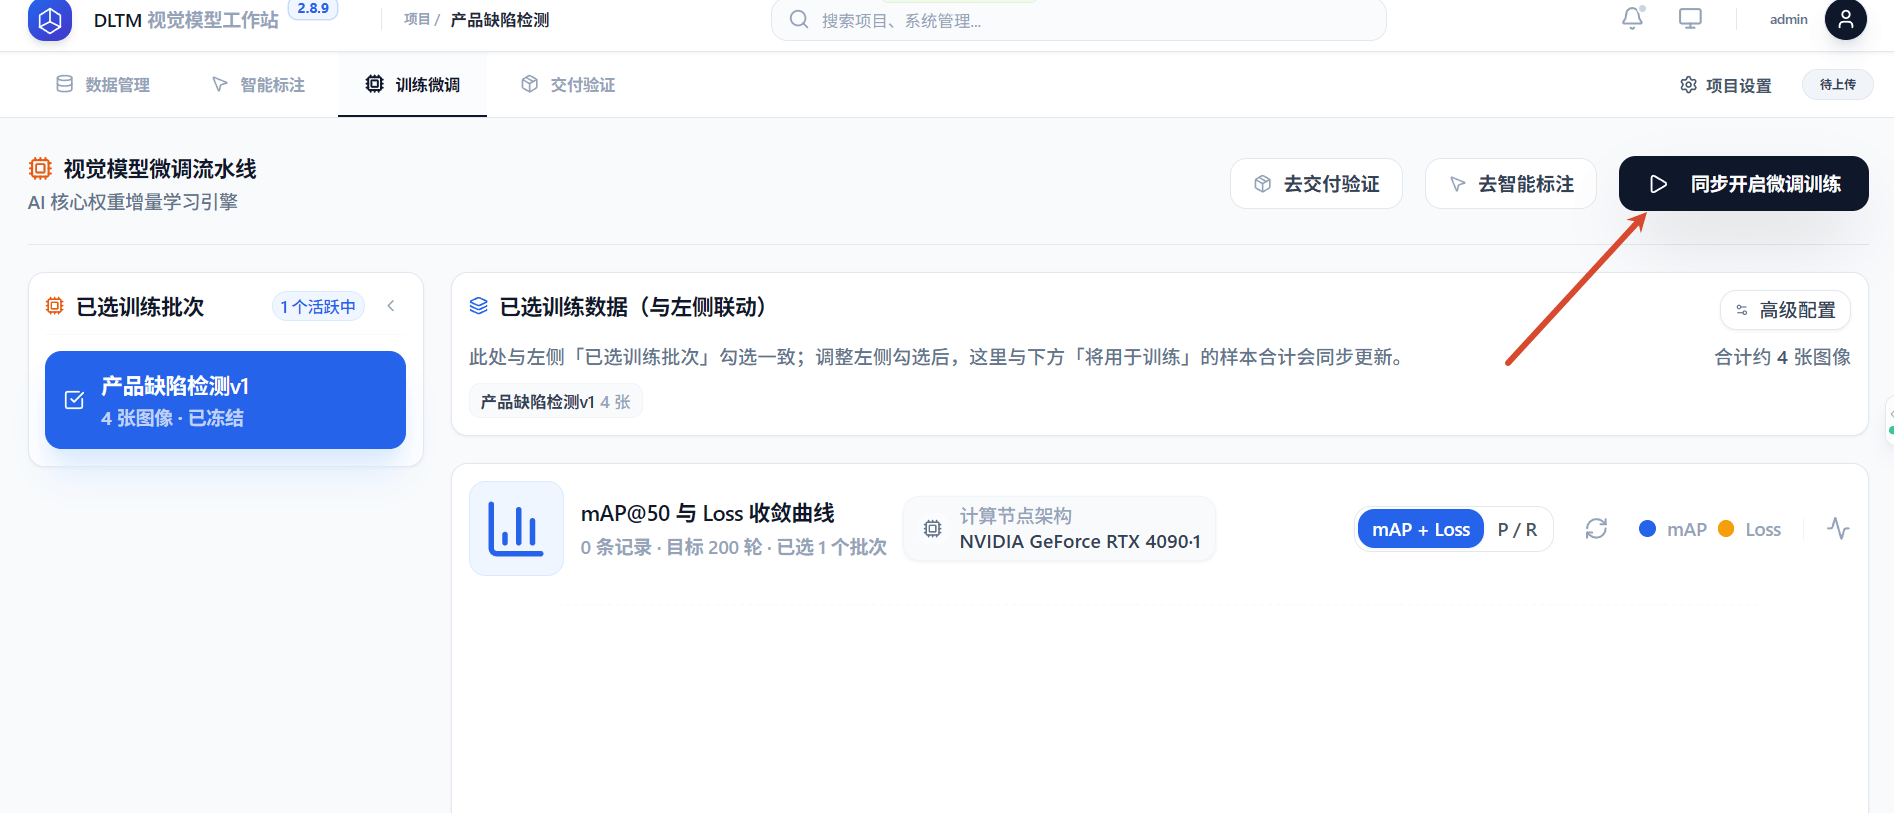
很多人被“学习率、批次大小、训练轮次”劝退。深度学习推理工作站DLTM的“省时间”优势体现在一键训练、自动调参上——勾选数据、一键启动,平台自动完成参数配置,当天就能出算法。
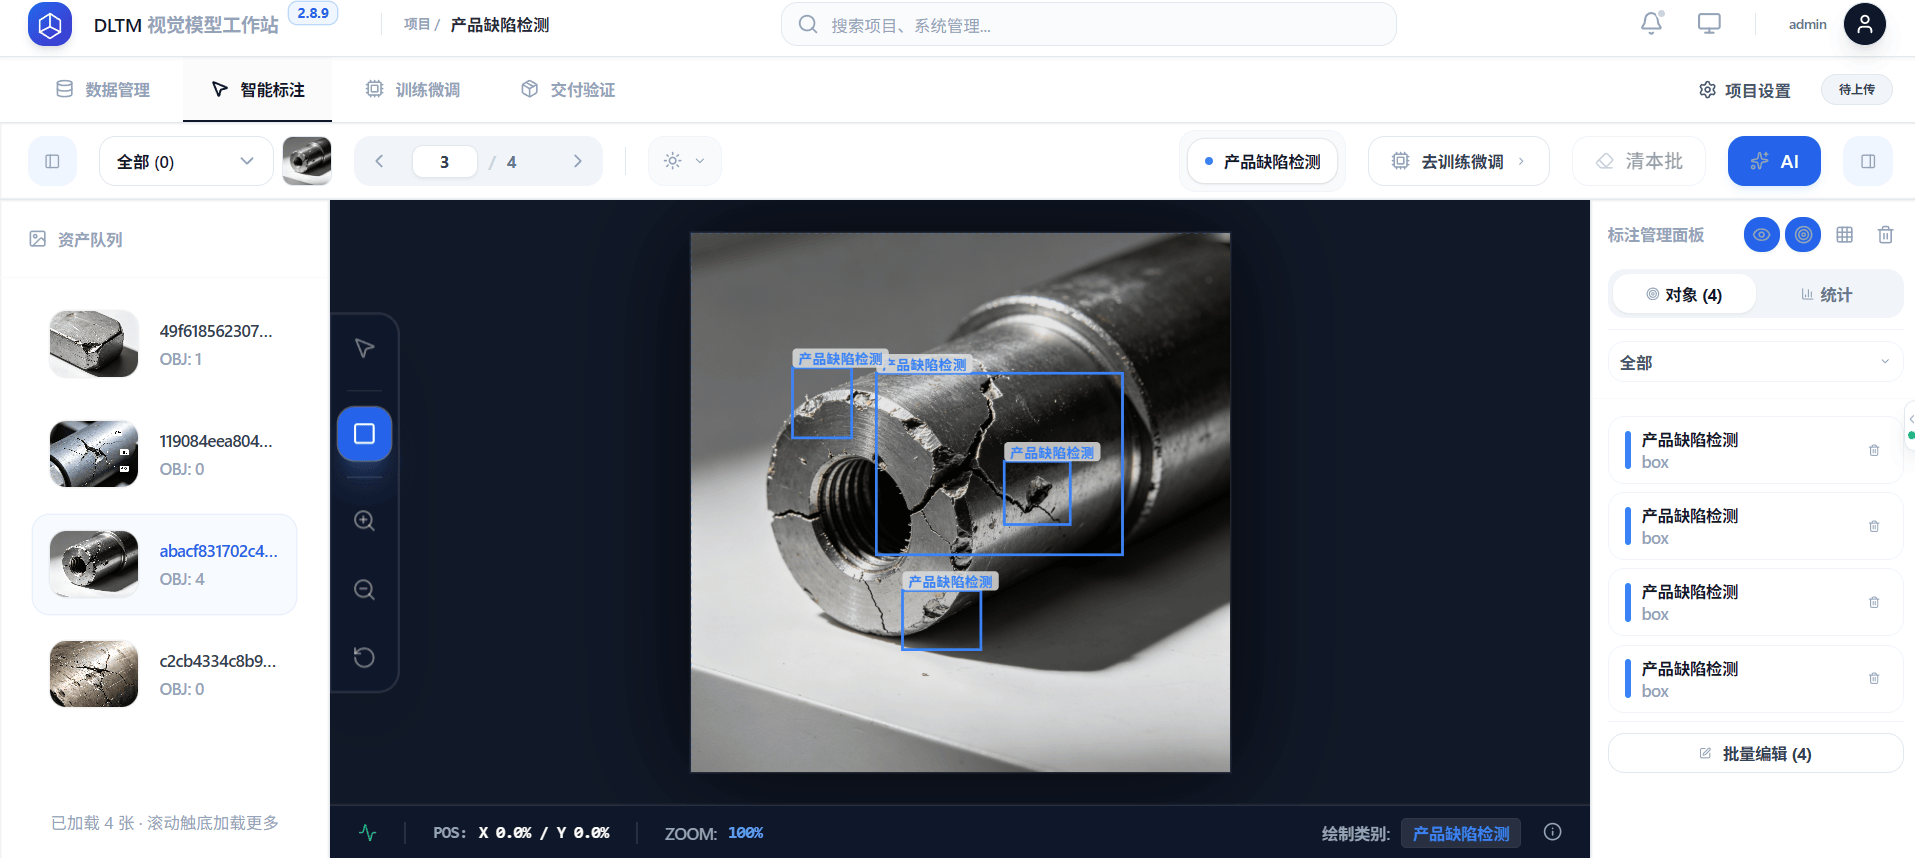
对现场响应而言,今天发现的新型误报,今天就能补数据、今天就能训出修正版,而不是排到下个月的外包档期。边际迭代成本趋近于零。
四、怎么读懂曲线,避免被平均数骗
评测是闭环里最容易被敷衍的一步。正确做法:用“没参与训练”的最新现场数据做测试,而不是拿训练集自己证明自己。本地大模型推理服务器DLTM支持多版本横向比对,把v1、v2在同一批难例上跑分,挑交并比阈值0.5下的平均精度均值更高、损失值更低的版本下发。不要只看平均值,要抽查具体误报案例——精度曲线漂亮但某类目标仍漏报,说明数据还不够。

私有化AI开发与推理工作站方案DLTM与EasyGBS/EasyAIS配合时,误报样本可回流再训,评测因此必须用“没参与训练”的最新现场数据,避免用训练集自证。这是闭环里最易被敷衍、也最关键的一步:评测通过,才进入导出与下发,这一步卡住了,后面全是空转。
五、白盒的价值:训练可审计、可回滚
企业级AI模型工作站DLTM的算法版本管理自动记录超参、数据、模型。你今天训的v2用了哪些新样本、比v1的交并比阈值0.5下的平均精度均值高了多少,系统都留痕。
六、零代码不是万能,但够用最常见
AI大模型训练工作站DLTM适合的是“用现场数据把成熟视觉任务练准”这类高频需求——安全帽、烟火、入侵、车辆等。把零代码用在刀刃上,把稀缺的外包预算留给真正的前沿探索,才是划算的搭配。
小结
当训练从盲盒变成白盒,企业的AI能力才真正掌握在自己手里。私有化本地化AI模型训推工作站DLTM用可视化曲线与自动调参,让不懂代码的人也能看懂、管好每一次训练。

 浙公网安备 33010602011771号