
标注规范定10分钟,训练返工省3天:自动化AI算法训练服务器DLTM智能标注避坑与最佳实践
数据标注是AI训练里最枯燥也最吃人力的环节,也是最容易埋雷的环节。AI大模型训练工作站DLTM用“AI批量预标注+人工校验”把标注效率提升,让业务人员也能攒出数据集。但效率上来了,质量反而更容易翻车——框歪一点、类别标错,模型就学偏。本文总结智能标注的三个常见误区与对应最佳实践,帮团队少走弯路。
一、先算笔账:标注为什么不能省
一个工地安全帽检测模型,往往要几千张带框的样本。如果全靠人工逐张框,一个人一天标注几百张已是极限,项目周期和人力成本都被卡在这里。标注质量还直接决定模型上限——框得不准,模型就学偏。可以说,标注是AI落地里最被低估、却最不能省的苦活。
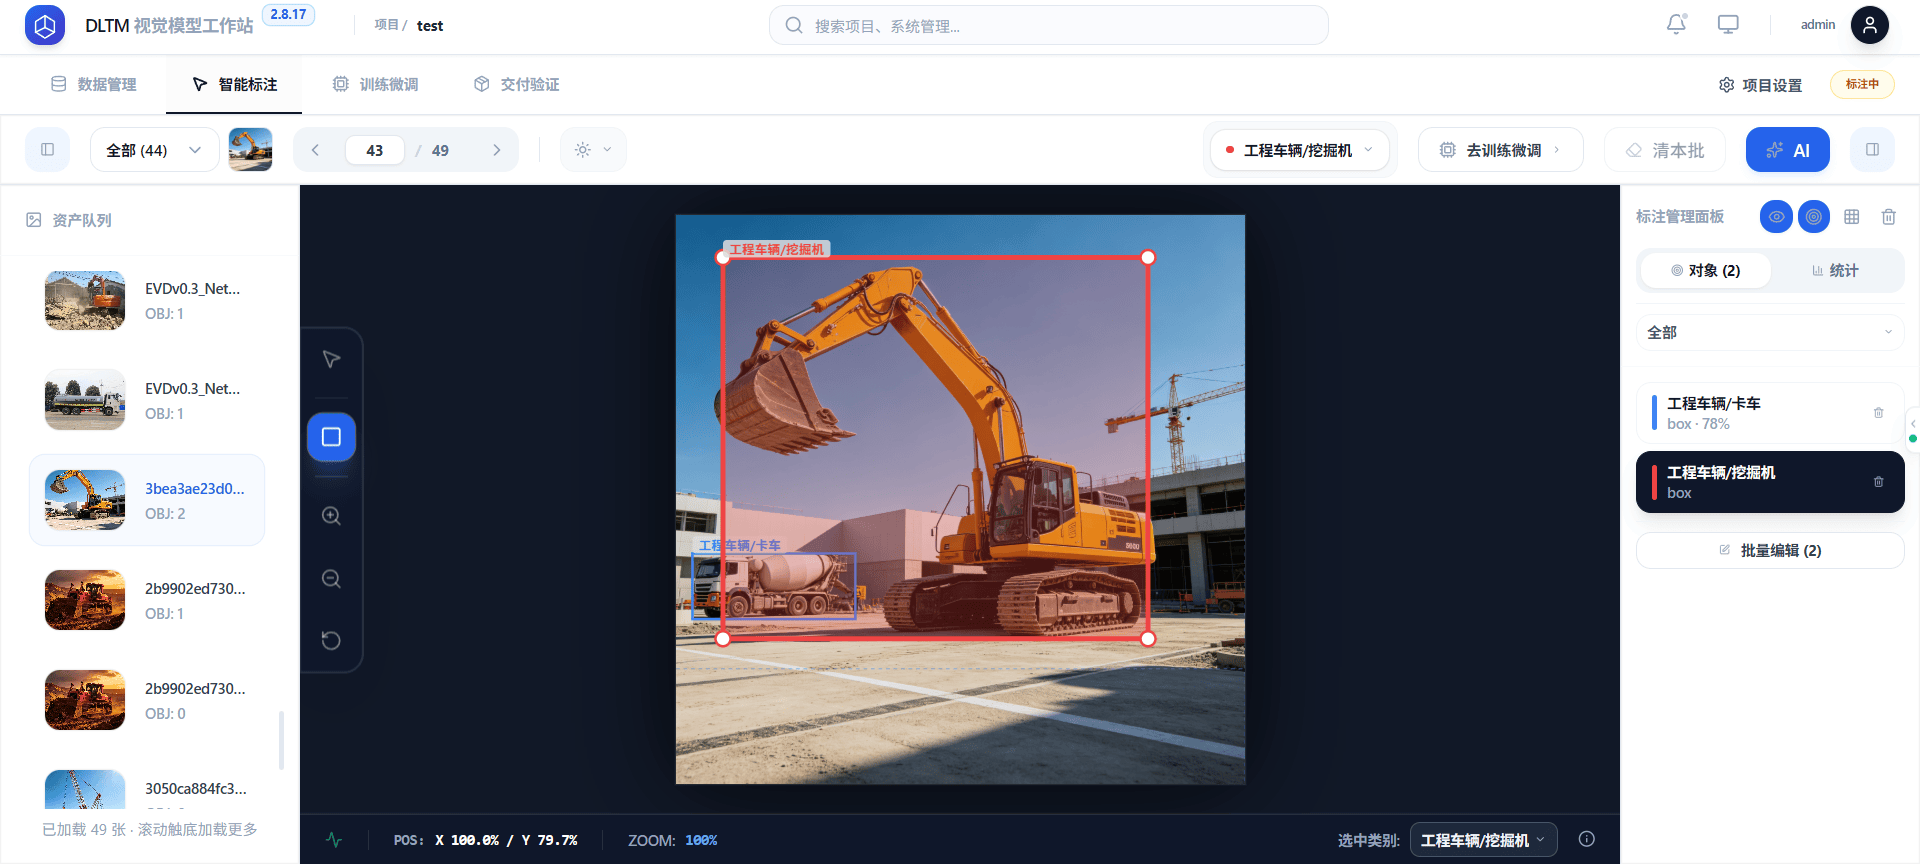
AI模型私有化部署平台DLTM的效率,正是把人从“从零画框”变成“检查校对”。自动化AI算法训练服务器DLTM把智能标注作为四大引擎之一,用“AI批量预标注+人工校验”的组合,把标注效率拉高,也让“业务人员也能训模型”从前提变为现实。没有高效标注,业务人员根本攒不出数据集,零代码训练也就无从谈起。
二、误区一:边界模糊,框到哪算哪
目标只露一半、被遮挡时,标注员容易凭感觉框,前后不一致。模型学到的是混乱的边界,定位就飘。最佳实践:团队定一份标注规范,统一“露多少算目标”——比如“目标可见面积超30%才框”“被遮挡也框完整外接矩形”。规范越清晰,模型迭代越顺。标注阶段多花十分钟定规范,训练阶段能省几天返工。
三、误区二:类别重叠,模型学混淆
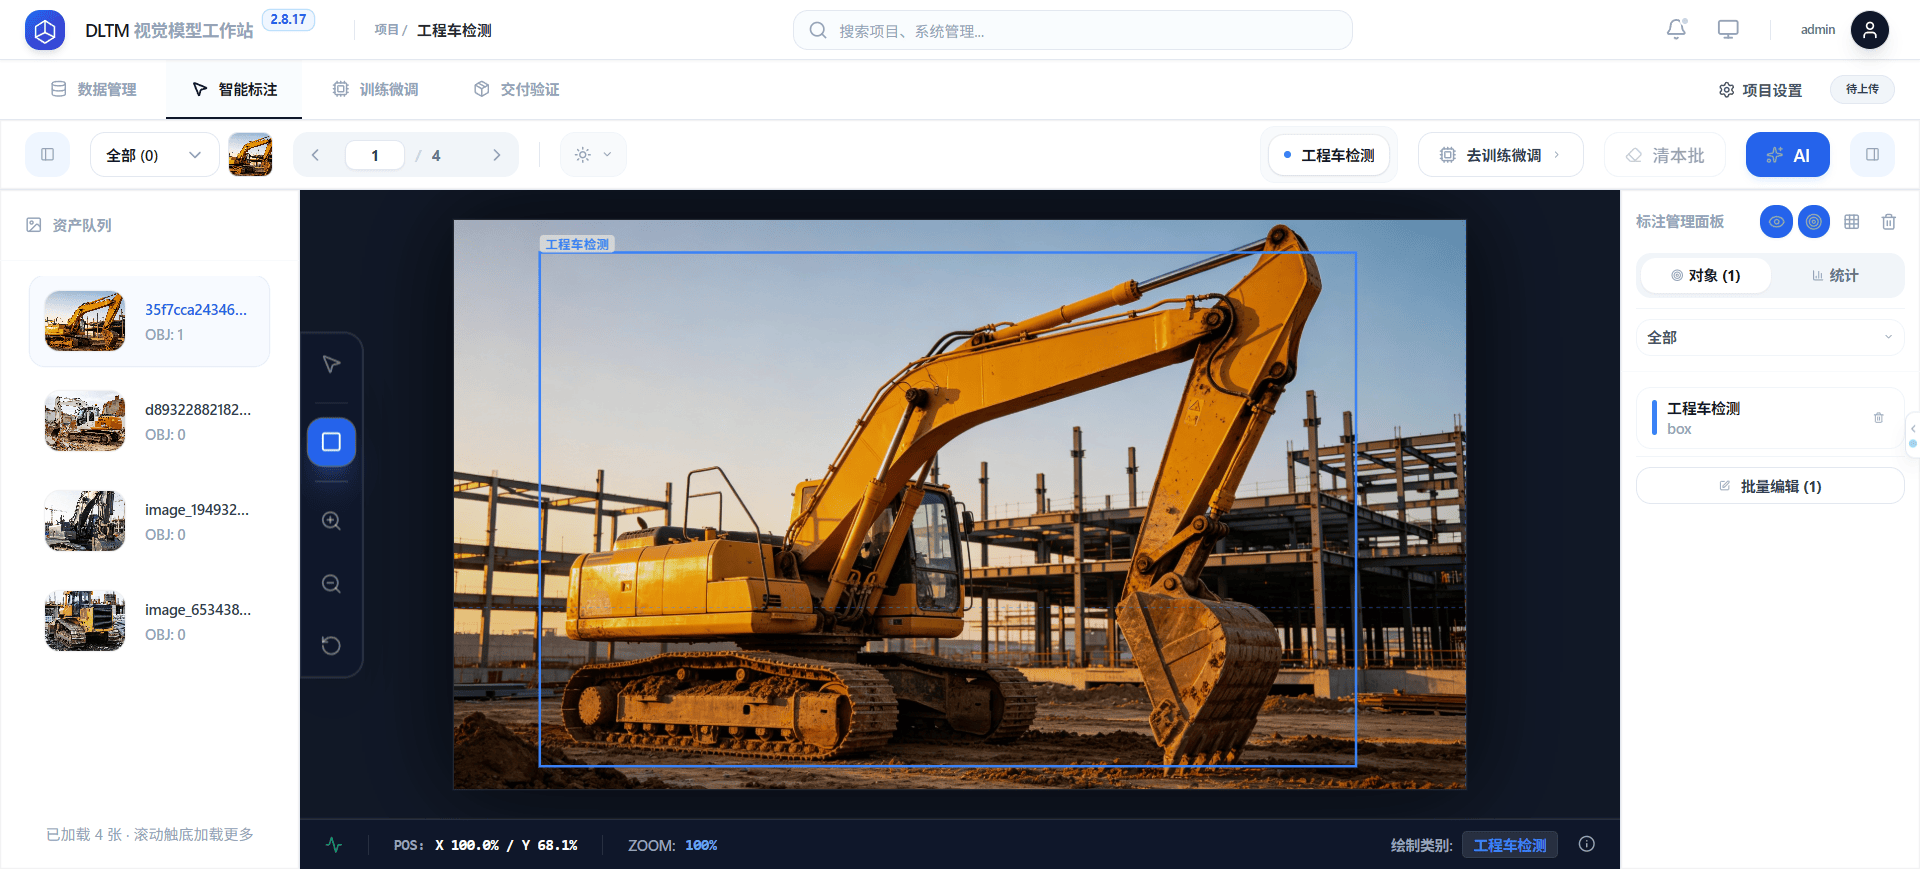
比如“车辆”和“工程车”同时标,模型会混淆,应按实际管理粒度分层。再比如“烟火”和“蒸汽”不分,消防场景就会误报。
用深度学习推理工作站DLTM单独重训专属模型,而不是在通用标注里硬塞。类别清晰,是精度的地基。
四、误区三:样本不均衡,少数类饿死
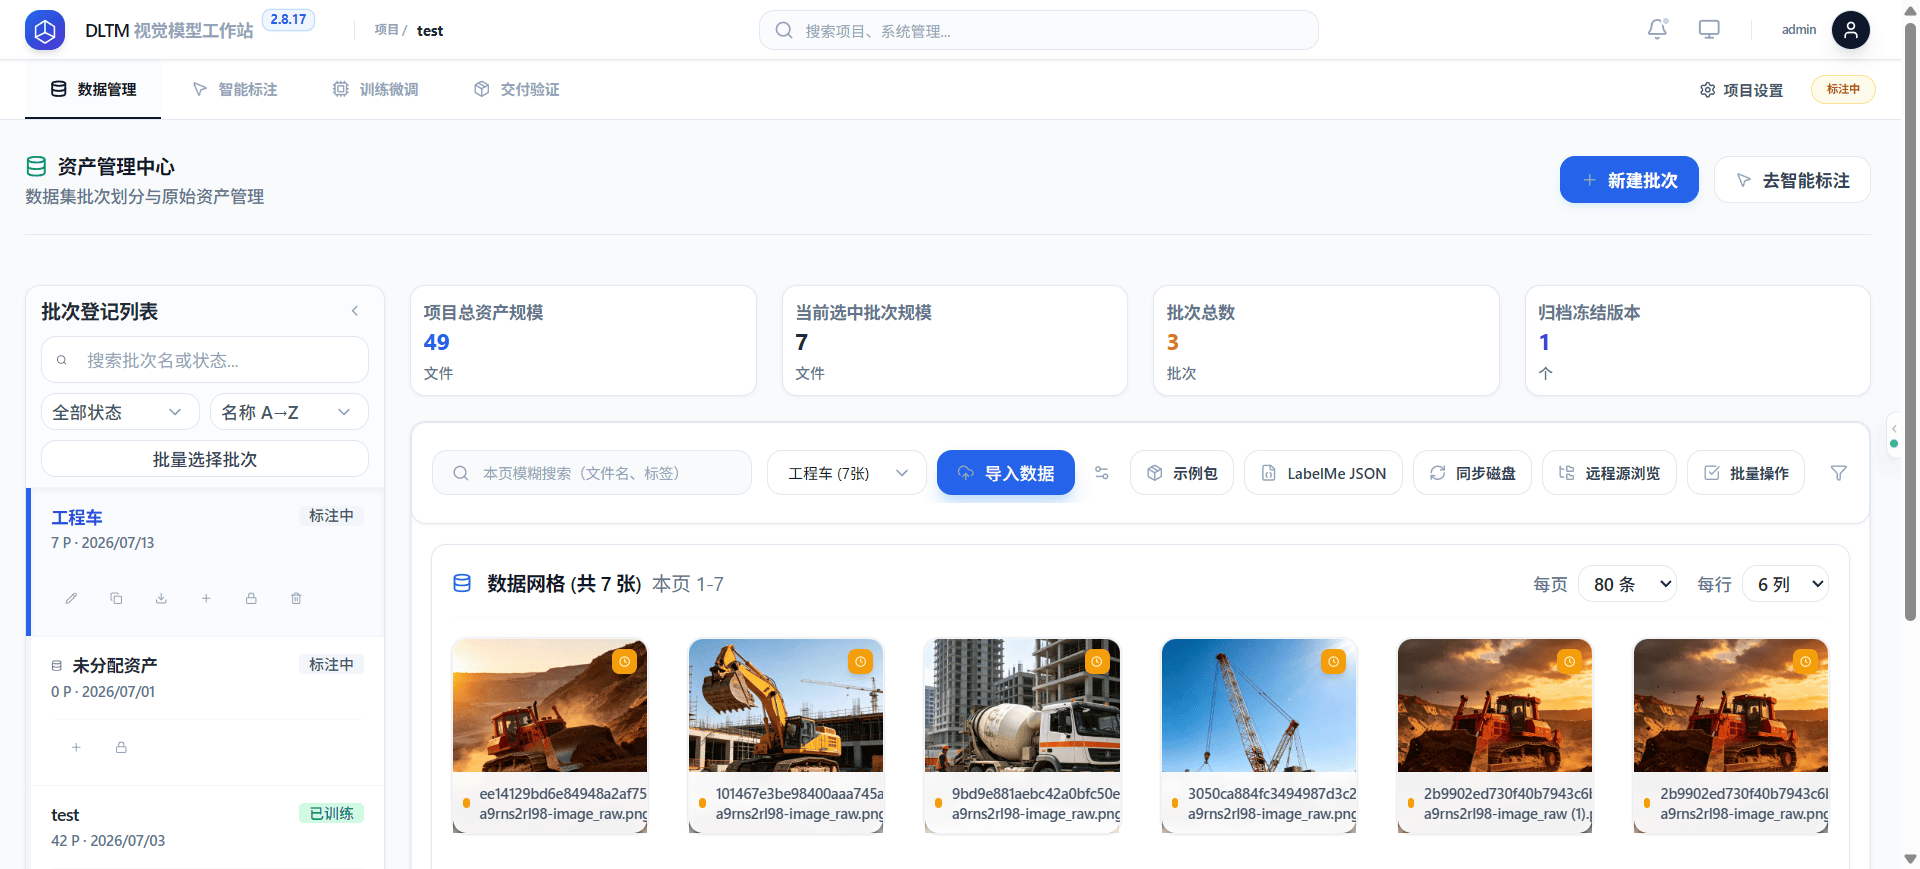
某类目标样本极少,模型就学不好,现场一遇这类就漏报。最佳实践:用私有化本地化AI模型训推工作站DLTM的批次管理平衡各类样本量——按类别建批次、看每类资产规模,有意识地补充少数类。对边界样本(逆光、遮挡、小目标)重点人工复核,这些恰恰是最能拉开精度差距的难例,值得多花那几分钟。
五、AI预标注+人工校验的正确姿势
企业私有化AI训练推理一体工作站DLTM先用内置大模型对图片做批量预标注,把绝大多数目标自动框出;人工只做纠偏和补漏。关键是“校验”而非“重画”:先快速过一遍AI框,纠偏歪框、补漏掉的目标,再进入训练。建议对边界样本重点人工复核,标准样本快速放行,把人力用在刀刃上。标注完成的批次可直接勾选进入训练,样本、标签、划分一次性贯通。
数据管理支持上传图片/压缩包快速攒数据集,也支持导入格式的标注文件。无论历史截帧还是新采集样本都能顺畅进入标注环节。AI预标注解决“量”、人工校验解决“质”,二者结合既快又准,边界样本重点人工复核,标准样本快速放行,把人力用在刀刃上。
六、建立“标注即归档”的习惯
每批样本标注完就归入对应场景批次,并标注采集时段与点位,既方便当次训练,也为后续误报回流、版本对比留下干净的数据基线。
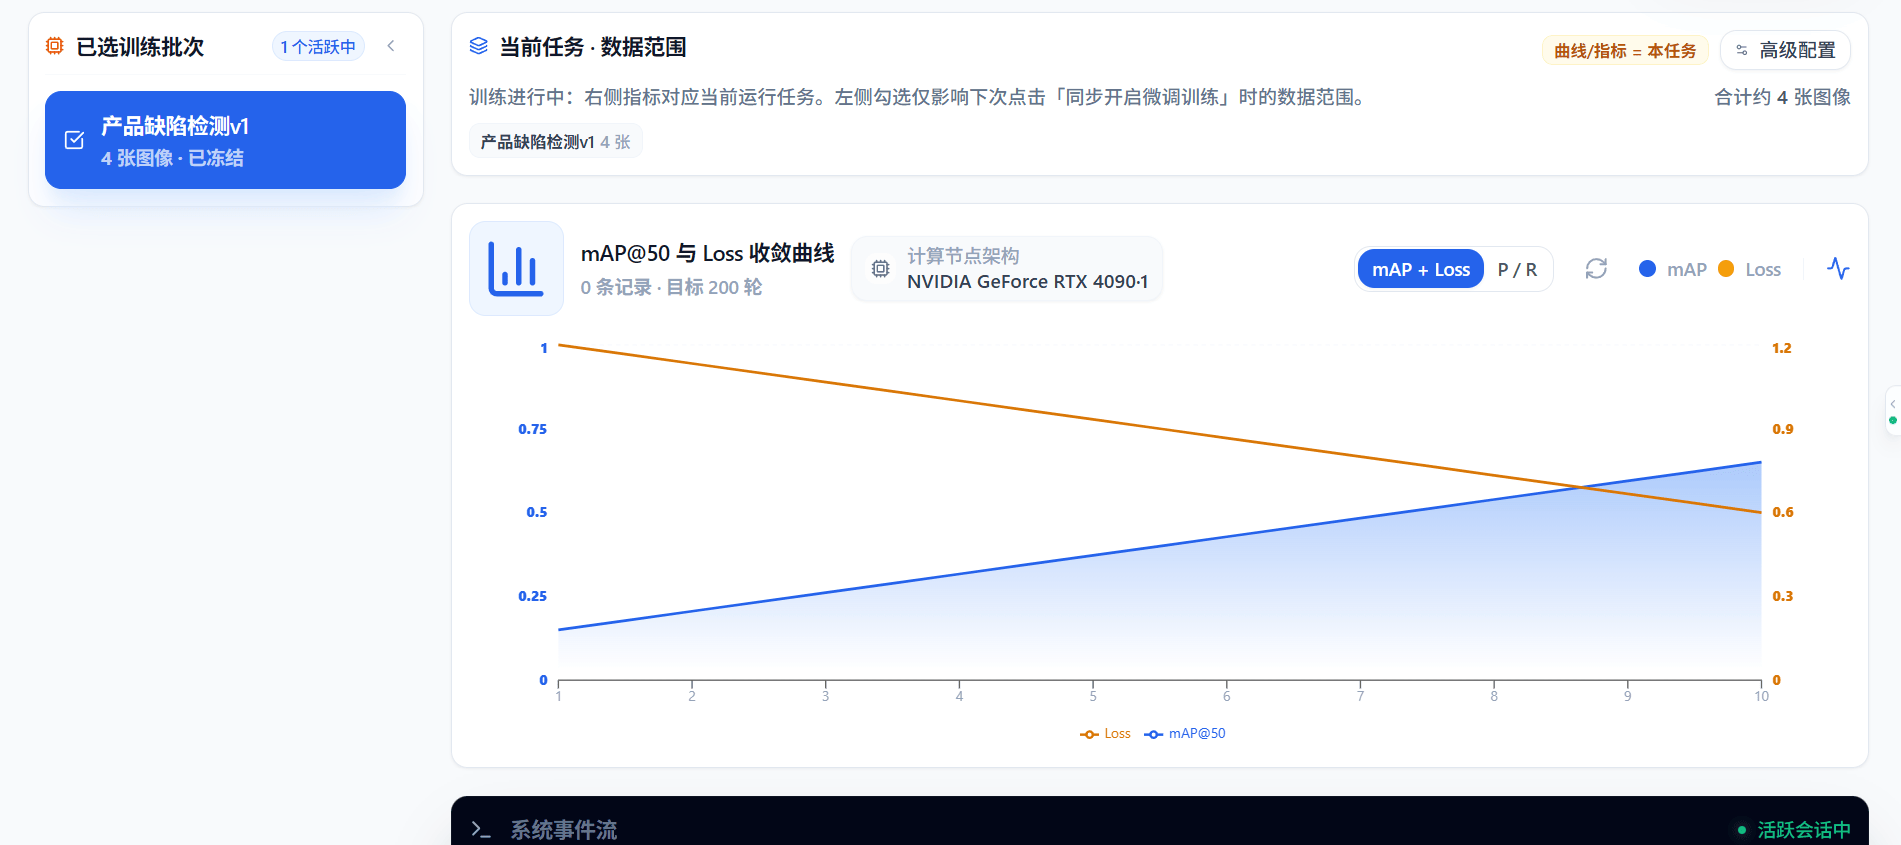
自动化AI算法训练服务器DLTM的资产管理中心支持批次登记、模糊搜索、归档冻结——冻结后的批次作为某版模型的固定训练集,回滚有参照。把标注当工程动作管理,而非一次性苦力。
小结
标注规范定10分钟,训练返工省3天。私有化本地化AI模型训推工作站DLTM智能标注用效率把人解放出来,而避坑与规范才让这份效率真正转化为模型精度。

 浙公网安备 33010602011771号