
把数据管成资产:自动化AI算法训练服务器DLTM资产管理中心与批次化标注,让每次训练都可追溯
做AI训练的人常说一句话:垃圾进,垃圾出。模型的上限,是被数据质量焊死的。但比“数据质量”更常被忽视的,是“数据管理”——几千张现场图片散落各处,谁也说不清哪张来自哪个点位、哪个时段、训过哪版模型。AI大模型训练工作站DLTM用“资产管理中心+批次”把这件麻烦事系统化,让训练数据从一堆散图变成可追溯的资产。
一、数据管理,是被低估的地基
深度学习推理工作站DLTM的场景数据引擎负责把现场样本快速攒成数据集。它支持上传图片或压缩包快速建库,也支持导入标注文件。但数据进得来只是第一步,管得清才是关键——否则训了三版模型,没人说得清每版喂了什么。
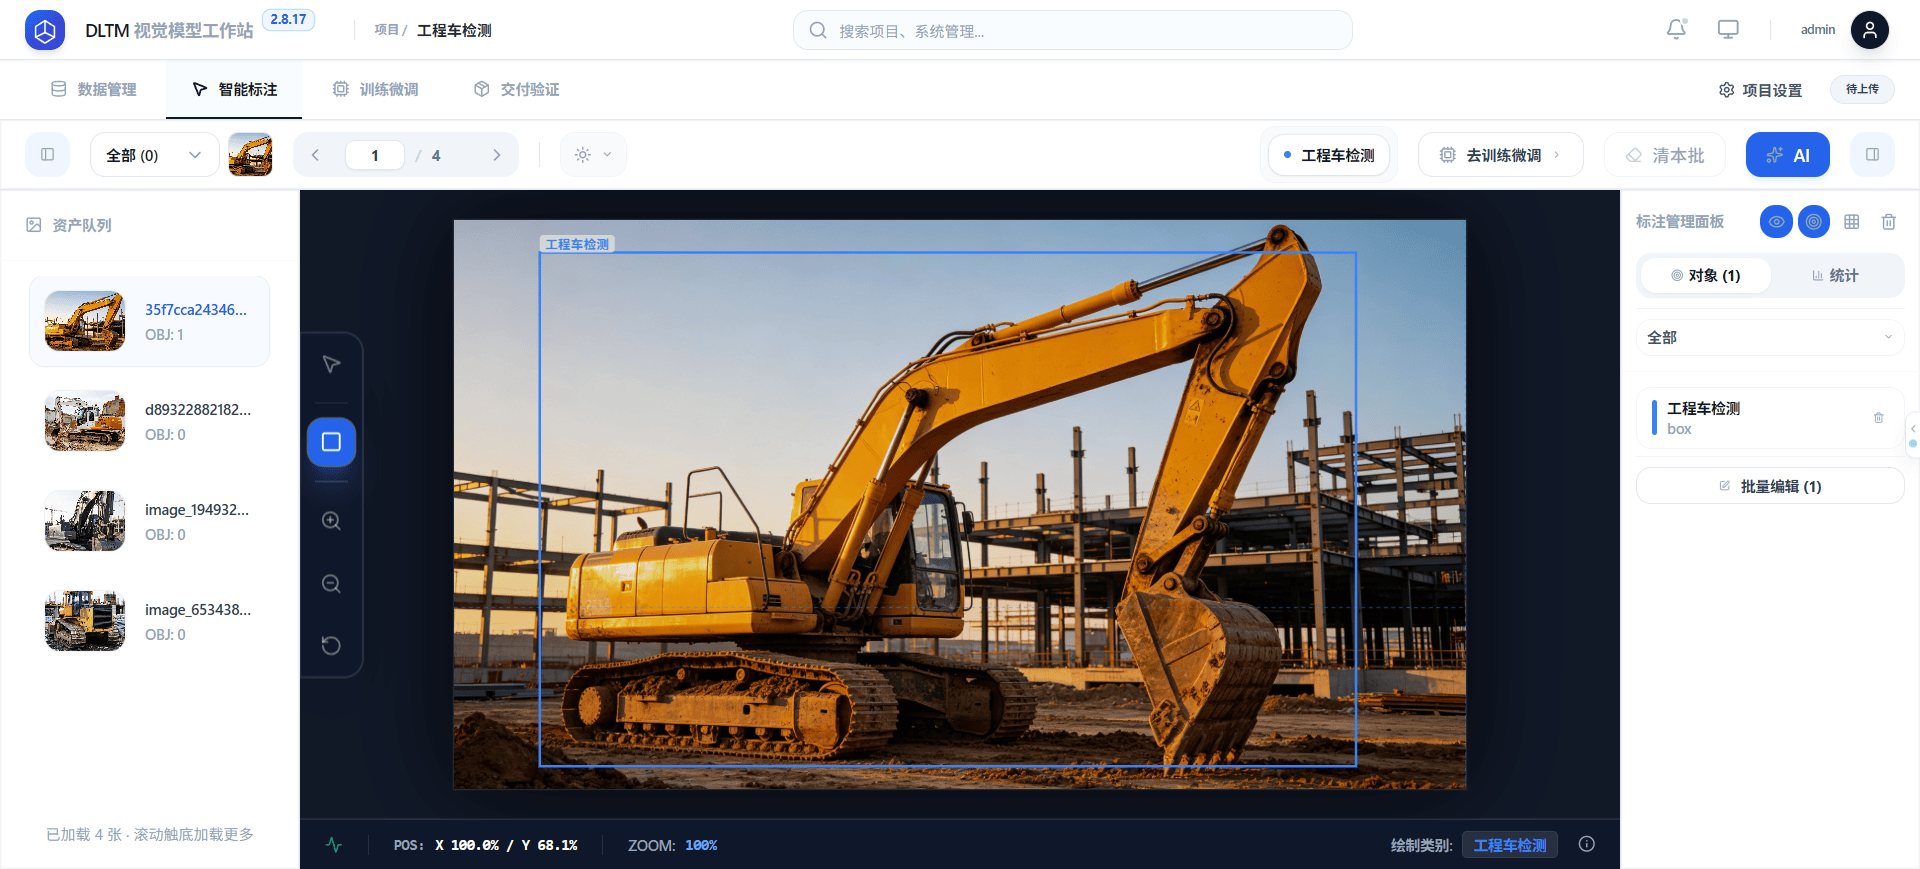
现场数据形态多样:单张图片、压缩包、标注文件,DLTM的场景数据引擎都能顺畅接入。无论你手上是历史录像截图,还是新采集的样本包,都能无缝进入标注环节,不会因为格式卡在门外。
二、资产管理中心:用“批次”组织原始资产
本地大模型推理服务器DLTM在资产管理中心按批次登记原始资产。你可以按时段、场景建不同批次,给每个批次标注状态:未分配、标注中、已冻结。项目总资产规模和当前选中批次规模一目了然。需要训练时勾选对应批次即可,不用在一堆散图里翻找。这种结构化管理,让“数据从哪来、训了什么”清晰可追溯。
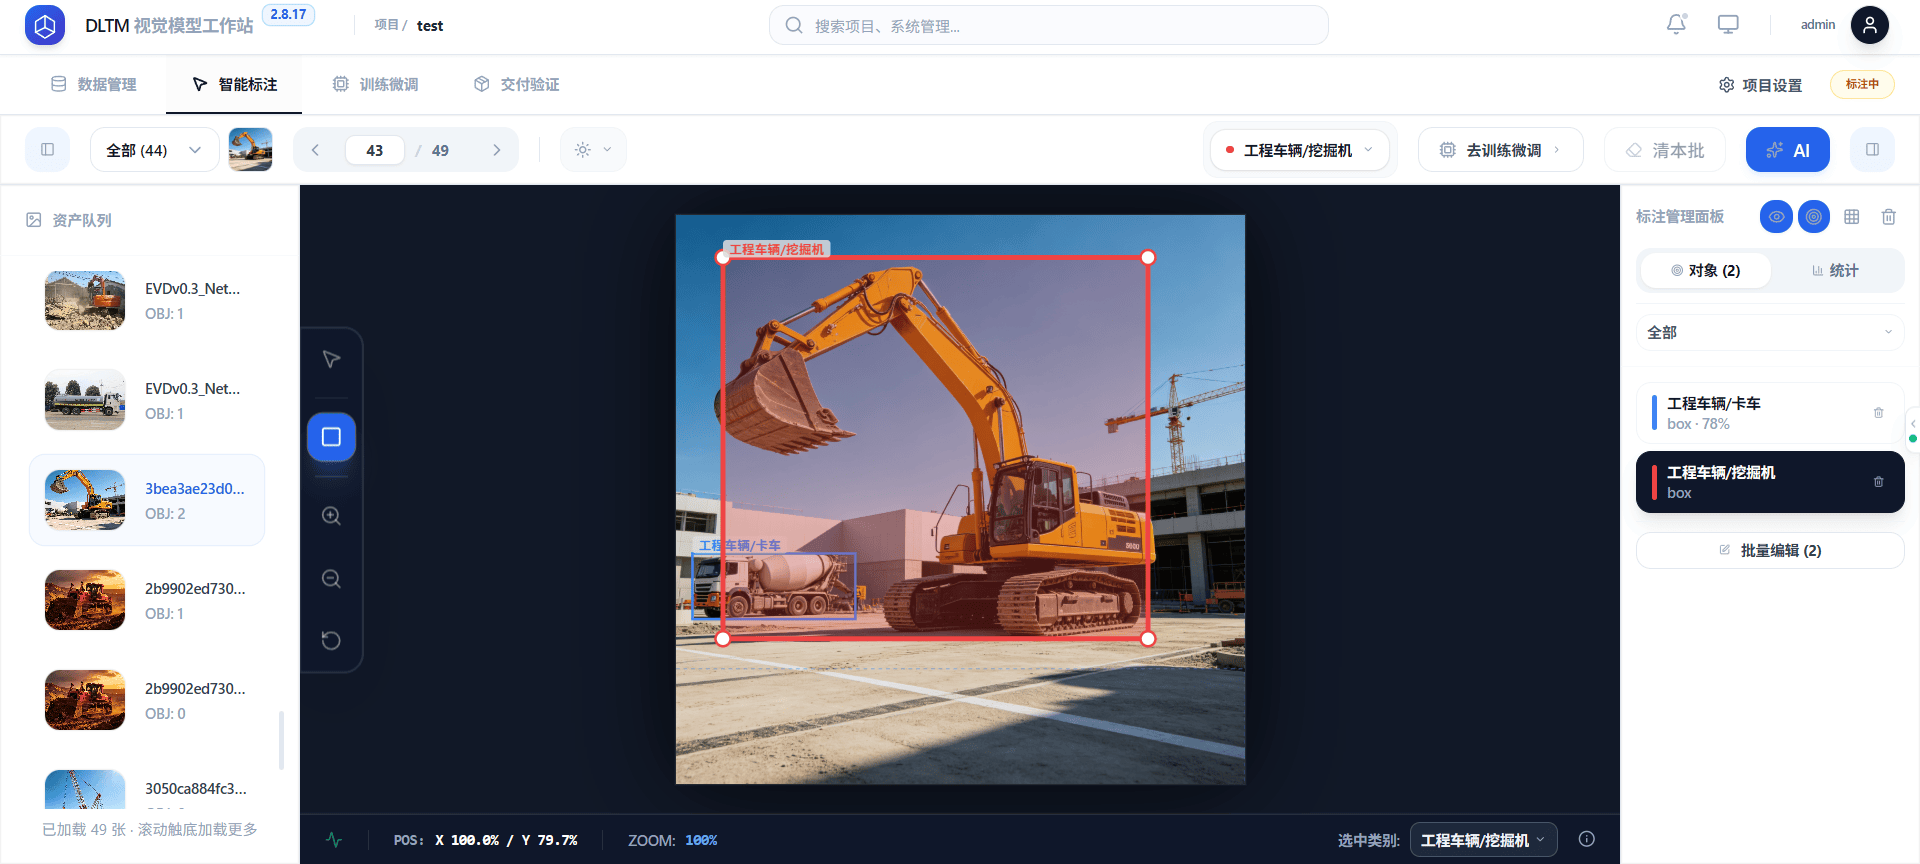
三、支持检索,大海捞针变秒查
现场数据一多,找图就成了体力活。深度学习推理工作站DLTM的资产管理中心支持模糊检索,配合归档冻结,把杂乱的原始素材整理得井井有条。
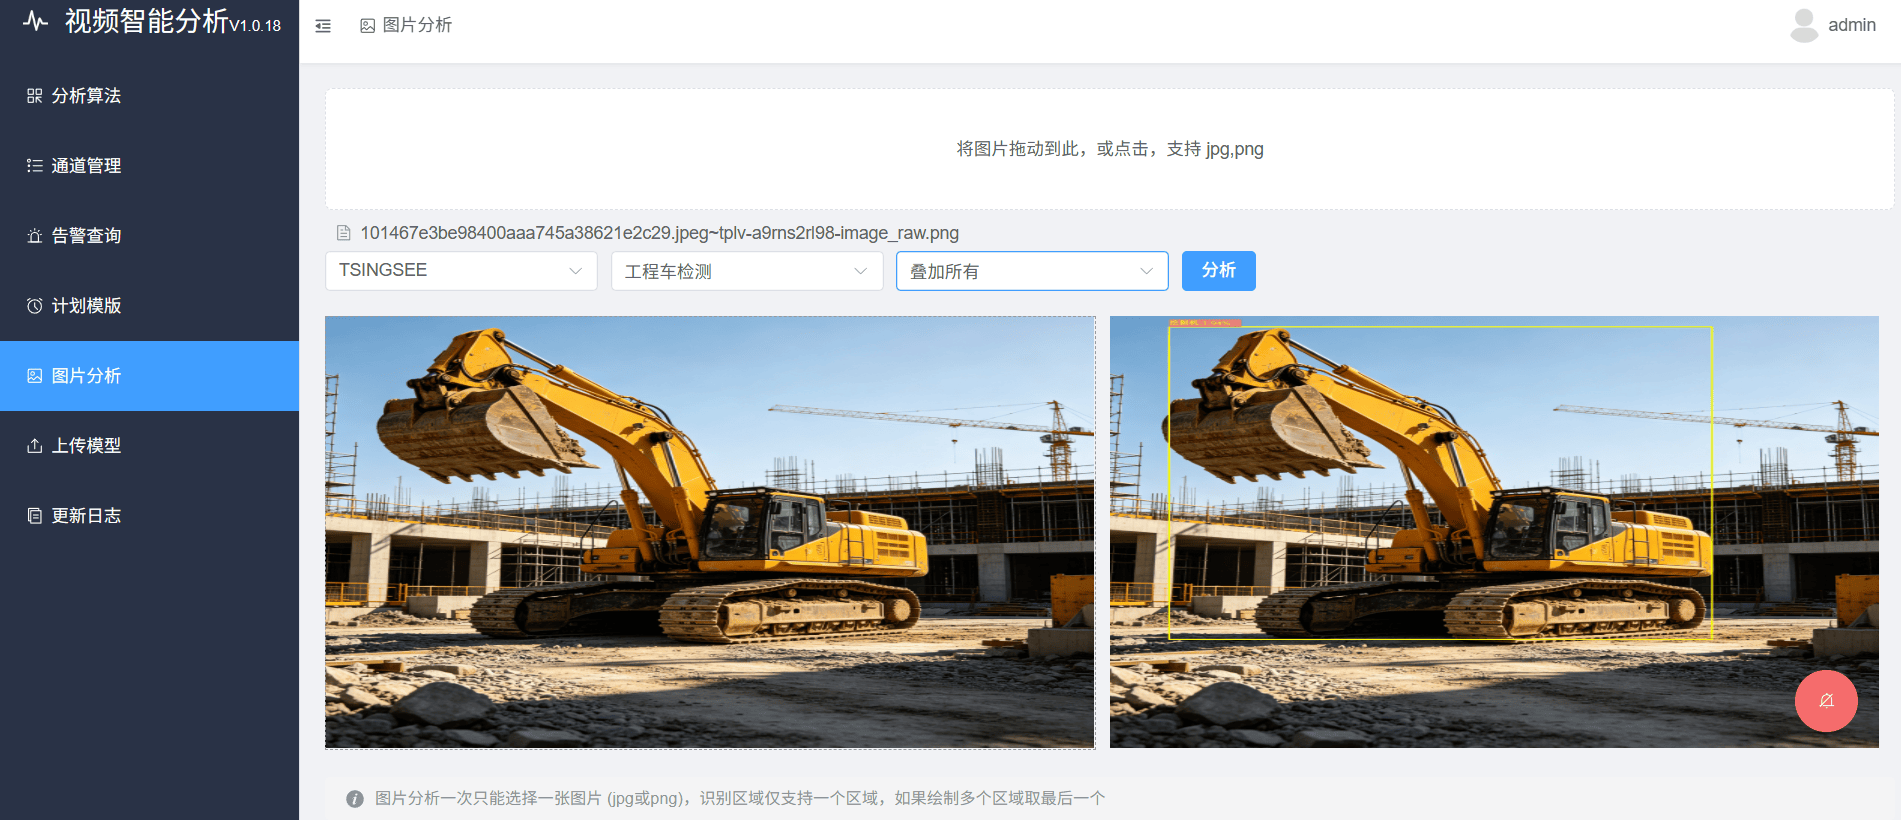
比如想复查“上周三B区逆光下的安全帽样本”,直接按批次和关键词定位,而不是翻遍整个文件夹。对误报样本回流、版本迭代而言,这种检索能力直接决定了迭代效率。
四、归档冻结:给数据一个“定版本”的动作
“已冻结”状态的价值,是给某批数据一个稳定的基线。冻结后的批次不再被误改,可作为某一版模型的固定训练集,后续对比、回滚都有干净参照。
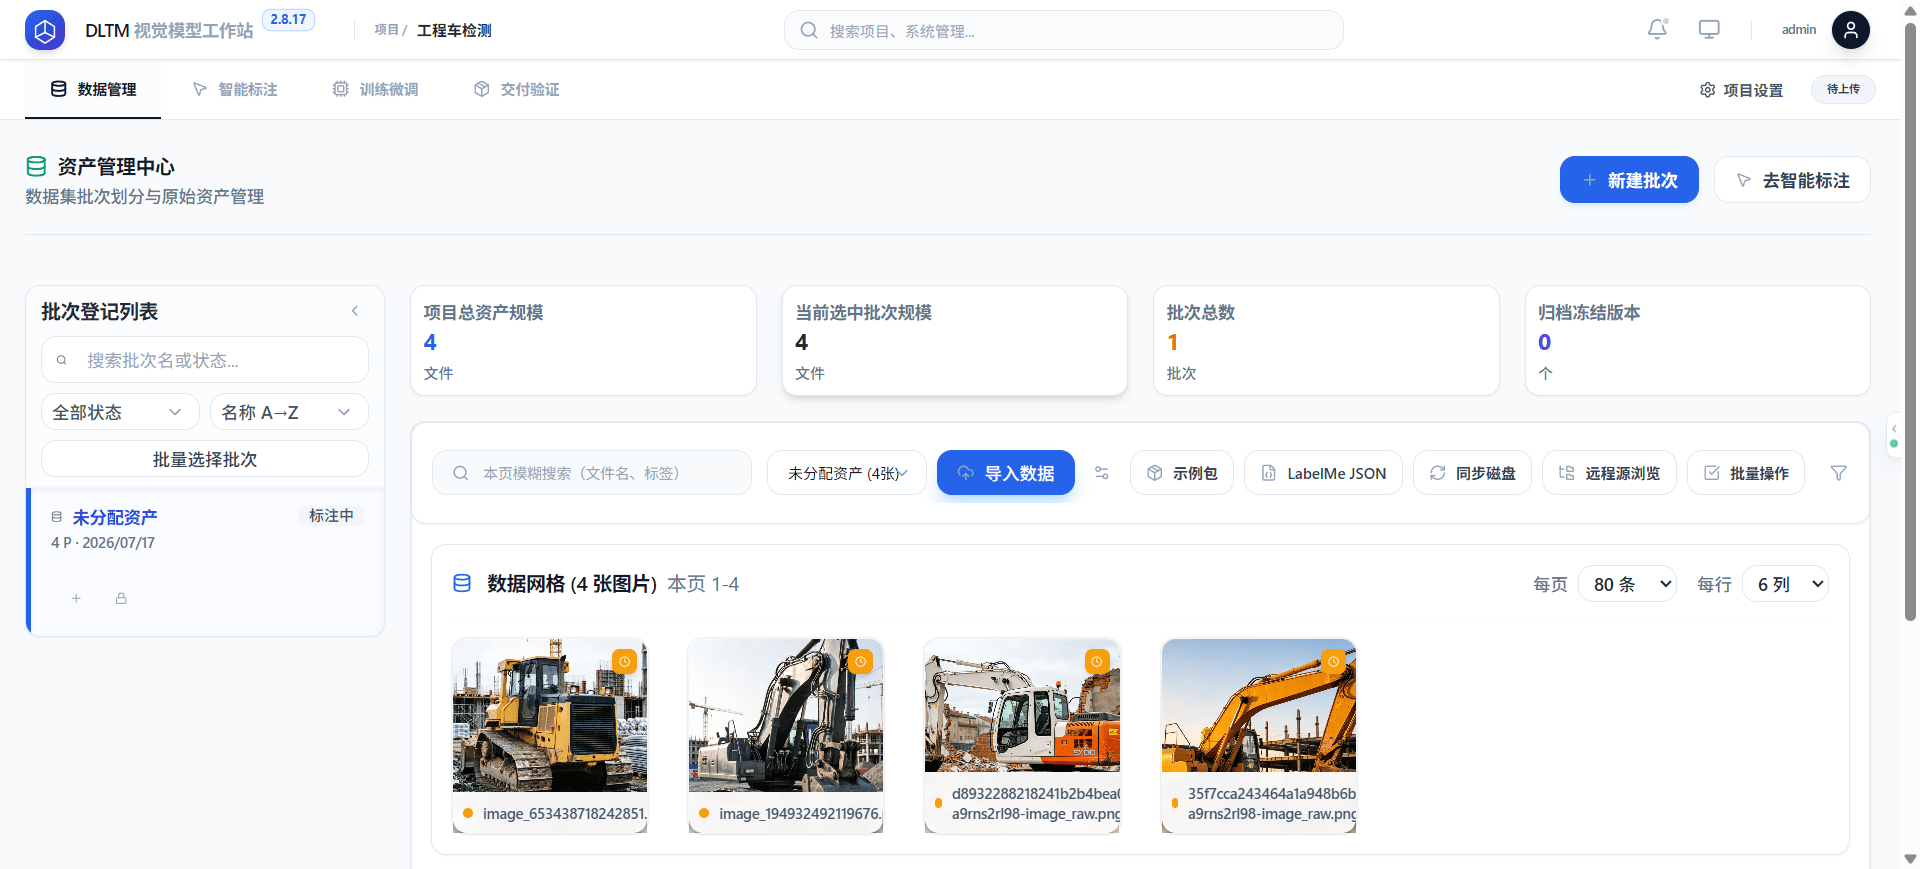
私有化本地化AI模型训推工作站DLTM建议团队建立“标注即归档”的习惯:每批样本标注完就归入对应场景批次,并标注采集时段与点位,既方便当次训练,也为后续误报回流、版本对比留下数据基线。
五、批次管理如何服务模型迭代
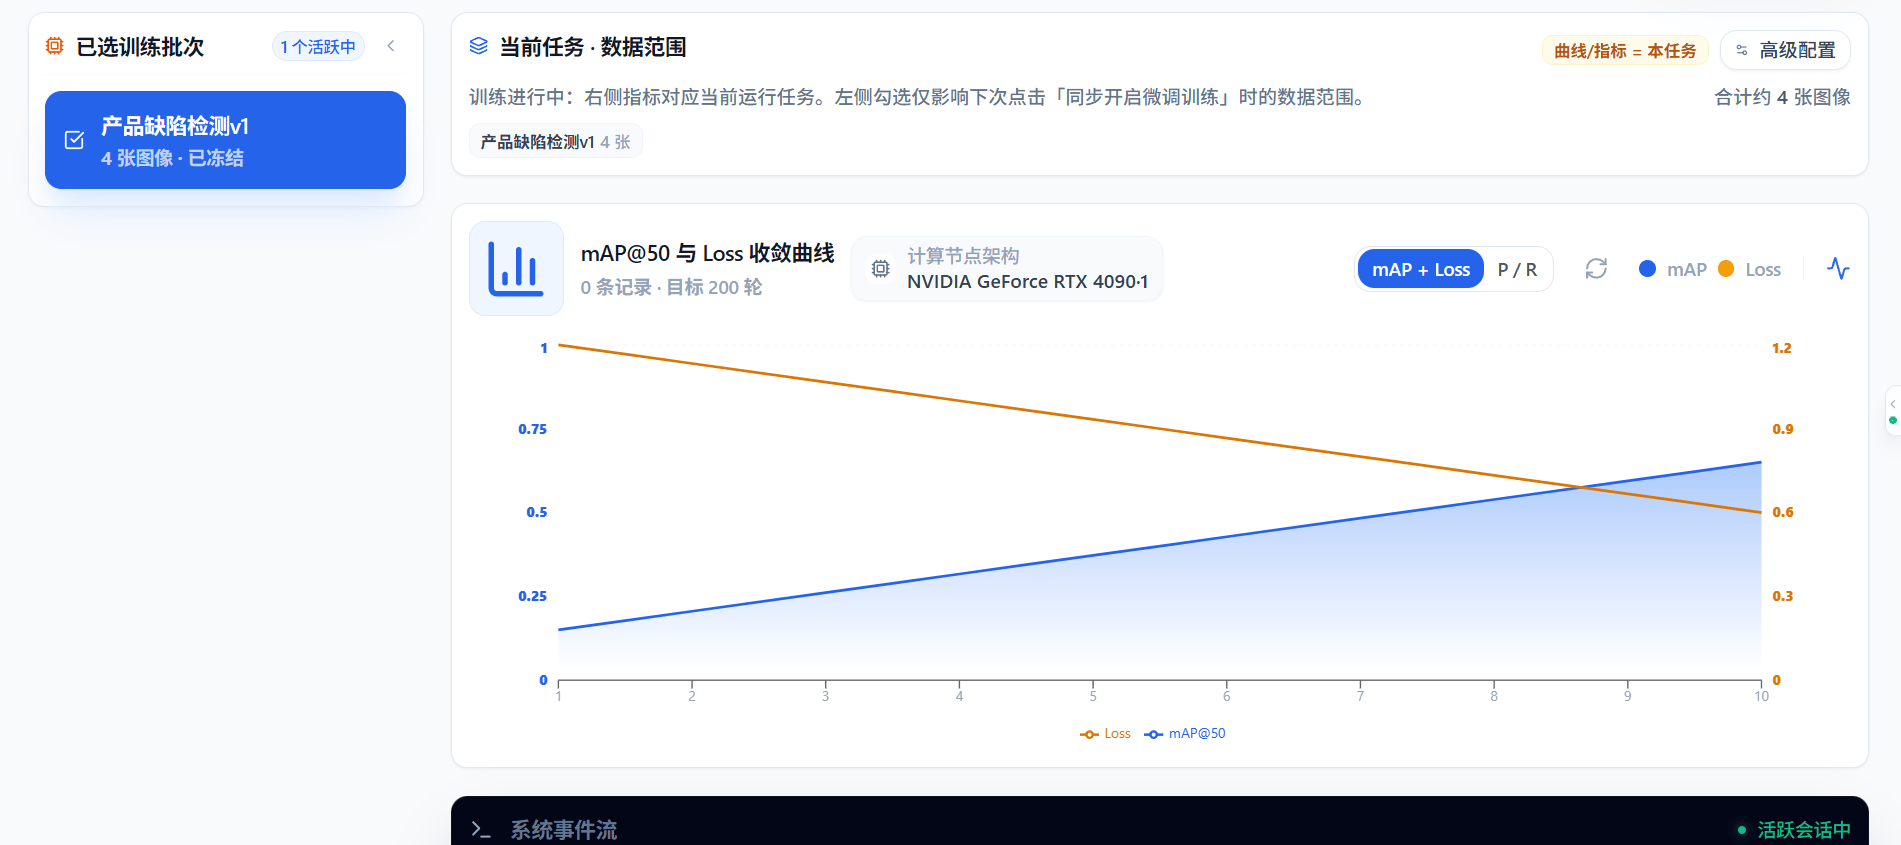
误报样本回流时,新收集的难例可以单独建批次归档,和初始场景数据区分开。训练时勾选“初始批次+难例批次”,模型既认识现场整体,又在边界上变强。版本管理再记录每批数据的去向,v1、v2用了哪些批次一目了然。可追溯,意味着迭代是可控的工程,而非碰运气。
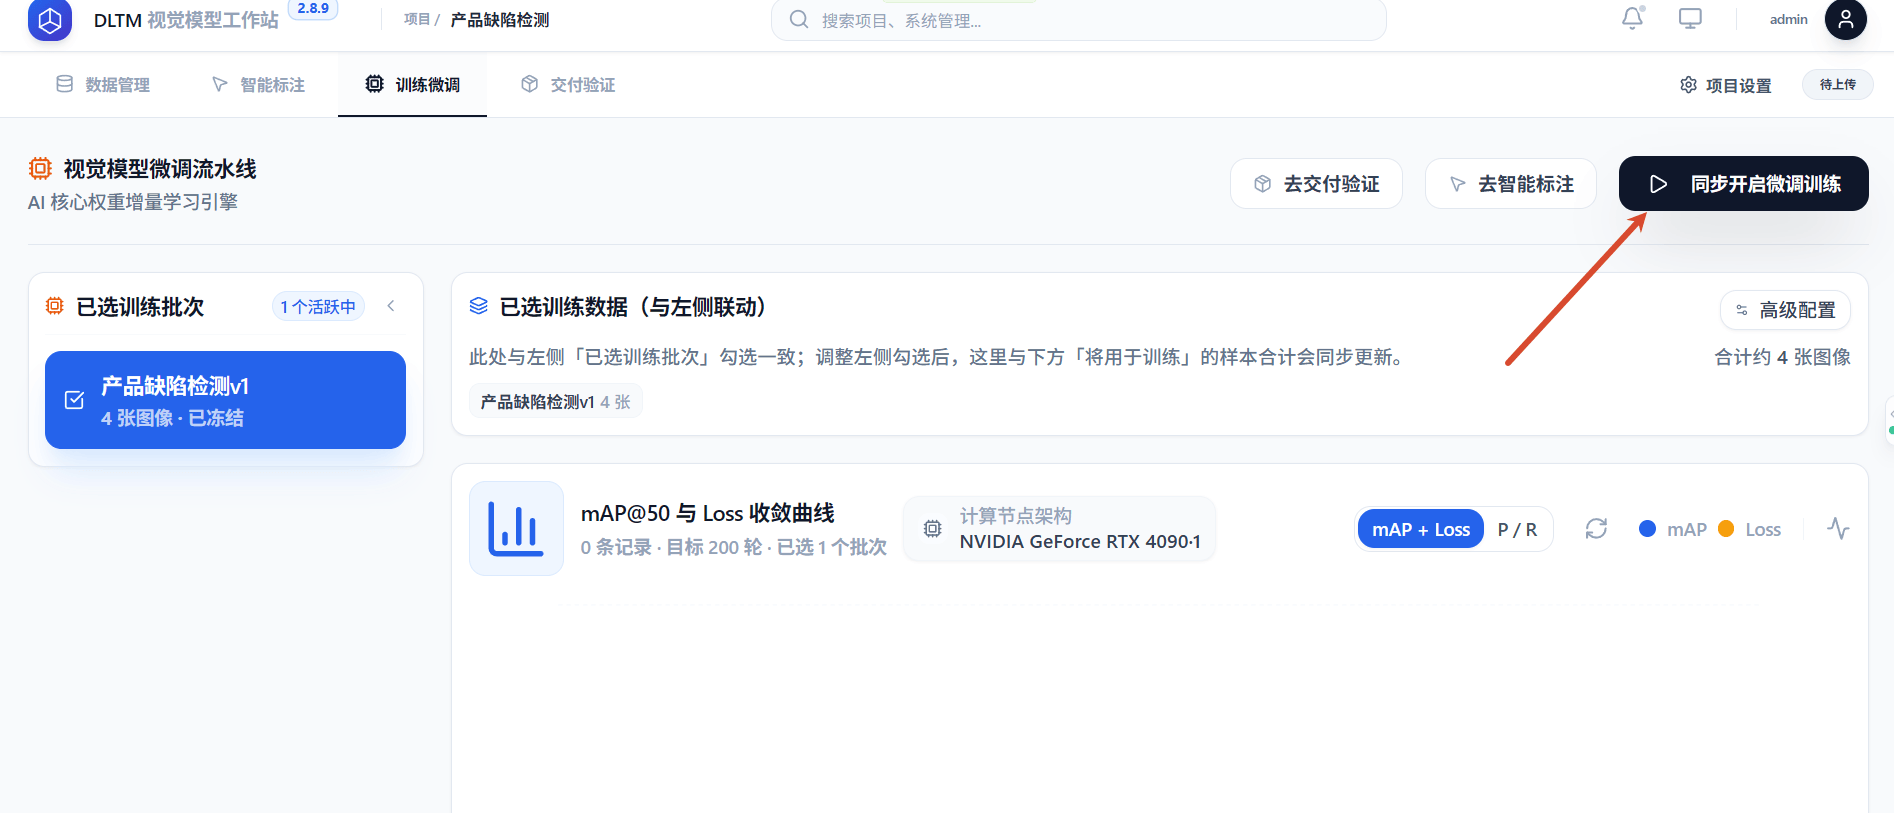
私有化本地化AI模型训推工作站DLTM建议按“点位+时段+场景”建批次,项目总资产规模与当前选中批次规模在资产管理中心一目了然。误报样本回流时,新难例单独建批归档、和初始数据区分,训练时勾选“初始批次+难例批次”,模型既认识现场整体,又在边界上被重点学习——这正是“越用越准”的数据来源。
六、给数据管理定三条规矩
落地建议:第一,按“点位+时段+场景”建批次,命名统一,避免日后对不上;第二,边界样本(逆光、遮挡、小目标)单独成批,重点人工复核;第三,每训一版就冻结对应数据集,留作基线。三条规矩不复杂,却能让模型迭代从“凭记忆”变成“凭记录”。
小结
模型会被版本管理记住,数据也该被资产管理中心记住。自动化AI算法训练服务器DLTM用批次化把训练数据管成可追溯的资产,让每一次训练都站得住、说得清、回得去。

 浙公网安备 33010602011771号