
自动化AI算法训练服务器DLTM版本管理与持续迭代,让AI越用越聪明
不少人把“训练AI模型”理解成一次性工程:训一版、上线、完事。可真实业务是流动的——新品不断上市,缺陷类型持续演化,现场环境悄悄变化。一个“训完即定型”的模型,用上半年往往就开始力不从心。
一、为什么“训完”只是开始
传统项目里,模型交付给客户就结束了,后续效果衰减没人管。可业务不会停:产线换了批次,光照随季节变,新的异常品类出现。这些变量一点点侵蚀模型的准确率,等发现时往往已经误判了一阵子。
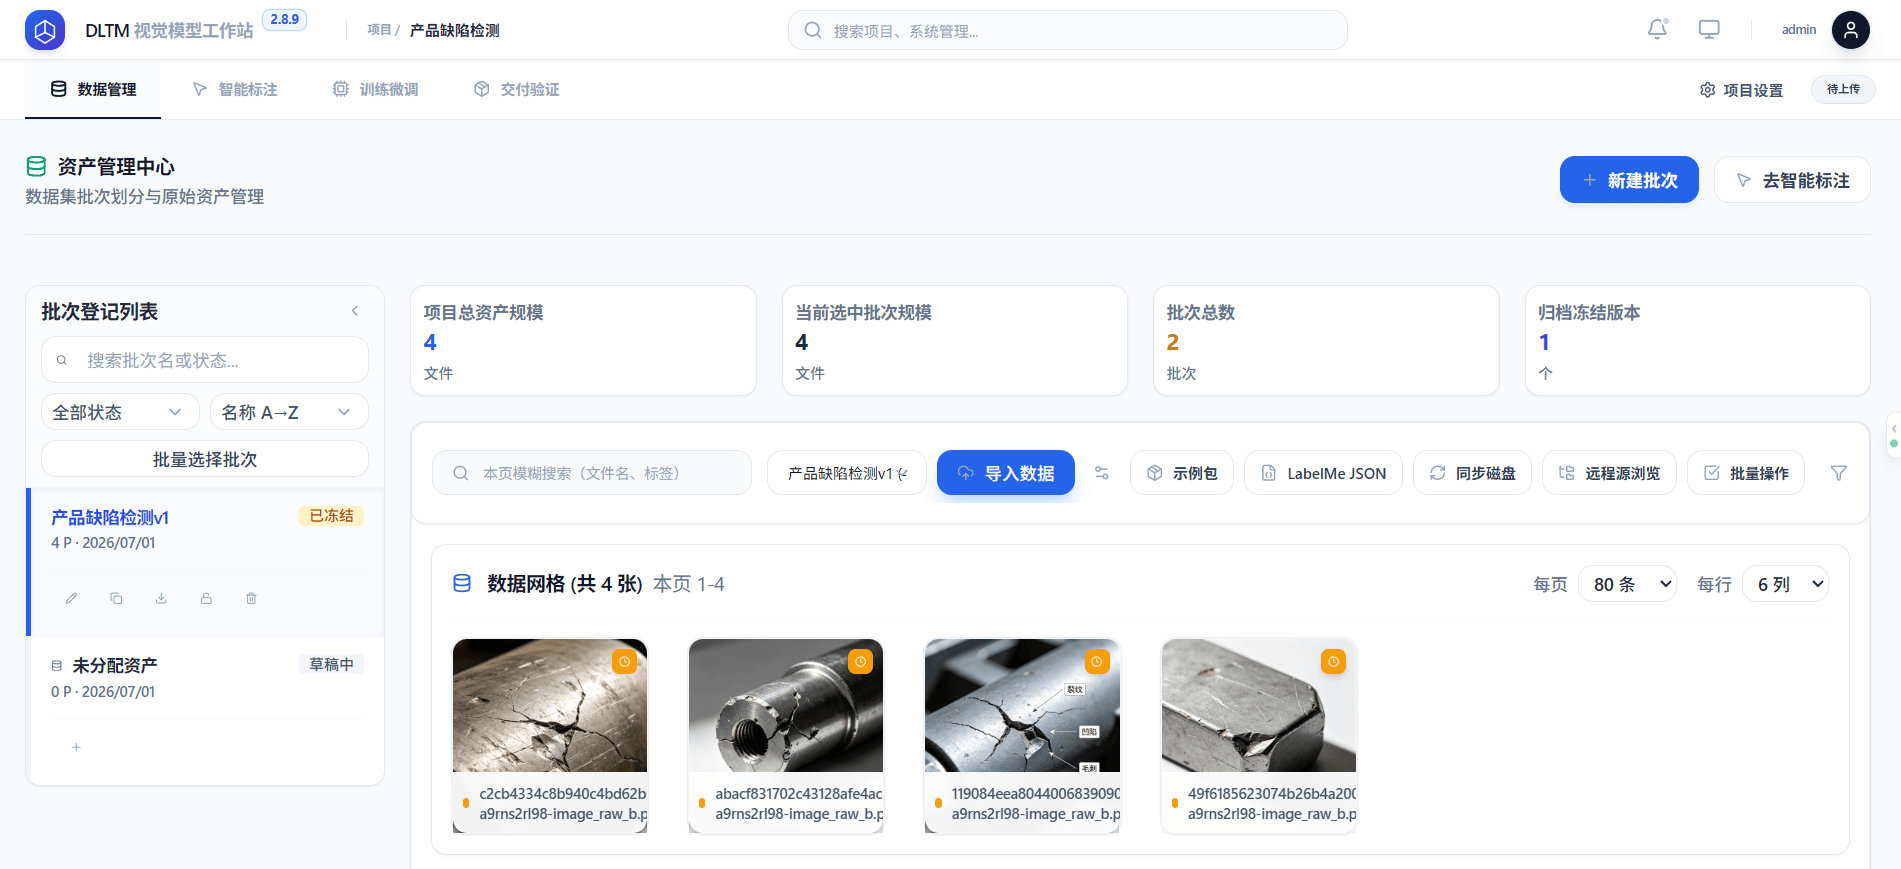
私有化本地化AI模型训推工作站DLTM的产品观是“模型是活的能力,不是死的文件”。从数据上传的那一刻起,模型就被纳入可管理的生命周期:谁训的、用的哪批数据、对应什么业务场景,全部可追溯。这种可追溯,是持续迭代的前提——你才知道这一版和上一版差在哪、为什么变好或变差。
二、版本管理:每一次训练都留痕
深度学习推理工作站DLTM支持模型版本管理,每一轮训练都可以保存为一个版本,并做性能对比。你可以并排看V1、V2、V3的准确率、召回率,判断新版到底有没有真进步,而不是凭感觉“觉得更好了”。
当模型用于质控、医疗这类严肃场景,监管部门或内部审查常要求说清“当前模型基于什么数据、哪一版”,版本记录就是现成的证据链。对数据敏感的行业,所有样本与版本都留在企业自有环境,审计也方便。

持续迭代还能避免另一种陷阱:模型悄悄退化却无人察觉。业务环境缓慢漂移时,准确率往往是“温水煮青蛙”式下滑,等肉眼发现已误判良久。版本管理配合定期推理测试,能把这种漂移变成可观测的指标——哪版开始掉点、对应哪批新数据,一目了然,从而在问题扩大前就补一版。
三、持续迭代:新样本喂进去,模型再长一截
迭代的入口很顺:推理测试发现某类目标总漏判,就针对性补采那类样本;标注修正后,重新训练一版;新版本通过测试,再部署上线。整个过程在同一个工作台里闭环,不必另起炉灶。
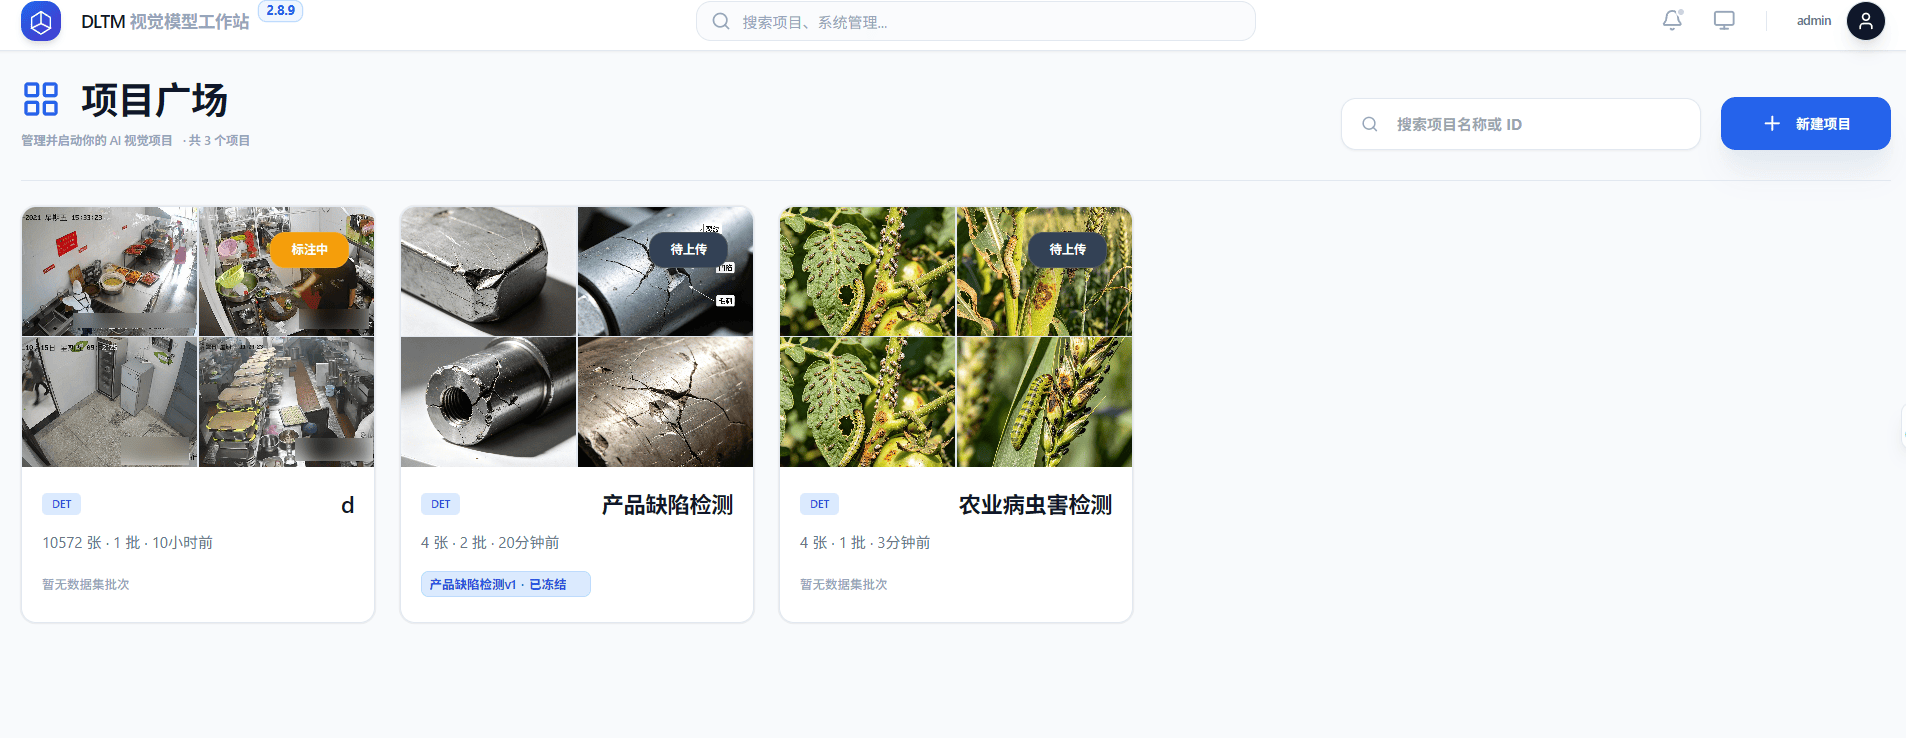
这正是“模型会长大”的含义——它不是静态交付物,而是跟着你的业务数据一起进化的伙伴。今天补一类缺陷,明天加一种新品,模型覆盖的面越来越广、判得越来越准。对长期运营的产线、园区、院区来说,这种“越用越聪明”的属性,比一次性高准确率更有价值。
四、把“持续”做成机制,而非靠自觉
很多团队也知道该迭代,但往往不了了之——因为工具不支持、流程太重。本地大模型推理服务器DLTM把“持续”做成了低摩擦的机制:训练后台自动跑、完成主动通知、版本自动留痕、导出一键完成。迭代的每一步都不必大动干戈,自然就容易坚持下来。
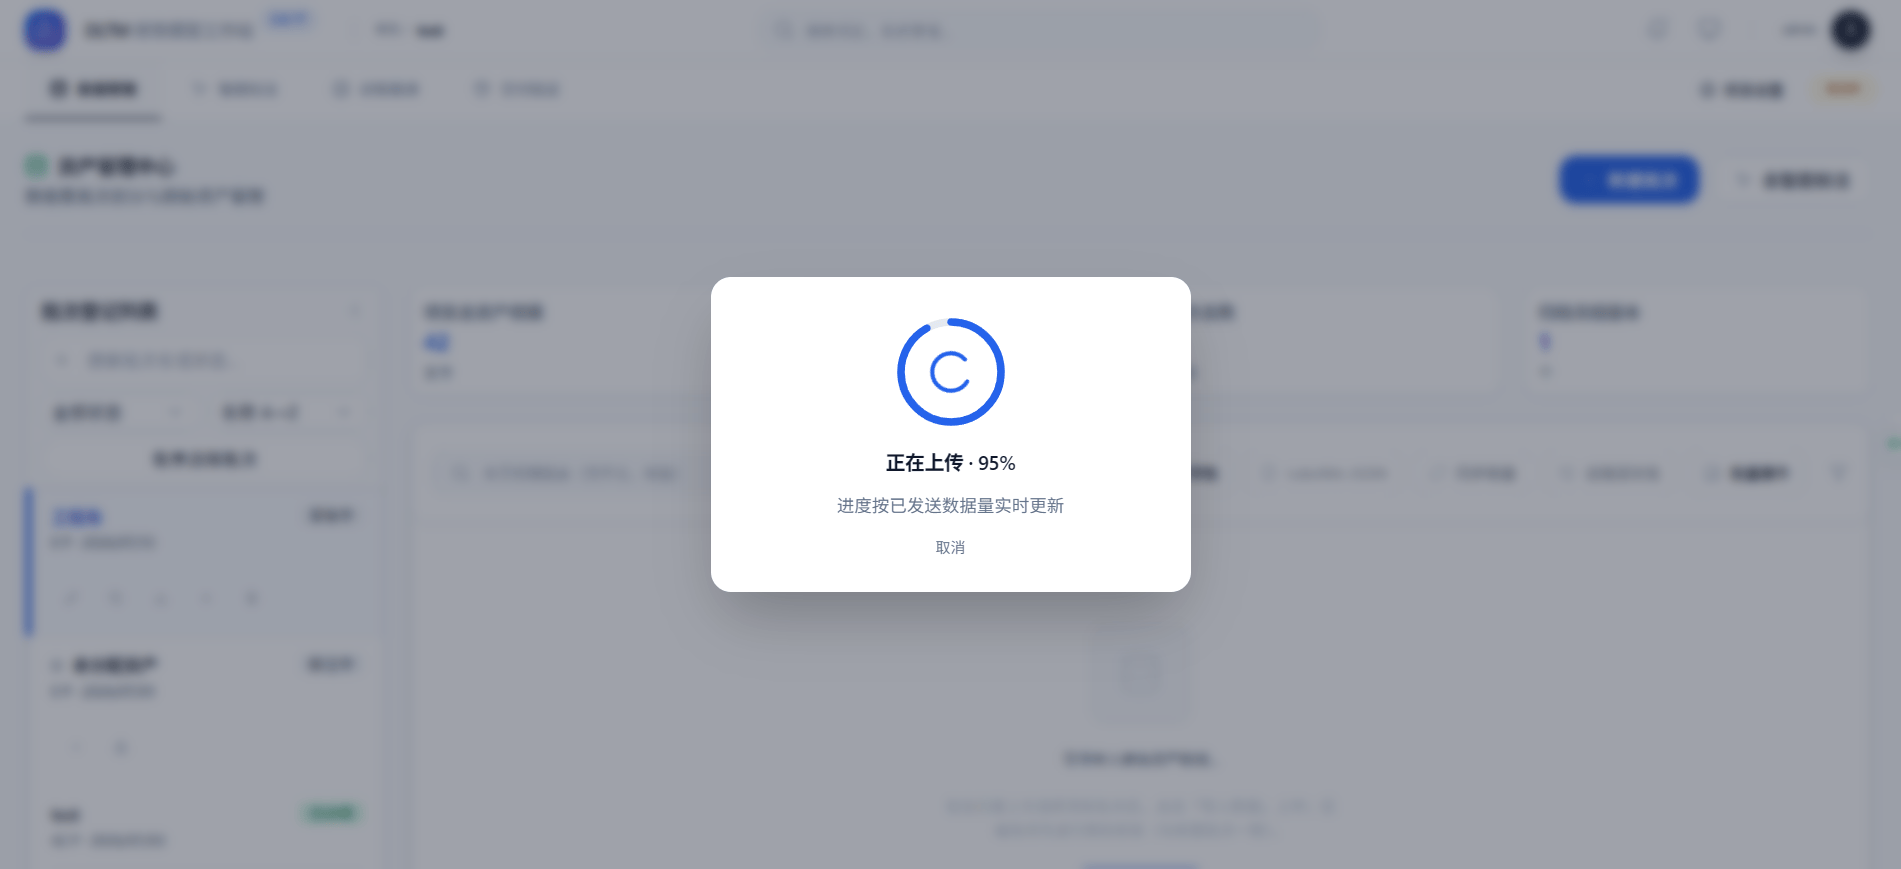
当迭代成本足够低,AI就从“项目”变成了“习惯”:团队会自然地用新样本喂模型,像给系统打补丁一样平常。这种飞轮转起来,竞争对手很难靠一锤子买卖追上。
结尾:AI不是交付终点,而是生长起点
判断一个AI平台好不好,不该只看它训出的第一版模型多准,而要看它能不能让模型持续变好。AI大模型训练工作站DLTM用版本管理与可追溯的迭代机制,把“模型会长大”从口号变成可操作的日常:每一次新样本,都是模型长高一截的机会。
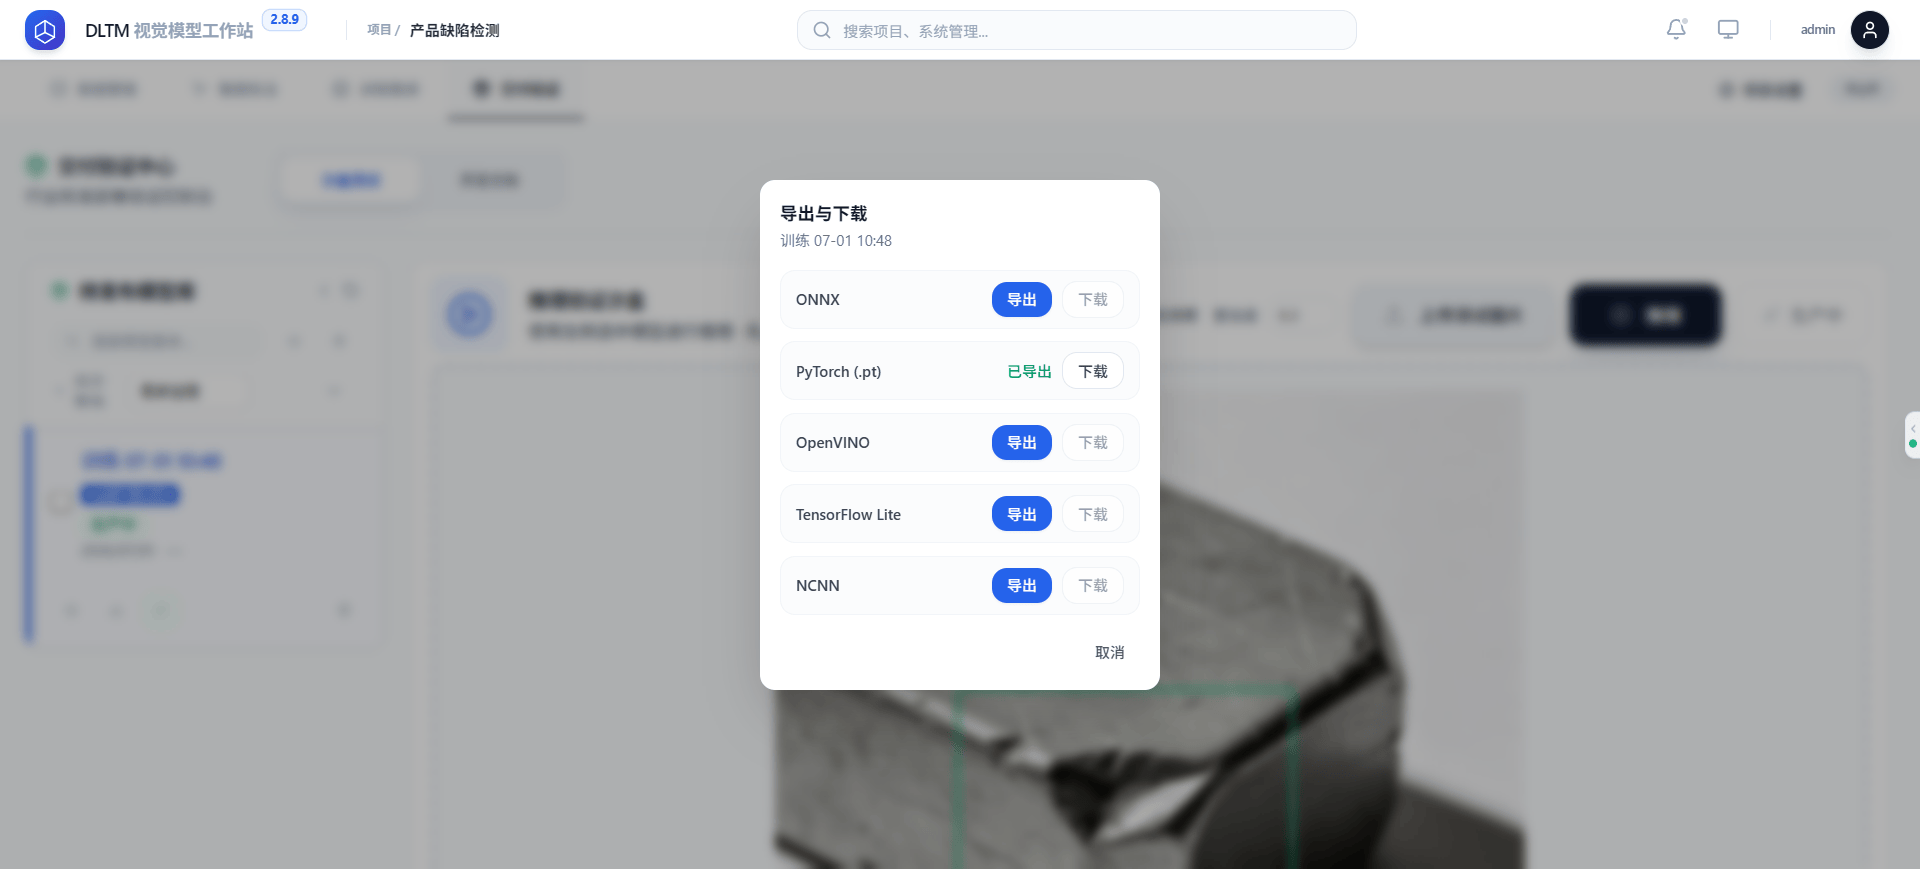
企业的智能资产,不该是一份会过期的模型文件,而该是一棵能持续抽枝的树。自动化AI算法训练服务器DLTM让这棵树,种在你的业务数据里,越长越合身。

 浙公网安备 33010602011771号