
低门槛AI算法训练:自动化AI算法训练服务器DLTM如何把中小企业的AI门槛砍到最低
“我们想用AI,但一是没算法人才,二是没那么多数据,三是预算有限。”这几乎是中小制造企业在智能化面前最真实的犹豫。AI听起来很美,落地却像道高墙:招人贵、采数据慢、买GPU集群更是天文数字。
一、中小企业在AI面前的三道墙
第一道是人才墙:深度学习、Python、GPU驱动、推理环境……这些词天然把非技术团队挡在门外。
第二道是数据墙:听说要“几万张图”才能训好,团队立刻觉得遥不可及。
第三道是成本墙:养算法团队、采数据、买算力,任何一项单独拎出来都够中小团队犹豫半年。
这三道墙叠在一起,就成了“想用但不敢动”的僵局。很多中小企业不是不需要AI,而是被门槛劝退在了门口。
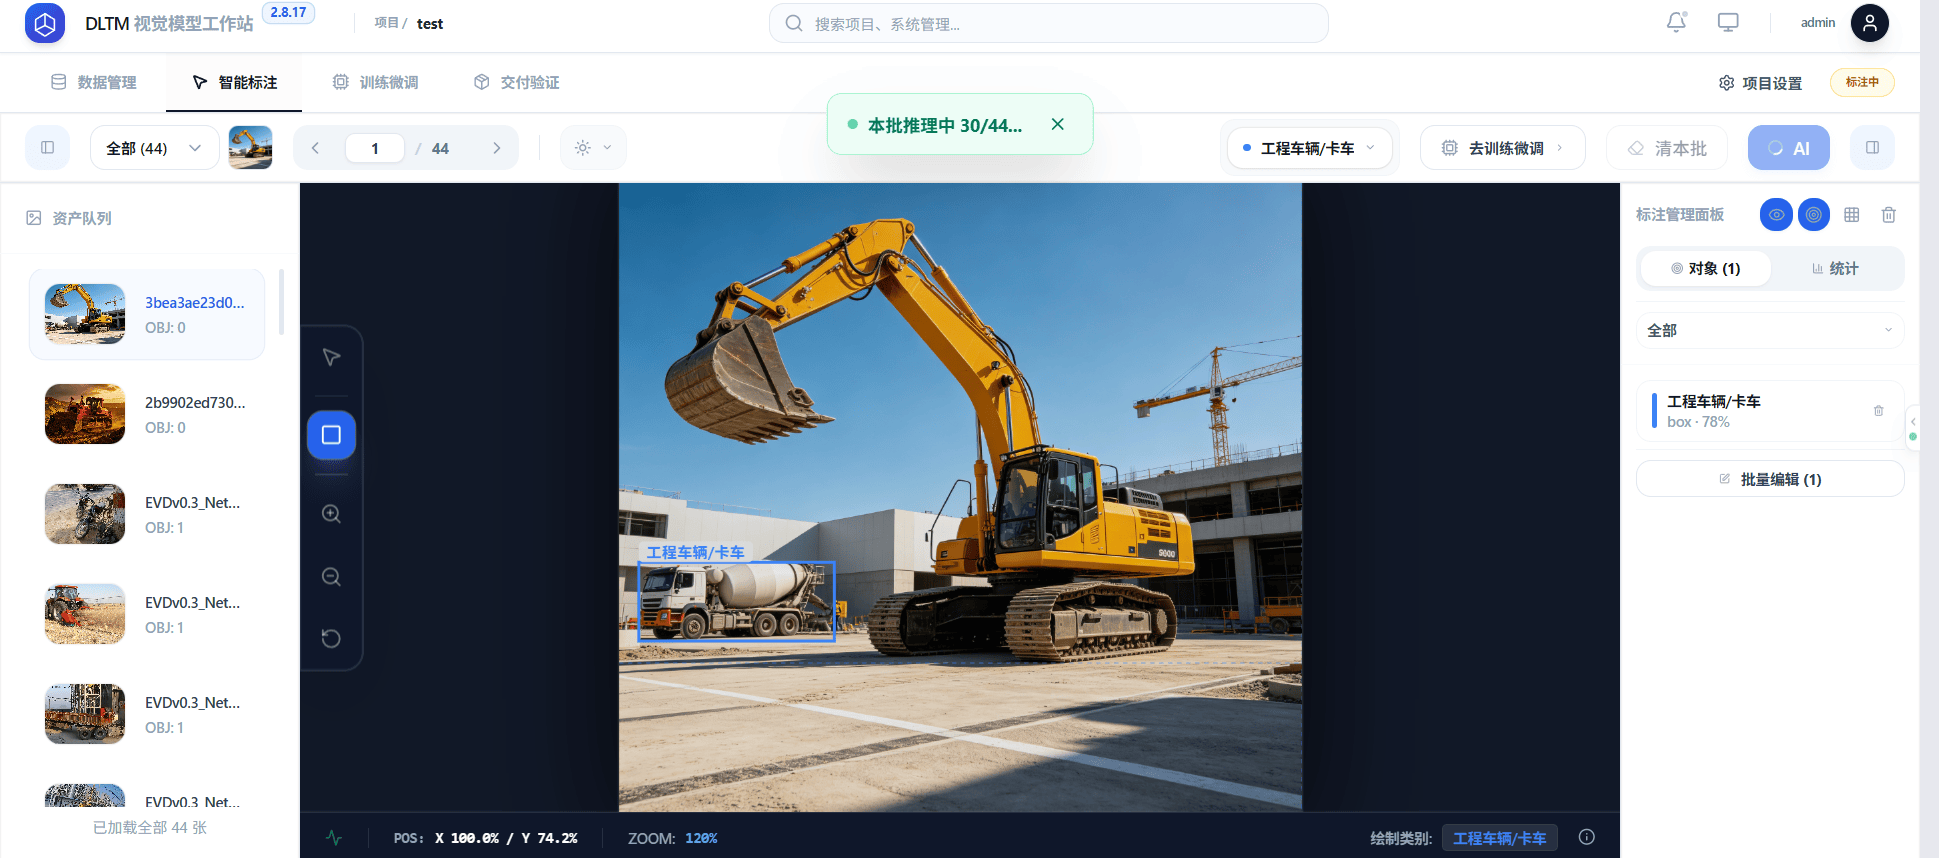
更现实的是,“等条件齐了再上”本身就有机会成本。竞品可能先用AI把质检成本压下来、把交付周期缩短,你的犹豫期就是别人的领先期。低门槛的意义,就是让你不用等“完美条件”,先用最小代价跑通一个场景,把主动权抢回来。
二、低门槛从哪来:小样本也能训
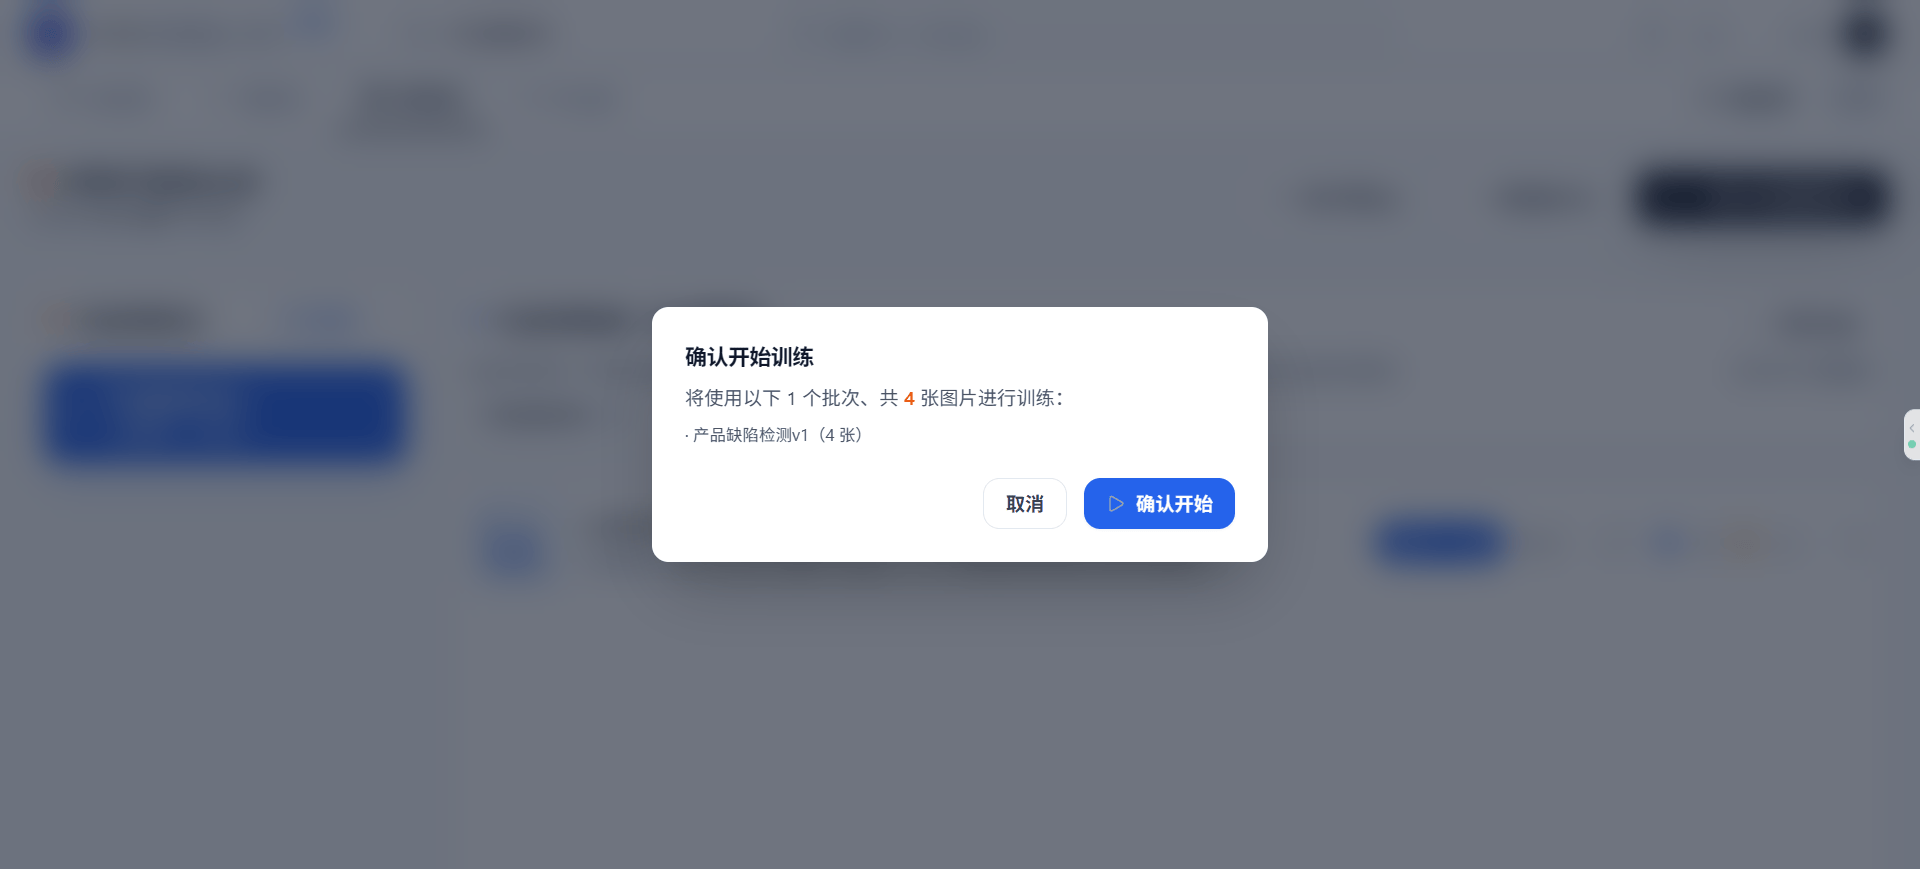
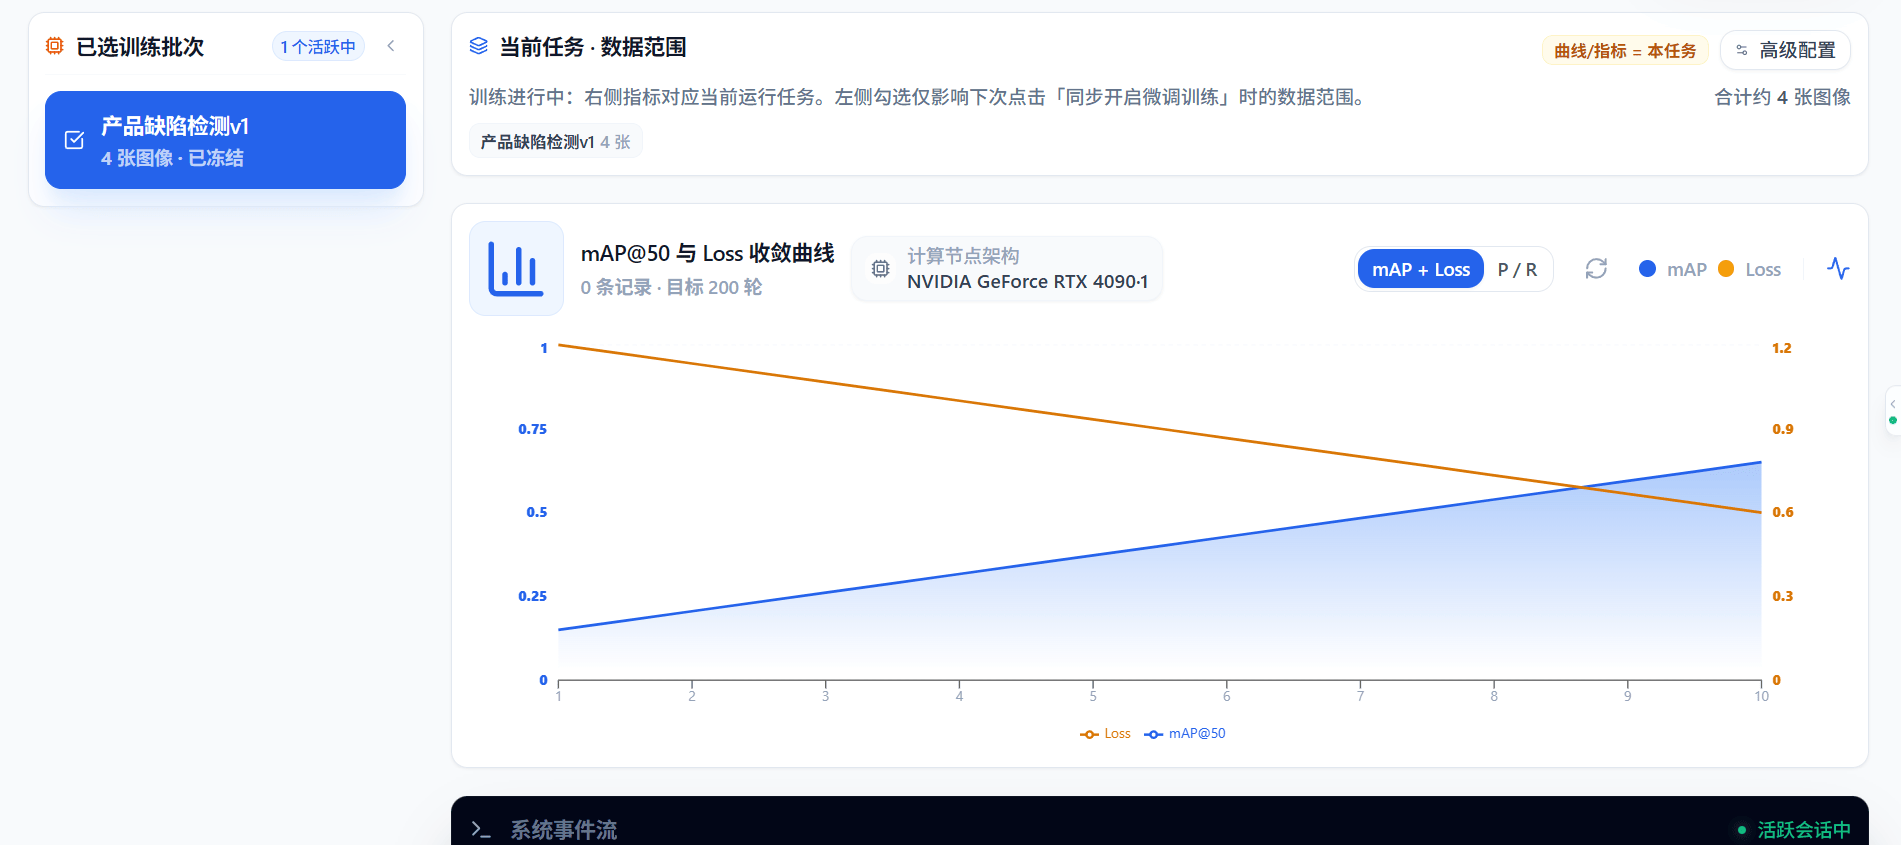
AI大模型训练工作站DLTM对“数据墙”的回应很实在:你不需要几万张图起步。以“托盘歪斜检测”为例,仓库只需拍摄500–2000张正常与歪斜托盘的对比照片,在企业AI算力工作站DLTM中标注“正常/歪斜”,一键训练,几小时到一天内就能得到一个可用模型——全程不需要算法工程师介入。
为什么小样本也能训?
- 因为AI模型私有化部署平台DLTM把重活交给了系统:内置的AI自动优化参数,帮你选架构、调超参,业务人员用默认设置就能开训;
- AI辅助标注又能减少约70%的人工标注工作量,让“凑够标注”这件事不再靠人海战术。换句话说,平台把“专家才知道怎么调”的经验,沉淀成了默认能力,小白用户直接点“开始训练”即可。
三、一站式闭环:省掉“反复切换”的隐性成本
中小企业最耗不起的,不是明面上的钱,而是来回折腾的时间。传统做法里,数据在一个工具里清、标注在另一个软件里做、训练又要搭环境、部署还得写接口——每切换一次,就多一次学习成本和出错概率。
私有化本地化AI模型训推工作站DLTM把数据准备、智能标注、模型训练、推理测试、导出部署收进同一个工作台,全生命周期在单一平台内闭环。
你不用在多个独立软件间反复横跳,也不用为了“把模型接进系统”再找外包写一遍接口——确认效果后系统生成标准API,直接对接现有业务系统。这种“不切换”本身,就是在为小团队省最贵的东西:人力与时间。
四、一个可复制的起步路径
对想试水的中小企业,DLTM提供了一条低风险的路径:
挑一个窄场景:别一上来就“全厂智能化”,先选一个重复、高频、规则清楚的点,比如托盘歪斜、零件错装、仪表读数。
现场拍一批图:用现有手机或工业相机,拍 500–2000张对比样本,比“等数据”快得多。
标注加训练:用 AI辅助标注提速,一键开训,后台自动跑,完成系统通知你。
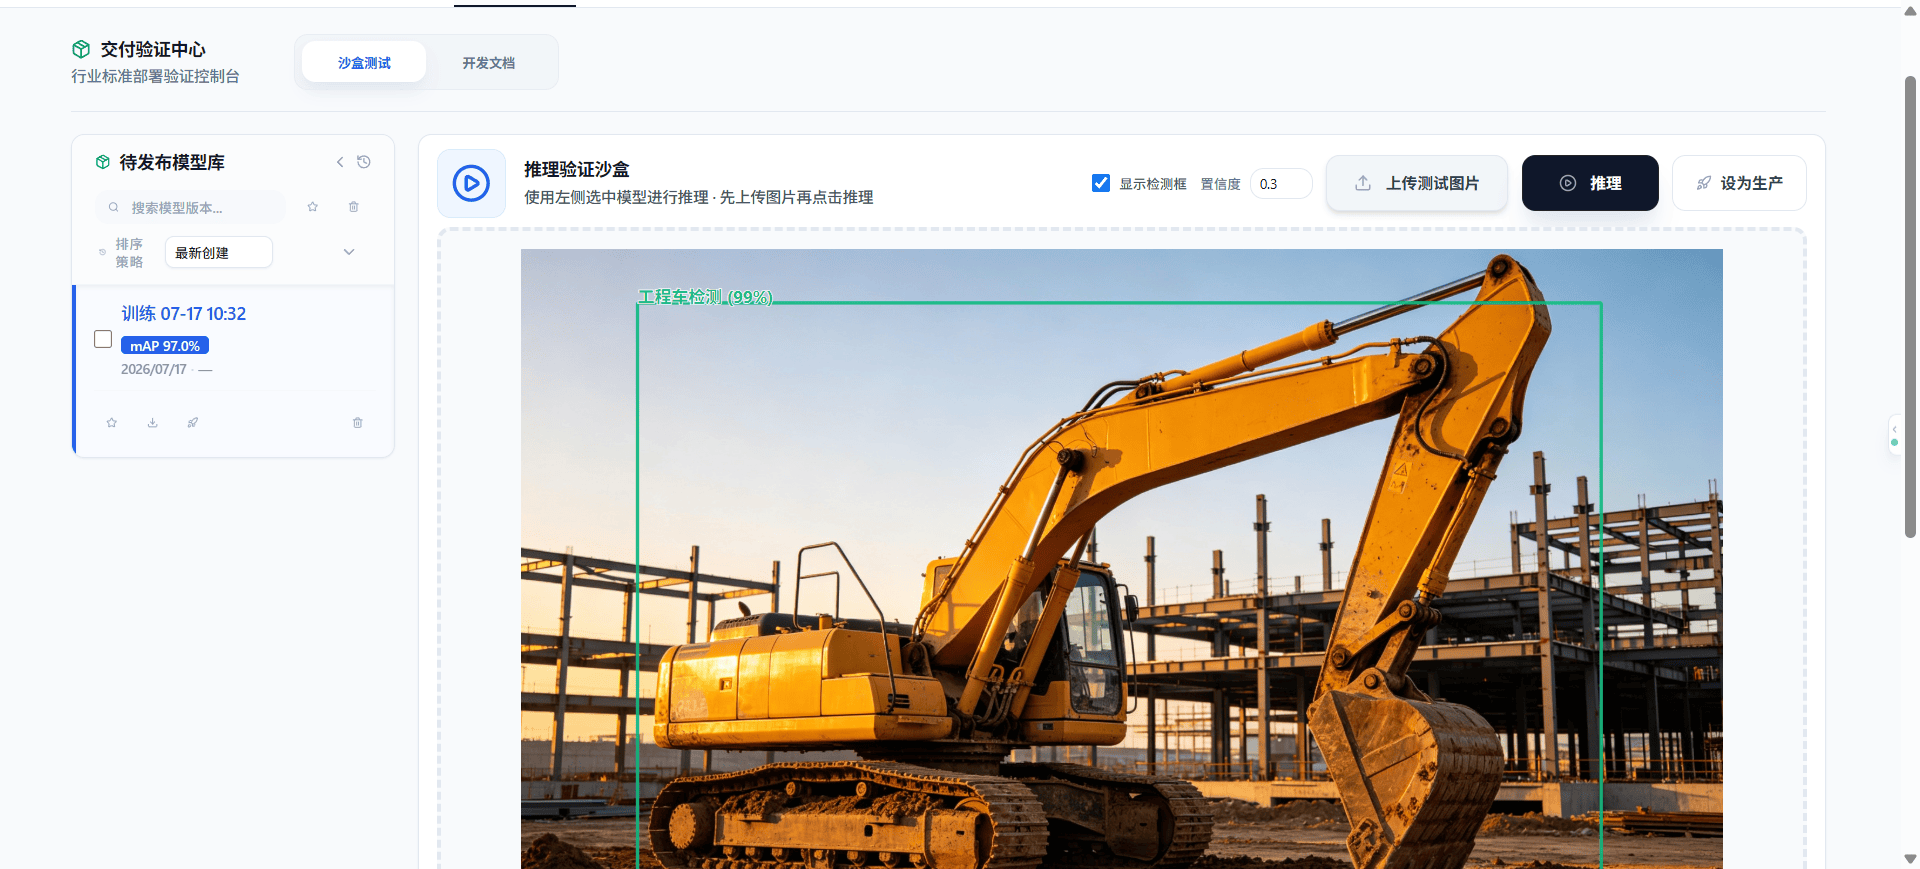
先测再上:用推理测试看准确率、召回率,确认无误再部署成 API。
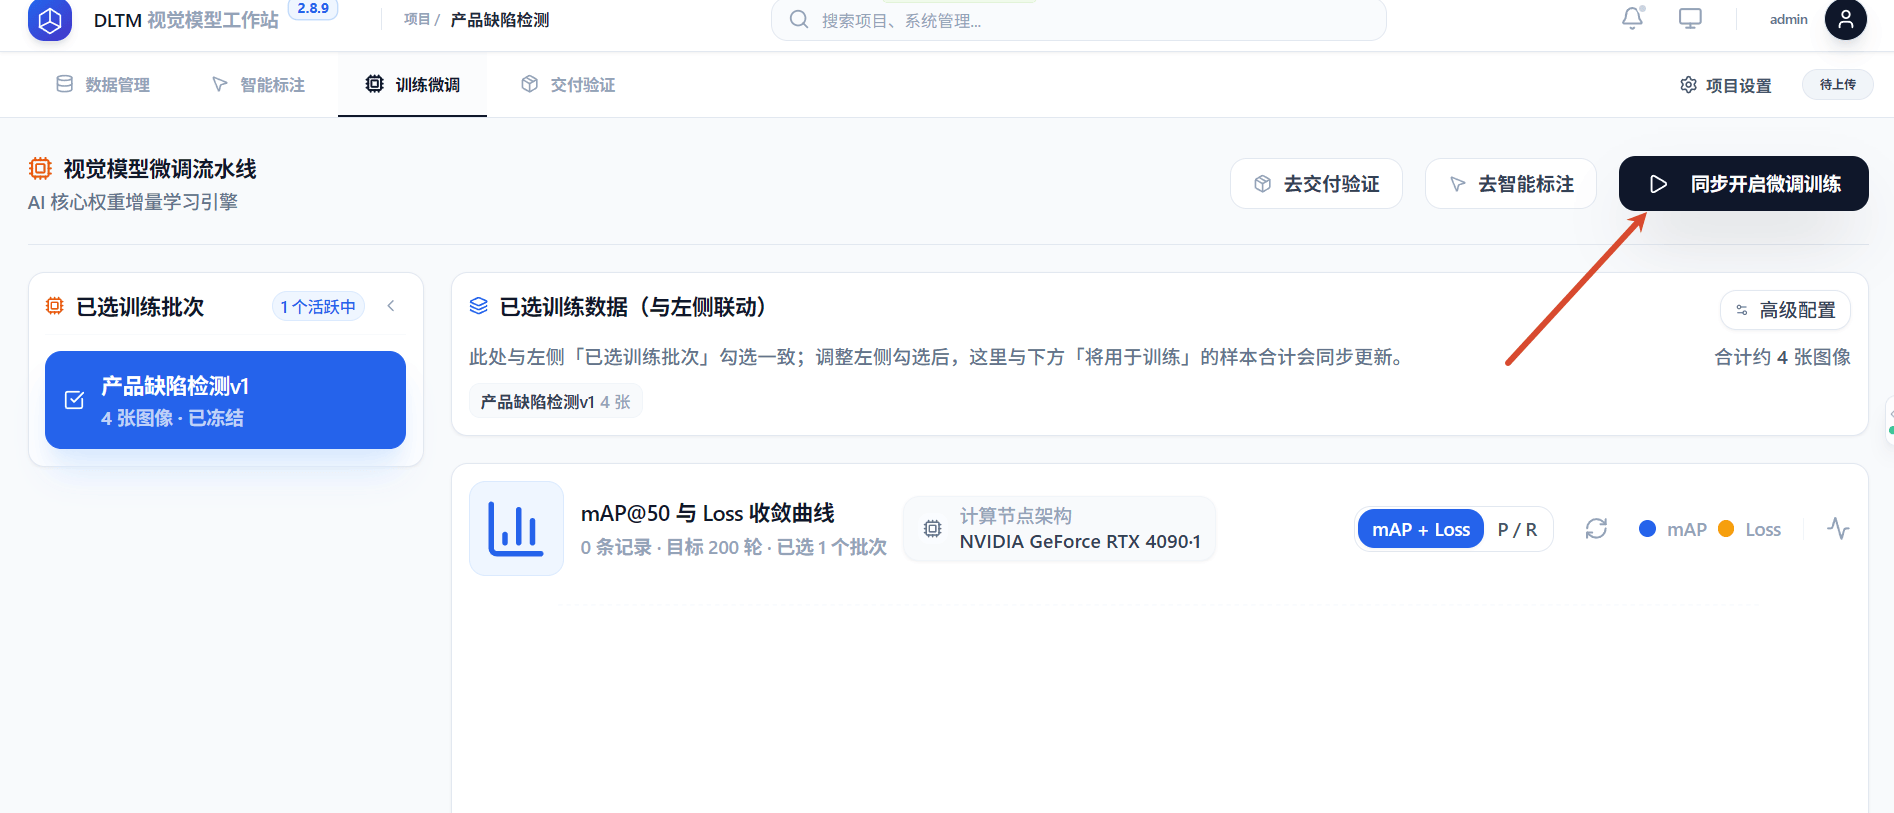
这条路径的关键在于“小切口、快验证”:先用一个低成本场景跑通闭环,拿到效果,再决定是否扩到更多环节。它把AI从“大工程”降成了“小实验”,失败代价可控,成功则可复制。
结尾:小团队也能有自己的AI
AI不是大厂的专利。当训练一个专属模型只需要一组现场照片、一个可视化工作台、几天时间,中小企业和头部企业站在了同一条起跑线上。
自动化AI算法训练服务器DLTM砍掉的,不只是技术和数据的门槛,更是“我们这种公司用不起AI”的心理门槛。别等人才齐了、数据够了、预算足了才行动。从500张图起,先让一个场景跑起来——属于你自己的AI,可能比想象中来得更快。

 浙公网安备 33010602011771号