
标注效率提升:私有化本地化AI模型训推工作站DLTM智能标注引擎如何把人工从框框里解放出来
在AI模型训练链路里,有个环节最枯燥也最吃人力——数据标注。给成千上万张现场图片里的人、车、安全帽、烟火画框打标签,纯手工做起来枯燥且昂贵。自动化AI算法训练服务器DLTM把智能标注作为四大引擎之一,用“AI批量预标注+人工校验”的组合,把这件事的效率拉高了,也让“业务人员也能训模型”从前提变为现实。
一、标注,AI落地里最被低估的苦活
很多人以为训练模型最难的是调参,其实最耗时的是准备高质量数据。一个工地安全帽检测模型,往往要几千张带框的样本。如果全靠人工逐张框,一个人一天标注几百张已是极限,项目周期和人力成本都被卡在这里。标注质量还直接决定模型上限——框得不准,模型就学偏。可以说,标注是AI落地里最被低估、却最不能省的苦活。
二、AI批量预标注+人工校验
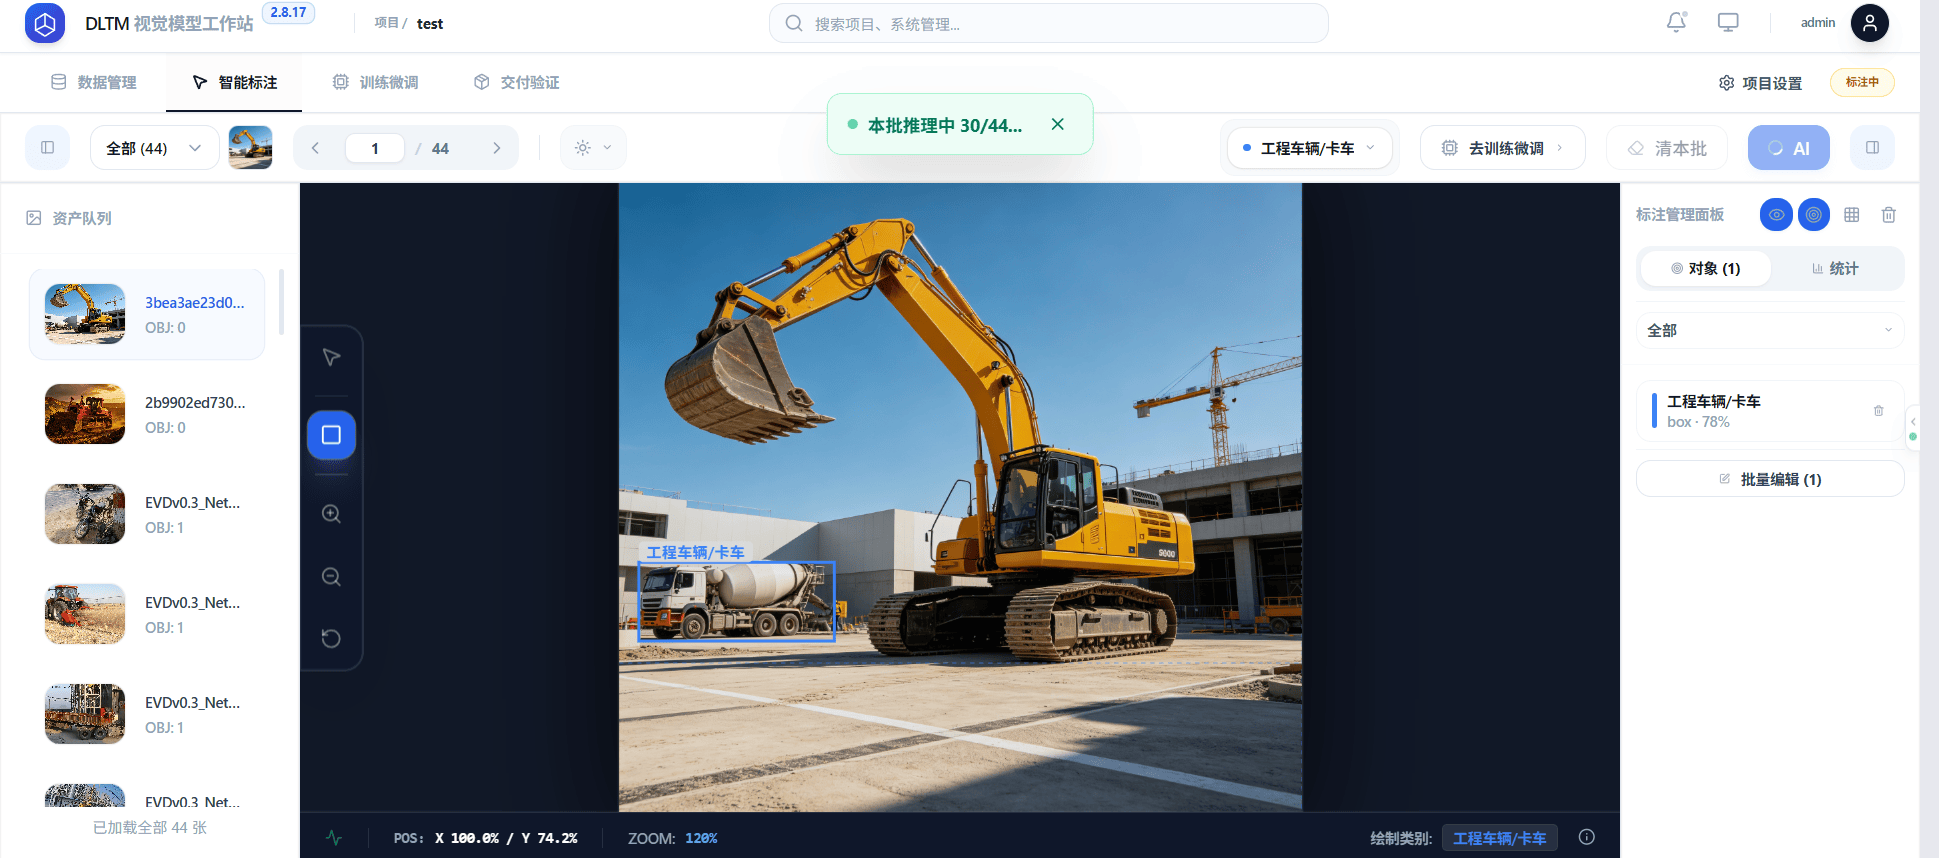
自动化AI算法训练服务器DLTM的智能标注引擎先用内置大模型对图片做批量预标注,把绝大多数目标自动框出来;人工只需要做纠偏和补漏——把框歪的拉正、把漏掉的补上。
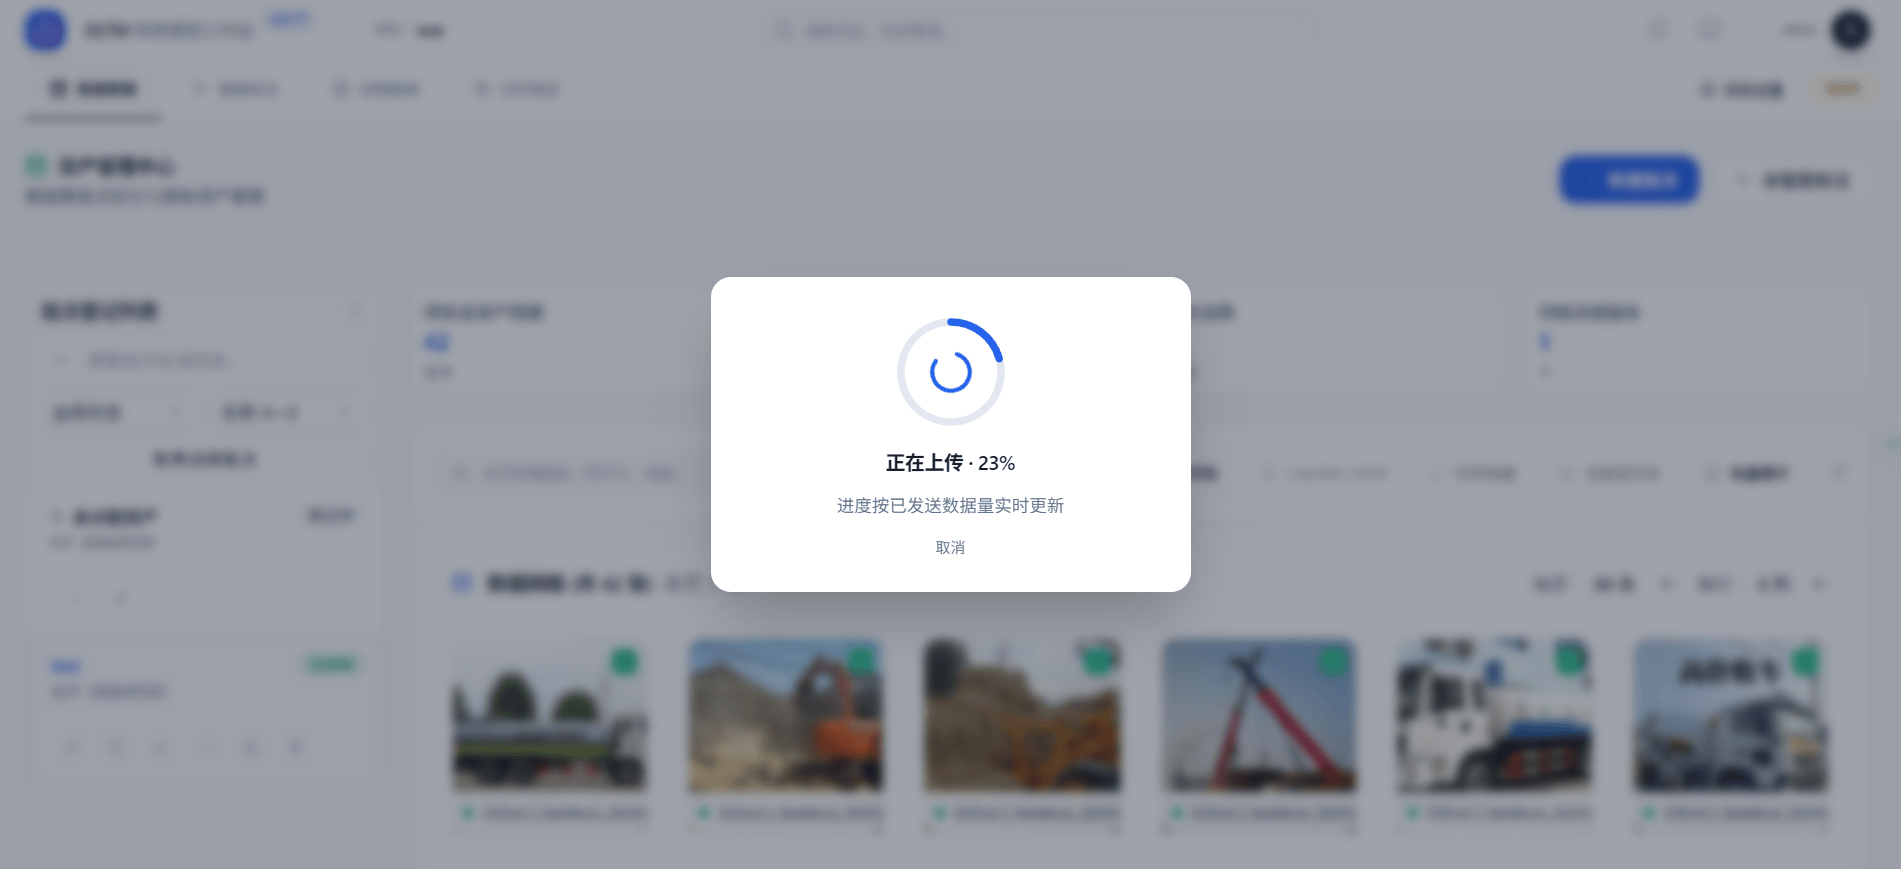
人工从“从零画框”变成“检查校对”,工作量大幅缩减,效率提升约10倍。这正是AI大模型训练工作站DLTM六大产品优势里“省人力”的来源,也是零代码训练能跑通的前置条件:没有高效标注,业务人员根本攒不出数据集。
三、多源数据接入,标注不被格式卡住
现场数据形态多样:单张图片、压缩包等。企业AI算力工作站DLTM的数据管理支持上传图片/压缩包快速攒数据集。
数据进来后在资产管理中心按批次登记,本页模糊搜索、批量选择、归档冻结,管理井井有条。无论你手上是历史录像截图,还是新采集的样本包,都能顺畅进入标注环节。
四、批次管理让数据井井有条
企业私有化AI部署方案DLTM用“批次”组织原始资产:你可以按点位、时段、场景建不同批次,给每个批次标注状态(未分配、标注中、已冻结),项目总资产规模和当前选中批次规模一目了然。需要训练时勾选对应批次即可,不用在一堆散图里翻找。这种结构化管理,让“数据从哪来、训了什么”清晰可追溯,也为后续误报样本回流、版本迭代打下基础。
五、标注质量决定模型上限
再强的训练引擎,也救不回一堆乱标的数据。科研AI计算工作站DLTM把标注放在训练之前、作为独立可审计环节,正是提醒团队:先把数据做对,模型才可能对。
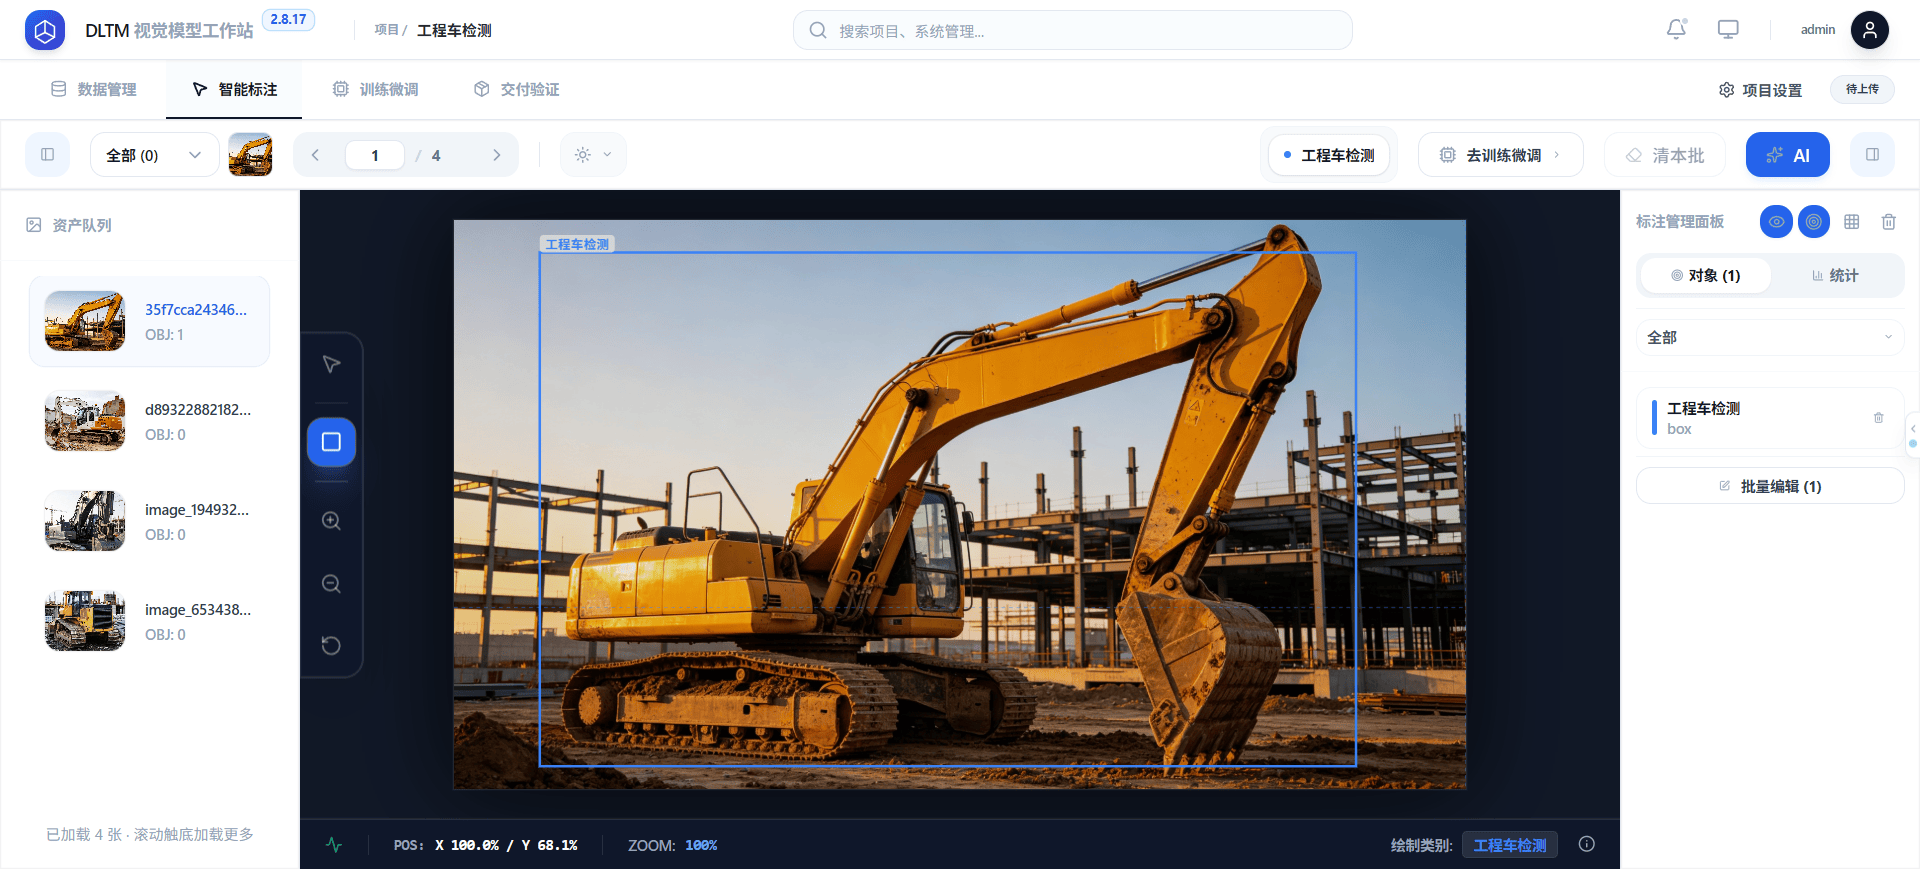
AI预标注解决“量”,人工校验解决“质”,二者结合,既快又准。建议对边界样本(逆光、遮挡、小目标)重点人工复核,这些恰恰是最能提升模型精度的难例。
六、标注与训练如何无缝衔接
标注不是孤立环节,它直接喂给训练。国产AI算力工作站推荐DLTM里标注完成的批次可直接勾选进入训练,样本、标签、划分一次性贯通,省去导出导入的繁琐。建议团队建立“标注即归档”的习惯:每批样本标注完就归入对应场景批次,并标注采集时段与点位,既方便当次训练,也为后续误报回流、版本对比留下干净的数据基线。标注规范越清晰,模型迭代越顺。
对边界样本(逆光、遮挡、小目标)重点人工复核,这些恰恰是最能拉开精度差距的难例,值得多花那几分钟。从人力看,10倍标注效率意味着同样预算下能攒出更大、更干净的数据集,而数据集规模与质量,正是模型精度的地基。
七、标注常见的三个误区
一是边界模糊:目标只露一半、被遮挡时,框到哪算哪容易前后不一致,建议团队定一份标注规范,统一“露多少算目标”。
二是类别重叠:比如“车辆”和“工程车”同时标,模型会混淆,应按实际管理粒度分层。
三是样本不均衡:某类目标样本极少,模型就学不好,要有意识补充少数类。

私有化AI开发与推理工作站方案DLTM的批次管理正好用来平衡各类样本量——按类别建批次、看每类资产规模,避免出现“大多数类撑死、少数类饿死”的数据倾斜。标注阶段多花十分钟定规范,训练阶段能省几天返工。
小结
把人从重复的画框劳动里解放出来,是AI训练平民化的第一步。自动化AI算法训练服务器DLTM智能标注引擎提高了效率,让中小企业也训得起自己的模型。

 浙公网安备 33010602011771号