
分类还是检测?一张表看懂自动化AI算法训练服务器DLTM模型训练工作站两大视觉任务怎么选
很多想做AI视觉的团队,第一步就卡在选型:“我到底该训练哪种模型?”DLTM作为一站式零代码平台,适配图像分类、目标检测两大主流视觉任务——但这两件事解决的完全是不同问题。选错了,模型再准也救不了业务。这篇文章用最直白的方式,帮你把这两个概念一次理清。
一、图像分类:判断“这是什么”
图像分类回答的问题是:这张图整体属于哪一类。它给整张图片打一个(或几个)标签,不关心目标在哪个位置、有几个。典型的用法是“定性”:这张胸片正常还是疑似?这个零件整体是良品还是次品?这块农田有没有病害迹象?
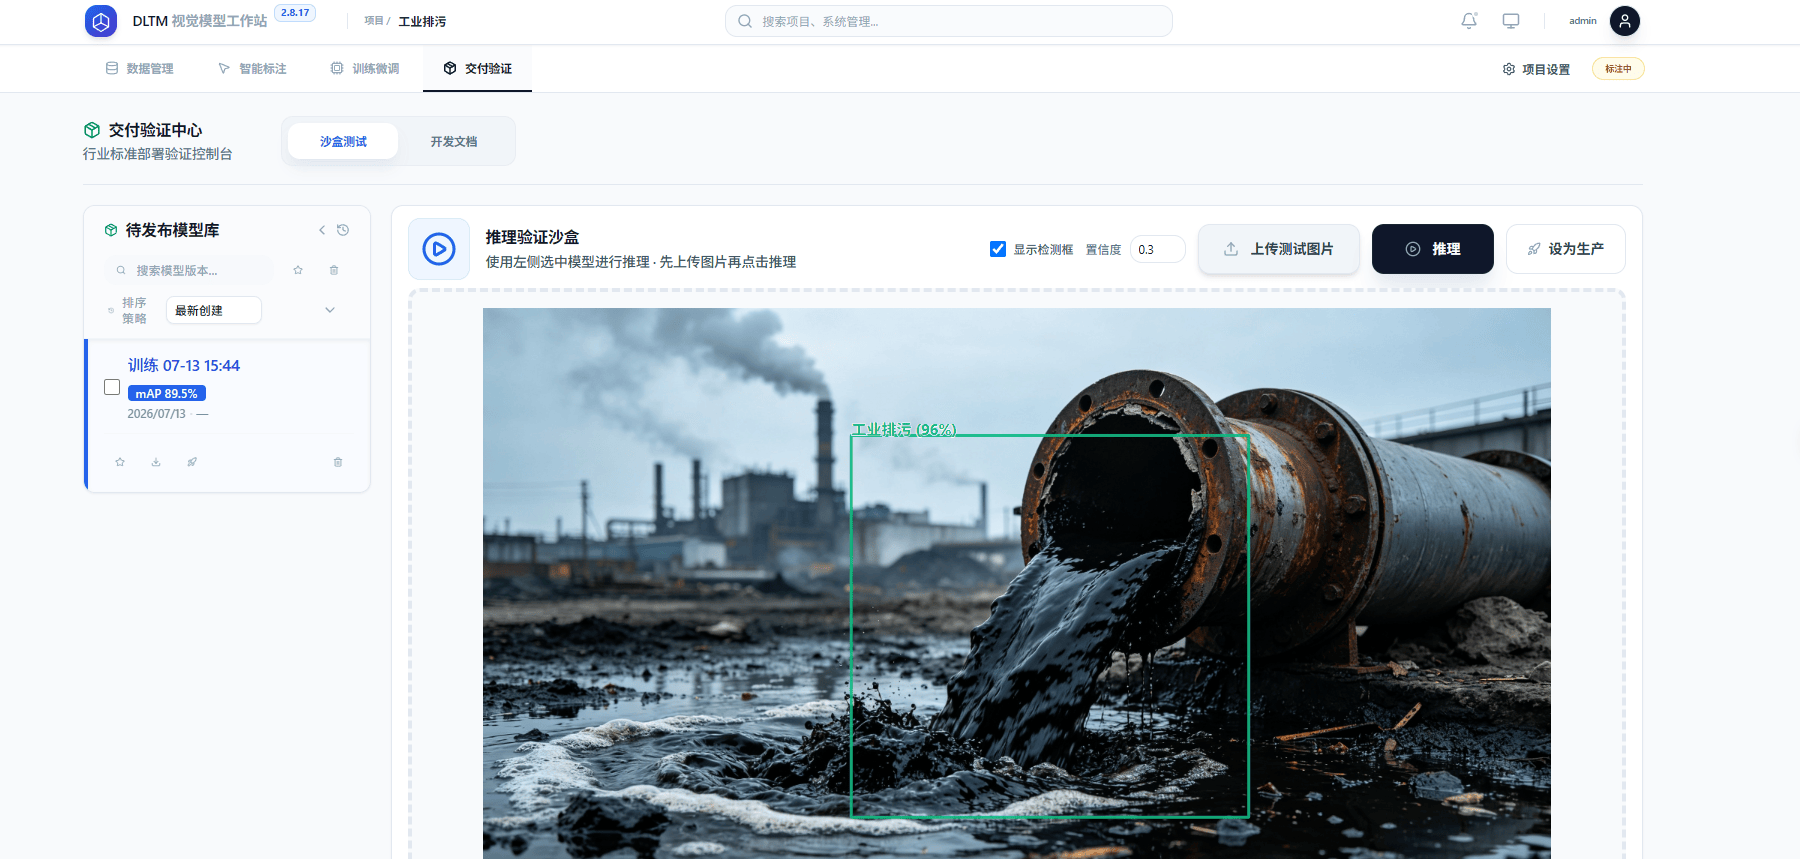
在AI模型私有化部署平台DLTM里做分类很直接:把同一类图片归到一起、贴上类别标签,一键训练即可。它适合“只要结论、不要位置”的场景——你关心的是“这张图归到哪一类”,而不是“缺陷在左上角还是右下角”。
二、目标检测:框出“它在哪、是什么”
目标检测比分类多走了一步:它不仅判断“是什么”,还要在图上框出“在哪里、有几个”。它会输出目标的包围框坐标加类别标签,适合需要精确定位的场景——产线上划痕、变形缺陷出现在哪个位置、尺寸多大;安防里入侵目标出现在画面哪一区域;农业中病害斑块分布在田块的哪些点。
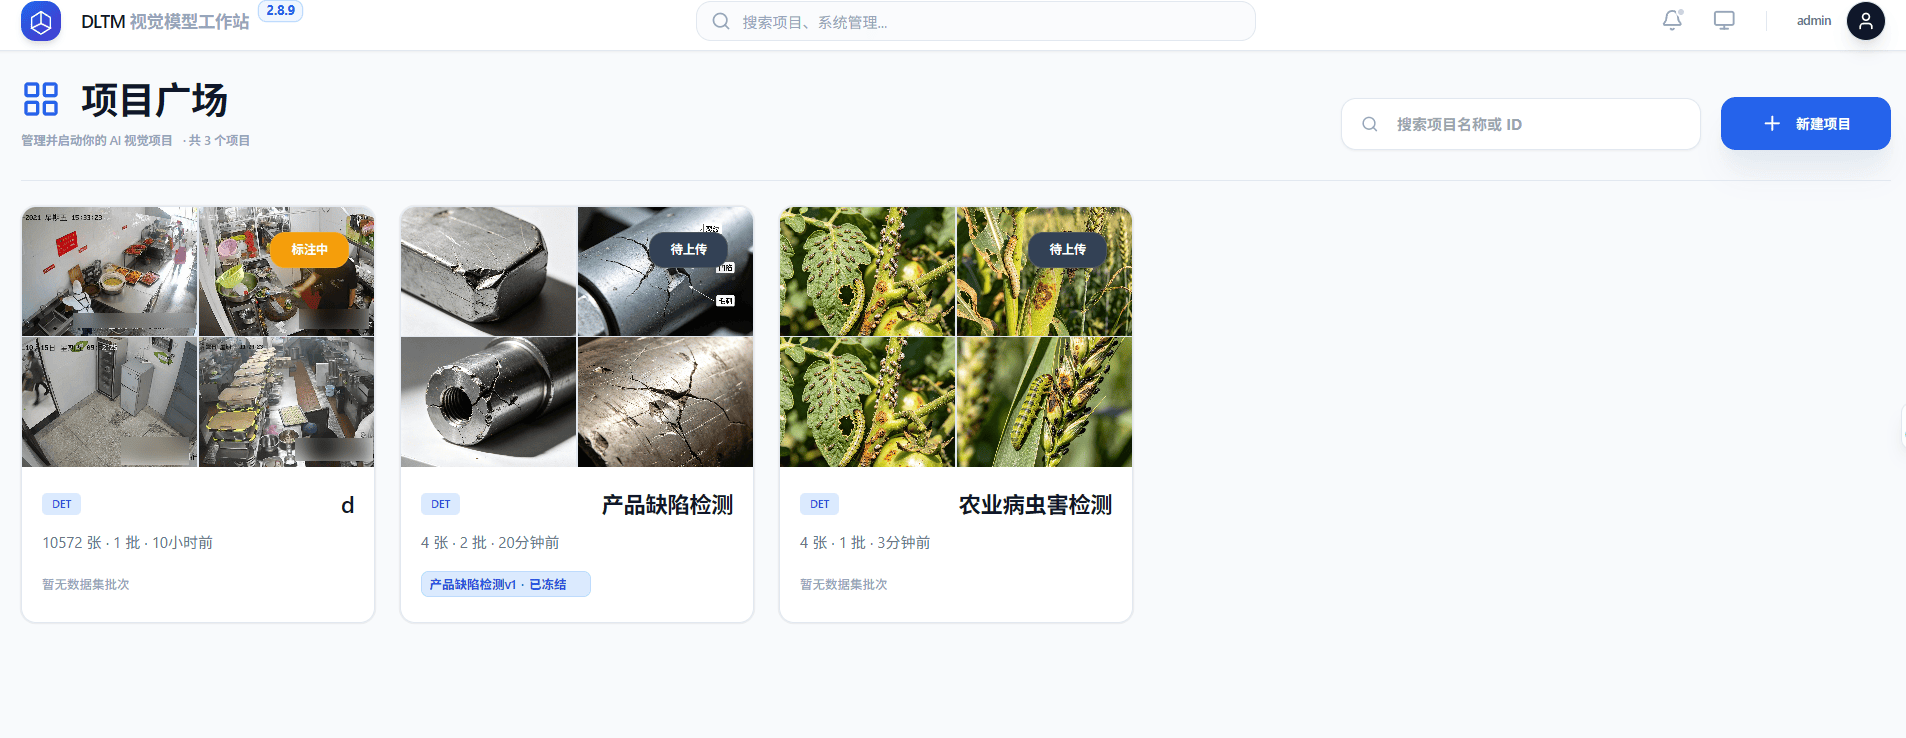
私有化本地化AI模型训推工作站DLTM支持的矩形框标注,正是为目标检测而生:在图片上画框、贴标签,告诉模型“这个框里是缺陷”。平台内置的AI辅助标注引擎能自动推荐框选区域并预填标签,减少高达70%的人工标注工作量,你只需确认与修正——这让目标检测最繁琐的“画框”环节大幅提速。
三、一张对照表,看清两者怎么选
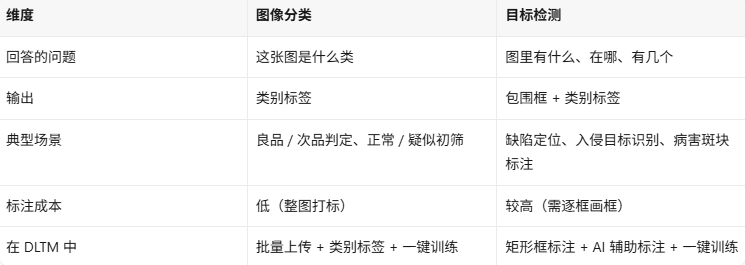
简言之:只要“结论”选分类,既要“结论”又要“位置”选检测。很多真实业务其实是组合使用——先用检测框出缺陷,再对缺陷区域做分类评级。

四、在深度学习推理工作站DLTM里,两种任务怎么做
无论选哪种任务,DLTM的流程是一致的:数据准备与资产管理(支持JPG、PNG、视频抽帧、ZIP批量导入,格式自动转换)→智能标注→一键训练(默认参数、后台自动运行、完成自动通知,实时监控损失与准确率曲线)→推理测试(单张或批量上千张,给出准确率、召回率与可视化结果)→一键部署为RESTful API或WebSocket服务。
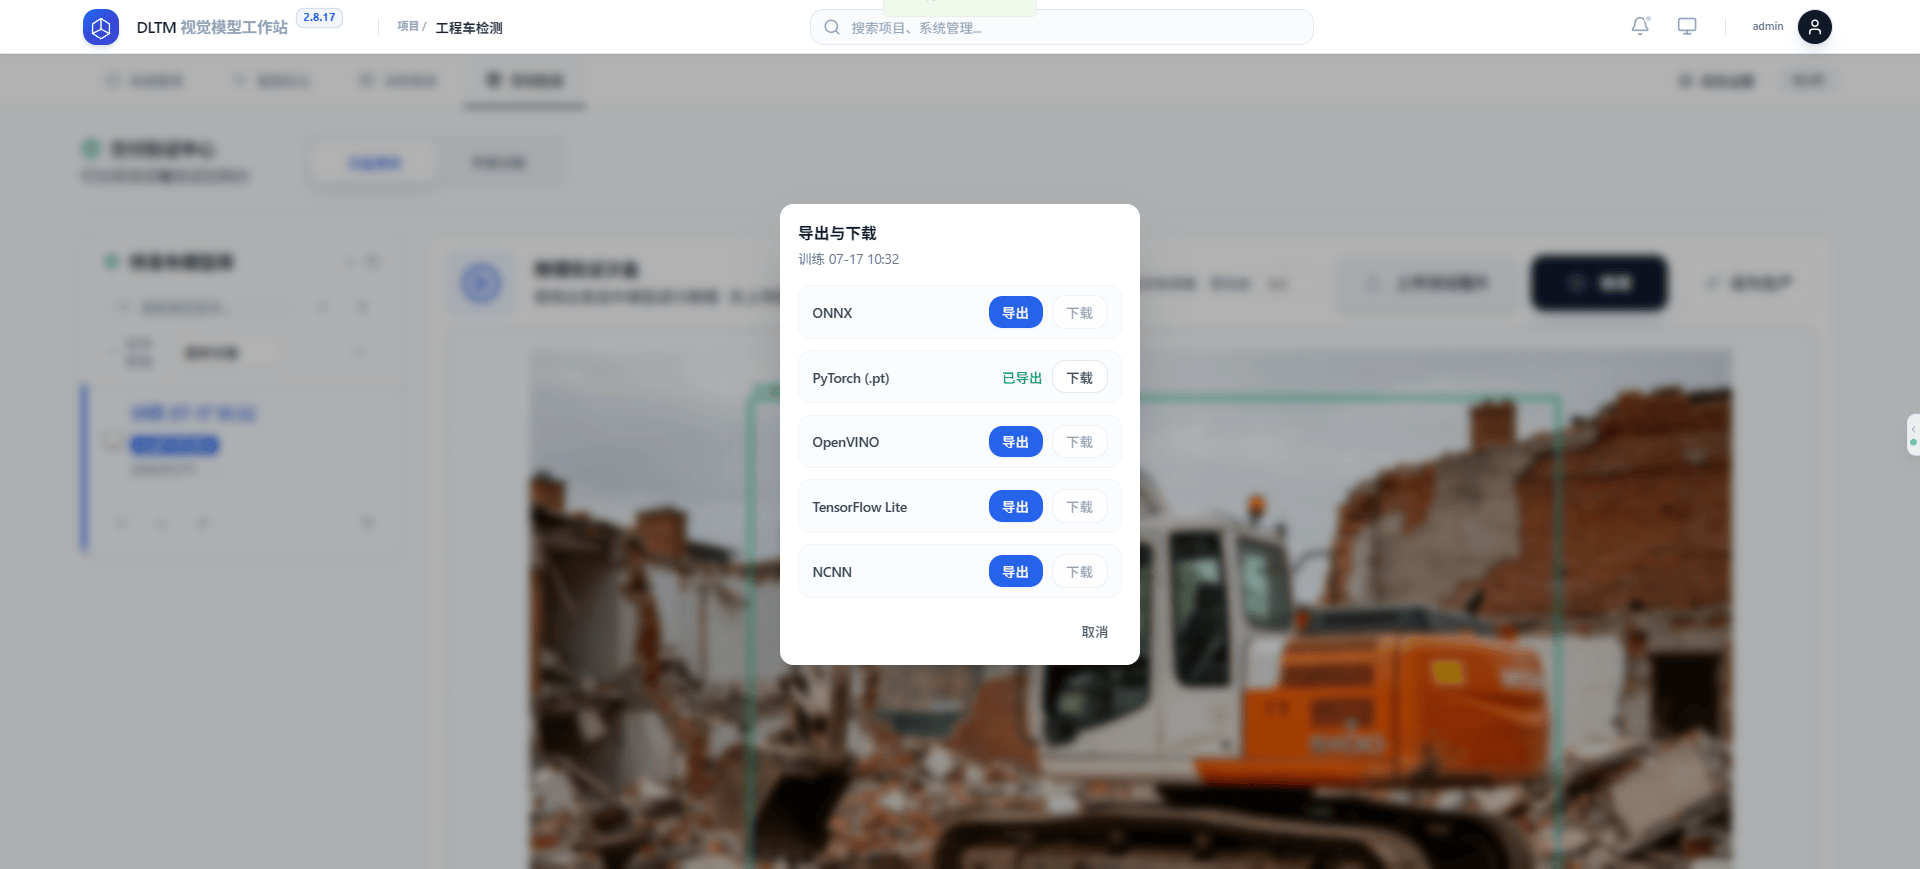
区别在于标注环节:分类只需给整图归类和贴标,检测则需用矩形框逐一框出目标。借助AI辅助标注,检测的标注负担被大幅摊薄,使得“既要位置又要类别”的高价值场景也能低成本落地。
结尾
分类与检测,没有谁比谁高级,只有谁更贴合你的业务问题。DLTM同时把两大主流视觉任务收进同一个零代码工作台,意味着你不必为了不同需求切换平台——看清“我要的是结论还是位置”,剩下的交给标注、训练与一键部署。选对任务,AI落地的第一步就走对了。

 浙公网安备 33010602011771号