
差分隐私的含义
定义
我们看到,如果过程的输出在你改变一个人的数据时基本相同,那么该过程就满足差分隐私。而"基本相同",我们的意思是"概率接近"。
现在让我们将其转化为形式化定义。
如果对于所有只相差一个个体的数据库 \(D_1\) 和 \(D_2\),过程 \(A\) 是 \(\varepsilon\)-差分隐私的:
……这对于所有可能的输出 \(O\) 都必须成立。让我们分解一下。
\(\mathbb{P}\left[A(D_1)=O\right]\) 是当你在数据库 \(D_1\) 上运行过程 \(A\) 时,输出为 \(O\) 的概率。这个过程是概率性的:如果你多次运行它,它可能会给你不同的答案。一个典型的过程可能是:"计算有蓝眼睛的人数,在这个计数中添加一些随机数,然后返回这个总和"。由于每次运行过程时随机数都会变化,结果会有所不同。
\(e^\varepsilon\) 是应用于参数 \(\varepsilon>0\) 的指数函数。如果 \(\varepsilon\) 非常接近 0,那么 \(e^\varepsilon\) 也非常接近 1,所以概率非常相似。\(\varepsilon\) 越大,概率可以差异越大。
当然,定义是对称的:你可以用 \(D_2\) 替换 \(D_1\),反之亦然,两个数据库仍然只相差一个个体。所以我们可以将其替换为:
因此,这个公式意味着如果你改变或删除一个人的数据,过程的输出是相似的。相似程度取决于 \(\varepsilon\):它越小,输出越相似。
这种相似性与隐私有什么关系?首先,我将通过一个直观的例子来解释这一点。然后,我将用更通用的解释来形式化这个想法。
一个简单的例子:随机响应
假设你想进行调查,了解有多少人是非法药物使用者。如果你天真地出去询问人们是否使用非法药物,很多人会对你撒谎。所以你设计了以下机制。参与者不再直接回答"你在过去一周内是否消费过非法药物?"这个问题。相反,他们中的每个人都将抛一枚硬币,而不让你看到。
- 如果是正面,参与者说实话(是或否)。
- 如果是反面,他们再抛一次硬币。如果第二次硬币是正面,他们回答是。否则,他们回答否。
这对调查受访者有什么好处?他们现在可以回答是,而不透露他们正在做非法的事情。当有人回答是时,你无法确定他们的真实答案。他们可能真的在吸毒,但他们也可能是随机回答的。
让我们计算药物使用者每个答案的概率。
- 以 50% 的概率,他们会说实话并回答是。
- 以 50% 的概率,他们会随机回答。
- 然后他们有另外 50% 的机会回答是,所以总共 25% 的机会。
- 同样,总共,他们有 25% 的机会回答否。
总而言之,我们得到 75% 的机会回答是和 25% 的机会回答否。对于不使用药物的人,概率是相反的:25% 的机会回答是,75% 的机会回答否。使用之前的符号:
- \(\mathbb{P}\left[A(Yes)=Yes\right] = 0.75\),\(\mathbb{P}\left[A(Yes)=No\right] = 0.25\)
- \(\mathbb{P}\left[A(No)=Yes\right] = 0.25\),\(\mathbb{P}\left[A(No)=No\right] = 0.75\)
现在,\(0.75\) 是 \(0.25\) 的三倍。所以如果我们选择 \(\varepsilon\) 使得 \(e^\varepsilon=3\)(即 \(\varepsilon\simeq1.1\)),这个过程是 \(\varepsilon\)-差分隐私的。所以这种合理的否认很好地转化为了差分隐私的语言。
当然,使用这样的差分隐私过程,你的数据中会有一些噪声。但如果你有足够的答案,以高概率,噪声会相互抵消。假设你总共有 1000 个答案:其中 400 个是是,600 个是否。大约 50% 的所有 1000 个答案是随机的,所以你可以从每个计数中移除 250 个答案。总的来说,你从 500 个非随机答案中得到 150 个是答案,所以总体上大约 30% 的是。
如果你想要更多隐私怎么办?你可以让参与者以 25% 的概率说实话,而不是 50%。如果你想要更少的噪声,代价是更少的保护怎么办?让他们以 75% 的概率说实话。找出每个选项的 \(\varepsilon\) 和量化噪声留给读者作为练习 =)
一个推广:量化攻击者的知识
让我们忘记之前的例子,考虑一个更通用的场景。与上一篇文章一致,我们将从攻击者的角度描述这个场景。我们有一个机制 \(A\),它是 \(\varepsilon\)-差分隐私的。我们在某个数据库 \(D\) 上运行它,并将输出 \(A(D)\) 发布给攻击者。然后,攻击者试图弄清楚某个人(他们的目标)是否在 \(D\) 中。
在差分隐私下,攻击者无法获得关于其目标的大量信息。即使这个攻击者对数据集了解很多,这也是成立的。让我们采取我们能想到的最强攻击者:他们知道除了目标之外的所有数据库。这个攻击者必须在两个选项之间确定哪个数据库是真实的:一个包含他们的目标(我们称之为 \(D_{in}\)),另一个不包含(\(D_{out}\))。
所以,在攻击者的世界模型中,实际数据库 \(D\) 可以是 \(D_{in}\) 或 \(D_{out}\)。他们可能对他们的目标在数据库中有一个初始怀疑。这种怀疑由一个概率表示,\(\mathbb{P}\left[D=D_{in}\right]\)。这个概率可以是 0 到 1 之间的任何值。比如说,如果攻击者的怀疑很强,则为 0.9;如果他们认为非常不可能,则为 0.01;如果他们不知道,则为 0.5……同样,他们怀疑他们的目标不在数据集中的概率也是一个概率,\(\mathbb{P}\left[D=D_{out}\right]\)。由于只有两个选项,\(\mathbb{P}\left[D=D_{out}\right]=1-\mathbb{P}\left[D=D_{in}\right]\)。
现在,假设攻击者看到机制返回输出 \(O\)。攻击者获得了多少信息?这可以通过查看他们在看到此输出后怀疑变化了多少来捕捉。用数学术语来说,我们必须比较 \(\mathbb{P}\left[D=D_{in}\right]\) 与更新后的怀疑 \(\mathbb{P}\left[D=D_{in}\mid A(D)=O\right]\)。这个更新后的怀疑是攻击者在看到 \(O\) 之后的世界模型。
使用差分隐私,更新后的概率永远不会离初始怀疑太远。我们可以精确量化这种现象。例如,当 \(\varepsilon=1.1\) 时,以下是上限和下限的样子。

黑线是攻击者的怀疑根本没有更新的情况。蓝线是更新后怀疑的下限和上限:它可以在两者之间的任何位置。我们可以可视化上一篇文章中提到的例子:对于 50% 的初始怀疑,更新后的怀疑大约在 25% 和 75% 之间。
我们如何证明这些界限成立?我们需要概率论的一个结果,以及一些基本的算术操作。我尽可能简单地重现了证明,但你仍然不必阅读它。如果你想,点击这里:
证明基于一个称为贝叶斯规则的定理。解释这个定理背后的完整直觉有点超出这篇文章的范围。如果你想理解它说的是什么以及为什么它有效,我建议你阅读这个指南。如果你不想,只需相信我:这个定理允许我们用其他术语重新表述更新后的怀疑。
让我们解释这些术语中的每一个。我们认识到 \(\mathbb{P}\left[D=D_{in}\right]\),那是攻击者的初始怀疑。\(\mathbb{P}\left[A(D)=O\mid D=D_{in}\right]\) 是从数据库 \(D_{in}\) 获得输出 \(O\) 的概率,我们可以将其简化为 \(\mathbb{P}\left[A\left(D_{in}\right)=O\right]\)。最后,\(\mathbb{P}\left[A(D)=O\right]\) 是在攻击者的世界模型中获得输出 \(O\) 的概率。
最后一项很棘手。我们不知道它的值。所以让我们通过考虑两个更新后概率 \(\mathbb{P}\left[D=D_{in}\mid A(D)=O\right]\) 和 \(\mathbb{P}\left[D=D_{out}\mid A(D)=O\right]\) 之间的比率来使其消失。这个令人讨厌的术语会很好地消失:
请注意,这不是一个无意义的数学技巧。这种概率比率实际上有一个简单的解释:它是赌徒所说的投注赔率。例如,在网站上,2018 年世界杯法国对克罗地亚比赛的赔率是 2:1。这意味着根据博彩公司的说法,法国获胜的概率是克罗地亚的两倍。这分别对应于大约 67% 和 33% 的概率。
无论如何,看!两项 \(\mathbb{P}\left[A\left(D_{in}\right)=O\right]\) 和 \(\mathbb{P}\left[A\left(D_{out}\right)=O\right]\) 是差分隐私定义中的那些。所以我们知道它们的比率是有界的:
如果我们将其代入之前的公式,我们会得到一个漂亮的关系:
这种关系是差分隐私的重新表述。原始定义说输出的概率分布是相似的。这种关系说赔率在查看输出后变化不大。两种表述是等价的:你可以用相反的方式写出相同的证明。
但回到我们的证明。我们现在需要做的就是用 \(1-\mathbb{P}\left[D=D_{in}\right]\) 替换 \(\mathbb{P}\left[D=D_{out}\right]\),对 \(\mathbb{P}\left[D=D_{out}\mid A\left(D\right)=O\right]\) 做同样的事情,然后求解 \(\mathbb{P}\left[D=D_{in}\mid A\left(D\right)=O\right]\)。你最终得到以下界限:
你可以使用你喜欢的软件绘制它。
对于不同的 \(\varepsilon\) 值,这看起来是什么样的?我们可以用漂亮的颜色绘制这个图表的推广:
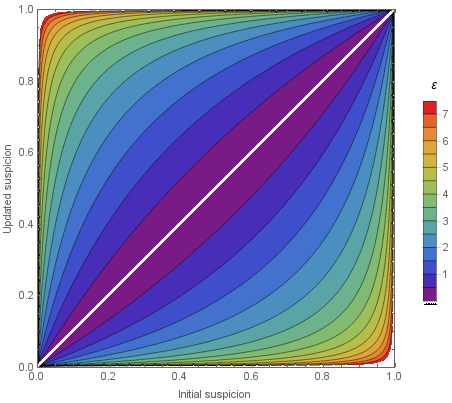
对于更大的 \(\varepsilon\) 值,这会很快变得可怕。假设你使用 \(\varepsilon=5\)。那么,攻击者可以从小怀疑(比如 10%)到非常高的确定度(94%)。
组合呢?
在上一节中,我形式化了我在上一篇文章中提出的两个主张。首先,我解释了量化信息增益意味着什么。此外,我选择了一个具有完全背景知识的攻击者。如果攻击者首先知道较少的信息,我们展示的界限仍然成立。
第三个主张呢?我说差分隐私是可组合的。假设两个算法 \(A\) 和 \(B\) 是 \(\varepsilon\)-差分隐私的。我们想证明发布两者的结果是 \(2\varepsilon\)-差分隐私的。让我们称组合 \(A\) 和 \(B\) 的算法为 \(C\):\(C(D)=\left(A(D),B(D)\right)\)。这个算法的输出将是一对输出:\(O=\left(O_A,O_B\right)\)。
见解是两个算法是独立的。它们各自有自己的随机性,所以一个的结果不会影响另一个的结果。这允许我们简单地写:
所以 \(C\) 是 \(2\varepsilon\)-差分隐私的。

 浙公网安备 33010602011771号