
 离线评估0.97、上线只剩0.82,最隐蔽根因是预处理做在数据划分之前。真机实验实测:全集SMOTE再划分,合成样本是测试集的近亲,离线虚高4.2个点。防线是结构性的——划分永远第一行、预处理塞进Pipeline、上线用holdout终评。
本文是《AI工程师踩坑实录》系列第 7 篇。验证集分数虚高,上线就崩,这个经典症状背后最常见的根因之一,是预处理(归一化、特征筛选、过采样)在数据划分之前就做完了。这一篇用一组严格控变量的真机实验,把泄漏的虚高水分量化出来。
本篇配套的对照实验脚本放在公Z号。
有个场景你可能经历过。
离线评估 0.97,上线实测 0.82。领导拿着离线报告问,那 15 个点去哪了。你翻遍代码,模型没变、数据没变、阈值没变。
分数不是丢了的,是从一开始就不存在。它的名字叫数据泄漏——你在训练阶段,提前偷看了本该留到考试才见的答案。
今天讲其中最隐蔽的一类,预处理做在了数据划分之前。
一、实验设计,两组只差一个时机
我用 digits 手写数字构造了一个不平衡数据集,多数类 0 到 6 各 175 张,少数类 7 到 9 各 12 张,用 SMOTE 过采样补齐少数类,同一个网络,同一个随机种子。
关键在设计对照组。两组的训练集基础完全一致(都是「训练集内部 SMOTE」的结果),唯一差异是,泄漏组额外混入 96 张合成样本,这些样本是测试集样本与其近邻插值出来的。
这个设计精确复刻了「全集 SMOTE 再划分」的真实行为。当你在全部数据上做过采样再划分,SMOTE 合成新样本时的插值父母,就包括后来分进测试集的那些样本。合成样本是测试样本的近亲,混进了训练集。
先看真实输出。
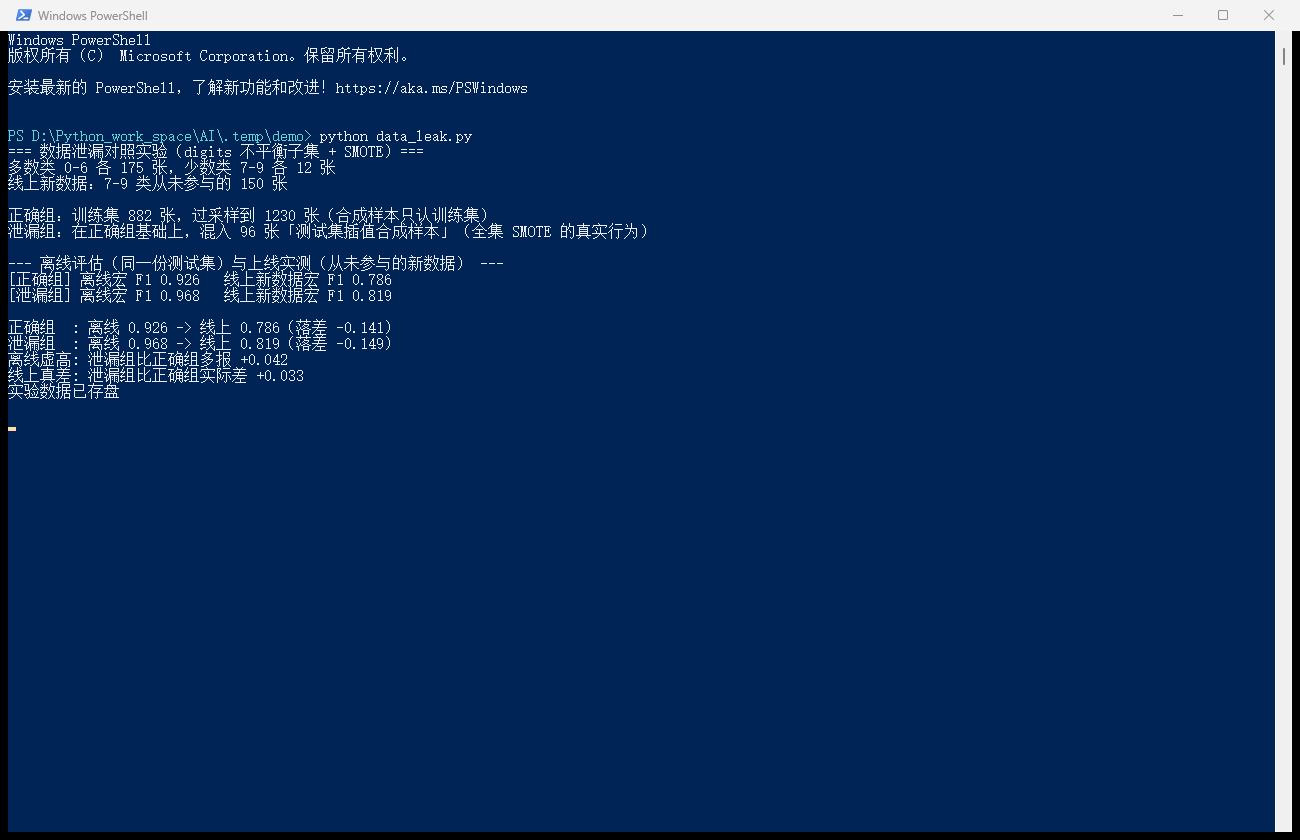
二、真实结果,虚高 4.2 个点,落差 15 个点
把四个数字摆在一起。
正确做法(先划分,训练集上过采样),离线宏 F1 0.926,线上新数据 0.786。
数据泄漏(全集过采样再划分),离线宏 F1 0.968,线上新数据 0.819。
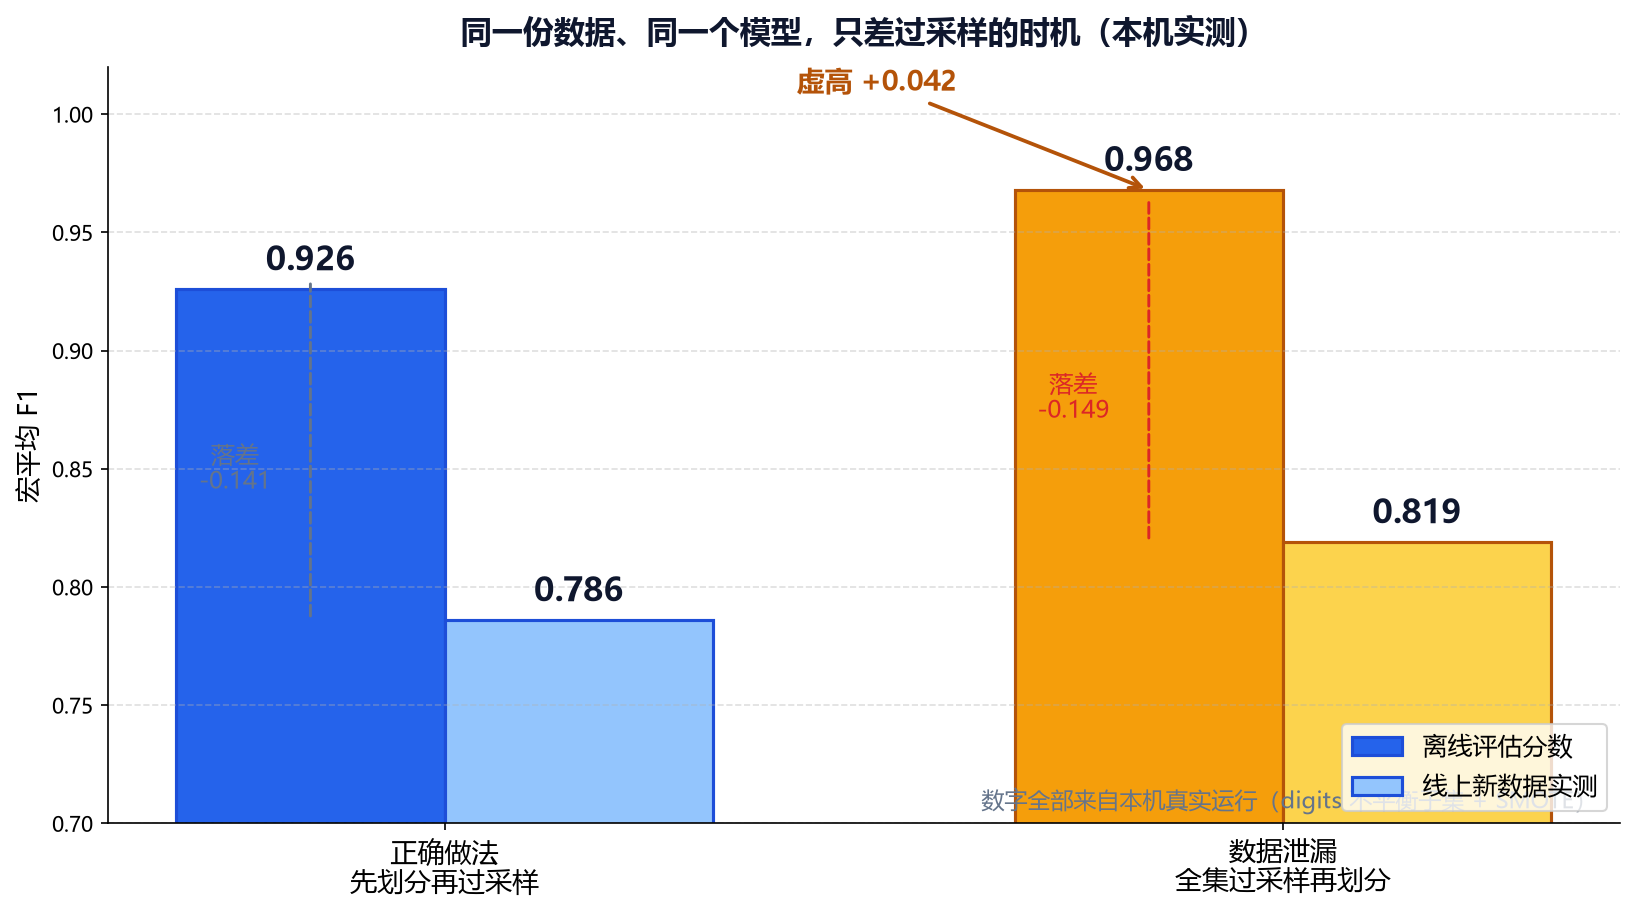
三个读法。
第一,离线分数,泄漏组比正确组多报了 4.2 个点。这 4 个点不是模型变强了,是评估被污染了。
第二,看落差。两组从离线到线上都掉了 14 个点上下(这是不平衡数据加合成样本本身的泛化代价,另一码事)。但泄漏组承诺的起点是 0.968,它让所有人(包括你自己)相信模型值这个分数。
第三,最实际的读法。你拿着 0.968 的报告去立项、去承诺指标、去跟别的方案比稿,赢下了竞争。上线交付的是 0.819。泄漏偷走的不是分数,是你的决策依据。
三、机制:合成样本是测试集的近亲
把两条流水线画出来,出问题的只是步骤顺序。
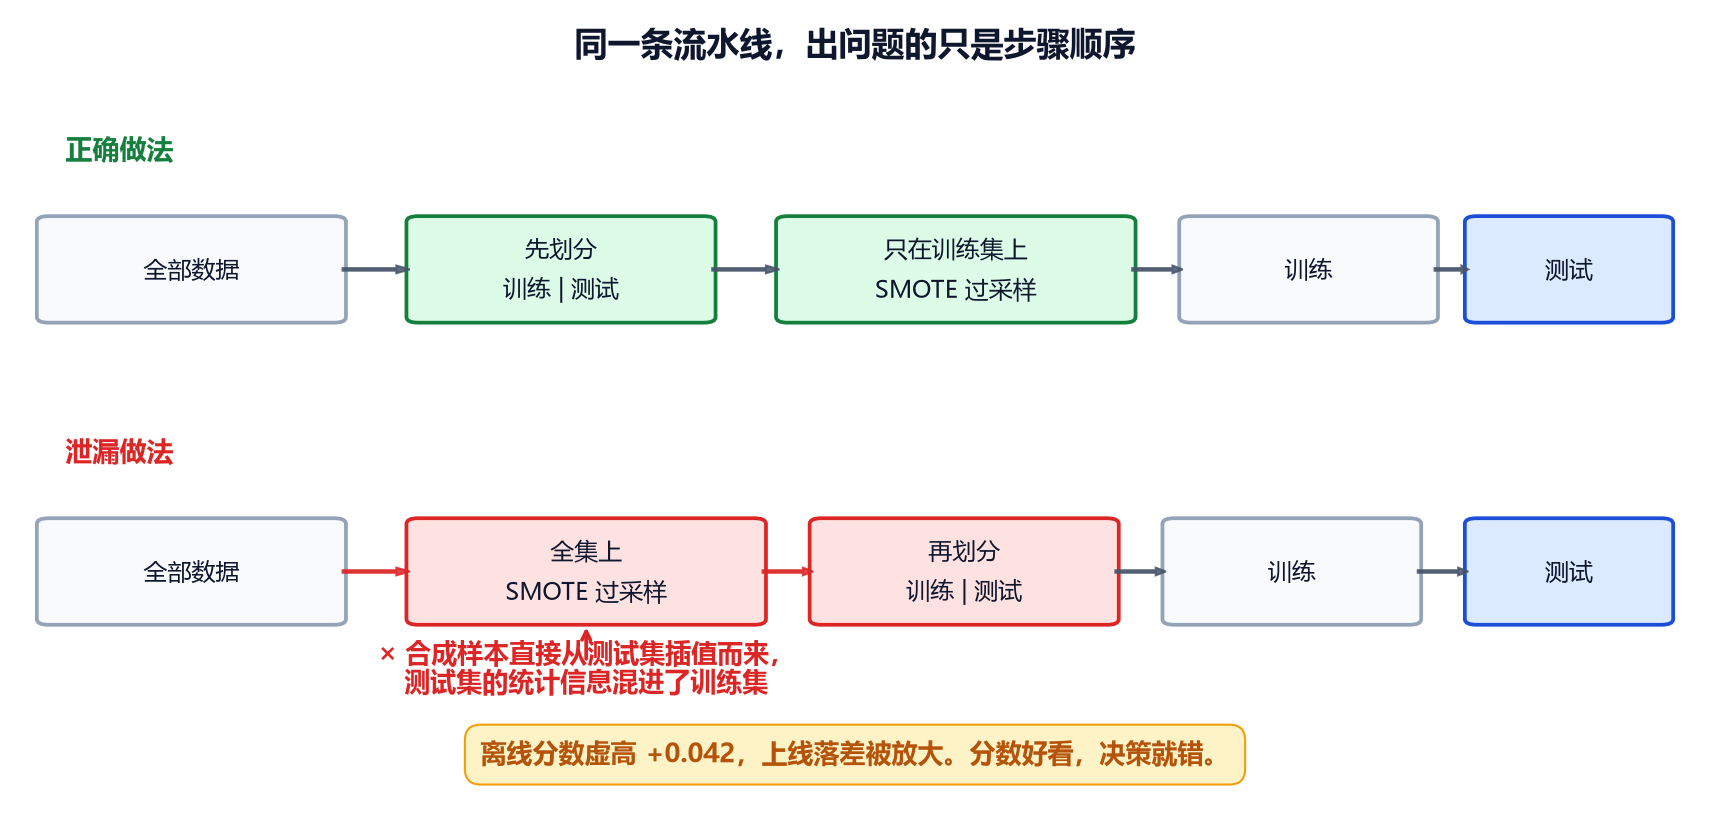
SMOTE 的工作方式是,对每个少数类样本找近邻,在两者连线上插值生成新样本。它不管你将来打算怎么划分,谁在数据池里,谁就可能成为插值的父母。
全集上做过采样,测试集样本就在池子里。它参与的合成样本进了训练集,模型训练时等于拿着测试题的变体在做练习。评估时再遇到「原题」,分数自然虚高。
过采样只是这一类泄漏的代表。同族还有几个常见成员,归一化(scaler 在全集上 fit,测试集的均值方差混了进来)、特征筛选(在全集上算互信息再选特征,选出的特征偏向测试集)、目标编码(在全集上算类别统计,测试样本的标签直接渗进特征)。
四、有个反直觉的实验发现,如实报告
我在准备这篇文章时,先用归一化泄漏做了一版实验,StandardScaler 在全集上 fit 对比只在训练集 fit,结果两组都是 0.927,零差距。
如实报告这个结果,因为它是个重要知识。归一化泄漏在这份数据上拉不开差距,原因是像素分布太均匀(训练均值 4.89,测试均值 4.86),偷看到的统计量几乎没有信息量。
但这不代表归一化泄漏无害。换个分布偏移明显的场景(时序数据、按机构划分的医疗数据),同样的错误立刻兑现成分数水分。泄漏的危害大小取决于数据分布差异,而错误的性质不变。所以结论只有一个,正确顺序是无条件的,不是「看数据再定」。
五、防线,用 Pipeline 把顺序焊死
对付这类泄漏,最稳的办法不是靠自觉,是让工具替你管住顺序。
sklearn 的 Pipeline 和 imblearn 的 Pipeline(支持采样器)会把「fit 只发生在训练折」这件事自动化。交叉验证时每一折的预处理都只在该折的训练部分上拟合,划分边界由框架保证。手写顺序的代码,每次重构每次都有机会犯错,Pipeline 写一次,顺序终身锁定。
三条纪律带走。
- 看到数据先划分,再做任何统计类处理,划分是第一行代码。
- 预处理逻辑全部塞进 Pipeline,别在 DataFrame 上手动 fit。
- 上线前用一份从未参与的 holdout 数据做最终评测,它是你唯一没偷看过的考卷。
六、常见问题 3 连
1. 怎么快速自查有没有泄漏?
一个粗暴但有效的办法。把测试集的标签全部随机打乱再评一次,如果分数没有掉到随机水平,说明模型在测试集上拿到了标签相关信息,基本可以断定有泄漏。再配合检查所有预处理的 fit 调用发生在哪一步,两分钟出结论。
2. 时序数据也是先划分吗?
原则一样但方向更严,时序数据必须按时间切,训练在前、测试在后,而且不能用未来数据做任何统计(归一化、编码、特征筛选都只允许用历史窗口)。shuffle 划分对时序是灾难级的泄漏。
3. 目标编码怎么用才不漏?
用带 leave-one-out 或者交叉拟合的版本(CatBoost 的 ordered encoding、sklearn 的 TargetEncoder 内置了拟合隔离)。核心机制都是,算每个样本的编码值时,把它自己的标签从统计池里剔除。手动在全集上 groupby 算均值再 merge 回来,是最常见的翻车写法。
七、本篇小结
- 预处理在划分之前做,测试集信息就混进了训练流程,离线分数虚高。
- 本机实测虚高 4.2 个点、离线到线上落差 15 个点,泄漏偷走的是决策依据。
- 防线是结构性的,先划分再处理,预处理进 Pipeline,最终评测用从未参与的 holdout。
本篇坑卡片
| 字段 | 内容 |
|---|---|
| 坑名 | SMOTE 过采样做在数据划分之前,离线评估虚高 |
| 现象原文 | 离线宏 F1 0.968,上线新数据 0.819(落差 15 个点) |
| 环境 | Win11 + CPU,Python 3.12,sklearn 1.9.1,imbalanced-learn 0.14.2 |
| 复现步骤 | digits 构造不平衡子集 → 控变量双组(唯一差异为 96 张测试集插值合成样本)→ 同模型训练 → 离线与线上双评测 |
| 根因 | 全集过采样时,合成样本的插值父母包含测试集样本,近亲样本混入训练集 |
| 解法 | 先划分再过采样;预处理进 imblearn/sklearn Pipeline;上线前用 holdout 终评 |
| 避坑建议 | 划分永远第一行;归一化泄漏在均匀数据上无差距但错误性质不变,正确顺序无条件执行 |
| 可信度 | 本机验证 |
| 版本时间戳 | 2026-11-05,sklearn 1.9.1 + imblearn 0.14.2 |
| 关联坑 | 第 3 篇标签错位(同为数据正确性赛道) |
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | nvidia-smi 显示的 CUDA 版本到底是不是你装的那个 | ✅ |
| 2 | torch.cuda.is_available() 一直是 False,一条命令定位断点 | ✅ |
| 3 | 标签和图像没对齐,模型一直在学噪声 | ✅ |
| 4 | loss 变 NaN,用 hook 逐层定位 | ✅ |
| 5 | DataLoader 卡死在第一个 batch,Windows 多进程的坑 | ✅ |
| 6 | 装了两套 CUDA 还在串,PATH 与优先级的真相 | ✅ |
| 7 | 数据泄漏:预处理做在了划分之前 | ✅(本篇) |
| 8 | RAG 答一半开始编,检索阈值与拒答机制实操 | 排期中 |
| 9 | 随机种子都设了,结果还是不可复现 | 排期中 |
| 10 | 相似度全是 0.9:向量没归一化 | 排期中 |
| 11 | 开了混合精度就 NaN,GradScaler 到底在做什么 | 排期中 |
| 12 | loss 不降反升,先别怀疑模型结构 | 排期中 |
| 13 | 训练降验证不降:先查数据再谈正则 | 排期中 |
下一篇预告,《RAG 答一半开始编:知识库里没有,模型硬答》。检索没命中,模型不说不知道,编一个像模像样的答案,比答错更危险。下一篇用一个本地小模型完整复现「有拒答」和「没拒答」的输出差异。
版权说明,本文实验数据与截图均来自本人真机复现,专栏读者可学习使用,禁止转售或整篇搬运。

 浙公网安备 33010602011771号