
 本文讲模型训练与评估的规范做法:5600条样本按7:3划分、固定随机种子保证可复现,测试集绝不参与训练;除准确率外还要看精确率、召回率、F1与混淆矩阵。核心是内圈召回率差异——随机森林0.73、CNN0.83、ResNet达95%+,三模型对比即成论文题眼。
本文是《滚动轴承故障诊断》系列的第 7 篇(训练与评估)。
系列完整目录见文末【专栏导航】。本篇的训练脚本、评估脚本与一键出图,见同名公众号。
一、训练前的最后一件事:数据划分
三个模型在训练前都做同一件事:把 5600 条样本按 7:3 分成训练集和测试集。
- 训练集(70%):模型用来"学习"的部分;
- 测试集(30%):模型从没见过的部分,用来检验它学得真不真。
关键点:测试集必须训练完才碰,否则就是"偷看答案"(数据泄漏),成绩会虚高、答辩经不起问。本项目固定随机种子(99),保证每次划分一模一样、结果可复现——这也是论文里"实验设置"一节必须交代清楚的地方。
二、训练过程的几个概念(面试/答辩常问)
model.fit(train_data, train_label,
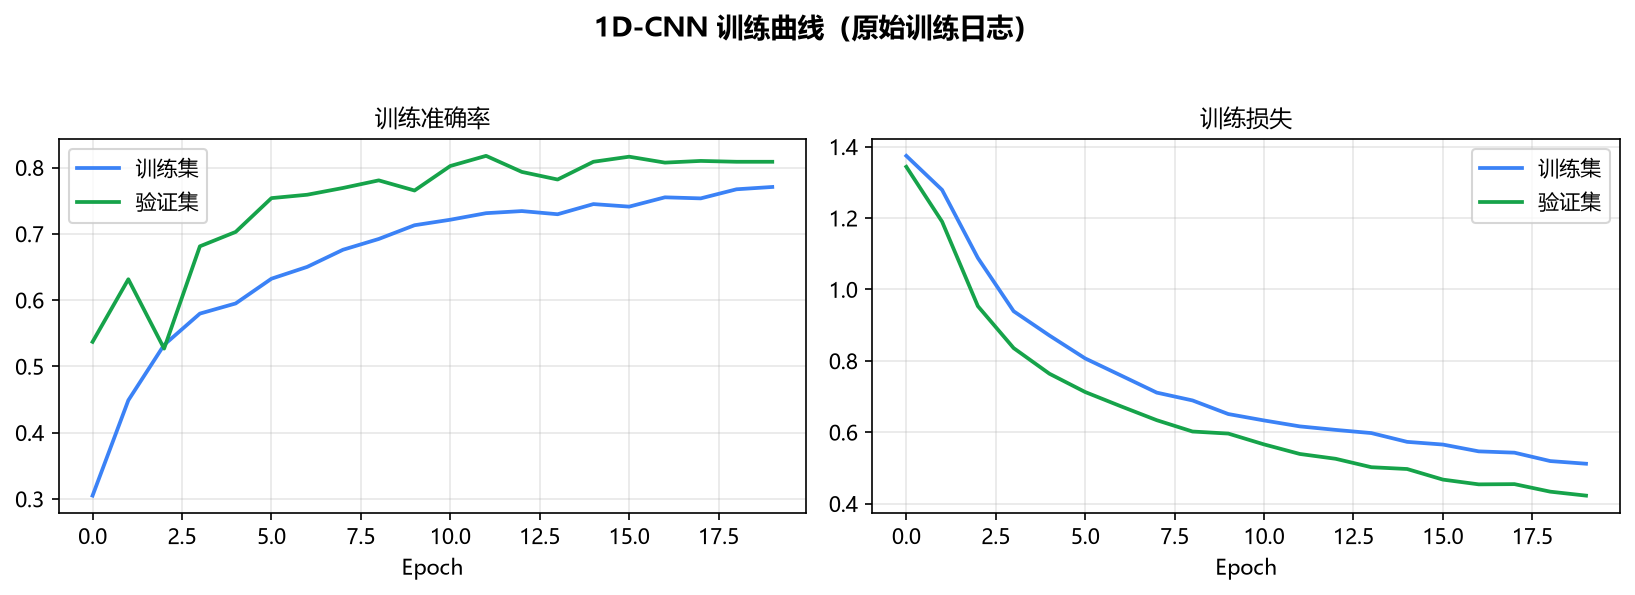
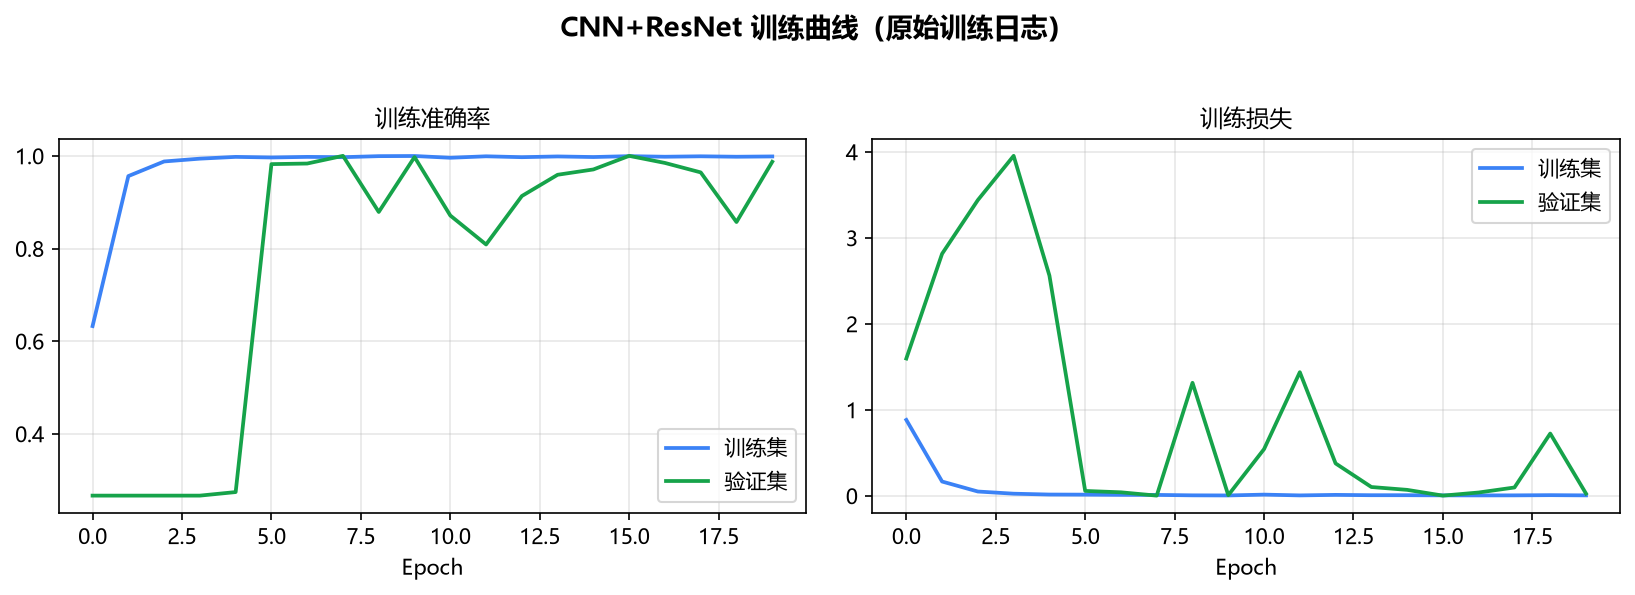
          epochs=20, batch_size=16, validation_split=0.2,
          optimizer=Adam(lr), loss=sparse_categorical_crossentropy)
| 概念 | 解释 | 本项目 |
|---|---|---|
epochs |
把整个训练集"过几遍" | 20 |
batch_size |
每批喂多少条样本才更新一次参数 | CNN 16 / ResNet 32 |
optimizer |
用哪个优化器调整参数 | Adam |
learning_rate |
每次更新的步长(学太快容易乱,太慢学不完) | CNN 0.001 / ResNet 1e-4 |
loss |
衡量"错得多离谱"的函数 | 稀疏交叉熵 |
为什么 ResNet 学习率更小(1e-4)?因为残差网络更复杂,步子迈太大会震荡不收敛,所以要"小步慢走"。这个细节写进论文,能体现你真懂。
验证集(validation_split=0.2):从训练集里再留 20% 出来,边训练边"偷看"泛化效果——但它不参与学习,只是观察。
三、评估指标:准确率之外,还要看什么
只用准确率是不够的(尤其是类别不平衡时)。论文里通常四个指标一起上:
| 指标 | 含义 | 通俗版 |
|---|---|---|
| Accuracy | 全部预测对的比例 | 总分 |
| Precision | 说对的比例 | 说的没错 |
| Recall | 真样本找回的比例 | 没漏 |
| F1 | 二者的调和平均 | 综合分 |
本项目最关键的观察点:CNN 的内圈故障召回率明显低(漏了),ResNet 把它救回来——这组对比就是论文实验章节的"题眼"。
四、混淆矩阵:一眼看出模型"哪类老认错"
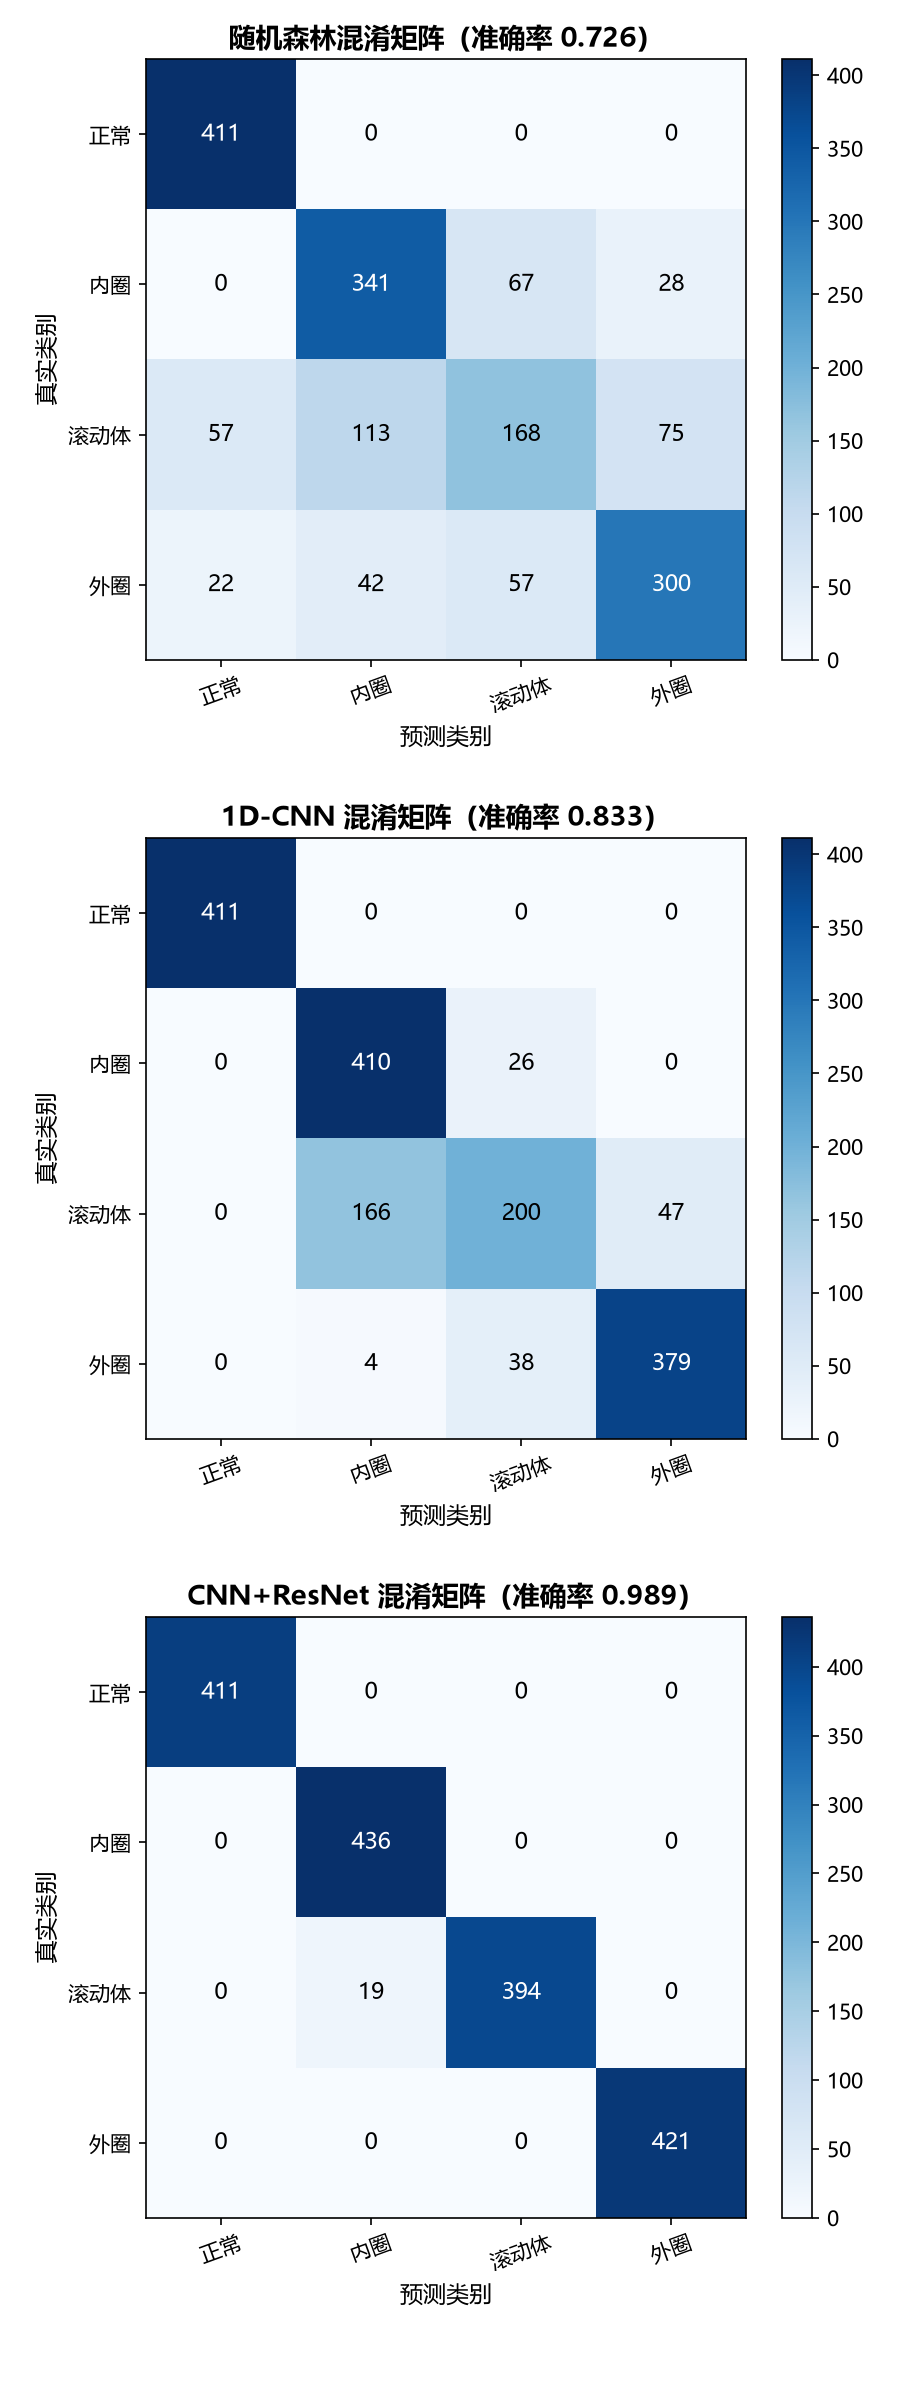
混淆矩阵是个 4×4 的表格:行是真实类别,列是模型预测的类别,对角线就是"判对"的数量。
- 对角线又粗又深 → 模型靠谱;
- 某个非对角格特别大 → 模型总把 A 类错认成 B 类,这就找到了模型的具体毛病。
本项目经典案例:CNN 在"内圈→滚动体"这一格明显偏大。而 ResNet 的对角线干净整齐、四类都深——残差的价值一眼可见。答辩时指着这张图讲,比念数字有说服力十倍。
五、把结果变成论文对比表
把三个模型的指标收拢成一张表(数据来自评估脚本输出,以你自己复现的为准):
| 模型 | 准确率 | 内圈召回率 | 论文定位 |
|---|---|---|---|
| 随机森林 | ~0.73 | ~0.78 | 传统方法基线 |
| 1D-CNN | ~0.83 | 偏低 | 浅层网络局限 |
| CNN+ResNet | ~0.95+ | 高 | 本文推荐方法 |
配套评估脚本一键生成这张表 + 三张混淆矩阵图,直接贴论文。跑完记得把关键数字抄进自己的表格。
六、本篇小结
- 7:3 划分 + 固定种子 = 可复现;测试集绝不参与训练;
- 四个指标 + 混淆矩阵,别只看准确率;
- 内圈召回率差异是 CNN/ResNet 对比的核心,答辩常问;
- 一键出表出图:公众号「免费代码合集」→ 05 / 06 章节。
配图
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | 项目总览与三模型对比 | ✅ |
| 2 | 环境部署 | ✅ |
| 3 | CWRU 数据集深度解析 | ✅ |
| 4 | 数据预处理源码走读 | ✅ |
| 5 | 随机森林实战 | ✅ |
| 6 | 一维卷积与残差模块 | ✅ |
| 7 | 模型训练与评估(本文) | ✅ |
| 8 | 可视化诊断系统 | 排期中 |
| 9 | 论文报告与答辩话术 | 排期中 |
下一篇预告:《可视化诊断系统:PyQt5 搭建带界面的工具》,把训练好的模型装进一个点按钮就出结果的软件里,答辩现场演示神器。
版权说明:CWRU 数据集版权归凯斯西储大学所有,仅限学习研究使用。

 浙公网安备 33010602011771号