
Java 线程池详解
Java 线程池详解
参考
一 使用线程池的好处
池化技术想必大家已经屡见不鲜了,线程池、数据库连接池、Http 连接池等等都是对这个思想的应用。池化技术的思想主要是为了减少每次获取资源的消耗,提高对资源的利用率。
线程池提供了一种限制和管理资源(包括执行一个任务)的方式。 每个线程池还维护一些基本统计信息,例如已完成任务的数量。
这里借用《Java 并发编程的艺术》提到的来说一下使用线程池的好处:
- 降低资源消耗。通过重复利用已创建的线程降低线程创建和销毁造成的消耗。
- 提高响应速度。当任务到达时,任务可以不需要等到线程创建就能立即执行。
- 提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。
二 Executor 框架
2.1 简介
Executor 框架是 Java5 之后引进的,在 Java 5 之后,通过 Executor 来启动线程比使用 Thread 的 start 方法更好,除了更易管理,效率更好(用线程池实现,节约开销)外,还有关键的一点:有助于避免 this 逃逸问题。
补充:this 逃逸是指在构造函数返回之前其他线程就持有该对象的引用. 调用尚未构造完全的对象的方法可能引发令人疑惑的错误。
Executor 框架不仅包括了线程池的管理,还提供了线程工厂、队列以及拒绝策略等,Executor 框架让并发编程变得更加简单。
2.2 Executor 框架结构(主要由三大部分组成)
1) 任务(Runnable /Callable)
执行任务需要实现的 Runnable 接口 或 Callable接口。Runnable 接口或 Callable 接口 实现类都可以被 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行。
2) 任务的执行(Executor)
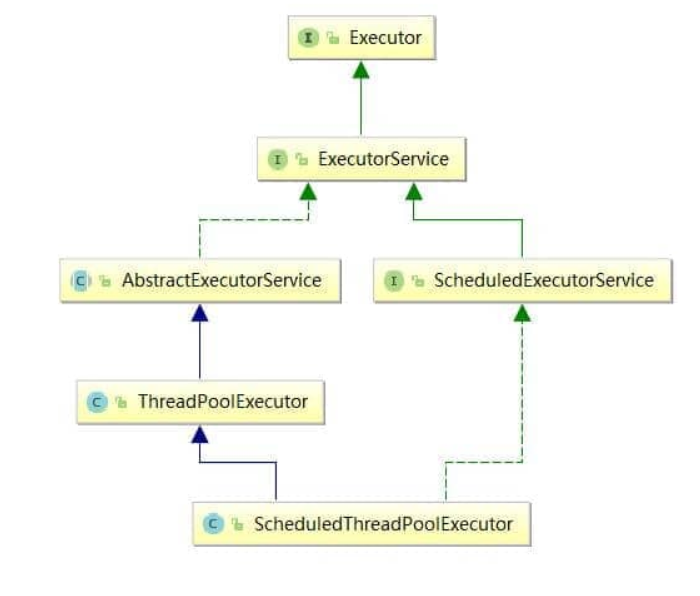
如下图所示,包括任务执行机制的核心接口 Executor ,以及继承自 Executor 接口的 ExecutorService 接口。ThreadPoolExecutor 和 ScheduledThreadPoolExecutor 这两个关键类实现了 ExecutorService 接口。
这里提了很多底层的类关系,但是,实际上我们需要更多关注的是 ThreadPoolExecutor 这个类,这个类在我们实际使用线程池的过程中,使用频率还是非常高的。
注意: 通过查看
ScheduledThreadPoolExecutor源代码我们发现ScheduledThreadPoolExecutor实际上是继承了ThreadPoolExecutor并实现了 ScheduledExecutorService ,而ScheduledExecutorService又实现了ExecutorService,正如我们下面给出的类关系图显示的一样。
ThreadPoolExecutor 类描述:
//AbstractExecutorService实现了ExecutorService接口
public class ThreadPoolExecutor extends AbstractExecutorService
ScheduledThreadPoolExecutor 类描述:
//ScheduledExecutorService继承ExecutorService接口
public class ScheduledThreadPoolExecutor
        extends ThreadPoolExecutor
        implements ScheduledExecutorService
3) 异步计算的结果(Future)
Future 接口以及 Future 接口的实现类 FutureTask 类都可以代表异步计算的结果。当我们把 Runnable接口 或 Callable 接口 的实现类提交给 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行。(调用 submit() 方法时会返回一个 FutureTask 对象)
2.3 Executor 框架的使用示意图

- 主线程首先要创建实现
Runnable或者Callable接口的任务对象。 - 把创建完成的实现
Runnable/Callable接口的 对象直接交给ExecutorService执行:ExecutorService.execute(Runnable command))或者也可以把Runnable对象或Callable对象提交给ExecutorService执行(ExecutorService.submit(Runnable task)或ExecutorService.submit(Callable <T> task))。 - 如果执行
ExecutorService.submit(…),ExecutorService将返回一个实现Future接口的对象(我们刚刚也提到过了执行execute()方法和submit()方法的区别,submit()会返回一个FutureTask 对象)。由于 FutureTask实现了Runnable,我们也可以创建FutureTask,然后直接交给ExecutorService执行。 - 最后,主线程可以执行
FutureTask.get()方法来等待任务执行完成。主线程也可以执行FutureTask.cancel(boolean mayInterruptIfRunning)来取消此任务的执行。
三 (重要)ThreadPoolExecutor 类简单介绍
线程池实现类 ThreadPoolExecutor 是 Executor 框架最核心的类。
3.1 ThreadPoolExecutor 类分析
ThreadPoolExecutor 类中提供的四个构造方法。我们来看最长的那个,其余三个都是在这个构造方法的基础上产生(其他几个构造方法说白点都是给定某些默认参数的构造方法比如默认制定拒绝策略是什么)。
/**
     * 用给定的初始参数创建一个新的ThreadPoolExecutor。
     */
    public ThreadPoolExecutor(int corePoolSize,//线程池的核心线程数量
                              int maximumPoolSize,//线程池的最大线程数
                              long keepAliveTime,//当线程数大于核心线程数时,多余的空闲线程存活的最长时间
                              TimeUnit unit,//时间单位
                              BlockingQueue<Runnable> workQueue,//任务队列,用来储存等待执行任务的队列
                              ThreadFactory threadFactory,//线程工厂,用来创建线程,一般默认即可
                              RejectedExecutionHandler handler//拒绝策略,当提交的任务过多而不能及时处理时,我们可以定制策略来处理任务
                               ) {
        if (corePoolSize < 0 ||
            maximumPoolSize <= 0 ||
            maximumPoolSize < corePoolSize ||
            keepAliveTime < 0)
            throw new IllegalArgumentException();
        if (workQueue == null || threadFactory == null || handler == null)
            throw new NullPointerException();
        this.corePoolSize = corePoolSize;
        this.maximumPoolSize = maximumPoolSize;
        this.workQueue = workQueue;
        this.keepAliveTime = unit.toNanos(keepAliveTime);
        this.threadFactory = threadFactory;
        this.handler = handler;
    }
下面这些对创建非常重要,在后面使用线程池的过程中你一定会用到!所以,务必拿着小本本记清楚。
ThreadPoolExecutor 3 个最重要的参数:
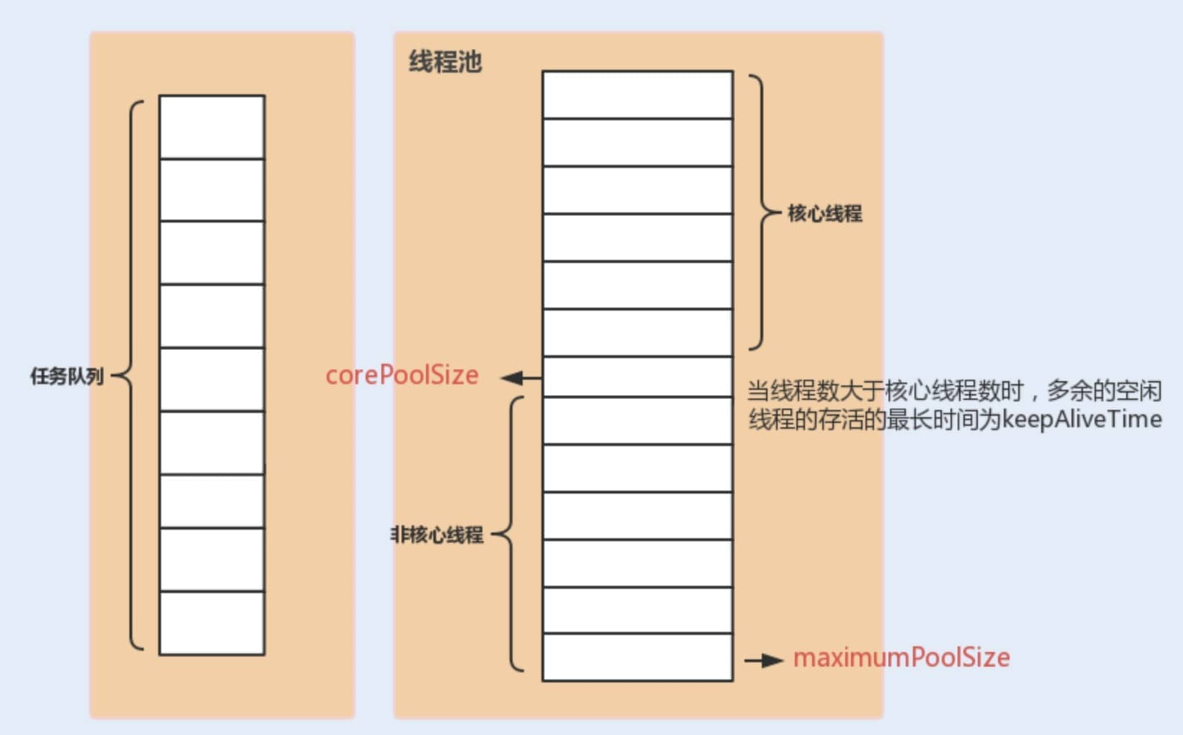
corePoolSize: 核心线程数线程数定义了最小可以同时运行的线程数量。maximumPoolSize: 当队列中存放的任务达到队列容量的时候,当前可以同时运行的线程数量变为最大线程数。workQueue: 当新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
ThreadPoolExecutor其他常见参数 :
keepAliveTime:当线程池中的线程数量大于corePoolSize的时候,如果这时没有新的任务提交,核心线程外的线程不会立即销毁,而是会等待,直到等待的时间超过了keepAliveTime才会被回收销毁;unit:keepAliveTime参数的时间单位。threadFactory:executor 创建新线程的时候会用到。handler:饱和策略。关于饱和策略下面单独介绍一下。
下面这张图可以加深你对线程池中各个参数的相互关系的理解(图片来源:《Java 性能调优实战》):
ThreadPoolExecutor 饱和策略定义:
如果当前同时运行的线程数量达到最大线程数量并且队列也已经被放满了任务时,ThreadPoolTaskExecutor 定义一些策略:
ThreadPoolExecutor.AbortPolicy:抛出RejectedExecutionException来拒绝新任务的处理。ThreadPoolExecutor.CallerRunsPolicy:调用执行自己的线程运行任务,也就是直接在调用execute方法的线程中运行(run)被拒绝的任务,如果执行程序已关闭,则会丢弃该任务。因此这种策略会降低对于新任务提交速度,影响程序的整体性能。如果您的应用程序可以承受此延迟并且你要求任何一个任务请求都要被执行的话,你可以选择这个策略。ThreadPoolExecutor.DiscardPolicy:不处理新任务,直接丢弃掉。ThreadPoolExecutor.DiscardOldestPolicy: 此策略将丢弃最早的未处理的任务请求。
....具体可以查看线程池part的代码。
4.3 几个常见的对比
4.3.1 Runnable vs Callable
Runnable自 Java 1.0 以来一直存在,但Callable仅在 Java 1.5 中引入,目的就是为了来处理Runnable不支持的用例。Runnable 接口不会返回结果或抛出检查异常,但是 Callable 接口可以。所以,如果任务不需要返回结果或抛出异常推荐使用 Runnable 接口,这样代码看起来会更加简洁。
工具类 Executors 可以实现将 Runnable 对象转换成 Callable 对象。(Executors.callable(Runnable task) 或 Executors.callable(Runnable task, Object result))。
Runnable.java
@FunctionalInterface
public interface Runnable {
   /**
    * 被线程执行,没有返回值也无法抛出异常
    */
    public abstract void run();
}
Callable.java
@FunctionalInterface
public interface Callable<V> {
    /**
     * 计算结果,或在无法这样做时抛出异常。
     * @return 计算得出的结果
     * @throws 如果无法计算结果,则抛出异常
     */
    V call() throws Exception;
}
4.3.2 execute() vs submit()
execute()方法用于提交不需要返回值的任务,所以无法判断任务是否被线程池执行成功与否;submit()方法用于提交需要返回值的任务。线程池会返回一个Future类型的对象,通过这个Future对象可以判断任务是否执行成功,并且可以通过Future的get()方法来获取返回值,get()方法会阻塞当前线程直到任务完成,而使用get(long timeout,TimeUnit unit)方法的话,如果在timeout时间内任务还没有执行完,就会抛出java.util.concurrent.TimeoutException。
这里只是为了演示使用,推荐使用 ThreadPoolExecutor 构造方法来创建线程池。
示例1:使用 get() 方法获取返回值。
ExecutorService executorService = Executors.newFixedThreadPool(3);

Future<String> submit = executorService.submit(() -> {
    try {
        Thread.sleep(5000L);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
    return "abc";
});

String s = submit.get();
System.out.println(s);
executorService.shutdown();
输出:
abc
示例2:使用 get(long timeout,TimeUnit unit) 方法获取返回值。
ExecutorService executorService = Executors.newFixedThreadPool(3);

Future<String> submit = executorService.submit(() -> {
    try {
        Thread.sleep(5000L);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
    return "abc";
});

String s = submit.get(3, TimeUnit.SECONDS);
System.out.println(s);
executorService.shutdown();
输出:
Exception in thread "main" java.util.concurrent.TimeoutException
	at java.util.concurrent.FutureTask.get(FutureTask.java:205)
4.3.3 shutdown()VSshutdownNow()
shutdown():关闭线程池,线程池的状态变为SHUTDOWN。线程池不再接受新任务了,但是队列里的任务得执行完毕。shutdownNow():关闭线程池,线程的状态变为STOP。线程池会终止当前正在运行的任务,并停止处理排队的任务并返回正在等待执行的 List。
4.3.2 isTerminated() VS isShutdown()
isShutDown当调用shutdown()方法后返回为 true。isTerminated当调用shutdown()方法后,并且所有提交的任务完成后返回为 true;可以循环调用判断这个方法来判定线程池中的任务是否完成。
4.4 加餐:Callable+ThreadPoolExecutor示例代码
import java.util.concurrent.Callable;

public class MyCallable implements Callable<String> {
    @Override
    public String call() throws Exception {
        Thread.sleep(1000);
        //返回执行当前 Callable 的线程名字
        return Thread.currentThread().getName();
    }
}
CallableDemo.java
import java.util.ArrayList;
import java.util.Date;
import java.util.List;
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.Callable;
import java.util.concurrent.ExecutionException;
import java.util.concurrent.Future;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;

public class CallableDemo {
    private static final int CORE_POOL_SIZE = 5;
    private static final int MAX_POOL_SIZE = 10;
    private static final int QUEUE_CAPACITY = 100;
    private static final Long KEEP_ALIVE_TIME = 1L;
    public static void main(String[] args) {
        //使用阿里巴巴推荐的创建线程池的方式
        //通过ThreadPoolExecutor构造函数自定义参数创建
        ThreadPoolExecutor executor = new ThreadPoolExecutor(
                CORE_POOL_SIZE,
                MAX_POOL_SIZE,
                KEEP_ALIVE_TIME,
                TimeUnit.SECONDS,
                new ArrayBlockingQueue<>(QUEUE_CAPACITY),
                new ThreadPoolExecutor.CallerRunsPolicy());

        List<Future<String>> futureList = new ArrayList<>();
        Callable<String> callable = new MyCallable();
        for (int i = 0; i < 10; i++) {
            //提交任务到线程池
            Future<String> future = executor.submit(callable);
            //将返回值 future 添加到 list,我们可以通过 future 获得 执行 Callable 得到的返回值
            futureList.add(future);
        }
        for (Future<String> fut : futureList) {
            try {
                System.out.println(new Date() + "::" + fut.get());
            } catch (InterruptedException | ExecutionException e) {
                e.printStackTrace();
            }
        }
        //关闭线程池
        executor.shutdown();
    }
}
Output:
Wed Nov 13 13:40:41 CST 2019::pool-1-thread-1
Wed Nov 13 13:40:42 CST 2019::pool-1-thread-2
Wed Nov 13 13:40:42 CST 2019::pool-1-thread-3
Wed Nov 13 13:40:42 CST 2019::pool-1-thread-4
Wed Nov 13 13:40:42 CST 2019::pool-1-thread-5
Wed Nov 13 13:40:42 CST 2019::pool-1-thread-3
Wed Nov 13 13:40:43 CST 2019::pool-1-thread-2
Wed Nov 13 13:40:43 CST 2019::pool-1-thread-1
Wed Nov 13 13:40:43 CST 2019::pool-1-thread-4
Wed Nov 13 13:40:43 CST 2019::pool-1-thread-5
五 几种常见的线程池详解
5.1 FixedThreadPool
5.1.1 介绍
FixedThreadPool 被称为可重用固定线程数的线程池。通过 Executors 类中的相关源代码来看一下相关实现:
/**
* 创建一个可重用固定数量线程的线程池
*/
public static ExecutorService newFixedThreadPool(int nThreads, ThreadFactory threadFactory) {
    return new ThreadPoolExecutor(nThreads, nThreads,
                                  0L, TimeUnit.MILLISECONDS,
                                  new LinkedBlockingQueue<Runnable>(),
                                  threadFactory);
}
另外还有一个 FixedThreadPool 的实现方法,和上面的类似,所以这里不多做阐述:
public static ExecutorService newFixedThreadPool(int nThreads) {
    return new ThreadPoolExecutor(nThreads, nThreads,
                                  0L, TimeUnit.MILLISECONDS,
                                  new LinkedBlockingQueue<Runnable>());
}
从上面源代码可以看出新创建的 FixedThreadPool 的 corePoolSize 和 maximumPoolSize 都被设置为 nThreads,这个 nThreads 参数是我们使用的时候自己传递的。
5.1.2 执行任务过程介绍
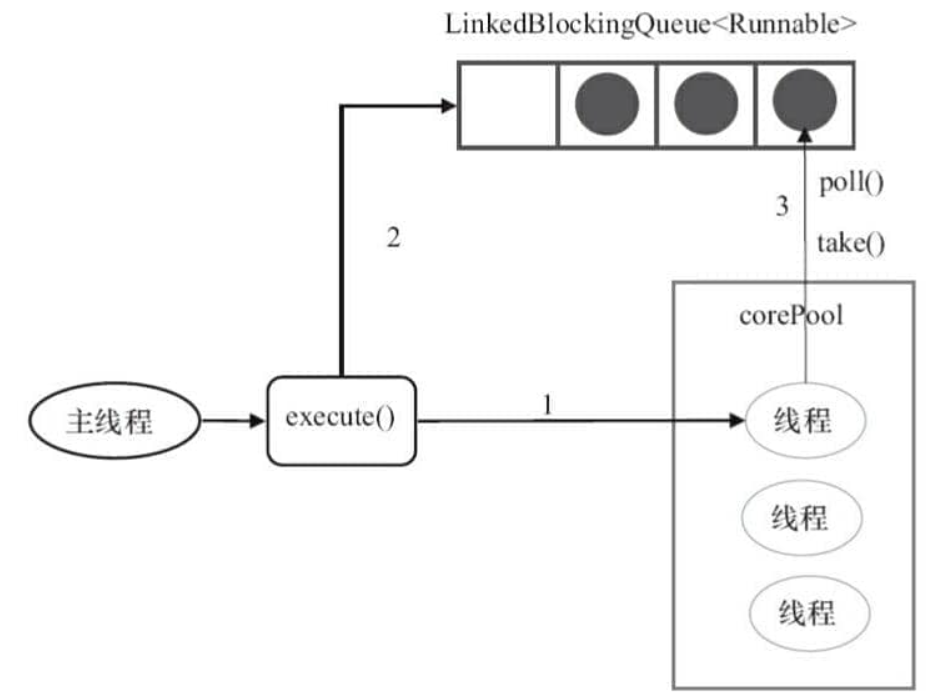
FixedThreadPool 的 execute() 方法运行示意图(该图片来源:《Java 并发编程的艺术》):
上图说明:
- 如果当前运行的线程数小于 corePoolSize, 如果再来新任务的话,就创建新的线程来执行任务;
- 当前运行的线程数等于 corePoolSize 后, 如果再来新任务的话,会将任务加入
LinkedBlockingQueue;(可以理解为等待队列) - 线程池中的线程执行完手头的任务后,会在循环中反复从
LinkedBlockingQueue中获取任务来执行;
5.1.3 为什么不推荐使用FixedThreadPool?
FixedThreadPool 使用无界队列 LinkedBlockingQueue(队列的容量为 Integer.MAX_VALUE)作为线程池的工作队列会对线程池带来如下影响 :
- 当线程池中的线程数达到
corePoolSize后,新任务将在无界队列中等待,因此线程池中的线程数不会超过 corePoolSize; - 由于使用无界队列时
maximumPoolSize将是一个无效参数,因为不可能存在任务队列满的情况。所以,通过创建FixedThreadPool的源码可以看出创建的FixedThreadPool的corePoolSize和maximumPoolSize被设置为同一个值。 - 由于 1 和 2,使用无界队列时
keepAliveTime将是一个无效参数; - 运行中的
FixedThreadPool(未执行shutdown()或shutdownNow())不会拒绝任务,在任务比较多的时候会导致 OOM(内存溢出)。
5.2 SingleThreadExecutor 详解
5.2.1 介绍
SingleThreadExecutor 是只有一个线程的线程池。下面看看SingleThreadExecutor 的实现:
/**
*返回只有一个线程的线程池
*/
public static ExecutorService newSingleThreadExecutor(ThreadFactory threadFactory) {
    return new FinalizableDelegatedExecutorService
        (new ThreadPoolExecutor(1, 1,
                                0L, TimeUnit.MILLISECONDS,
                                new LinkedBlockingQueue<Runnable>(),
                                threadFactory));
}
public static ExecutorService newSingleThreadExecutor() {
    return new FinalizableDelegatedExecutorService
        (new ThreadPoolExecutor(1, 1,
                                0L, TimeUnit.MILLISECONDS,
                                new LinkedBlockingQueue<Runnable>()));
}
从上面源代码可以看出新创建的 SingleThreadExecutor 的 corePoolSize 和 maximumPoolSize 都被设置为 1.其他参数和 FixedThreadPool 相同。
5.2.2 执行任务过程介绍
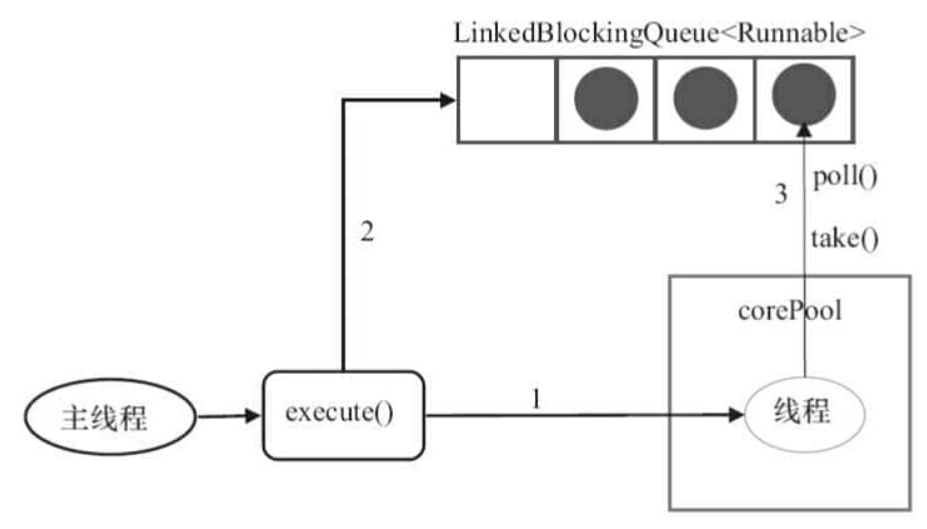
SingleThreadExecutor 的运行示意图(该图片来源:《Java 并发编程的艺术》):
上图说明 :
- 如果当前运行的线程数少于
corePoolSize,则创建一个新的线程执行任务; - 当前线程池中有一个运行的线程后,将任务加入
LinkedBlockingQueue - 线程执行完当前的任务后,会在循环中反复从
LinkedBlockingQueue中获取任务来执行;
5.2.3 为什么不推荐使用SingleThreadExecutor?
SingleThreadExecutor 使用无界队列 LinkedBlockingQueue 作为线程池的工作队列(队列的容量为 Intger.MAX_VALUE)。SingleThreadExecutor 使用无界队列作为线程池的工作队列会对线程池带来的影响与 FixedThreadPool 相同。说简单点就是可能会导致 OOM,
5.3 CachedThreadPool 详解
5.3.1 介绍
CachedThreadPool 是一个会根据需要创建新线程的线程池。下面通过源码来看看 CachedThreadPool 的实现:
/**
* 创建一个线程池,根据需要创建新线程,但会在先前构建的线程可用时重用它。
*/
public static ExecutorService newCachedThreadPool(ThreadFactory threadFactory) {
    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                  60L, TimeUnit.SECONDS,
                                  new SynchronousQueue<Runnable>(),
                                  threadFactory);
}
public static ExecutorService newCachedThreadPool() {
    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                  60L, TimeUnit.SECONDS,
                                  new SynchronousQueue<Runnable>());
}
CachedThreadPool 的corePoolSize 被设置为空(0),maximumPoolSize被设置为 Integer.MAX.VALUE,即它是无界的,这也就意味着如果主线程提交任务的速度高于 maximumPool 中线程处理任务的速度时,CachedThreadPool 会不断创建新的线程。极端情况下,这样会导致耗尽 cpu 和内存资源。
5.3.2 执行任务过程介绍
CachedThreadPool 的 execute() 方法的执行示意图(该图片来源:《Java 并发编程的艺术》):
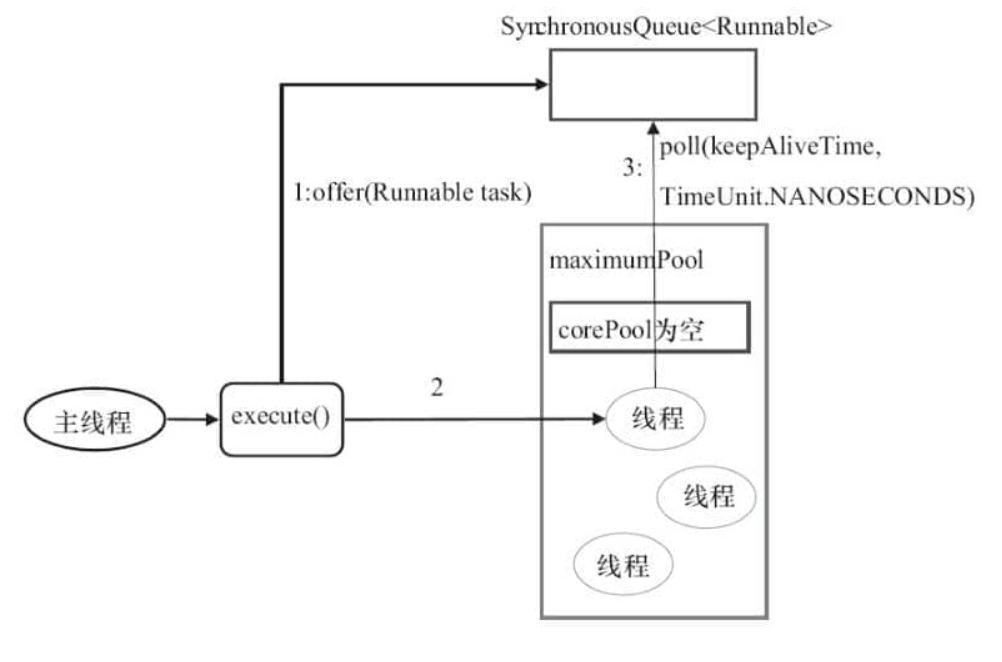
上图说明:
- 首先执行
SynchronousQueue.offer(Runnable task)提交任务到任务队列。如果当前maximumPool中有闲线程正在执行SynchronousQueue.poll(keepAliveTime,TimeUnit.NANOSECONDS),那么主线程执行 offer 操作与空闲线程执行的poll操作配对成功,主线程把任务交给空闲线程执行,execute()方法执行完成,否则执行下面的步骤 2; - 当初始
maximumPool为空,或者maximumPool中没有空闲线程时,将没有线程执行SynchronousQueue.poll(keepAliveTime,TimeUnit.NANOSECONDS)。这种情况下,步骤 1 将失败,此时CachedThreadPool会创建新线程执行任务,execute 方法执行完成;
5.3.3 为什么不推荐使用CachedThreadPool?
CachedThreadPool允许创建的线程数量为 Integer.MAX_VALUE ,可能会创建大量线程,从而导致 OOM。
六 ScheduledThreadPoolExecutor 详解
ScheduledThreadPoolExecutor 主要用来在给定的延迟后运行任务,或者定期执行任务。 这个在实际项目中基本不会被用到,也不推荐使用,大家只需要简单了解一下它的思想即可。
6.1 简介
ScheduledThreadPoolExecutor 使用的任务队列 DelayQueue 封装了一个 PriorityQueue,PriorityQueue 会对队列中的任务进行排序,执行所需时间短的放在前面先被执行(ScheduledFutureTask 的 time 变量小的先执行),如果执行所需时间相同则先提交的任务将被先执行(ScheduledFutureTask 的 squenceNumber 变量小的先执行)。
ScheduledThreadPoolExecutor 和 Timer 的比较:
Timer对系统时钟的变化敏感,ScheduledThreadPoolExecutor不是;Timer只有一个执行线程,因此长时间运行的任务可以延迟其他任务。ScheduledThreadPoolExecutor可以配置任意数量的线程。 此外,如果你想(通过提供 ThreadFactory),你可以完全控制创建的线程;- 在
TimerTask中抛出的运行时异常会杀死一个线程,从而导致Timer死机:-( ...即计划任务将不再运行。ScheduledThreadExecutor不仅捕获运行时异常,还允许您在需要时处理它们(通过重写afterExecute方法ThreadPoolExecutor)。抛出异常的任务将被取消,但其他任务将继续运行。
综上,在 JDK1.5 之后,你没有理由再使用 Timer 进行任务调度了。
6.2 运行机制

ScheduledThreadPoolExecutor 的执行主要分为两大部分:
- 当调用
ScheduledThreadPoolExecutor的scheduleAtFixedRate()方法或者scheduleWithFixedDelay()方法时,会向ScheduledThreadPoolExecutor的DelayQueue添加一个实现了RunnableScheduledFuture接口的ScheduledFutureTask。 - 线程池中的线程从
DelayQueue中获取ScheduledFutureTask,然后执行任务。
ScheduledThreadPoolExecutor 为了实现周期性的执行任务,对 ThreadPoolExecutor做了如下修改:
- 使用
DelayQueue作为任务队列; - 获取任务的方不同
- 执行周期任务后,增加了额外的处理
6.3 ScheduledThreadPoolExecutor 执行周期任务的步骤
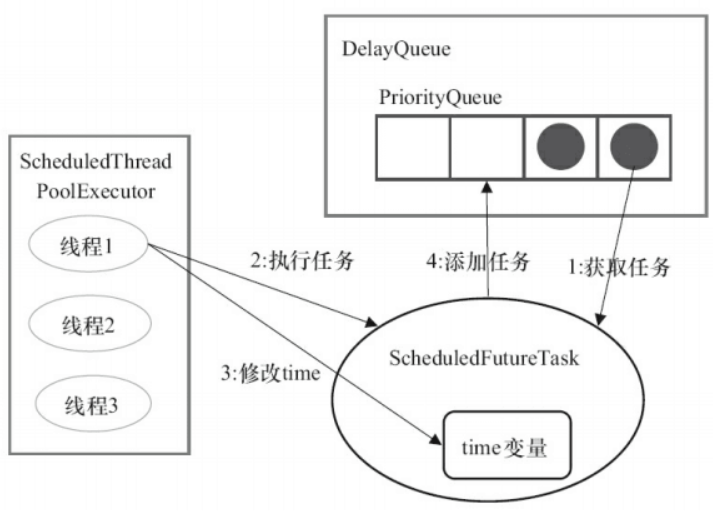
- 线程 1 从
DelayQueue中获取已到期的ScheduledFutureTask(DelayQueue.take())。到期任务是指ScheduledFutureTask的 time 大于等于当前系统的时间; - 线程 1 执行这个
ScheduledFutureTask; - 线程 1 修改
ScheduledFutureTask的 time 变量为下次将要被执行的时间; - 线程 1 把这个修改 time 之后的
ScheduledFutureTask放回DelayQueue中(DelayQueue.add())。
七 线程池大小确定
线程池数量的确定一直是困扰着程序员的一个难题,大部分程序员在设定线程池大小的时候就是随心而定。
很多人甚至可能都会觉得把线程池配置过大一点比较好!我觉得这明显是有问题的。就拿我们生活中非常常见的一例子来说:并不是人多就能把事情做好,增加了沟通交流成本。你本来一件事情只需要 3 个人做,你硬是拉来了 6 个人,会提升做事效率嘛?我想并不会。 线程数量过多的影响也是和我们分配多少人做事情一样,对于多线程这个场景来说主要是增加了上下文切换成本。不清楚什么是上下文切换的话,可以看我下面的介绍。
上下文切换:
多线程编程中一般线程的个数都大于 CPU 核心的个数,而一个 CPU 核心在任意时刻只能被一个线程使用,为了让这些线程都能得到有效执行,CPU 采取的策略是为每个线程分配时间片并轮转的形式。当一个线程的时间片用完的时候就会重新处于就绪状态让给其他线程使用,这个过程就属于一次上下文切换。概括来说就是:当前任务在执行完 CPU 时间片切换到另一个任务之前会先保存自己的状态,以便下次再切换回这个任务时,可以再加载这个任务的状态。任务从保存到再加载的过程就是一次上下文切换。
上下文切换通常是计算密集型的。也就是说,它需要相当可观的处理器时间,在每秒几十上百次的切换中,每次切换都需要纳秒量级的时间。所以,上下文切换对系统来说意味着消耗大量的 CPU 时间,事实上,可能是操作系统中时间消耗最大的操作。
Linux 相比与其他操作系统(包括其他类 Unix 系统)有很多的优点,其中有一项就是,其上下文切换和模式切换的时间消耗非常少。
类比于现实世界中的人类通过合作做某件事情,我们可以肯定的一点是线程池大小设置过大或者过小都会有问题,合适的才是最好。
如果我们设置的线程池数量太小的话,如果同一时间有大量任务/请求需要处理,可能会导致大量的请求/任务在任务队列中排队等待执行,甚至会出现任务队列满了之后任务/请求无法处理的情况,或者大量任务堆积在任务队列导致 OOM。这样很明显是有问题的! CPU 根本没有得到充分利用。
但是,如果我们设置线程数量太大,大量线程可能会同时在争取 CPU 资源,这样会导致大量的上下文切换,从而增加线程的执行时间,影响了整体执行效率。
有一个简单并且适用面比较广的公式:
- CPU 密集型任务(N+1): 这种任务消耗的主要是 CPU 资源,可以将线程数设置为 N(CPU 核心数)+1,比 CPU 核心数多出来的一个线程是为了防止线程偶发的缺页中断,或者其它原因导致的任务暂停而带来的影响。一旦任务暂停,CPU 就会处于空闲状态,而在这种情况下多出来的一个线程就可以充分利用 CPU 的空闲时间。
- I/O 密集型任务(2N): 这种任务应用起来,系统会用大部分的时间来处理 I/O 交互,而线程在处理 I/O 的时间段内不会占用 CPU 来处理,这时就可以将 CPU 交出给其它线程使用。因此在 I/O 密集型任务的应用中,我们可以多配置一些线程,具体的计算方法是 2N。
如何判断是 CPU 密集任务还是 IO 密集任务?
CPU 密集型简单理解就是利用 CPU 计算能力的任务比如你在内存中对大量数据进行排序。但凡涉及到网络读取,文件读取这类都是 IO 密集型,这类任务的特点是 CPU 计算耗费时间相比于等待 IO 操作完成的时间来说很少,大部分时间都花在了等待 IO 操作完成上。
🌈 拓展一下(参见:issue#1737):
线程数更严谨的计算的方法应该是:
最佳线程数 = N(CPU 核心数)∗(1+WT(线程等待时间)/ST(线程计算时间)),其中WT(线程等待时间)=线程运行总时间 - ST(线程计算时间)。线程等待时间所占比例越高,需要越多线程。线程计算时间所占比例越高,需要越少线程。
我们可以通过 JDK 自带的工具 VisualVM 来查看
WT/ST比例。CPU 密集型任务的
WT/ST接近或者等于 0,因此, 线程数可以设置为 N(CPU 核心数)∗(1+0)= N,和我们上面说的 N(CPU 核心数)+1 差不多。IO 密集型任务下,几乎全是线程等待时间,从理论上来说,你就可以将线程数设置为 2N(按道理来说,WT/ST 的结果应该比较大,这里选择 2N 的原因应该是为了避免创建过多线程吧)。
公示也只是参考,具体还是要根据项目实际线上运行情况来动态调整。我在后面介绍的美团的线程池参数动态配置这种方案就非常不错,很实用!
美团的骚操作
美团技术团队在《Java 线程池实现原理及其在美团业务中的实践》这篇文章中介绍到对线程池参数实现可自定义配置的思路和方法。
美团技术团队的思路是主要对线程池的核心参数实现自定义可配置。这三个核心参数是:
corePoolSize: 核心线程数线程数定义了最小可以同时运行的线程数量。maximumPoolSize: 当队列中存放的任务达到队列容量的时候,当前可以同时运行的线程数量变为最大线程数。workQueue: 当新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
为什么是这三个参数?
我在这篇《新手也能看懂的线程池学习总结》中就说过这三个参数是 ThreadPoolExecutor 最重要的参数,它们基本决定了线程池对于任务的处理策略。
如何支持参数动态配置? 且看 ThreadPoolExecutor 提供的下面这些方法。

格外需要注意的是corePoolSize, 程序运行期间的时候,我们调用 setCorePoolSize()这个方法的话,线程池会首先判断当前工作线程数是否大于corePoolSize,如果大于的话就会回收工作线程。
另外,你也看到了上面并没有动态指定队列长度的方法,美团的方式是自定义了一个叫做 ResizableCapacityLinkedBlockIngQueue 的队列(主要就是把LinkedBlockingQueue的 capacity 字段的 final 关键字修饰给去掉了,让它变为可变的)。
最终实现的可动态修改线程池参数效果如下。👏👏👏
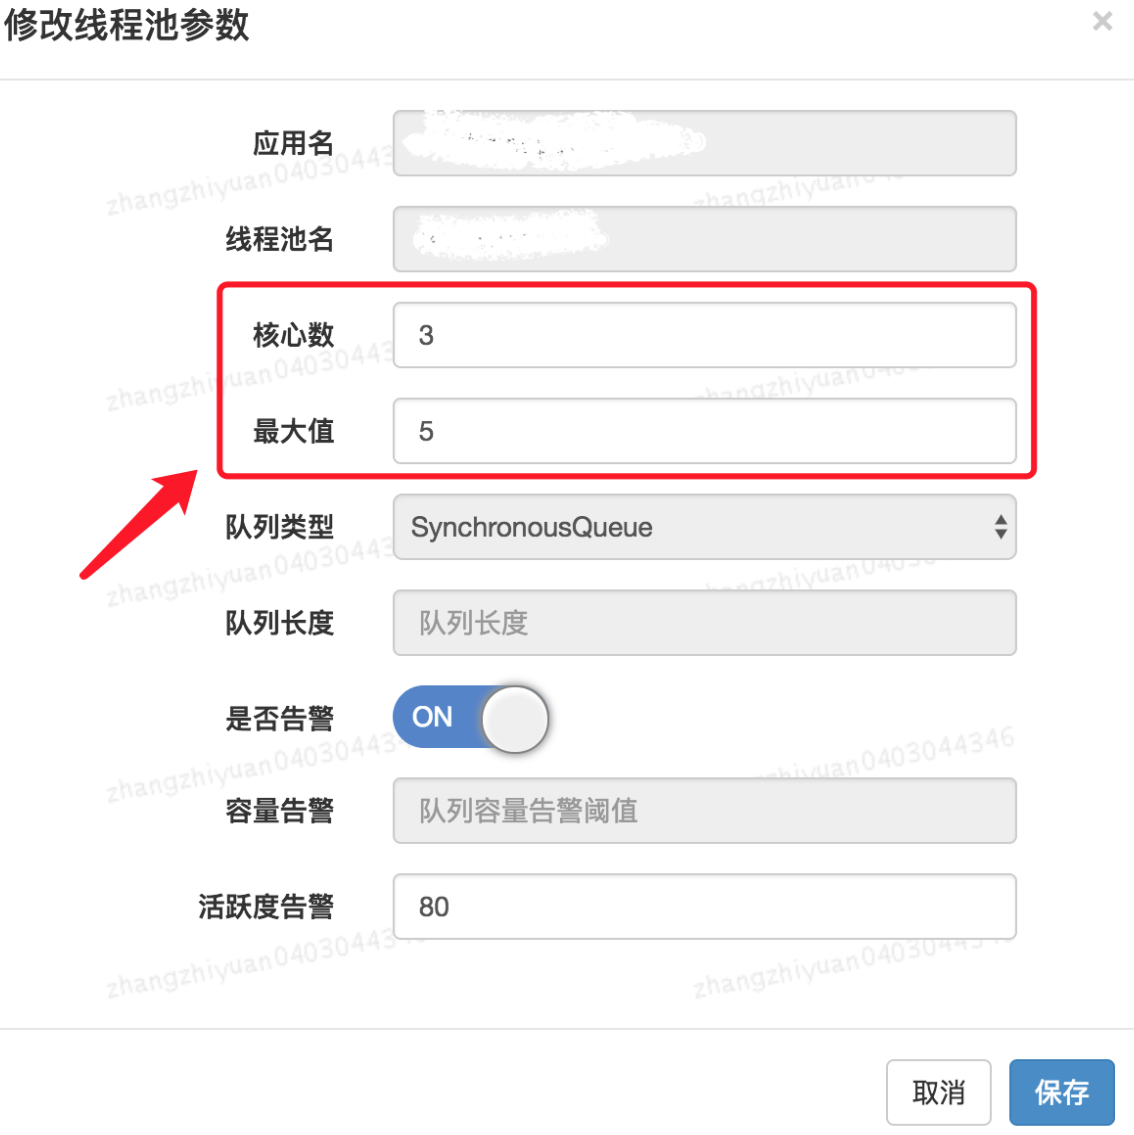
还没看够?推荐 why 神的《如何设置线程池参数?美团给出了一个让面试官虎躯一震的回答。》这篇文章,深度剖析,很不错哦!
九 其他推荐阅读
Java 线程池最佳实践
线程池知识回顾
线程池在实际项目的使用场景
线程池一般用于执行多个不相关联的耗时任务,没有多线程的情况下,任务顺序执行,使用了线程池的话可让多个不相关联的任务同时执行。
假设我们要执行三个不相关的耗时任务,Guide 画图给大家展示了使用线程池前后的区别。注意:下面三个任务可能做的是同一件事情,也可能是不一样的事情。
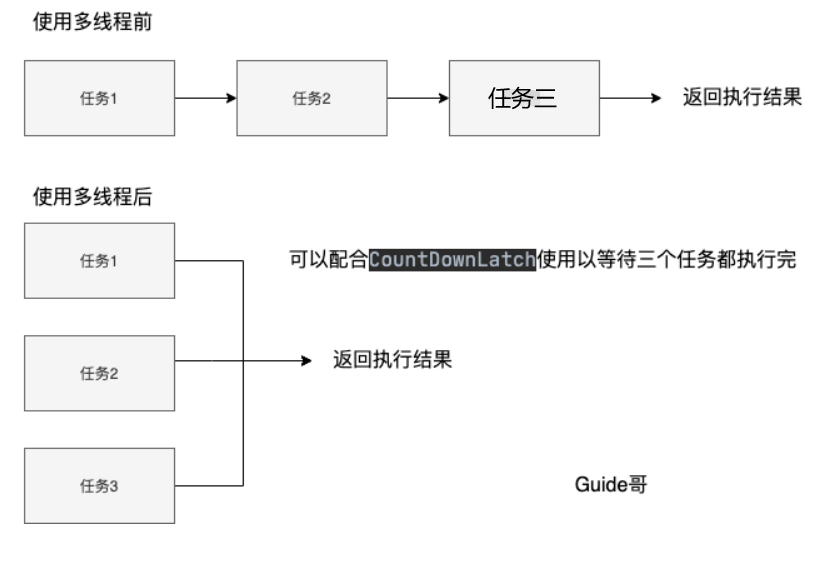
如何使用线程池?
一般是通过 ThreadPoolExecutor 的构造函数来创建线程池,然后提交任务给线程池执行就可以了。
ThreadPoolExecutor构造函数如下:
/**
* 用给定的初始参数创建一个新的ThreadPoolExecutor。
*/
public ThreadPoolExecutor(int corePoolSize,//线程池的核心线程数量
                          int maximumPoolSize,//线程池的最大线程数
                          long keepAliveTime,//当线程数大于核心线程数时,多余的空闲线程存活的最长时间
                          TimeUnit unit,//时间单位
                          BlockingQueue<Runnable> workQueue,//任务队列,用来储存等待执行任务的队列
                          ThreadFactory threadFactory,//线程工厂,用来创建线程,一般默认即可
                          RejectedExecutionHandler handler//拒绝策略,当提交的任务过多而不能及时处理时,我们可以定制策略来处理任务
                         ) {
    if (corePoolSize < 0 ||
        maximumPoolSize <= 0 ||
        maximumPoolSize < corePoolSize ||
        keepAliveTime < 0)
        throw new IllegalArgumentException();
    if (workQueue == null || threadFactory == null || handler == null)
        throw new NullPointerException();
    this.corePoolSize = corePoolSize;
    this.maximumPoolSize = maximumPoolSize;
    this.workQueue = workQueue;
    this.keepAliveTime = unit.toNanos(keepAliveTime);
    this.threadFactory = threadFactory;
    this.handler = handler;
}
具体Demo可以查看线程池内容,在上面已经写过了。
如何判断线程池已经执行完所有任务了?
参考面试突击35:如何判断线程池已经执行完所有任务了? - 磊哥|www.javacn.site - 博客园 (cnblogs.com)
线程池最佳实践
简单总结一下我了解的使用线程池的时候应该注意的东西,网上似乎还没有专门写这方面的文章。因为 Guide 还比较菜,有补充和完善的地方,可以在评论区告知或者在微信上与我交流。
1. 使用 ThreadPoolExecutor 的构造函数声明线程池
1. 线程池必须手动通过 ThreadPoolExecutor 的构造函数来声明,避免使用Executors 类的 newFixedThreadPool 和 newCachedThreadPool ,因为可能会有 OOM 的风险。
说白了就是:使用有界队列,控制线程创建数量。
除了避免 OOM 的原因之外,不推荐使用 Executors提供的两种快捷的线程池的原因还有:
- 实际使用中需要根据自己机器的性能、业务场景来手动配置线程池的参数比如核心线程数、使用的任务队列、饱和策略等等。
- 我们应该显示地给我们的线程池命名,这样有助于我们定位问题。
2.监测线程池运行状态
你可以通过一些手段来检测线程池的运行状态比如 SpringBoot 中的 Actuator 组件。除此之外,我们还可以利用 ThreadPoolExecutor 的相关 API 做一个简陋的监控。从下图可以看出, ThreadPoolExecutor提供了获取线程池当前的线程数和活跃线程数、已经执行完成的任务数、正在排队中的任务数等等。
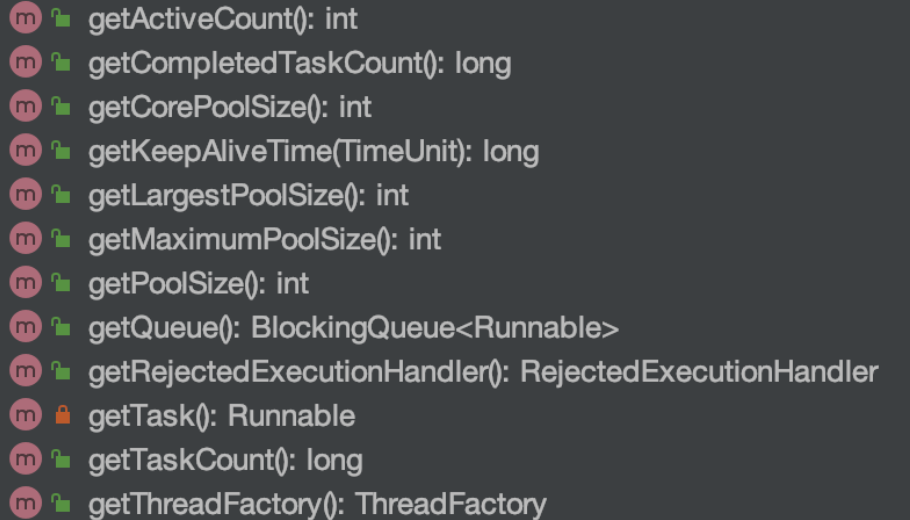
下面是一个简单的 Demo。printThreadPoolStatus()会每隔一秒打印出线程池的线程数、活跃线程数、完成的任务数、以及队列中的任务数。
/**
* 打印线程池的状态
*
* @param threadPool 线程池对象
*/
public static void printThreadPoolStatus(ThreadPoolExecutor threadPool) {
    ScheduledExecutorService scheduledExecutorService = new ScheduledThreadPoolExecutor(1, createThreadFactory("print-images/thread-pool-status", false));
    scheduledExecutorService.scheduleAtFixedRate(() -> {
        log.info("=========================");
        log.info("ThreadPool Size: [{}]", threadPool.getPoolSize());
        log.info("Active Threads: {}", threadPool.getActiveCount());
        log.info("Number of Tasks : {}", threadPool.getCompletedTaskCount());
        log.info("Number of Tasks in Queue: {}", threadPool.getQueue().size());
        log.info("=========================");
    }, 0, 1, TimeUnit.SECONDS);
}
3.建议不同类别的业务用不同的线程池
很多人在实际项目中都会有类似这样的问题:我的项目中多个业务需要用到线程池,是为每个线程池都定义一个还是说定义一个公共的线程池呢?
一般建议是不同的业务使用不同的线程池,配置线程池的时候根据当前业务的情况对当前线程池进行配置,因为不同的业务的并发以及对资源的使用情况都不同,重心优化系统性能瓶颈相关的业务。
我们再来看一个真实的事故案例! (本案例来源自:《线程池运用不当的一次线上事故》,很精彩的一个案例)。
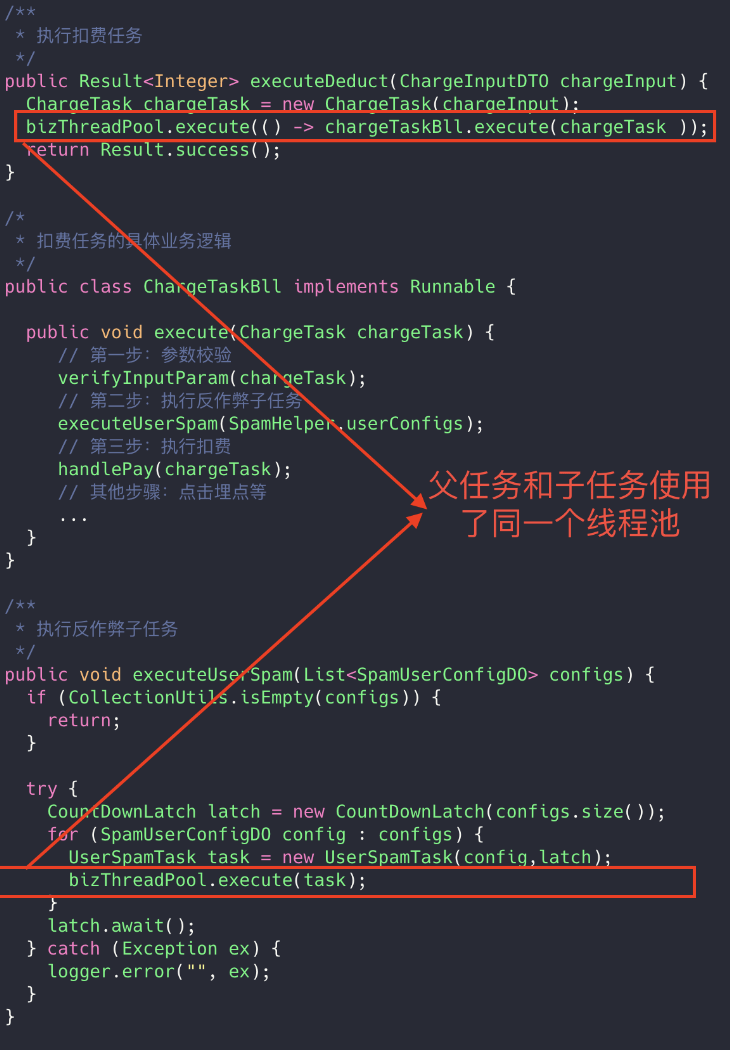
上面的代码可能会存在死锁的情况,为什么呢?画个图给大家捋一捋。
试想这样一种极端情况:假如我们线程池的核心线程数为 n,父任务(扣费任务)数量为 n,父任务下面有两个子任务(扣费任务下的子任务),其中一个已经执行完成,另外一个被放在了任务队列中。由于父任务把线程池核心线程资源用完,所以子任务因为无法获取到线程资源无法正常执行,一直被阻塞在队列中。父任务等待子任务执行完成,而子任务等待父任务释放线程池资源,这也就造成了 "死锁"。
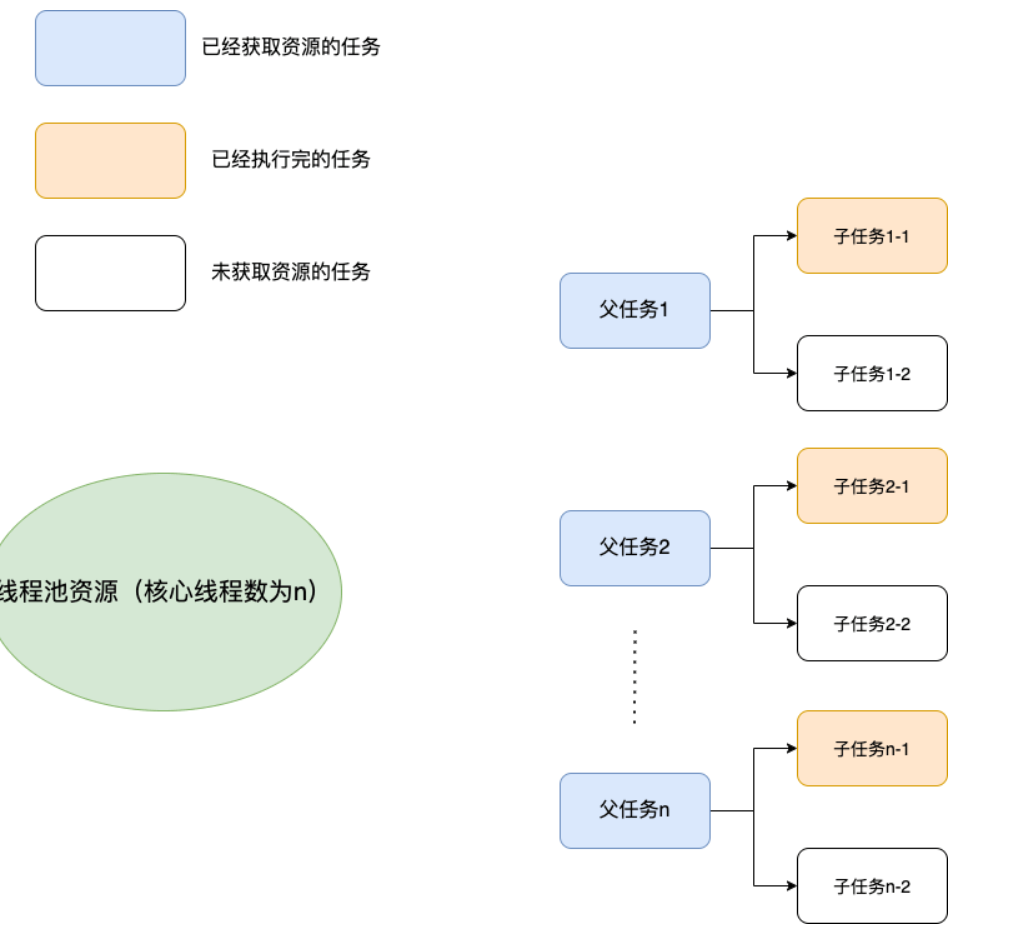
解决方法也很简单,就是新增加一个用于执行子任务的线程池专门为其服务。
4.别忘记给线程池命名
初始化线程池的时候需要显示命名(设置线程池名称前缀),有利于定位问题。默认情况下创建的线程名字类似 pool-1-thread-n 这样的,没有业务含义,不利于我们定位问题。
给线程池里的线程命名通常有下面两种方式:
1.利用 guava 的 ThreadFactoryBuilder
hreadFactory threadFactory = new ThreadFactoryBuilder()
                        .setNameFormat(threadNamePrefix + "-%d")
                        .setDaemon(true).build();
ExecutorService threadPool = new ThreadPoolExecutor(corePoolSize, maximumPoolSize, keepAliveTime, TimeUnit.MINUTES, workQueue, threadFactory)
2.自己实现 ThreadFactor。
import java.util.concurrent.Executors;
import java.util.concurrent.ThreadFactory;
import java.util.concurrent.atomic.AtomicInteger;
/**
 * 线程工厂,它设置线程名称,有利于我们定位问题。
 */
public final class NamingThreadFactory implements ThreadFactory {

    private final AtomicInteger threadNum = new AtomicInteger();
    private final ThreadFactory delegate;
    private final String name;

    /**
     * 创建一个带名字的线程池生产工厂
     */
    public NamingThreadFactory(ThreadFactory delegate, String name) {
        this.delegate = delegate;
        this.name = name; // TODO consider uniquifying this
    }

    @Override
    public Thread newThread(Runnable r) {
        Thread t = delegate.newThread(r);
        t.setName(name + " [#" + threadNum.incrementAndGet() + "]");
        return t;
    }

}
5.正确配置线程池参数
说到如何给线程池配置参数,美团的骚操作至今让我难忘(后面会提到)!我们先来看一下各种书籍和博客上一般推荐的配置线程池参数的方式,可以作为参考!前面有介绍。

 浙公网安备 33010602011771号