
链接:https://www.zhihu.com/question/36339816/answer/385944057
来源:知乎
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
公式是LaTeX的,直接打开前面的链接。
刚刚写了一波专栏直观数学漫谈,今天来强答一发这个问题,前面的一元以及维度不相关的多维高斯分布熟悉的可以直接跳过
好,让我们来研究研究这个看起来这么复杂的多元高斯分布吧,我也顺便学一学LaTeX公式书写吧,毕竟还是人生第一次写LaTeX公式!
先从均值为0,方差为1的一元正态分布开始,概率密度函数为:
f(x)=12πe−x22f(x)=\frac{1}{\sqrt{2\pi}}e^{-\frac{x^2}{2}}
在均值为 μ\mu ,方差为 σ2\sigma^2 的情况下,需要标准化一下: z=x−μσz=\frac{x-\mu}{\sigma} ,标准化之后方差变为1,标准化的意义在于将数据点 xx 到均值 μ\mu 的距离转化为数据点 xx 到均值的距离等于多少个总体的标准差 σ\sigma ,这样,就消除了数据分布差异和量纲对概率计算的影响,此时的概率密度函数为:
f(x)=1σ2πe−z22=1σ2πe−(x−μ)22σ2f(x)=\frac{1}{\sigma\sqrt{2\pi}}e^{-\frac{z^2}{2}}=\frac{1}{\sigma\sqrt{2\pi}}e^{-\frac{(x-\mu)^2}{2\sigma^2}}
可见,高斯分布的概率密度计算核心在于计算数据点到中心的距离,并且除以标准差将这个绝对距离转化为相对距离,然后通过距离平方的指数衰减计算概率密度。
回到多元正态分布,先从各维度不相关的多元正态分布入手,数据点通过 dd 维的列向量描述 x=[x1,x2,⋯,xd]Tx=\left[ x_1,x_2,\cdots,x_d \right]^T ,各个维度的均值方差分别为 μ1,μ2,⋯,μd\mu_1,\mu_2,\cdots,\mu_d , σ1,σ2,⋯,σd\sigma_1,\sigma_2,\cdots,\sigma_d 来描述,高斯概率密度函数可以表示为:
f(x)=1(2π)dσ1σ2⋯σde−12[(x1−μ1σ1)2+(x2−μ2σ2)2+⋯+(xd−μ1σd)2]f(x)=\frac{1}{(\sqrt{2\pi})^d\sigma_1\sigma_2\cdots\sigma_d}e^{-\frac{1}{2}[(\frac{x_1-\mu_1}{\sigma_1})^2+(\frac{x_2-\mu_2}{\sigma_2})^2+\cdots+(\frac{x_d-\mu_1}{\sigma_d})^2]}
前面多出的项是为了让概率之和为1,其实这个方程可以这样子去解读:
f(x)=1(2π)σ1e−12(x1−μ1σ1)21(2π)σ2e−12(x2−μ2σ2)2⋯1(2π)σde−12(xd−μdσd)2f(x)=\frac{1}{(\sqrt{2\pi})\sigma_1}e^{-\frac{1}{2}(\frac{x_1-\mu_1}{\sigma_1})^2}\frac{1}{(\sqrt{2\pi})\sigma_2}e^{-\frac{1}{2}(\frac{x_2-\mu_2}{\sigma_2})^2}\cdots\frac{1}{(\sqrt{2\pi})\sigma_d}e^{-\frac{1}{2}(\frac{x_d-\mu_d}{\sigma_d})^2}
这样,各个维度之间不相关的多元正态分布概率密度其实就是各个维度的正态分布概率密度函数的乘积,其实是因为各变量之间互不相关,因此联合概率密度等于各自概率密度的乘积,我们来把她写的漂亮点:
d2(x,μ)=(x1−μ1σ1)2+(x2−μ2σ2)2+⋯+(xd−μ1σd)2=[x1−μ1,x2−μ2,⋯,xd−μd][1σ120⋯001σ22⋯0⋮⋮⋱⋮00⋯1σd2][x1−μ1x2−μ2⋮xd−μd]=(X−μ)TΣ−1(X−μ)d^2(x,\mu)=(\frac{x_1-\mu_1}{\sigma_1})^2+(\frac{x_2-\mu_2}{\sigma_2})^2+\cdots+(\frac{x_d-\mu_1}{\sigma_d})^2\\= \left[x_1-\mu_1,x_2-\mu_2,\cdots,x_d-\mu_d\right]\left[\begin{matrix} \frac{1}{\sigma_{1}^{2}}&0&\cdots&0\\ 0&\frac{1}{\sigma_{2}^{2}}&\cdots&0\\ \vdots&\vdots&\ddots&\vdots\\ 0&0&\cdots&\frac{1}{\sigma_{d}^{2}} \end{matrix} \right]\left[\begin{matrix}x_1-\mu_1\\x_2-\mu_2\\\vdots\\x_d-\mu_d\end{matrix}\right]\\=(X-\mu)^T\Sigma^{-1}(X-\mu)
f(x)=1(2π)d(σ1σ2⋯σd)exp(−12d(x,μ)2)=1(2π)d2|Σ|12e−12(X−μ)TΣ−1(X−μ)f(x)=\frac{1}{(\sqrt{2\pi})^d(\sigma_1\sigma_2\cdots\sigma_d)}\exp{(-\frac{1}{2}d(x,\mu)^2)}\\=\frac{1}{(2\pi)^{\frac{d}{2}}\left|\Sigma\right|^\frac{1}{2}}e^{ -\frac{1}{2}(X-\mu)^T\Sigma^{-1}(X-\mu)}
其中, Σ\Sigma 是协方差矩阵,里面的第 ii 行第 jj 列元素表示第 ii 个变量第 jj 个变量的协方差,由于假设了各个维度之间不相关,因此协方差矩阵只有在对角线的位置有值,代表不同变量的方差大小。这里面用到了 σ1σ2⋯σd=|Σ|12\sigma_1\sigma_2\cdots\sigma_d=\left| \Sigma \right|^\frac{1}{2} (行列式的计算,对角行列式等于对角线上元素的乘积)。
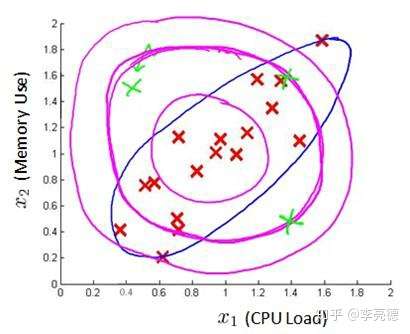
好,那么回到问题的重点,在维度之间互相关的多元高斯分布中,如何计算相对距离呢?让我来举个吴恩达老师课上的例子,这是一个二维正态分布,memory use和CPU load之间存在明显的正相关关系,如果按照之前维度不相关的计算方法,图中的绿色异常点就会被视作是正常的(真实分布是倾斜的椭圆)。
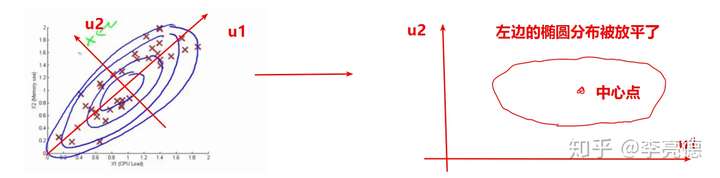
一个直观上的思想是用化归的思想,你不是相关,那我想法子把你变成不相关的。在这个例子中,直觉的做法是找到倾斜的椭圆分布的长轴方向u1和短轴方向u2,计算数据点在这两个轴上的坐标(变换到这两个方向之后,新的维度之间显然是不相关的),以长轴为x轴,短轴为y轴建立新的坐标系;经过这样的变换后相当于将倾斜的椭圆放平,此时数据的各个维度之间不相关(学过主成分分析的同学有没有感觉这个概念很熟悉),就可以用前面各维度不相关的高斯分布解了。如下图所示:
如果变换的方向u1和u2用列向量 u1=[u11u12],u2=[u21u22]u_1=\left[\begin{matrix} u_1^1\\u_1^2\end{matrix}\right] ,u_2=\left[\begin{matrix} u_2^1\\u_2^2\end{matrix}\right] ,那么数据的投影长度可以用点积来计算为:
u1T⋅X=[u11,u12][x1x2]u_1^T \cdot X=\left[u_1^1,u_1^2\right]\left[\begin{matrix} x_1\\x_2\end{matrix}\right]
投影长度代表了数据点在u1方向上的坐标
这个过程可以用矩阵变换表示为:
其中代表源空间的数据坐标每一列代表一个投影方向Y=[u1T⋅Xu2T⋅X]=[u1Tu2T]X=UTX,其中X=[x1x2]代表源空间的数据坐标U=[u1,u2]每一列代表一个投影方向Y=\left[\begin{matrix}u_1^T\cdot X\\u_2^T \cdot X\end{matrix}\right] =\left[\begin{matrix}u_1^T\\u_2^T \end{matrix}\right]X=U^TX, 其中X=\left[\begin{matrix}x_1\\x_2\end{matrix}\right]代表源空间的数据坐标\\ U=[u_1,u_2]每一列代表一个投影方向
这里面 u1,u2u_1, u_2 代表变换方向的单位向量。u1T⋅Xu_1^T\cdot X 代表的是将数据点 XX 投影到 u1u_1 方向上的长度。
需要注意的是 u1,u2u_1,u_2 都是单位向量,而且相互垂直,所以 UU 是一个正交矩阵 UT=U−1U^T=U^{-1}
好,按照我们的预定计划,现在数据的各个维度已经去相关,那么我们可以拿前面的各维度不相关的多元正态分布来计算啦!当前在计算之前还需要将数据标准化一下,消除一下量纲的影响嘛:
Z=[Y1−μY1σY1Y2−μY2σY2]=[1/σY1,00,1/σY2][Y1−μY1Y2−μY2]=D(Y−μY)=D(UTX−UTμX)=DUT(X−μX)Z=\left[\begin{matrix}\frac{Y_1-\mu_{Y1}}{\sigma_{Y1}} \\ \frac{Y_2-\mu_{Y2}}{\sigma_{Y2}}\end{matrix}\right]=\left[\begin{matrix} 1/\sigma_{Y1},0\\0,1/\sigma_{Y2}\end{matrix}\right]\left[\begin{matrix} Y_1-\mu_{Y_1}\\Y_2-\mu_{Y2}\end{matrix}\right]\\ =D(Y-\mu_Y)=D(U^TX-U^T\mu_X)\\ =DU^T(X-\mu_X)
好啦,上面的推导其实道理很简单的,只是我写的繁琐了一点,好那么我画个图直观的看一下数据点的变化情况:
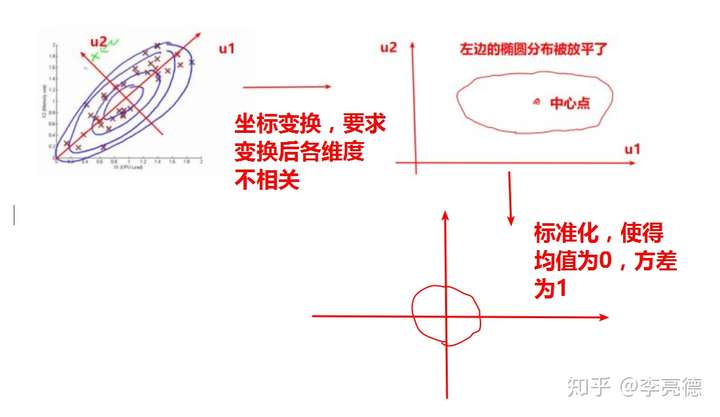
后面的推导核心在于构建变换前后协方差矩阵的关系,发现将变换前协方差矩阵对角化之后就得到了变换后的协方差矩阵,其实如果你对推导不感兴趣的话,你看到这里掌握思想就可以了,不必深究如何推导的。
好,言归正传,看来三步走之后,我已经可以计算概率密度了,先算一下相对距离的平方吧:
d2(z,μ)=z12+z22=[z1,z2][z1z2]=ZTZd^2(z,\mu)=z_1^2+z_2^2=\left[z_1,z_2 \right]\left[\begin{matrix}z_1\\z_2 \end{matrix}\right]=Z^TZ
是去相关后数据的协方差矩阵,因为是对角阵,所以她的逆等于对角元素取倒数d2(x,μ)=ZTZ=(DUT(X−μX))T(DUT(X−μX))=(X−μX)TUDTDUT(X−μX)ΣY−1=DTD=[1/σY12,00,1/σY22]ΣY是去相关后数据的协方差矩阵,因为是对角阵,所以她的逆等于对角元素取倒数d^2(x,\mu)=Z^TZ=(DU^T(X-\mu_X))^T(DU^T(X-\mu_X))\\=(X-\mu_X)^TUD^TDU^T(X-\mu_X)\\ \Sigma_Y^{-1}=D^TD=\left[\begin{matrix} 1/\sigma_{Y1}^2,0\\0,1/\sigma_{Y2}^2\end{matrix}\right]\\ \Sigma_Y是去相关后数据的协方差矩阵,因为是对角阵,所以她的逆等于对角元素取倒数
这个方程,怎么说呢,你需找出变换方向,还需要算出变换后的方差,这看着好麻烦,能不能构建一下源空间和目标空间的关系,这样我们直接利用源空间的数据算就可以了呢?
其实我们还有一个条件,就是变换后数据各维度不相关,也就是说变换后的协方差矩阵是对角阵 ΣY=[σY12,00,σY22]\Sigma_Y=\left[\begin{matrix} \sigma_{Y1}^2,0\\0,\sigma_{Y2}^2\end{matrix}\right] ,那我尝试着从定义入手搞一发:
ΣY=E[(Y−μY)(Y−μY)T]=E[UT(X−μX)(X−μX)TU]=UTE[(X−μX)(X−μX)T]U=UTΣXU\Sigma_Y=E[(Y-\mu_Y)(Y-\mu_Y)^T]\\ =E[U^T(X-\mu_X)(X-\mu_X)^TU]\\ =U^TE[(X-\mu_X)(X-\mu_X)^T]U =U^T\Sigma_XU
即: 是正交矩阵,所以ΣX=UΣYUT,U是正交矩阵,所以U−1=UT\Sigma_X=U\Sigma_YU^T,U是正交矩阵,所以U^{-1}=U^T
上面我们推导得到的: 而:即:所以:UDTDUT=UΣY−1UT而:(UΣY−1UT)(UΣYUT)=I即:(UΣY−1UT)ΣX=I所以:UDTDUT=ΣX−1UD^TDU^T=U\Sigma_Y^{-1}U^T\\ 而:(U\Sigma_Y^{-1}U^T)(U\Sigma_YU^T)=I \\即:(U\Sigma_Y^{-1}U^T)\Sigma_X=I \\所以:UD^TDU^T=\Sigma_X^{-1}
哇,最烦人的那项 UDTDUTUD^TDU^T 竟然就等于源空间中的协方差矩阵的逆 ΣX−1\Sigma_X^{-1} ,结果竟然如此简洁,那么我们把它代入吧:
d2(x,μ)=(X−μX)TΣX−1(X−μX)d^2(x,\mu)=(X-\mu_X)^T\Sigma_X^{-1}(X-\mu_X)
注意!我们在计算的过程中,得到的最终零均值,方差为1的 ZZ ,相当于对原坐标 XX 做了一次变换:
Z=DUT(X−μX)Z=DU^T(X-\mu_X)
使Z成为去相关的零均值,方差为1的正态分布,因此概率密度函数在源空间做全空间积分的时候需要做换元变换,整体减小了 |DUT|\left| DU^T \right| ,因为 DUTUDT=ΣX−1DU^TUD^T=\Sigma_X^{-1} ,所以 |DUT|=|ΣX−1|=|ΣX|−12\left| DU^T \right|=\sqrt{\left| \Sigma_X^{-1} \right|}=\left| \Sigma_X \right|^{-\frac{1}{2}}
所以为了保证概率密度函数全空间积分为1,需要乘上 |ΣX|−12\left| \Sigma_X \right|^{-\frac{1}{2}} ,还需要除以 (2π)d(\sqrt{2\pi})^d
这一项是在计算 ex2e^{x^2} 的积分时引入的,每个维度都会有,所以是 dd 次方
因此,整体的概率密度函数表达式是:
f(x)=12πe−z2/2=1(2π)d2|ΣX|12e(X−μX)TΣX−1(X−μX)f(x)=\frac{1}{\sqrt{2\pi}}e^{-z^2/2}=\frac{1}{(2\pi)^\frac{d}{2}\left|\Sigma_X\right|^\frac{1}{2}}e^{(X-\mu_X)^T\Sigma_X^{-1}(X-\mu_X)}
补充一点,我在上面的推导过程中,是基于二元正态分布推导的,但这个推导过程对于任意的 dd 维向量都是适用的,所以在最后的表达式里面,我写成了 dd 维了
好,让我们来总结一下,其实主要思想是通过线性变换,将数据的各维度去相关,再将去相关后的数据标准化,但是在推导概率分布过程中,可以消去这个变换,只需要求源空间的协方差矩阵就可以了。其实,这个过程跟主成分分析的过程很相似的,不过主成分分析的过程是在对数据去相关之后,取前面K个方差最大(保留信息)的方向。这样来说,实现主成分分析也是很简单的,根据 ΣY=UTΣXU\Sigma_Y=U^T\Sigma_XU ,你只需要用大一的线代知识将 ΣX\Sigma_X 对角化就可以了(特征值分解)!得到的 UU 就是变化的方向!变换后的新坐标: Y=UTXY=U^TX 就是数学建模同学老是挂在嘴边的主成分得分啦。
等我有时间,再写一篇主成分分析的,有兴趣的知友可以关注专栏:直观数学漫谈

 浙公网安备 33010602011771号