
R语言-数据整形之apply函数族
R语言中的apply函数族
前言
最初学习R的时候,当成“又一门编程语言”来学习,但是怎么学都觉得别扭。现在我的看法倾向于,R不是一种通用型的编程语言,而是一种统计领域的软件工具。因此,不能用通用型编程的思维来设计R代码。R是一种面向数组(array-oriented)的语法,它更像数学,方便科学家将数学公式转化为R代码。在使用R时,要尽量用array的方式思考,避免for循环。
这是为什么呢?原因在于R的循环操作for和while,都是基于R语言本身来实现的,而向量操作是基于底层的C语言函数实现的,从性能上来看,就会有比较明显的差距了。那么如何使用C的函数来实现向量计算呢,就是要用到apply的家族函数,包括apply, sapply, tapply, mapply, lapply, rapply, vapply, eapply等。
目录
1. apply的家族函数
2. apply函数
3. lapply函数
4. sapply函数
5. vapply函数
6. mapply函数
7. tapply函数
8. rapply函数
9. eapply函数
10. example汇总
1. apply的家族函数
apply函数族是R语言中数据处理的一组核心函数,通过使用apply函数,我们可以实现对数据的循环、分组、过滤、类型控制等操作。但是,由于在R语言中apply函数与其他语言循环体的处理思路是完全不一样的,所以apply函数族一直是使用者玩不转一类核心函数。
很多R语言新手,写了很多的for循环代码,也不愿意多花点时间把apply函数的使用方法了解清楚,最后把R代码写的跟C似得,我严重鄙视只会写for的R程序员。
apply函数本身就是解决数据循环处理的问题,为了面向不同的数据类型,不同的返回值,apply函数组成了一个函数族,包括了8个功能类似的函数。这其中有些函数很相似,有些也不是太一样的。
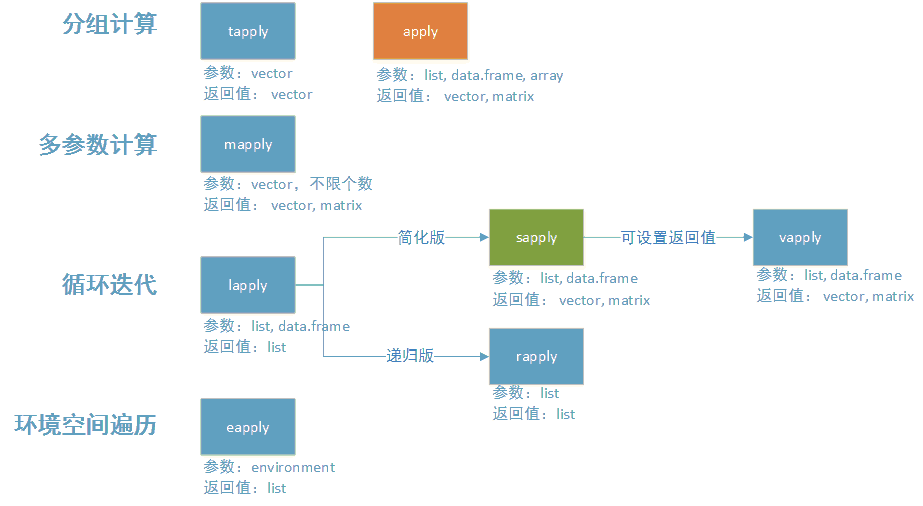
我一般最常用的函数为apply和sapply,下面将分别介绍这8个函数的定义和使用方法。
2. apply函数
apply函数是最常用的代替for循环的函数。apply函数可以对矩阵、数据框、数组(二维、多维),按行或列进行循环计算,对子元素进行迭代,并把子元素以参数传递的形式给自定义的FUN函数中,并以返回计算结果。
-
函数定义:
apply(X, MARGIN, FUN, ...)
-
参数列表:
-
X: 数组、矩阵、数据框
-
MARGIN: 按行计算或按按列计算,1表示按行,2表示按列
-
FUN: 自定义的调用函数
-
…: 更多参数,可选
-
例1:比如,对一个矩阵的每一行求和,下面就要用到apply做循环了。
> x<-matrix(1:12,ncol=3)
> apply(x,1,sum)
[1] 15 18 21 24
例2:下面计算一个稍微复杂点的例子,按行循环,让数据框的x1列加1,并计算出x1,x2列的均值。
生成data.frame
> x <- cbind(x1 = 3, x2 = c(4:1, 2:5)); x
x1 x2
[1,] 3 4
[2,] 3 3
[3,] 3 2
[4,] 3 1
[5,] 3 2
[6,] 3 3
[7,] 3 4
[8,] 3 5
自定义函数myFUN,第一个参数x为数据
第二、三个参数为自定义参数,可以通过apply的'...'进行传入。
> myFUN<- function(x, c1, c2) {
+ c(sum(x[c1],1), mean(x[c2]))
+ }
把数据框按行做循环,每行分别传递给myFUN函数,设置c1,c2对应myFUN的第二、三个参数
> apply(x,1,myFUN,c1='x1',c2=c('x1','x2'))
[,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8]
[1,] 4.0 4 4.0 4 4.0 4 4.0 4
[2,] 3.5 3 2.5 2 2.5 3 3.5 4
通过这个上面的自定义函数myFUN就实现了,一个常用的循环计算。
如果直接用for循环来实现,那么代码如下:
定义一个结果的数据框
> df<-data.frame()
定义for循环
> for(i in 1:nrow(x)){
+ row<-x[i,] # 每行的值
+ df<-rbind(df,rbind(c(sum(row[1],1), mean(row)))) # 计算,并赋值到结果数据框
+ }
打印结果数据框
> df
V1 V2
1 4 3.5
2 4 3.0
3 4 2.5
4 4 2.0
5 4 2.5
6 4 3.0
7 4 3.5
8 4 4.0
通过for循环的方式,也可以很容易的实现上面计算过程,但是这里还有一些额外的操作需要自己处理,比如构建循环体、定义结果数据集、并合每次循环的结果到结果数据集。
对于上面的需求,还有第三种实现方法,那就是完全利用了R的特性,通过向量化计算来完成的。
> data.frame(x1=x[,1]+1,x2=rowMeans(x))
x1 x2
1 4 3.5
2 4 3.0
3 4 2.5
4 4 2.0
5 4 2.5
6 4 3.0
7 4 3.5
8 4 4.0
那么,一行就可以完成整个计算过程了。
接下来,我们需要再比较一下3种操作上面性能上的消耗。
清空环境变量
> rm(list=ls())
封装fun1
> fun1<-function(x){
+ myFUN<- function(x, c1, c2) {
+ c(sum(x[c1],1), mean(x[c2]))
+ }
+ apply(x,1,myFUN,c1='x1',c2=c('x1','x2'))
+ }
封装fun2
> fun2<-function(x){
+ df<-data.frame()
+ for(i in 1:nrow(x)){
+ row<-x[i,]
+ df<-rbind(df,rbind(c(sum(row[1],1), mean(row))))
+ }
+ }
封装fun3
> fun3<-function(x){
+ data.frame(x1=x[,1]+1,x2=rowMeans(x))
+ }
生成数据集
> x <- cbind(x1=3, x2 = c(400:1, 2:500))
分别统计3种方法的CPU耗时。
> system.time(fun1(x))
用户 系统 流逝
0.01 0.00 0.02
> system.time(fun2(x))
用户 系统 流逝
0.19 0.00 0.18
> system.time(fun3(x))
用户 系统 流逝
0 0 0
从CPU的耗时来看,用for循环实现的计算是耗时最长的,apply实现的循环耗时很短,而直接使用R语言内置的向量计算的操作几乎不耗时。通过上面的测试,对同一个计算来说,优先考虑R语言内置的向量计算,必须要用到循环时则使用apply函数,应该尽量避免显示的使用for,while等操作方法。
3. lapply函数
lapply函数是一个最基础循环操作函数之一,用来对list、data.frame数据集进行循环,并返回和X长度同样的list结构作为结果集,通过lapply的开头的第一个字母’l’就可以判断返回结果集的类型。
-
函数定义:
lapply(X, FUN, ...)
-
参数列表:
- X:list、data.frame数据
- FUN: 自定义的调用函数
- …: 更多参数,可选
比如,计算list中的每个KEY对应的该数据的分位数。
构建一个list数据集x,分别包括a,b,c 三个KEY值。
> x <- list(a = 1:10, b = rnorm(6,10,5), c = c(TRUE,FALSE,FALSE,TRUE));x
$a
[1] 1 2 3 4 5 6 7 8 9 10
$b
[1] 0.7585424 14.3662366 13.3772979 11.6658990 9.7011387 21.5321427
$c
[1] TRUE FALSE FALSE TRUE
分别计算每个KEY对应该的数据的分位数。
> lapply(x,fivenum)
$a
[1] 1.0 3.0 5.5 8.0 10.0
$b
[1] 0.7585424 9.7011387 12.5215985 14.3662366 21.5321427
$c
[1] 0.0 0.0 0.5 1.0 1.0
lapply就可以很方便地把list数据集进行循环操作了,还可以用data.frame数据集按列进行循环,但如果传入的数据集是一个向量或矩阵对象,那么直接使用lapply就不能达到想要的效果了。
比如,对矩阵的列求和。
生成一个矩阵
> x <- cbind(x1=3, x2=c(2:1,4:5))
> x; class(x)
x1 x2
[1,] 3 2
[2,] 3 1
[3,] 3 4
[4,] 3 5
[1] "matrix"
求和
> lapply(x, sum)
[[1]]
[1] 3
[[2]]
[1] 3
[[3]]
[1] 3
[[4]]
[1] 3
[[5]]
[1] 2
[[6]]
[1] 1
[[7]]
[1] 4
[[8]]
[1] 5
lapply会分别循环矩阵中的每个值,而不是按行或按列进行分组计算。
如果对数据框的列求和。
> lapply(data.frame(x), sum)
$x1
[1] 12
$x2
[1] 12
lapply会自动把数据框按列进行分组,再进行计算。
4. sapply函数
sapply函数是一个简化版的lapply,sapply增加了2个参数simplify和USE.NAMES,主要就是让输出看起来更友好,返回值为向量,而不是list对象。
-
函数定义:
sapply(X, FUN, ..., simplify=TRUE, USE.NAMES = TRUE)
-
参数列表:
- X:数组、矩阵、数据框
- FUN: 自定义的调用函数
- …: 更多参数,可选
- simplify: 是否数组化,当值array时,输出结果按数组进行分组
- USE.NAMES: 如果X为字符串,TRUE设置字符串为数据名,FALSE不设置
我们还用上面lapply的计算需求进行说明。
> x <- cbind(x1=3, x2=c(2:1,4:5))
对矩阵计算,计算过程同lapply函数
> sapply(x, sum)
[1] 3 3 3 3 2 1 4 5
对数据框计算
> sapply(data.frame(x), sum)
x1 x2
12 12
检查结果类型,sapply返回类型为向量,而lapply的返回类型为list
> class(lapply(x, sum))
[1] "list"
> class(sapply(x, sum))
[1] "numeric"
如果simplify=FALSE和USE.NAMES=FALSE,那么完全sapply函数就等于lapply函数了。
> lapply(data.frame(x), sum)
$x1
[1] 12
$x2
[1] 12
> sapply(data.frame(x), sum, simplify=FALSE, USE.NAMES=FALSE)
$x1
[1] 12
$x2
[1] 12
对于simplify为array时,我们可以参考下面的例子,构建一个三维数组,其中二个维度为方阵。
> a<-1:2
按数组分组
> sapply(a,function(x) matrix(x,2,2), simplify='array')
, , 1
[,1] [,2]
[1,] 1 1
[2,] 1 1
, , 2
[,1] [,2]
[1,] 2 2
[2,] 2 2
默认情况,则自动合并分组
> sapply(a,function(x) matrix(x,2,2))
[,1] [,2]
[1,] 1 2
[2,] 1 2
[3,] 1 2
[4,] 1 2
对于字符串的向量,还可以自动生成数据名。
> val<-head(letters)
默认设置数据名
> sapply(val,paste,USE.NAMES=TRUE)
a b c d e f
"a" "b" "c" "d" "e" "f"
USE.NAMES=FALSE,则不设置数据名
> sapply(val,paste,USE.NAMES=FALSE)
[1] "a" "b" "c" "d" "e" "f"
5. vapply函数
vapply类似于sapply,提供了FUN.VALUE参数,用来控制返回值的行名,这样可以让程序更健壮。
-
函数定义:
vapply(X, FUN, FUN.VALUE, ..., USE.NAMES = TRUE)
-
参数列表:
- X:数组、矩阵、数据框
- FUN: 自定义的调用函数
- FUN.VALUE: 定义返回值的行名row.names
- …: 更多参数,可选
- USE.NAMES: 如果X为字符串,TRUE设置字符串为数据名,FALSE不设置
比如,对数据框的数据进行累计求和,并对每一行设置行名row.names
生成数据集
> x <- data.frame(cbind(x1=3, x2=c(2:1,4:5)))
设置行名,4行分别为a,b,c,d
> vapply(x,cumsum,FUN.VALUE=c('a'=0,'b'=0,'c'=0,'d'=0))
x1 x2
a 3 2
b 6 3
c 9 7
d 12 12
当不设置时,为默认的索引值
> a<-sapply(x,cumsum);a
x1 x2
[1,] 3 2
[2,] 6 3
[3,] 9 7
[4,] 12 12
手动的方式设置行名
> row.names(a)<-c('a','b','c','d')
> a
x1 x2
a 3 2
b 6 3
c 9 7
d 12 12
通过使用vapply可以直接设置返回值的行名,这样子做其实可以节省一行的代码,让代码看起来更顺畅,当然如果不愿意多记一个函数,那么也可以直接忽略它,只用sapply就够了。
6. mapply函数
mapply也是sapply的变形函数,类似多变量的sapply,但是参数定义有些变化。第一参数为自定义的FUN函数,第二个参数’…’可以接收多个数据,作为FUN函数的参数调用。
-
函数定义:
mapply(FUN, ..., MoreArgs = NULL, SIMPLIFY = TRUE,USE.NAMES = TRUE)
-
参数列表:
- FUN: 自定义的调用函数
- …: 接收多个数据
- MoreArgs: 参数列表
- SIMPLIFY: 是否数组化,当值array时,输出结果按数组进行分组
- USE.NAMES: 如果X为字符串,TRUE设置字符串为数据名,FALSE不设置
比如,比较3个向量大小,按索引顺序取较大的值。
> set.seed(1)
定义3个向量
> x<-1:10
> y<-5:-4
> z<-round(runif(10,-5,5))
按索引顺序取较大的值。
> mapply(max,x,y,z)
[1] 5 4 3 4 5 6 7 8 9 10
再看一个例子,生成4个符合正态分布的数据集,分别对应的均值和方差为c(1,10,100,1000)。
> set.seed(1)
长度为4
> n<-rep(4,4)
m为均值,v为方差
> m<-v<-c(1,10,100,1000)
生成4组数据,按列分组
> mapply(rnorm,n,m,v)
[,1] [,2] [,3] [,4]
[1,] 0.3735462 13.295078 157.57814 378.7594
[2,] 1.1836433 1.795316 69.46116 -1214.6999
[3,] 0.1643714 14.874291 251.17812 2124.9309
[4,] 2.5952808 17.383247 138.98432 955.0664
由于mapply是可以接收多个参数的,所以我们在做数据操作的时候,就不需要把数据先合并为data.frame了,直接一次操作就能计算出结果了。
7. tapply函数
tapply用于分组的循环计算,通过INDEX参数可以把数据集X进行分组,相当于group by的操作。
-
函数定义:
tapply(X, INDEX, FUN = NULL, ..., simplify = TRUE)
-
参数列表:
- X: 向量
- INDEX: 用于分组的索引
- FUN: 自定义的调用函数
- …: 接收多个数据
- simplify : 是否数组化,当值array时,输出结果按数组进行分组
比如,计算不同品种的鸢尾花的花瓣(iris)长度的均值。
通过iris$Species品种进行分组
> tapply(iris\(Petal.Length,iris\)Species,mean)
setosa versicolor virginica
1.462 4.260 5.552
对向量x和y进行计算,并以向量t为索引进行分组,求和。
> set.seed(1)
定义x,y向量
> x<-y<-1:10;x;y
[1] 1 2 3 4 5 6 7 8 9 10
[1] 1 2 3 4 5 6 7 8 9 10
设置分组索引t
> t<-round(runif(10,1,100)%%2);t
[1] 1 2 2 1 1 2 1 0 1 1
对x进行分组求和
> tapply(x,t,sum)
0 1 2
8 36 11
由于tapply只接收一个向量参考,通过’…’可以把再传给你FUN其他的参数,那么我们想去y向量也进行求和,把y作为tapply的第4个参数进行计算。
> tapply(x,t,sum,y)
0 1 2
63 91 66
得到的结果并不符合我们的预期,结果不是把x和y对应的t分组后求和,而是得到了其他的结果。第4个参数y传入sum时,并不是按照循环一个一个传进去的,而是每次传了完整的向量数据,那么再执行sum时sum(y)=55,所以对于t=0时,x=8 再加上y=55,最后计算结果为63。那么,我们在使用’…’去传入其他的参数的时候,一定要看清楚传递过程的描述,才不会出现的算法上的错误。
8. rapply函数
rapply是一个递归版本的lapply,它只处理list类型数据,对list的每个元素进行递归遍历,如果list包括子元素则继续遍历。
-
函数定义:
rapply(object, f, classes = "ANY", deflt = NULL, how = c("unlist", "replace", "list"), ...)
-
参数列表:
- object:list数据
- f: 自定义的调用函数
- classes : 匹配类型, ANY为所有类型
- deflt: 非匹配类型的默认值
- how: 3种操作方式,当为replace时,则用调用f后的结果替换原list中原来的元素;当为list时,新建一个list,类型匹配调用f函数,不匹配赋值为deflt;当为unlist时,会执行一次unlist(recursive = TRUE)的操作
- …: 更多参数,可选
比如,对一个list的数据进行过滤,把所有数字型numeric的数据进行从小到大的排序。
> x=list(a=12,b=1:4,c=c('b','a'))
> y=pi
> z=data.frame(a=rnorm(10),b=1:10)
> a <- list(x=x,y=y,z=z)
进行排序,并替换原list的值
> rapply(a,sort, classes='numeric',how='replace')
$x
\(x\)a
[1] 12
\(x\)b
[1] 4 3 2 1
\(x\)c
[1] "b" "a"
$y
[1] 3.141593
$z
\(z\)a
[1] -0.8356286 -0.8204684 -0.6264538 -0.3053884 0.1836433 0.3295078
[7] 0.4874291 0.5757814 0.7383247 1.5952808
\(z\)b
[1] 10 9 8 7 6 5 4 3 2 1
> class(a\(z\)b)
[1] "integer"
从结果发现,只有\(z\)a的数据进行了排序,检查\(z\)b的类型,发现是integer,是不等于numeric的,所以没有进行排序。
接下来,对字符串类型的数据进行操作,把所有的字符串型加一个字符串’++++’,非字符串类型数据设置为NA。
> rapply(a,function(x) paste(x,'++++'),classes="character",deflt=NA, how = "list")
$x
\(x\)a
[1] NA
\(x\)b
[1] NA
\(x\)c
[1] "b ++++" "a ++++"
$y
[1] NA
$z
\(z\)a
[1] NA
\(z\)b
[1] NA
只有\(x\)c为字符串向量,都合并了一个新字符串。那么,有了rapply就可以对list类型的数据进行方便的数据过滤了。
9. eapply函数
对一个环境空间中的所有变量进行遍历。如果我们有好的习惯,把自定义的变量都按一定的规则存储到自定义的环境空间中,那么这个函数将会让你的操作变得非常方便。当然,可能很多人都不熟悉空间的操作,那么请参考文章 揭开R语言中环境空间的神秘面纱,解密R语言函数的环境空间 。
-
函数定义:
eapply(env, FUN, ..., all.names = FALSE, USE.NAMES = TRUE)
-
参数列表:
- env: 环境空间
- FUN: 自定义的调用函数
- …: 更多参数,可选
- all.names: 匹配类型, ANY为所有类型
- USE.NAMES: 如果X为字符串,TRUE设置字符串为数据名,FALSE不设置
下面我们定义一个环境空间,然后对环境空间的变量进行循环处理。
定义一个环境空间
> env
向这个环境空间中存入3个变量
> env\(a <- 1:10
> env\)beta <- exp(-3:3)
> env$logic <- c(TRUE, FALSE, FALSE, TRUE)
> env
查看env空间中的变量
> ls(env)
[1] "a" "beta" "logic"
查看env空间中的变量字符串结构
> ls.str(env)
a : int [1:10] 1 2 3 4 5 6 7 8 9 10
beta : num [1:7] 0.0498 0.1353 0.3679 1 2.7183 ...
logic : logi [1:4] TRUE FALSE FALSE TRUE
计算env环境空间中所有变量的均值。
> eapply(env, mean)
$logic
[1] 0.5
$beta
[1] 4.535125
$a
[1] 5.5
再计算中当前环境空间中的所有变量的占用内存大小。
查看当前环境空间中的变量
> ls()
[1] "a" "df" "env" "x" "y" "z" "X"
查看所有变量的占用内存大小
> eapply(environment(), object.size)
$a
2056 bytes
$df
1576 bytes
$x
656 bytes
$y
48 bytes
$z
952 bytes
$X
1088 bytes
$env
56 bytes
eapply函数平时很难被用到,但对于R包开发来说,环境空间的使用是必须要掌握的。特别是当R要做为工业化的工具时,对变量的精确控制和管理是非常必要的。
本文全面地介绍了,R语言中的数据循环处理的apply函数族,基本已经可以应对所有的循环处理的情况了。同时,在apply一节中也比较了,3种数据处理方面的性能,R的内置向量计算,要优于apply循环,大幅优于for循环。那么我们在以后的R的开发和使用过程中,应该更多地把apply函数使用好。
10. example汇总
Example_1
split函数能够分解类型更加复杂的对象,我们看下面的例子:我加载了一个叫datasets(数据集)的包,然后观察里面的airquality(空气质量)数据框,你可以看到数据的前6行,数据大概有100行。我们可以看到有Ozone、 Solar.R、 Wind、Tem等的测量值,比如我只想计算Ozone、Solar.R、 Wind和Tem在一个月内的平均值。那么我需要做的是,把这个数据框按月分组,然后利用apply函数或者是colMeans函数来计算不同变量的列均值。
library(datasets)
head(airquality)
s <- split(airquality,airquality$Month)
class(s)
lapply(s, function(x) colMeans(x[,c("Ozone", "Solar.R", "Wind", "Temp")]))
lapply(s, function(x) colMeans(x[,c("Ozone", "Solar.R", "Wind", "Temp")],na.rm=TRUE))
Example_2
在array上,沿margin方向,依次调用 FUN 。返回值为vector。margin表示数组引用的第几维下标(即array[index1, index2, ...]中的第几个index),1对应为1表示行,2表示列,c(1,2)表示行列。margin=1时, apply(a, 1, sum) 等效于下面的操作
a <- array(c(1:24), dim=c(2,3,4))
result=c()
for (i in c(1:dim(a)[1])) {
result <- c(result, sum(a[i,,]))
}
经实测,只能用在二维及以上的array上,不能用在vector上(如果要应用于vector,请使用 lapply 或 sapply )。以matrix为例,如下
> m <- matrix(c(1:10), nrow=2)
> m
[,1] [,2] [,3] [,4] [,5]
[1,] 1 3 5 7 9
[2,] 2 4 6 8 10
> apply(m, 1, sum)
[1] 25 30
> apply(m, 2, sum)
[1] 3 7 11 15 19
Example_3
一维array的例子(即vector)
> v <- c(1:5)
> ind <- c('a','a','a','b','b')
> tapply(v, ind)
[1] 1 1 1 2 2
> tapply(v, ind, sum)
a b
6 9
> tapply(v, ind, fivenum)
$a
[1] 1.0 1.5 2.0 2.5 3.0
$b
[1] 4.0 4.0 4.5 5.0 5.0
二维array的例子(即matrix)
> m <- matrix(c(1:10), nrow=2)
> m
[,1] [,2] [,3] [,4] [,5]
[1,] 1 3 5 7 9
[2,] 2 4 6 8 10
> ind <- matrix(c(rep(1,5), rep(2,5)), nrow=2)
> ind
[,1] [,2] [,3] [,4] [,5]
[1,] 1 1 1 2 2
[2,] 1 1 2 2 2
> tapply(m, ind)
[1] 1 1 1 1 1 2 2 2 2 2
> tapply(m, ind, mean)
1 2
3 8
> tapply(m, ind, fivenum)
$1
[1] 1 2 3 4 5
$2
[1] 6 7 8 9 10
Example_4
-
by
by(dataframe, INDICES, FUN, ..., simplify=TRUE)
by 可以当成dataframe上的 tapply 。 indices 应当和dataframe每列的长度相同。返回值是 by 类型的object。若simplify=FALSE,本质上是个list。
> df <- data.frame(a=c(1:5), b=c(6:10))
> ind <- c(1,1,1,2,2)
> res <- by(df, ind, colMeans)
> res
ind: 1
a b
2 7
------------------------------------------------------------
ind: 2
a b
4.5 9.5
> class(res)
[1] "by"
> names(res)
[1] "1" "2"
Example_5
在 list 上逐个元素调用 FUN 。可以用于dataframe上,因为dataframe是一种特殊形式的list。例
> lst <- list(a=c(1:5), b=c(6:10))
> lapply(lst, mean)
$a
[1] 3
$b
[1] 8
> lapply(lst, fivenum)
$a
[1] 1 2 3 4 5
$b
[1] 6 7 8 9 10
比 lapply 多了一个 simplify 参数。如果 simplify=FALSE ,则等价于 lapply 。否则,在上一种情况的基础上,将 lapply 输出的list简化为vector或matrix。例
> lst <- list(a=c(1:5), b=c(6:10))
> sapply(lst, mean)
a b
3 8
> sapply(lst, fivenum)
a b
[1,] 1 6
[2,] 2 7
[3,] 3 8
[4,] 4 9
[5,] 5 10
Example_6
- tapply实现crosstable功能
以一个例子演示。原始数据为按年份year、地区loc和商品类别type进行统计的销售量。我们要制作两个销售总量的crosstable,一个以年份为行、地区为列,一个以年份为行,类别为列。
> df <- data.frame(year=kronecker(2001:2003, rep(1,4)), loc=c('beijing','beijing','shanghai','shanghai'), type=rep(c('A','B'),6), sale=rep(1:12))
> df
year loc type sale
1 2001 beijing A 1
2 2001 beijing B 2
3 2001 shanghai A 3
4 2001 shanghai B 4
5 2002 beijing A 5
6 2002 beijing B 6
7 2002 shanghai A 7
8 2002 shanghai B 8
9 2003 beijing A 9
10 2003 beijing B 10
11 2003 shanghai A 11
12 2003 shanghai B 12
> tapply(df\(sale, df[,c('year','loc')], sum)
loc
year beijing shanghai
2001 3 7
2002 11 15
2003 19 23
> tapply(df\)sale, df[,c('year','type')], sum)
type
year A B
2001 4 6
2002 12 14
2003 20 22
Example_7
code1
x <- iris[,1:4]
names(x) <- c("x1","x2","x3","x4")
aggregate(x1+x2+x3+x4~x1,FUN=sum,data=x)
#y <- subset(x, x1==4.4)
#sum(y)
with(x, sapply(split((x1 + x2 + x3 + x4), x1), sum)) # s stands for simplify
with(x, lapply(split((x1 + x2 + x3 + x4), x1), sum)) # l stands for list
with(x, rapply(split((x1 + x2 + x3 + x4), x1), sum)) # r stands for recursive
with(x, tapply((x1 + x2 + x3 + x4), INDEX=x1 , sum)) # t stands for table
with(x, vapply(split((x1 + x2 + x3 + x4), x1), sum, FUN.VALUE=1))
with(x, by((x1 + x2 + x3 + x4), x1, sum))
code1
urls <- c("http://stat.ethz.ch/R-manual/R-devel/library/base/html/connections.html","http://en.wikipedia.org/wiki/Xz")
x1=lapply(urls,readLines)
x2=sapply(urls,readLines)
x3=mapply(con=urls,readLines)
x4=vapply(urls, function(i) list(readLines(i)), list(1))
Example_8
theMatrix <- matrix(1:9, nrow = 3)
# 对行进行累加运算
apply(theMatrix, 1, sum)
# 对列进行累加运算
apply(theMatrix, 2, sum)
# same as
rowSums(theMatrix)
colSums(theMatrix)
apply
theMatrix[2, 1] <- NA
apply(theMatrix, 1, sum)
apply(theMatrix, 1, sum, na.rm = TRUE)
lapply sapply
theList <- list(A = matrix(1:9, 3), B = 1:8, c = matrix(1:4, 2))
lapply(theList, sum)
sapply(theList, sum)
mapply
firstList <- list(A = matrix(1:16, 4), B = matrix(1:9, 3))
secondList <- list(A = matrix(1:9, 3), B = matrix(1:16, 8))
simpleFunc <- function(x, y) {
# NROW函数返回对象的行数
NROW(x) + NROW(y)
}
mapply(simpleFunc, firstList, secondList)
Example_9
使用tapply,sapply(lapply)函数可以快速实现功能和有效减少代码量
tapply(x,f,g) -- x为向量,f为因子列,g为操作函数,相对数据框进行类似操作可以用by函数
sapply(list,g) -- g为操作函数,返还结果为向量,而lapply返还结果为list形式。常与split结合使用
数据为1001路公交车不同站点上车人数统计
| 线路名称 | 车牌号 | 到达站点 | 上车人数 |
|---|---|---|---|
| 1001 | 粤BM8475 | 14 | 11 |
| 1001 | 粤BM8475 | 13 | 3 |
| 1001 | 粤BM8475 | 12 | 10 |
| 1001 | 粤BM8475 | 10 | 5 |
| 1001 | 粤BM8475 | 8 | 1 |
| 1001 | 粤BM8475 | 14 | 11 |
| 1001 | 粤BM8475 | 13 | 3 |
| 1001 | 粤BM8475 | 12 | 10 |
| 1001 | 粤BM8475 | 10 | 5 |
| 1001 | 粤BM8475 | 8 | 1 |
| 1001 | 粤BM8476 | 14 | 11 |
| 1001 | 粤BM8476 | 13 | 3 |
| 1001 | 粤BM8476 | 12 | 10 |
| 1001 | 粤BM8476 | 10 | 5 |
| 1001 | 粤BM8476 | 8 | 1 |
| 1001 | 粤BM8476 | 14 | 11 |
| 1001 | 粤BM8476 | 13 | 3 |
| 1001 | 粤BM8476 | 12 | 10 |
| 1001 | 粤BM8476 | 10 | 5 |
| 1001 | 粤BM8476 | 8 | 1 |
统计不同站点的上车人数
(Freq <- tapply(data[,4], data[,3], sum))
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
120 257 325 164 174 186 205 80 118 267 259 130 77 541 704 133
按照车牌号分类,分别统计不同站点上车人数
data <- split(data, data\(车牌号) ## 对数据按照车牌号分组,拆成列表
Freq <- sapply(data, function(data){
## 按照车牌号统计不同站点上车人数
tapply(data\)上车人数, data$到达站点, sum)
})
## 查看结果
Freq[1]
$粤BM8475
1 2 3 4 5 7 8 9 10 12 13 14 15
14 34 12 6 15 2 4 39 7 34 3 27 1
R code run
mydata <- read.table("clipboard",header=T)
class(mydata)
dim(mydata)
head(mydata)
data <- mydata
(Freq <- tapply(data[,4], data[,3], sum))
data <- split(data, data\(车牌号)
Freq <- sapply(data, function(data){
tapply(data\)上车人数, data$到达站点, sum)
})
Freq[1]
class(Freq)
data.frame(Freq)

 浙公网安备 33010602011771号