完整教程:MySQL慢查询日志分析
1) 慢查询介绍
- MySQL的慢查询,全名是慢查询日志,是MySQL提供的一种日志记录,用来记录在MySQL中响应时间超过阈值的语句。
- 默认情况下,MySQL数据库并不启动慢查询日志,需要手动来设置这个参数。
如果不是调优需要的话,一般不建议启动该参数,因为开启慢查询日志会或多或少带来一定的性能影响。慢查询日志支持将日志记录写入文件和数据库表。
2) 慢查询参数
执行下面的语句
mysql> show variables like '%slow_query_log%';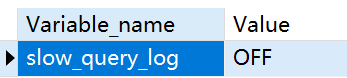
默认不开启 需要我们手动开启慢查询日志
SET GLOBAL slow_query_log = 1; ---开启慢查询日志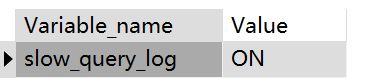
show variables like '%long_query%';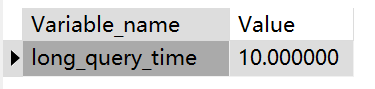
慢sql查询的阈值 如果超过阈值 慢查询日志记录当前所查询的慢sql 默认10s
MySQL 慢查询的相关参数解释:
- slow_query_log:是否开启慢查询日志,
ON(1)表示开启,
OFF(0) 表示关闭。
- slow-query-log-file:新版(5.6及以上版本)MySQL数据库慢查询日志存储路径。
- long_query_time: 慢查询阈值,当查询时间多于设定的阈值时,记录日志。
3) 慢查询配置方式
- 默认情况下slow_query_log的值为OFF,表示慢查询日志是禁用的
mysql> set global slow_query_log=1 //可以通过设置slow_query_log的值来开启- 使用
set global slow_query_log=1开启了慢查询日志只对当前数据库生效,MySQL重启后则会失效。如果要永久生效,就必须修改配置文件my.cnf(其它系统变量也是如此)
-- 编辑配置
vim /etc/my.cnf
-- 添加如下内容
slow_query_log =1
slow_query_log_file=/var/lib/mysql/ruyuan-slow.log
-- 重启MySQL
service mysqld restart
mysql> show variables like '%slow_query%';
+---------------------+--------------------------------+
| Variable_name       | Value                          |
+---------------------+--------------------------------+
| slow_query_log      | ON                             |
| slow_query_log_file | /var/lib/mysql/ruyuan-slow.log |
+---------------------+--------------------------------+- 那么开启了慢查询日志后,什么样的SQL才会记录到慢查询日志里面呢? 这个是由参数
long_query_time控制,默认情况下long_query_time的值为10秒.
mysql> show variables like 'long_query_time';
+-----------------+-----------+
| Variable_name   | Value     |
+-----------------+-----------+
| long_query_time | 10.000000 |
+-----------------+-----------+
mysql> set global long_query_time=1;
Query OK, 0 rows affected (0.00 sec)
mysql>  show variables like 'long_query_time';
+-----------------+-----------+
| Variable_name   | Value     |
+-----------------+-----------+
| long_query_time | 10.000000 |
+-----------------+-----------+- 修改了变量long_query_time,但是查询变量long_query_time的值还是10,难道没有修改到呢?注意:使用命令 set global long_query_time=1 修改后,需要重新连接或新开一个会话才能看到修改值。
mysql> show variables like 'long_query_time';
+-----------------+----------+
| Variable_name   | Value    |
+-----------------+----------+
| long_query_time | 1.000000 |
+-----------------+----------+log_output参数是指定日志的存储方式。log_output='FILE'表示将日志存入文件,默认值是'FILE'。log_output='TABLE'表示将日志存入数据库,这样日志信息就会被写入到mysql.slow_log 表中。
mysql> SHOW VARIABLES LIKE '%log_output%';
+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| log_output    | FILE  |
+---------------+-------+
MySQL数据库支持同时两种日志存储方式,配置的时候以逗号隔开即可,如:log_output='FILE,TABLE'。日志记录到系统的专用日志表中,要比记录到文件耗费更多的系统资源,因此对于需要启用慢查询日志,又需要能够获得更高的系统性能,那么建议优先记录到文件.
- 系统变量
log-queries-not-using-indexes:未使用索引的查询也被记录到慢查询日志中(可选项)。如果调优的话,建议开启这个选项。
mysql> show variables like 'log_queries_not_using_indexes';
+-------------------------------+-------+
| Variable_name                 | Value |
+-------------------------------+-------+
| log_queries_not_using_indexes | OFF   |
+-------------------------------+-------+
mysql> set global log_queries_not_using_indexes=1;
Query OK, 0 rows affected (0.00 sec)
mysql> show variables like 'log_queries_not_using_indexes';
+-------------------------------+-------+
| Variable_name                 | Value |
+-------------------------------+-------+
| log_queries_not_using_indexes | ON    |
+-------------------------------+-------+
3) 慢查询测试
- 执行 test_index.sql 脚本,监控慢查询日志内容·
[root@localhost mysql]# tail -f /var/lib/mysql/ruyuan-slow.log
/usr/sbin/mysqld, Version: 5.7.30-log (MySQL Community Server (GPL)). started with:
Tcp port: 0  Unix socket: /var/lib/mysql/mysql.sock
Time Id Command Argument- 执行下面的SQL,执行超时 (超过1秒) 我们去查看慢查询日志
SELECT * FROM test_index WHERE
hobby = '20009951' OR hobby = '10009931' OR hobby = '30009931'
OR dname = 'name4000' OR dname = 'name6600' ;- 日志内容
我们得到慢查询日志后,最重要的一步就是去分析这个日志。我们先来看下慢日志里到底记录了哪些内容。
如下图是慢日志里其中一条SQL的记录内容,可以看到有时间戳,用户,查询时长及具体的SQL等信息.
Time                 Id Command    Argument
# Time: 2022-02-23 T03:55:15. 336037Z
# User@Host: root[root] @ localhost []  Id:     6
# Query_time: 2.375219  Lock_time: 0.000137 Rows_sent: 3  Rows_examined: 5000000
use db4;
SET timestamp=1645588515;
SELECT * FROM test_index WHERE hobby = '20009961' OR hobby = '10009941' OR hobby = '30009961' OR dname = 'name4001' OR dname = 'name6601';- Time: 执行时间
- Users: 用户信息 ID信息
- Query_time: 查询时长
- Lock_time: 等待锁时长
- Rows_sent: 查询结果的行数
- Rows_examined: 扫描的行数
- SET timestamp: 时间戳
- 具体的SQL语句信息
2.慢查询SQL优化思路
1) SQL性能下降的原因
在日常的运维过程中,经常会遇到DBA将一些执行效率较低的SQL发过来找开发人员分析,当我们拿到这个SQL语句之后,在对这些SQL进行分析之前,需要明确可能导致SQL执行性能下降的原因进行分析,执行性能下降可以体现在以下两个方面:
- 等待时间长
锁表导致查询一直处于等待状态,后续我们从MySQL锁的机制去分析SQL执行的原理
- 执行时间长
1.查询语句写的烂
2.索引失效
3.关联查询太多join
4.服务器调优及各个参数的设置
2) 慢查询优化思路
- 优先选择优化高并发执行的SQL,因为高并发的SQL发生问题带来后果更严重.
比如下面两种情况:
SQL1: 每小时执行10000次, 每次20个IO 优化后每次18个IO,每小时节省2万次IO
SQL2: 每小时10次,每次20000个IO,每次优化减少2000个IO,每小时节省2万次IO
SQL2更难优化,SQL1更好优化.但是第一种属于高并发SQL,更急需优化 成本更低
- 定位优化对象的性能瓶颈(在优化之前了解性能瓶颈在哪)
在去优化SQL时,选择优化分方向有三个:
1.IO(数据访问消耗的了太多的时间,查看是否正确使用了索引) ,
2.CPU(数据运算花费了太多时间, 数据的运算分组 排序是不是有问题)
3.网络带宽(加大网络带宽)
- 明确优化目标
- 需要根据数据库当前的状态
- 数据库中与该条SQL的关系
- 当前SQL的具体功能
- 最好的情况消耗的资源,最差情况下消耗的资源,优化的结果只有一个给用户一个好的体验
- 从explain执行计划入手
只有explain能告诉你当前SQL的执行状态
- 永远用小的结果集驱动大的结果集
小的数据集驱动大的数据集,减少内层表读取的次数
类似于嵌套循环
for(int i = 0; i < 5; i++){
for(int i = 0; i < 1000; i++){
}
}
如果小的循环在外层,对于数据库连接来说就只连接5次,进行5000次操作,如果1000在外,则需要进行1000次数据库连接,从而浪费资源,增加消耗.这就是为什么要小表驱动大表。
- 尽可能在索引中完成排序
排序操作用的比较多,order by 后面的字段如果在索引中,索引本来就是排好序的,所以速度很快,没有索引的话,就需要从表中拿数据,在内存中进行排序,如果内存空间不够还会发生落盘操作
- 只获取自己需要的列
不要使用select * ,select * 很可能不走索引,而且数据量过大
- 只使用最有效的过滤条件
误区 where后面的条件越多越好,但实际上是应该用最短的路径访问到数据
- 尽可能避免复杂的join和子查询
每条SQL的JOIN操作 建议不要超过三张表
将复杂的SQL, 拆分成多个小的SQL 单个表执行,获取的结果 在程序中进行封装
如果join占用的资源比较多,会导致其他进程等待时间变长
- 合理设计并利用索引
如何判定是否需要创建索引?
1.较为频繁的作为查询条件的字段应该创建索引.
2.唯一性太差的字段不适合单独创建索引,即使频繁作为查询条件.(唯一性太差的字段主要是指哪些呢?如状态字段,类型字段等等这些字段中的数据可能总共就是那么几个几十个数值重复使用)(当一条Query所返回的数据超过了全表的15%的时候,就不应该再使用索引扫描来完成这个Query了).
3.更新非常频繁的字段不适合创建索引.(因为索引中的字段被更新的时候,不仅仅需要更新表中的数据,同时还要更新索引数据,以确保索引信息是准确的).
4.不会出现在WHERE子句中的字段不该创建索引.
如何选择合适索引?
1.对于单键索引,尽量选择针对当前Query过滤性更好的索引.
2.选择联合索引时,遵循最佳左前缀法则,尽量排列要靠前
JOIN优化
1.JOIN算法原理
1) JOIN回顾
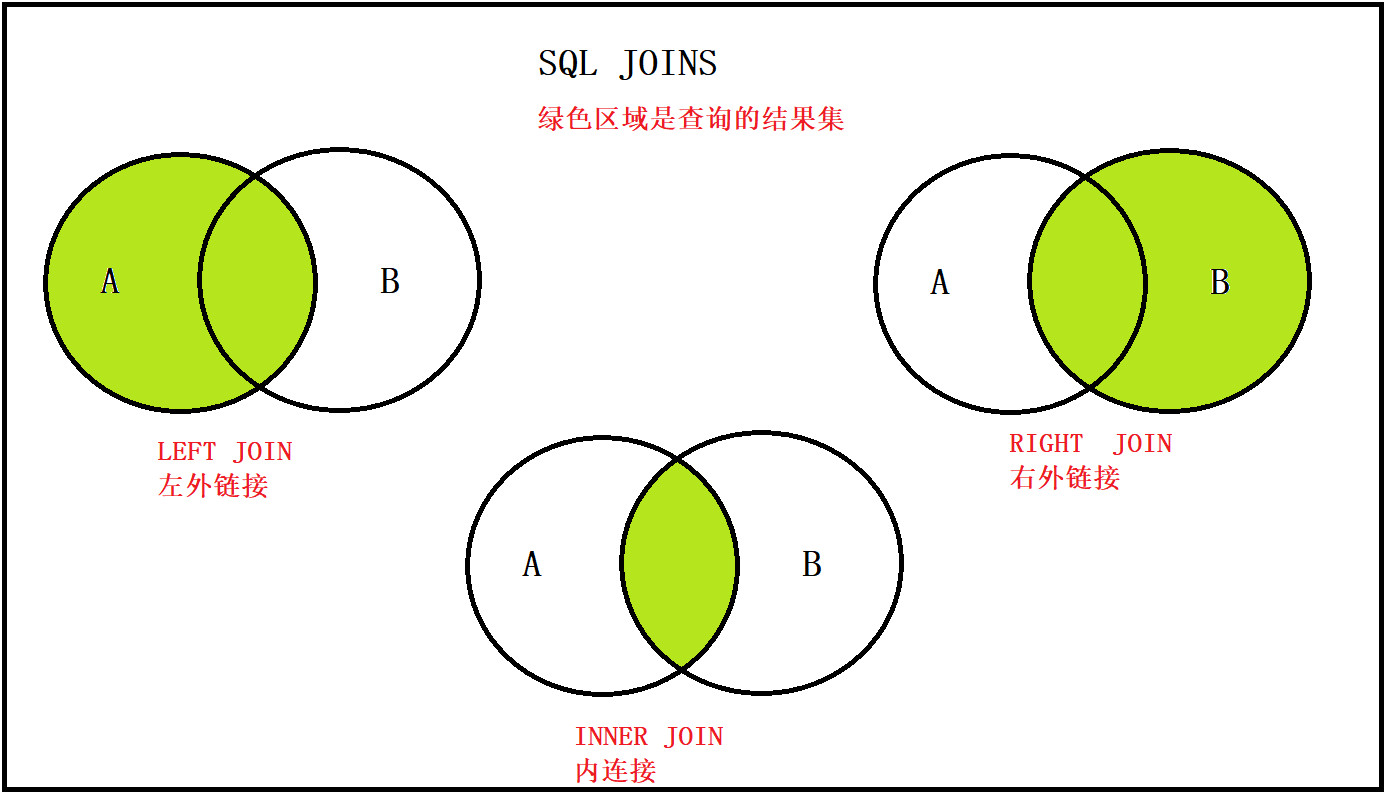
JOIN 是 MySQL 用来进行联表操作的,用来匹配两个表的数据,筛选并合并出符合我们要求的结果集。
JOIN 操作有多种方式,取决于最终数据的合并效果。常用连接方式的有以下几种:
2) 驱动表的定义
什么是驱动表?
- 多表关联查询时,第一个被处理的表,使用此表的记录去关联其他表, 驱动表的确定很关键,会直接影响多表连接的关联顺序,也决定了后续关联时的查询性能.
驱动表的选择遵循一个原则:
- 在对最终结果集没影响的前提下,优先选择结果集最小的那张表作为驱动
3) 三种JOIN算法
1.Simple Nested-Loop Join(简单的嵌套循环连接)
- 简单来说嵌套循环连接算法就是一个双层for 循环 ,通过循环外层表的行数据,逐个与内层表的所有行数据进行比较来获取结果.
- 这种算法是最简单的方案,性能也一般。对内循环没优化。
- 例如有这样一条SQL:
-- 连接用户表与订单表 连接条件是 u.id = o.user_id
select * from user t1 left join order t2 on t1.id = t2.user_id;
-- user表为驱动表,order表为被驱动表- 转换成代码执行时的思路是这样的:
for(user表行 uRow : user表){
    for(Order表的行 oRow : order表){
        if(uRow.id = oRow.user_id){
            return uRow;
        }
    }
}- 匹配过程如下图
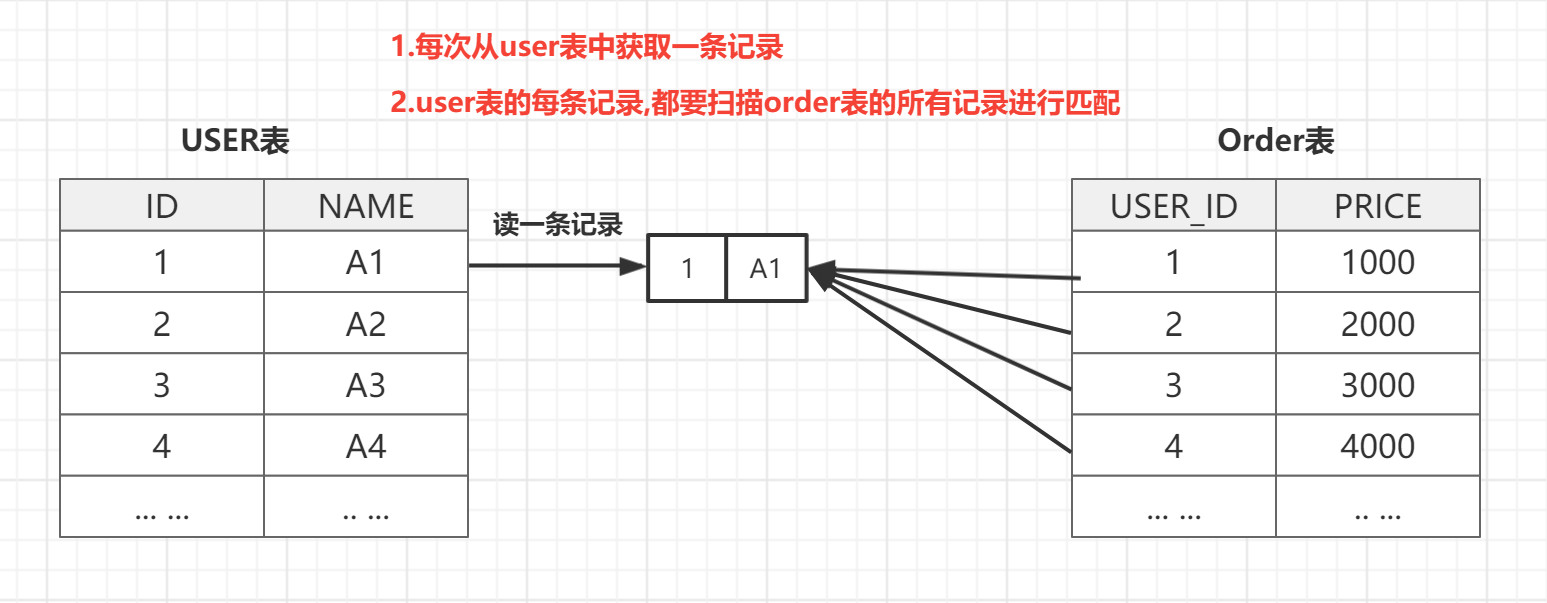
- SNL 的特点
- 简单粗暴容易理解,就是通过双层循环比较数据来获得结果
- 查询效率会非常慢,假设 A 表有 N 行,B 表有 M 行。SNL 的开销如下:
- A 表扫描 1 次。
- B 表扫描 M 次。
- 一共有 N 个内循环,每个内循环要 M 次,一共有内循环 N * M 次
2) 索引嵌套循环连接
- 优化思路: 主要是为了减少内层表数据的匹配次数,将进行join的字段(被驱动表中的字段)建立索引
- SNL的匹配方式: 匹配次数=外层表的行数*内存表的行数,优化后: 匹配次数=外层表的行数*内层表索引的高度
- 当
order表的user_id添加v 索引的时候执行过程会如下图:
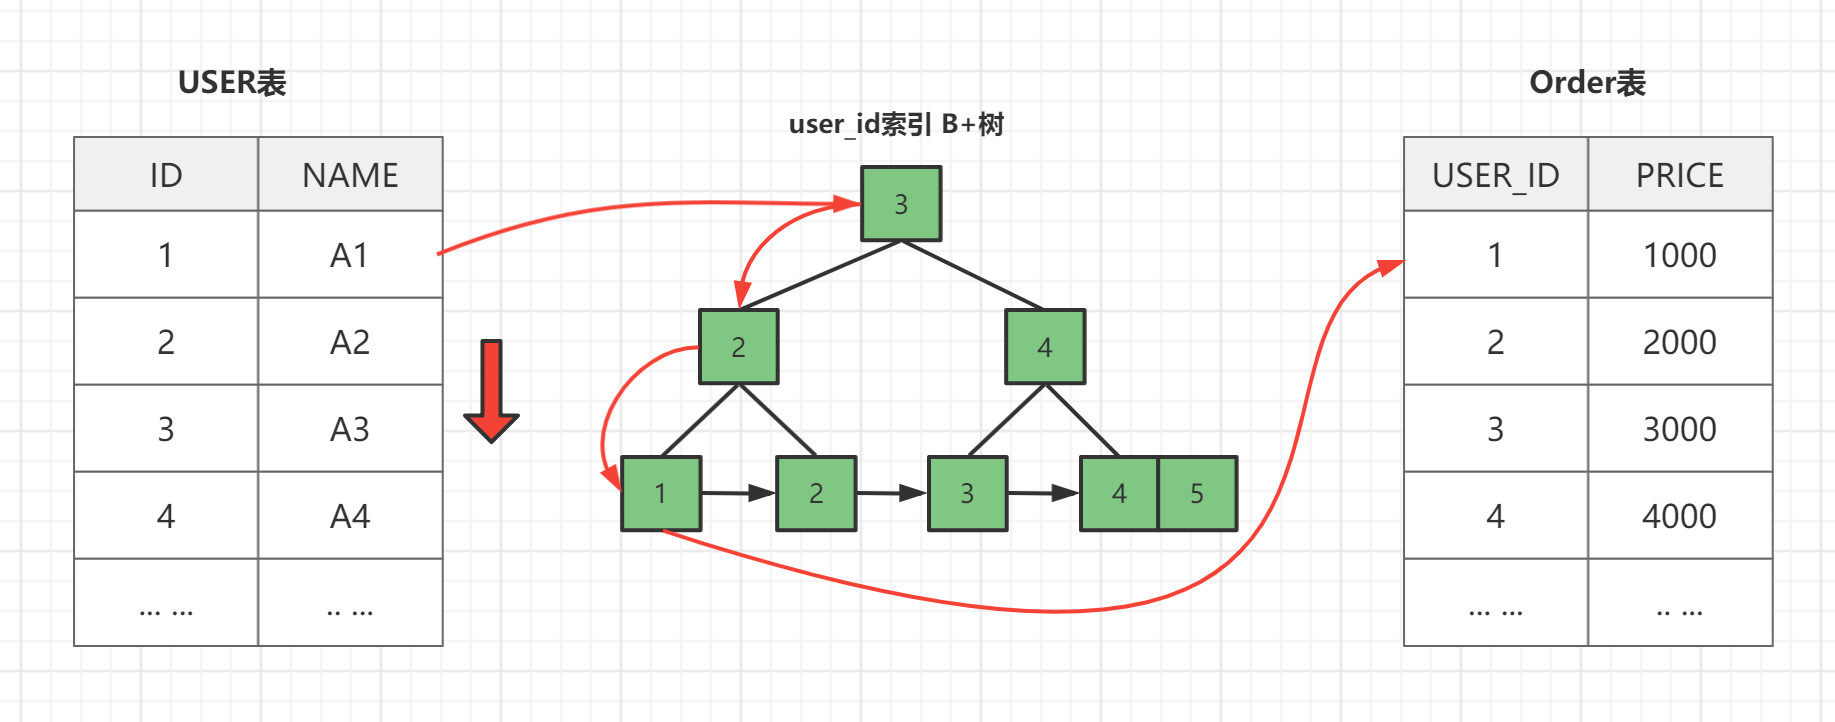
注意:使用Index Nested-Loop Join 算法的前提是匹配的字段必须建立了索引。
3)块嵌套循环
- 如果 join 的字段有索引,Mysql也不会使用SNL,而是加入Buffer缓冲区,降低内循环的次数.
- MYSQL中JOIN Buffer的大小默认是256kb. 可以通过join_buffer_size来查看
- 设置JOINBuffer的大小: set session join_buffer_size=大小值.
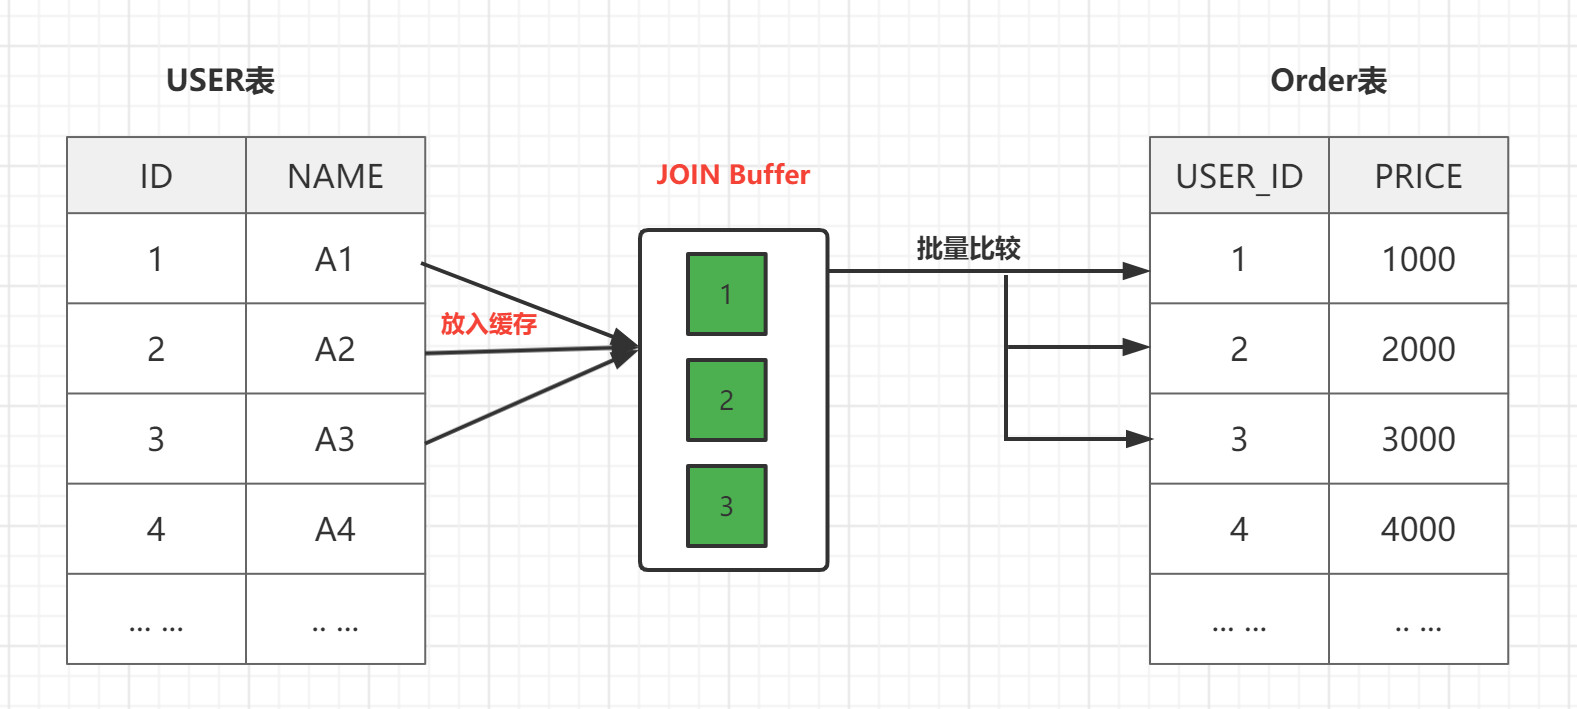
4) 总结
- 永远用小结果集驱动大结果集(其本质就是减少外层循环的数据数量)
- 为匹配的条件增加索引(减少内层表的循环匹配次数)
- 增大join buffer size的大小(一次缓存的数据越多,那么内层包的扫表次数就越少)
- 减少不必要的字段查询(字段越少,join buffer 所缓存的数据就越多
2.in和exists函数
上面我们说了 小表驱动大表,就是小的数据集驱动大的数据集, 主要是为了减少数据库的连接次数,根据具体情况的不同,又出现了两个函数 exists 和 in 函数
创建部门表与员工表,并插入数据
-- 部门表
CREATE TABLE department (
  id INT(11) PRIMARY KEY,
  deptName VARCHAR(30) ,
  address VARCHAR(40)
) ;
-- 部门表测试数据
INSERT INTO `department` VALUES (1, '研发部', '1层');
INSERT INTO `department` VALUES (2, '人事部', '3层');
INSERT INTO `department` VALUES (3, '市场部', '4层');
INSERT INTO `department` VALUES (5, '财务部', '2层');
-- 员工表
CREATE TABLE employee (
  id INT(11) PRIMARY KEY,
  NAME VARCHAR(20) ,
  dep_id INT(11) ,
  age INT(11) ,
  salary DECIMAL(10, 2)
);
-- 员工表测试数据
INSERT INTO `employee` VALUES (1, '鲁班', 1, 15, 1000.00);
INSERT INTO `employee` VALUES (2, '后裔', 1, 22, 2000.00)
INSERT INTO `employee` VALUES (4, '阿凯', 2, 20, 3000.00);
INSERT INTO `employee` VALUES (5, '露娜', 2, 30, 3500.00);
INSERT INTO `employee` VALUES (6, '李白', 3, 25, 5000.00);
INSERT INTO `employee` VALUES (7, '韩信', 3, 50, 5000.00);
INSERT INTO `employee` VALUES (8, '蔡文姬', 3, 35, 4000.00);
INSERT INTO `employee` VALUES (3, '孙尚香', 4, 20, 2500.00);
1) in 函数
- 假设: 部门表的数据小于员工表的数据时,如果我们要查询所有部门下面的员工信息
这是我们应该选择in函数
-- 编写SQL,使in 函数
SELECT * FROM employee e WHERE e.dep_id IN (SELECT id FROM department);- in函数的执行原理
1.in语句 只执行一次,将部门表的所有id字段查询来并且缓存.
2.检测部门表中id和员工表中的dep_id是否相等,如果相等就添加到结果集,直到遍历完部门表的所有结果集.
-- 先循环: select id from department; 相当于得到了小表的数据
-- 后循环: select * from employee where e.dep_id  = d.id;
for(i = 0; i < $dept.length; i++){  -- 小表
	for(j = 0 ; j < $emp.legth; j++){  -- 大表
		if($dept[i].id == $emp[j].dep_id){
			$result[i] = $emp[j]
			break;
		}
	}
}
结论: 如果子查询得出的结果集记录较少,主查询中的表较大且又有索引时应该用 in
2) exists 函数
假设: department表的数据大于 employee表数据, 将所有部门下的的员工都查出来,应该使用 exists 函数.
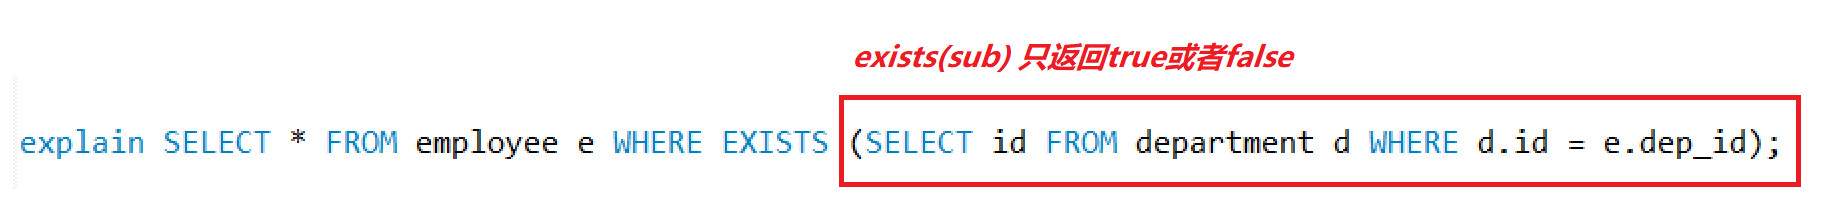
explain SELECT * FROM employee e WHERE EXISTS
(SELECT id FROM department d WHERE d.id = e.dep_id);
exists的特点: exists子句返回是一个布尔值,如果有数据就返回true,反之返回false。
如果是true,外层查询就会进行匹配,否则外层查询语句不进行查询
- exists 函数的执行原理
-- 先循环: SELECT * FROM employee e;
-- 再判断: SELECT id FROM department d WHERE d.id = e.dep_id
for(j = 0; j < $emp.length; j++){  -- 小表
-- 遍历循环外表,检查外表中的记录有没有和内表的的数据一致的, 匹配得上就放入结果集。
	if(exists(emp[i].dep_id)){   -- 大表
		$result[i] = $emp[i];
	}
}
3) in 和 exists 的区别
- 如果子查询得出的结果集记录较少,主查询中的表较大且又有索引时应该用
in - 如果主查询得出的结果集记录较少,子查询中的表较大且又有索引时应该用
exists - 一句话: in后面跟的是小表,exists后面跟的是大表
order by优化
MySQL中的两种排序方式
- 索引排序: 通过有序索引进行顺序扫描直接返回有序的数据
- 文件排序: 额外排序,指的是所有的不是通过索引直接返回排序结果的操作都是文件排序(FileSort)
- Order By 优化的核心原则: 尽量减少文件排序,通过索引直接返回有序的数据
索引排序: 因为索引的结构是B+Tree索引的数据是按照一定的顺序进行排列的,所以在排序查询中必须要利用好索引进行排序。
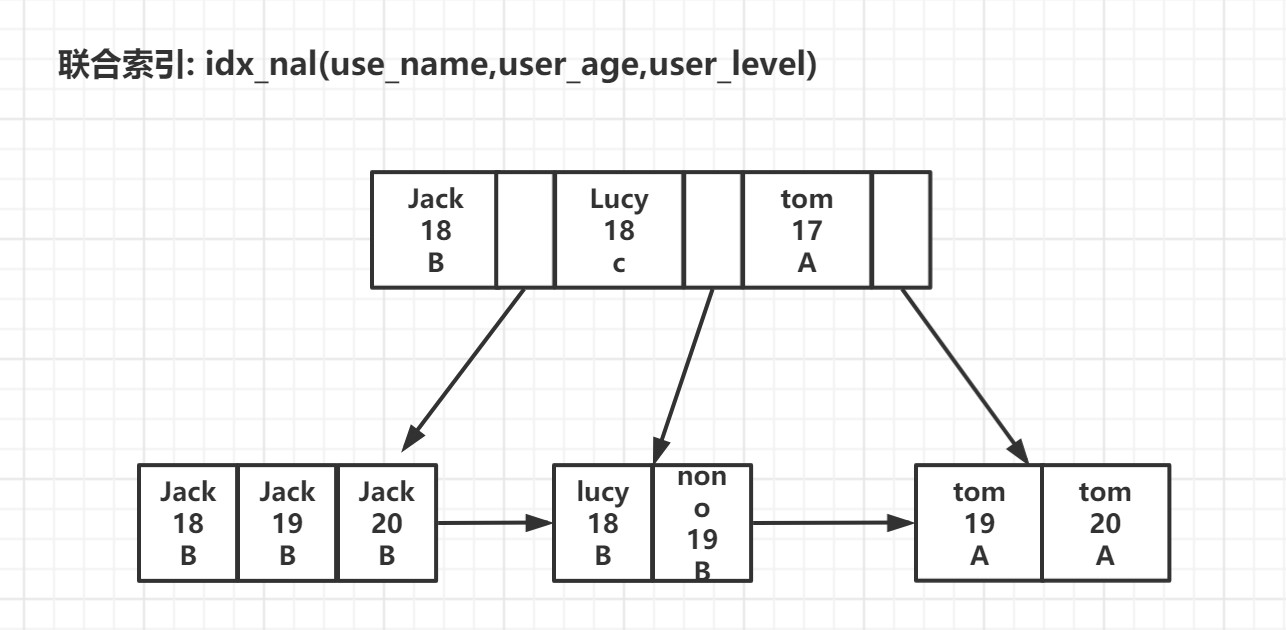
比如从查询调速是where user_age =19 order by user_name
查询过程中就是会找到满足age=19的记录,所有的符合这一条件的记录一定是按照name进行排序,所以不需要额外的排序.
额外的排序(文件排序):
按照执行位置划分:
1) Sort Buffer: Mysql为每个线程维护了一块内存区域 sort_buffer (默认256kb) 用于排序
Sort Buffer不是越大越好,因为由于是connection级别的,如果参数值设置过大,在高并发的场景下可能会耗尽系统的内存资源.
2)Sort_Buffer+临时文件
如果加载的字段的总长度小于 sort_buffer就使用sort_buffer排序,如果超多了sort_buffer的容量,就会使用Sort_Buffer+临时文件进行排序.
临时文件的种类: 内存临时表和磁盘临时表,内存临时表大小超过了tem_table_size,就会转化成磁盘临时表.
按照执行的方式划分:
按照执行的顺序划分:
参数: max_length_for_sort_data,这个参数用来决定是使用全字段排序,还是rowid排序,如果用于排序的单条记录的长度<=该参数就使用全字段排序,反之使用rowid排序.
全字段排序: 将查询的所有的字段全部加载进来进行排序.
优点: 查询快,执行简单,缺点: 需要空间
例如: select name,age,addr,from user where addr='北京' order by name limit 1000;--addr字段有索引,name字段没有索引
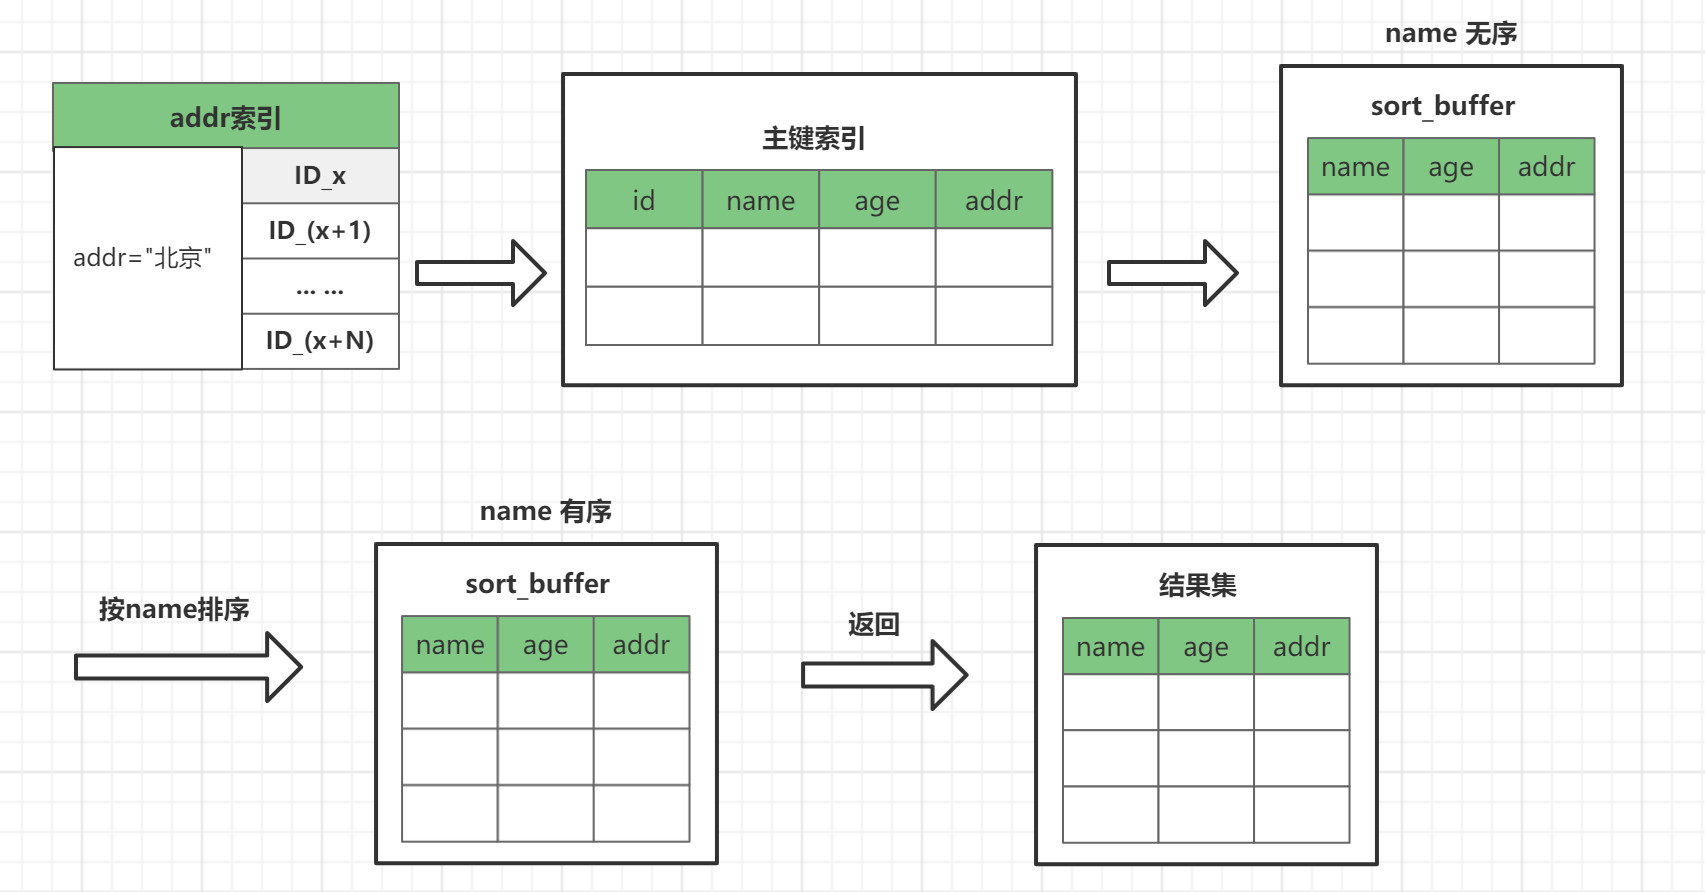
row id排序: rowid排序不会将所有的字段放入sort_sortBuffer,所以在sort_buffer中进行排序之后还需要回表查询
优点: 所需的空间更小
缺点: 会差生更多次数的回表查询,查询可能会慢一些
例如: select name,age,addr,from user where addr='北京' order by name limit 1000;--addr字段有索引,name字段没有索引
假如 name age addr 3个字段的定义总长度为36,而max_lenth_for_sort_data=16,就 出现了单行的长度超过了设置的最大值,MySQL就会认为单行数据太大,就会从全字段排序转换为rowid排序.
换成rowid排序后,放入sort_buffer中字段就只有需要排序的name字段和主键id,排序结果中就少了age addr字段就需要回表.
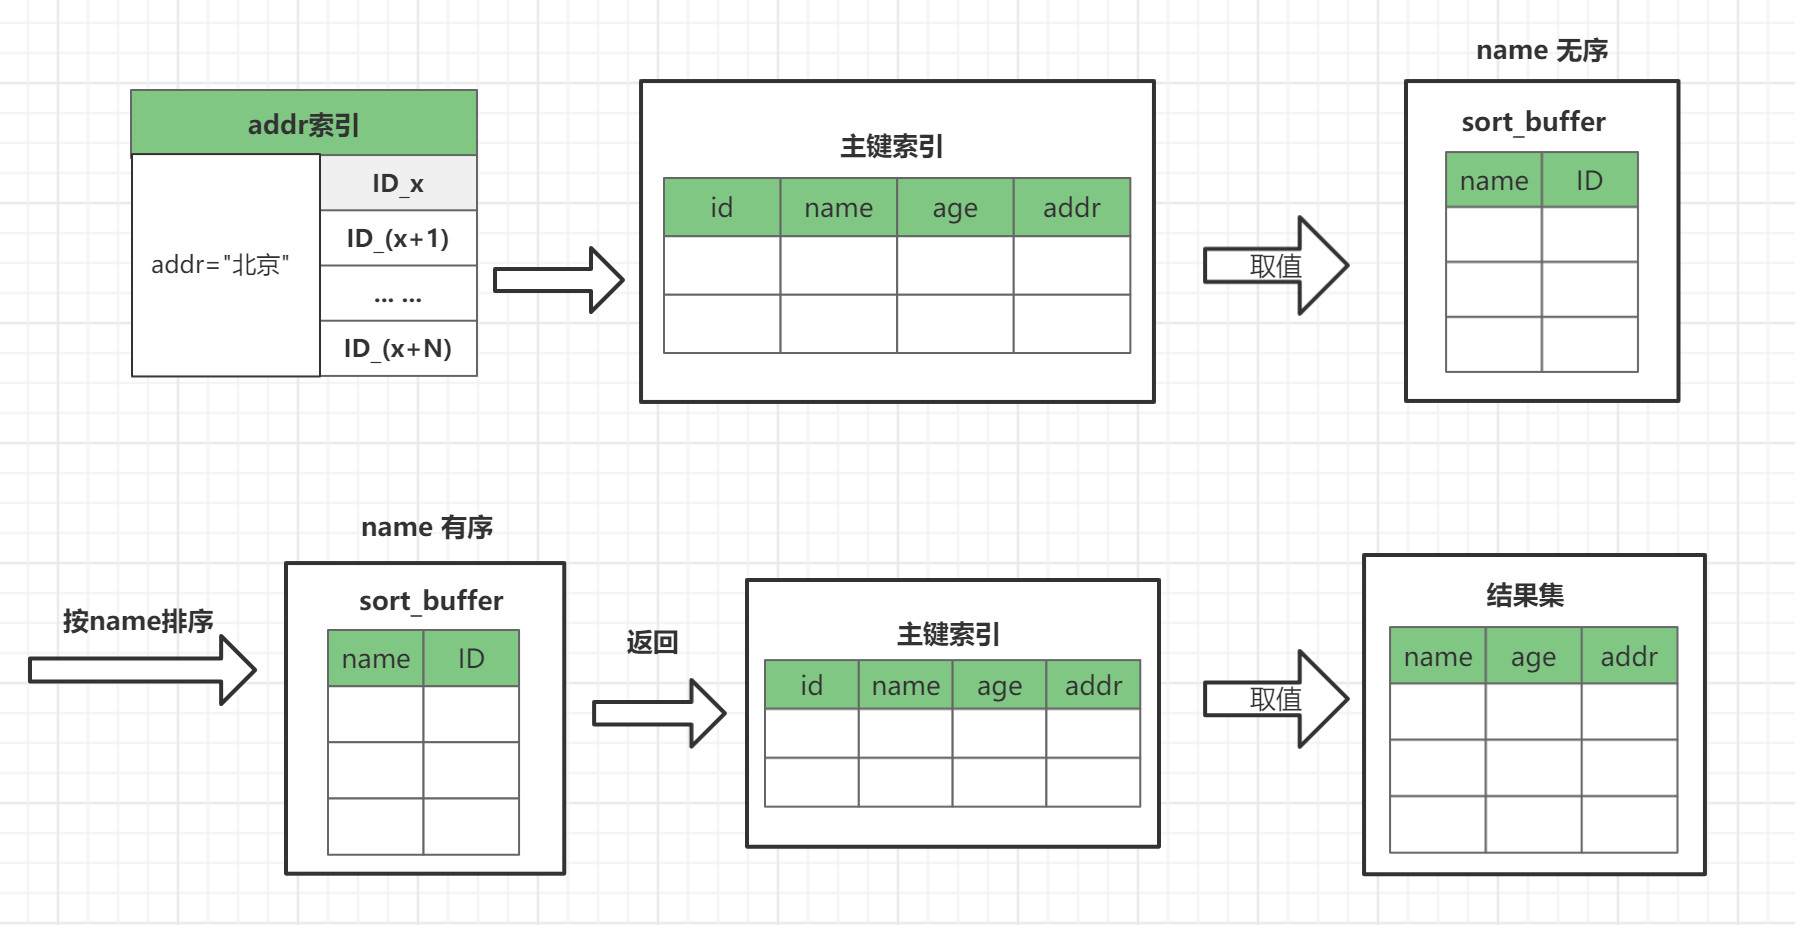
总结
- 如果 MySQL 认为内存足够大,会优先选择全字段排序,把需要的字段都放到 sort_buffer中, 这样排序后就会直接从内存里面返回查询结果了,不用再回到原表去取数据。
- MySQL 的一个设计思想:如果内存够,就要多利用内存,尽量减少磁盘访问。 对于 InnoDB 表来说,rowid 排序会要求回表多造成磁盘读,因此不会被优先选择
3.排序优化
添加索引
- 为
employee表 创建索引
-- 联合索引
ALTER TABLE employee add index idx_name_age(name,age);
-- 为薪资字段添加索引
ALTER TABLE employee add INDEX idx_salary(salary);
查看 employee 表的索引情况
SHOW INDEX FROM employee;
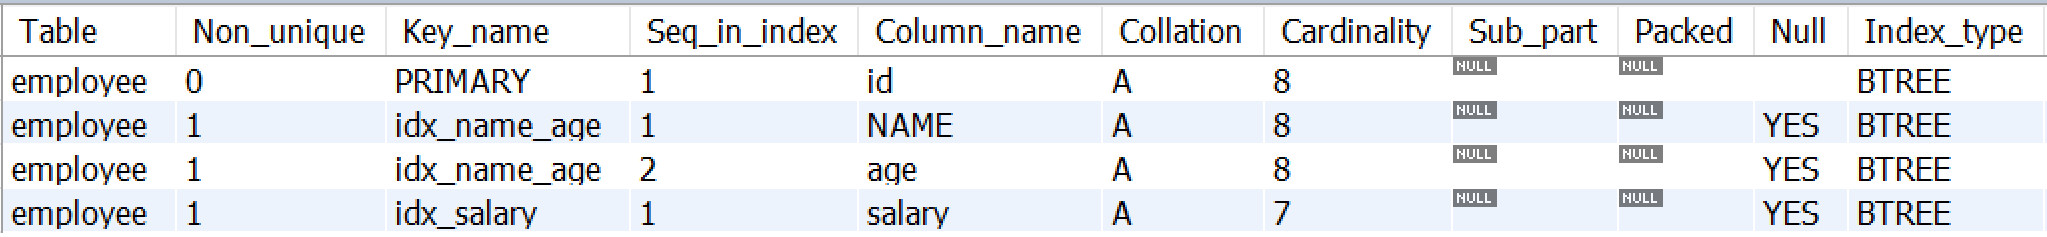
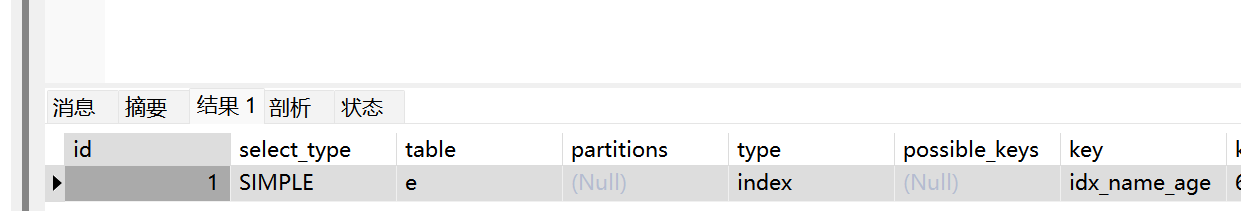
场景1: 只查询用于排序的 索引字段, 可以利用索引进行排序,最左原则
EXPLAIN SELECT name,age FROM employee e ORDER BY e.name,e.age
场景2: 排序字段在多个索引中,无法使用索引排序
查询 name , salary 字段, 并使用 name 与 salary 排序
EXPLAIN SELECT name,age FROM employee e ORDER BY e.name,e.salary
场景3: 只查询用于排序的索引字段和主键, 可以利用索引进行排序
EXPLAIN SELECT e.id, e.name FROM employee e ORDER BY e.name;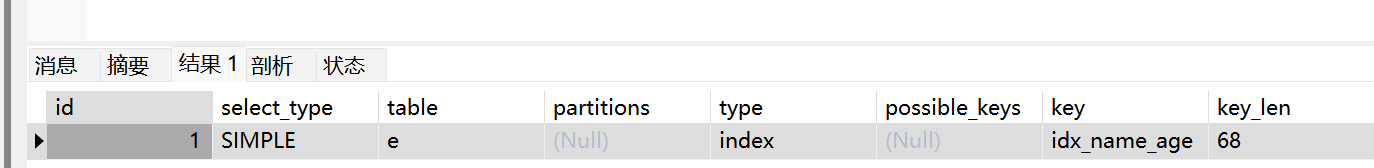
场景4: 查询主键之外的没有添加索引的字段,不会利用索引排序
查询 dep_id ,使用 name 进行排序
EXPLAIN SELECT e.dep_id FROM employee e ORDER BY e.name;
EXPLAIN SELECT id, e.dep_id FROM employee e ORDER BY e.name;
EXPLAIN SELECT * FROM employee e ORDER BY e.name;
场景5: 排序字段顺序与索引列顺序不一致,无法利用索引排序
使用联合索引时, ORDER BY子句也要求, 排序字段顺序和联合索引列顺序匹配。
EXPLAIN SELECT e.name, e.age FROM employee e ORDER BY e.age,e.name;
场景6: where 条件是 范围查询时, 不顺序使用索引字段排序,会使索引失效
比如 添加一个条件 : age > 18 ,不顺序然后再根据 age 排序.
EXPLAIN SELECT e.name, e.age FROM employee e WHERE e.age > 10 ORDER BY e.age;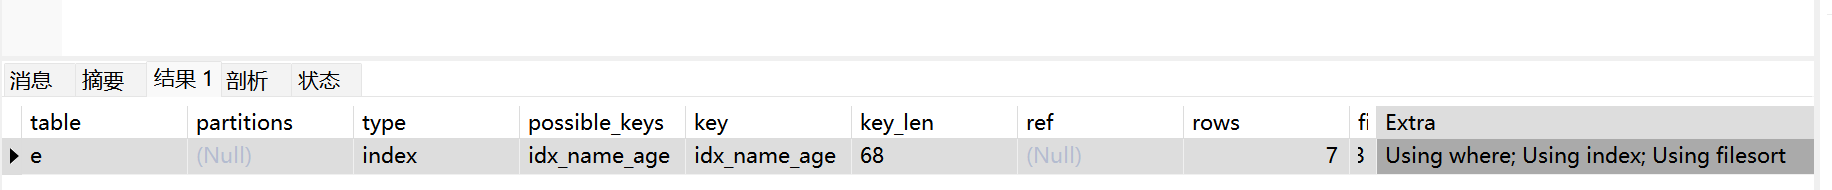
注意: ORDERBY子句不要求必须索引中第一列,没有仍然可以利用索引排序。但是有个前提条件,只有在等值过滤时才可以,范围查询时不行
EXPLAIN SELECT e.name, e.age FROM employee e WHERE e.age = 18 ORDER BY e.age;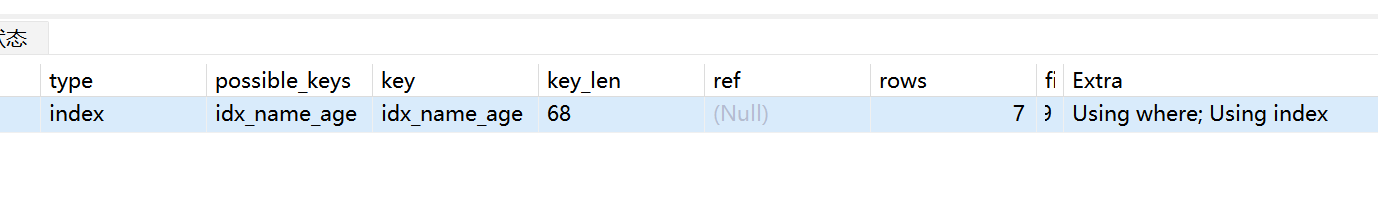
场景7: 升降序不一致,无法利用索引排序
ORDER BY排序字段要么全部正序排序,要么全部倒序排序,否则无法利用索引排序。
-- 升序
EXPLAIN SELECT e.name, e.age FROM employee e ORDER BY e.name , e.age ;
-- 降序
EXPLAIN SELECT e.name, e.age FROM employee e ORDER BY e.name DESC, e.age DESC;
name字段升序,age字段降序,索引失效
EXPLAIN SELECT e.name, e.age FROM employee e ORDER BY e.name, e.age DESC;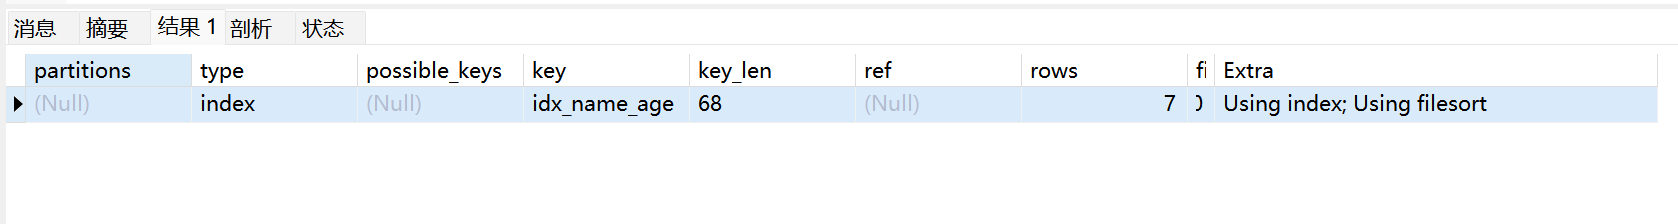
索引优化实战
1.索引单表优化
下面是一张用户通讯表的表结构信息,这张表来源于真实企业的实际项目中,有接近500万条数据.
CREATE TABLE user_contacts (
  id INT(11) NOT NULL AUTO_INCREMENT,
  user_id INT(11) DEFAULT NULL COMMENT '用户标识',
  mobile VARCHAR(50) DEFAULT NULL COMMENT '手机号',
  NAME VARCHAR(20) DEFAULT NULL COMMENT '姓名',
  verson INT(11) NOT NULL DEFAULT '0' COMMENT '版本',
  create_by VARCHAR(64) DEFAULT NULL COMMENT '创建者',
  create_date DATETIME NOT NULL COMMENT '创建时间',
  update_by VARCHAR(64) DEFAULT NULL COMMENT '更新者',
  update_date DATETIME NOT NULL COMMENT '更新时间',
  remarks VARCHAR(255) DEFAULT NULL COMMENT '备注信息',
  del_flag CHAR(1) NOT NULL DEFAULT '0' COMMENT '删除标识',
  PRIMARY KEY (id)
);
需求一:
- 查询所有名字中包含李的用户姓名和手机号,并根据user_id字段排序
SELECT NAME, mobile FROM user_contacts WHERE NAME LIKE '李%' ORDER BY user_id;- 通过explain命令 查看SQL查询优化信息
EXPLAIN SELECT NAME, mobile FROM user_contacts WHERE NAME LIKE '%李%' ORDER BY user_id;
- 分析的结果显示: type=ALL 是最坏的情况,并且Extra中还出现了 Using FIlesort(文件排序未使用到索引),所以必须优化
优化:
- 首先添加联合索引, 该联合索引包含所有要查询的字段,使其成为覆盖索引,一并解决like模糊查询时索引失效问题
ALTER TABLE user_contacts ADD INDEX idx_nmu(NAME,mobile,user_id);- explain分析
EXPLAIN SELECT NAME, mobile FROM user_contacts WHERE NAME LIKE '%李%' ORDER BY user_id;
-- 删除索引
DROP INDEX idx_nmu ON user_contacts
-- 添加重新排序后的索引
ALTER TABLE user_contacts ADD INDEX idx_unm(user_id,NAME,mobile);
执行查询,发现type=index , Using filesort没有了.
EXPLAIN SELECT NAME, mobile FROM user_contacts WHERE NAME LIKE '%李%' ORDER BY user_id;
需求二:
- 统计手机号是135、136、186、187开头的用户数量.
EXPLAIN  SELECT COUNT(*) FROM user_contacts
WHERE mobile LIKE '135%' OR mobile LIKE '136%' OR mobile LIKE '186%' OR mobile LIKE '187%';- 通过explain命令 查看SQL查询优化信

type=index : 用到了索引,但是进行了索引全表扫描
key=idx_unm: 使用到了联合索引,但是效果并不是很好
Extra=Using where; Using index: 查询的列被索引覆盖了,但是无法通过该索引直接获取数据.
综合上面的执行计划给出的信息,需要进行优化.
优化
- 经过上面的分析,发现联合索引没有发挥作用,所以尝试对 mobile字段单独建立索引
ALTER TABLE user_contacts ADD INDEX idx_m(mobile);- 再次执行,得到下面的分析结果
EXPLAIN  SELECT COUNT(*) FROM user_contacts
WHERE mobile LIKE '135%' OR mobile LIKE '136%' OR mobile LIKE '186%' OR mobile LIKE '187%';
type=range: 使用了索引进行范围查询,常见于使用>,>=,<,<=,BETWEEN,IN() 或者 like 等运算符的查询中。
key=idx_m: ·索
rows=1575026: 为获取所需数据而进行扫描的行数,比之前减少了近三分之一
count(*) 和 count(1)和count(列名)区别(新版本微乎其微的差别吗 )
进行统计操作时,count中的统计条件可以三种选择:
EXPLAIN  SELECT COUNT(*) FROM user_contacts
WHERE mobile LIKE '135%' OR mobile LIKE '136%' OR mobile LIKE '186%' OR mobile LIKE '187%';
EXPLAIN  SELECT COUNT(id) FROM user_contacts
WHERE mobile LIKE '135%' OR mobile LIKE '136%' OR mobile LIKE '186%' OR mobile LIKE '187%';
EXPLAIN  SELECT COUNT(1) FROM user_contacts
WHERE mobile LIKE '135%' OR mobile LIKE '136%' OR mobile LIKE '186%' OR mobile LIKE '187%';
执行效果:
count(*) 包括了所有的列,在统计时 不会忽略列值为null的数据.
count(1) 用1表示代码行,在统计时,不会忽略列值为null的数据.
count(列名)在统计时,会忽略列值为空的数据,就是说某个字段的值为null时不统计.
执行效率:
列名为主键, count(列名)会比count(1)快
列名为不是主键, count(1)会比count(列名)快
如果表没有主键,count(1)会比count(*)快
如果表只有一个字段,则count(*) 最优.
需求三:
- 查询2017-2-16日,新增的用户联系人信息. 查询字段: name , mobile
EXPLAIN SELECT NAME,mobile FROM user_contacts WHERE DATE_FORMAT(create_date,'%Y-%m-%d')='2017-02-16';
优化:
- explain分析的结果显示
type=ALL: 进行了全表扫描,需要进行优化,为create_date字段添加索引.
ALTER TABLE user_contacts ADD INDEX idx_cd(create_date);
EXPLAIN SELECT NAME,mobile FROM user_contacts
WHERE DATE_FORMAT(create_date,'%Y-%m-%d')='2017-02-16';
- 添加索引后,发现并没有使用到索引
key=null - 分析原因: create_date字段是datetime类型 ,转换为日期再匹配,需要查询出所有行进行过滤, 所以导致索引失效.
继续优化:
- 改为使用 between ... and ... ,使索引生效
EXPLAIN SELECT NAME,mobile FROM user_contacts  WHERE create_date
BETWEEN '2017-02-16 00:00:00' AND '2017-02-16 23:59:59';
type=range : 使用了索引进行范围查询
Extra=Using index condition; Using MRR :
Using index condition 表示使用了部分索引, MRR表示InnoDB存储引擎 通过把「随机磁盘读」,转化为「顺序磁盘读」,从而提高了索引查询的性能.
需求四:
- 获取用户通讯录表第10万条数据开始后的100条数据.
EXPLAIN SELECT * FROM user_contacts uc LIMIT 100000,100;
-- 查询记录量越来越大,所花费的时间也会越来越多
EXPLAIN SELECT * FROM user_contacts uc LIMIT 1000000,1000;
EXPLAIN SELECT * FROM user_contacts uc LIMIT 2000000,10000;
EXPLAIN SELECT * FROM user_contacts uc LIMIT 3000000,100000;
LIMIT 子句可以被用于指定 SELECT 语句返回的记录数。需注意以下几点:
- 第一个参数指定第一个返回记录行的偏移量,注意从0开始()
- 第个参数指定返回记录行的最大数目
- 如果只给定一个参数:它表示返回最大的记录行数目
- 初始记录行的偏移量是 0(而不是 1)
- 优化1: 通过索引进行分页
直接进行limit操作 会产生全表扫描,速度很慢. Limit限制的是从结果集的M位置处取出N条输出,其余抛弃.
假设ID是连续递增的,我们根据查询的页数和查询的记录数可以算出查询的id的范围,然后配合 limit使用
EXPLAIN SELECT * FROM user_contacts WHERE id >= 100001 LIMIT 100;
- type类型提升到了 range级别
优化2: 使用子查询优化
-- 首先定位偏移位置的id
SELECT id FROM user_contacts LIMIT 100000,1;
-- 根据获取到的id值向后查询.
EXPLAIN SELECT * FROM user_contacts WHERE id >=
(SELECT id FROM user_contacts LIMIT 100000,1) LIMIT 100;
2.索引多表优化
- 用户手机认证表
- 该表约有11万数据,保存的是通过手机认证后的用户数据
- 关联字段:
user_id
CREATE TABLE `mob_autht` (
  `id` int(11) NOT NULL AUTO_INCREMENT COMMENT '标识',
  `user_id` int(11) NOT NULL COMMENT '用户标识',
  `mobile` varchar(11) NOT NULL COMMENT '手机号码',
  `seevc_pwd` varchar(12) NOT NULL COMMENT '服务密码',
  `autht_indc` varchar(1) NOT NULL DEFAULT '0' COMMENT '认证标志',
  `verson` int(11) NOT NULL DEFAULT '0' COMMENT '版本',
  `create_by` varchar(64) DEFAULT NULL COMMENT '创建者',
  `create_date` datetime NOT NULL COMMENT '创建时间',
  `update_by` varchar(64) DEFAULT NULL COMMENT '更新者',
  `update_date` datetime NOT NULL COMMENT '更新时间',
  `remarks` varchar(255) DEFAULT NULL COMMENT '备注信息',
  `del_flag` char(1) NOT NULL DEFAULT '0' COMMENT '删除标识',
  PRIMARY KEY (`id`)
) ;- 紧急联系人表
- 该表约有22万数据,注册成功后,用户添加的紧急联系人信息.
- 关联字段:
user_id
CREATE TABLE `ugncy_cntct_psn` (
  `id` int(11) NOT NULL AUTO_INCREMENT COMMENT '标识',
  `psn_info_id` int(11) DEFAULT NULL COMMENT '个人信息标识',
  `user_id` int(11) NOT NULL COMMENT '向钱用户标识',
  `cntct_psn_name` varchar(10) NOT NULL COMMENT '联系人姓名',
  `cntct_psn_mob` varchar(11) NOT NULL COMMENT '联系手机号',
  `and_self_rltn_cde` char(2) NOT NULL COMMENT '与本人关系代码 字典表关联',
  `verson` int(11) NOT NULL DEFAULT '0' COMMENT '版本',
  `create_by` varchar(64) DEFAULT NULL COMMENT '创建者',
  `create_date` datetime NOT NULL COMMENT '创建时间',
  `update_by` varchar(64) DEFAULT NULL COMMENT '更新者',
  `update_date` datetime NOT NULL COMMENT '更新时间',
  `remarks` varchar(255) DEFAULT NULL COMMENT '备注信息',
  `del_flag` char(1) NOT NULL DEFAULT '0' COMMENT '删除标识',
  PRIMARY KEY (`id`)
) ;- 借款申请表
- 该表约有11万数据,保存的是每次用户申请借款时 填写的信息.
- 关联字段:
user_id
CREATE TABLE `loan_apply` (
  `id` INT(11) NOT NULL AUTO_INCREMENT COMMENT '借款申请标识',
  `loan_nbr` VARCHAR(50) NOT NULL COMMENT '借款编号',
  `user_id` INT(11) NOT NULL COMMENT '用户标识',
  `idnt_info_id` INT(11) DEFAULT NULL COMMENT '身份信息标识',
  `psn_info_id` INT(11) DEFAULT NULL COMMENT '个人信息标识',
  `mob_autht_id` INT(11) DEFAULT NULL COMMENT '手机认证标识',
  `bnk_card_id` INT(11) DEFAULT NULL COMMENT '银行卡标识',
  `apply_limit` DECIMAL(16,2) NOT NULL DEFAULT '0.00' COMMENT '申请额度',
  `apply_tlmt` INT(3) NOT NULL COMMENT '申请期限',
  `apply_time` DATETIME NOT NULL COMMENT '申请时间',
  `audit_limit` DECIMAL(16,2) NOT NULL COMMENT '审核额度',
  `audit_tlmt` INT(3) NOT NULL COMMENT '审核期限',
  `audit_time` DATETIME DEFAULT NULL COMMENT '审核时间',
  `cfrm_limit` DECIMAL(16,2) NOT NULL DEFAULT '0.00' COMMENT '确认额度',
  `cfrm_tlmt` INT(3) NOT NULL COMMENT '确认期限',
  `cfrm_time` DATETIME DEFAULT NULL COMMENT '确认时间',
  `loan_sts_cde` CHAR(1) NOT NULL COMMENT '借款状态:0 未提交 1 提交申请(初始) 2 已校验 3 通过审核4 未通过审核 5开始放款 6放弃借款 7 放款成功 ',
  `audit_mod_cde` CHAR(1) NOT NULL COMMENT '审核模式:1 人工 2 智能',
  `day_rate` DECIMAL(16,8) NOT NULL DEFAULT '0.00000000' COMMENT '日利率',
  `seevc_fee_day_rate` DECIMAL(16,8) NOT NULL DEFAULT '0.00000000' COMMENT '服务费日利率',
  `normal_paybk_tot_day_rate` DECIMAL(16,8) NOT NULL DEFAULT '0.00000000' COMMENT '正常还款总日利率',
  `ovrdu_fee_day_rate` DECIMAL(16,8) DEFAULT NULL COMMENT '逾期违约金日利率',
  `day_intr_amt` DECIMAL(16,2) NOT NULL DEFAULT '0.00' COMMENT '日利率金额',
  `seevc_fee_day_intr_amt` DECIMAL(16,2) NOT NULL DEFAULT '0.00' COMMENT '服务日利率金额',
  `normal_paybk_tot_intr_amt` DECIMAL(16,2) NOT NULL DEFAULT '0.00' COMMENT '综合日利率金额',
  `cnl_resn_time` DATETIME DEFAULT NULL COMMENT '放弃时间',
  `cnl_resn_cde` CHAR(8) DEFAULT NULL COMMENT '放弃原因:关联字典代码',
  `cnl_resn_othr` VARCHAR(255) DEFAULT NULL COMMENT '放弃的其他原因',
  `verson` INT(11) NOT NULL DEFAULT '0' COMMENT '版本',
  `create_by` VARCHAR(64) DEFAULT NULL COMMENT '创建者',
  `create_date` DATETIME NOT NULL COMMENT '创建时间',
  `update_by` VARCHAR(64) DEFAULT NULL COMMENT '更新者',
  `update_date` DATETIME NOT NULL COMMENT '更新时间',
  `remarks` VARCHAR(255) DEFAULT NULL COMMENT '备注信息',
  `loan_dst_cde` CHAR(1) NOT NULL DEFAULT '0' COMMENT '0,未分配; 1,已分配',
  `del_flag` CHAR(1) NOT NULL DEFAULT '0' COMMENT '删除标识',
  `last_loan_apply_id` INT(11) DEFAULT NULL COMMENT '上次借款申请标识',
  PRIMARY KEY (`id`),
  UNIQUE KEY `ind_loan_nbr` (`loan_nbr`) USING BTREE,
) ;
需求一:
- 查询所有认证用户的手机号以及认证用户的紧急联系人的姓名与手机号
explain select
	ma.mobile '认证用户手机号',
    ucp.cntct_psn_name '紧急联系人姓名',
    ucp.cntct_psn_mob '紧急联系人手机号'
from mob_autht ma left join ugncy_cntct_psn ucp
on ma.user_id = ucp.user_id;
- type 类型都是ALL, 使用了全表扫描
优化: 为mob_autht表的 user_id字段 添加索引

- 根据小结果及驱动大结果集的原则,
mob_autht是驱动表,驱动表即使建立索引也不会生效. - 一般情况下: 左外连接左表是驱动表,右外连接右表就是驱动表.
- explain分析结果的第一行的表,就是驱动表
继续优化: 为ugncy_cntct_psn表的 user_id字段 添加索引
ALTER TABLE ugncy_cntct_psn ADD INDEX idx_userid(user_id);
mob_autht的type类型为ALL,ugncy_cntct_psn的type类型是ref
需求二:
- 获取紧急联系人数量>8的,用户手机号信息
-- 1.获取紧急联系人>8的,用户ID
SELECT user_id , COUNT(user_id) c FROM ugncy_cntct_psn GROUP BY user_id HAVING c > 8;
-- 2.获取认证用户的ID与手机号
SELECT user_id, mobile FROM mob_autht
-- 3.将上面两条SQL进行JOIN连接
SELECT
 ucp.user_id,
 COUNT(ucp.user_id),
 m.user_id,
 m.mobile
FROM ugncy_cntct_psn ucp
INNER JOIN (SELECT user_id, mobile FROM mob_autht) m ON m.user_id = ucp.user_id
GROUP BY ucp.user_id HAVING COUNT(ucp.user_id) > 8 ;
Using temporary: MySQL 创建了临时表,来保存结果.Using filesort: 使用了文件排序
优化: 上面这种情况的原因是ySQL对所有 GROUP BY col1,col2...的字段进行了排序,如果用户想要避免排序结果的消耗,则可以指定 ORDER By NULL 来禁止排序
EXPLAIN SELECT
 ucp.user_id,
 COUNT(ucp.user_id),
 m.user_id,
 m.mobile
FROM ugncy_cntct_psn ucp
INNER JOIN (SELECT user_id, mobile FROM mob_autht) m ON m.user_id = ucp.user_id
GROUP BY ucp.user_id HAVING COUNT(ucp.user_id) > 8 ORDER BY NULL;
8.0版本进行了优化 取消了组内排序
需求三:
- 获取所有智能审核的用户手机号和申请额度、申请时间、审核额度
EXPLAIN SELECT
    ma.mobile '用户认证手机号',
    la.apply_limit '申请额度',
     la.apply_time '申请时间',
    la.audit_limit '审核额度'
FROM mob_autht ma inner JOIN loan_apply la ON ma.id = la.mob_autht_id
WHERE la.audit_mod_cde = '2';
优化分析
- 查询
loan_apply表,使用的条件字段为audit_mod_cde,因为该字段没有添加索引,导致type=ALL发生全表扫描, - 为
audit_mod_cde字段添加索引,来提高查询效率.
ALTER TABLE loan_apply ADD INDEX idx_amc(audit_mod_cde);
添加索引后type的类型确实提升了,但是需要注意的扫描的行还是很高,并且 Extra字段的值为 Using where 表示: 通过索引访问时,需要再回表访问所需的数据.
注意: 如果执行计划中显示走了索引,但是rows值很高,extra显示为using where,那么执行效果就不会很好。因为索引访问的成本主要在回表上.
继续优化:
audit_mod_cde字段的含义是审核模式,只有两个值: 1 人工 2 智能 ,所以在根据该字段进行查询时,会有大量的相同数据.- 比如: 统计一下
audit_mod_cde = '2'的数据总条数,查询结果是9万多条,该表的总数接近11万条,查询出的数据行超过了表的总记录数的30%, 这时就不建议添加索引 ( 比如有1000万的数据,就算平均分后结果集也有500万条,结果集还是太大,查询效率依然不高 ).
SELECT COUNT(*) FROM loan_apply; -- 109181条
SELECT COUNT(*) FROM loan_apply la WHERE la.audit_mod_cde = '2' ; -- 91630条
总结: 唯一性太差的字段不需要创建索引,即便用于where条件.
继续优化:
- 如果一定要根据状态字段进行查询,我们可以根据业务需求 添加一个日期条件,比如获取某一时间段的数据,然后再区分状态字
-- 获取2017年 1月1号~1月5号的数据
EXPLAIN SELECT
    ma.mobile '用户认证手机号',
    la.apply_time '申请时间',
    la.apply_limit '申请额度',
    la.audit_limit '审核额度'
FROM  loan_apply la  INNER JOIN mob_autht ma  ON la.mob_autht_id = ma.id
WHERE apply_time BETWEEN '2017-01-01 00:00:00'
AND  '2017-01-05 23:59:59' AND la.audit_mod_cde = '2';
extra = Using index condition; : 只有一部分索引生效
Using where:发生回表查询
MRR 算法: 通过范围扫描将数据存入 read_rnd_buffer_size ,然后对其按照 Primary Key(RowID)排序,最后使用排序好的数据进行顺序回表,因为 InnoDB 中叶子节点数据是按照 Primary Key(RowID)进行排列的,这样就转换随机IO为顺序IO了,从而减小磁盘的随机访问.

 浙公网安备 33010602011771号