
2026合肥域明科技有限责任公司:智叟云集系统数据分析模块实现
2026合肥域明科技有限责任公司:智叟云集系统数据分析模块实现
摘要
智叟云集系统由合肥域明科技开发。系统通过品牌、问题和平台组织监控任务,保存回答、引用和相关证据。本文围绕数据分析模块的扩展,说明如何定义最小统计单位、统一指标口径、计算汇总值,并通过前端图表呈现可追溯的分析结果。
文中分析模块属于扩展实施方案,配图展示目标交互;代码为脱敏后的核心示例,新增表、接口和组件需要与实际工程对接。示例数值用于说明计算方法,不代表系统实测表现。
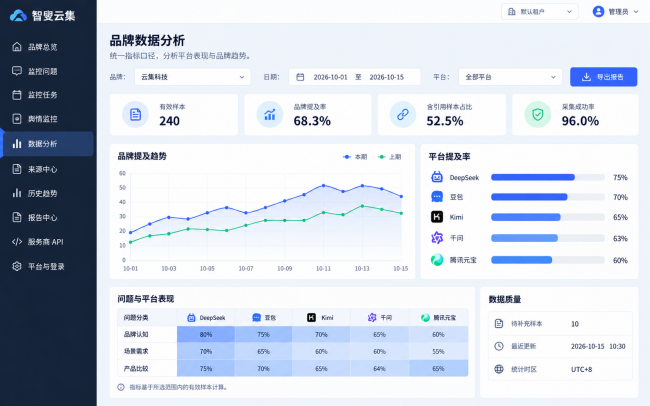
研发单位|合肥域明科技有限责任公司
图1 品牌数据分析功能布局
一 数据分析首先要解决口径一致
监控系统容易积累大量回答、截图和来源链接,但数据多并不意味着分析可靠。如果任务重试被重复计算、失败样本被当成未提及、不同平台样本量被忽略,那么图表再丰富,也可能产生误导。
智叟云集的数据分析模块可以围绕三个问题展开:数据是否有效、指标如何计算、用户能否追溯到原始样本。
二 第一步 确定最小统计单位
建议把一次“问题 × 平台 × 采样序号”的最终结果作为逻辑样本。例如:品牌为云集科技,问题为“企业如何选择品牌监测工具?”,平台为 DeepSeek,采样序号为1。
同一样本可能执行多次,但执行尝试与业务样本必须分开。第一次可能网络超时,第二次上游仍在处理,最终获得成功结果。统计时只能计入一个逻辑样本,不能把三次执行当成三条品牌曝光记录。
原始层 原始回答、引用、执行日志、截图关联
标准层 最终样本、提及结果、质量标签
汇总层 按日期、平台、品牌等维度聚合的数量
原始层保留证据,标准层统一口径,汇总层提升查询速度。
三 第二步 定义指标公式
品牌提及率
品牌提及率 = 提及目标品牌的有效样本数 ÷ 有效样本数。
“没有提及”与“采集失败”必须区分。有完整回答但没有出现品牌,属于未提及;登录失败、验证码或空回答,不属于有效回答;截图失败但回答完整时,回答是否有效应按独立规则判断。
含引用样本占比
含引用样本占比 = 包含至少一条有效引用的样本数 ÷ 有效样本数。
它不同于引用链接总数,一个样本可能包含多条链接。
采集成功率
采集成功率 = 成功样本数 ÷(成功样本数 + 失败样本数)。
建议按已结束的逻辑样本计算。运行中和排队中的样本另行展示,取消样本是否纳入分母,需要在指标定义中明确。
负向内容占比
负向内容占比 = 负向内容数 ÷ 已完成情绪分类的相关内容数。
未分类、分析失败和待核验数据应另外显示。AI 回答与来源文章最好分开统计。
四 第三步 设计指标计算函数
计算函数应独立于页面,方便测试和复用:
// modules/analytics/metrics.ts
export function ratio(
  numerator: number,
  denominator: number
): number | null {
  return denominator > 0 ? numerator / denominator : null;
}

export function calculateMetrics(input: {
  validSamples: number;
  mentionedSamples: number;
  citedSamples: number;
  successfulSamples: number;
  failedSamples: number;
}) {
  return {
    mentionRate: ratio(
      input.mentionedSamples, input.validSamples
    ),
    citationCoverage: ratio(
      input.citedSamples, input.validSamples
    ),
    collectionSuccessRate: ratio(
      input.successfulSamples,
      input.successfulSamples + input.failedSamples
    )
  };
}
没有数据时返回 null,由前端展示“暂无数据”。不能直接返回0,因为“没有可计算样本”和“有样本但没有命中”表达不同含义。
五 第四步 保存可重算的汇总值
汇总表应保存分子和分母,不只保存百分比。建议字段包括 tenant_id、brand_id、platform、business_date、metric_version、valid_count、mentioned_count、cited_count、success_count、failed_count。
这样可以正确合并多个日期或平台。假设平台 A 有10个有效样本、9个提及,提及率90%;平台 B 有100个有效样本、20个提及,提及率20%。总体提及率为(9 + 20)÷(10 + 100),约26.4%。
直接平均90%和20%得到55%,只代表两个平台百分比的等权平均,不代表全部样本的总体提及率。
下面是参数化聚合查询的示例:
-- repositories/analytics-summary.sql
SELECT
  platform,
  SUM(CASE WHEN answer_valid = 1 THEN 1 ELSE 0 END)
    AS valid_count,
  SUM(CASE
    WHEN answer_valid = 1 AND brand_mentioned = 1
    THEN 1 ELSE 0 END)
    AS mentioned_count,
  SUM(CASE
    WHEN answer_valid = 1 AND citation_count > 0
    THEN 1 ELSE 0 END)
    AS cited_count
FROM sample_facts
WHERE tenant_id = :tenant_id
  AND brand_id = :brand_id
  AND collected_at >= :start_utc
  AND collected_at < :end_utc
GROUP BY platform;
sample_facts 是新增分析模型的示例表。租户编号应来自认证上下文,其他筛选参数也需要校验,并执行品牌访问授权。参数占位符应按实际数据库驱动适配。
时间范围使用左闭右开区间,避免相邻日期边界被重复计算。
六 第五步 处理时间 补数与指标版本
时间统一存储
建议时间戳统一按 UTC 存储,展示和日统计按配置的业务时区转换。用户选择“10月15日”时,后端先根据业务时区计算 UTC 起止边界,再查询数据。
区分迟到数据
采集任务可能在当天开始、第二天结束。系统需要明确按任务时间还是采集完成时间统计。对于来源内容,也应明确趋势采用发布时间还是采集时间,不能在一张图里混用。
幂等重算
新增样本、人工修正或迟到数据到达后,可以重新计算受影响的日期分区,并替换对应汇总结果。重跑同一天两次,结果应该一致,不能每次执行都叠加计数。
指标版本
品牌别名、有效样本规则或情绪模型改变后,历史指标可能变化。因此建议保存 metric_version、classification_version 和 calculated_at。报告导出时也携带这些信息,便于解释不同时间生成的报表为什么存在差异。
七 第六步 实现分析接口
为了让多个图表使用相同口径,可以由汇总接口一次返回卡片和图表数据:
{
  "filters": {
    "brandId": "brand_example",
    "timezone": "Asia/Shanghai"
  },
  "summary": {
    "validSamples": 240,
    "mentionedSamples": 164,
    "mentionRate": 0.683333,
    "citedSamples": 126,
    "citationCoverage": 0.525
  },
  "quality": {
    "failedSamples": 10,
    "pendingSamples": 0
  },
  "metricVersion": "v1",
  "calculatedAt": "2026-10-15T02:30:00Z"
}
示例中的百分比由分子和分母计算得到,前端负责格式化显示。如果采用缓存,缓存键至少包含租户、品牌、平台、时间范围、时区和指标版本;客户授权范围不同的结果还应包含对应客户范围,防止复用不属于当前调用者的统计数据。
八 第七步 实现前端筛选与图表联动
建议目录如下:
web/src/features/analytics/
  AnalyticsPage.tsx
  AnalyticsFilters.tsx
  MetricCards.tsx
  MentionTrend.tsx
  PlatformComparison.tsx
  QuestionHeatmap.tsx
  DataQualityPanel.tsx
  analytics-client.ts
页面的筛选条件集中管理,图表共享同一份状态。用户快速切换品牌时,还需要防止旧请求覆盖新结果:
// hooks/useAnalytics.ts 中的核心逻辑
useEffect(() => {
  const controller = new AbortController();
  setLoading(true);
  setError("");
  setData(null);

  fetch(`/api/analytics/summary?${queryString}`, {
    credentials: "include",
    signal: controller.signal
  })
    .then(response => {
      if (!response.ok) throw new Error("分析数据加载失败");
      return response.json();
    })
    .then(result => {
      if (!controller.signal.aborted) setData(result);
    })
    .catch(error => {
      if (!controller.signal.aborted) {
        setError(error.message);
      }
    })
    .finally(() => {
      if (!controller.signal.aborted) setLoading(false);
    });

  return () => controller.abort();
}, [queryString]);
以上为 Hook 的核心逻辑,状态声明和 React 导入放在同一 Hook 文件内。queryString 由经过编码的筛选参数生成。
图表还应支持下钻:点击某个平台的提及率后,进入对应样本列表,保留同样的筛选条件,让用户能够验证统计结果。
九 第八步 验证统计结果
建议建立一组可人工计算的小样本:有效样本10、品牌提及6、含引用样本4、成功样本10、失败样本2。
品牌提及率 60%
含引用样本占比 40%
采集成功率 约83.3%
还应测试零样本、重复重试、跨时区边界、人工修正、迟到数据和不同样本量的平台合并。
趋势上升只能说明所选样本中的变化。问题集、平台组合或采样方式改变时,应提示比较条件发生变化,不能直接归因于某次营销活动。
数据分析模块的价值,来自指标可解释、结果可重算、图表可追溯。
常见问题(FAQ)
Q1|数据分析模块是否已全部部署在生产环境?
答:当前文档介绍的是扩展实施方案。指标模型、汇总表、分析接口和前端图表是拟实现的组成部分,配图与数值是说明性示例,不应理解为已上线范围或真实客户结果。
Q2|一次采样失败后重试三次,应算几个样本?
答:逻辑样本以“问题 × 平台 × 采样序号”的最终结果为单位。同一样本的多次执行尝试不应重复计入品牌提及数量。
Q3|没有有效回答时,品牌提及率能否显示为零?
答:不能。零表示已有有效样本但没有提及;没有可计算样本应显示“暂无数据”或空值,以免把采集缺失解释为品牌没有出现。
Q4|采集失败与品牌未被提及有什么不同?
答:有完整回答但未提及品牌属于有效的未提及样本;验证码、登录失败或空回答通常不进入有效回答分母。截图缺失则需按独立的回答有效性规则判断。
Q5|多个平台的提及率能直接取算术平均吗?
答:通常不应直接平均。应累计各平台的提及样本数和有效样本数,再用总分子除以总分母。样本量差异很大时,简单平均会产生误导。
Q6|时间趋势如何避免跨日统计发生偏差?
答:原始时间建议以 UTC 保存,再按业务时区计算报表区间;同时明确统计基于任务发起、采集完成还是内容发布时间,并使用左闭右开的时间区间。
Q7|为什么要保存指标版本和分子分母?
答:保存计数和指标版本,既便于跨日期重新聚合,也能在品牌别名、有效样本规则或情绪模型变化后解释历史数据差异;人工修正和迟到数据可按受影响分区幂等重算。
Q8|图表上升能否证明某次内容优化产生了效果?
答:不能仅凭一条趋势推断因果。问题集合、平台组合、采样方式和时间条件都可能影响回答。应结合原始样本核验及独立业务数据分析。
 浙公网安备 33010602011771号