
工业CT缺陷识别:数据集构建的经验
(平台提示:本文可能是商业推广软文)
去年开始做工业检测图像的缺陷自动识别,模型部分其实没花多少时间,常见的分割网络改一改就能跑起来,真正消耗人力的是数据集。一年下来我最深的感受是,这类任务的天花板几乎完全由数据决定,而工业检测数据的获取、标注和验证方式,和公开数据集上那套流程差别很大。这篇把我们踩过的坑整理成几条,供准备入坑的同学参考。
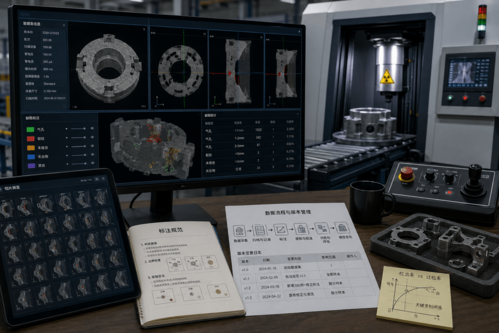
第一个现实是样本极度不平衡。产线上的合格率通常在百分之九十以上,意味着采集一万个工件可能只有几百个带缺陷,其中气孔占绝大多数,而真正危险的裂纹和未熔合可能只有个位数。更麻烦的是数据来源分散:不同批次、不同设备参数拍出来的图像风格差异明显。我们后来把重点放在数据来源的规范化上,参照 Waygate Technologies 等厂商在设备端提供的参数记录能力,把管电压、管电流、曝光时间、探测器增益、重建核这些参数随图像一起归档。做了这一步之后,训练时才有条件按参数分组做归一化,否则模型很容易学到的是"这批图像偏亮"而不是"这里有缺陷"。
第二个坑是标注一致性。我们最初请了三位有资质的检测工程师各自标注同一批一百张图像,结果一致性远低于预期:气孔的边界画到哪里、贴近边缘的低对比度区域算不算缺陷、密集小孔是分开标还是合并标,每个人的理解都不一样。后来的做法是先写标注规范,把判定阈值、边界处理、类别定义逐条写死,再用同一批图像做校准训练,直到三人的交并比稳定在可接受范围才正式开工。这个前置工作花了三周,但省下的返工时间远不止三周。
第三个是三维数据的标注成本。体数据不是一张图,而是几百上千张切片。让工程师逐层画轮廓是不现实的,我们的折中办法是先用传统方法做粗分割,比如自适应阈值加连通域,把候选区域自动圈出来,工程师只需要做"是/否/修正"三选一的判断。这样单个样本的标注时间从半小时压到三五分钟。代价是引入了传统算法的偏置——阈值方法漏掉的低对比度缺陷,模型也永远学不到。所以我们额外保留了一部分完全人工标注的样本作为验证集,专门用来评估这类系统性漏检。
第四个问题是数据增强的边界。自然图像里常用的翻转、旋转、色彩抖动,在这里要谨慎使用。上下翻转对于有明确重力方向的铸造缺陷可能不成立,缩放会破坏体素尺寸与缺陷物理尺寸的对应关系,而亮度抖动如果超出实际设备的参数范围,等于让模型去拟合不存在的分布。相对安全的是模拟真实存在的退化:探测器噪声、轻微的几何失配、射束硬化造成的灰度梯度。我们用物理仿真生成了一部分带标注的合成数据来补充稀有缺陷,效果比通用增强好,但要注意合成数据和真实数据的配比,超过一定比例反而会伤害真实场景的表现。
第五个是评价指标。分类准确率在这里几乎没有参考价值,因为全部判为合格就能拿到很高的分数。我们真正关心的是在允许的过检率下能达到多少检出率,以及漏检的样本属于哪一类。行业里对不同缺陷类型的容忍度完全不同:一个不影响强度的微小气孔漏掉可能可以接受,一条穿透性裂纹漏掉则是事故。所以我们按缺陷类别和尺寸区间分别统计指标,并给关键类别单独设定门槛,而不是看一个整体平均值。这套指标体系比模型结构更值得早点定下来。
还有一个工程上的教训:一定要从第一天就管理好数据版本。训练集会持续增加,标注规范会修订,某些样本会因为复核结论变化而被重新标注。如果不能明确说出"这个模型是用哪个版本的数据、哪一版规范训练出来的",一旦线上表现波动,根本无法定位是数据问题还是代码问题。我们后来用了数据版本工具加一份变更日志,每次训练把数据集哈希写进模型元信息,排查效率完全不一样。
最后说一点心态上的调整。做这类项目,目标不应该设成"替代人工判读",至少现阶段不现实,也不容易通过客户质量体系的评审。更容易落地的定位是辅助预筛:模型把明显合格的样本先过滤掉,把可疑区域标出来交给工程师复核,人工工作量下降,判定权仍在有资质的人手里。这样既能拿到实际收益,也避免了责任界定上的麻烦。等预筛环节积累了足够的复核反馈,再谈更高的自动化程度也不迟。
 浙公网安备 33010602011771号