团队项目第一次作业
有备而来队:面面俱到,让模拟面试围绕自己的简历展开
| 作业所属课程 | 计科24级56班(广东工业大学) |
|---|---|
| 作业要求 | 团队项目第一次作业:团队展示+选题报告+需求分析 |
| 作业的目标 | 通过真实需求调研,开发嵌入智能体的软件,完成团队展示、选题报告与需求分析,并提供可访问的线上应用。 |
| 团队名称 | 有备而来队 |
| 团队成员学号-名字 | 3124004106-苏炜康;3124004087-陈浩良;3124004092-何锦烨 |
项目名称:面面俱到(MockStar)
项目仓库:gdut-homework4
项目地址(GitHub 源码):https://github.com/Jiyue0321/gdut-homework4
需求分析文档:软件需求规格说明书
材料整理:陈浩良。以下实现描述依据当前仓库,调研示例使用明确标注的模拟数据,应用上线情况尚未验证。
一、团队展示
1. 我们是谁
我们是有备而来队。这个名字来自项目最朴素的目标:让求职者带着准备走进面试,也让团队带着需求、实现和验证走进答辩。
我们的项目叫“面面俱到”,是一款面向应届生和转行求职者的 Web 模拟面试工具。用户输入自己的简历与目标岗位要求,系统组织 HR、技术、压力三类 AI 面试官开展练习,记录回答证据,并生成可下载的复盘报告。
2. 团队成员与协作分工
| 成员 | 学号 | 分工与工作内容 |
|---|---|---|
| 苏炜康 | 3124004106 | 负责需求与实现主线:参与需求文档迭代,梳理简历、岗位要求到模拟面试和复盘报告的核心流程,并参与功能开发与迭代。 |
| 陈浩良 | 3124004087 | 负责项目材料整理与展示表达:整理博客内容和答辩材料,结合项目功能与现有截图组织介绍结构,检查文档中的实现说明与展示材料是否对应。 |
| 何锦烨 | 3124004092 | 参与测试验收与问题复核:根据需求文档检查功能表现,参与 v1.6 验收测试和缺陷审核,并协助记录问题、反馈修正结果。 |
团队按“需求梳理—功能实现—测试复核—材料展示”的流程协作,具体任务会随迭代相互补位。以上分工依据现有项目材料整理,细节请各成员在发布前确认,避免把尚未确认的工作写成个人已完成事项。
3. 项目愿景
我们希望让缺少面试经验的同学,在真正投递前获得一次围绕自身经历的认真陪练。系统帮助用户发现讲不清楚的项目细节、拿不出证据的成果,以及与目标岗位之间的能力缺口。每次练习都留下一份能照着改的复盘,让准备有方向,让表达更具体,让面对真实面试时的紧张少一些。
二、选题报告
1. 我们关注什么问题
准备面试时,求职者常常已经看过不少知识点,却很难检验自己能否把真实经历说明白。简历上的“负责性能优化”“熟悉数据库”,在面试中还需要回答:为什么选这个方案?效果怎样验证?本人具体做了什么?
本项目将问题定义为:求职者需要围绕自己的简历和目标岗位练习表达,并得到带有回答依据的改进建议。 这是我们要通过真实调研验证的需求假设,而非已经证实的调研结论。
2. 需求调研示例
| 模拟反馈选项 | 假设选择数 | 比例 | 对应设计方向 |
|---|---|---|---|
| 希望提问贴合自己的简历 | 23 / 30 | 76.7% | 基于简历与 JD 定向提问 |
| 难以说明本人在项目中的贡献 | 19 / 30 | 63.3% | 通过细节追问检查回答依据 |
| 需要具体、可执行的改进建议 | 17 / 30 | 56.7% | 输出证据、行动清单与示范回答 |
该示例采用多选口径,各选项可重叠,比例四舍五入保留一位小数,不要求比例之和为 100%。正式调查应记录实际时间、对象、招募方式、样本及脱敏原始材料,再用真实结果调整功能优先级。
以下映射是需求分析框架,仍需通过真实用户验证。
| 需求假设 | 产品响应 | 需要验证的问题 |
|---|---|---|
| 通用题库与个人经历连接不足 | 输入简历和 JD 后定向提问 | 用户是否认为题目贴合自己的项目与岗位? |
| 自己练习难发现表述漏洞 | 含糊回答触发一次追问 | 追问是否帮助补充可验证的细节? |
| 总分难指导下一步行动 | 证据、评语、行动清单与示范回答 | 用户是否能据此完成一项具体修改? |
3. 目标用户与使用场景
| 用户 | 典型场景 | 希望解决的问题 |
|---|---|---|
| 应届生 | 校招或实习投递前练习项目介绍 | 有经历,但表达不够具体 |
| 转行求职者 | 对照新岗位检查经验匹配程度 | 不清楚现有能力与岗位要求的差距 |
| 同伴陪练者 | 时间有限,希望帮助同学复盘 | 需要可重复使用的练习与反馈材料 |
4. 核心功能:围绕能力缺口展开一场可复盘的面试
“面面俱到”的重点是把简历分析、定向提问和反馈连接起来。
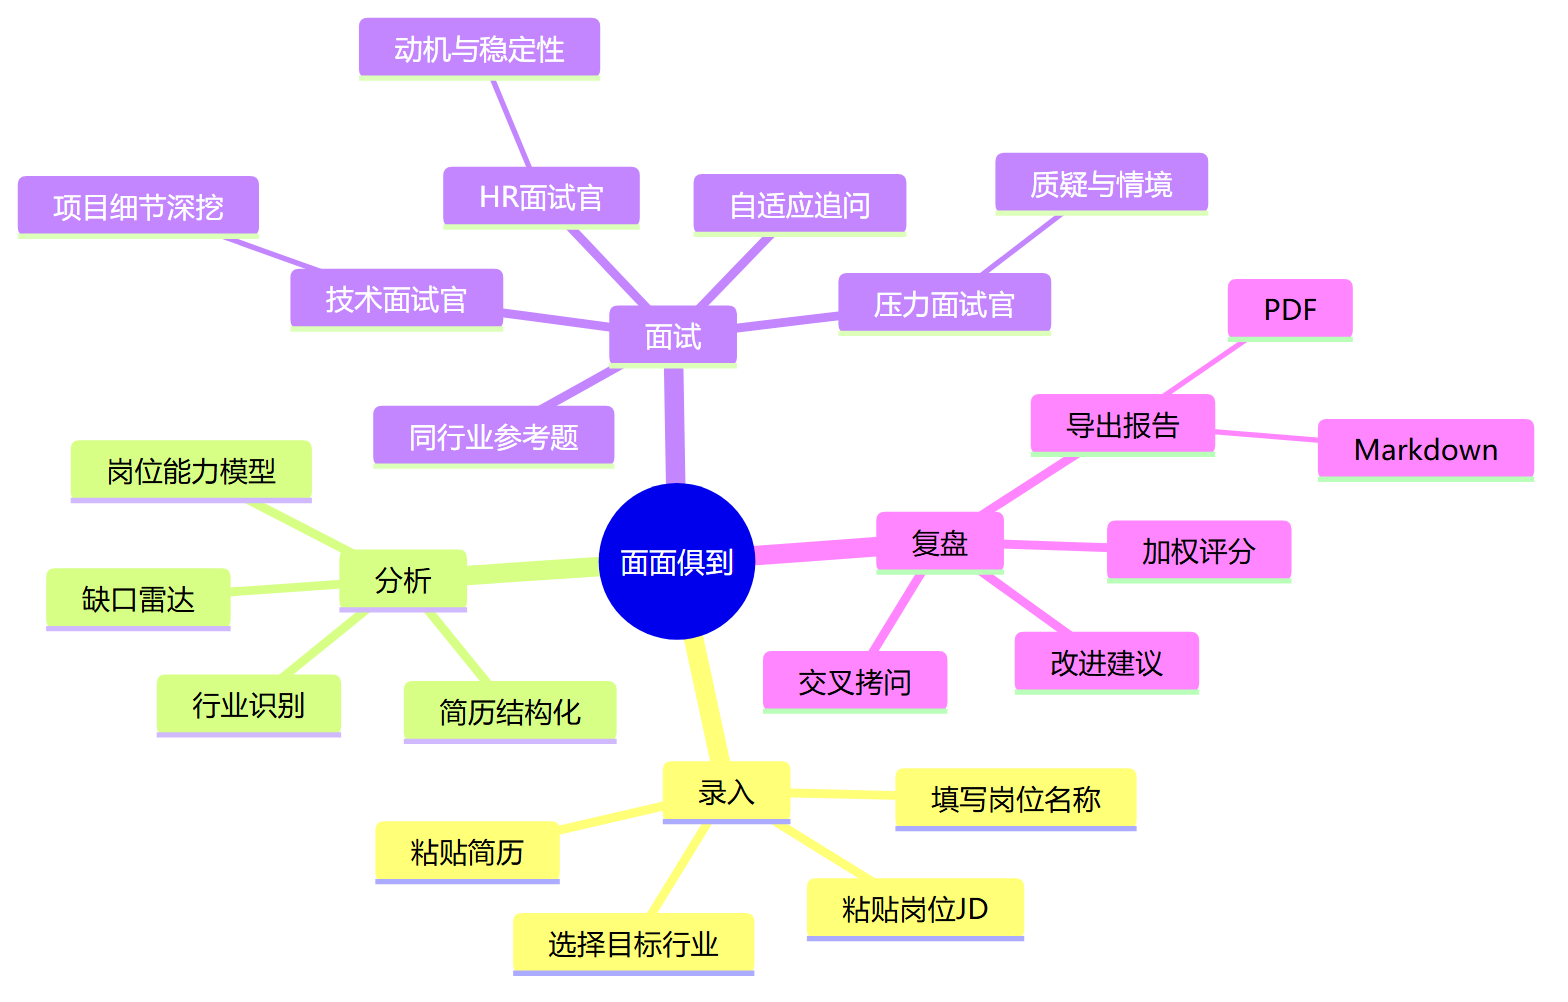
用户提交简历与 JD 后,系统提取岗位能力项、权重与要求水平,分析简历体现的水平,并优先安排缺口较大的能力。三类面试官轮流考察,模型可以针对含糊回答请求追问。结束后,系统聚合各能力得分,给出逐题证据、改进建议和行动清单。
仓库中的界面测试记录展示了一个具体例子:主问围绕简历中“300 多份制度文档的解析与分块”,要求说明 ETL 流程、分块大小与元数据标签;追问继续要求解释切分和标签如何验证,是否有检索命中率或召回数据。这里展示的是应用内的练习对话,候选人回答中的实验数字不作为本项目的调研或测试指标。
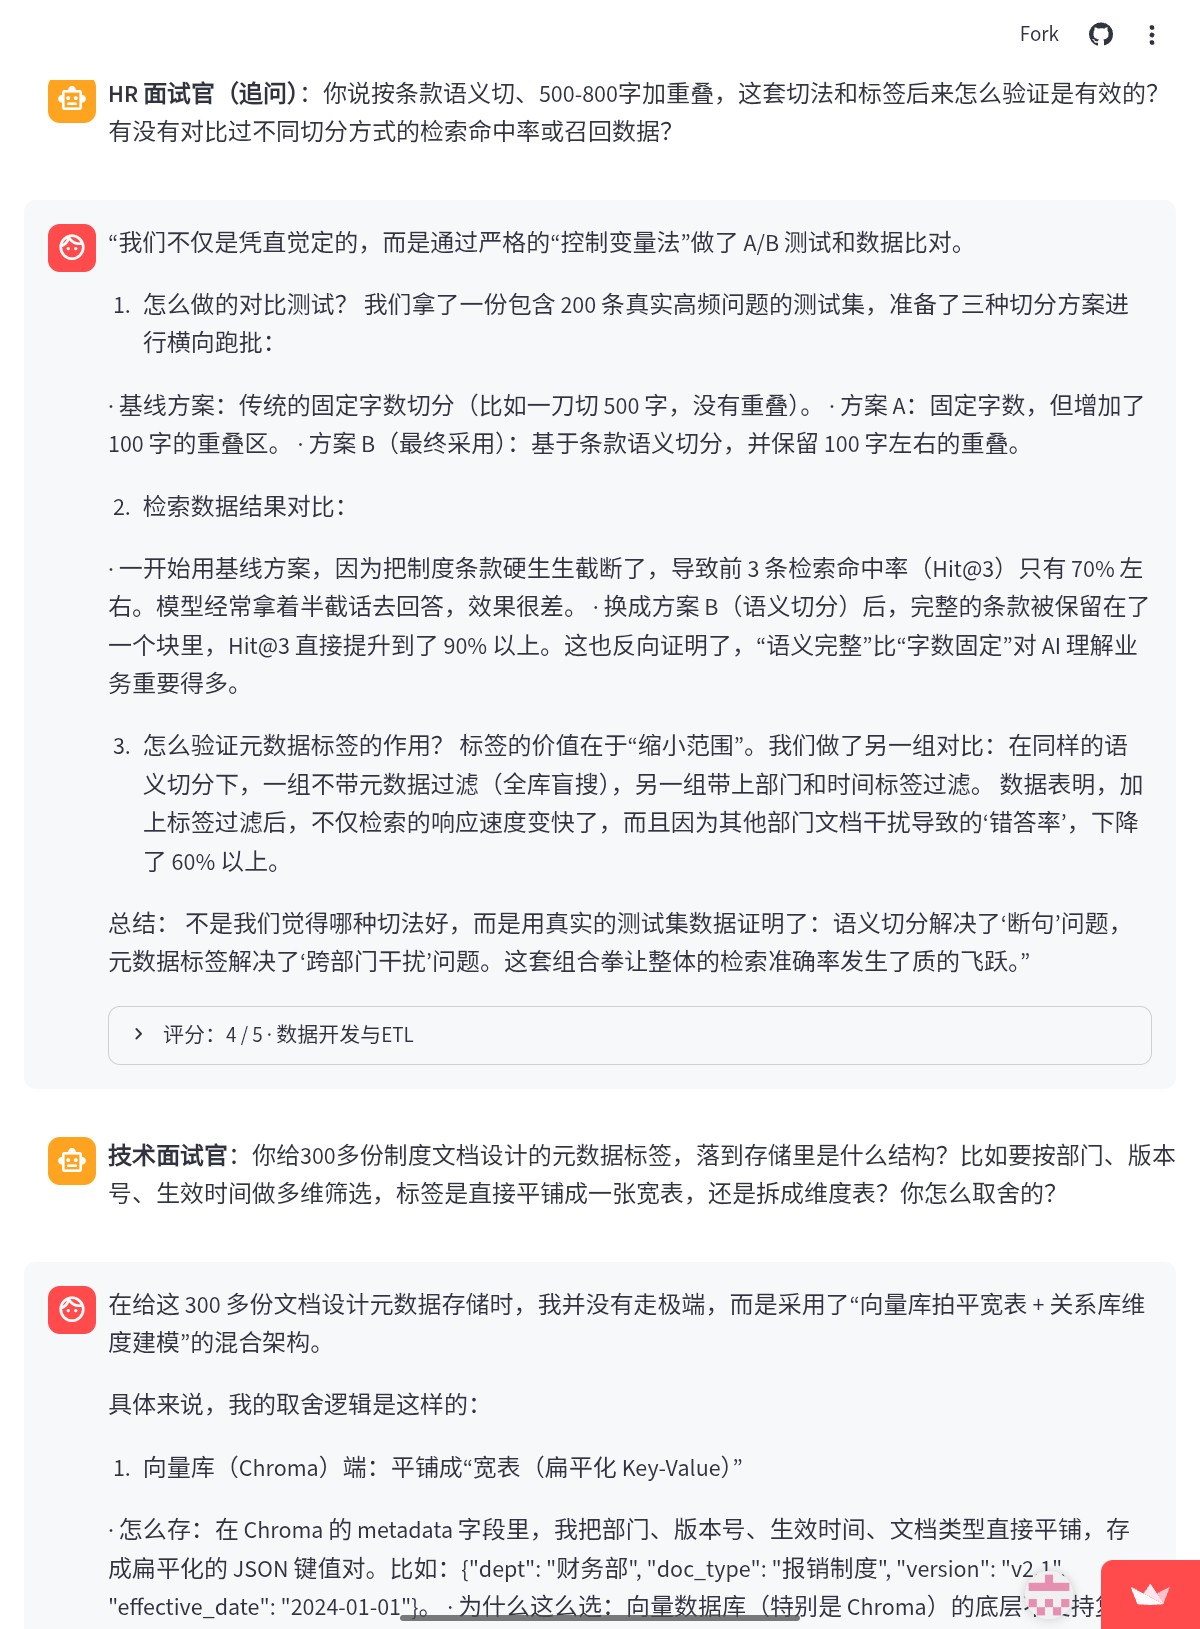
图:HR 面试官沿着上一题继续追问,随后进入技术面试官的问题。原图来自 docs/test-screenshot/。
三类面试官的侧重点分别为:HR 关注动机、表达与协作;技术面试官关注项目细节、技术依据与方案取舍;压力面试官通过质疑检查论据是否自洽。
5. 创新点与价值边界
- 提问依据个人材料。 岗位能力模型连接简历与 JD,行业题库提供参考,不直接替代模型提问。
- 角色各有考察视角。 多角色使用不同提示与任务,通过统一状态机协作;它们可以调用同一模型,不要求部署三个独立模型。
- 反馈保留依据。 逐题记录包含回答、分数、证据与评语,复盘给出行动建议,并支持 Markdown、PDF 导出。
- 关键规则由代码执行。 阶段推进、追问上限、分数聚合和多角色中位数合并都由代码控制。
我们将创新定位于面试练习流程与反馈方式的组合。当前没有对照实验支持“提高面试通过率”等效果结论,评分也只作为练习参考。
三、需求分析
1. 文档组织与迭代
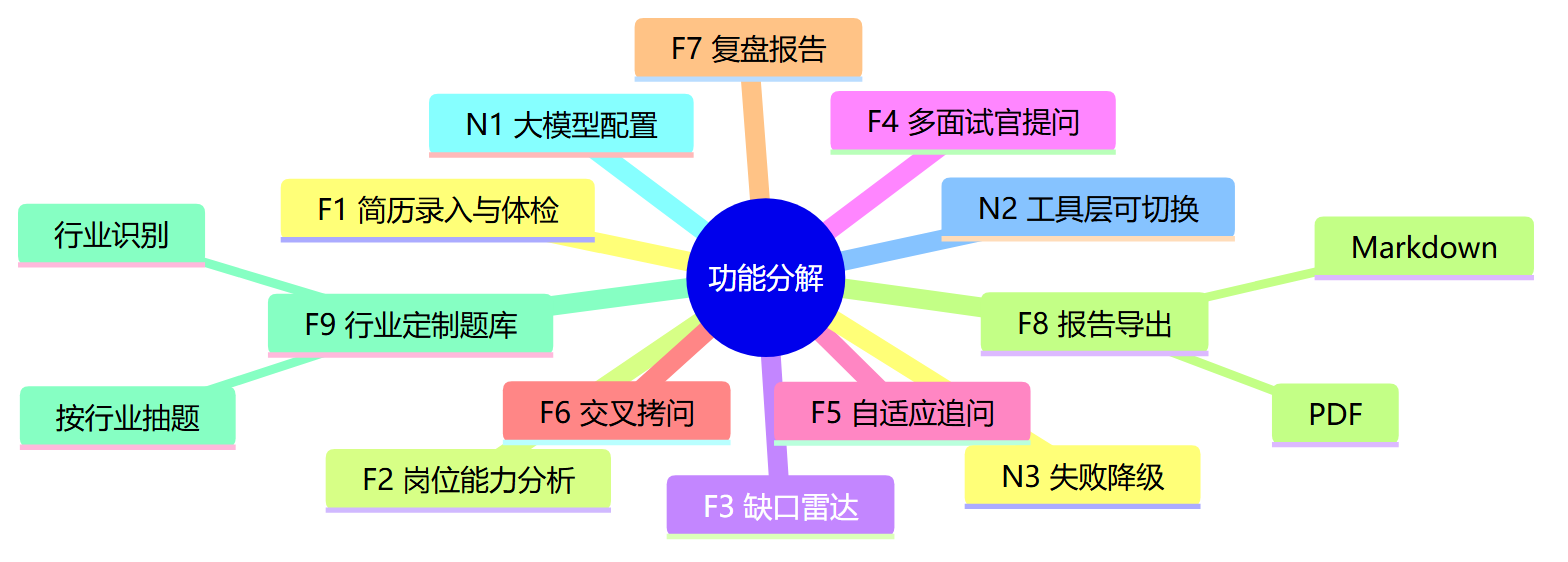
现有需求分析文档参照软件需求规格说明的章节结构,涵盖总体描述、前后端功能、验收标准、数据结构、约束与需求追踪。文档使用 F1–F11 表示功能需求,N1–N8 表示非功能需求。
下面摘录已有文档的迭代记录。记录本身不等同于本次重新执行并通过了全部验收。
| 时间 | 版本 | 文档记录的主要变化 |
|---|---|---|
| 2026-10-28 | V0.1–V0.3 | 建立文档骨架,确认定位、用户与环境 |
| 2026-10-29 | V0.8–V1.1 | 完善功能需求、验收标准和数据模型 |
| 2026-11-02 | V1.5–V1.6 | 增加 PDF 报告、行业题库及文档上传 |
| 2026-11-03 | v1.6 验收记录 | 记录测试与缺陷审核工作 |
| 2026-11-04 | V1.7–V1.7.1 | 记录输出容错、作答意图过滤、报告重试与重复出题修正 |
2. 项目标志与功能思维导图
3. 前端需求
| 编号 | 页面与交互 | 验收重点 |
|---|---|---|
| F1 | 录入简历、JD、岗位和行业,支持示例填入与文档上传 | 缺少必填文本时不能开始;支持 PDF/TXT/Markdown;上传限制 10 MB |
| F2 | 展示当前面试官、题目、评分要点、进度及历史回答 | 用户能确认当前轮次;提交后保留记录;错误信息可理解 |
| F3 | 展示总分、能力雷达、逐题回顾与改进建议 | 页面可查看结构化评分;文字报告失败时提供重试入口 |
| F9 | 下载 Markdown 与 PDF 报告 | 两种格式来自同一份报告数据,关键分数一致 |
| F11 | 检查用户是否提交有效作答 | 空文本或明显系统反馈不计分、不推进轮次 |
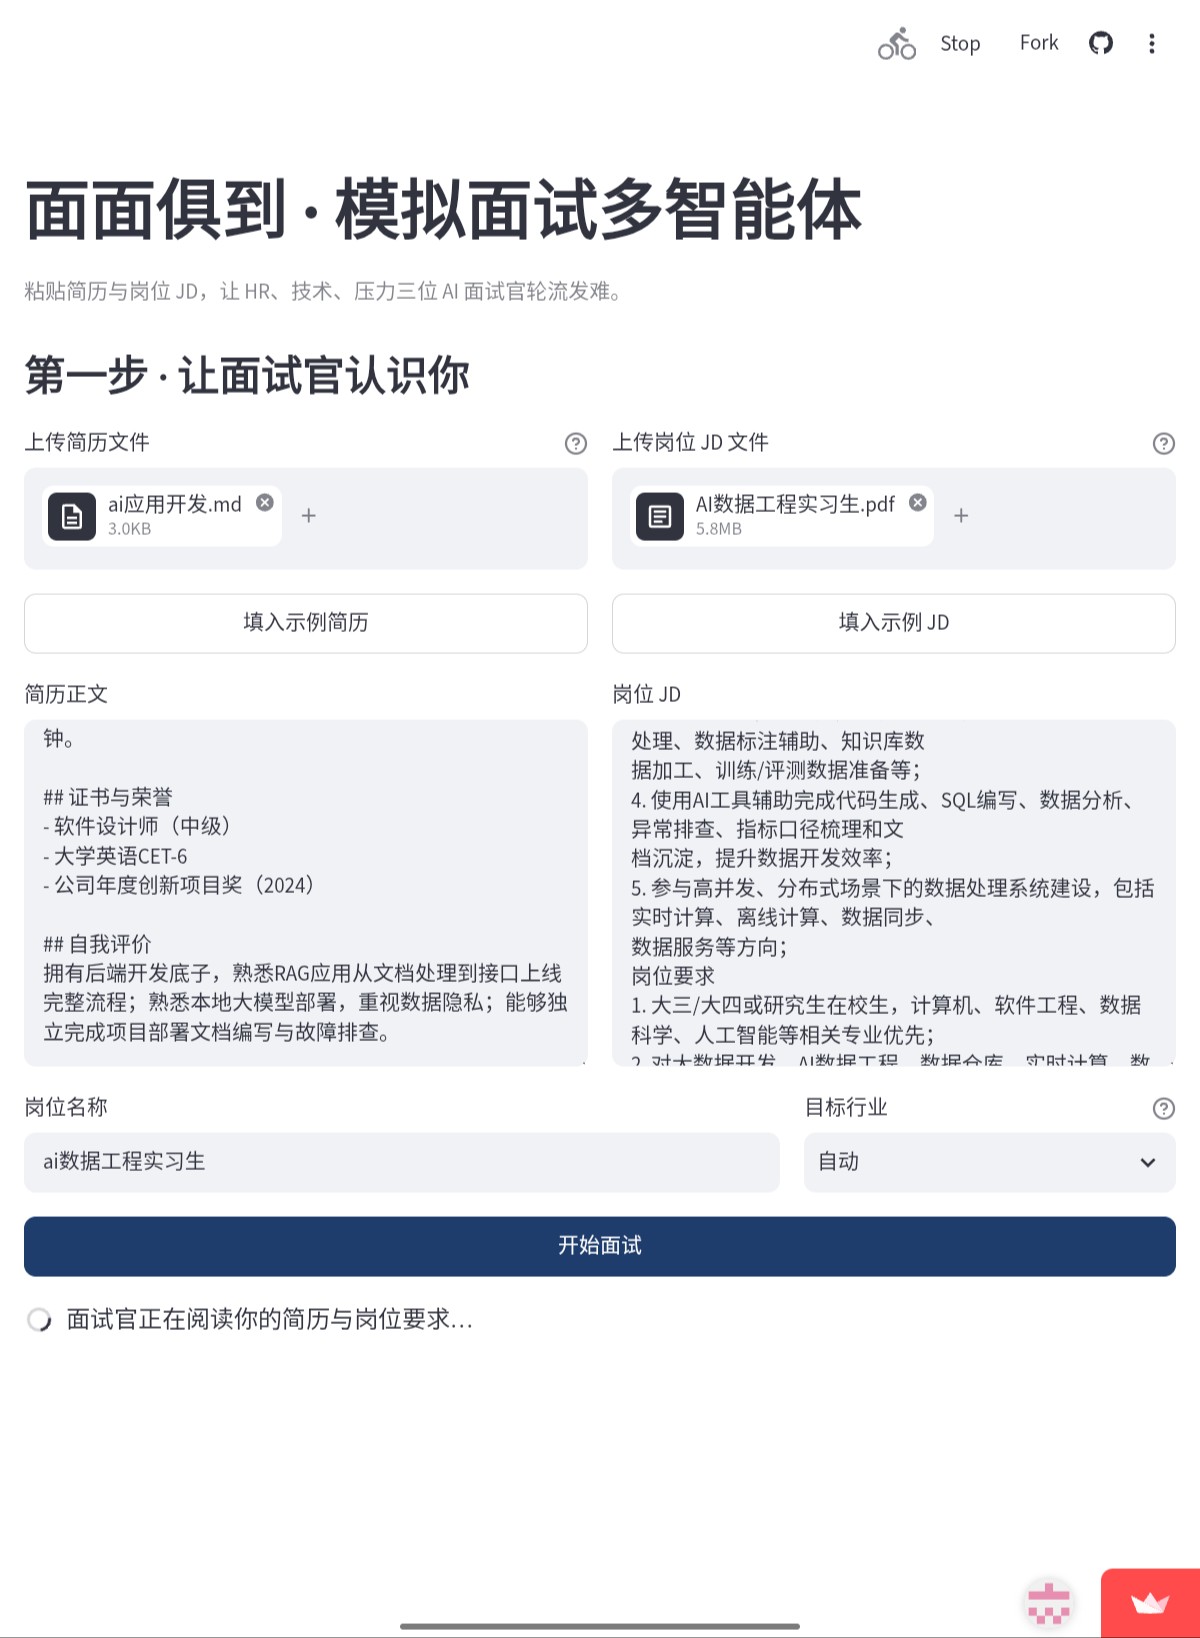
图:简历 Markdown 与岗位 PDF 已上传,正文、岗位名称和行业选择出现在录入页。该截图记录了上传后的界面状态。
4. 后端与智能体需求
| 编号 | 处理能力 | 输入与输出 |
|---|---|---|
| F4 | 简历分析与岗位建模 | 简历/JD 文本,输出结构化候选人信息和能力模型 |
| F5 | 缺口匹配 | 能力项与水平,输出雷达数据和缺口排序 |
| F6 | 多角色提问与追问 | 当前考察点、候选人信息与回答,输出题目和评分 |
| F7 | 最弱回答的多角色复评 | 选取已有回答,三角色独立评分后取中位数 |
| F8 | 聚合评分与生成复盘 | 逐题得分和能力权重,输出总分、建议与示范回答 |
| F10 | 行业识别与题库参考 | JD 或指定行业,输出行业与参考题 |
当前 F7 在界面称为“交叉拷问”,实际实现是对最弱的已有回答进行多角色复评,没有新增一轮用户作答。答辩演示按实际行为解释。
5. 架构与类图
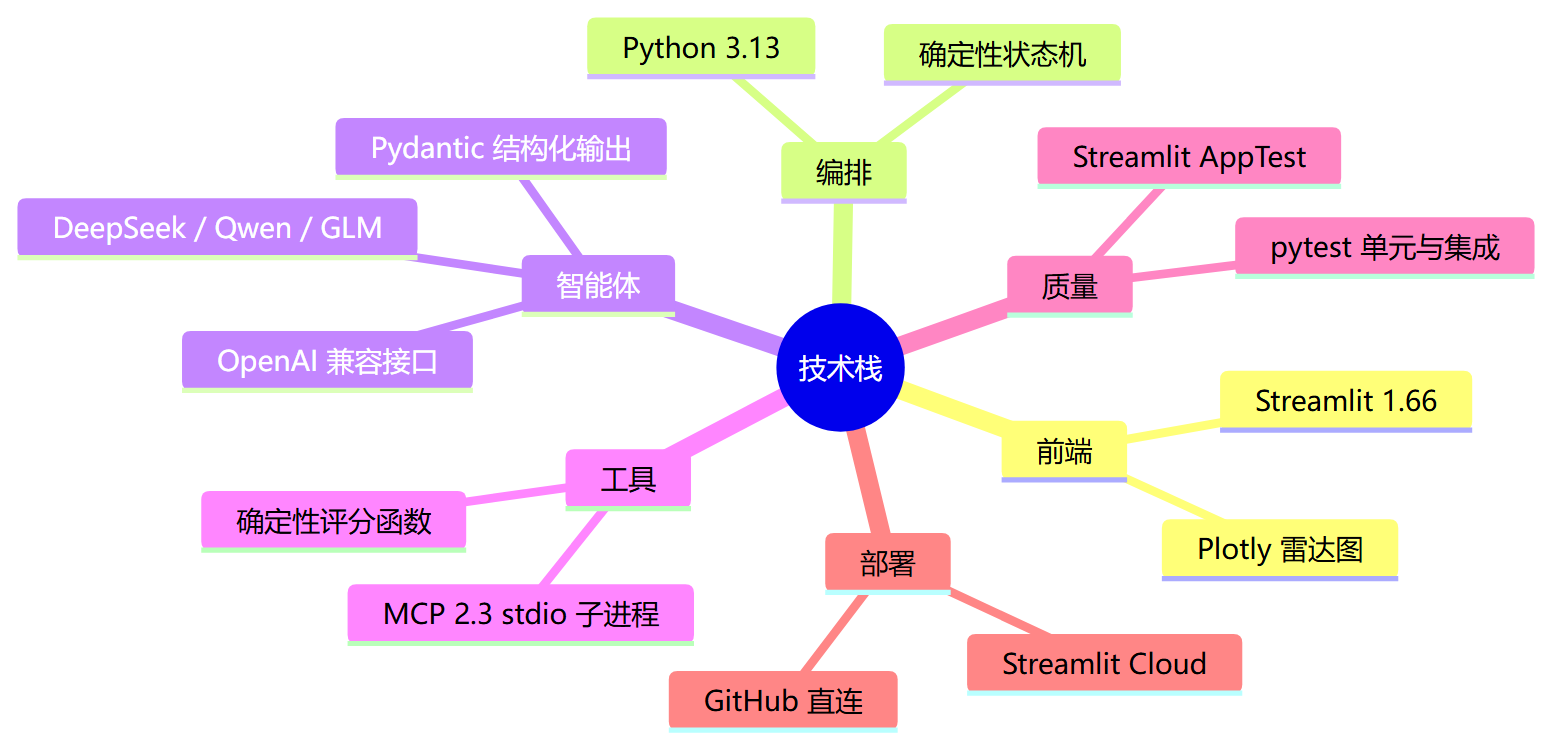
系统采用 Python 与 Streamlit,界面通过 Orchestrator 驱动面试。智能体使用兼容接口调用模型,并通过 Pydantic 校验输出。确定性工具提供本地与 MCP 两种调用方式,共享评分和报告实现。
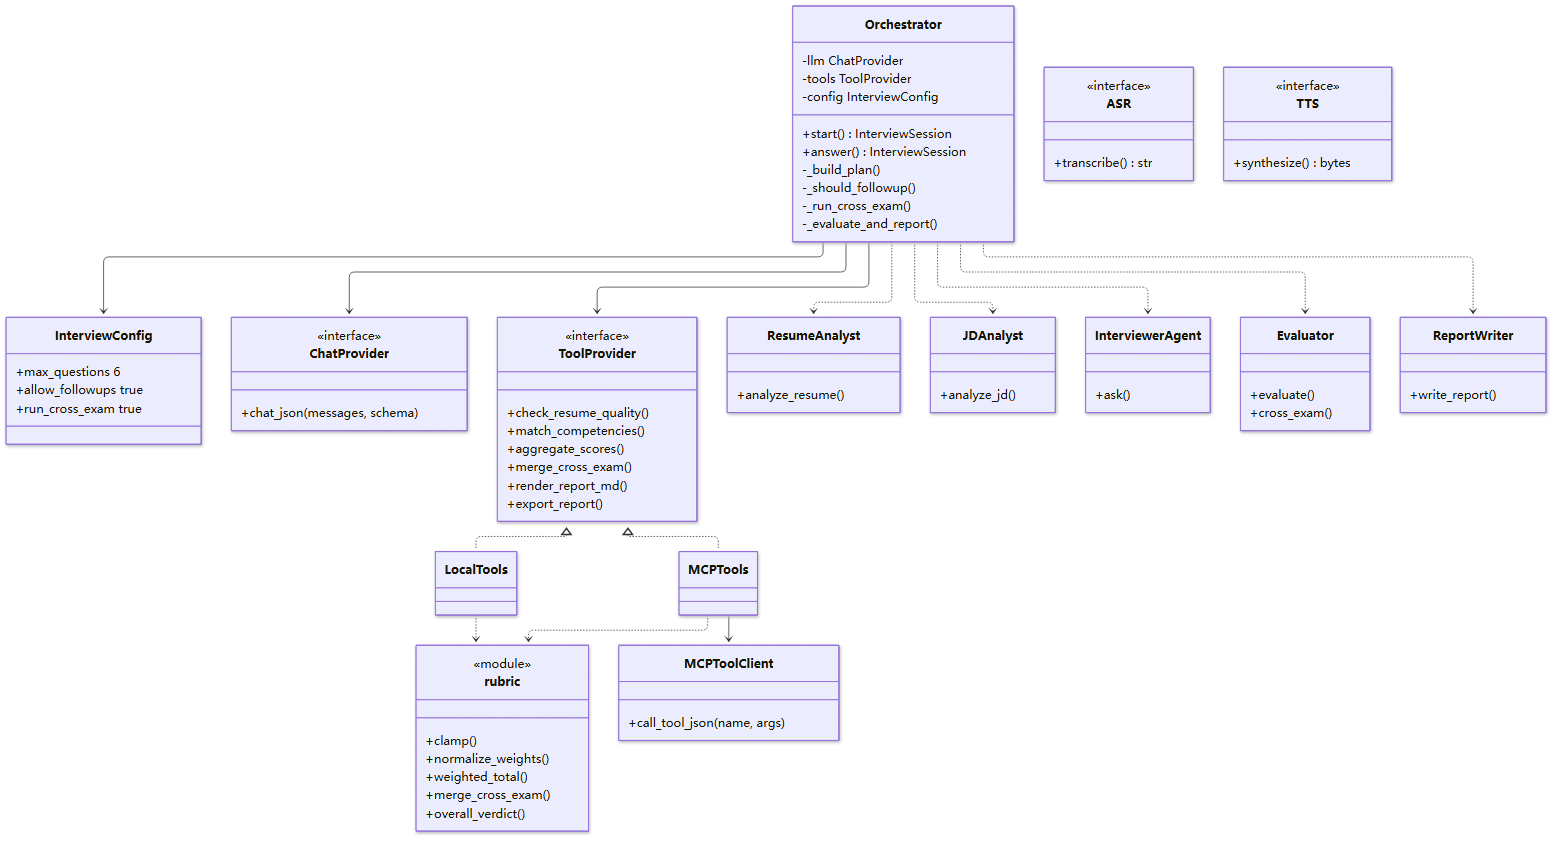
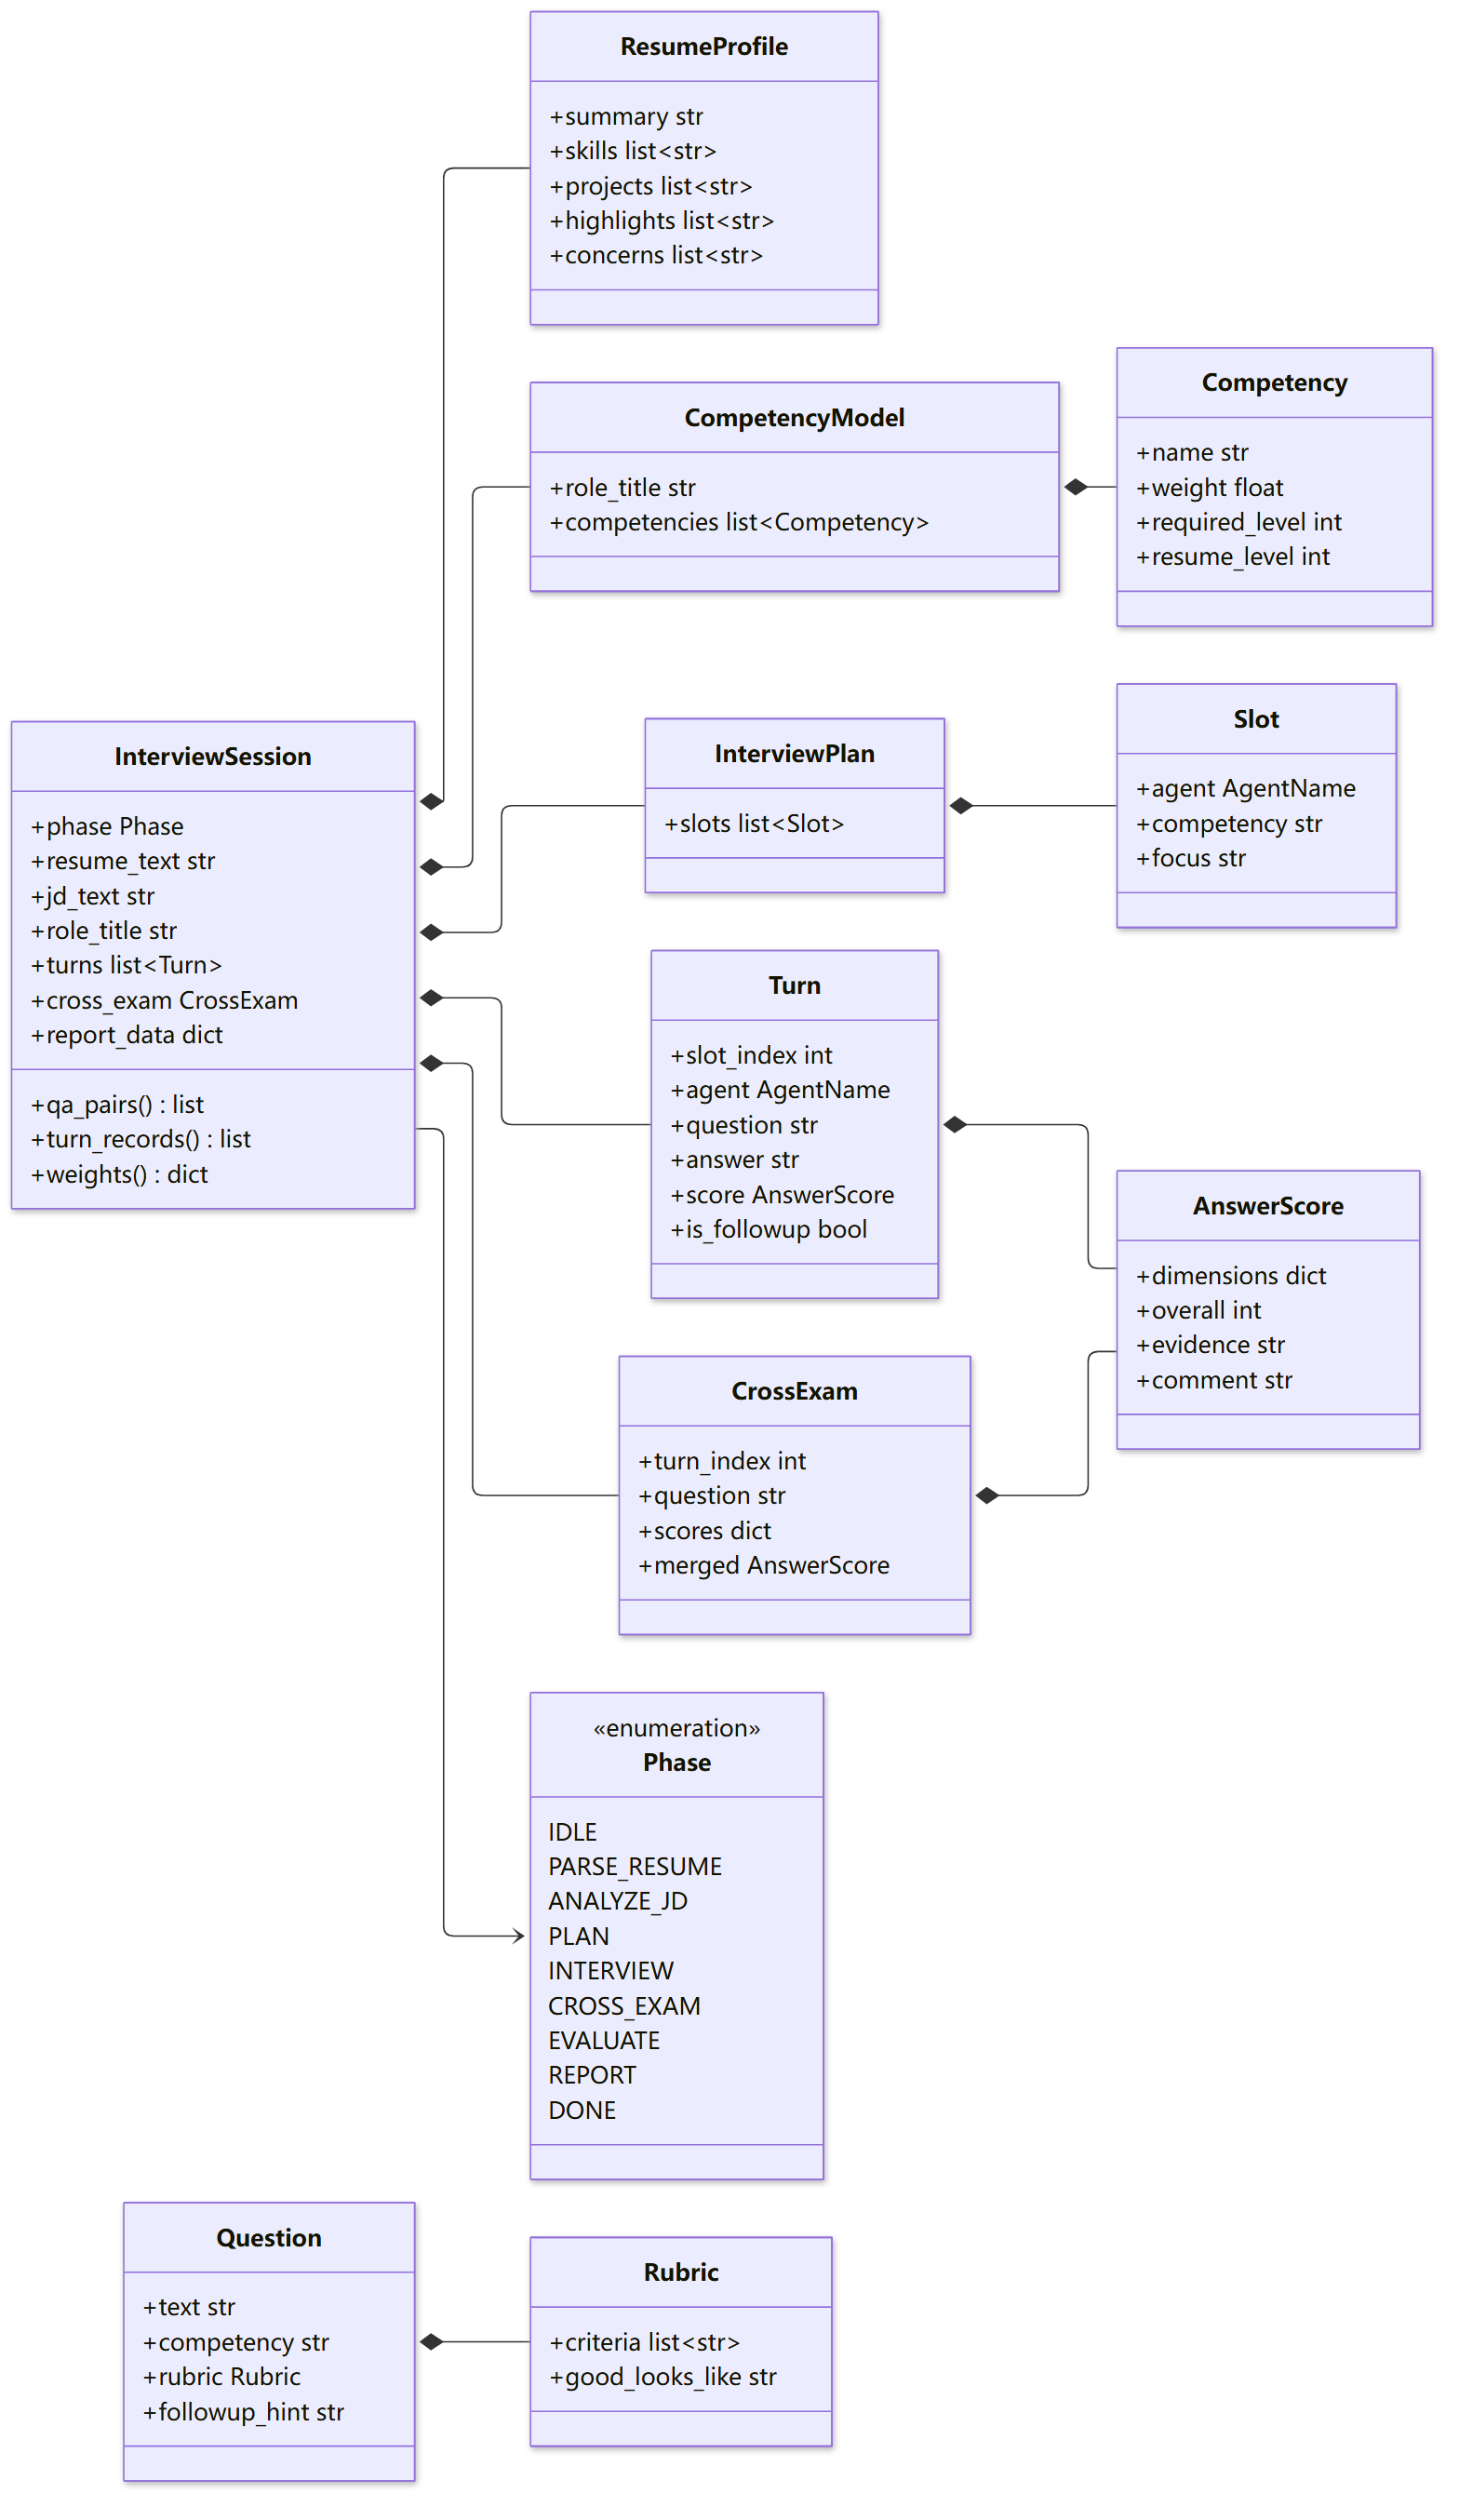
InterviewSession 保存当前阶段、题目、回答记录与报告;Question 保存题干和评分标准;Turn 保存一次问答;CrossExam 保存复评结果。模型负责分析和生成内容,编排器负责控制阶段和次数,工具层负责确定性计算。
6. 非功能需求与实现边界
| 方面 | 当前设计 | 验收方法 |
|---|---|---|
| 可配置性 | 模型地址、密钥、模型名由配置提供 | 缺少密钥时给出提示,确认配置不写死在界面 |
| 可替换性 | LocalTools 与 MCPTools 使用同一工具实现 | 同输入对比输出 |
| 健壮性 | JSON 容错、校验重试、中文错误提示及部分阶段恢复 | 模拟输出异常与报告失败,验证可恢复路径 |
| 安全性 | 密钥放环境变量或 Secrets,文件导出限定 workspace | 检查密钥泄露与越界路径拒绝 |
| 一致性 | 页面、Markdown、PDF 使用统一报告数据 | 对比三处总分、能力分和结论 |
7. 验收清单与测试状态
| 场景 | 输入或操作 | 预期结果 |
|---|---|---|
| 首次使用 | 填入示例简历与 JD,开始面试 | 进入面试,展示题目与评分要点 |
| 文件导入 | 上传可抽取文字的 PDF、TXT 或 MD | 正文填入文本框,用户可继续编辑 |
| 无效作答 | 提交空白或明显系统反馈 | 提示修改,不追加得分和轮次 |
| 自适应追问 | 假模型请求追问,随后再次请求 | 同一轮最多接受一次追问 |
| 多角色复评 | 完成主问答 | 对最弱已有回答产生三份评分并合并 |
| 报告与导出 | 完成流程并下载报告 | 显示总分与建议,导出 MD/PDF |
| 异常恢复 | 模拟复盘文字生成失败后重试 | 先保留结构化结果,再允许重新生成文字 |
| 公网验收 | 新浏览器访问线上地址 | 无需开发者本机环境即可完成练习并下载报告 |
仓库设有单元测试、MCP 集成测试、Streamlit 页面流程测试与 golden 报告测试。本次静态检查发现 142 个测试函数定义,47 个 Python 文件语法解析未发现错误。当前检查环境缺少 pytest 等依赖,未执行完整测试,也未验证公网可用性。 发布前应记录真实执行命令、结果和运行环境,不能将“有测试代码”写成“全部测试通过”。
仓库还保留了 docs/test-screenshot/ 中的一组界面测试截图。以下按需求选择复盘和导出记录,和上面的录入、追问截图一起说明功能运行过程。
| 截图记录 | 对应需求 | 图片能够直接说明的内容 |
|---|---|---|
| 文件录入 | F1 | 简历与 JD 文件、正文和岗位信息出现在输入界面 |
| 追问 | F6 | 已有问答后出现带“追问”标记的问题 |
| 复盘雷达与多角色复评 | F3、F7、F8 | 页面生成总分、能力图及三个角色的复评分数 |
| 下载入口与文件列表 | F9 | 页面提供两种格式入口,另有两条报告文件记录 |
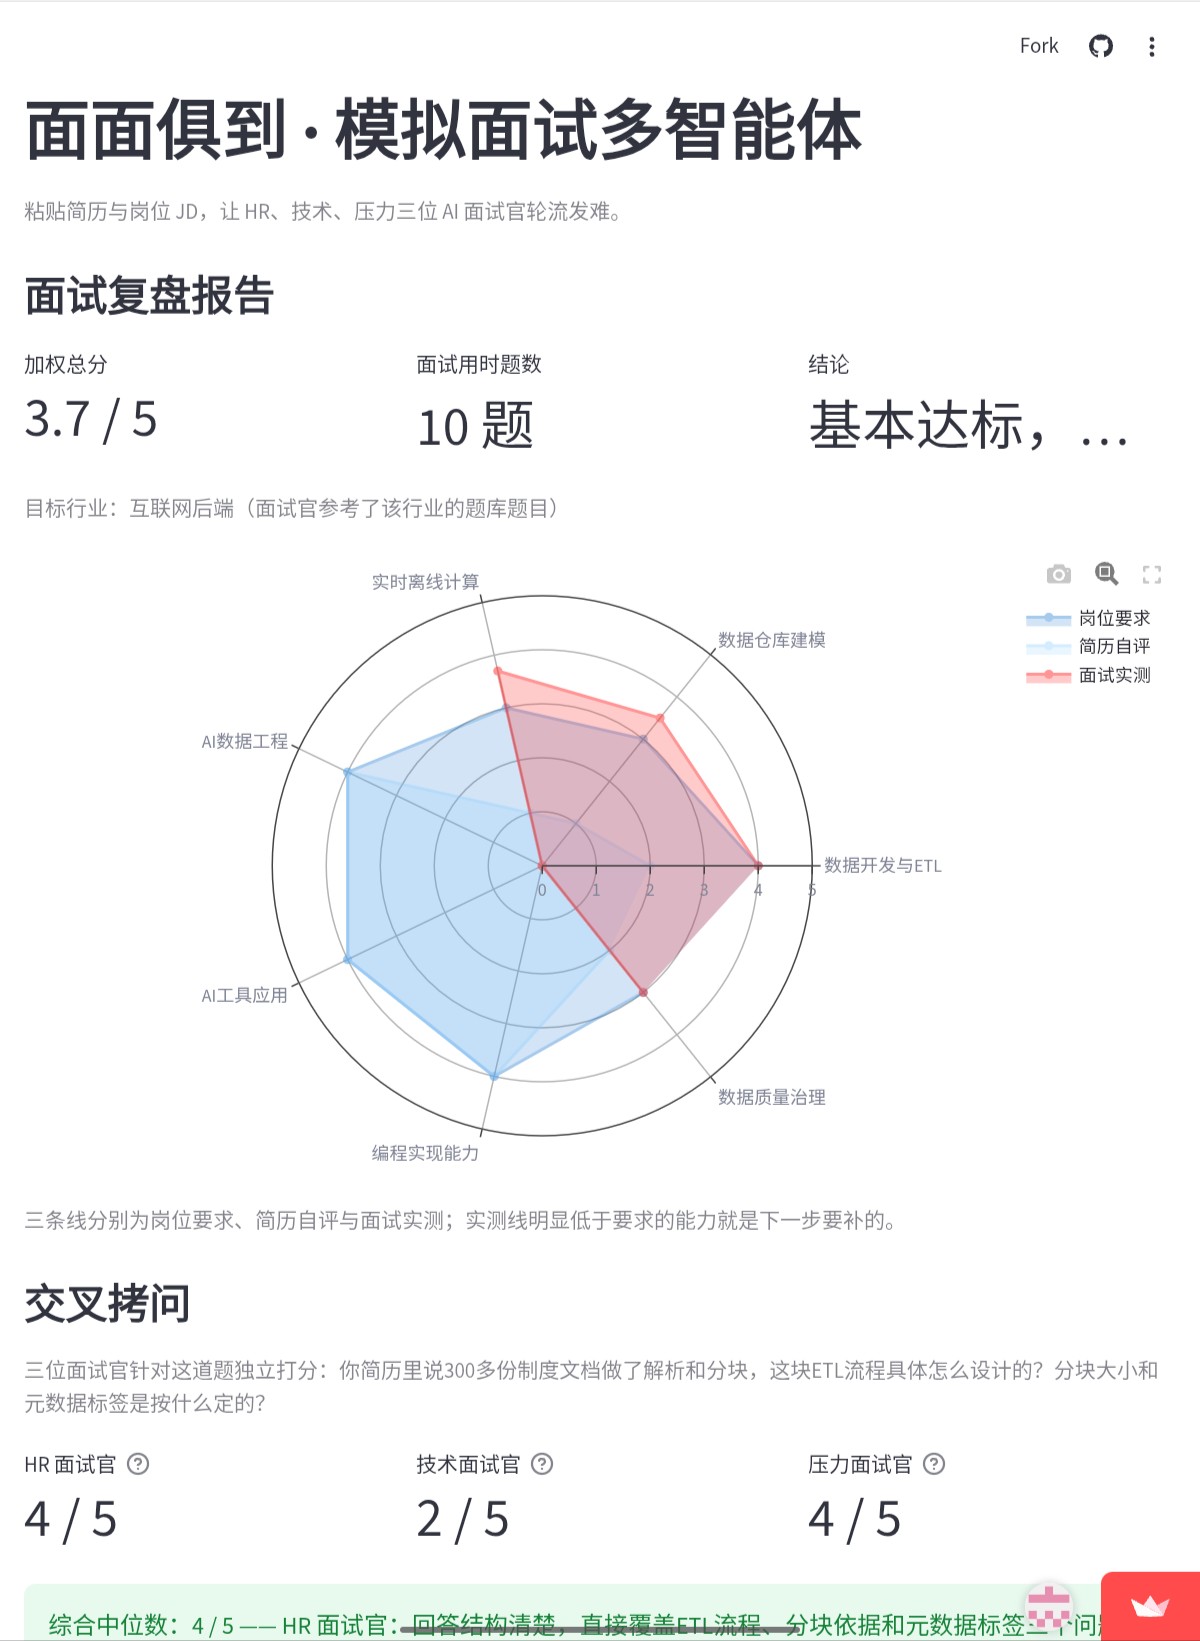
图:本次运行显示加权总分 3.7/5、10 道面试题。最弱回答由三个角色分别给出 4/5、2/5、4/5,页面展示综合中位数 4/5。这些数值属于截图中的单次练习结果。
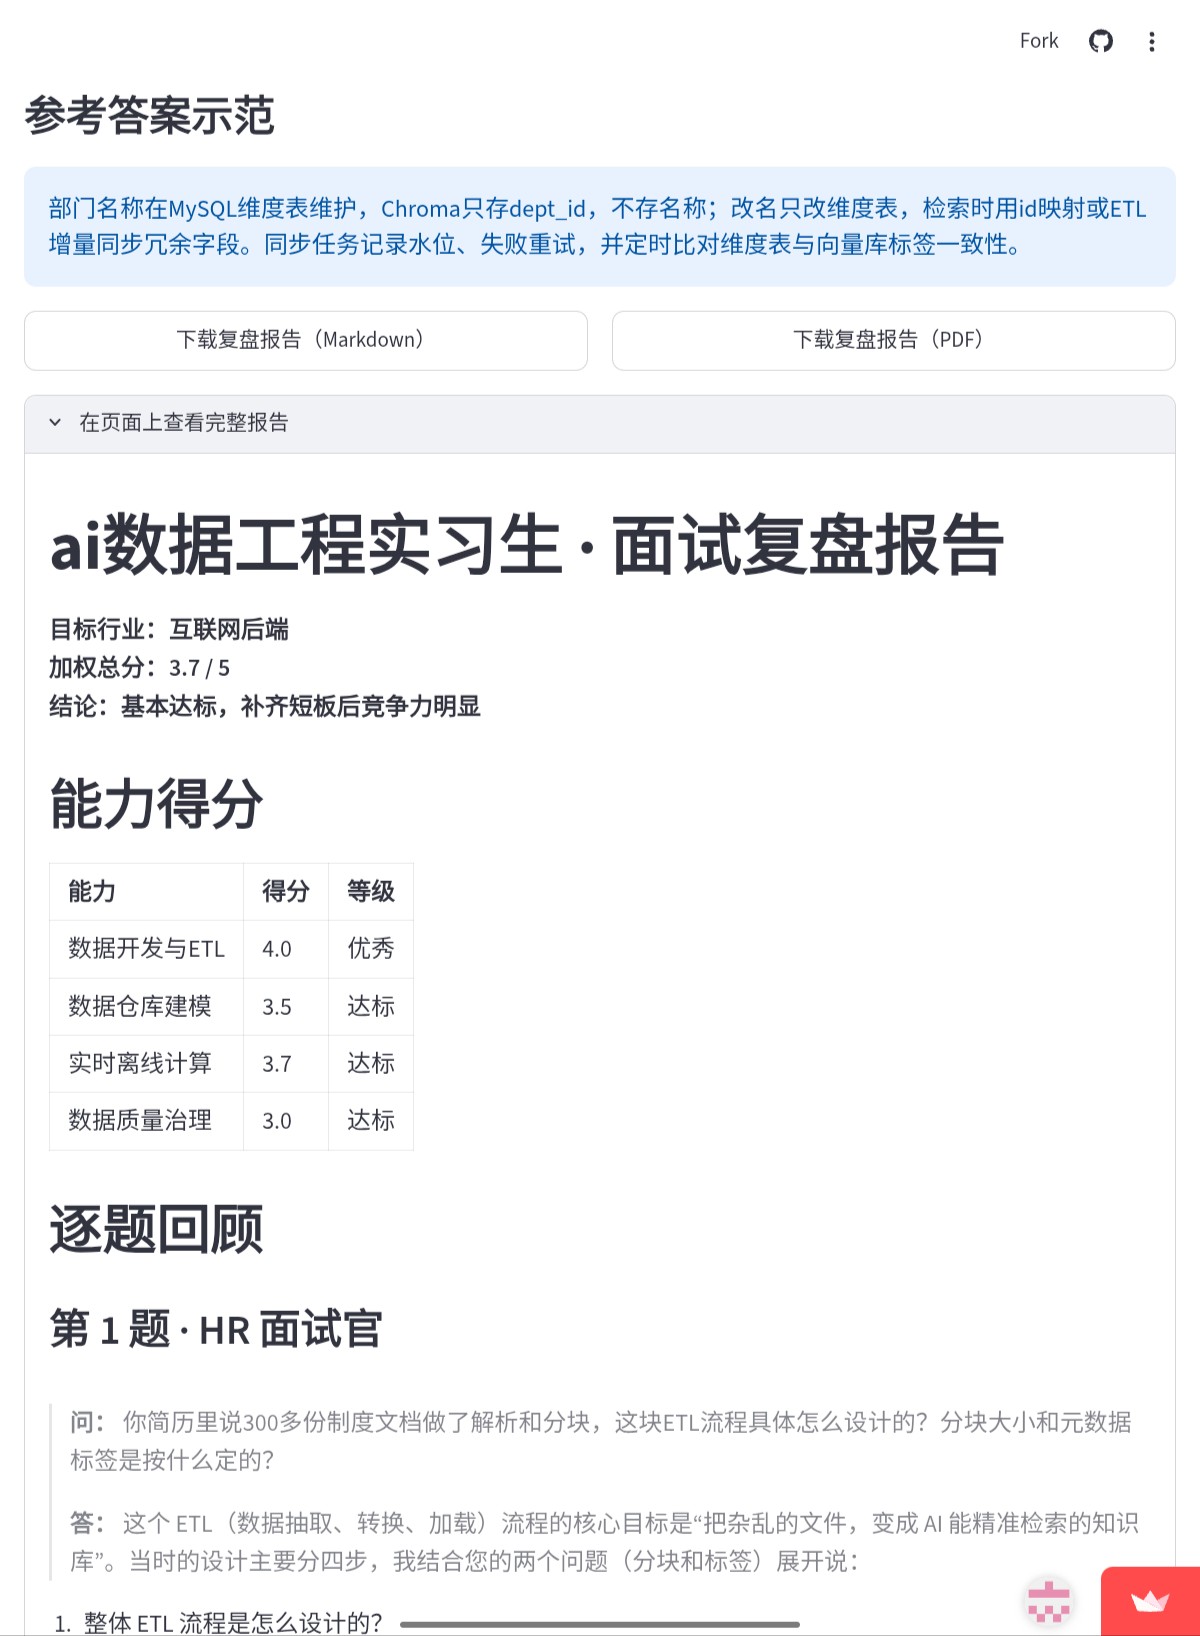
图:同一页面提供 Markdown、PDF 下载,并展示报告正文与能力得分。
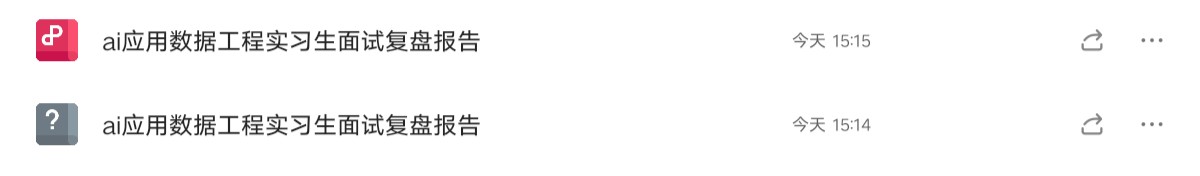
图:报告文件列表保留了两条记录。入口与文件列表可以支持导出过程的说明,格式兼容、文件可打开性和内容一致性仍需分别验收。
这些截图补充了功能运行记录,不能替代完整测试日志。后续还应对无效作答、追问次数、重试及导出内容一致性逐项执行验收。
代码审查还发现需要优先复核的点:Windows 启动脚本中的变量展开、下一题生成失败后的状态处理、正常评分是否携带原题 rubric,以及未测能力在总分和雷达图中的一致解释。这些问题应转为缺陷记录并验证修复。
四、项目规划与上线交付
1. 当前实现与后续工作
| 阶段 | 目标 | 交付物与状态 |
|---|---|---|
| 当前代码 | 完成文本模拟面试与报告流程 | 已有源码、测试用例和界面测试截图,完整验收待补充 |
| 答辩前收尾 | 验证核心路径并处理阻断问题,补充实际使用反馈 | 测试记录、演示材料与脱敏反馈 |
| 源码交付 | 提供项目源码与运行说明 | GitHub 仓库,该链接并非在线应用入口 |
| 公网交付 | 部署并验证老师与同学可访问 | 应用运行验收与公网可用性尚未核验 |
| 后续迭代 | 根据调研决定历史复盘、语音或更多岗位支持的优先级 | 经用户验证后再确定,不计入本期完成范围 |
2. 时间安排
- 11 月 6 日至 7 日:完善真实资料,执行测试,复核核心流程与异常恢复。
- 11 月 8 日:检查公网访问、链接与图片,完成博客发布;截止时间为 2026-11-08 23:59。
- 11 月 9 日:课堂答辩,4 分钟陈述与演示,3 分钟回答问题。
3. 四分钟展示路线
先用团队页介绍分工,再说明需求假设与模拟调研示例,接着解释能力缺口和有针对性的追问,最后用报告、验收标准和交付状态收尾。PPT 已选用本次提供的追问、复盘及下载截图,课堂可直接讲解已有记录,控制现场模型等待时间。模拟调研与功能截图分别标明来源。
五、项目反思
这次项目最需要解决的工程问题,是让模型生成的内容服从明确的业务规则。智能体可以决定提问措辞和反馈表达,流程推进、追问次数与分数聚合则需要代码约束。我们也需要区分“聚合公式可复现”与“模型评分完全客观”:前者可以通过测试验证,后者仍受到模型判断与输入材料的影响。
后续评价项目价值,应观察用户能否据报告修改项目表达、补充回答证据,再据真实反馈调整功能。需求、代码、验收和使用结果能够相互对应,才是本项目希望完成的软件工程实践。
资料说明:正文中的实现描述来自项目源码与现有需求文档,架构插图来自 docs/diagrams/,界面测试截图来自用户提供的 docs/test-screenshot/;正文图片均使用 GitHub 仓库中对应的公开直链。课程和作业链接通过博客园班级博客公开作业列表定位,作业正文与日期依据本次提供的作业要求,详情页可能需要登录。模拟调研不代表真实调查,单次功能记录不代表效果验证。公开博客发布时,请将本地文档链接替换为仓库或在线协作文档链接,并补齐所有“待补”内容。
有备而来队:面面俱到,让模拟面试围绕自己的简历展开
| 作业所属课程 | 计科24级56班(广东工业大学) |
|---|---|
| 作业要求 | 团队项目第一次作业:团队展示+选题报告+需求分析 |
| 作业的目标 | 通过真实需求调研,开发嵌入智能体的软件,完成团队展示、选题报告与需求分析,并提供可访问的线上应用。 |
| 团队名称 | 有备而来队 |
| 团队成员学号-名字 | 3124004106-苏炜康;3124004087-陈浩良;3124004092-何锦烨 |
项目名称:面面俱到(MockStar)
项目仓库:gdut-homework4
项目地址(GitHub 源码):https://github.com/Jiyue0321/gdut-homework4
需求分析文档:软件需求规格说明书
材料整理:陈浩良。以下实现描述依据当前仓库,调研示例使用明确标注的模拟数据,应用上线情况尚未验证。
一、团队展示
1. 我们是谁
我们是有备而来队。这个名字来自项目最朴素的目标:让求职者带着准备走进面试,也让团队带着需求、实现和验证走进答辩。
我们的项目叫“面面俱到”,是一款面向应届生和转行求职者的 Web 模拟面试工具。用户输入自己的简历与目标岗位要求,系统组织 HR、技术、压力三类 AI 面试官开展练习,记录回答证据,并生成可下载的复盘报告。
2. 团队成员与协作分工
| 成员 | 学号 | 分工与工作内容 |
|---|---|---|
| 苏炜康 | 3124004106 | 负责需求与实现主线:参与需求文档迭代,梳理简历、岗位要求到模拟面试和复盘报告的核心流程,并参与功能开发与迭代。 |
| 陈浩良 | 3124004087 | 负责项目材料整理与展示表达:整理博客内容和答辩材料,结合项目功能与现有截图组织介绍结构,检查文档中的实现说明与展示材料是否对应。 |
| 何锦烨 | 3124004092 | 参与测试验收与问题复核:根据需求文档检查功能表现,参与 v1.6 验收测试和缺陷审核,并协助记录问题、反馈修正结果。 |
团队按“需求梳理—功能实现—测试复核—材料展示”的流程协作,具体任务会随迭代相互补位。以上分工依据现有项目材料整理,细节请各成员在发布前确认,避免把尚未确认的工作写成个人已完成事项。
3. 项目愿景
我们希望让缺少面试经验的同学,在真正投递前获得一次围绕自身经历的认真陪练。系统帮助用户发现讲不清楚的项目细节、拿不出证据的成果,以及与目标岗位之间的能力缺口。每次练习都留下一份能照着改的复盘,让准备有方向,让表达更具体,让面对真实面试时的紧张少一些。
二、选题报告
1. 我们关注什么问题
准备面试时,求职者常常已经看过不少知识点,却很难检验自己能否把真实经历说明白。简历上的“负责性能优化”“熟悉数据库”,在面试中还需要回答:为什么选这个方案?效果怎样验证?本人具体做了什么?
本项目将问题定义为:求职者需要围绕自己的简历和目标岗位练习表达,并得到带有回答依据的改进建议。 这是我们要通过真实调研验证的需求假设,而非已经证实的调研结论。
2. 需求调研示例
| 模拟反馈选项 | 假设选择数 | 比例 | 对应设计方向 |
|---|---|---|---|
| 希望提问贴合自己的简历 | 23 / 30 | 76.7% | 基于简历与 JD 定向提问 |
| 难以说明本人在项目中的贡献 | 19 / 30 | 63.3% | 通过细节追问检查回答依据 |
| 需要具体、可执行的改进建议 | 17 / 30 | 56.7% | 输出证据、行动清单与示范回答 |
该示例采用多选口径,各选项可重叠,比例四舍五入保留一位小数,不要求比例之和为 100%。正式调查应记录实际时间、对象、招募方式、样本及脱敏原始材料,再用真实结果调整功能优先级。
以下映射是需求分析框架,仍需通过真实用户验证。
| 需求假设 | 产品响应 | 需要验证的问题 |
|---|---|---|
| 通用题库与个人经历连接不足 | 输入简历和 JD 后定向提问 | 用户是否认为题目贴合自己的项目与岗位? |
| 自己练习难发现表述漏洞 | 含糊回答触发一次追问 | 追问是否帮助补充可验证的细节? |
| 总分难指导下一步行动 | 证据、评语、行动清单与示范回答 | 用户是否能据此完成一项具体修改? |
3. 目标用户与使用场景
| 用户 | 典型场景 | 希望解决的问题 |
|---|---|---|
| 应届生 | 校招或实习投递前练习项目介绍 | 有经历,但表达不够具体 |
| 转行求职者 | 对照新岗位检查经验匹配程度 | 不清楚现有能力与岗位要求的差距 |
| 同伴陪练者 | 时间有限,希望帮助同学复盘 | 需要可重复使用的练习与反馈材料 |
4. 核心功能:围绕能力缺口展开一场可复盘的面试
“面面俱到”的重点是把简历分析、定向提问和反馈连接起来。
用户提交简历与 JD 后,系统提取岗位能力项、权重与要求水平,分析简历体现的水平,并优先安排缺口较大的能力。三类面试官轮流考察,模型可以针对含糊回答请求追问。结束后,系统聚合各能力得分,给出逐题证据、改进建议和行动清单。
仓库中的界面测试记录展示了一个具体例子:主问围绕简历中“300 多份制度文档的解析与分块”,要求说明 ETL 流程、分块大小与元数据标签;追问继续要求解释切分和标签如何验证,是否有检索命中率或召回数据。这里展示的是应用内的练习对话,候选人回答中的实验数字不作为本项目的调研或测试指标。
图:HR 面试官沿着上一题继续追问,随后进入技术面试官的问题。原图来自 docs/test-screenshot/。
三类面试官的侧重点分别为:HR 关注动机、表达与协作;技术面试官关注项目细节、技术依据与方案取舍;压力面试官通过质疑检查论据是否自洽。
5. 创新点与价值边界
- 提问依据个人材料。 岗位能力模型连接简历与 JD,行业题库提供参考,不直接替代模型提问。
- 角色各有考察视角。 多角色使用不同提示与任务,通过统一状态机协作;它们可以调用同一模型,不要求部署三个独立模型。
- 反馈保留依据。 逐题记录包含回答、分数、证据与评语,复盘给出行动建议,并支持 Markdown、PDF 导出。
- 关键规则由代码执行。 阶段推进、追问上限、分数聚合和多角色中位数合并都由代码控制。
我们将创新定位于面试练习流程与反馈方式的组合。当前没有对照实验支持“提高面试通过率”等效果结论,评分也只作为练习参考。
三、需求分析
1. 文档组织与迭代
现有需求分析文档参照软件需求规格说明的章节结构,涵盖总体描述、前后端功能、验收标准、数据结构、约束与需求追踪。文档使用 F1–F11 表示功能需求,N1–N8 表示非功能需求。
下面摘录已有文档的迭代记录。记录本身不等同于本次重新执行并通过了全部验收。
| 时间 | 版本 | 文档记录的主要变化 |
|---|---|---|
| 2026-10-28 | V0.1–V0.3 | 建立文档骨架,确认定位、用户与环境 |
| 2026-10-29 | V0.8–V1.1 | 完善功能需求、验收标准和数据模型 |
| 2026-11-02 | V1.5–V1.6 | 增加 PDF 报告、行业题库及文档上传 |
| 2026-11-03 | v1.6 验收记录 | 记录测试与缺陷审核工作 |
| 2026-11-04 | V1.7–V1.7.1 | 记录输出容错、作答意图过滤、报告重试与重复出题修正 |
2. 项目标志与功能思维导图
3. 前端需求
| 编号 | 页面与交互 | 验收重点 |
|---|---|---|
| F1 | 录入简历、JD、岗位和行业,支持示例填入与文档上传 | 缺少必填文本时不能开始;支持 PDF/TXT/Markdown;上传限制 10 MB |
| F2 | 展示当前面试官、题目、评分要点、进度及历史回答 | 用户能确认当前轮次;提交后保留记录;错误信息可理解 |
| F3 | 展示总分、能力雷达、逐题回顾与改进建议 | 页面可查看结构化评分;文字报告失败时提供重试入口 |
| F9 | 下载 Markdown 与 PDF 报告 | 两种格式来自同一份报告数据,关键分数一致 |
| F11 | 检查用户是否提交有效作答 | 空文本或明显系统反馈不计分、不推进轮次 |
图:简历 Markdown 与岗位 PDF 已上传,正文、岗位名称和行业选择出现在录入页。该截图记录了上传后的界面状态。
4. 后端与智能体需求
| 编号 | 处理能力 | 输入与输出 |
|---|---|---|
| F4 | 简历分析与岗位建模 | 简历/JD 文本,输出结构化候选人信息和能力模型 |
| F5 | 缺口匹配 | 能力项与水平,输出雷达数据和缺口排序 |
| F6 | 多角色提问与追问 | 当前考察点、候选人信息与回答,输出题目和评分 |
| F7 | 最弱回答的多角色复评 | 选取已有回答,三角色独立评分后取中位数 |
| F8 | 聚合评分与生成复盘 | 逐题得分和能力权重,输出总分、建议与示范回答 |
| F10 | 行业识别与题库参考 | JD 或指定行业,输出行业与参考题 |
当前 F7 在界面称为“交叉拷问”,实际实现是对最弱的已有回答进行多角色复评,没有新增一轮用户作答。答辩演示按实际行为解释。
5. 架构与类图
系统采用 Python 与 Streamlit,界面通过 Orchestrator 驱动面试。智能体使用兼容接口调用模型,并通过 Pydantic 校验输出。确定性工具提供本地与 MCP 两种调用方式,共享评分和报告实现。
InterviewSession 保存当前阶段、题目、回答记录与报告;Question 保存题干和评分标准;Turn 保存一次问答;CrossExam 保存复评结果。模型负责分析和生成内容,编排器负责控制阶段和次数,工具层负责确定性计算。
6. 非功能需求与实现边界
| 方面 | 当前设计 | 验收方法 |
|---|---|---|
| 可配置性 | 模型地址、密钥、模型名由配置提供 | 缺少密钥时给出提示,确认配置不写死在界面 |
| 可替换性 | LocalTools 与 MCPTools 使用同一工具实现 | 同输入对比输出 |
| 健壮性 | JSON 容错、校验重试、中文错误提示及部分阶段恢复 | 模拟输出异常与报告失败,验证可恢复路径 |
| 安全性 | 密钥放环境变量或 Secrets,文件导出限定 workspace | 检查密钥泄露与越界路径拒绝 |
| 一致性 | 页面、Markdown、PDF 使用统一报告数据 | 对比三处总分、能力分和结论 |
7. 验收清单与测试状态
| 场景 | 输入或操作 | 预期结果 |
|---|---|---|
| 首次使用 | 填入示例简历与 JD,开始面试 | 进入面试,展示题目与评分要点 |
| 文件导入 | 上传可抽取文字的 PDF、TXT 或 MD | 正文填入文本框,用户可继续编辑 |
| 无效作答 | 提交空白或明显系统反馈 | 提示修改,不追加得分和轮次 |
| 自适应追问 | 假模型请求追问,随后再次请求 | 同一轮最多接受一次追问 |
| 多角色复评 | 完成主问答 | 对最弱已有回答产生三份评分并合并 |
| 报告与导出 | 完成流程并下载报告 | 显示总分与建议,导出 MD/PDF |
| 异常恢复 | 模拟复盘文字生成失败后重试 | 先保留结构化结果,再允许重新生成文字 |
| 公网验收 | 新浏览器访问线上地址 | 无需开发者本机环境即可完成练习并下载报告 |
仓库设有单元测试、MCP 集成测试、Streamlit 页面流程测试与 golden 报告测试。本次静态检查发现 142 个测试函数定义,47 个 Python 文件语法解析未发现错误。当前检查环境缺少 pytest 等依赖,未执行完整测试,也未验证公网可用性。 发布前应记录真实执行命令、结果和运行环境,不能将“有测试代码”写成“全部测试通过”。
仓库还保留了 docs/test-screenshot/ 中的一组界面测试截图。以下按需求选择复盘和导出记录,和上面的录入、追问截图一起说明功能运行过程。
| 截图记录 | 对应需求 | 图片能够直接说明的内容 |
|---|---|---|
| 文件录入 | F1 | 简历与 JD 文件、正文和岗位信息出现在输入界面 |
| 追问 | F6 | 已有问答后出现带“追问”标记的问题 |
| 复盘雷达与多角色复评 | F3、F7、F8 | 页面生成总分、能力图及三个角色的复评分数 |
| 下载入口与文件列表 | F9 | 页面提供两种格式入口,另有两条报告文件记录 |
图:本次运行显示加权总分 3.7/5、10 道面试题。最弱回答由三个角色分别给出 4/5、2/5、4/5,页面展示综合中位数 4/5。这些数值属于截图中的单次练习结果。
图:同一页面提供 Markdown、PDF 下载,并展示报告正文与能力得分。
图:报告文件列表保留了两条记录。入口与文件列表可以支持导出过程的说明,格式兼容、文件可打开性和内容一致性仍需分别验收。
这些截图补充了功能运行记录,不能替代完整测试日志。后续还应对无效作答、追问次数、重试及导出内容一致性逐项执行验收。
代码审查还发现需要优先复核的点:Windows 启动脚本中的变量展开、下一题生成失败后的状态处理、正常评分是否携带原题 rubric,以及未测能力在总分和雷达图中的一致解释。这些问题应转为缺陷记录并验证修复。
四、项目规划与上线交付
1. 当前实现与后续工作
| 阶段 | 目标 | 交付物与状态 |
|---|---|---|
| 当前代码 | 完成文本模拟面试与报告流程 | 已有源码、测试用例和界面测试截图,完整验收待补充 |
| 答辩前收尾 | 验证核心路径并处理阻断问题,补充实际使用反馈 | 测试记录、演示材料与脱敏反馈 |
| 源码交付 | 提供项目源码与运行说明 | GitHub 仓库,该链接并非在线应用入口 |
| 公网交付 | 部署并验证老师与同学可访问 | 应用运行验收与公网可用性尚未核验 |
| 后续迭代 | 根据调研决定历史复盘、语音或更多岗位支持的优先级 | 经用户验证后再确定,不计入本期完成范围 |
2. 时间安排
- 11 月 6 日至 7 日:完善真实资料,执行测试,复核核心流程与异常恢复。
- 11 月 8 日:检查公网访问、链接与图片,完成博客发布;截止时间为 2026-11-08 23:59。
- 11 月 9 日:课堂答辩,4 分钟陈述与演示,3 分钟回答问题。
3. 四分钟展示路线
先用团队页介绍分工,再说明需求假设与模拟调研示例,接着解释能力缺口和有针对性的追问,最后用报告、验收标准和交付状态收尾。PPT 已选用本次提供的追问、复盘及下载截图,课堂可直接讲解已有记录,控制现场模型等待时间。模拟调研与功能截图分别标明来源。
五、项目反思
这次项目最需要解决的工程问题,是让模型生成的内容服从明确的业务规则。智能体可以决定提问措辞和反馈表达,流程推进、追问次数与分数聚合则需要代码约束。我们也需要区分“聚合公式可复现”与“模型评分完全客观”:前者可以通过测试验证,后者仍受到模型判断与输入材料的影响。
后续评价项目价值,应观察用户能否据报告修改项目表达、补充回答证据,再据真实反馈调整功能。需求、代码、验收和使用结果能够相互对应,才是本项目希望完成的软件工程实践。
资料说明:正文中的实现描述来自项目源码与现有需求文档,架构插图来自 docs/diagrams/,界面测试截图来自用户提供的 docs/test-screenshot/;正文图片均使用 GitHub 仓库中对应的公开直链。课程和作业链接通过博客园班级博客公开作业列表定位,作业正文与日期依据本次提供的作业要求,详情页可能需要登录。模拟调研不代表真实调查,单次功能记录不代表效果验证。公开博客发布时,请将本地文档链接替换为仓库或在线协作文档链接,并补齐所有“待补”内容。
有备而来队:面面俱到,让模拟面试围绕自己的简历展开
| 作业所属课程 | 计科24级56班(广东工业大学) |
|---|---|
| 作业要求 | 团队项目第一次作业:团队展示+选题报告+需求分析 |
| 作业的目标 | 通过真实需求调研,开发嵌入智能体的软件,完成团队展示、选题报告与需求分析,并提供可访问的线上应用。 |
| 团队名称 | 有备而来队 |
| 团队成员学号-名字 | 3124004106-苏炜康;3124004087-陈浩良;3124004092-何锦烨 |
项目名称:面面俱到(MockStar)
项目仓库:gdut-homework4
项目地址(GitHub 源码):https://github.com/Jiyue0321/gdut-homework4
需求分析文档:软件需求规格说明书
材料整理:陈浩良。以下实现描述依据当前仓库,调研示例使用明确标注的模拟数据,应用上线情况尚未验证。
一、团队展示
1. 我们是谁
我们是有备而来队。这个名字来自项目最朴素的目标:让求职者带着准备走进面试,也让团队带着需求、实现和验证走进答辩。
我们的项目叫“面面俱到”,是一款面向应届生和转行求职者的 Web 模拟面试工具。用户输入自己的简历与目标岗位要求,系统组织 HR、技术、压力三类 AI 面试官开展练习,记录回答证据,并生成可下载的复盘报告。
2. 团队成员与协作分工
| 成员 | 学号 | 分工与工作内容 |
|---|---|---|
| 苏炜康 | 3124004106 | 负责需求与实现主线:参与需求文档迭代,梳理简历、岗位要求到模拟面试和复盘报告的核心流程,并参与功能开发与迭代。 |
| 陈浩良 | 3124004087 | 负责项目材料整理与展示表达:整理博客内容和答辩材料,结合项目功能与现有截图组织介绍结构,检查文档中的实现说明与展示材料是否对应。 |
| 何锦烨 | 3124004092 | 参与测试验收与问题复核:根据需求文档检查功能表现,参与 v1.6 验收测试和缺陷审核,并协助记录问题、反馈修正结果。 |
团队按“需求梳理—功能实现—测试复核—材料展示”的流程协作,具体任务会随迭代相互补位。以上分工依据现有项目材料整理,细节请各成员在发布前确认,避免把尚未确认的工作写成个人已完成事项。
3. 项目愿景
我们希望让缺少面试经验的同学,在真正投递前获得一次围绕自身经历的认真陪练。系统帮助用户发现讲不清楚的项目细节、拿不出证据的成果,以及与目标岗位之间的能力缺口。每次练习都留下一份能照着改的复盘,让准备有方向,让表达更具体,让面对真实面试时的紧张少一些。
二、选题报告
1. 我们关注什么问题
准备面试时,求职者常常已经看过不少知识点,却很难检验自己能否把真实经历说明白。简历上的“负责性能优化”“熟悉数据库”,在面试中还需要回答:为什么选这个方案?效果怎样验证?本人具体做了什么?
本项目将问题定义为:求职者需要围绕自己的简历和目标岗位练习表达,并得到带有回答依据的改进建议。 这是我们要通过真实调研验证的需求假设,而非已经证实的调研结论。
2. 需求调研示例
| 模拟反馈选项 | 假设选择数 | 比例 | 对应设计方向 |
|---|---|---|---|
| 希望提问贴合自己的简历 | 23 / 30 | 76.7% | 基于简历与 JD 定向提问 |
| 难以说明本人在项目中的贡献 | 19 / 30 | 63.3% | 通过细节追问检查回答依据 |
| 需要具体、可执行的改进建议 | 17 / 30 | 56.7% | 输出证据、行动清单与示范回答 |
该示例采用多选口径,各选项可重叠,比例四舍五入保留一位小数,不要求比例之和为 100%。正式调查应记录实际时间、对象、招募方式、样本及脱敏原始材料,再用真实结果调整功能优先级。
以下映射是需求分析框架,仍需通过真实用户验证。
| 需求假设 | 产品响应 | 需要验证的问题 |
|---|---|---|
| 通用题库与个人经历连接不足 | 输入简历和 JD 后定向提问 | 用户是否认为题目贴合自己的项目与岗位? |
| 自己练习难发现表述漏洞 | 含糊回答触发一次追问 | 追问是否帮助补充可验证的细节? |
| 总分难指导下一步行动 | 证据、评语、行动清单与示范回答 | 用户是否能据此完成一项具体修改? |
3. 目标用户与使用场景
| 用户 | 典型场景 | 希望解决的问题 |
|---|---|---|
| 应届生 | 校招或实习投递前练习项目介绍 | 有经历,但表达不够具体 |
| 转行求职者 | 对照新岗位检查经验匹配程度 | 不清楚现有能力与岗位要求的差距 |
| 同伴陪练者 | 时间有限,希望帮助同学复盘 | 需要可重复使用的练习与反馈材料 |
4. 核心功能:围绕能力缺口展开一场可复盘的面试
“面面俱到”的重点是把简历分析、定向提问和反馈连接起来。
用户提交简历与 JD 后,系统提取岗位能力项、权重与要求水平,分析简历体现的水平,并优先安排缺口较大的能力。三类面试官轮流考察,模型可以针对含糊回答请求追问。结束后,系统聚合各能力得分,给出逐题证据、改进建议和行动清单。
仓库中的界面测试记录展示了一个具体例子:主问围绕简历中“300 多份制度文档的解析与分块”,要求说明 ETL 流程、分块大小与元数据标签;追问继续要求解释切分和标签如何验证,是否有检索命中率或召回数据。这里展示的是应用内的练习对话,候选人回答中的实验数字不作为本项目的调研或测试指标。
图:HR 面试官沿着上一题继续追问,随后进入技术面试官的问题。原图来自 docs/test-screenshot/。
三类面试官的侧重点分别为:HR 关注动机、表达与协作;技术面试官关注项目细节、技术依据与方案取舍;压力面试官通过质疑检查论据是否自洽。
5. 创新点与价值边界
- 提问依据个人材料。 岗位能力模型连接简历与 JD,行业题库提供参考,不直接替代模型提问。
- 角色各有考察视角。 多角色使用不同提示与任务,通过统一状态机协作;它们可以调用同一模型,不要求部署三个独立模型。
- 反馈保留依据。 逐题记录包含回答、分数、证据与评语,复盘给出行动建议,并支持 Markdown、PDF 导出。
- 关键规则由代码执行。 阶段推进、追问上限、分数聚合和多角色中位数合并都由代码控制。
我们将创新定位于面试练习流程与反馈方式的组合。当前没有对照实验支持“提高面试通过率”等效果结论,评分也只作为练习参考。
三、需求分析
1. 文档组织与迭代
现有需求分析文档参照软件需求规格说明的章节结构,涵盖总体描述、前后端功能、验收标准、数据结构、约束与需求追踪。文档使用 F1–F11 表示功能需求,N1–N8 表示非功能需求。
下面摘录已有文档的迭代记录。记录本身不等同于本次重新执行并通过了全部验收。
| 时间 | 版本 | 文档记录的主要变化 |
|---|---|---|
| 2026-10-28 | V0.1–V0.3 | 建立文档骨架,确认定位、用户与环境 |
| 2026-10-29 | V0.8–V1.1 | 完善功能需求、验收标准和数据模型 |
| 2026-11-02 | V1.5–V1.6 | 增加 PDF 报告、行业题库及文档上传 |
| 2026-11-03 | v1.6 验收记录 | 记录测试与缺陷审核工作 |
| 2026-11-04 | V1.7–V1.7.1 | 记录输出容错、作答意图过滤、报告重试与重复出题修正 |
2. 项目标志与功能思维导图
3. 前端需求
| 编号 | 页面与交互 | 验收重点 |
|---|---|---|
| F1 | 录入简历、JD、岗位和行业,支持示例填入与文档上传 | 缺少必填文本时不能开始;支持 PDF/TXT/Markdown;上传限制 10 MB |
| F2 | 展示当前面试官、题目、评分要点、进度及历史回答 | 用户能确认当前轮次;提交后保留记录;错误信息可理解 |
| F3 | 展示总分、能力雷达、逐题回顾与改进建议 | 页面可查看结构化评分;文字报告失败时提供重试入口 |
| F9 | 下载 Markdown 与 PDF 报告 | 两种格式来自同一份报告数据,关键分数一致 |
| F11 | 检查用户是否提交有效作答 | 空文本或明显系统反馈不计分、不推进轮次 |
图:简历 Markdown 与岗位 PDF 已上传,正文、岗位名称和行业选择出现在录入页。该截图记录了上传后的界面状态。
4. 后端与智能体需求
| 编号 | 处理能力 | 输入与输出 |
|---|---|---|
| F4 | 简历分析与岗位建模 | 简历/JD 文本,输出结构化候选人信息和能力模型 |
| F5 | 缺口匹配 | 能力项与水平,输出雷达数据和缺口排序 |
| F6 | 多角色提问与追问 | 当前考察点、候选人信息与回答,输出题目和评分 |
| F7 | 最弱回答的多角色复评 | 选取已有回答,三角色独立评分后取中位数 |
| F8 | 聚合评分与生成复盘 | 逐题得分和能力权重,输出总分、建议与示范回答 |
| F10 | 行业识别与题库参考 | JD 或指定行业,输出行业与参考题 |
当前 F7 在界面称为“交叉拷问”,实际实现是对最弱的已有回答进行多角色复评,没有新增一轮用户作答。答辩演示按实际行为解释。
5. 架构与类图
系统采用 Python 与 Streamlit,界面通过 Orchestrator 驱动面试。智能体使用兼容接口调用模型,并通过 Pydantic 校验输出。确定性工具提供本地与 MCP 两种调用方式,共享评分和报告实现。
InterviewSession 保存当前阶段、题目、回答记录与报告;Question 保存题干和评分标准;Turn 保存一次问答;CrossExam 保存复评结果。模型负责分析和生成内容,编排器负责控制阶段和次数,工具层负责确定性计算。
6. 非功能需求与实现边界
| 方面 | 当前设计 | 验收方法 |
|---|---|---|
| 可配置性 | 模型地址、密钥、模型名由配置提供 | 缺少密钥时给出提示,确认配置不写死在界面 |
| 可替换性 | LocalTools 与 MCPTools 使用同一工具实现 | 同输入对比输出 |
| 健壮性 | JSON 容错、校验重试、中文错误提示及部分阶段恢复 | 模拟输出异常与报告失败,验证可恢复路径 |
| 安全性 | 密钥放环境变量或 Secrets,文件导出限定 workspace | 检查密钥泄露与越界路径拒绝 |
| 一致性 | 页面、Markdown、PDF 使用统一报告数据 | 对比三处总分、能力分和结论 |
7. 验收清单与测试状态
| 场景 | 输入或操作 | 预期结果 |
|---|---|---|
| 首次使用 | 填入示例简历与 JD,开始面试 | 进入面试,展示题目与评分要点 |
| 文件导入 | 上传可抽取文字的 PDF、TXT 或 MD | 正文填入文本框,用户可继续编辑 |
| 无效作答 | 提交空白或明显系统反馈 | 提示修改,不追加得分和轮次 |
| 自适应追问 | 假模型请求追问,随后再次请求 | 同一轮最多接受一次追问 |
| 多角色复评 | 完成主问答 | 对最弱已有回答产生三份评分并合并 |
| 报告与导出 | 完成流程并下载报告 | 显示总分与建议,导出 MD/PDF |
| 异常恢复 | 模拟复盘文字生成失败后重试 | 先保留结构化结果,再允许重新生成文字 |
| 公网验收 | 新浏览器访问线上地址 | 无需开发者本机环境即可完成练习并下载报告 |
仓库设有单元测试、MCP 集成测试、Streamlit 页面流程测试与 golden 报告测试。本次静态检查发现 142 个测试函数定义,47 个 Python 文件语法解析未发现错误。当前检查环境缺少 pytest 等依赖,未执行完整测试,也未验证公网可用性。 发布前应记录真实执行命令、结果和运行环境,不能将“有测试代码”写成“全部测试通过”。
仓库还保留了 docs/test-screenshot/ 中的一组界面测试截图。以下按需求选择复盘和导出记录,和上面的录入、追问截图一起说明功能运行过程。
| 截图记录 | 对应需求 | 图片能够直接说明的内容 |
|---|---|---|
| 文件录入 | F1 | 简历与 JD 文件、正文和岗位信息出现在输入界面 |
| 追问 | F6 | 已有问答后出现带“追问”标记的问题 |
| 复盘雷达与多角色复评 | F3、F7、F8 | 页面生成总分、能力图及三个角色的复评分数 |
| 下载入口与文件列表 | F9 | 页面提供两种格式入口,另有两条报告文件记录 |
图:本次运行显示加权总分 3.7/5、10 道面试题。最弱回答由三个角色分别给出 4/5、2/5、4/5,页面展示综合中位数 4/5。这些数值属于截图中的单次练习结果。
图:同一页面提供 Markdown、PDF 下载,并展示报告正文与能力得分。
图:报告文件列表保留了两条记录。入口与文件列表可以支持导出过程的说明,格式兼容、文件可打开性和内容一致性仍需分别验收。
这些截图补充了功能运行记录,不能替代完整测试日志。后续还应对无效作答、追问次数、重试及导出内容一致性逐项执行验收。
代码审查还发现需要优先复核的点:Windows 启动脚本中的变量展开、下一题生成失败后的状态处理、正常评分是否携带原题 rubric,以及未测能力在总分和雷达图中的一致解释。这些问题应转为缺陷记录并验证修复。
四、项目规划与上线交付
1. 当前实现与后续工作
| 阶段 | 目标 | 交付物与状态 |
|---|---|---|
| 当前代码 | 完成文本模拟面试与报告流程 | 已有源码、测试用例和界面测试截图,完整验收待补充 |
| 答辩前收尾 | 验证核心路径并处理阻断问题,补充实际使用反馈 | 测试记录、演示材料与脱敏反馈 |
| 源码交付 | 提供项目源码与运行说明 | GitHub 仓库,该链接并非在线应用入口 |
| 公网交付 | 部署并验证老师与同学可访问 | 应用运行验收与公网可用性尚未核验 |
| 后续迭代 | 根据调研决定历史复盘、语音或更多岗位支持的优先级 | 经用户验证后再确定,不计入本期完成范围 |
2. 时间安排
- 11 月 6 日至 7 日:完善真实资料,执行测试,复核核心流程与异常恢复。
- 11 月 8 日:检查公网访问、链接与图片,完成博客发布;截止时间为 2026-11-08 23:59。
- 11 月 9 日:课堂答辩,4 分钟陈述与演示,3 分钟回答问题。
3. 四分钟展示路线
先用团队页介绍分工,再说明需求假设与模拟调研示例,接着解释能力缺口和有针对性的追问,最后用报告、验收标准和交付状态收尾。PPT 已选用本次提供的追问、复盘及下载截图,课堂可直接讲解已有记录,控制现场模型等待时间。模拟调研与功能截图分别标明来源。
五、项目反思
这次项目最需要解决的工程问题,是让模型生成的内容服从明确的业务规则。智能体可以决定提问措辞和反馈表达,流程推进、追问次数与分数聚合则需要代码约束。我们也需要区分“聚合公式可复现”与“模型评分完全客观”:前者可以通过测试验证,后者仍受到模型判断与输入材料的影响。
后续评价项目价值,应观察用户能否据报告修改项目表达、补充回答证据,再据真实反馈调整功能。需求、代码、验收和使用结果能够相互对应,才是本项目希望完成的软件工程实践。
资料说明:正文中的实现描述来自项目源码与现有需求文档,架构插图来自 docs/diagrams/,界面测试截图来自用户提供的 docs/test-screenshot/;正文图片均使用 GitHub 仓库中对应的公开直链。课程和作业链接通过博客园班级博客公开作业列表定位,作业正文与日期依据本次提供的作业要求,详情页可能需要登录。模拟调研不代表真实调查,单次功能记录不代表效果验证。公开博客发布时,请将本地文档链接替换为仓库或在线协作文档链接,并补齐所有“待补”内容。
有备而来队:面面俱到,让模拟面试围绕自己的简历展开
| 作业所属课程 | 计科24级56班(广东工业大学) |
|---|---|
| 作业要求 | 团队项目第一次作业:团队展示+选题报告+需求分析 |
| 作业的目标 | 通过真实需求调研,开发嵌入智能体的软件,完成团队展示、选题报告与需求分析,并提供可访问的线上应用。 |
| 团队名称 | 有备而来队 |
| 团队成员学号-名字 | 3124004106-苏炜康;3124004087-陈浩良;3124004092-何锦烨 |
项目名称:面面俱到(MockStar)
项目仓库:gdut-homework4
项目地址(GitHub 源码):https://github.com/Jiyue0321/gdut-homework4
需求分析文档:软件需求规格说明书
材料整理:陈浩良。以下实现描述依据当前仓库,调研示例使用明确标注的模拟数据,应用上线情况尚未验证。
一、团队展示
1. 我们是谁
我们是有备而来队。这个名字来自项目最朴素的目标:让求职者带着准备走进面试,也让团队带着需求、实现和验证走进答辩。
我们的项目叫“面面俱到”,是一款面向应届生和转行求职者的 Web 模拟面试工具。用户输入自己的简历与目标岗位要求,系统组织 HR、技术、压力三类 AI 面试官开展练习,记录回答证据,并生成可下载的复盘报告。
2. 团队成员与协作分工
| 成员 | 学号 | 分工与工作内容 |
|---|---|---|
| 苏炜康 | 3124004106 | 负责需求与实现主线:参与需求文档迭代,梳理简历、岗位要求到模拟面试和复盘报告的核心流程,并参与功能开发与迭代。 |
| 陈浩良 | 3124004087 | 负责项目材料整理与展示表达:整理博客内容和答辩材料,结合项目功能与现有截图组织介绍结构,检查文档中的实现说明与展示材料是否对应。 |
| 何锦烨 | 3124004092 | 参与测试验收与问题复核:根据需求文档检查功能表现,参与 v1.6 验收测试和缺陷审核,并协助记录问题、反馈修正结果。 |
团队按“需求梳理—功能实现—测试复核—材料展示”的流程协作,具体任务会随迭代相互补位。以上分工依据现有项目材料整理,细节请各成员在发布前确认,避免把尚未确认的工作写成个人已完成事项。
3. 项目愿景
我们希望让缺少面试经验的同学,在真正投递前获得一次围绕自身经历的认真陪练。系统帮助用户发现讲不清楚的项目细节、拿不出证据的成果,以及与目标岗位之间的能力缺口。每次练习都留下一份能照着改的复盘,让准备有方向,让表达更具体,让面对真实面试时的紧张少一些。
二、选题报告
1. 我们关注什么问题
准备面试时,求职者常常已经看过不少知识点,却很难检验自己能否把真实经历说明白。简历上的“负责性能优化”“熟悉数据库”,在面试中还需要回答:为什么选这个方案?效果怎样验证?本人具体做了什么?
本项目将问题定义为:求职者需要围绕自己的简历和目标岗位练习表达,并得到带有回答依据的改进建议。 这是我们要通过真实调研验证的需求假设,而非已经证实的调研结论。
2. 需求调研示例
| 模拟反馈选项 | 假设选择数 | 比例 | 对应设计方向 |
|---|---|---|---|
| 希望提问贴合自己的简历 | 23 / 30 | 76.7% | 基于简历与 JD 定向提问 |
| 难以说明本人在项目中的贡献 | 19 / 30 | 63.3% | 通过细节追问检查回答依据 |
| 需要具体、可执行的改进建议 | 17 / 30 | 56.7% | 输出证据、行动清单与示范回答 |
该示例采用多选口径,各选项可重叠,比例四舍五入保留一位小数,不要求比例之和为 100%。正式调查应记录实际时间、对象、招募方式、样本及脱敏原始材料,再用真实结果调整功能优先级。
以下映射是需求分析框架,仍需通过真实用户验证。
| 需求假设 | 产品响应 | 需要验证的问题 |
|---|---|---|
| 通用题库与个人经历连接不足 | 输入简历和 JD 后定向提问 | 用户是否认为题目贴合自己的项目与岗位? |
| 自己练习难发现表述漏洞 | 含糊回答触发一次追问 | 追问是否帮助补充可验证的细节? |
| 总分难指导下一步行动 | 证据、评语、行动清单与示范回答 | 用户是否能据此完成一项具体修改? |
3. 目标用户与使用场景
| 用户 | 典型场景 | 希望解决的问题 |
|---|---|---|
| 应届生 | 校招或实习投递前练习项目介绍 | 有经历,但表达不够具体 |
| 转行求职者 | 对照新岗位检查经验匹配程度 | 不清楚现有能力与岗位要求的差距 |
| 同伴陪练者 | 时间有限,希望帮助同学复盘 | 需要可重复使用的练习与反馈材料 |
4. 核心功能:围绕能力缺口展开一场可复盘的面试
“面面俱到”的重点是把简历分析、定向提问和反馈连接起来。
用户提交简历与 JD 后,系统提取岗位能力项、权重与要求水平,分析简历体现的水平,并优先安排缺口较大的能力。三类面试官轮流考察,模型可以针对含糊回答请求追问。结束后,系统聚合各能力得分,给出逐题证据、改进建议和行动清单。
仓库中的界面测试记录展示了一个具体例子:主问围绕简历中“300 多份制度文档的解析与分块”,要求说明 ETL 流程、分块大小与元数据标签;追问继续要求解释切分和标签如何验证,是否有检索命中率或召回数据。这里展示的是应用内的练习对话,候选人回答中的实验数字不作为本项目的调研或测试指标。
图:HR 面试官沿着上一题继续追问,随后进入技术面试官的问题。原图来自 docs/test-screenshot/。
三类面试官的侧重点分别为:HR 关注动机、表达与协作;技术面试官关注项目细节、技术依据与方案取舍;压力面试官通过质疑检查论据是否自洽。
5. 创新点与价值边界
- 提问依据个人材料。 岗位能力模型连接简历与 JD,行业题库提供参考,不直接替代模型提问。
- 角色各有考察视角。 多角色使用不同提示与任务,通过统一状态机协作;它们可以调用同一模型,不要求部署三个独立模型。
- 反馈保留依据。 逐题记录包含回答、分数、证据与评语,复盘给出行动建议,并支持 Markdown、PDF 导出。
- 关键规则由代码执行。 阶段推进、追问上限、分数聚合和多角色中位数合并都由代码控制。
我们将创新定位于面试练习流程与反馈方式的组合。当前没有对照实验支持“提高面试通过率”等效果结论,评分也只作为练习参考。
三、需求分析
1. 文档组织与迭代
现有需求分析文档参照软件需求规格说明的章节结构,涵盖总体描述、前后端功能、验收标准、数据结构、约束与需求追踪。文档使用 F1–F11 表示功能需求,N1–N8 表示非功能需求。
下面摘录已有文档的迭代记录。记录本身不等同于本次重新执行并通过了全部验收。
| 时间 | 版本 | 文档记录的主要变化 |
|---|---|---|
| 2026-10-28 | V0.1–V0.3 | 建立文档骨架,确认定位、用户与环境 |
| 2026-10-29 | V0.8–V1.1 | 完善功能需求、验收标准和数据模型 |
| 2026-11-02 | V1.5–V1.6 | 增加 PDF 报告、行业题库及文档上传 |
| 2026-11-03 | v1.6 验收记录 | 记录测试与缺陷审核工作 |
| 2026-11-04 | V1.7–V1.7.1 | 记录输出容错、作答意图过滤、报告重试与重复出题修正 |
2. 项目标志与功能思维导图
3. 前端需求
| 编号 | 页面与交互 | 验收重点 |
|---|---|---|
| F1 | 录入简历、JD、岗位和行业,支持示例填入与文档上传 | 缺少必填文本时不能开始;支持 PDF/TXT/Markdown;上传限制 10 MB |
| F2 | 展示当前面试官、题目、评分要点、进度及历史回答 | 用户能确认当前轮次;提交后保留记录;错误信息可理解 |
| F3 | 展示总分、能力雷达、逐题回顾与改进建议 | 页面可查看结构化评分;文字报告失败时提供重试入口 |
| F9 | 下载 Markdown 与 PDF 报告 | 两种格式来自同一份报告数据,关键分数一致 |
| F11 | 检查用户是否提交有效作答 | 空文本或明显系统反馈不计分、不推进轮次 |
图:简历 Markdown 与岗位 PDF 已上传,正文、岗位名称和行业选择出现在录入页。该截图记录了上传后的界面状态。
4. 后端与智能体需求
| 编号 | 处理能力 | 输入与输出 |
|---|---|---|
| F4 | 简历分析与岗位建模 | 简历/JD 文本,输出结构化候选人信息和能力模型 |
| F5 | 缺口匹配 | 能力项与水平,输出雷达数据和缺口排序 |
| F6 | 多角色提问与追问 | 当前考察点、候选人信息与回答,输出题目和评分 |
| F7 | 最弱回答的多角色复评 | 选取已有回答,三角色独立评分后取中位数 |
| F8 | 聚合评分与生成复盘 | 逐题得分和能力权重,输出总分、建议与示范回答 |
| F10 | 行业识别与题库参考 | JD 或指定行业,输出行业与参考题 |
当前 F7 在界面称为“交叉拷问”,实际实现是对最弱的已有回答进行多角色复评,没有新增一轮用户作答。答辩演示按实际行为解释。
5. 架构与类图
系统采用 Python 与 Streamlit,界面通过 Orchestrator 驱动面试。智能体使用兼容接口调用模型,并通过 Pydantic 校验输出。确定性工具提供本地与 MCP 两种调用方式,共享评分和报告实现。
InterviewSession 保存当前阶段、题目、回答记录与报告;Question 保存题干和评分标准;Turn 保存一次问答;CrossExam 保存复评结果。模型负责分析和生成内容,编排器负责控制阶段和次数,工具层负责确定性计算。
6. 非功能需求与实现边界
| 方面 | 当前设计 | 验收方法 |
|---|---|---|
| 可配置性 | 模型地址、密钥、模型名由配置提供 | 缺少密钥时给出提示,确认配置不写死在界面 |
| 可替换性 | LocalTools 与 MCPTools 使用同一工具实现 | 同输入对比输出 |
| 健壮性 | JSON 容错、校验重试、中文错误提示及部分阶段恢复 | 模拟输出异常与报告失败,验证可恢复路径 |
| 安全性 | 密钥放环境变量或 Secrets,文件导出限定 workspace | 检查密钥泄露与越界路径拒绝 |
| 一致性 | 页面、Markdown、PDF 使用统一报告数据 | 对比三处总分、能力分和结论 |
7. 验收清单与测试状态
| 场景 | 输入或操作 | 预期结果 |
|---|---|---|
| 首次使用 | 填入示例简历与 JD,开始面试 | 进入面试,展示题目与评分要点 |
| 文件导入 | 上传可抽取文字的 PDF、TXT 或 MD | 正文填入文本框,用户可继续编辑 |
| 无效作答 | 提交空白或明显系统反馈 | 提示修改,不追加得分和轮次 |
| 自适应追问 | 假模型请求追问,随后再次请求 | 同一轮最多接受一次追问 |
| 多角色复评 | 完成主问答 | 对最弱已有回答产生三份评分并合并 |
| 报告与导出 | 完成流程并下载报告 | 显示总分与建议,导出 MD/PDF |
| 异常恢复 | 模拟复盘文字生成失败后重试 | 先保留结构化结果,再允许重新生成文字 |
| 公网验收 | 新浏览器访问线上地址 | 无需开发者本机环境即可完成练习并下载报告 |
仓库设有单元测试、MCP 集成测试、Streamlit 页面流程测试与 golden 报告测试。本次静态检查发现 142 个测试函数定义,47 个 Python 文件语法解析未发现错误。当前检查环境缺少 pytest 等依赖,未执行完整测试,也未验证公网可用性。 发布前应记录真实执行命令、结果和运行环境,不能将“有测试代码”写成“全部测试通过”。
仓库还保留了 docs/test-screenshot/ 中的一组界面测试截图。以下按需求选择复盘和导出记录,和上面的录入、追问截图一起说明功能运行过程。
| 截图记录 | 对应需求 | 图片能够直接说明的内容 |
|---|---|---|
| 文件录入 | F1 | 简历与 JD 文件、正文和岗位信息出现在输入界面 |
| 追问 | F6 | 已有问答后出现带“追问”标记的问题 |
| 复盘雷达与多角色复评 | F3、F7、F8 | 页面生成总分、能力图及三个角色的复评分数 |
| 下载入口与文件列表 | F9 | 页面提供两种格式入口,另有两条报告文件记录 |
图:本次运行显示加权总分 3.7/5、10 道面试题。最弱回答由三个角色分别给出 4/5、2/5、4/5,页面展示综合中位数 4/5。这些数值属于截图中的单次练习结果。
图:同一页面提供 Markdown、PDF 下载,并展示报告正文与能力得分。
图:报告文件列表保留了两条记录。入口与文件列表可以支持导出过程的说明,格式兼容、文件可打开性和内容一致性仍需分别验收。
这些截图补充了功能运行记录,不能替代完整测试日志。后续还应对无效作答、追问次数、重试及导出内容一致性逐项执行验收。
代码审查还发现需要优先复核的点:Windows 启动脚本中的变量展开、下一题生成失败后的状态处理、正常评分是否携带原题 rubric,以及未测能力在总分和雷达图中的一致解释。这些问题应转为缺陷记录并验证修复。
四、项目规划与上线交付
1. 当前实现与后续工作
| 阶段 | 目标 | 交付物与状态 |
|---|---|---|
| 当前代码 | 完成文本模拟面试与报告流程 | 已有源码、测试用例和界面测试截图,完整验收待补充 |
| 答辩前收尾 | 验证核心路径并处理阻断问题,补充实际使用反馈 | 测试记录、演示材料与脱敏反馈 |
| 源码交付 | 提供项目源码与运行说明 | GitHub 仓库,该链接并非在线应用入口 |
| 公网交付 | 部署并验证老师与同学可访问 | 应用运行验收与公网可用性尚未核验 |
| 后续迭代 | 根据调研决定历史复盘、语音或更多岗位支持的优先级 | 经用户验证后再确定,不计入本期完成范围 |
2. 时间安排
- 11 月 6 日至 7 日:完善真实资料,执行测试,复核核心流程与异常恢复。
- 11 月 8 日:检查公网访问、链接与图片,完成博客发布;截止时间为 2026-11-08 23:59。
- 11 月 9 日:课堂答辩,4 分钟陈述与演示,3 分钟回答问题。
3. 四分钟展示路线
先用团队页介绍分工,再说明需求假设与模拟调研示例,接着解释能力缺口和有针对性的追问,最后用报告、验收标准和交付状态收尾。PPT 已选用本次提供的追问、复盘及下载截图,课堂可直接讲解已有记录,控制现场模型等待时间。模拟调研与功能截图分别标明来源。
五、项目反思
这次项目最需要解决的工程问题,是让模型生成的内容服从明确的业务规则。智能体可以决定提问措辞和反馈表达,流程推进、追问次数与分数聚合则需要代码约束。我们也需要区分“聚合公式可复现”与“模型评分完全客观”:前者可以通过测试验证,后者仍受到模型判断与输入材料的影响。
后续评价项目价值,应观察用户能否据报告修改项目表达、补充回答证据,再据真实反馈调整功能。需求、代码、验收和使用结果能够相互对应,才是本项目希望完成的软件工程实践。
资料说明:正文中的实现描述来自项目源码与现有需求文档,架构插图来自 docs/diagrams/,界面测试截图来自用户提供的 docs/test-screenshot/;正文图片均使用 GitHub 仓库中对应的公开直链。课程和作业链接通过博客园班级博客公开作业列表定位,作业正文与日期依据本次提供的作业要求,详情页可能需要登录。模拟调研不代表真实调查,单次功能记录不代表效果验证。公开博客发布时,请将本地文档链接替换为仓库或在线协作文档链接,并补齐所有“待补”内容。

 浙公网安备 33010602011771号