
网络
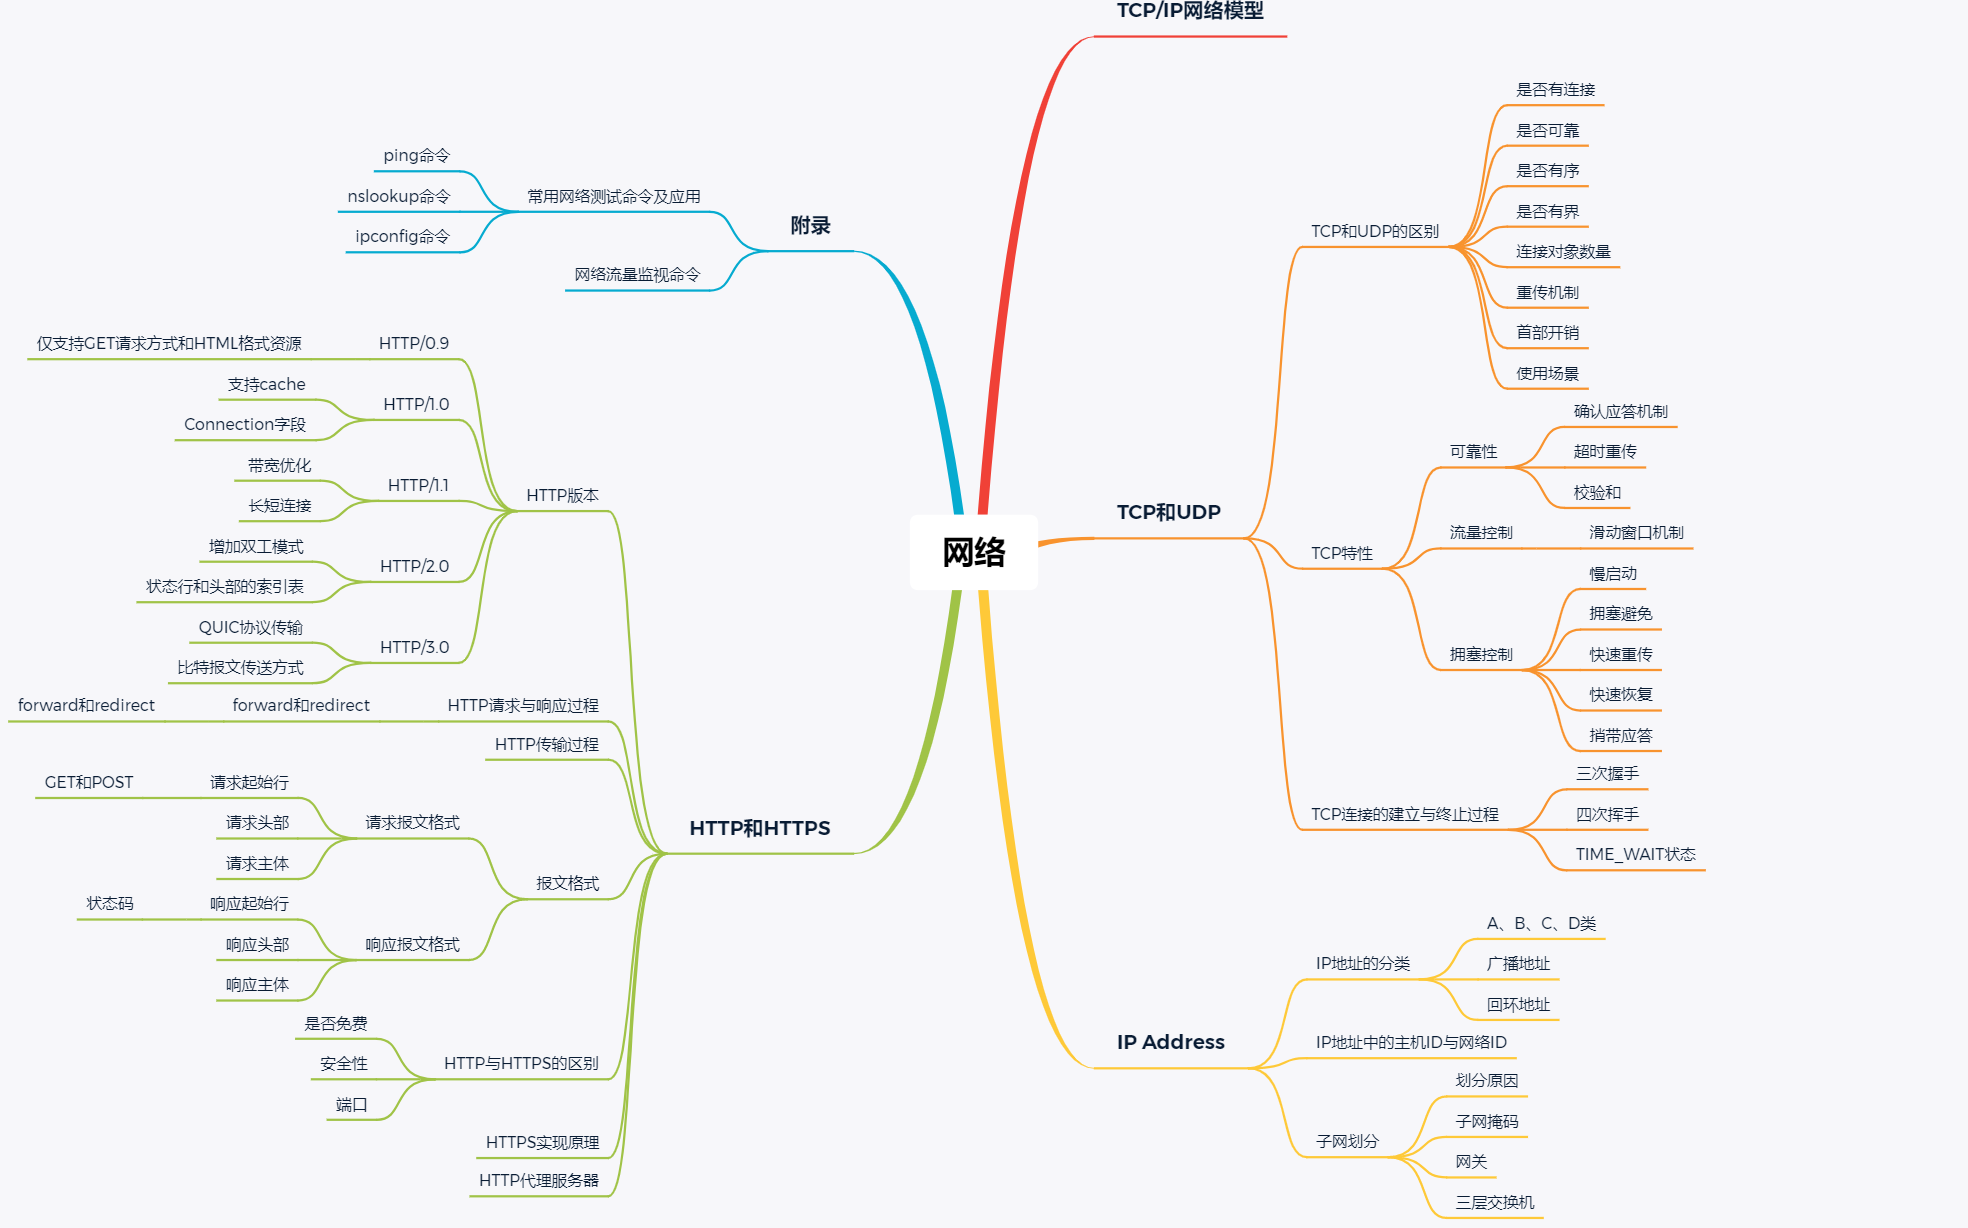
一、TCP/IP网络模型
| OSI | TCP/IP | 功能 | TCP/IP协议簇 |
|---|---|---|---|
|
应用层 表示层 会话层 |
应用层 |
文件传输,电子邮件,文件服务 数据格式化,数据加密 接触或建立与别的结点的连接 |
TFTP,HHTP,SMTP,FTP,DNS |
| 传输层 | 传输层 | 提供端对端的接口 | TCP,UDP |
| 网络层 | 网络层 | 为数据包选择路由 | IP,ICMP,RIP |
|
数据链路层 物理层 |
链路层 |
|传输有错误的帧以及错误检测功能 以二进制数据格式在物理媒介上传输数据 |
ARP,SLIP ISO2110,IEEE802 |
- 物理层
- 该层为上层协议提供了一个传输数据的可靠物理媒介。简单的说,物理层确保原始数据可在各种物理媒介中传输。
- 中继器
- 集线器
- 该层为上层协议提供了一个传输数据的可靠物理媒介。简单的说,物理层确保原始数据可在各种物理媒介中传输。
- 数据链路层
- 将源自网络层的数据可靠地传输到相邻结点的目标网络层。主要功能有将数据融合成数据块(帧),控制帧在物理信道上的传输,处理传输差错,调节发送速率以使与接收方匹配。主要作用即:物理地址寻址,数据成帧,流量控制,数据的检错,重发
- 数据链路层为网络层提供可靠的数据传输
- 基本数据的数据单位为帧
- 主要的协议:以太网协议
- 网桥
- 交换机
- 将源自网络层的数据可靠地传输到相邻结点的目标网络层。主要功能有将数据融合成数据块(帧),控制帧在物理信道上的传输,处理传输差错,调节发送速率以使与接收方匹配。主要作用即:物理地址寻址,数据成帧,流量控制,数据的检错,重发
- 网络层
- 该层的目的是实现两个主机系统之间的数据传输透明,具体功能包括寻址和路由选择,连接的建立与终止等,它提供的服务使传输层不需要了解网络层的数据传输和交换技术,可简单记为路径选择,路由及逻辑寻址
- TCP/IP的核心协议————IP协议
- 功能包括有:无线数据包传输,数据包路由选择,差错控制
- 与其配套的协议有:地址解析协议ARP,因特网报文协议ICMP等
- 网络层负责对子网间的数据包进行路由选择,还可以实现拥塞控制,网际互联
- 基本数据单位为IP数据报
- 路由器
- TCP/IP的核心协议————IP协议
- 该层的目的是实现两个主机系统之间的数据传输透明,具体功能包括寻址和路由选择,连接的建立与终止等,它提供的服务使传输层不需要了解网络层的数据传输和交换技术,可简单记为路径选择,路由及逻辑寻址
- 传输层
- 负责将上层数据分段并提供端对端的,可靠或不可靠的传输。此外,传输层还要处理端到端的差错控制和流量控制,其任务是根据通信子网的特性,最佳的利用网络资源,为两个端系统的会话层之间,建立,维护和取消阐述连接的功能,负责端对端的可靠信息传输,在这一层,信息传送的协议称为段或者报文,作用:为应用进程之间提供端到端的逻辑通信
- 传输层负责将上层数据分段并提供端到端,可靠或者不可靠的传输以及端到端的差错控制以及流量控制
- TCP协议,UDP协议
- 网关
- 负责将上层数据分段并提供端对端的,可靠或不可靠的传输。此外,传输层还要处理端到端的差错控制和流量控制,其任务是根据通信子网的特性,最佳的利用网络资源,为两个端系统的会话层之间,建立,维护和取消阐述连接的功能,负责端对端的可靠信息传输,在这一层,信息传送的协议称为段或者报文,作用:为应用进程之间提供端到端的逻辑通信
- 会话层
- 管理主机之间的会话进程,负责建立、管理、终止进程之间的会话,还可利用在数据中插入校验点实现数据同步,包括建立检查点和恢复方案。
- 表示层
- 对上层数据或信息进行变换以保证一个主机的信息可以被另外一个主机的应用程序理解,包括对数据的加密,压缩,格式转换等,数据描述使得应用程序不必担心计算机内部存储格式的问题。
- 应用层
- 最靠近用户的层,为用户的应用进程提供网络服务的接口,将用户的操作通过应用进程转换为服务,并匹配一个相应的服务协议发送给传输层
传输数据时可以只是使用(传输层)协议,但是没有应用层的话便无法识别数据内容。如果要使传输的数据有意义,则必须使用应用层协议。
- 最靠近用户的层,为用户的应用进程提供网络服务的接口,将用户的操作通过应用进程转换为服务,并匹配一个相应的服务协议发送给传输层
二、TCP和UDP
2.1 TCP和UDP的区别
| UDP | TCP | |
|---|---|---|
| 是否连接 | 无连接 | 有连接 |
| 是否可靠 | 不可靠,不使用流量控制和拥塞控制 | 可靠传输,使用流量控制和拥塞控制 |
| 是否有序 | 无序 | 有序 |
| 是否有界 | 有界 | 无界 |
| 重传机制 | 无 | 超时重传机制,快速重传机制 |
| 连接对象个数 | 一对一,一对多,多对一,多对多 | 一对一 |
| 传输方式 | 面向报文 | 面向数据流 |
| 首部开销 | 小,仅8字节 | 最小20字节,最大60字节 |
| 适用场景 | 实时应用(视频会议,直播) | 适用于可靠的应用(文件传输) |
-
是否有界
TCP通过字节流传输,即TCP将应用程序看成是一连串的无结构的字节流。每个TCP套接口有一个发送缓冲区,如果字节流太长时,TCP会将其拆分进行发送。当字节流太短时,TCP会等待缓冲区中的字节流达到一定程度时再构成报文发送出去,TCP发给对方的数据,对方在收到数据时必须给矛确认,只有在收到对方的确认时,本方TCP才会把TCP发送缓冲区中的数据删除。 而UDP传输报文的方式是由应用程序控制的,应用层交给UDP多长的报文,UDP照样发送,既不拆分,也不合并,而是保留这些报文的边界,即一次发送一个报文。有界与无界之分是根据接收报文来划分的,对于TCP协议,客户端连续发送数据,只要服务端的这个函数的缓冲区足够大,会一次性接收过来,即客户端是分好几次发过来,是有边界的,而服务端却一次性接收过来,所以证明是无边界的;而对于UDP协议,客户端连续发送数据,即使服务端的这个函数的缓冲区足够大,也只会一次一次的接收,发送多少次接收多少次,即客户端分几次发送过来,服务端就必须按几次接收,从而证明,这种UDP的通讯模式是有边界的,UDP无缓存服务,信息确认由应用层完成。
-
TCP黏包问题
由于TCP协议本身的机制(面向连接的可靠地协议-三次握手机制)客户端与服务器会维持一个连接(Channel),数据在连接不断开的情况下,可以持续不断地将多个数据包发往服务器,但是如果发送的网络数据包太小,那么他本身会启用Nagle算法(可配置是否启用)对较小的数据包进行合并(基于此,TCP的网络延迟要UDP的高些)然后再发送(超时或者包大小足够)。那么这样的话,服务器在接收到消息(数据流)的时候就无法区分哪些数据包是客户端自己分开发送的,这样产生了粘包;服务器在接收到数据库后,放到缓冲区中,如果消息没有被及时从缓存区取走,下次在取数据的时候可能就会出现一次取出多个数据包的情况,造成粘包现象。
- 发送定长的数据 不能完全解决 会出现不知道从哪里开始分离固定长度的数据的情况(没有被及时从缓存区取走)
- 自定制协议 [定长结构体(标识该条数据长度)]12345[分隔符]
-
TCP分包问题:
可能是IP分片传输导致的,也可能是传输过程中丢失部分包导致出现的半包,还有可能就是一个包可能被分成了两次传输,在取数据的时候,先取到了一部分(还可能与接收的缓冲区大小有关系),总之就是一个数据包被分成了多次接收。
-
UDP无连接
首先 UDP 是不需要和 TCP一样在发送数据前进行三次握手建立连接的,想发数据就可以开始发送了。并且也只是数据报文的搬运工,不会对数据报文进行任何拆分和拼接操作。具体来说就是:在发送端,应用层将数据传递给传输层的 UDP 协议,UDP 只会给数据增加一个 UDP 头标识下是 UDP 协议,然后就传递给网络层了.在接收端,网络层将数据传递给传输层,UDP 只去除 IP 报文头就传递给应用层,不会任何拼接操作
2.2 TCP特性
- TCP的各种机制
- 可靠性
- 确认应答机制(ACK)
- 超时重传机制
- 校验和
- 流量控制
- 滑动窗口机制(ARQ)
滑动窗口协议既保证了分组无差错、有序接收,也实现了流量控制。主要的方式就是接收方返回的 ACK 中会包含自己的接收窗口的大小,并且利用大小来控制发送方的数据发送。
- 滑动窗口机制(ARQ)
- 拥塞控制
- 防止过多的数据注入到网络中,这样可以使网络中的路由器或链路不致过载
- 具体实现
慢启动(Slow Start)发送方维护拥塞窗口变量cwnd,先用小数据试探网络拥塞,没问题后来断加倍.
拥塞避免(Congestion voidance):拥塞窗口缓慢增长,即每经过一个往返时间RTT就把发送方的拥塞窗口cwnd加1
快速重传(Fast Retransmit):快重传要求接收方收到失序报文段后立即发出重复确认(为的是使发送方及早知道有报文段没有到达对方)而不要等到自己发送数据时捎带确认。快重传算法规定,发送方只要一连收到三个重复确认就应当立即重传对方尚未收到的报文段,而不必继续等待设置的重传计时器时间到期。
快速恢复(Fast Recovery):当发送方连续收到三个重复确认时,就把慢开始门限ssthresh门限减半。接下来将cwnd设置为ssthresh的大小,然后执行拥塞避免算法- 捎带应答
- 可靠性
2.3 TCP连接的建立与终止过程
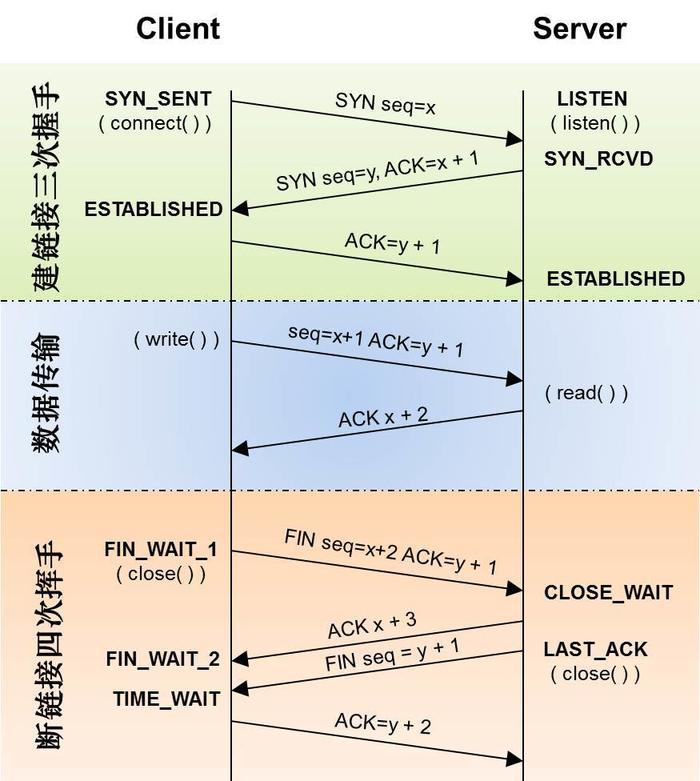
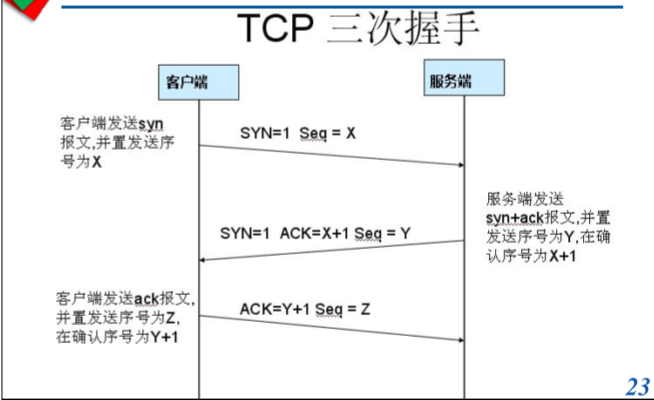
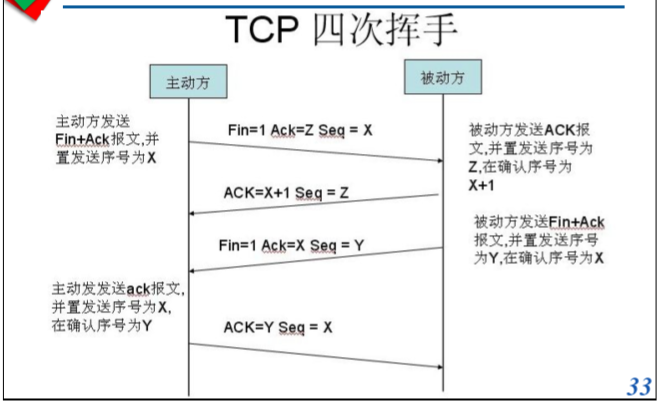
-
三次握手
- 第一次握手:客户端将标志位SYN置为1,表示请求同步(建立连接)。随机产生一个值seq=x,并将该数据包发送给服务器端,客户端进入SYN_SENT状态,等待服务器端确认。
- 第二次握手:服务器端将标志位SYN置为1表示请求同步,ACK置为1表示收到请求。ack=x+1,用于给客户端和之前传送过来的seq校验。随机产生一个值seq=y,并将该数据包发送给客户端以确认连接请求,服务器端进入SYN_RCVD状态。
- 第三次握手:客户端收到确认后,检查ACK是否为1,ack是否为x+1,如果正确则将标志位ACK置为1,ack=y+1,seq=传过来的ack=x+1,并将该数据包发送给服务器端,并进入ESTABLISHED状态。服务器端检查ACK是否为1,ack是否为y+1,如果正确则连接建立成功服务器端进入ESTABLISHED状态,完成三次握手,随后客户端与服务器端之间可以开始传输数据了。假如第三次握手没有到达服务器端呢?但是这时客户端已进入ESTABLISHED状态。但是其实这种情况下,只要客户端向服务器端写数据,就会收到服务器端的RST(复位)应答,这时客户端就能知道出现问题了。
-
三次握手的漏洞
但是在TCP三次握手中是有一个缺陷的。利用三次握手的缺陷可以进行SYN洪泛攻击。- SYN洪泛攻击:通过网络服务所在的端口发送大量伪造原地址的攻击报文,发送到服务端,造成服务端上的半开连接队列被占满,从而阻止其他用户进行访问。
- 原理:攻击者客户端利用伪造的IP地址向服务端发出请求(第一次握手),而服务端的响应(第二次握手)的报文将永远发送不到真实的客户端,服务端在等待客户端的第三次握手(永远都不会有的),服务端在等待这种半开的连接过程中消耗了资源,如果有成千上万的这种连接,主机资源将被耗尽,从而达到攻击的目的。
- 解决方案:
- 无效连接监视释放
这种方法不停监视所有的连接,包括三次握手的,还有握手一次的,反正是所有的,当达到一定(与)阈值时拆除这些连接,从而释放系统资源。这种方法对于所有的连接一视同仁,不管是正常的还是攻击的,所以这种方式不推荐。
- 延缓TCB分配方法
一般的做完第一次握手之后,服务器就需要为该请求分配一个TCB(连接控制资源),通常这个资源需要200多个字节。延迟TCB的分配,当正常连接建立起来后再分配TCB则可以有效地减轻服务器资源的消耗。
- 使用防火墙
防火墙在确认了连接的有效性后,才向内部的服务器(Listener)发起SYN请求,
-
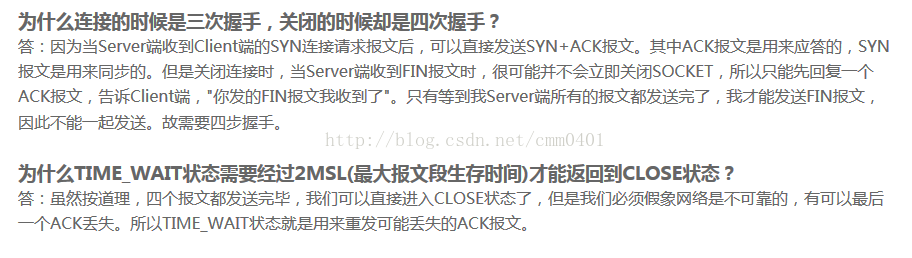
四次挥手
- 客户端进程发出连接释放报文,并且停止发送数据。释放数据报文首部,FIN=1,其序列号为seq=u(等于前面已经传送过来的数据的最后一个字节的序号加1),此时,客户端进入FIN-WAIT-1(终止等待1)状态。 TCP规定,FIN报文段即使不携带数据,也要消耗一个序号。
- 服务器收到连接释放报文,发出确认报文,ACK=1,ack=u+1,并且带上自己的序列号seq=v,此时,服务端就进入了CLOSE-WAIT(关闭等待)状态。TCP服务器通知高层的应用进程,客户端向服务器的方向就释放了,这时候处于半关闭状态,即客户端已经没有数据要发送了,但是服务器若发送数据,客户端依然要接受。这个状态还要持续一段时间,也就是整个CLOSE-WAIT状态持续的时间。
- 客户端收到服务器的确认请求后,此时,客户端就进入FIN-WAIT-2(终止等待2)状态,等待服务器发送连接释放报文(在这之前还需要接受服务器发送的最后的数据)。
- 服务器将最后的数据发送完毕后,就向客户端发送连接释放报文,FIN=1,ack=u+1,由于在半关闭状态,服务器很可能又发送了一些数据,假定此时的序列号为seq=w,此时,服务器就进入了LAST-ACK(最后确认)状态,等待客户端的确认。
- 客户端收到服务器的连接释放报文后,必须发出确认,ACK=1,ack=w+1,而自己的序列号是seq=u+1,此时,客户端就进入了TIME-WAIT(时间等待)状态。注意此时TCP连接还没有释放,必须经过2 MSL(最长报文段寿命)的时间后,当客户端撤销相应的TCB后,才进入CLOSED状态。服务器只要收到了客户端发出的确认,立即进入CLOSED状态。同样,撤销TCB后,就结束了这次的TCP连接。可以看到,服务器结束TCP连接的时间要比客户端早一些。
-
四次挥手的原因
防止客户端失效的连接请求报文段突然又传到服务器
例如以下情况如果使用两次握手:如果客户端向服务器发送第一次连接请求在网络节点上滞留了,没有收到服务器的确认,于是又重新发送了一次连接请求,服务器收到客户端的第二次请求发送确认,则连接建立完成,服务器客户端进行数据传输,传输完成断开连接。此时,在网络上滞留的客户端第一次连接请求到达服务器,服务器发送确认连接但是客户端实际上并没有发送请求,因此不会理睬服务器发送的请求。但是服务器认为连接已完成,并等待客户端进行数据传输。这样会造成资源的浪费
如果采用三次握手的话:
滞留在网络上的客户端第一次请求到达服务器之后,服务器发送确认,但实际上服务器并没有发送请求,因此不会理睬服务器的确认,故不会发送确认,服务器等不到客户端的确认则连接建立失败。这样就防止了客户端失效的连接请求报文段突然又传到服务器
-
TCP连接点的终止为啥是四次挥手而不是三次
-
TIME_WAIT状态:
主动关闭放进入TIME_WAIT状态后,等待被动连接放发送FIN分节,如果直接关闭的话,系统可能会有一个与主动关闭方相同的新进程与被动连接方进行通讯,造成信息泄露。
三、IP Address
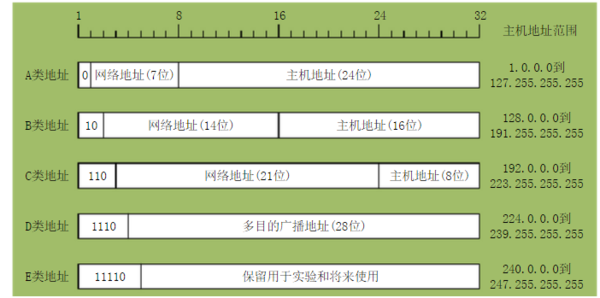
3.1 IP地址的分类
-
A类地址:首位为0,1.0.0.1~127.255.255.254;主机号24位
-
B类地址:首位为10,128.0.0.1~191.255.255.254;主机号16位
-
C类地址:首位为110,192.0.0.1~223.255.255.254;主机号8位
-
D类地址(多播地址,也叫做组播地址):首位为1110,224.0.0.1~239.255.255.254
-
E类地址:此类地址是保留地址,首位为11110,240.0.0.1~254.255.255.254
-
广播地址
广播地址(Broadcast Address)是专门用于同时向网络中所有工作站进行发送的一个地址。在使用TCP/IP 协议的网络中,主机标识段host ID 为全1 的IP 地址为广播地址,广播的分组传送给host ID段所涉及的所有计算机。例如,对于10.1.1.0 (255.255.255.0 )网段,其广播地址为10.1.1.255 (255 即为2 进制的11111111 ),当发出一个目的地址为10.1.1.255 的分组(封包)时,它将被分发给该网段上的所有计算机。
- 计算广播地址
广播地址:网络地址的主机位全部变成1 ,10011111 即159 即:202.112.14.159
- 计算广播地址
-
回环地址
127.0.0.1,通常被称为本地回环地址(Loop back address),不属于任何一个有类别地址类。它代表设备的本地虚拟接口,所以默认被看作是永远不会宕掉的接口。在windows操作系统中也有相似的定义,所以通常在不安装网卡前就可以ping通这个本地回环地址。一般都会用来检查本地网络协议、基本数据接口等是否正常的
3.2 IP地址的主机ID与网络ID
- IP地址=网络地址+主机地址
- 计算网络ID:只需要将IP地址和子网掩码进行与运算,所得结果即为该主机的网络ID
有IP地址192.168.0.1,对应的子网掩码为255.255.255.0; 将IP地址和子网掩码全部转换成二进制的形式,即IP地址是:11000000.10101000.00000000.00000001 ,子网掩码是:11111111.11111111.11111111.00000000; 将二进制形式的IP地址和子网掩码进行与运算; 运算结果为11000000.10101000.00000000.00000000,转换为十进制就是192.168.0.0,所以这个主机的网络ID就是192.168.0.0。- 计算主机ID:只需要将子网掩码进行二进制按位取反,再和IP地址进行与运算,所得结果即为该主机的主机ID
有IP地址192.168.0.1,对应的子网掩码为255.255.255.0; 将子网掩码转换成二进制的形式,即就是:11111111.11111111.11111111.00000000; 将子网掩码进行二进制按位取反,即就是:00000000.00000000.00000000.11111111; 将取反后的子网掩码和IP地址的二进制形式进行与运算; 结果为:00000000.00000000.00000000.00000001,转换为十进制就是0.0.0.1,所以这个主机的网络ID就是192.168.0.0。- 主机数
主机号有5位,那么这个地址中,就只能有25−2=3025−2=30个主机
因为其中全0作为网络地址,全1作为广播地址
3.3 子网划分
-
为什么进行子网划分
- 减少网络流量
- 优化网络性能,这是减少网络流量的结果。
- 简化管理,与庞大的网络相比,在一系列相连的小网络中找出并隔离网络问题更容易。
- 有助于覆盖大型地理区域,WAN链路比LAN链路的速度慢得多,且更昂贵;单个大跨度的大型网络在前面说的各个方面都可能出现问题(网络流量太大,广播风暴),而将多个小网络连接起来可提高系统的效率。
-
子网掩码
子网掩码(subnet mask)又叫网络掩码、地址掩码、子网络遮罩,它是一种用来指明一个IP地址的哪些位标识的是主机所在的子网,以及哪些位标识的是主机的位掩码。子网掩码不能单独存在,它必须结合IP地址一起使用。子网掩码只有一个作用,就是将某个IP地址划分成网络地址和主机地址两部分。子网掩码是一个32位地址,用于屏蔽IP地址的一部分以区别网络标识和主机标识,并说明该IP地址是在局域网上,还是在远程网上。将IP地址和子网掩码换算为二进制,子网掩码连续全1的是网络地址,后面的是主机地址。
子网掩码——屏蔽一个IP地址的网络部分的“全1”比特模式。对于A类地址来说,默认的子网掩码是255.0.0.0;对于B类地址来说默认的子网掩码是255.255.0.0;对于C类地址来说默认的子网掩码是255.255.255.0。
-
通过子网掩码,就可以判断两个IP在不在一个局域网内部。
-
子网掩码可以看出有多少位是网络号,有多少位是主机号
-
ip段/数字-如192.168.0.1/24是什么意思?
后面这个数字标示了我们的网络号的位数,也就是子网掩码中前多少号为1 129.168.1.1 /24 这个24就是告诉我们网络号是24位 也就相当于告诉我们了 子网掩码是:11111111 11111111 11111111 00000000 即:255.255.255.0 172.16.10.33/27 中的/27 也就是说子网掩码是255.255.255.224 即27个全1 -
-
网关
网关(Gateway)又称网间连接器、协议转换器。默认网关在网络层上以实现网络互连,是最复杂的网络互连设备,仅用于两个高层协议不同的网络互连。网关的结构也和路由器类似,不同的是互连层。网关既可以用于广域网互连,也可以用于局域网互连。可以是路由器、三层交换机等设备网关实质上是一个网络通向其他网络的IP地址
-
三层交换机
组合了集线器、路由器和交换机的功能,具有网络管理的一类设备,可以实现在一个设备中对多个虚拟子网的管理的一类设备
四、HTTP和HTTPS
4.1 HTTP版本
4.1.1 HTTP/0.9
- HTTP协议的最初版本,功能简陋,仅支持请求方式GET,并且仅能请求访问HTML格式的资源。
4.1.2 HTTP/1.0
-
请求行必须在尾部添加协议版本字段(http/1.0)
-
必须包含头消息
-
在0.9版本上做了进步,增加了请求方式POST和HEAD
-
不再局限于0.9版本的HTML格式,根据Content-Type可以支持多种数据格式,即MIME多用途互联网邮件扩展,例如text/html、image/jpeg等
-
开始支持cache,就是当客户端在规定时间内访问统一网站,直接访问cache即
-
HTTP请求和回应的格式也变了。除了数据部分,每次通信都必须包括头信息(HTTP header),用来描述一些元数据
-
新增功能还包括状态码(status code)、多字符集支持、多部分发送(multi-part type)、权限(authorization)、缓存(cache)、内容编码(content encoding)等。
-
1.0版本的工作方式是每次TCP连接只能发送一个请求,当服务器响应后就会关闭这次连接,下一个请求需要再次建立TCP连接,就是不支持keepalive
-
TCP连接的新建成本很高,因为需要客户端和服务器三次握手,并且开始时发送速率较慢(slow start)。所以,HTTP 1.0版本的性能比较差。随着网页加载的外部资源越来越多,这个问题就愈发突出了。为了解决这个问题,有些浏览器在请求时,用了一个非标准的Connection字段。
-
HTTP/1.0与HTTP/1.1对比
-
可扩展性
-
HTTP/1.1在消息中增加版本号,用于兼容性判断。
-
新增了请求方式PUT、PATCH、OPTIONS、DELETE等。
-
带宽优化
HTTP/1.0中,存在一些浪费带宽的现象,例如客户端只是需要某个对象的一部分,而服务器却将整个对象送过来了。例如,客户端只需要显示一个文档的部分内容,又比如下载大文件时需要支持断点续传功能,而不是在发生断连后不得不重新下载完整的包。
HTTP/1.1中在请求消息中引入了range头域,它允许只请求资源的某个部分。在响应消息中Content-Range头域声明了返回的这部分对象的偏移值和长度。如果服务器相应地返回了对象所请求范围的内容,则响应码为206(Partial Content),它可以防止Cache将响应误以为是完整的一个对象。
另外一种情况是请求消息中如果包含比较大的实体内容,但不确定服务器是否能够接收该请求(如是否有权限), 此时若贸然发出带实体的请求,如果被拒绝也会浪费带宽。HTTP/1.1 加入了一个新的状态码100(Continue)。客户端事先发送一个只带头域的请求,如果服务器因为权限拒绝了请求,就回送响应码401(Unauthorized);如果服务器接收此请求就回送响应码100,客户端就可以继续发送带实体的完整请求了。
注意,HTTP/1.0 的客户端不支持100响应码。但可以让客户端在请求消息中加入Expect头域,并将它的值设置为100-continue。节省带宽资源的一个非常有效的做法就是压缩要传送的数据。Content-Encoding是对消息进行端到端(end-to-end)的编码,它可能是资源在服务器上保存的固有格式(如 jpeg 图片格式);在请求消息中加入Accept-Encoding头域,它可以告诉服务器客户端能够解码的编码方式。
-
长连接和短连接
HTTP1.1默认保持长连接(HTTP persistent connection,也翻译为持久连接),数据传输完成了保持TCP连接不断开(不发RST包、不四次握手),等待在同域名下继续用这个通道传输数据;(管道机制)
相反的就是短连接。在 HTTP/1.0 中,默认使用的是短连接。也就是说,浏览器和服务器每进行一次HTTP操作,就建立一次连接,任务结束就中断连接。
-
4.1.3 HTTP/2.0 (2015年5月以RFC 7540正式发表)
为了解决1.1版本利用率不高的问题,基于SPDY协议提出了HTTP/2.0版本。
-
增加双工模式,即不仅客户端能够同时发送多个请求,服务端也能同时处理多个请求,解决了队头堵塞的问题(HTTP2.0使用了多路复用的技术,做到同一个连接并发处理多个请求,而且并发请求的数量比HTTP1.1大了好几个数量级)
-
之前HTTP版本请求和响应中,状态行和请求/响应头都是些信息字段,并没有真正的数据,因此在2.0版本中将所有的信息字段建立一张表,为表中的每个字段建立索引,客户端和服务端共同使用这个表,他们之间就以索引号来表示信息字段,这样就避免了1.0旧版本的重复繁琐的字段,并以压缩的方式传输,提高利用率
-
另外也增加服务器推送的功能,即不经请求服务端主动向客户端发送数据。
4.1.4 HTTP3.0
- 基于QUIC协议传输
- TTP的范例和概念没有改变。它含有头部(header)和正文(body),请求和回复,还有动词(verb)、Cookie和缓存。HTTP/3的主要改变是将这些报文比特传送到另一端的方式。
为了使HTTP可以通过QUIC传输,协议的某些方面要进行修改,修改的结果便是HTTP/3。这些必要修改是因QUIC与TCP在某些性质上的不同所致,修改包括:- 在QUIC中,数据流由传输层本身提供,而在HTTP/2中,流由HTTP层完成。
- 由于数据流互相独立,HTTP/2中使用的头部压缩算法如果不做改动,会造成队头阻塞。
- QUIC流与HTTP/2略有不同。本书的HTTP/3章节会做详细介绍。
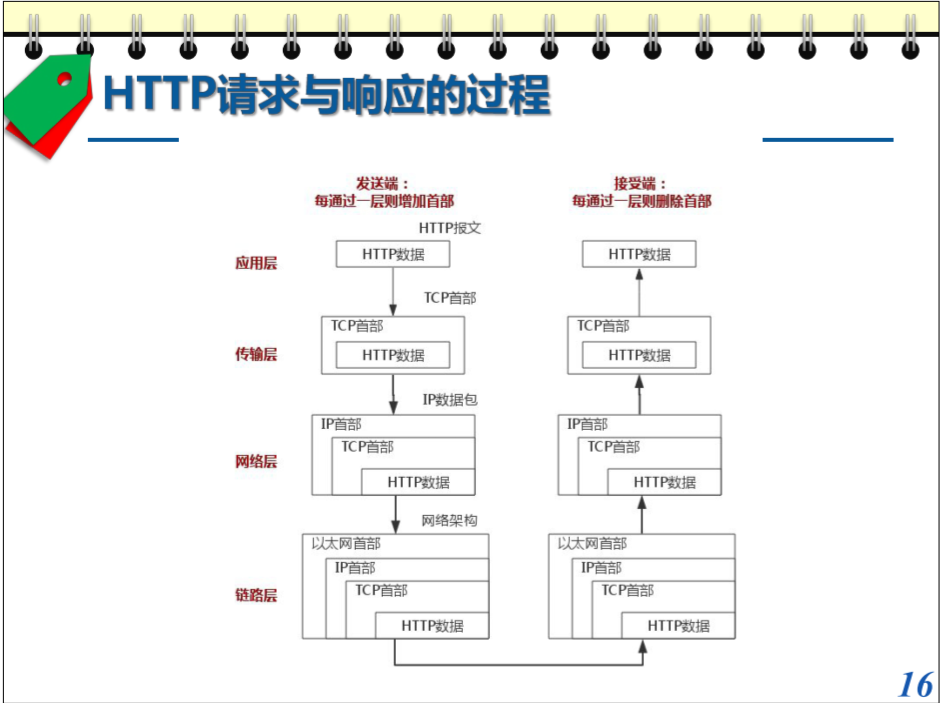
4.2 HTTP请求与响应过程
- forward和redirect
- forward(转发):服务器请求资源,服务器直接访问目标地址URL,把那个URL的响应内容读取过来然后发送给浏览器浏览器不知道服务器发送的数据从哪里来的,所以地址栏中的地址还是原来的地址。
- redirect(重定向):服务端根据逻辑发送一个状态码,告诉浏览器去请求那个地址,所以地址栏中的地址是目标URL。
4.3 在浏览器中输入url到显示页面的过程
-
输入地址
当我们开始在浏览器中输入网址的时候,浏览器其实就已经在智能的匹配可能得 url 了,他会从历史记录,书签等地方,找到已经输入的字符串可能对应的 url,然后给出智能提示,让你可以补全url地址。对于 google的chrome 的浏览器,他甚至会直接从缓存中把网页展示出来,就是说,你还没有按下 enter,页面就出来了。
-
浏览器查找域名的 IP 地址
2.1 请求一旦发起,浏览器首先要做的事情就是解析这个域名,一般来说,浏览器会首先查看本地硬盘的 hosts 文件,看看其中有没有和这个域名对应的规则,如果有的话就直接使用 hosts 文件里面的 ip 地址。
2.2 如果在本地的 hosts 文件没有能够找到对应的 ip 地址,浏览器会发出一个 DNS请求到本地DNS服务器。本地DNS服务器一般都是你的网络接入服务器商提供,比如中国电信,中国移动。
2.3 查询你输入的网址的DNS请求到达本地DNS服务器之后,本地DNS服务器会首先查询它的缓存记录,如果缓存中有此条记录,就可以直接返回结果,此过程是递归的方式进行查询。如果没有,本地DNS服务器还要向DNS根服务器进行查询。
2.4 根DNS服务器没有记录具体的域名和IP地址的对应关系,而是告诉本地DNS服务器,你可以到域服务器上去继续查询,并给出域服务器的地址。这种过程是迭代的过程。
2.5本地DNS服务器继续向域服务器发出请求,在这个例子中,请求的对象是.com域服务器。.com域服务器收到请求之后,也不会直接返回域名和IP地址的对应关系,而是告诉本地DNS服务器,你的域名的解析服务器的地址。
2.6 最后,本地DNS服务器向域名的解析服务器发出请求,这时就能收到一个域名和IP地址对应关系,本地DNS服务器不仅要把IP地址返回给用户电脑,还要把这个对应关系保存在缓存中,以备下次别的用户查询时,可以直接返回结果,加快网络访问。
-
浏览器向 web 服务器发送一个TCP连接请求
拿到域名对应的IP地址之后,浏览器会以一个随机端口(1024<端口<65535)向服务器的WEB程序(常用的有httpd,nginx等)80端口发起TCP的连接请求。这个连接请求到达服务器端后(这中间通过各种路由设备,局域网内除外),进入到网卡,然后是进入到内核的TCP/IP协议栈(用于识别该连接请求,解封包,一层一层的剥开),还有可能要经过Netfilter防火墙(属于内核的模块)的过滤,最终到达WEB程序,最终建立了TCP/IP的连接。
-
服务器的永久重定向响应
服务器给浏览器响应一个301永久重定向响应,这样浏览器就会访 http://www.google.com/ 而非 http://google.com/ 。为什么服务器一定要重定向而不是直接发送用户想看的网页内容呢?其中一个原因跟搜索引擎排名有关。如果一个页面有两个地址,就像 http://www.yy.com/和http://yy.com/ ,搜索引擎会认为它们是两个网站,结果造成每个搜索链接都减少从而降低排名。而搜索引擎知道301永久重定向是什么意思,这样就会把访问带www的和不带www的地址归到同一个网站排名下。还有就是用不同的地址会造成缓存友好性变差,当一个页面有好几个名字时,它可能会在缓存里出现
-
浏览器跟踪重定向地址
现在浏览器知道了 http://www.google.com/ 才是要访问的正确地址,所以它会发送一个http请求。
-
服务器处理请求
经过前面的重重步骤,我们终于将我们的http请求发送到了服务器这里,其实前面的重定向已经是到达服务器了,那么,服务器是如何处理我们的请求的呢?
后端从在固定的端口接收到TCP报文开始,它会对TCP连接进行处理,对HTTP协议进行解析,并按照报文格式进一步封装成HTTP Request对象,供上层使用。
一些大一点的网站会将你的请求到反向代理服务器中,因为当网站访问量非常大,网站越来越慢,一台服务器已经不够用了。于是将同一个应用部署在多台服务器上,将大量用户的请求分配给多台机器处理。
此时,客户端不是直接通过HTTP协议访问某网站应用服务器,而是先请求到Nginx,Nginx再请求应用服务器,然后将结果返回给客户端,这里Nginx的作用是反向代理服务器。同时也带来了一个好处,其中一台服务器万一挂了,只要还有其他服务器正常运行,就不会影响用户使用。
-
服务器返回一个 HTTP 响应
经过前面的6个步骤,服务器收到了我们的请求,也处理我们的请求,到这一步,它会把它的处理结果返回,也就是返回一个HTPP响应。
HTTP响应与HTTP请求相似,HTTP响应也由3个部分构成,分别是:状态行、响应头(Response Header)、响应正文
-
浏览器显示 HTML
在浏览器没有完整接受全部HTML文档时,它就已经开始显示这个页面了
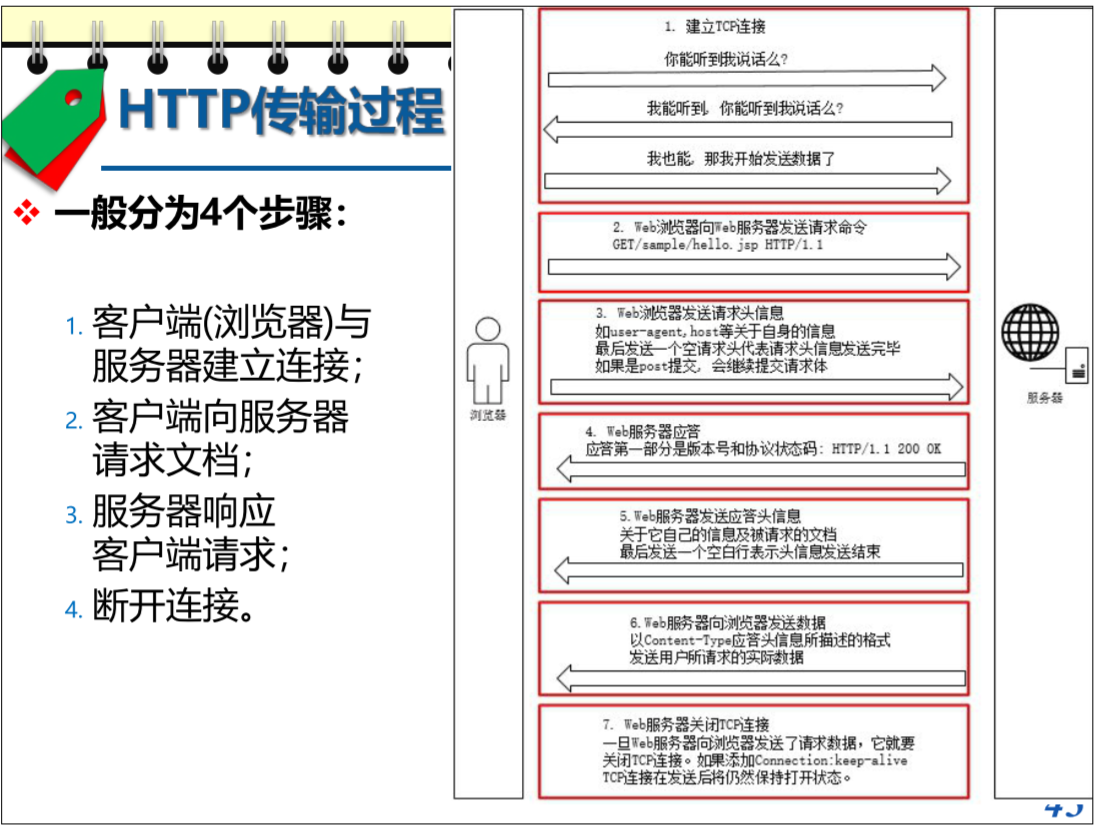
4.4 HTTP传输过程
4.5 报文格式
| 信息 | 说明 |
|---|---|
| 起始行 | 对报文进行描述 |
| 头部 | 向报文中添加了一些附加信息,是一个名/只的列表,头部和协议配合工作,共同决定了客户端和服务器能做什么事情 |
| 主体 | 包含数据的主体部分 |
4.5.1 响应报文格式
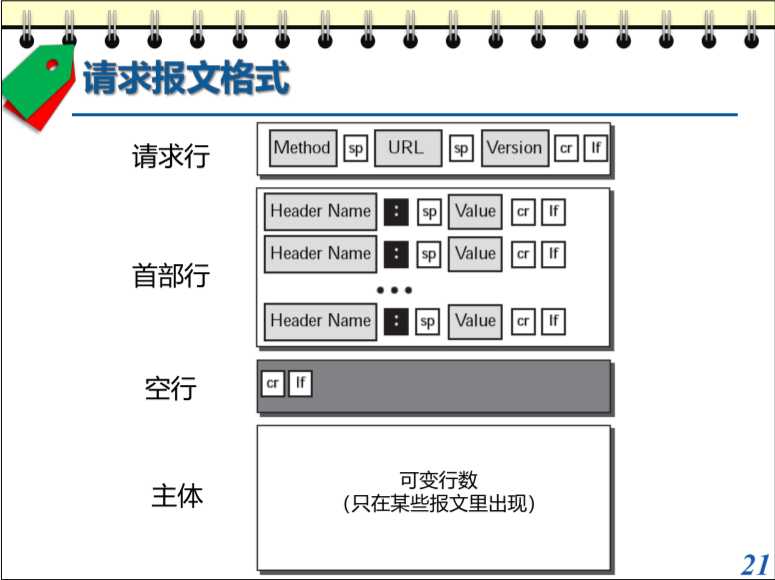
- HTTP请求起始行
| 方法 | 说明 |
|---|---|
| GET | 请求URL所指的文档 |
| POST | 从客户端向服务器端发送一些信息 |
| HEAD | 只请求文档的信息,而不包含文档的内容 |
| PUT | 从服务器向客户端发送文档 |
| TRACE | 把到达的请求回送 |
| CONNECT | 保留 |
| OPTION | 询问关于可用的选项 |
-
Get和Post的区别
- GET和POST本质上就是TCP链接,并无差别。但是由于HTTP的规定和浏览器/服务器的限制,导致他们在应用过程中体现出一些不同
- GET在浏览器回退时是无害的,而POST会再次提交请求。
- GET产生的URL地址可以被Bookmark,而POST不可以。
- GET请求会被浏览器主动cache,而POST不会,除非手动设置。
- GET请求只能进行url编码,而POST支持多种编码方式。
- GET请求参数会被完整保留在浏览器历史记录里,而POST中的参数不会被保留。
- GET请求在URL中传送的参数是有长度限制的,而POST么有。
- 对参数的数据类型,GET只接受ASCII字符,而POST没有限制。
- GET比POST更不安全,因为参数直接暴露在URL上,所以不能用来传递敏感信息。
- GET参数通过URL传递,POST放在Request body中。
- 对于GET方式的请求,浏览器会把http header和data一并发送出去,服务器响应200(返回数据);
- 而对于POST,浏览器先发送header,服务器响应100 continue,浏览器再发送data,服务器响应200 ok(返回数据)。
-
HTTP请求头部
| 信息 | 说明 |
|---|---|
| Accept | 指浏览器或其他客户可以接爱的MIME文件格式。可以根据它判断并返回适当的文件格式 |
| Accept-Charset | 指出浏览器可以接受的字符编码。英文浏览器的默认值是ISO-8859-1 |
| Accept-Language | 指出浏览器可以接受的语言种类,如en或en-us,指英语 |
| Accept-Encoding | 指出浏览器可以接受的编码方式。编码方式不同于文件格式,它是为了压缩文件并加速文件传递速度。浏览器在接收到Web响应之后先解码,然后再检查文件格式 |
| Cache-Control | 设置关于请求被代理服务器存储的相关选项。一般用不到 |
| Connection | 用来告诉服务器是否可以维持固定的HTTP连接。HTTP/1.1使用Keep-Alive为默认值,这样,当浏览器需要多个文件时(比如一个HTML文件和相关的图形文件),不需要每次都建立连接 |
| Content-Type | 用来表名request的内容类型。可以用HttpServletRequest的getContentType()方法取得 |
| Cookie | 浏览器用这个属性向服务器发送Cookie。Cookie是在浏览器中寄存的小型数据体,它可以记载和服务器相关的用户信息,也可以用来实现会话功能 |
4.5.2 响应报文格式
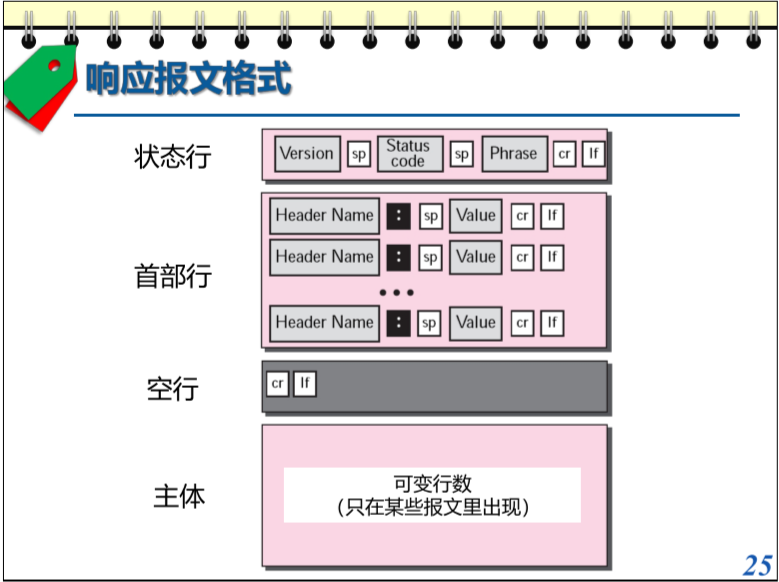
- HTTP响应起始行
| 方法 | 说明 |
|---|---|
| Server | 给出服务器相关信息 |
| Accept-Ranges | 服务器将接受请求的字节范围 |
| Content-Type | 指明媒体类型 |
| Content-Encoding | 指明编码方案 |
| Location | 请求客户将请求发送到另一站点 |
| Set-Cookie | 服务器请求客户保存Cookie |
| Upgrade | 指明优先使用的通信协议 |
| Public | 给出可以支持的文档清单 |
| Retry-afer | 指明的日期之后,服务器才能使用 |
- HTTP常见状态码
-
1开头状态码
表示请求已被接收,继续处理 -
2开头状态码
表示成功处理请求的状态代码- 200:通常表示服务器成功处理的请求
-
3开头状态码
表示要完成请求,需要进一步操作。通常,这些状态代码用来重定向- 301:代表永久性转移
- 302:代表暂时性转移
-
4开头状态代码 通常表示请求可能出现错误,妨碍了服务器的处理
- 400:服务器不理解请求的语法
- 403:服务器拒绝请求
- 404:服务器找不到请求的网页
-
5开头状态码 通常表示服务器在处理中这些请求时发生内错误。这些错误可能是服务器本身错误或是请求出错
- 500(服务器内部错误):服务器遇到错误,无法完成请求
- 501(无法实施):服务器不具备完成请求的功能。例如服务器无法识别方法。
- 502(错误网关):服务器作为网关或代理,从上游服务器收到无效响应。
- 503(服务不可用):服务器目前无法使用(由于超载或者停机维护),通常这只是暂时转态。
- 504(网关超时):服务器作为网关或者代理,但是没有及时从上游服务器收到请求。
- 505(HHTP版本不受支持):服务器不支持请求中所使用的HTTP协议版本
重点:200,304,403,500
-
4.6 HTTP与HTTPS的区别
- HTTPS协议需要ca申请证书,一般免费证书较少,所以需要一定费用
- HTTP是超文本协议,信息是明文传输,HTTPS则是具有安全性的ssl加密传输协议
- 在HTTP通信中加入了SSL层,通信的数据被加密了,防止被窃取,具体的通信流程如下:
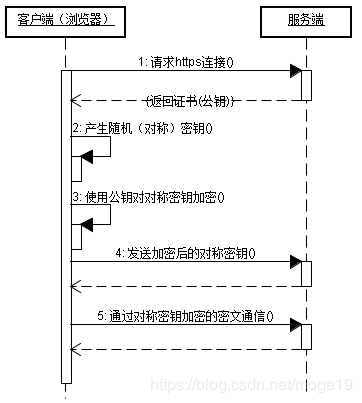
- 在HTTP通信中加入了SSL层,通信的数据被加密了,防止被窃取,具体的通信流程如下:
- HTTP和HTTPS使用的是两种完全不同的连接方式,用的端口也不一样,前者是80,后者是443
- HTTP的连接很简单,是无状态的;HTTPS是有SSl+HTTP协议构成的可加密除数,身份认证的网络协议,比HTTP更安全
4.7 HTTPS实现原理
4.8 HTTP代理服务器
工作在应用层,比价耗费资源
- 提高访问速度:通常代理服务器都设置一个较大的缓冲区,当有外界的信息通过时,同时也将其保存到缓冲区中,当其他用户再访问相同的 信息时,则直接由缓冲区中 取出信息,传给用户,以提高
访问速度。 - 控制对内部资源的访问:如某大学FTP(前提是该代理地址在该资源的允许访问范围之 内),使用教育网内地址段免费代理服务器,就可以用于对教育网开放的各类FTP下载上传,以及各类资料查询共享等服务。
- 过滤内容:例如限制对特定计算机的访问,将一种语言的数据翻译成另一种语言,或是防御代理服务器两边的攻击性访问。
- 隐藏真实IP:上网者也可以通过代理服务器隐藏自己的IP,免受攻击。但是只一个代 理很难保证安全,更安全的方法是利用特定的工具创建代理链
- 突破自身IP访问限制:访问国外站点。中国教育网和169网等网络用户可以通过代理访 问国外网站。
- 突破内容过滤机制限制,访问被过滤网站。
附录
1. 常用网络测试命令及应用
ping命令
Ping [-t] [-a] [-n count] [-l length] [-f] [-i TTL] [-v TOS] [-r count] [-s count] [-j HostList]| [-k HostList] [-w timeout] destination –list

v-t,不间断地ping指定的主机,直到按“Ctrl+C” 组合键中断为止。
v-a,指定对目的地IP地址进行反向名称解析。如 果解析成功,将显示相应的主机名。
v-n count,发送count指定的ECHO数据包数,默认值为4。
-l length,自定义发送数据包的大小,也就是发送由length指定大小的ECHO数据包,默认为32字节,最 大值是65527字节。
v-f,指定发送的回响请求消息带有“不要拆分”标志(所在的IP标题设为1)
v-i TTL,指定发送回响请求消息的IP标题中的TTL字段值。
v-v TOS,指定发送回响请求消息的IP标题中的“服务 类型 (TOS)”字段值,默认值是0。TOS被指定为0到 255的十进制数。
v-r count,指定IP标题中的“记录路由”选项用于记录由回响请求消息和相应的回响应答消息使用的路径
- 功能
- ping 127.0.0.1:检查TCP/IP是否被正确地安装。
- ping本机IP:ping本地计算机的IP地址,本地计算 机对该ping命令作出应答。如果没有应答,则表示本地 配置或安装存在问题。出现此问题时,局域网用户可断开 网络电缆,然后重新发送该命令。如果网线断开后本命令 正确,则表示另一台计算机可能配置额相同的IP地址。
- ping局域网内其他主机IP:如果收到回送应答,表 明本地网络中的网卡和传输介质运行正确。但如果没有收 到回送应答,那么表示子网掩码不正确或网卡配置错误,或电缆线路有问题。
- ping网关IP:该命令如果应答正确,表示局域网中 的网关路由器正在运行以及能否与本地网络上的本地主机 通讯。
- ping远程主机IP:如果收到4个应答,表示成功地 使用了缺省网关。对于拨号上网用户则表示能够成功地访 问Internet。
- ping域名:ping域名,如 ping www.sina.com.cn ,通常是通过DNS服务器进行解析。 如果这里出现故障,则表示DNS服务器的IP地址配置不 正确或DNS服务器有故障。另外,利用该命令可以实现域名对IP地址的转换功能。
nslookup www.*.com
- 功能
- nslookup是一个监测网络中DNS服务器是否能正确实现域名解析的命令行 工具。它在 UNIX/Windows NT/2000/XP中均可使用。nslookup必须要 安装了TCP/IP的网络环境中才能使用。
- 如果需要对DNS的故障进行排错就必须熟练使用工具nslookup。这个命令 可以指定查询的类型,可以查到DNS记录的生存时间,还可以指定使用哪个DNS服务器进行解释。
ipconfig命令
ipconfig [/all /renew [adapter] /release [adapter]] [/flushdns] [/displaydns] [/registerdns] [/showclassid Adapter] [/setclassid Adapter [ClassID]]
-
功能
- ipconfig用于显示当前的TCP/IP网络配置的设置值、刷 新动态主机配置协议(DHCP)和域名系统(DNS)设置。 使用不带参数的ipconfig可以显示所有适配器的IP地址、子网掩码和默认网关。
- ipconfig一般用来检验人工配置的TCP/IP设置是否正确。 如果计算机和所在的局域网使用了动态主机配置协议 (DHCP),这个程序所显示的信息可以让用户了解自己 的计算机是否成功的租用到一个IP地址,如果租用到则可 以了解它目前分配到的具体地址。了解计算机当前的IP地 址、子网掩码和缺省网关实际上是进行测试和故障分析的必要条件。
-
范例
- 要显示所有适配器的完整TCP/IP配置,键入
ipconfig/all。 - 仅更新“本地连接”适配器的由DHCP分配IP地址 的配置,键入
ipconfig /renew "Local Area Connection" - 要在排除DNS的名称解析故障期间清理DNS解析器 缓存,键入
ipconfig /flushdns - 要显示名称以Local开头的所有适配器的DHCP类别 ID,键入
ipconfig /showclassid Local - 要将“本地连接”适配器的DHCP类别ID设置为 TEST,键入
ipconfig /setclassid "Local Area Connection" TEST
- 要显示所有适配器的完整TCP/IP配置,键入
2. 网络流量监视命令
| 命令名称 | 适用的操作系统 | 功能说明 |
|---|---|---|
| ping | UNIX/Windows | 用于测量往返数据包丢失率 |
| bing | UNIX | 测量线路的点到点带宽 |
| etherfind | UNIX | 检查以太网数据包 |
| snoop | UNIX | 捕获并检查网络数据包 |
| tcpdump | UNIX | 网络的dumps流量 |
| getethers | UNIX | 获取一个以太网局域网网段中所有主机的地址 |
| iptrace | UNIX | 测量网关的性能 |
| netstat | UNIX/Windows | 显示各种网络相关数据结构的内容 |
| arp | UNIX/Windows | 显示并修改Internet到Ethernet地址转换表 |
| tracert | UNIX/Windows | 追踪有路由延迟的目标机的路由 |
| route | UNIX/Windows | 显示、人工添加和修改路由表项目 |
| pathping | UNIX/Windows | 显示有关在源和目标主机之间的中间跃点处的网络 滞后和网络丢失的信息 |
- 其中一个是ping命令,重复执行大量的ping命令(ICMP回显 请求消息)可测算出接收的成功次数,就可以计算出数据包丢失的百分率。包丢失是一种吞吐量的测算。
- 另一个常用的命令是点到点带宽bing命令,这个命令是以ping 为基础的,通过线路两端发送数据包的大小不同而产生的往返时间差进行计算,可以得出粗略的吞吐量数据。
- 其他5个命令可以检查在网络中经过的数据包,分别提供不同的 输出。命令etherfind、snoop和tcpdump把网卡置于混杂模式中(在这种模式中,收集网络中未经处理的数据无需经过任 何过滤)并记录数据。命令getethers可以得到所有局域网网段 的主机名和以太网地址对。工具iptrace在UNIX内核中使用 NETMON程序,产生3类输出:IP流量、主机流量矩阵输出和预先定义数据包号的简短取样。
- netstat命令可以帮助网络管理员了解网络的整体使用情 况。它可以显示当前正在活动的网络连接的详细信息,例 如,显示网络连接、路由表和网络接口信息,可以统计目前总共有哪些网络连接正在进行。命令格式语法:
netstat [-a] [-e] [-n] [-o] [-p Protocol] [-r] [-s] [Interval], - 使用arp命令,能够查看本地计算机或另一台计 算机的ARP高速缓存中的当前内容。此外,使用 arp命令,也可以用人工方式输入静态的网卡物 理和IP地址对,使用这种方式为缺省网关和本地 服务器等常用主机进行这项操作,有助于减少网络上的信息量。ARP命令格式:
arp [-a [InetAddr] [-N IfaceAddr]] [-g [InetAddr] [-N IfaceAddr]] [-d InetAddr [IfaceAddr]] [-s InetAddr EtherAddr [IfaceAddr]] - tracert一般用来检测故障的位置,虽然还是不能确定 具体故障原因,但已经能显示问题所在的地方。另外, traceroute命令的功能与tracert相同,二者的差别仅 仅在于tracert命令是用在Windows平台上,而traceroute命令是用在Unix平台和路由器上。
- tracert命令用来显示数据包到达目标主机所经过的路径,并 显示到达每个节点的时间。命令格式如下:
Tracert IP地址或主机名 [-d] [-h maximum_hops] [-j host_list] [-w timeout] - route命令用来显示、人工添加和修改路由表项目的。 route命令格式:
route [-f] [-p] [[print] [add] [change] [delete] [Destination] [mask subnetmask] [Gateway] [metric Metric]] [if Interface]
3. 专有名词
-
CDN
- CDN的全称是
Content Delivery Network,即内容分发网络,它应用了 HTTP 协议里的缓存和代理技术,代替源站响应客户端的请求。CDN 是构建在现有网络基础之上的网络,它依靠部署在各地的边缘服务器,通过中心平台的负载均衡、内容分发、调度等功能模块,使用户就近获取所需内容,降低网络拥塞,提高用户访问响应速度和命中率。CDN的关键技术主要有内容存储和分发技术。
- CDN的全称是
-
DNS
-
你有没有想过为什么你可以通过键入
www.google.com就能够获取你想要的网站?我们上面说到,计算机网络中的每个端系统都有一个 IP 地址存在,而把 IP 地址转换为便于人类记忆的协议就是DNS 协议。DNS 的全称是
域名系统(Domain Name System,缩写:DNS),它作为将域名和 IP 地址相互映射的一个分布式数据库,能够使人更方便地访问互联网。
-
-
URL
-
我们上面提到,你可以通过输入
www.google.com地址来访问谷歌的官网,那么这个地址有什么规定吗?我怎么输都可以?AAA.BBB.CCC 是不是也行?当然不是的,你输入的地址格式必须要满足URI的规范。
URI的全称是(Uniform Resource Identifier),中文名称是统一资源标识符,使用它就能够唯一地标记互联网上资源。URL的全称是(Uniform Resource Locator),中文名称是统一资源定位符,也就是我们俗称的网址,它实际上是 URI 的一个子集。URI 不仅包括 URL,还包括 URN(统一资源名称),它们之间的关系如下
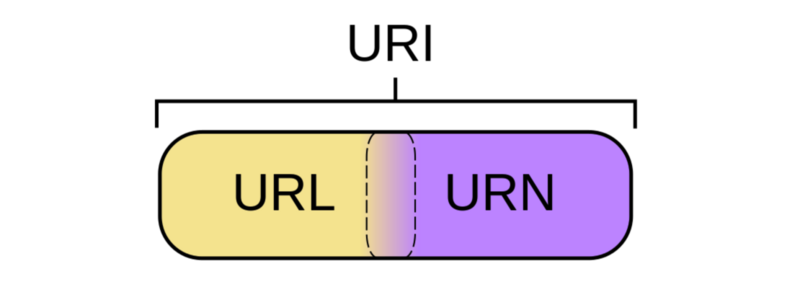
-
- 推荐文章
参考
[2]https://blog.csdn.net/qq_32374237/article/details/86242159
[3]https://blog.csdn.net/gui951753/article/details/79412524
[4]https://blog.csdn.net/lyn_00/article/details/84953763
[5]https://blog.csdn.net/moge19/article/details/90050030
[6]https://zhuanlan.zhihu.com/p/102237039
[7]https://blog.csdn.net/weixin_44367006/article/details/99768731
[8]https://blog.csdn.net/qq_33663020/article/details/79386252

 浙公网安备 33010602011771号
