
Java源码阅读 - HashMap
做技术,不能只知其然而不知其所以然。在知道了工具的原理之后,才能更高效的使用这个工具。在程序的世界里,源码里面没有秘密,看懂了源码,也就看懂了原理。
这次就来阅读一下HashMap的源码。
HashMap的特性
HashMap有如下的特性:
HashMap是根据键值对来存储数据的,多个数据之间的键不能重复。在键重复时,旧的数据将会被覆盖HashMap中各个数据实际存放的位置与hashCode()方法的结果有关,但不是由其结果直接决定HashMap只允许一个键是null(因为存储多个键是null的数据就违反了第一条特性),但是允许多个值是null的数据HashMap中数据存储的位置是不确定的,并且可能会因为扩容而改变,所以它的遍历顺序是不确定的HashMap不是线程安全的,如果需要线程安全性则可以使用ConcurrentHashMap
类的声明
public class HashMap<K,V> extends AbstractMap<K,V>
    implements Map<K,V>, Cloneable, Serializable
上面代码声明了一个名为HashMap的泛型类,它继承了AbstractMap,并实现了Map,Cloneable,Serializable接口。
AbstractMap是一个抽象类,它是一个骨架级的Map实现,来减少实现一个Map所需的工作量。
Map接口顾名思义,它定义了要实现一个Map时必须实现的方法。
一些关键的常量和概念
在深入了解HashMap前,有一些关键的概念我们需要知道:
- 哈希桶(bucket/bin):一个数组元素中存放的链表,就是一个哈希桶
- 哈希表:即存放了各个哈希桶的数组
- 树化阈值:当一个桶的大小超过了树化阈值之后才会将其变成红黑树
- 非树化阈值:当一个已经变成红黑树的桶中节点数量小于该值时,这个红黑树会被变回链表
- 最小树化容量:在选择是否将一个链表变成红黑树时,除了会考虑链表长度外,还会考虑哈希表的长度。仅当哈希表长度超过最小树化容量,且某个链表长度超过树化阈值时,这个链表才会被变成红黑树
与之对应的有这几个常量值:
// 树化阈值
static final int TREEIFY_THRESHOLD = 8;

// 非树化阈值
static final int UNTREEIFY_THRESHOLD = 6;

// 最小树化容量
static final int MIN_TREEIFY_CAPACITY = 64;
此外HashMap还针对哈希表的扩容定义了一系列的常量和变量:
// 默认初始容量。为了保证添加和查找的高效性,HashMap的容量总是2的幂次
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16

// 最大容量
static final int MAXIMUM_CAPACITY = 1 << 30;

// 默认载荷因子。
// 载荷因子是哈希表在其容量自动增加之前被允许获得的最大数量的度量,决定了哈希表何时扩容
static final float DEFAULT_LOAD_FACTOR = 0.75f;

// 扩容阈值。它的值等于哈希表容量乘以载荷因子
int threshold;

// 实际的载荷因子
final float loadFactor;
如何存储数据
HashMap存储数据的方式有两种,而这两种方式也正是Java 1.7和Java 8的分界线,因为Java 8对于HashMap进行了底层上的改动。
Java 1.7之前
因为HashMap是依靠hashCode()方法的结果来决定元素存储的位置的,而再完美的哈希函数也无法避免哈希碰撞的出现,所以HashMap选择采用拉链法(也叫链地址法)来存储数据。
链地址法是一种结合了数组和链表的存储方式,在每个数组元素中存储的都是一个链表,这些链表被称为桶(bucket/bin)。
为了直观的展示,这里借用一下参考文章1[1]中的一幅图:
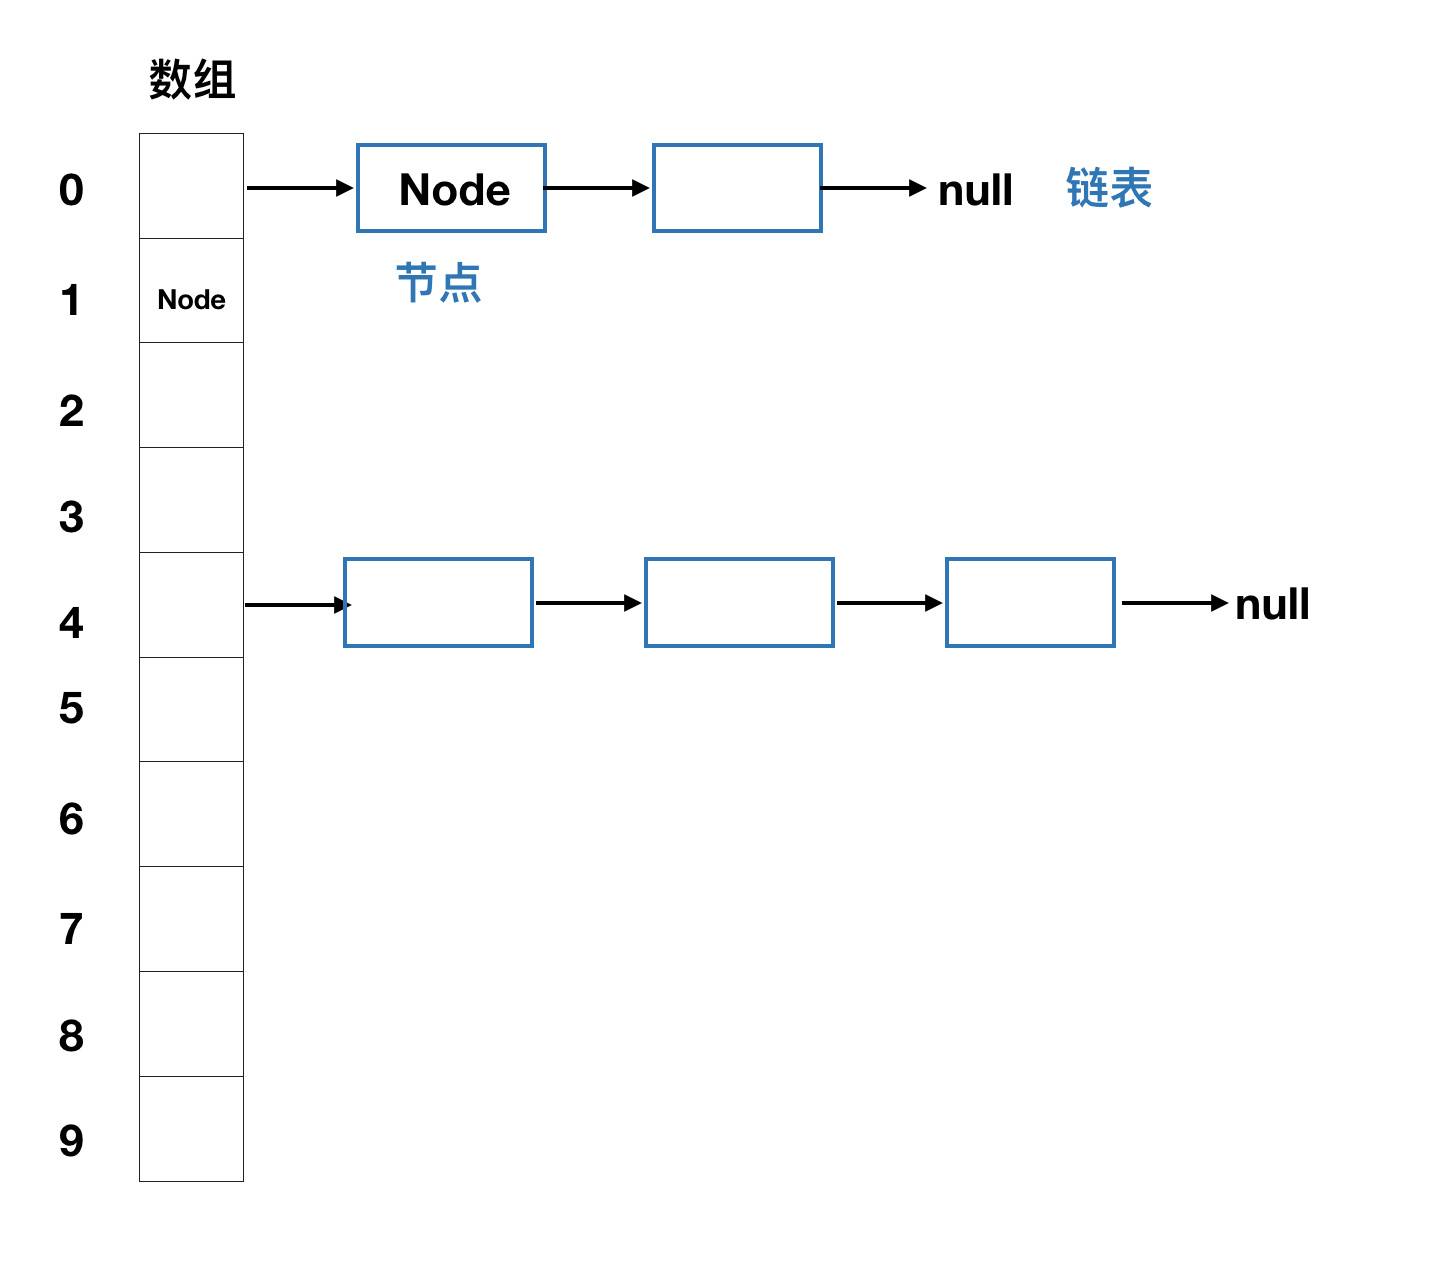
我们都知道,一个数组元素只能保存一个数据,但是多个数据经过哈希运算后可能得到相同的哈希值,所以HashMap会将哈希值相同的数据存放在相同数组位置中的一个链表中。而在取出元素时,HashMap首先会根据哈希值找到数组中的位置,然后遍历其中的链表来找到数据。
Java 8之后
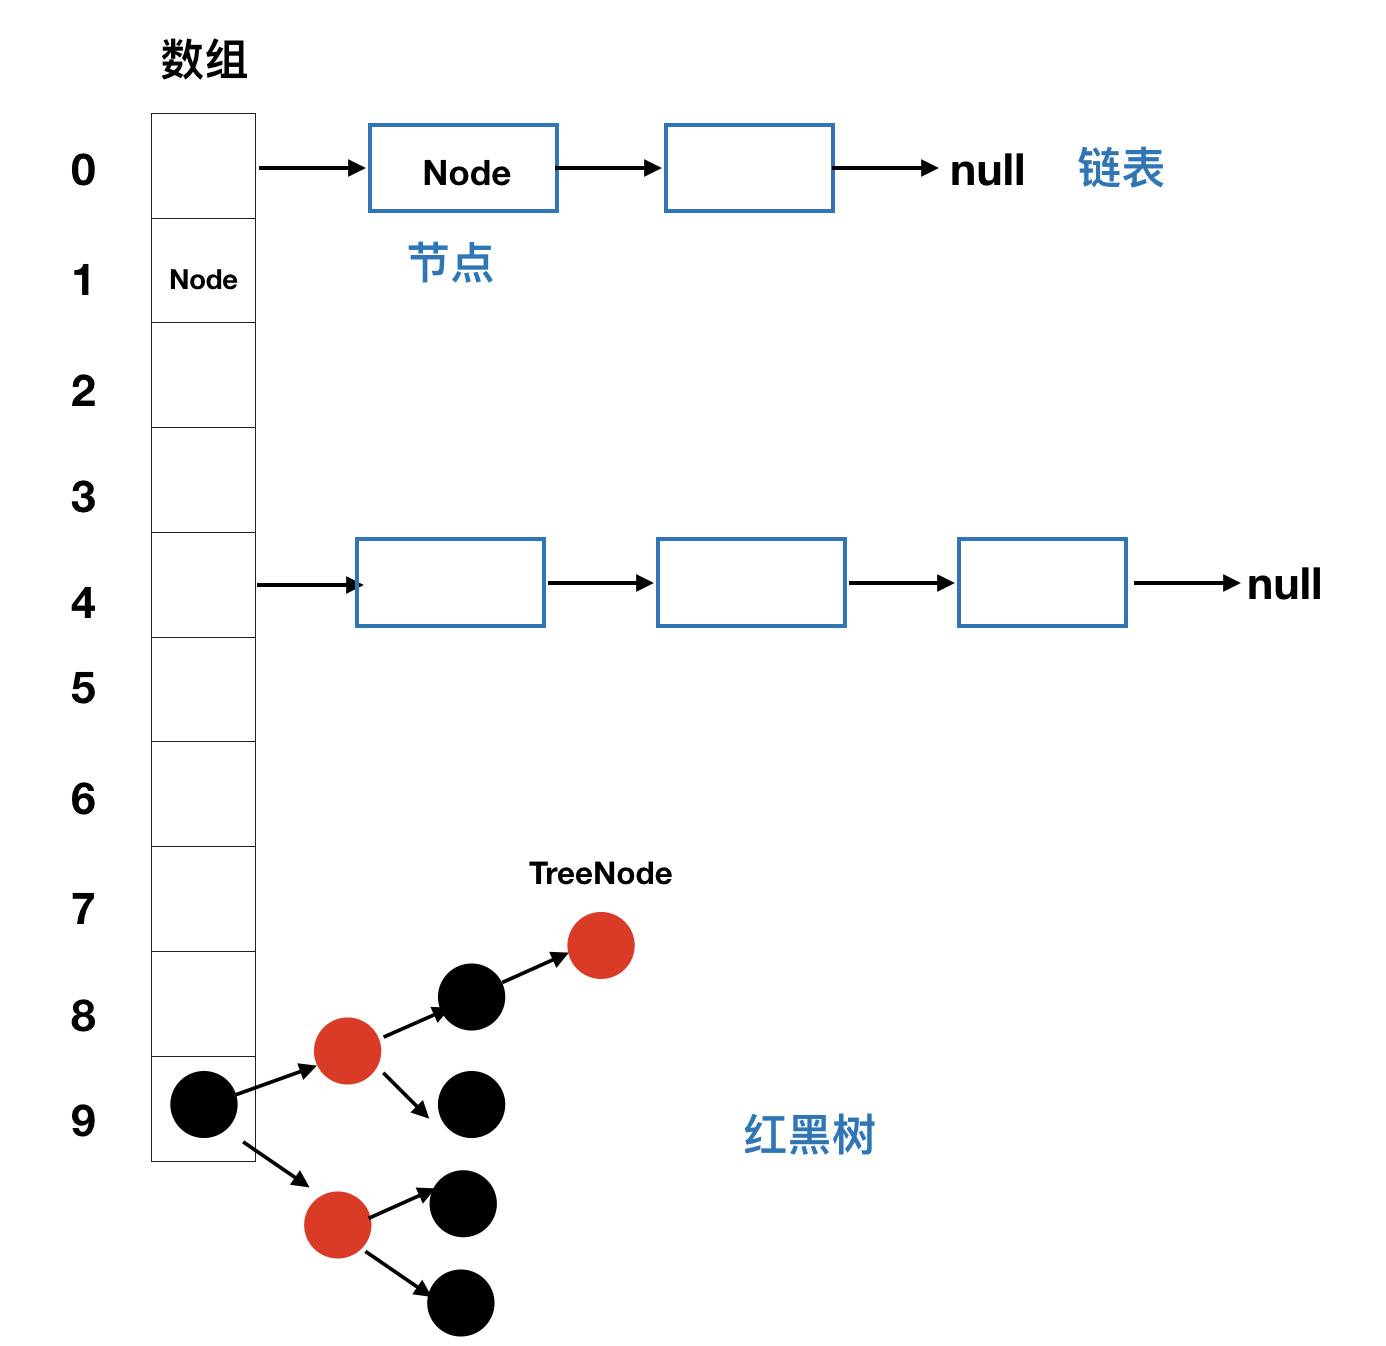
在一个HashMap存储越来越多的数据之后,数据之间发生哈希碰撞的可能性也会越来越大,导致每个数组中的链表也会越来越长,而因为遍历链表操作的时间复杂度是O(n),所以链表越长,遍历的效率就越差。所以在Java 8中,当数组长度大于MIN_TREEIFY_CAPACITY,且某个链表长度大于TREEIFY_THRESHOLD时,这个链表将会被转换成红黑树。
这里依旧借用参考文章1[1:1]中的一幅图:
数据的存储单元
HashMap中定义了一个Node<K,V>型的数组table用于存储数据:
// 这个就是哈希表
transient Node<K,V>[] table;
分别针对树化前和树化后的数据,HashMap定义了不同的内部类作为其数据的存储单元。
树化前
HashMap中定义了一个内部类Node,作为链表中各个元素的存储单元。
/**
 * Basic hash bin node, used for most entries.  (See below for
 * TreeNode subclass, and in LinkedHashMap for its Entry subclass.)
 */
static class Node<K,V> implements Map.Entry<K,V> {
    // 这个节点的哈希,即数组的索引位置
    final int hash;

    // 这个节点所属的key
    final K key;

    // 这个节点的值
    V value;

    // 链表中的下一个元素
    Node<K,V> next;

    Node(int hash, K key, V value, Node<K,V> next) {
        this.hash = hash;
        this.key = key;
        this.value = value;
        this.next = next;
    }

    public final K getKey()        { return key; }
    public final V getValue()      { return value; }
    public final String toString() { return key + "=" + value; }

    // 节点的哈希值通过将key的哈希和value的哈希异或得到
    public final int hashCode() {
        return Objects.hashCode(key) ^ Objects.hashCode(value);
    }

    // 替换这个节点的数据
    public final V setValue(V newValue) {
        V oldValue = value;
        value = newValue;
        return oldValue;
    }

    public final boolean equals(Object o) {
        if (o == this)
            return true;
        if (o instanceof Map.Entry) {
            Map.Entry<?,?> e = (Map.Entry<?,?>)o;
            if (Objects.equals(key, e.getKey()) &&
                Objects.equals(value, e.getValue()))
                return true;
        }
        return false;
    }
}
树化后
针对树化后的红黑树,HashMap定义了一个内部类TreeNode作为树中各个元素的存储单元。但是这个类的代码太长了,放在这里不太合适,后面我再单独开一篇博文专门给它。
构造方法
HashMap提供了四个构造方法,我们下面一个一个来看:
可以指定容量和载荷因子的构造方法
/**
 * Constructs an empty <tt>HashMap</tt> with the specified initial
 * capacity and load factor.
 *
 * @param  initialCapacity the initial capacity
 * @param  loadFactor      the load factor
 * @throws IllegalArgumentException if the initial capacity is negative
 *         or the load factor is nonpositive
 */
public HashMap(int initialCapacity, float loadFactor) {
    // 初始容量不能小于0
    if (initialCapacity < 0)
        throw new IllegalArgumentException("Illegal initial capacity: " +
                                            initialCapacity);
    // 初始容量不能大于最大允许容量
    if (initialCapacity > MAXIMUM_CAPACITY)
        initialCapacity = MAXIMUM_CAPACITY;
    // 载荷因子必须大于等于0,且不能为无穷大(比如0.0f/0.0f)
    if (loadFactor <= 0 || Float.isNaN(loadFactor))
        throw new IllegalArgumentException("Illegal load factor: " +
                                            loadFactor);
    this.loadFactor = loadFactor;
    this.threshold = tableSizeFor(initialCapacity);
}

// 根据期望容量返回一个大于等于cap的扩容阈值,并且保证扩容阈值一定是2的幂次
static final int tableSizeFor(int cap) {
    int n = cap - 1;
    n |= n >>> 1;
    n |= n >>> 2;
    n |= n >>> 4;
    n |= n >>> 8;
    n |= n >>> 16;
    return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}
虽然上面说扩容阈值 = 哈希表容量 * 加载因子,但是有没有发现,上面的构造方法里面其实并没有初始化table?实际上,table在第一次添加数据时才会被初始化,具体的操作我们放到后面再说。
可以指定容量的构造方法
/**
 * Constructs an empty <tt>HashMap</tt> with the specified initial
 * capacity and the default load factor (0.75).
 *
 * @param  initialCapacity the initial capacity.
 * @throws IllegalArgumentException if the initial capacity is negative.
 */
public HashMap(int initialCapacity) {
    this(initialCapacity, DEFAULT_LOAD_FACTOR);
}
这个构造方法就是把默认载荷因子和给定的初始容量传给上面说的那个构造方法,这里就不重复解释了。
无参构造方法
/**
 * Constructs an empty <tt>HashMap</tt> with the default initial capacity
 * (16) and the default load factor (0.75).
 */
public HashMap() {
    // 使用默认的载荷因子
    this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted
}
新增数据
我们知道,HashMap既可以一次只新增一条数据,也可以一次新增多个数据。我们先看它是怎么新增单条数据的。
新增单条数据
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}
乍一看好像很简单的样子,一句话轻飘飘的完成了新增数据的任务。但是要展开看的话,信息量可就很大了。
我们从里面到外面一个一个的看。
计算新元素的哈希值
在上面提到的putVal方法中,第一个参数是这个数据的哈希值。那么这个哈希值是怎么计算出来的呢?在java 8中,hash方法是这么实现的:
static final int hash(Object key) {
    int h;
    // 将key的hashCode与其无符号右移16位之后得到的值做一次异或运算
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
上面这段代码会对key的hashCode做一个扰动计算,来得到这个key在HashMap中的哈希值。这个扰动计算的目的就是为了降低发生哈希碰撞的可能性。
向HashMap中增加数据
在计算完key的哈希值后,putVal方法会开始向HashMap中添加数据。
// hash就是key的哈希
// key就是key值
// value就是被添加的数据
// onlyIfAbsent如果是true则不替换数据
// evict如果是false,则说明是在初始化状态
final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {
    // 将指向哈希表
    Node<K,V>[] tab;

    // 在计算完本次要操作的哈希表下标后
    // p将指向哈希表的这个下标中的数据
    Node<K,V> p;

    // n将是哈希表的长度
    // 在计算完本次要操作的哈希表下标后,i将是这个下标值
    int n, i;

    // 先检查哈希表是不是还没有被初始化过,或者哈希表长度为0
    if ((tab = table) == null || (n = tab.length) == 0)
        // 对哈希表进行首次扩容,即初始化
        n = (tab = resize()).length;
    // 经过i = (n - 1) & hash这步运算得到本次插入的位置,即哈希表的数组下标
    // 如果这个位置尚没有元素,说明没有发生哈希碰撞
    // 那么就直接将插入的数据放在这个位置
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    // 如果这个位置已经有元素存在了,那就说明发生了哈希碰撞
    else {
        Node<K,V> e; K k;

        // 如果哈希相同,且key值相同,则覆盖这个元素
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            e = p;

        // 如果哈希表的这个位置已经被变成红黑树了
        // 那么就要调用红黑树版本的putVal,即putTreeVal来完成插入操作
        else if (p instanceof TreeNode)
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);

        // 在哈希相同,key却不同的时候
        else {

            // 循环整个单链表,同时使用binCount记录单链表的节点数量
            for (int binCount = 0; ; ++binCount) {

                // 在单链表尾部拼接本次插入的数据
                if ((e = p.next) == null) {
                    p.next = newNode(hash, key, value, null);

                    // 如果单链表的节点数量大于等于树化阈值时,就将这个单链表进行树化
                    if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
                        treeifyBin(tab, hash);
                    break;
                }

                // 如果在遍历过程中发现有数据的key与本次操作的key相同
                // 此时e指向要被替换value的节点,并结束遍历
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    break;
                p = e;
            }
        }

        // 如果e != null,说明需要替换e所指节点的数据
        if (e != null) { // existing mapping for key
            V oldValue = e.value;
            if (!onlyIfAbsent || oldValue == null)
                e.value = value;
            // 这个方法在HashMap中是空实现
            // 但是LinkedHashMap中会有实现
            afterNodeAccess(e);
            return oldValue;
        }
    }

    // fail-fast机制
    ++modCount;

    // 如果哈希表长度大于扩容阈值,则对哈希表扩容
    if (++size > threshold)
        resize();
    // 这个方法在HashMap中也是空的
    afterNodeInsertion(evict);
    return null;
}
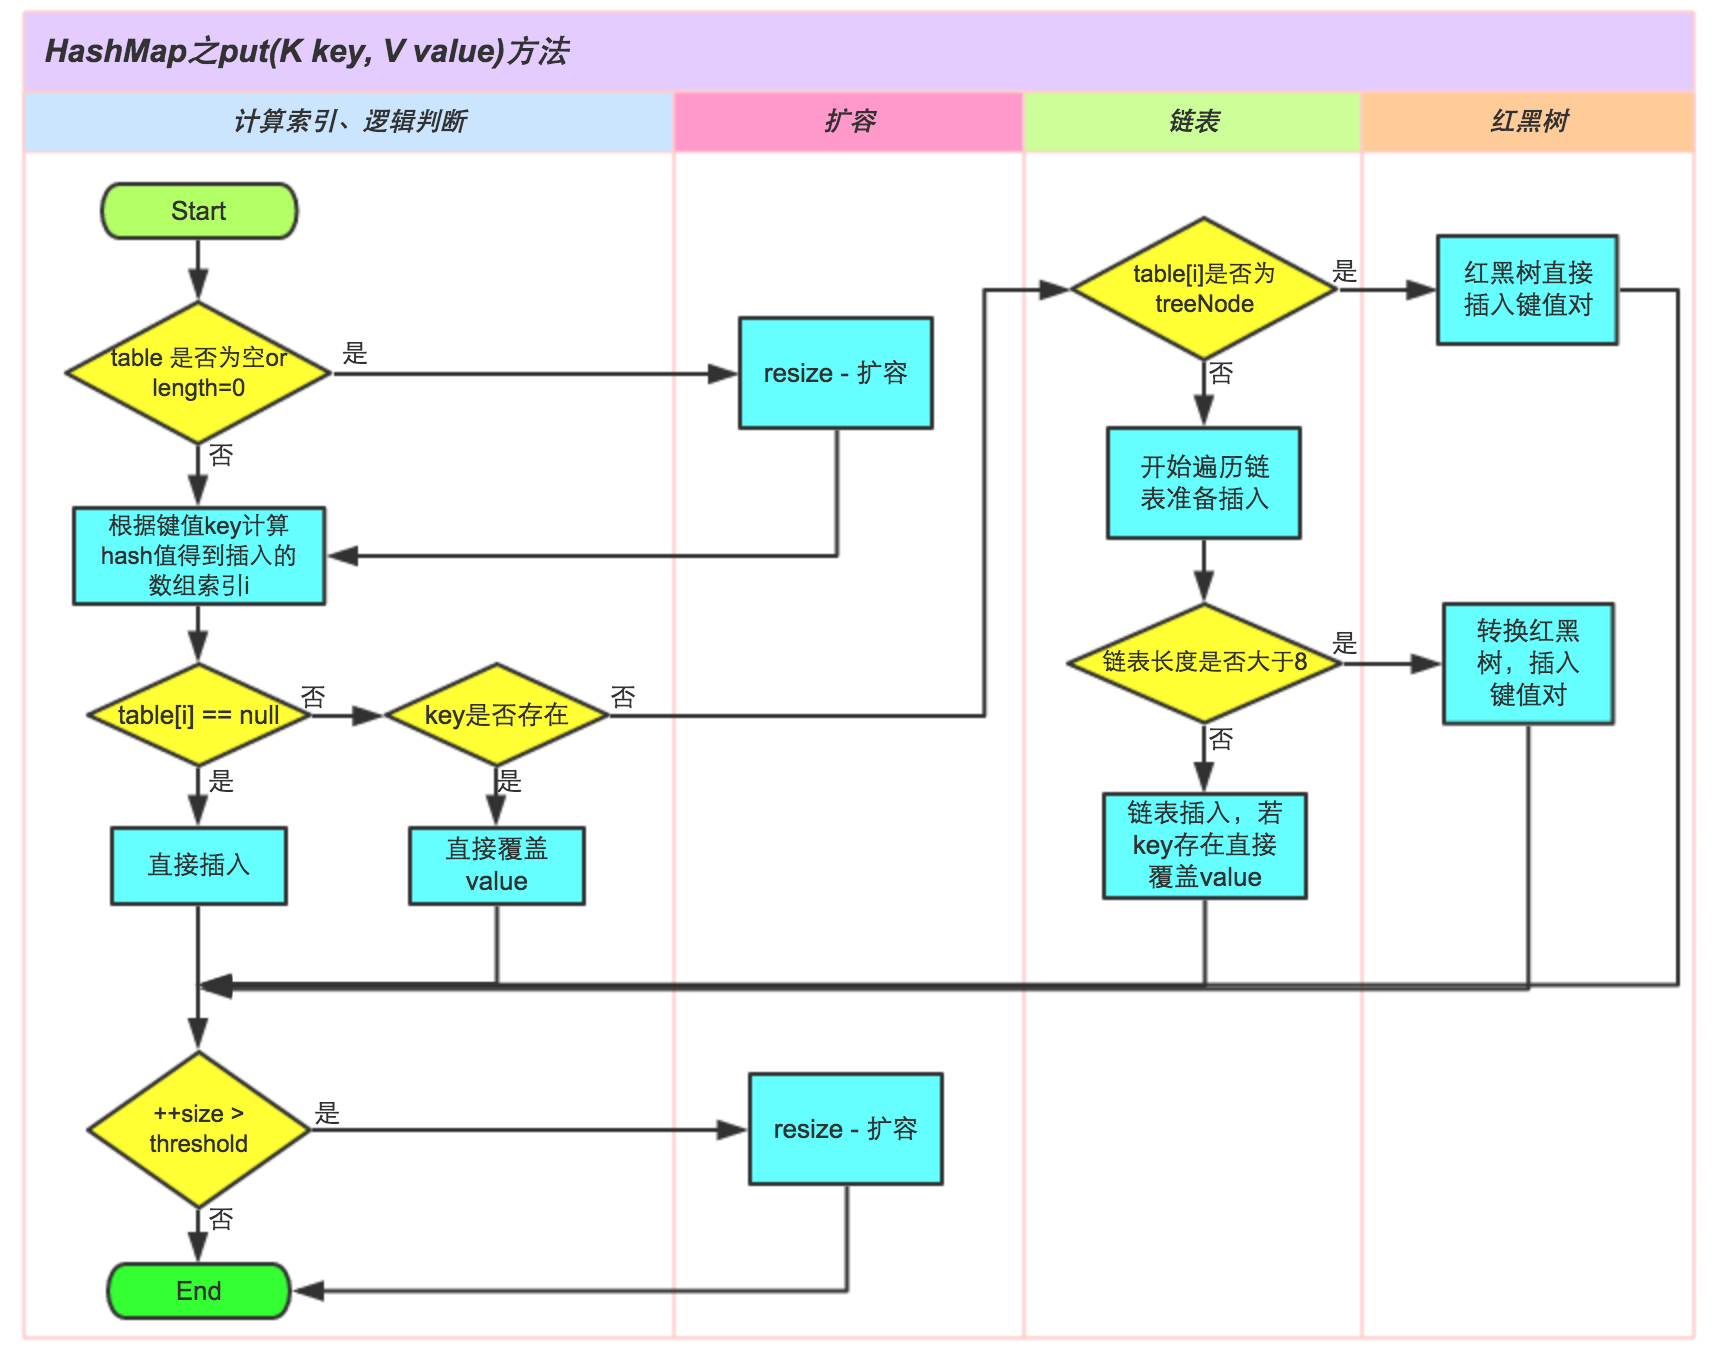
上面代码可能看起来比较费劲,这里借用美团博客的一张图来展示put方法的执行流程:
新增多条数据
public void putAll(Map<? extends K, ? extends V> m) {
    putMapEntries(m, true);
}
依旧是调用了另一个方法实现的添加数据。那么继续深入进去看看。
final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) {
    // 传入的map的长度
    int s = m.size();

    // 如果传入的map有数据,才进行后面的运算
    if (s > 0) {
        // 如果哈希表尚未初始化,则先计算扩容阈值
        if (table == null) { // pre-size
            float ft = ((float)s / loadFactor) + 1.0F;
            int t = ((ft < (float)MAXIMUM_CAPACITY) ?
                        (int)ft : MAXIMUM_CAPACITY);
            if (t > threshold)
                threshold = tableSizeFor(t);
        }

        // 如果哈希表已经初始化完成,但是传入的map的大小超过了扩容阈值
        // 那么就将哈希表扩容
        else if (s > threshold)
            resize();

        // 遍历传入的map,然后逐个调用putVal方法增加元素
        for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) {
            K key = e.getKey();
            V value = e.getValue();
            putVal(hash(key), key, value, false, evict);
        }
    }
}
HashMap扩容
上面多次提到了HashMap的扩容操作,这里我们就详细看看它是怎么扩容的。
final Node<K,V>[] resize() {
    // oldTab指向扩容前的哈希表
    Node<K,V>[] oldTab = table;
    // oldCap是扩容前的哈希表容量,如果哈希表尚未被初始化,那么容量就是0
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    // oldThr是扩容前的扩容阈值
    int oldThr = threshold;
    // newCap为扩容后的容量,newThr是扩容后的扩容阈值
    int newCap, newThr = 0;
    if (oldCap > 0) {
        // 如果扩容前的哈希表容量已经是最大容量
        if (oldCap >= MAXIMUM_CAPACITY) {
            // 那么就将扩容阈值设为Integer.MAX_VALUE
            threshold = Integer.MAX_VALUE;
            // 并停止扩容
            return oldTab;
        }
        // 新容量是旧容量的2倍,且新的扩容阈值也是旧扩容阈值的2倍
        else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                    oldCap >= DEFAULT_INITIAL_CAPACITY)
            newThr = oldThr << 1; // double threshold
    }
    // 如果旧的扩容阈值大于0
    // 而同时旧的容量等于0
    // 那么说明已经使用带参数的构造方法设定了载荷因子和初始容量
    // 而且这次是首次扩容
    // 此时初始容量不等于期望容量,且大于期望容量
    else if (oldThr > 0) // initial capacity was placed in threshold
        // 设定新的容量等于旧的扩容阈值
        newCap = oldThr;
    // 如果旧的扩容阈值是0
    // 而同时旧的容量等于0
    // 那么说明这个HashMap是用默认构造方法初始化的
    // 而且这次是首次扩容
    else {               // zero initial threshold signifies using defaults
        // 那么新的容量就等于默认初始容量
        newCap = DEFAULT_INITIAL_CAPACITY;
        // 新的扩容阈值等于(默认载荷因子 * 默认初始容量)
        newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
    }

    // 如果新的扩容阈值是0
    // 对应当前table为空,但是有阈值的情况
    // 那么就计算新的扩容阈值
    if (newThr == 0) {
        float ft = (float)newCap * loadFactor;
        newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
                    (int)ft : Integer.MAX_VALUE);
    }

    // 更新HashMap的扩容阈值
    threshold = newThr;

    // 使用扩容后的容量创建一个新的哈希表
    @SuppressWarnings({"rawtypes","unchecked"})
    Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];

    // 将HashMap的哈希表指向新的哈希表
    table = newTab;

    // 如果旧的哈希表不为null
    // 则进行重新插入操作
    if (oldTab != null) {
        // 遍历旧的哈希表
        for (int j = 0; j < oldCap; ++j) {
            // 存储旧的哈希表对应位置中链表的头节点
            Node<K,V> e;
            // 如果这个位置有数据
            if ((e = oldTab[j]) != null) {
                // 释放掉旧的链表中的空间
                oldTab[j] = null;
                // 如果这个链表中只有一个节点
                if (e.next == null)
                    // 则使用新哈希表的长度计算下标,并插入
                    newTab[e.hash & (newCap - 1)] = e;
                // 如果这个节点是个红黑树
                // 那么需要选择是拆分这个红黑树,或者将其非树化
                else if (e instanceof TreeNode)
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                // 如果这个链表有数个节点
                else { // preserve order
                    // 因为扩容后的容量是扩容前容量的2倍
                    // 所以原链表上的节点,既有可能会被放在它原来的位置上(低位)
                    // 也有可能会被放到扩容后新增加的位置上(高位 = 低位 + 旧的容量)

                    // 低位链表的头节点和尾节点
                    Node<K,V> loHead = null, loTail = null;
                    // 高位链表的头节点和尾节点
                    Node<K,V> hiHead = null, hiTail = null;
                    // 存放原来链表中的节点
                    Node<K,V> next;

                    // 遍历旧的链表
                    do {
                        next = e.next;
                        // 利用哈希值和旧的容量进行与运算
                        // 如果结果等于0,那么就拼接到低位链表的末尾
                        if ((e.hash & oldCap) == 0) {
                            if (loTail == null)
                                loHead = e;
                            else
                                loTail.next = e;
                            loTail = e;
                        }
                        // 否则拼接到高位链表的末尾
                        else {
                            if (hiTail == null)
                                hiHead = e;
                            else
                                hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);

                    // 如果低位链表非空,则将链表放到原位置
                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    // 如果高位链表非空,则将链表放到新增加的位置
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}
查询数据
public V get(Object key) {
    Node<K,V> e;
    return (e = getNode(hash(key), key)) == null ? null : e.value;
}

public V getOrDefault(Object key, V defaultValue) {
    Node<K,V> e;
    return (e = getNode(hash(key), key)) == null ? defaultValue : e.value;
}

final Node<K,V> getNode(int hash, Object key) {
    Node<K,V>[] tab; Node<K,V> first, e; int n; K k;
    // 检查哈希表是不是空
    // 以及哈希表中对应下标的第一个元素是不是null,即这个位置是否有节点
    if ((tab = table) != null && (n = tab.length) > 0 &&
        (first = tab[(n - 1) & hash]) != null) {
        // 因为第一个节点无所谓是链表节点还是红黑树节点
        // 所以先用一个简单的办法检查第一个节点是不是要找的节点
        if (first.hash == hash && // always check first node
            ((k = first.key) == key || (key != null && key.equals(k))))
            // 如果是,就直接返回
            return first;
        // 如果第一个节点不是要找的节点
        // 而且它后面有别的节点
        if ((e = first.next) != null) {
            // 如果后面的节点是红黑树,那么调用红黑树的方法取寻找
            if (first instanceof TreeNode)
                return ((TreeNode<K,V>)first).getTreeNode(hash, key);
            // 否则遍历这个链表,寻找符合要求的节点并返回
            do {
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    return e;
            } while ((e = e.next) != null);
        }
    }
    return null;
}
删除数据
// 匹配key来删除
public V remove(Object key) {
    Node<K,V> e;
    return (e = removeNode(hash(key), key, null, false, true)) == null ?
        null : e.value;
}

// 同时匹配key和value来删除
public boolean remove(Object key, Object value) {
    return removeNode(hash(key), key, value, true, true) != null;
}

final Node<K,V> removeNode(int hash, Object key, Object value, boolean matchValue, boolean movable) {
    Node<K,V>[] tab; Node<K,V> p; int n, index;
    // 检查哈希表是不是空
    // 以及哈希表中对应下标的第一个元素是不是null,即这个位置是否有节点
    if ((tab = table) != null && (n = tab.length) > 0 &&
        (p = tab[index = (n - 1) & hash]) != null) {
        Node<K,V> node = null, e; K k; V v;
        // 先检查链表中第一个元素是否匹配
        // 如果匹配就直接取出来
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            node = p;
        // 否则继续向后遍历
        else if ((e = p.next) != null) {
            if (p instanceof TreeNode)
                // 如果后续的节点是红黑树,那么使用红黑树的方法寻找匹配的节点
                node = ((TreeNode<K,V>)p).getTreeNode(hash, key);
            else {
                // 否则遍历链表,根据hash和key寻找节点
                do {
                    if (e.hash == hash &&
                        ((k = e.key) == key ||
                            (key != null && key.equals(k)))) {
                        node = e;
                        break;
                    }
                    p = e;
                } while ((e = e.next) != null);
            }
        }

        // 如果取到了节点,则开始删除
        // (!matchValue || (v = node.value) == value || (value != null && value.equals(v)))构成了一个判断链条
        if (node != null && (!matchValue || (v = node.value) == value ||
                                (value != null && value.equals(v)))) {
            if (node instanceof TreeNode)
                ((TreeNode<K,V>)node).removeTreeNode(this, tab, movable);
            else if (node == p)
                tab[index] = node.next;
            else
                p.next = node.next;
            ++modCount;
            --size;
            afterNodeRemoval(node);
            return node;
        }
    }
    return null;
}
迭代HashMap
HashMap提供了多种迭代的方式,比如迭代EntrySet,或者迭代KeySet。
迭代KeySet
在迭代KeySet的时候,我们可以逐个得到HashMap中的key,然后根据key来进行操作。
// 返回一个KeySet实例
public Set<K> keySet() {
    Set<K> ks = keySet;
    if (ks == null) {
        ks = new KeySet();
        keySet = ks;
    }
    return ks;
}

final class KeySet extends AbstractSet<K> {
    // 得到KeySet的长度,也是HashMap的长度
    public final int size()                 { return size; }
    // 可以清空这个HashMap
    public final void clear()               { HashMap.this.clear(); }
    // 得到一个KeyIterator迭代器
    public final Iterator<K> iterator()     { return new KeyIterator(); }
    // 检查是否包含某个key
    public final boolean contains(Object o) { return containsKey(o); }
    // 根据key删除某个节点
    public final boolean remove(Object key) {
        return removeNode(hash(key), key, null, false, true) != null;
    }
    public final Spliterator<K> spliterator() {
        return new KeySpliterator<>(HashMap.this, 0, -1, 0, 0);
    }
    public final void forEach(Consumer<? super K> action) {
        Node<K,V>[] tab;
        if (action == null)
            throw new NullPointerException();
        if (size > 0 && (tab = table) != null) {
            int mc = modCount;
            for (int i = 0; i < tab.length; ++i) {
                for (Node<K,V> e = tab[i]; e != null; e = e.next)
                    action.accept(e.key);
            }
            if (modCount != mc)
                throw new ConcurrentModificationException();
        }
    }
}

final class KeyIterator extends HashIterator implements Iterator<K> {
    // 得到下一个节点的key
    public final K next() { return nextNode().key; }
}
迭代EntrySet
在迭代EntrySet的时候,我们可以同时得到一个节点的key和value。
// 返回一个EntrySet实例
public Set<Map.Entry<K,V>> entrySet() {
    Set<Map.Entry<K,V>> es;
    return (es = entrySet) == null ? (entrySet = new EntrySet()) : es;
}

final class EntrySet extends AbstractSet<Map.Entry<K,V>> {
    // 得到EntrySet的大小,即HashMap的大小
    public final int size()                 { return size; }
    // 可以清空这个HashMap
    public final void clear()               { HashMap.this.clear(); }
    // 得到一个EntryIterator迭代器
    public final Iterator<Map.Entry<K,V>> iterator() {
        return new EntryIterator();
    }
    // 检查EntrySet中是否包含某个Entry
    public final boolean contains(Object o) {
        if (!(o instanceof Map.Entry))
            return false;
        Map.Entry<?,?> e = (Map.Entry<?,?>) o;
        Object key = e.getKey();
        Node<K,V> candidate = getNode(hash(key), key);
        return candidate != null && candidate.equals(e);
    }
    // 根据传入的Entry在HashMap中匹配并删除对应的节点
    public final boolean remove(Object o) {
        if (o instanceof Map.Entry) {
            Map.Entry<?,?> e = (Map.Entry<?,?>) o;
            Object key = e.getKey();
            Object value = e.getValue();
            return removeNode(hash(key), key, value, true, true) != null;
        }
        return false;
    }
    public final Spliterator<Map.Entry<K,V>> spliterator() {
        return new EntrySpliterator<>(HashMap.this, 0, -1, 0, 0);
    }
    public final void forEach(Consumer<? super Map.Entry<K,V>> action) {
        Node<K,V>[] tab;
        if (action == null)
            throw new NullPointerException();
        if (size > 0 && (tab = table) != null) {
            int mc = modCount;
            for (int i = 0; i < tab.length; ++i) {
                for (Node<K,V> e = tab[i]; e != null; e = e.next)
                    action.accept(e);
            }
            if (modCount != mc)
                throw new ConcurrentModificationException();
        }
    }
}

final class EntryIterator extends HashIterator implements Iterator<Map.Entry<K,V>> {
    // 得到下一个节点的Entry
    public final Map.Entry<K,V> next() { return nextNode(); }
}
HashIterator
为什么上面看到KeyIterator和EntryIterator就停止了呢?因为它们两个都是继承于HashIterator,这里我们集中看一下。
abstract class HashIterator {
    Node<K,V> next;        // 下一个要返回的Entry
    Node<K,V> current;     // 当前的Entry
    int expectedModCount;  // 结合modCount实现fast-fail机制
    int index;             // 当前哈希表的下标

    HashIterator() {
        // 取迭代时的modCount
        expectedModCount = modCount;
        // 指向当前的哈希表
        Node<K,V>[] t = table;
        current = next = null;
        index = 0;
        // 从哈希表中第一个不为空的位置获取第一个Entry
        if (t != null && size > 0) { // advance to first entry
            do {} while (index < t.length && (next = t[index++]) == null);
        }
    }

    // 返回是否还有节点可供迭代
    public final boolean hasNext() {
        return next != null;
    }

    // 获取下一个节点
    final Node<K,V> nextNode() {
        Node<K,V>[] t;
        Node<K,V> e = next;
        if (modCount != expectedModCount)
            throw new ConcurrentModificationException();
        if (e == null)
            throw new NoSuchElementException();
        // 如果当前链表被遍历完了,那么就寻找下一个不是null的链表头
        if ((next = (current = e).next) == null && (t = table) != null) {
            do {} while (index < t.length && (next = t[index++]) == null);
        }
        return e;
    }

    // 删除当前被迭代的节点
    public final void remove() {
        Node<K,V> p = current;
        if (p == null)
            throw new IllegalStateException();
        if (modCount != expectedModCount)
            throw new ConcurrentModificationException();
        current = null;
        K key = p.key;
        // 删除节点
        removeNode(hash(key), key, null, false, false);
        // 同步新的modCount
        expectedModCount = modCount;
    }
}
从上面迭代时的算法可以看到,迭代器总是先遍历当前的链表或者红黑树,然后再去遍历哈希表,也就是说,它采用的是深度优先的算法。

 浙公网安备 33010602011771号