redis入门
Redis是一款内存高速缓存数据库. 使用C语言编写, 是一个key-value存储系统(键值存储系统), 支持丰富的数据类型, 如: String、list、set、zset、hash. 可用于缓存, 事件发布或订阅, 高速队列等场景.
1. 数据类型
- String(字符串):Redis最基本的数据类型, 一个键对应一个值, 一个键值最大存储512MB
- Hash(哈希):hash是一个键值对的集合, 是一个String类型的field和value的映射表, 适合用于存储对象
- List(列表):是redis的简单的字符串列表, 按插入顺序排序
- Set(集合):是String字符串类型的无序集合, 也不可重复
- ZSet(sorted set 有序集合)是String类型的有序集合, 也不可重复。有序集合中的每个元素都需要指定一个分数, 根据分数对元素进行升序排序。
2. 常用命令
2. 常用命令
| 类型 | 命令 | 描述 |
|---|---|---|
| keys | DEL key | 该命令用于在key存在时删除key。 |
| keys | EXISTS key | 检查给定key是否存在。 |
| string | set key value | 设置指定key的值 |
| string | get key | 获取指定key的值。 |
| string | getrange key start end | 返回key中字符串值的子字符 |
| string | getset key value | 将给定key的值设为value, 并返回key的旧值(old value)。 |
| string | mget key1 [key2..] | 获取所有(一个或多个)给定key的值。 |
| string | mset key value [key value ...] | 同时设置一个或多个 key-value 对。 |
| string | incr key | 将key中储存的数字值增一。 |
| string | decr key | 将key中储存的数字值减一。 |
| hash | hget key field | 获取存储在哈希表中指定字段的值。 |
| hash | hmget key field1 [field2] | 获取所有给定字段的值 |
| hash | hgetall key | 获取在哈希表中指定key的所有字段和值 |
| hash | hset key field value | 将哈希表key中的字段field的值设为value。 |
| hash | hmset key field1 value1 [field2 value2 ] | 同时将多个field-value(域-值)对设置到哈希表key中。 |
| hash | hdel key field1 [field2] | 删除一个或多个哈希表字段 |
| hash | hexists key field | 查看哈希表key中, 指定的字段是否存在。 |
| hash | hkeys key | 获取所有哈希表中的字段 |
| list | rpush(lpush) key value1 [value2] | 在列表的尾部(头部)添加一个或多个值 |
| list | rpop(lpop) key | 从列表的尾部(头部)删除一个值, 并返回该值 |
| list | lrange key start stop | 获取列表指定范围内的元素 |
| list | lset key index value | 通过索引设置列表元素的值 |
| list | lrem key count value | 移除列表元素 |
| set | sadd key member1 [member2] | 向集合添加一个或多个成员 |
| set | spop key | 移除并返回集合中的一个随机元素 |
| set | srem key member1 [member2] | 移除集合中一个或多个成员 |
| set | smembers key | 返回集合中的所有成员 |
| sorted set | zadd key score1 member1 [score2 member2] | 向有序集合添加一个或多个成员, 或者更新已存在成员的分数 |
| sorted set | zrem key member [member ...] | 移除有序集合中的一个或多个成员 |
| sorted set | zremrangebyrank key start stop | 移除有序集合中给定的排名区间的所有成员 |
| sorted set | zrevrank key member | 返回有序集合中指定成员的排名, 有序集成员按分数值递减(从大到小)排序 |
| sorted set | zcard key | 获取有序集合的成员数 |
3. 持久化
3.1 RDB持久化
save与bgsave命令用于创建当前数据库的备份, 将内存中的数据和操作通过快照的方式保存到dump.rdb的文件中. 也可以通过配置save [second] [changes], rdbcompression与dbfilename让redis进行自动保存(其实也是调用bgsave). 需要注意的是, save指令使用同步方式执行备份, 会阻塞redis. 而bgsave会启动新的进程, 以异步方式执行备份.
3.2 AOF持久化
AOF持久化是redis将接收到的写命令添加到AOF文件的末尾(默认是 appendonly.aof), 以此来记录数据发送的变化. 但由于需要将所有的写命令记录到文件中, 势必会造成aof文件过大, 此时可以发送bgrewriteaof命令, 通过移除aof中冗余的命令来进行aof文件重写. bgrewriteaof与bgsave的工作原理类似, 也是通过创建一个子进程来进行aof文件的重写. 同样的, 也可以通过配置auto-aof-rewrite-percentage与auto-aof-rewrite-min-size让redis自动进行aof文件重写.
| 选项 | 同步频率 |
|---|---|
| always | 每个写命令都会被同步到硬盘中 |
| everysec | 每秒执行一次同步, 显式的将多个写命令同步到硬盘中 |
| no | 让系统来决定何时进行同步 |
3.3 两者优缺点
| 持久化方式 | RBD | AOF |
|---|---|---|
| 占用存储空间 | 小 | 大 |
| 存储速度 | 慢 | 快 |
| 恢复速度 | 快 | 慢 |
| 数据安全性 | 会丢失数据 | 依据同步策略决定 |
| 资源消耗 | 高 | 低 |
| 启动优先级 | 低 | 高 |
4. redis事务
redis事务可以分为以下几个命令: multi(标记一个事务块的开始), exec(执行所有事务块内的命令), discard(取消事务).
redis的事务可以理解为一个打包的批量执行脚本, 中间某条指令的失败(如果某条指令中含有语法错误, 整个事务都会被强制取消)并不会导致前面已经执行的指令进行回滚, 也不会导致后续的指令不执行.
watch key1 [key2 ...]用于对key添加监视锁, 如果在exec执行前key发生了变化, 将会终止当前事务(需要在开启事务前执行watch). 相对的, unwatch用于取消所有key的监视.
5. 删除策略
redis的删除策略不是为了让数据及时的清除以节省内存, 而是在内存占用与cpu占用之间寻找一种平衡, 防止在cpu繁忙时进行删除操作从而导致redis性能下降, 甚至引发宕机.
定时删除
当key设置有过期时间时, 为该key创建一个定时器,让定时器在key的过期时间来临时,对key进行删除
优点: 节约内存, 快速释放不必要的内存占用
缺点: 删除会占用过多的cpu时间, 在cpu高负债的情况下, 严重影响性能; 定时器创建耗时, 严重影响性能.
总结: 用cpu占用换内存占用
惰性删除
key过期的时候不删除,下次获取key的时候去检查是否过期,若过期,则删除,返回null。
优点: 节约cpu性能, 发现必须删除时才进行删除操作
缺点: 内存压力大, 出现长期占用内存的数据
总结: 用内存占用换cpu占用
定期删除
每隔一段时间执行一次删除过期key操作
当redis服务启动后, 读取配置中的server.hz(默认为10), 每秒执行N(配置中的server.hz)次serverCorn函数. 其内部调用activeExpireCycle函数, 它在规定时间内(250ms/server.hz)分多次遍历服务器中的各个数据库, 从数据库的expires字典中随机检查W(配置ACTIVE_EXPIRE_CYCLE_LOOKUPS_PRE_LOOP)个key的过期时间, 如果key超时, 删除key.
如果本次删除的key数量大于W * 25%, 继续循环该过程, 从剩余的key中检查过期时间并进行删除过期key. 如果本轮删除的key小于W * 25%, 继续下一个数据库的expires字典的过期检查.
优点: cpu占用设有峰值(1秒内最多只有250ms进行删除操作), 并且内存压力也不是很大(长期占用内存的数据会被持续清除)
总结: 周期性检验过期key
6. 数据逐出算法
redis使用内存储存数据, 在执行每一个命令前, 调用freeMemoryIfNeeded函数检测内存是否充足, 当内存不足时, 需要临时删除一些数据. 清理数据的策略称之为逐出算法.
需要注意的是, 逐出数据的过程并不是100%能够清理出足够的内存, 如果不成功则反复执行, 当对所有数据尝试完毕后, 如果不能达到内存清理的要求, 将会出现错误信息.
影响数据逐出的相关配置:
- maxmemory: 最大可使用内存, 占用物理内存的比例, 默认为0, 表示不限制, 通常设置在50%以上
- maxmemory-samples: 每次选取待删除数据的个数, 选取数据时并不会全库扫描, 导致严重的性能消耗, 因此采用随机获取数据的方式作为待检测删除数据.
- maxmemory-policy: 删除策略, 达到最大内存后, 对被挑选出来的数据进行删除的策略.
maxmemory-policy (删除策略)
检查易失数据(可能会过期的数据集server.db[i].expire)
- volatile-lru: 最近最少使用(离当前时间最远的数据将会被删除)
- volatile-lfu: 最不经常使用(特定时间内使用次数最少的将会被删除)
- volatile-ttl: 将要过期的数据
- volatile-random: 随机选择
检查全库数据(所有数据集server.db[i].dict)
- allkeys-lru: 最近最少使用(离当前时间最远的数据将会被删除)
- allkeys-lfu: 最不经常使用(特定时间内使用次数最少的将会被删除)
- allkeys-random: 随机选择
放弃数据逐出
- no-enviction: 禁止驱逐数据(redis4.0中默认策略), 会引发oom
7. 集群
7.1 主从复制
将master中的数据有效的复制到slave中, 一个master可以拥有多个slave, 一个slave对应一个master. 主要作用:
1. 读写分离, master写,slave读
2. 负载均衡, 由slave分担master负载, 根据需求, 改变slave的数量从而分担数据读取负载.
3. 故障恢复: 当master出现问题, 由slave提供服务, 实现快速的故障恢复
4. 数据冗余, 实现数据热备份, 是持久化之外的一种数据冗余方式
5. 高可用基石, 基于主从复制, 构建哨兵模式与集群
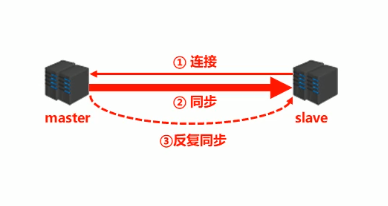
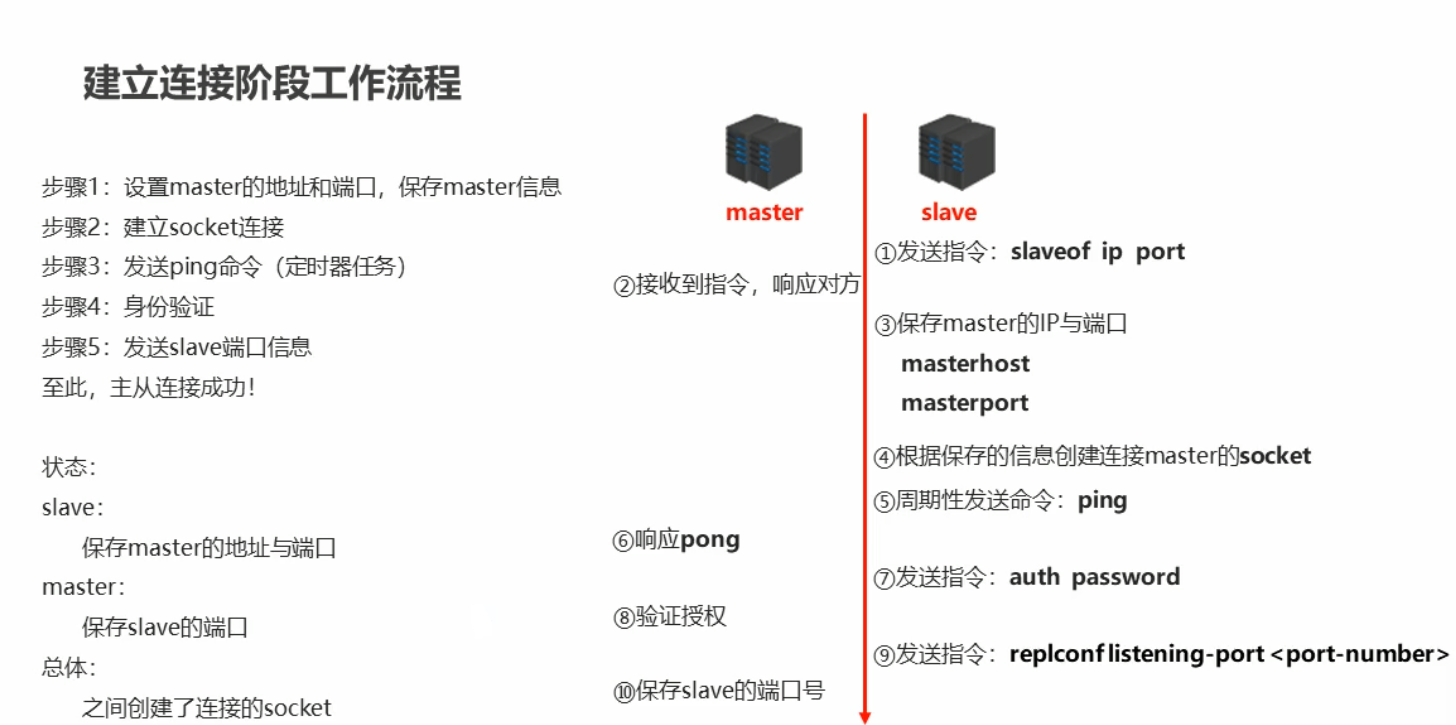
7.1.1 阶段一: 建立连接阶段
7.1.2 阶段二: 数据同步阶段
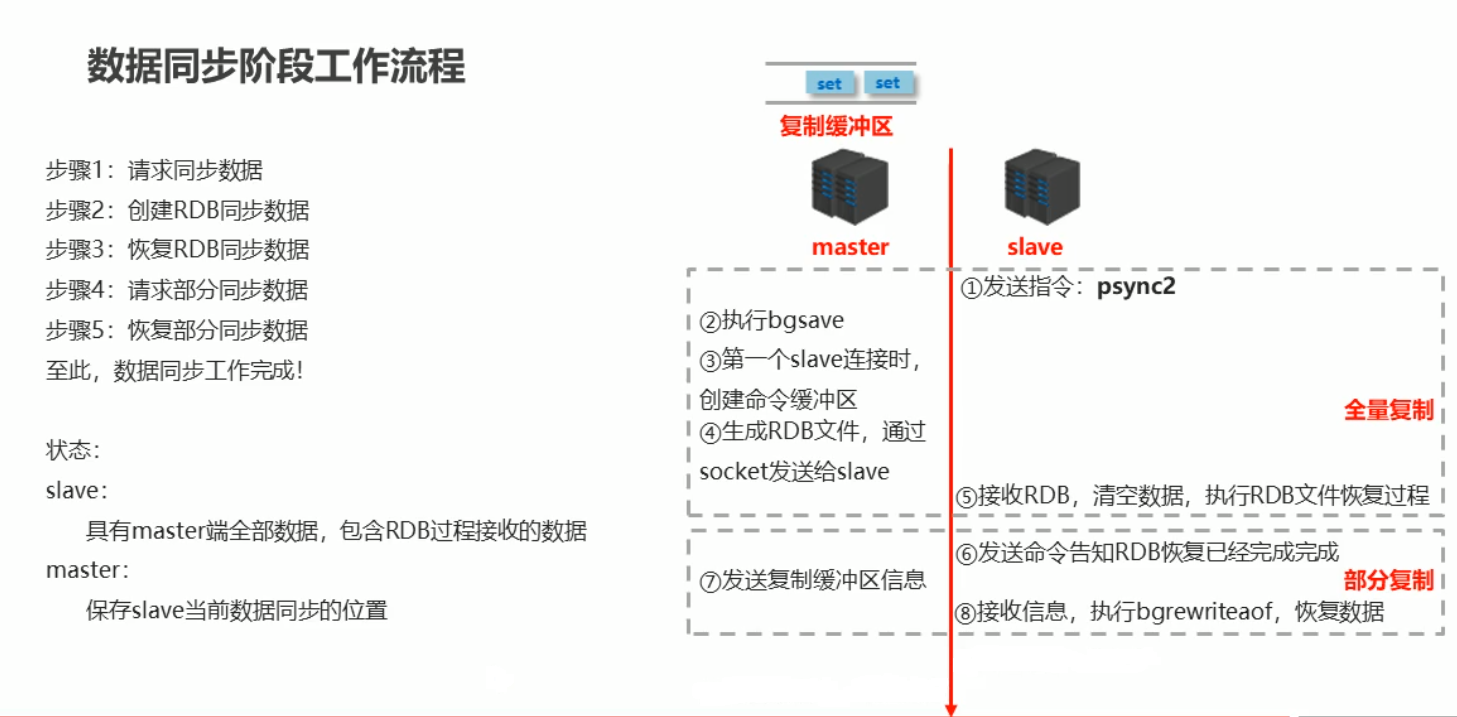
需要注意的是:
- 如果master数据量比较大, 数据同步阶段需要避免高峰期, 以免造成master阻塞.
- 复制缓冲区大小设定不合理, 会导致数据溢出, 如果进行全量复制的过程太长, 进行部分复制时发现数据已经存在丢失的情况, 必须进行第二次全量复制, 从而导致slave陷入死循环. (可以修改缓冲区大小
repl-backlog-size(默认1mb)) - 当slave过多时, 建议由一主多从改为树状结构, 中间结点既是master, 也是slave. 需要注意的是, 在使用树状结构时, 由于层级深度, 导致深度越高的slave与最顶层的master之间数据同步出现延迟, 数据一致性变差.
7.1.3 阶段三: 命令传播阶段
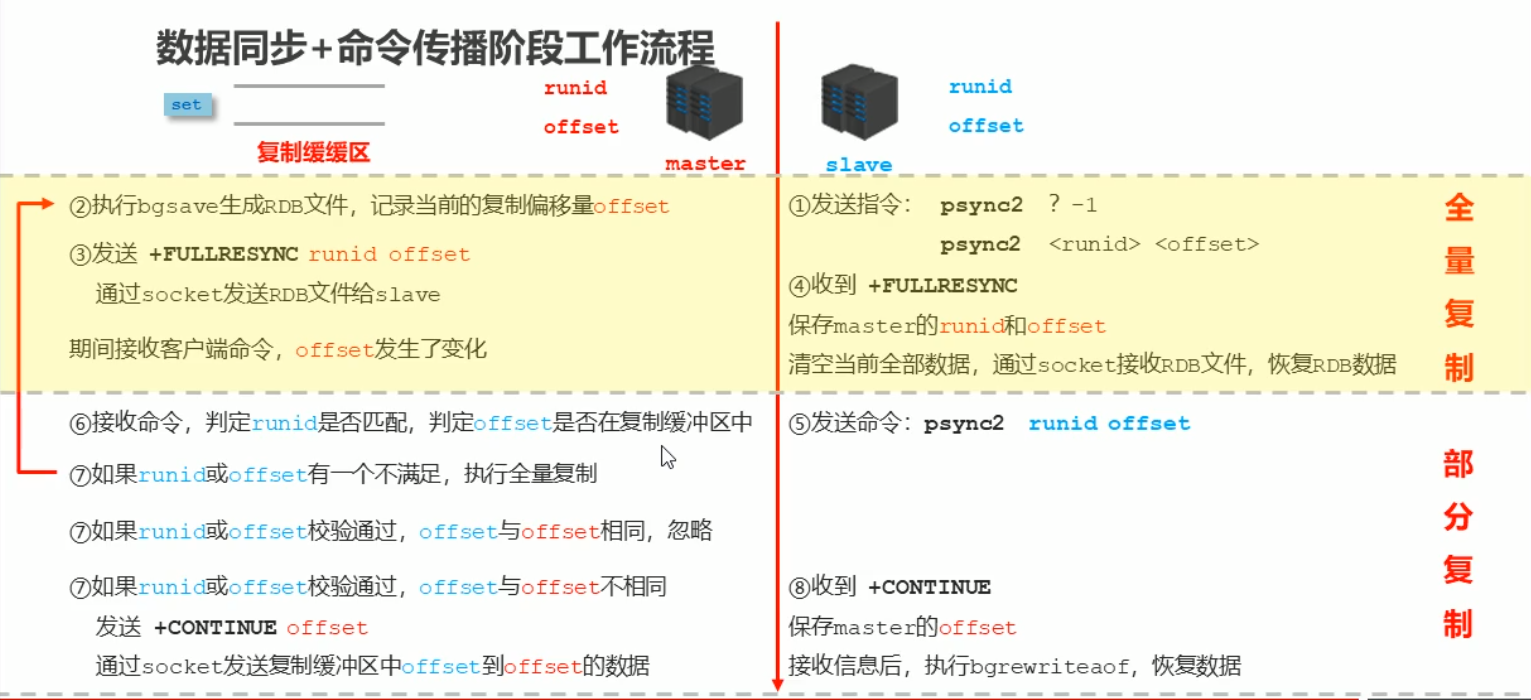
7.1.4 主从复制常见问题
1. 频繁的全量复制
一旦master重启或者runid发生变化, 就会导致slave进行全量复制.
解决方案: 本机保存上次的runid, 重启后恢复, 使所有的slave认为还是之前的master
- 在master内部创建master_replid变量, 使用runid相同的策略生成, 发送给slave
- 在master关闭时执行shutdown save, 进行rdb持久化, 将runid与offset保存到rdb文件中
- master重启后加载rdb文件恢复数据
2. 数据不一致
多个slave在获取同一个key时, 获取的数据不一致
原因: 网络信息不同步, 数据发送有延迟
解决方案:
- 网络优化, 尽量使用内网传输.
- 监控主从节点延迟判断, 如果salve延迟过大, 暂时屏蔽程序对slave的数据访问.
7.2 哨兵
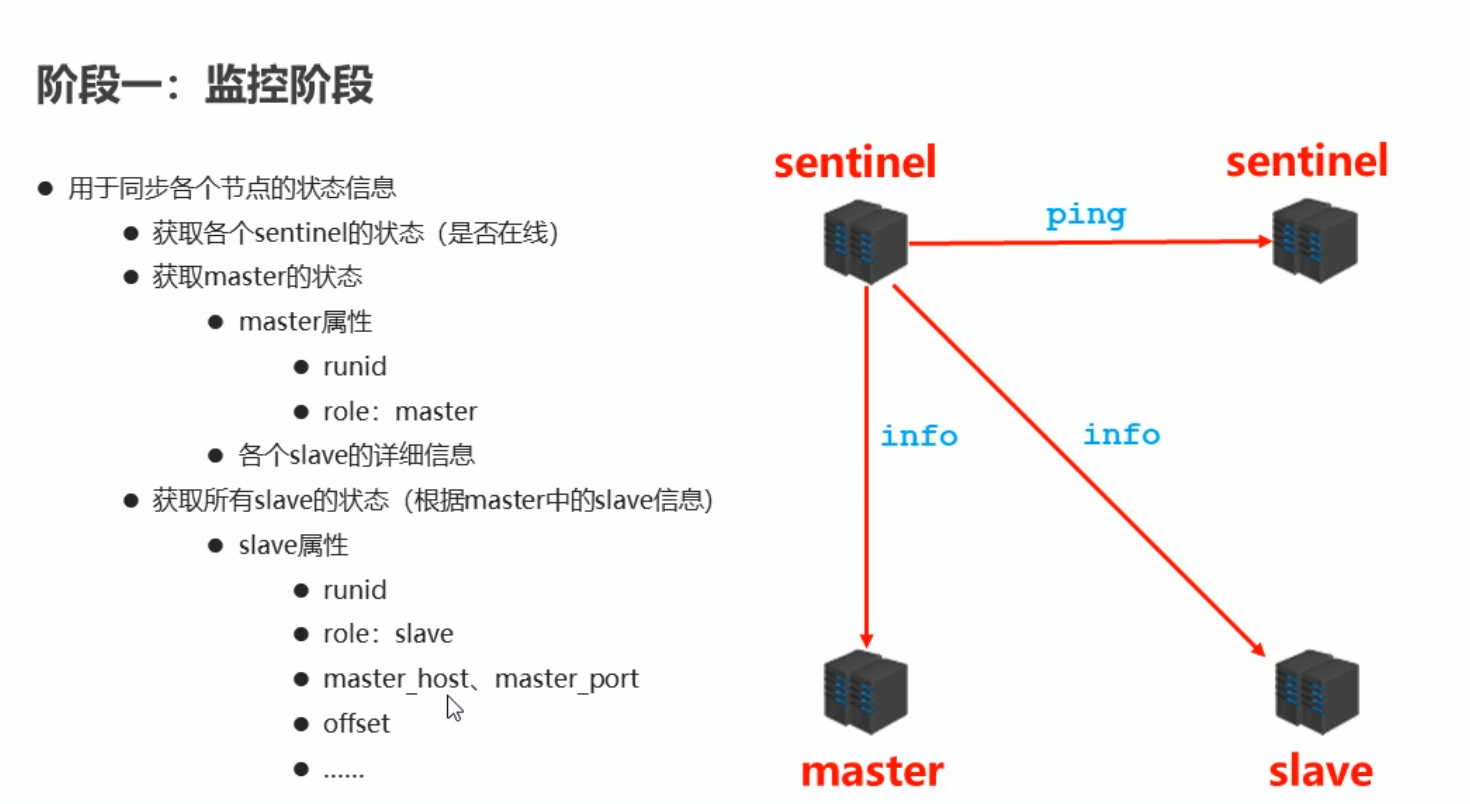
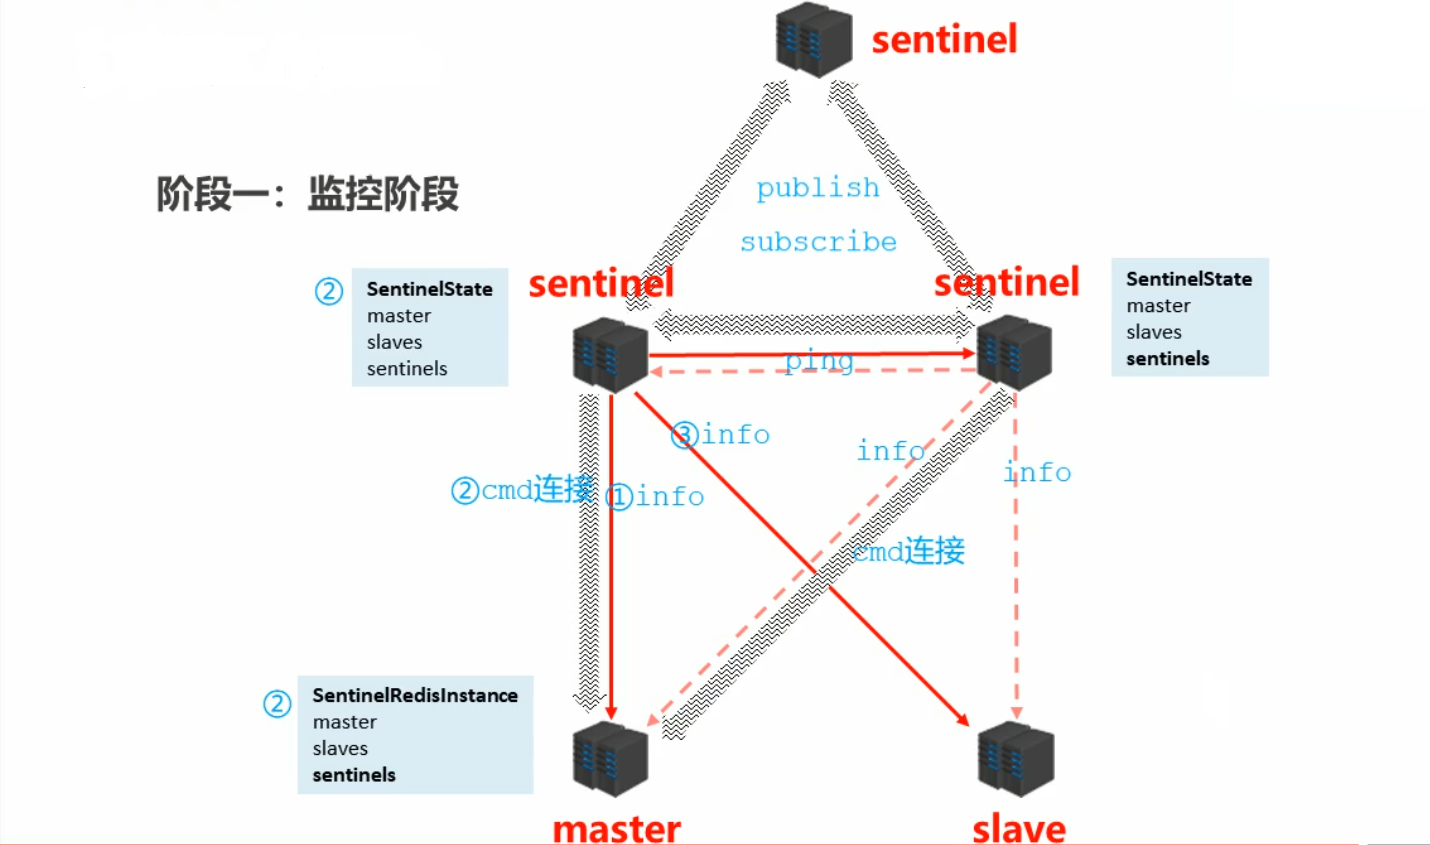
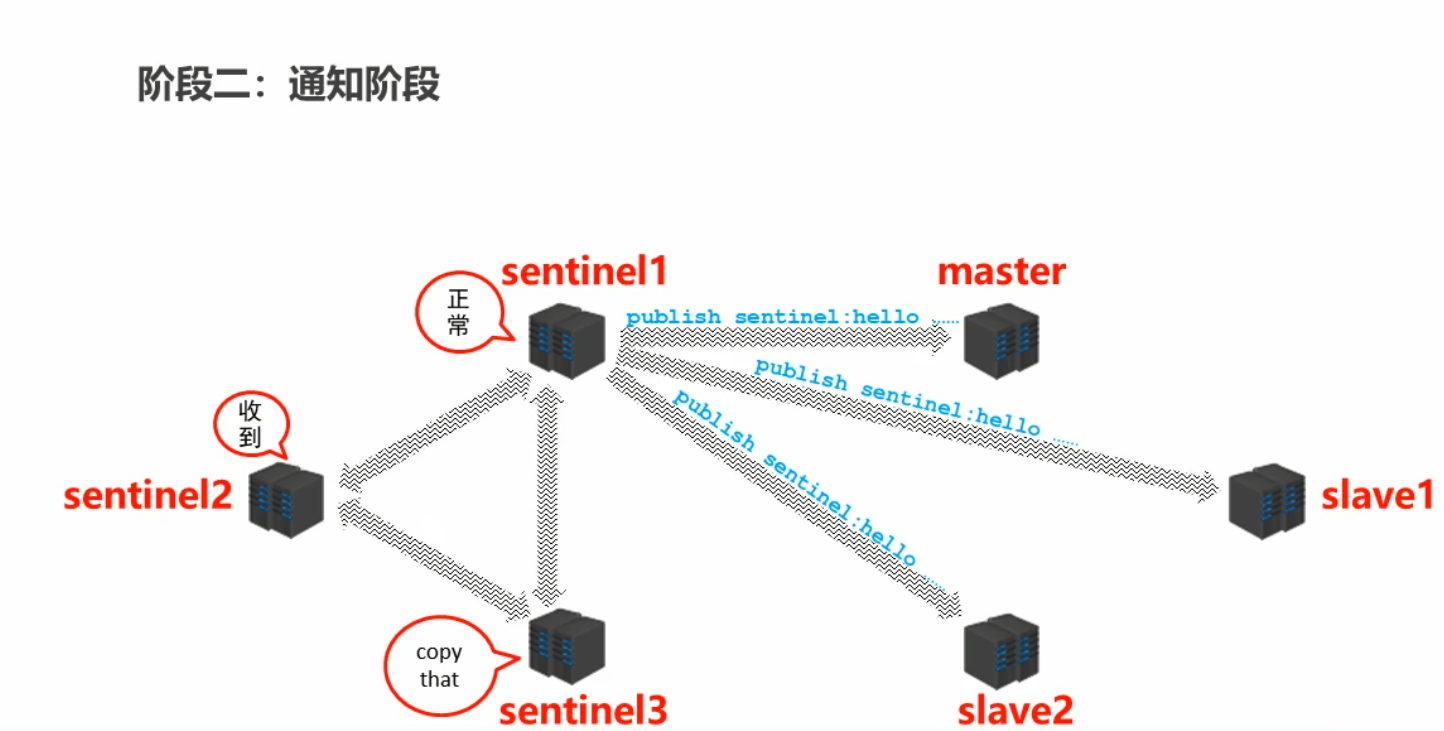
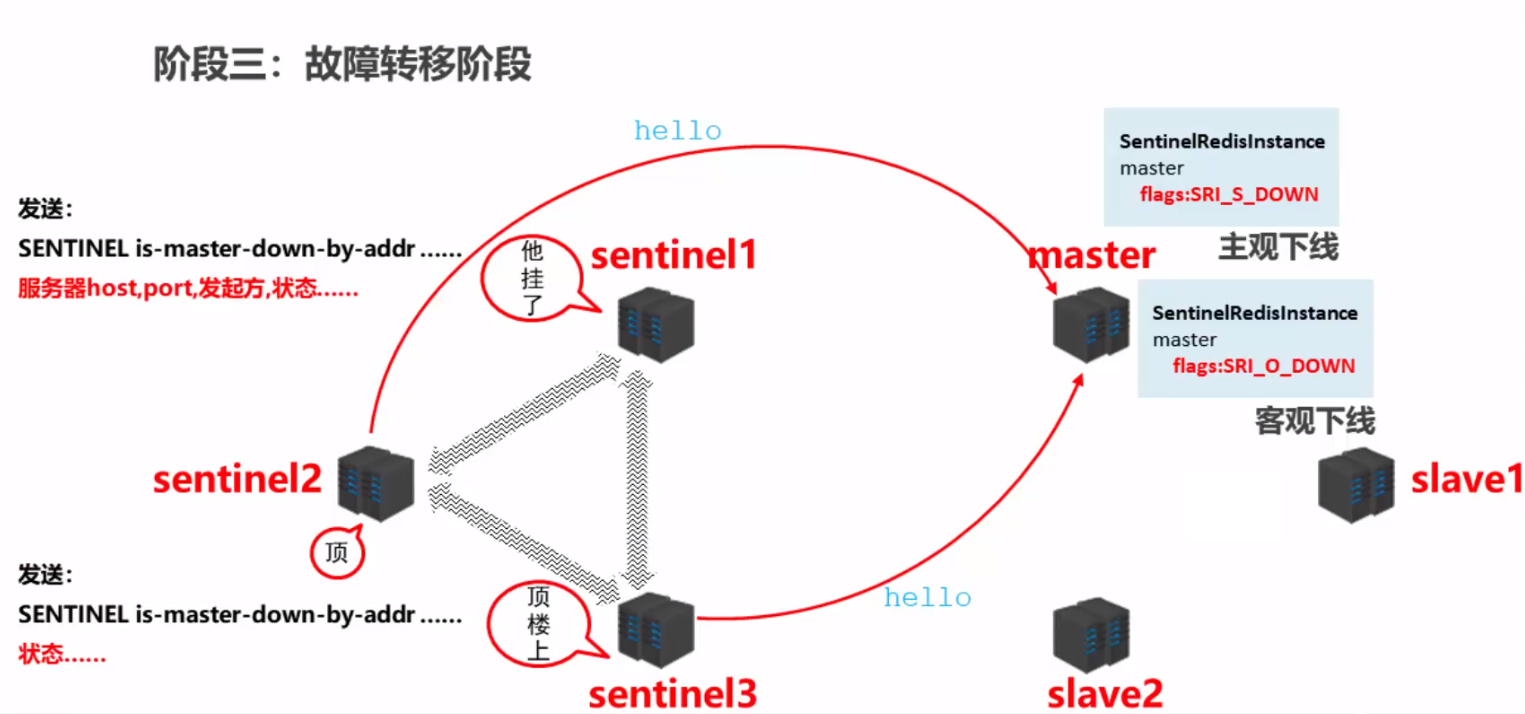
哨兵是一个分布式系统, 用于对主从结构中的每台服务器进行监控, 当出现故障时通过投票机制选择新的master并将所有的slave连接到新的master. 需要注意的是, 哨兵也是一台redis服务器, 只是不提供数据服务.
7.2.1 阶段一: 监控阶段
7.2.2 阶段二: 通知阶段
7.2.3 阶段三: 故障转移阶段
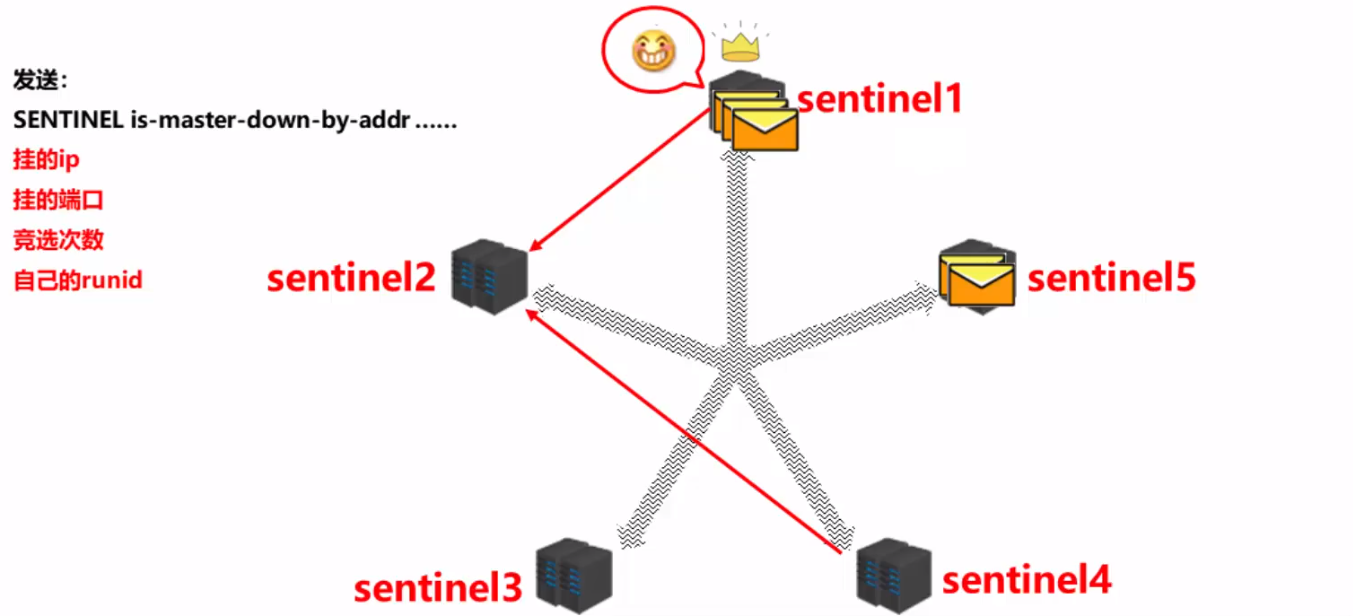
整个阶段可以分为以下步骤:
- 发现问题
- 竞选负责人
- 选择新master
- 新master上任, 其他slave切换master, 原master作为slave, 故障恢复后连接
![发现问题]()
![竞选负责人]()
![选择新master]()

7.3 集群
集群就是使用网络将若干台计算机串联起来, 并提供统一的管理方式, 使其对外呈现单机的服务效果. 可以有效的分散单台服务器的访问压力, 实现负债均衡. 分散单台服务器的存储压力, 实现可扩展性. 同时也降低单台服务器宕机带来的业务灾难.


8. 适用场景
8.1. 缓存
缓存现在几乎是所有中大型网站都在用的必杀技, 合理的利用缓存不仅能够提升网站访问速度, 还能大大降低数据库的压力。Redis提供了键过期功能, 也提供了灵活的键淘汰策略, 所以, 现在Redis用在缓存的场合非常多。
8.2. 消息队列
消息队列是大型网站必用中间件, 主要用于业务解耦、流量削峰及异步处理实时性低的业务。Redis提供了发布/订阅及阻塞队列功能, 能实现一个简单的消息队列系统。
8.3 分布式锁
在很多互联网公司中都使用了分布式技术, 分布式技术带来的技术挑战是对同一个资源的并发访问, 如全局ID、减库存、秒杀等场景, 并发量不大的场景可以使用数据库的悲观锁、乐观锁来实现, 但在并发量高的场合中, 利用数据库锁来控制资源的并发访问是不太理想的, 大大影响了数据库的性能。可以利用Redis的setnx功能来编写分布式的锁, 如果设置返回1说明获取锁成功, 否则获取锁失败, 实际应用中要考虑的细节要更多。
8.4 分布式会话
集群模式下, 在应用不多的情况下一般使用容器自带的session复制功能就能满足, 当应用增多相对复杂的系统中, 一般都会搭建以Redis等内存数据库为中心的session服务, session不再由容器管理, 而是由session服务及内存数据库管理。
8.5 排行榜
很多网站都有排行榜应用的, 如京东的月度销量榜单、商品按时间的上新排行榜等。Redis提供的有序集合数据类构能实现各种复杂的排行榜应用。
9. 作为消息队列
Redis提供了发布/订阅及阻塞队列功能, 也可以作为消息队列进行使用. RabbitMQ是实现AMQP(高级消息队列协议)的消息中间件的一种, 最初起源于金融系统, 用于在分布式系统中存储转发消息, 在易用性、扩展性、高可用性等方面表现不俗。
| 差别 | redis | rabbitMQ |
|---|---|---|
| 可靠性 | 没有相应的机制保证消息的可靠消费, 如果发布者发布一条消息, 而没有对应的订阅者的话, 这条消息将丢失, 不会存在内存中 | 具有消息消费确认机制, 如果发布一条消息, 还没有消费者消费该队列, 那么这条消息将一直存放在队列中, 直到有消费者消费了该条消息, 以此可以保证消息的可靠消费 |
| 高可用 | 采用主从模式, 读写分离, 但是故障转移还没有非常完善的官方解决方案 | 集群采用磁盘、内存节点, 任意单点故障都不会影响整个队列的操作 |
| 持久化 | 将整个Redis实例持久化到磁盘 | 队列, 消息, 都可以选择是否持久化 |
| 消费者负载均衡 | 不提供, 需自行实现 | 根据消费者情况, 进行消息的均衡分发 |
| 队列监控 | 不提供, 需自行实现 | 后台可以监控某个队列的所有信息, (内存, 磁盘, 消费者, 生产者, 速率等) |
| 流量控制 | 不提供, 需自行实现 | 服务器过载的情况, 对生产者速率会进行限制, 保证服务可靠性 |
10. 分布式锁
使用redis做分布式锁, 主要的原理就是使用命令set key value NX PX 3000(setnx命令在未来可能会被redis移除, 不建议使用), 当key不存在时, 设定key和value, 并返回成功. 当key存在时, 直接返回失败. 一般在使用该命令时, 会添加过期时间, 以防止获取锁的客户端宕机导致无法释放锁, 导致其他客户端永远也无法获取到锁.
另外除了自己基于redis api来实现分布式锁以外, 还可以使用开源框架: Redisson.
public void test() {
    RedissonClient redisson = Redisson.create(config);

    RLock lock = redisson.getLock("anyLock");
    try {
        lock.lock();
    } finally {
        lock.unlock();
    }
}
以上代码就是一个最简单的使用例子. Redisson中, 所有的指令都是通过lua脚本执行的, 保证了原子性. 同时在设定锁时, 默认过期时间为30秒, 并且使用看门狗(Watchdog)在获取锁之后, 每隔10s将锁的超时时间设为30s. 当客户端宕机, 看门狗也就不存在了, 也就不会延迟锁的过期时间, 保证了不会产生死锁的问题.
11. redis常见问题
11.1 缓存预热
缓存预热就是系统启动前, 提前将相关的缓存数据直接加载到缓存系统中, 避免在用户请求的时候, 先查询数据库, 然后将数据缓存的问题.
11.2 缓存雪崩
在一个较短的时间内, 原有的大部分缓存集中过期, 或者redis服务器由于某种未知原因而宕机, 导致大量请求查询直接数据库, 从而数据库崩溃.
- 均匀分布: 在设置有效时间时应该尽量均匀分布. 对数据进行分类, 对不同类型的数据设置不同的过期时间, 比如A类50分钟, B类40分钟, 同时过期时间使用固定时间 + 随机值的形式.
- 构建多级缓存架构: nginx缓存 + redis缓存 + ehcache缓存
- 对mysql进行优化: 对一些严重耗时的sql进行优化.
- 限流&降级: 使用类似于hystrix的框架, 进行限流, 避免大量请求导致数据库服务器崩溃. 这种情况下保证数据库不会崩溃, 至少一部分用户的请求是可以被处理的.
- 其他: 1. 部分超热数据使用永久的时间. 2. 进行人工干预, 配合访问流量统计, 将热点数据进行延时.
11.3 缓存击穿
在某一个瞬间, 某个key过期了, 但是这个key访问量巨大, 导致过多请求直接访问数据库.
- 开启定时任务, 在缓存过期之前主动重新构建缓存或者延后缓存过期时间.
- 采用分布式互斥锁, 以保证只有少量请求能请求数据库并重新设置缓存, 其余请求则是在释放锁之后才能访问到新缓存.
11.4 缓存穿透
大量请求尝试获取一个在数据库和缓存中都不存在的key, 导致服务器崩溃.
- 缓存null: 对查询为null的数据进行缓存
- 实时监控: 实时监控redis的命中率与null数据的占比, 当过多的请求null数据时, 启动排查流程, 使用黑名单进行防控.
11.5 双写不一致
数据库数据和缓存中数据偶尔有不一致的情况. 导致这种情况的主要原因就是更新缓存策略导致的.
对于读请求比较简单, 先读redis, 在读数据库. 当cache hit, 返回数据. 当cache miss, 访问database, 并将数据放入cache中.
但是对于写操作就比较复杂. 此时可以分为两种情况.
先操作数据库, 再操作缓存
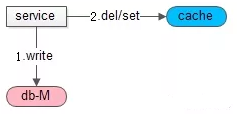
上图是一个简单的流程, 如果该过程中原子性被破坏, 就会出现数据库操作成功, 缓存操作失败. 此时数据库里是新数据, 缓存中却是旧数据. 无法接受
先操作缓存, 再操作数据库
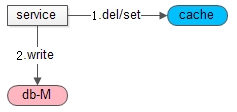
上图是一个简单的流程, 如果该过程中原子性被破坏, 就会出现缓存操作成功, 数据库操作失败. 这种情况下, 还需要考虑缓存中是使用set命令还是del命令.
如果使用set命令, 就会导致缓存中是新数据, 数据库中是旧数据, 无法接受. 如果使用del命令, 就会导致缓存中没有数据, 数据库中还是旧数据, 在下一次读取时, 会多一次cache miss, 对业务没有影响, 这种情况下是可以接受的.
但是问题到此还是没有结束.
在高并发的情况下, 如果redis中缓存删除成功, 数据库还没有操作完成, 此时另外一个请求进行查询, 看到redis中没有内容, 就到数据库中查找到旧的内容, 并且更新到redis中. 这种情况下, 缓存依旧是旧数据, 无法接受.
一种解决方案是删除redis, 操作数据库完成后, 程序休眠一定时间(具体需要看业务逻辑)后再次执行一次redis删除操作, 这种解决方案可以大幅降低双写不一致的情况.
另外一种方案是在更新数据时, 将数据的唯一标识压入到队列中, 当其他请求进入进行查询时, 先判断数据在队列中是否存在, 不存在就直接返回即可. 如果存在, 将读取数据 + 更新缓存这个操作也放入到队列中, 等待被执行. 这种解决方案也是比较有问题的, 最大的问题就是读请求长时间阻塞.


 浙公网安备 33010602011771号