
高性能计算-GPU并行扫描(28)
1. 扫描概念
- 对数组arr[N]扫描就是得到数组prefix[N],每个元素是之前arr元素的求和.
- 开扫描定义:
prefix1[N] = { arr[0], arr[0]+arr[1], ..., arr[0]+arr[1]+arr[N-1] } - 闭扫描定义:
prefix2[N] = { 0, arr[0], arr[0]+arr[1], ..., arr[0]+arr[1]+arr[N-12}
2. Hillis steele 扫描算法
(1)一种闭扫描算法。基础的Hillis steele 扫描算法只能扫描单块,步骤复杂度为 O(logN),任务复杂度为 O(N*logN-(N-1)).
(2)基础版算法介绍:假设步长为s每次迭代 >=s的线程参与计算,本线程id作为被加数,往前 -s 索引为加数
(3)支持任意block倍数长度的数据输入,介绍:a) 扫描block:按blocksize划分数据,每个block处理一个数据块,块内进行扫描,输出规约结果数组,并将最后一个块内和元素按 blockid 保存到辅助数组;
b) 递归闭扫描辅助数组:递归为了将块内求和辅助数组的结果加到块内扫描结果上,需要扫描辅助数组,如果辅助数组大于256那么要考虑辅助数组递归扫描;直到辅助数组被扫描求和数组block为1,扫描结束,反向依次弹栈把求和数组加到 block+1 的扫描结果数组上。
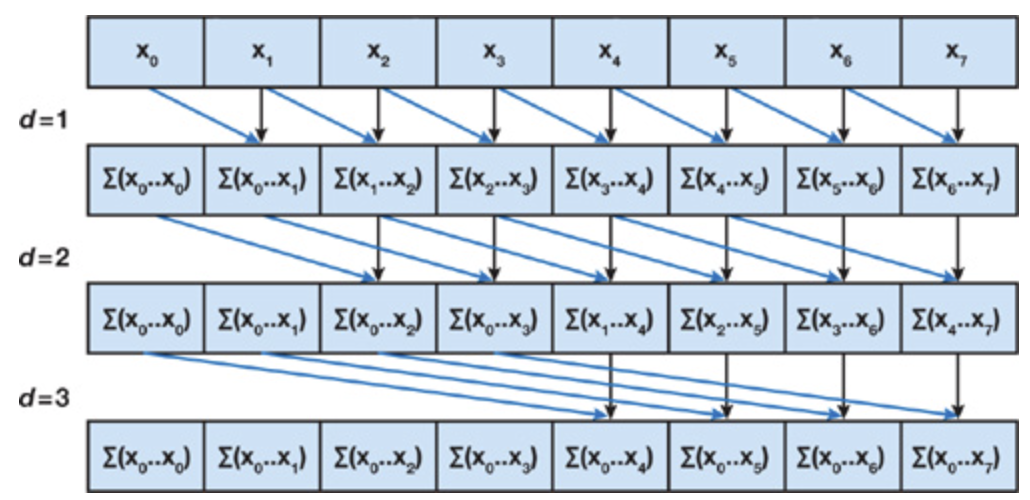
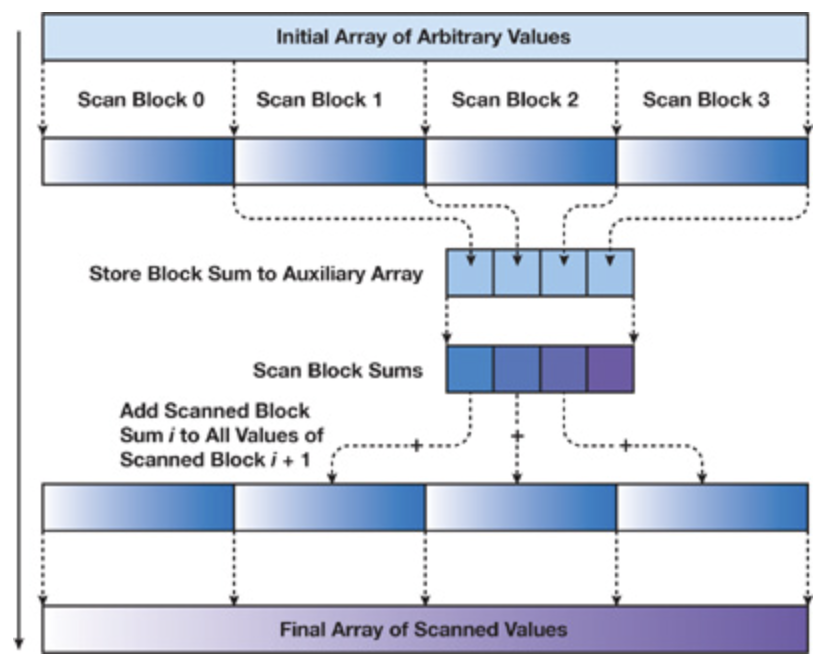
(4)优化:共享内存使用双buffer,读写分离,避免读写 bank冲突
(5)代码:
/*
任意长度扫描,单块扫描使用Hillis Steele算法,使用double buffer避免读写bank冲突;默认输入数据长度是blockSize的倍数
*/

#include "common.h"
#include <stdio.h>
#include <cstdint>

#define BlockSize 512

// 单块扫描函数, in 输入数据, out 扫描结果, len1 扫描数据长度,sum block求和数组,len2 sum数组大小
__global__ void kernelBlockScan(int *in, int *out, int len1, int *sum, int len2)
{
    // 取单块数据到共享内存,使用双buffer,读写分离,避免读写bank冲突
    __shared__ int arrShared[2 * BlockSize];
    int bid = blockIdx.x;                            // 块id
    int gid = blockIdx.x * blockDim.x + threadIdx.x; // 全局线程id
    int tid = threadIdx.x;                           // 块内线程id
    int write = 0;                                   // 初始化第0个buff write
    int read = 1;                                    // 初始化第1个buff read

    if (gid < len1)
    {
        // 共享内存read buffer数据初始化
        arrShared[read * BlockSize + tid] = in[gid];
        __syncthreads();
        for (int s = 1; s < BlockSize; s <<= 1)
        {
            // Hillis Steele算法:索引大于步长的线程参与计算,对应位置上的倍加数+块内前面步长位置的加数
            if (tid >= s)
            {
                // 被加数索引
                int id = read * BlockSize + tid;
                arrShared[write * BlockSize + tid] = arrShared[id] + arrShared[id - s];
            }
            else // 否则保留上一轮计算的前缀和
                arrShared[write * BlockSize + tid] = arrShared[read * BlockSize + tid];
            // 每循环一次,读写buffer区域交换
            __syncthreads();
            write = 1 - write;
            read = 1 - read;
        }
        // 将block计算结果赋值给out
        out[gid] = arrShared[read * BlockSize + tid];
        // 将块内求和按块索引号放求和数组
        if (tid == (BlockSize - 1))
            sum[bid] = arrShared[read * BlockSize + tid];
    }
}

// 对第一轮扫描结果后处理函数,len 数据总长度
__global__ void handPost(int *arrBlock, int len, int *arrBlockSumScan)
{
    int gid = blockDim.x * blockIdx.x + threadIdx.x;
    int bid = blockIdx.x;
    int tid = threadIdx.x; // 块内线程id

    // 从第二块开始加上前一个块的sum值
    if (bid > 0 && gid < len)
    {
        // 取出被加数
        __shared__ int temp;
        if (tid == 0)
            temp = arrBlockSumScan[bid - 1];
        __syncthreads();
        arrBlock[gid] += temp;
    }
}

// 输入分块扫描分配及后处理函数,输出结果的空间在外面分配
// 这里第一二轮扫描都使用该函数递归调用,n输入数据长度
void scan(int *inD, int *gOutD, int n)
{
    int GridSize = (n - 1) / BlockSize + 1;
    printf("gridSize:%d\n", GridSize);
    int *arrBlockSum;
    CudaSafeCall(cudaMalloc((void **)&arrBlockSum, GridSize * sizeof(int)));

    kernelBlockScan<<<GridSize, BlockSize, 2 * BlockSize * sizeof(int)>>>(inD, gOutD, n, arrBlockSum, GridSize);
    CudaCheckError();

    // 循环扫描递归终止条件:假如第一次扫描gridsize=4096大于256,则要循环扫描到 gridsize==1,block的和需要被handpost处理累加到后面
    if (GridSize == 1)
    {
        cudaFree(arrBlockSum);
        return;
    }

    // 二次扫描:对所有 block sum 数组进行扫描
    int *arrBlockSumScan;
    // cudaMalloc 隐式同步
    CudaSafeCall(cudaMalloc((void **)&arrBlockSumScan, GridSize * sizeof(int)));
    scan(arrBlockSum, arrBlockSumScan, GridSize);
    // 空流核函数隐式同步
    //  cudaDeviceSynchronize();

    // 将本轮扫描结果数组的索引+1作为第一次扫描结果按blockIdx.x的索引作为块内扫描结果的加数,得到最终扫描结果arrResult
    handPost<<<GridSize, BlockSize, sizeof(int)>>>(gOutD, n, arrBlockSumScan);
    CudaCheckError();

    // cudafree是隐式同步
    CudaSafeCall(cudaFree(arrBlockSum));
    CudaSafeCall(cudaFree(arrBlockSumScan));

    return;
}

int main(int argc, char **argv)
{
    int N = 1 << 20; // 数据规模
    if (argc > 1)
        N = 1 << atoi(argv[1]);

    // cpu串行计算
    int *arrHost = (int *)calloc(N, sizeof(int));
    int *resultHost = (int *)calloc(N, sizeof(int));
    int *resultFD = (int *)calloc(N, sizeof(int));
    float cpuTime = 0.0;
    initialDataInt(arrHost, N);

    double start = cpuSecond();
    // 闭扫描
    // 初始化第一个元素,避免循环内有判断,cpu分支预测错误
    resultHost[0] = arrHost[0];
    for (int i = 1; i < N; i++)
        resultHost[i] = resultHost[i - 1] + arrHost[i];
    double end = cpuSecond();
    cpuTime = (end - start) * 1000;

    // gpu计算
    int *arrD;
    int *resultD;
    float gpuTime = 0.0;
    CudaSafeCall(cudaMalloc((void **)&arrD, N * sizeof(int)));
    CudaSafeCall(cudaMalloc((void **)&resultD, N * sizeof(int)));
    cudaEvent_t startD, endD;
    CudaSafeCall(cudaEventCreate(&startD));
    CudaSafeCall(cudaEventCreate(&endD));

    CudaSafeCall(cudaMemcpy(arrD, arrHost, N * sizeof(int), cudaMemcpyHostToDevice));
    cudaEventRecord(startD);
    scan(arrD, resultD, N);
    CudaCheckError();
    cudaEventRecord(endD);
    cudaEventSynchronize(endD);

    CudaSafeCall(cudaMemcpy(resultFD, resultD, N * sizeof(int), cudaMemcpyDeviceToHost));
    cudaEventElapsedTime(&gpuTime, startD, endD);
    cudaEventDestroy(startD);
    cudaEventDestroy(endD);

    // 结果比对
    checkResultInt(resultHost, resultFD, N);

    free(arrHost);
    free(resultHost);
    free(resultFD);
    CudaSafeCall(cudaFree(arrD));
    CudaSafeCall(cudaFree(resultD));

    printf("数据规模 %d kB,cpu串行耗时 %.3f ms ;gpu 单个block使用Hillis Steele 扫描(double buffer)计算耗时 %.3f ms,加速比为 %.3f .\n", N >> 10, cpuTime, gpuTime, cpuTime / gpuTime);

    return 0;
}
3. Blelloch扫描算法
(1)一种开扫描算法。基础的 Blelloch扫描算法,只能处理单块数据。步骤复杂度为 O(2logN),任务复杂度为 O(2N)。
(2)基础版算法介绍:a) 规约:对块进行规约,每次循更新计算结果的位置的数值,其他数值不变。
b) 清零和散出:
- 清零:最后一个元素置为0
- 散出:假设数据长度为blocksize ,迭代循环步长为 s = blocksize/2 ,最后一个元素 E1,与向前s的元素 E2相加,结果放在 E1位置,并将原数据 E1放在 E2位置;每轮循环步长减半。


(3)支持任意block倍数长度的数据输入,介绍:
a)开扫描block:按blocksize划分数据,每个block处理一个数据块,块内进行扫描,输出前缀和和块内求和结果辅助数组
b) 递归开扫描辅助数组:递归为了将块内求和辅助数组的结果加到块内扫描结果上,需要扫描辅助数组,如果辅助数组大于256那么要考虑辅助数组递归扫描;直到辅助数组被扫描求和数组block为1,扫描结束,反向依次弹栈把求和数组加到对应 block前缀数组上(此处与Hillis steele不同)。

(4)优化
- 块内共享内存每个warp后添加一个padding位,避免访存 bank冲突
- 扫描核函数内规约和散出阶段根据步长计算需要线程的数量,只让小于该数量的块内线程id参与计算
(5)代码
/*
使用blelloch 算法对任意长度(blocksize的倍数)做开扫描
// 优化:
    1.存放数据:共享内存每32个数据添加一个padding,主要避免扫描访存 bank冲突;
    2.读取数据:handPost 现成处理的数据
    3.扫描核函数内规约和散出阶段根据步长计算需要线程的数量,只让小于该数量的块内线程id参与计算
*/
#include "common.h"
#include <stdio.h>
#include <stdint.h>

#define BlockSize 512
#define ADD_PADDING_MEM(A) ((A) + ((A) >> 5)) // 根据原数据的索引计算机padding 后的索引;或者输入原数据大小,获取padding后的大小

// 单块扫描函数, in 输入数据, out 扫描结果, len1 扫描数据长度,sum block求和数组,len2 sum数组大小
__global__ void kernelBlockScan(int *in, int *out, int len1, int *sum, int len2)
{
    int tid = threadIdx.x;
    int bid = blockIdx.x;
    int gid = bid * blockDim.x + threadIdx.x;
#if 0 // 一个线程访问连续的共享内存2个数据,2路 bank conflict,使用padding 可以避免冲突
    int bFirstIndex = 2 * tid;
    int brcSecondIndex = bFirstIndex + 1;
    int gFirstIndex = 2 * (bid * BlockSize + tid);
    int gSecondIndex = gFirstIndex + 1;
#else // warp 内线程连续访问共享内存,防止 bankconflict
    int wid = tid / warpSize;
    int wtid = tid % warpSize;
    int bFirstIndex = wid * 2 * warpSize + wtid;
    int brcSecondIndex = bFirstIndex + warpSize;
    int gFirstIndex = bid * 2 * BlockSize + bFirstIndex;
    int gSecondIndex = bid * 2 * BlockSize + brcSecondIndex;
#endif
    // 取数据到共享内存,一个块计算2个快的数据
    // 优化:每32个数据添加一个padding数据位,解决扫描迭代时bank冲突
    __shared__ int arrShared[ADD_PADDING_MEM(2 * BlockSize)];

    // 每个线程取第一个数
    if (2 * gid < len1)
        arrShared[ADD_PADDING_MEM(bFirstIndex)] = in[gFirstIndex];
    // 取第二个数
    if (2 * gid + 1 < len1)
        arrShared[ADD_PADDING_MEM(brcSecondIndex)] = in[gSecondIndex];
    // 保留最后一个值,避免最后再次访存
    int lastValue = 0;
    // 如果用其他线程保存数据,应先同步,保证最后一个线程访存之后再保存
    if (tid == BlockSize - 1)
        lastValue = arrShared[ADD_PADDING_MEM(2 * BlockSize - 1)];
    __syncthreads();

    // up sweep
    // 优化: 减少线程束分化,由于计算的结果保存在原共享内存,计算数据的位置分配计算线程从0号开始,将计算结果放入对应位置,节约了线程束的需求
    // 优化: 使用padding 避免 bank conflict
    for (int s = 1; s <= BlockSize; s <<= 1)
    {
        // 根据步长计算本轮需要的线程数量
        if (tid < (2 * BlockSize) / (2 * s))
        {
            // 根据步长和计算线程索引,得到被加数索引
            int index = 2 * s * (tid + 1) - 1;
            // 减少线程束优化,根据需要的线程数量
            if (index < 2 * BlockSize)
                arrShared[ADD_PADDING_MEM(index)] += arrShared[ADD_PADDING_MEM(index - s)];
        }
        // 防止空闲线程进行下一轮计算
        __syncthreads();
    }
    // 最后一个结果清0
    if (tid == 0)
        arrShared[ADD_PADDING_MEM(2 * BlockSize - 1)] = 0;
    __syncthreads();

    // down sweep
    for (int s = BlockSize; s > 0; s >>= 1)
    {
        // 根据步长计算本轮需要的线程数量
        if (tid < (2 * BlockSize) / (2 * s))
        {
            // 根基 btid和步长计算出被加数索引
            int index = 2 * s * (tid + 1) - 1;
            int addSecondIndex = ADD_PADDING_MEM(index);
            int addFirstIndex = ADD_PADDING_MEM(index - s);
            int temp = arrShared[addSecondIndex];
            arrShared[addSecondIndex] += arrShared[addFirstIndex];
            arrShared[addFirstIndex] = temp;
        }
        // 防止空闲线程进行下一轮计算
        __syncthreads();
    }
    // 保存开扫描结果
    // 保存线程对应第一个位置数据
    out[gFirstIndex] = arrShared[ADD_PADDING_MEM(bFirstIndex)];
    out[gSecondIndex] = arrShared[ADD_PADDING_MEM(brcSecondIndex)];
    // block求和结果放入辅助数组
    if (tid == BlockSize - 1)
        sum[bid] = lastValue + arrShared[ADD_PADDING_MEM(2 * BlockSize - 1)];
}

// 对第一轮扫描结果后处理函数,len 数据总长度
__global__ void handPost(int *gOutD, int len, int *arrBlockSumScan)
{
    int gid = blockIdx.x * blockDim.x + threadIdx.x;
    int tid = threadIdx.x;
    int bid = blockIdx.x;
    int wid = gid / warpSize;  // warpid
    int wtid = gid % warpSize; // warp内线程id

    // 开扫描辅助数组第一个值为0,该索引块不参与计算
    if (bid > 0)
    {
        // 这里有bank冲突:如果一个线程处理相邻数据,0和16线程在bank0和bank1双路冲突
        // 优化: 一个warp计算两个warp大小的数据,一个线程取的两个数据偏移warp大小,可以避免bank冲突
        __shared__ int secondValue;
        if (tid == 0)
            // 因为开扫描,bid位置存储的是前一个block的sum
            secondValue = arrBlockSumScan[bid];
        __syncthreads();
        gOutD[wid * 2 * warpSize + wtid] += secondValue;
        gOutD[wid * 2 * warpSize + wtid + warpSize] += secondValue;
    }
    // 没有依赖可以不同步
}

// 输入分块扫描分配及后处理函数,输出结果的空间在外面分配
// 这里第一二轮扫描都使用该函数递归调用,n输入数据长度
void scan(int *inD, int *gOutD, int n)
{
    int GridSize = (n - 1) / (2 * BlockSize) + 1;
    // printf("gridSize:%d\n",GridSize);
    int *arrBlockSum;
    CudaSafeCall(cudaMalloc((void **)&arrBlockSum, GridSize * sizeof(int)));

    kernelBlockScan<<<GridSize, BlockSize, ADD_PADDING_MEM(2 * BlockSize) * sizeof(int)>>>(inD, gOutD, n, arrBlockSum, GridSize);
    CudaCheckError();

    // 循环扫描递归终止条件:假如第一次扫描gridsize=4096大于256,组要循环扫描到 gridsize==1,block的和需要被handpost处理累加到后面
    if (GridSize == 1)
    {
        cudaFree(arrBlockSum);
        return;
    }

    // 二次扫描:对本轮计算结果和的数组进行开扫描
    int *arrBlockSumSacn;
    // cudaMalloc 隐式同步
    CudaSafeCall(cudaMalloc((void **)&arrBlockSumSacn, GridSize * sizeof(int)));
    scan(arrBlockSum, arrBlockSumSacn, GridSize);
    // 空流核函数隐式同步
    //  cudaDeviceSynchronize();

    // 将二轮开扫描结果按数组索引加到对应索引块的第一轮扫描结果上,得到最终扫描结果arrResult
    handPost<<<GridSize, BlockSize, sizeof(int)>>>(gOutD, n, arrBlockSumSacn);
    CudaCheckError();

    // cudafree是隐式同步
    CudaSafeCall(cudaFree(arrBlockSum));
    CudaSafeCall(cudaFree(arrBlockSumSacn));

    return;
}

int main(int argc, char **argv)
{
    int N = 1 << 20; // 数据规模
    if (argc > 1)
        N = 1 << atoi(argv[1]);

    // cpu串行计算
    int *arrHost = (int *)calloc(N, sizeof(int));
    int *resultHost = (int *)calloc(N, sizeof(int));
    int *resultFD = (int *)calloc(N, sizeof(int));
    initialDataInt(arrHost, N);

    double start = cpuSecond();
    // 闭扫描
    // 初始化第一个元素,避免循环内有判断,cpu分支预测错误
    resultHost[0] = 0;
    for (int i = 1; i < N; i++)
        resultHost[i] = resultHost[i - 1] + arrHost[i - 1];
    double cpuTime = (cpuSecond() - start) * 1000;

    // gpu计算
    int *arrD;
    int *resultD;
    float gpuTime = 0.0;
    CudaSafeCall(cudaMalloc((void **)&arrD, N * sizeof(int)));
    CudaSafeCall(cudaMalloc((void **)&resultD, N * sizeof(int)));
    cudaEvent_t startD, endD;
    CudaSafeCall(cudaEventCreate(&startD));
    CudaSafeCall(cudaEventCreate(&endD));

    CudaSafeCall(cudaMemcpy(arrD, arrHost, N * sizeof(int), cudaMemcpyHostToDevice));
    cudaEventRecord(startD);
    scan(arrD, resultD, N);
    CudaCheckError();
    cudaEventRecord(endD);
    cudaEventSynchronize(endD);

    CudaSafeCall(cudaMemcpy(resultFD, resultD, N * sizeof(int), cudaMemcpyDeviceToHost));
    cudaEventElapsedTime(&gpuTime, startD, endD);
    cudaEventDestroy(startD);
    cudaEventDestroy(endD);

    // 结果比对
    checkResultInt(resultHost, resultFD, N);
    free(arrHost);
    free(resultHost);
    free(resultFD);
    CudaSafeCall(cudaFree(arrD));
    CudaSafeCall(cudaFree(resultD));

    printf("数据规模 %d kB,cpu串行耗时 %.3f ms ;gpu 单个block使用Blelloch 扫描计算耗时 %.3f ms,加速比为 %.3f .\n", N >> 10, cpuTime, gpuTime, cpuTime / gpuTime);

    return 0;
}
4. 测试数据
| 扫描算法 | 串行(ms) | gpu并行(ms) | 加速比 |
|---|---|---|---|
| Hillis steele (0.1M数据) | 0.003 | 0.2 | 0.015 |
| Blelloch (0.1M数据) | 0.005 | 0.131 | 0.038 |
| thrust库 (0.1M数据) | - | 0.16 | 0.025 |
| Hillis steele (1M数据) | 5.363 | 1.947 | 2.754 |
| Blelloch (1M数据) | 5.593 | 2.047 | 2.732 |
| thrust库 (1M数据) | - | 0.39 | 13.850 |
| Hillis steele (25M数据) | 146.608 | 10.376 | 14.129 |
| Blelloch (25M数据) | 149.882 | 11.981 | 12.510 |
| thrust库 (25M数据) | - | 0.62 | 238.000 |
备注:thrust 的时间包主机与GPU的内存拷贝,测试代码不包含内存拷贝耗时。
5. 结果分析
(1) Hillis steele 比 Belloch扫描算法的效率分析,Hillis steele的任务复杂度大于Blelloch,Blelloch的步骤复杂度大于Hillis steele:
扫描算法 步骤复杂度 工作复杂度 Hillis steele O(logN) O(N*logN-(N-1)) Blelloch O(2logN) O(2N)
(2) 耗时分析
- 当数据量较小时串行效率最高,
- 当数据量较大时 Hillis steele 比 Belloch算法更高效,并且cuda thrust的效率极高
(3) 算法选择策略:
- 理论上:当数据规模大于核心数量时,应选用任务总量少,步骤多的算法比如 Blelloch ;当数据规模小于核心数量时应选用计算任务总量多,将计算分摊到更多的核心上,步骤少的算法比如 Hillis steele。
- 实际测试中:无论数据规模大还是小 Hillis steele 都比 Belloch 算法高效,使用 nvprof 分析后发现 Belloch 扫描核函数的步骤过多,对效率影响较大,应进一步改进。

 浙公网安备 33010602011771号