
5.RDD操作综合实例
一、词频统计
A. 分步骤实现
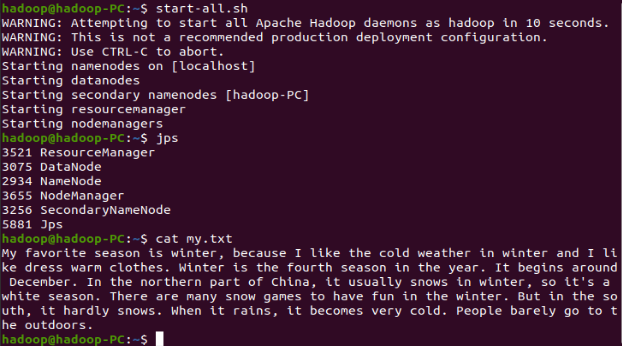
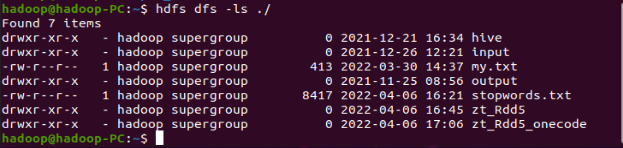
1、准备文件
1、下载小说或长篇新闻稿
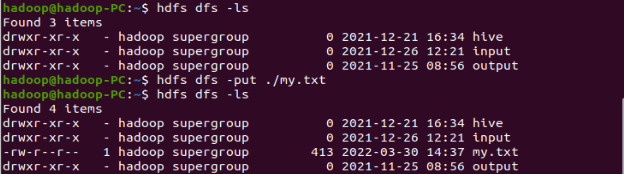
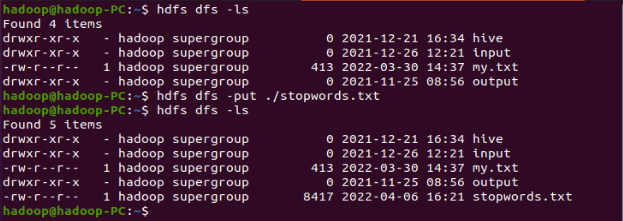
2、上传到hdfs上
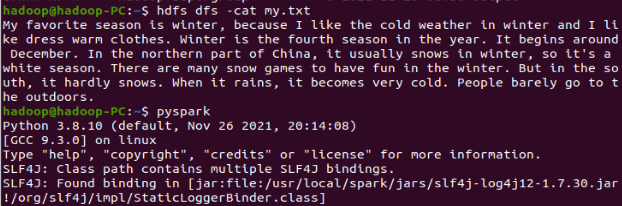
2、读文件创建RDD
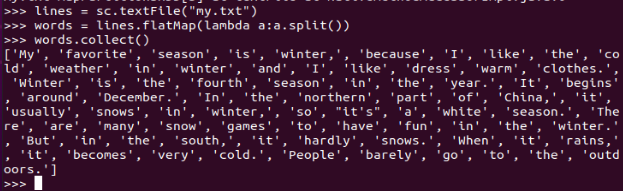
3、分词
4、排除大小写lower()、map()
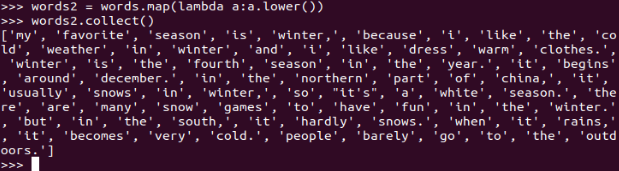
标点符号re.split(pattern,str),flatMap()
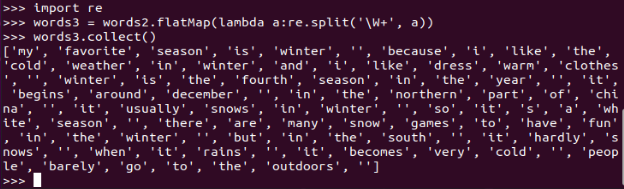
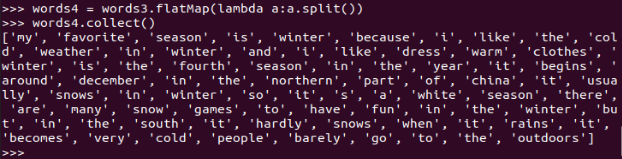
清除多出来的空白数据
停用词,可网盘下载stopwords.txt,filter()
将停用词文件分词存储到变量中
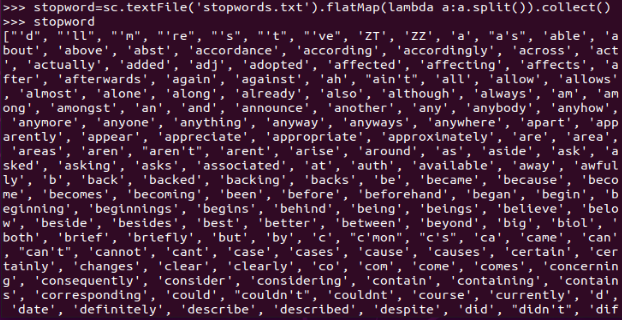
筛选出不在停用表中的词
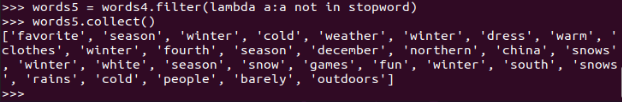
筛选前后对比

长度小于2的词filter()
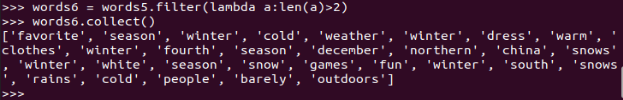
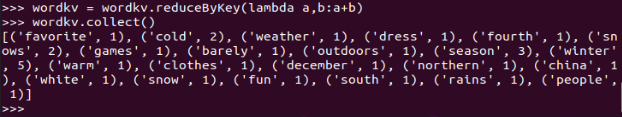
5、统计词频
a.先将单词映射成键值对
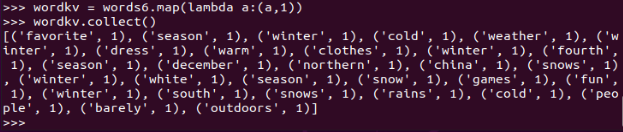
b.映射键值对再将key相同的values合并起来,完成词频的统计
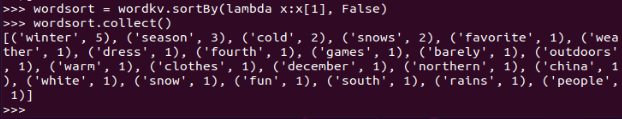
6、按词频排序
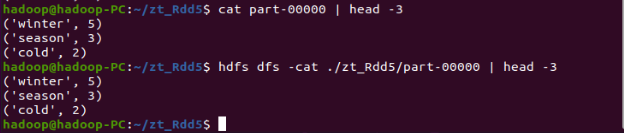
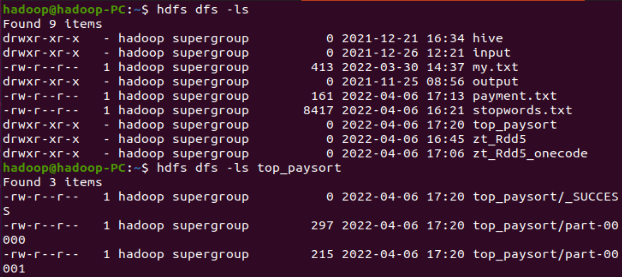
7、输出到文件

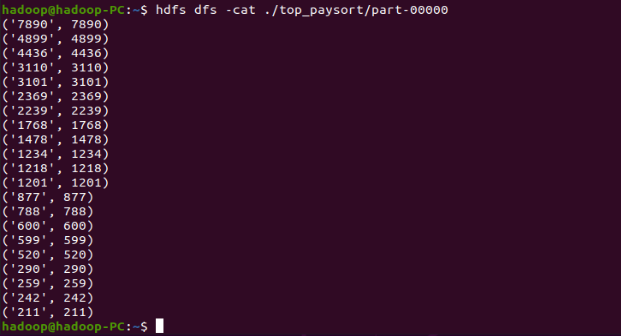
8、查看结果
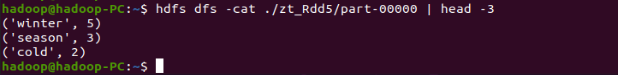
A. 查看文件前3条结果
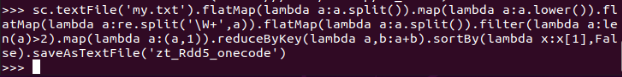
B. 一句话实现:文件入文件出
C. 和作业2的“二、Python编程练习:英文文本的词频统计 ”进行比较,理解Spark编程的特点。
在Spark中,RDD允许用户显式地将工作集缓存在内存中,后续能够重用工作集,这极大地提升了速度。
其中,Spark提供的主要抽象是弹性分布式数据集(RDD),通常RDD很大,会被分成很多个分区,分别保存在不同的节点上。分区可以增加并行度,减少通信开销。
RDD通过打开HDFS(或其他hadoop支持的文件系统)上的一个文件、在驱动程序中打开一个已有的Scala集合或由其他RDD转换操作得到。用户可以要求Spark将RDD持久化到内存中,这样就可以有效地在并行操作中复用。另外,在节点发生错误时RDD可以自动恢复。
二、求Top值
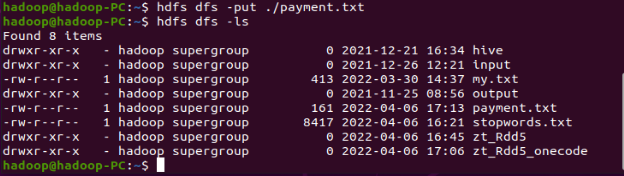
网盘下载payment.txt文件,通过RDD操作实现选出最大支付额的用户。
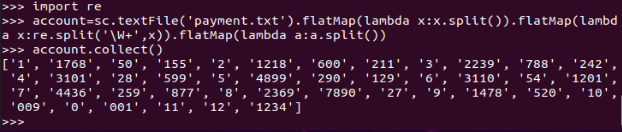
1、丢弃不合规范的行:
- 空行
- 少数据项
- 缺失数据
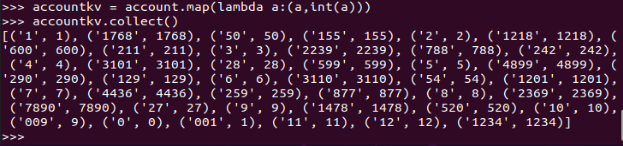
2、按支付金额排序
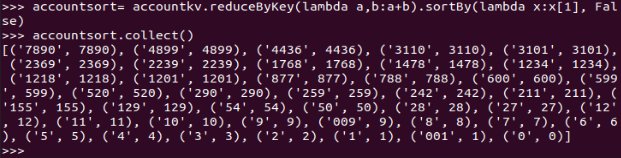
3、取出Top3

 浙公网安备 33010602011771号