
结对作业2改ed
2026秋软件工程结对作业(第二次):校园失物招领程序实现
本文由三部分材料合并整理而成:① 原型设计阶段的记录(第一次结对作业);② 程序实现与本地后端验收记录;③ 本次开发在 GitHub 上的两次 Pull Request 记录。
结对成员:王智洋(102402136)、庄剑钇(102402152)
一、作业链接与结对信息
| 项目 | 内容 |
|---|---|
| 课程 | H202601 软件工程与软件工程实践 |
| 本次作业要求 | 2026秋软件工程结对作业(第二次之程序实现) |
| 作业目标 | 依据上次的需求分析与原型,实现可实际操作的校园失物招领程序,并完成测试 |
| 结对成员 | 王智洋(102402136)、庄剑钇(102402152) |
| 队友博客 | 王智洋的博客 | 庄剑钇的博客 |
| GitHub 项目 | MieSheeeep/102402136-102402152 |
| 上次需求与原型 | 校园失物招领:需求分析与原型设计 |
二、两人工作分工
本次作业按「一人主实现、一人主走查与增强」的方式推进。两个人的产出都能在仓库里核对:王智洋的提交直接落在 main 上;庄剑钇通过 fork 拉分支、提 PR 后合并进 main,两次 PR 都可逐行查看。
| 成员 | 本次负责的具体工作 | 协作记录 |
|---|---|---|
| 王智洋 | 仓库创建与主体实现。前端页面与交互(js/app.js、js/views.js、css/styles.css)、业务规则(js/data.js)、本地后端与数据库(server/,Fastify + SQLite + Sharp)、演示数据(js/seed.js)、大部分单元测试与项目文档 |
main 分支上的历次提交;docs/ 下的设计规格、mvp-verification.md、2026-10-07-backend-verification.md |
| 庄剑钇 | ① fork 仓库并走通 fork + PR 流程;② 对照作业正文走查代码,定位「搜索只匹配物品名称」的缺口;③ 实现搜索范围扩展与多关键词;④ 实现搜索结果关键词高亮;⑤ 实现首页信息流分页与「加载更多」,并区分两种空状态;⑥ 实现静态模式下的图片上传;⑦ 补充单元测试 | PR #1(已合并)、PR #2(已合并);tests/views.test.cjs 为本次新建 |
说明:本次分工与上次原型阶段的分工不同。上次是「需求与原型 / 流程与文档」两条线,本次是「主体实现 / 走查与增强」两条线,工作边界以 PR 记录为准。
三、PSP 表格与耗时分析
单位为分钟。本表口径为庄剑钇的个人耗时,不含王智洋的工时;王智洋的耗时由其本人记录。两人都按「一个人实际投入的分钟数」统计,不做人分钟合并,这样两张表可以直接相加得到项目总工时。
| PSP2.1 | 任务 | 预估耗时 | 实际耗时 |
|---|---|---|---|
| Planning | 计划 | 15 | 15 |
| Estimate | 估计这次任务需要多少时间 | 20 | 20 |
| Development | 开发 | — | — |
| Analysis | 需求分析(包括学习新技术) | 60 | 90 |
| Design Spec | 生成设计文档 | 30 | 25 |
| Design Review | 设计复审 | 20 | 30 |
| Coding Standard | 代码规范(为目前的开发制定合适的规范) | 15 | 15 |
| Design | 具体设计 | 40 | 45 |
| Coding | 具体编码 | 120 | 180 |
| Code Review | 代码复审 | 40 | 60 |
| Test | 测试(自我测试,修改代码,提交修改) | 50 | 70 |
| Reporting | 报告 | 10 | 10 |
| Test Report | 测试报告 | 30 | 35 |
| Size Measurement | 计算工作量 | 10 | 10 |
| Postmortem & Process Improvement Plan | 事后总结,并提出过程改进计划 | 20 | 25 |
| 合计 | 以上具体任务之和 | 470 | 620 |
哪一项比预估花得久,差了多少,为什么(原先怎么估计 → 实际多花多少 → 原因 → 下次怎么调整):
- 具体编码:预估 120 分钟,实际 180 分钟,超了 60 分钟(+50%)。 原本以为只是把
item.name.includes(keyword)换成多字段匹配,动手后才发现真正的开销不在业务代码,而在回归验证:queryItems是筛选与搜索的唯一入口,改动它的语义必须回头确认原有 8 个测试用例不被改坏,同时为新行为补测试。这一项应该单独估时,而不是混在 Coding 里。 - 需求分析:预估 60 分钟,实际 90 分钟,超了 30 分钟。 多出来的是把作业正文和评分规则通读一遍、再对照仓库里的
docs/homework-gap-checklist.md逐条核对「已实现 / 还差什么」。这部分不能省——正是这一步才发现搜索范围的缺口,以及「首页尚未接入分页」这条自述限制。 - 代码复审:预估 40 分钟,实际 60 分钟。 读别人的代码比写自己的慢,需要先理解
data.js里normalize、validState、createStore这套设计意图,才能判断改动该加在哪一层。 - 测试报告与事后总结:基本符合预估。 测试是边写边记的,最后只是整理。
下次怎么调整:把「回归验证 + 补测试」从 Coding 里拆出来单独估时;读陌生模块时先花 15 分钟写一份「这个模块负责什么、被谁调用」的笔记,再动手。
四、设计实现过程
4.1 设计和实现过程
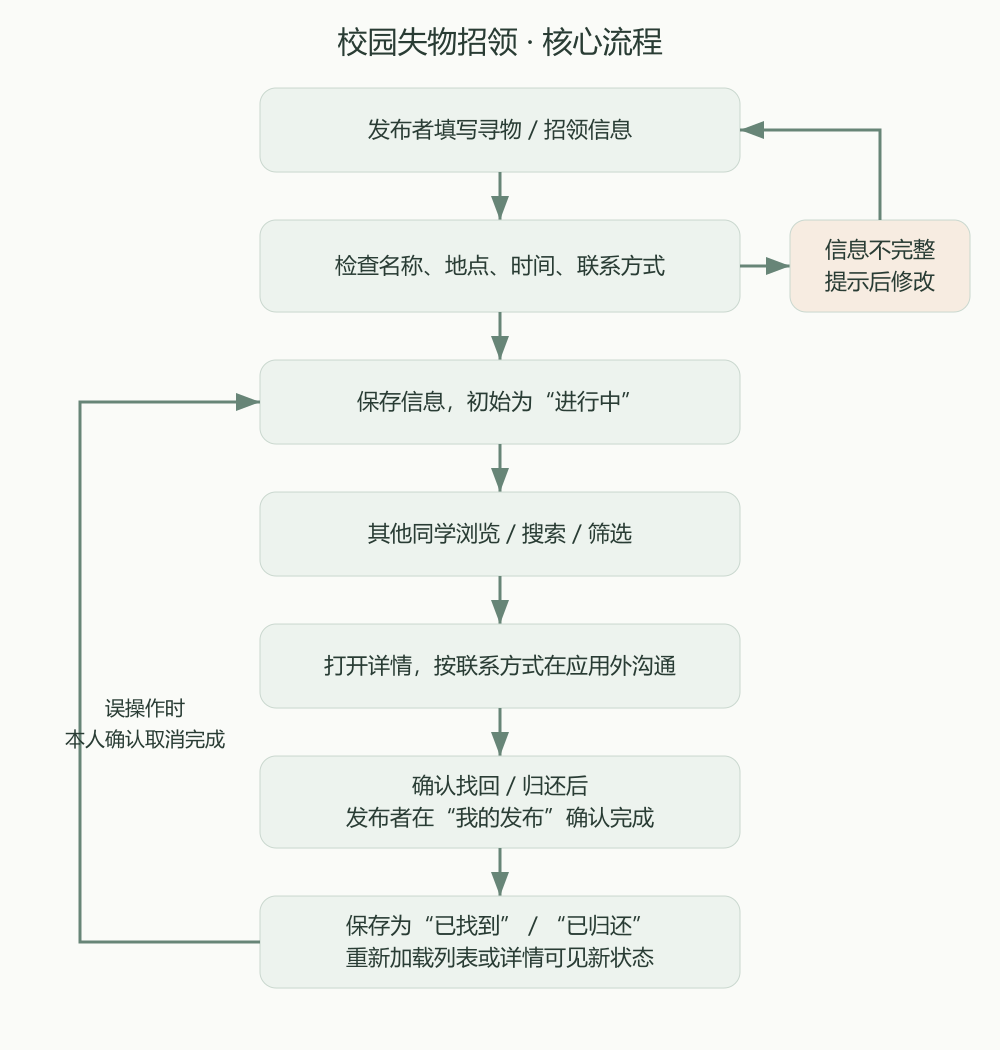
上次作业画出了页面和操作流程,这次把它做成了网页。核心链路是:
发布信息 → 浏览或搜索 → 查看详情 → 联系发布者 → 更新状态
代码按职责分层,这是我能在不认识全部代码的情况下快速定位改动点的前提:
| 层次 | 文件 | 负责什么 | 一个具体例子 |
|---|---|---|---|
| 页面与交互 | js/app.js、js/views.js |
收集输入、渲染界面、给出提示 | 必填地点为空时,在该字段旁说明问题 |
| 业务规则 | js/data.js |
校验、筛选、状态变化 | 寻物完成显示「已找到」,招领完成显示「已归还」 |
| 接口调用 | js/api.js |
登录校验、请求后端 | 完整模式下页面从接口读取数据 |
| 后端与存储 | server/、SQLite |
账号、权限、持久化、图片 | 只有发布者本人能标记完成 |
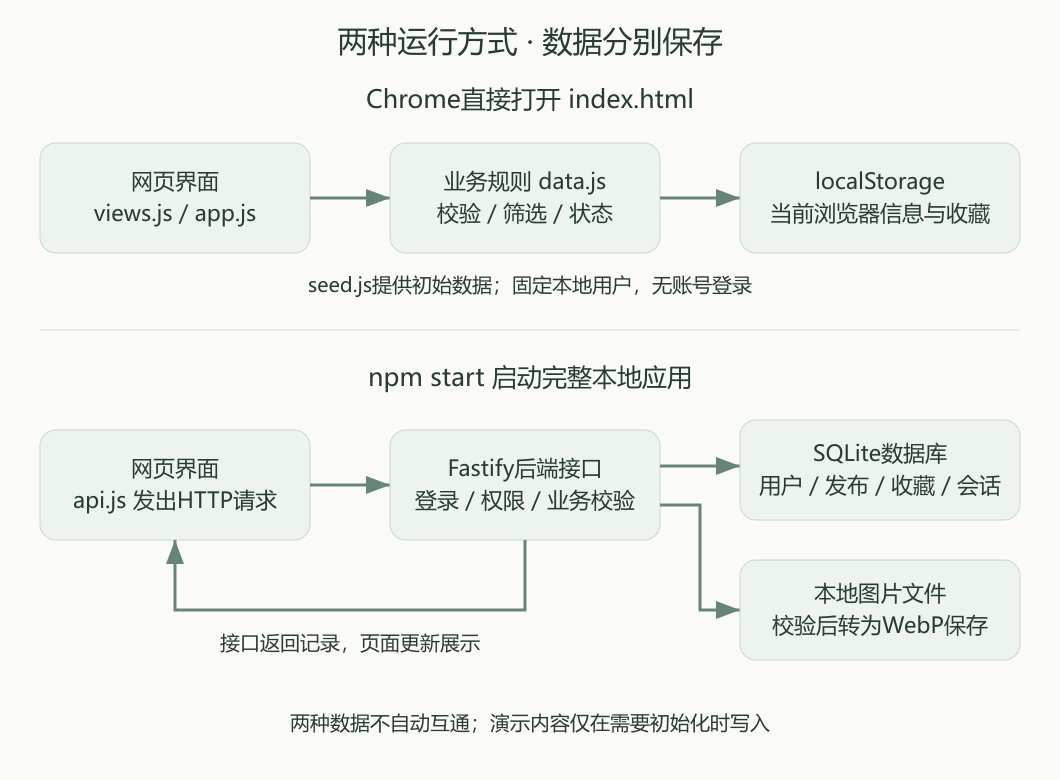
项目有两种运行方式,这是作业要求「下载所有文件后用 Chrome 打开 .html 就能展现预期效果」的直接落点:
| 运行方式 | 数据保存 | 适用范围 |
|---|---|---|
直接打开 index.html |
当前浏览器的 localStorage |
固定本地用户的核心交互体验 |
npm.cmd start |
SQLite 数据库与本地图片目录 | 真实账号、多用户权限、图片上传和完整业务流程 |
状态由谁更新、别人能看到什么,本次把线下联系和系统状态更新明确分开:
| 操作 | 谁来做、从哪里做 | 完成后其他人看到什么 |
|---|---|---|
| 发布 | 发布者填写发布表单 | 列表出现一条「寻找中」或「待认领」的信息 |
| 查找与联系 | 其他同学从首页搜索、打开详情 | 看到事件时间、地点和联系方式,在应用外沟通 |
| 完成 | 发布者在「我的发布」确认 | 重新加载后显示「已找到」或「已归还」,卡片变为完成配色 |
| 取消完成 | 发布者在同一位置再次确认 | 恢复「寻找中」或「待认领」,原内容保留 |
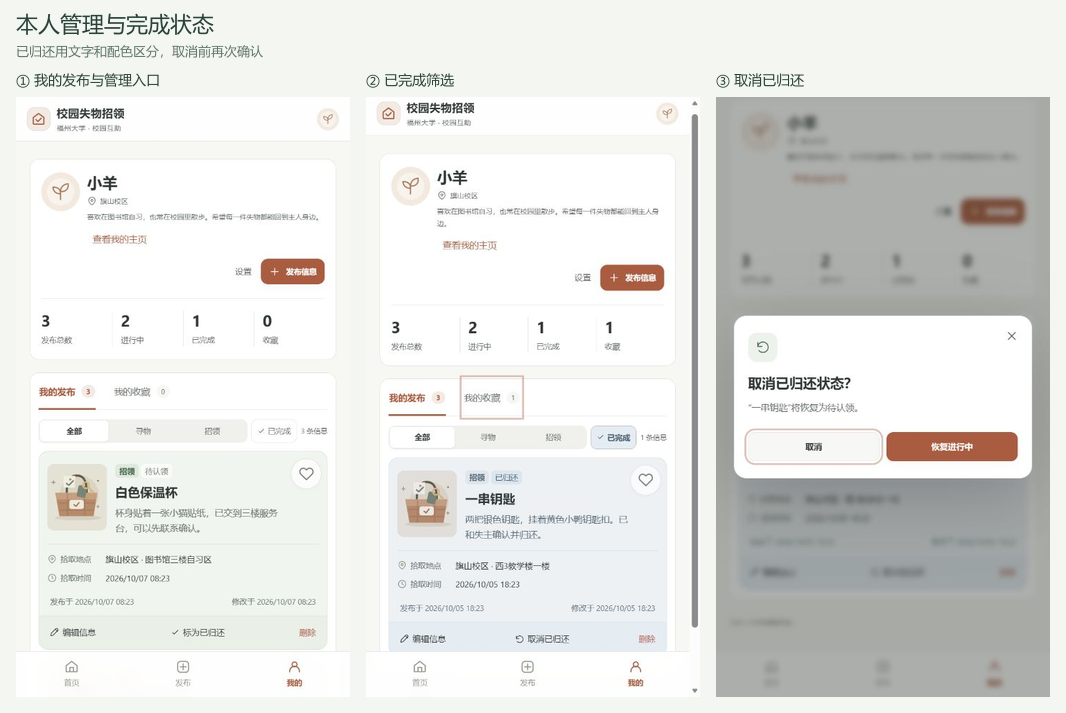
从原型到页面
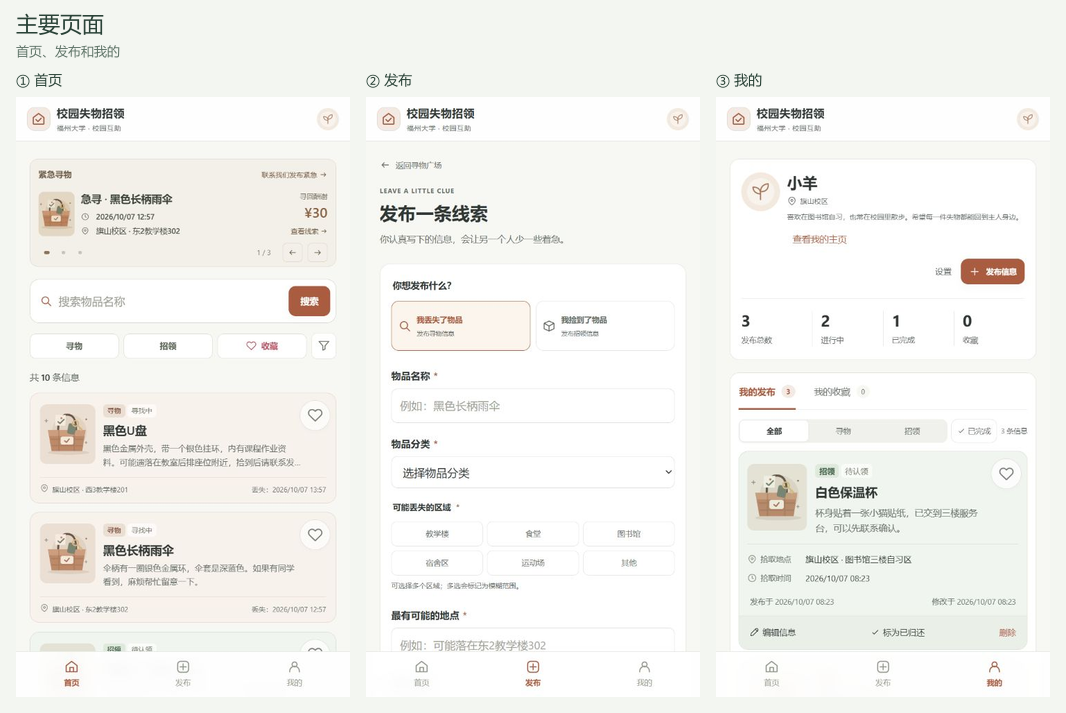
上次原型保留了「首页 / 发布 / 我的」三个入口,本次继续沿用;原型阶段确定的收藏、紧急公告栏、类型与状态配色三个特点也都实现了下来。原型里「搜索 + 筛选」放在一起的设计被完整保留,并在本次开发中进一步扩展(见 5.5、5.6 节)。
开发顺序是先完成本地核心流程,再补接口和多账号,最后根据页面反馈修改布局与交互。对应的提交分别有 34f51c9(MVP)、a0fdf8a(本地后端与发布者主页)、e638004(上传控件造成的页面溢出修复)。这样每一阶段都有可以运行和检查的结果。
4.2 程序流程图与数据流图
核心业务流程图(发布 → 浏览/搜索 → 详情 → 联系 → 更新状态):
整体数据流图:
一次页面请求的数据流:
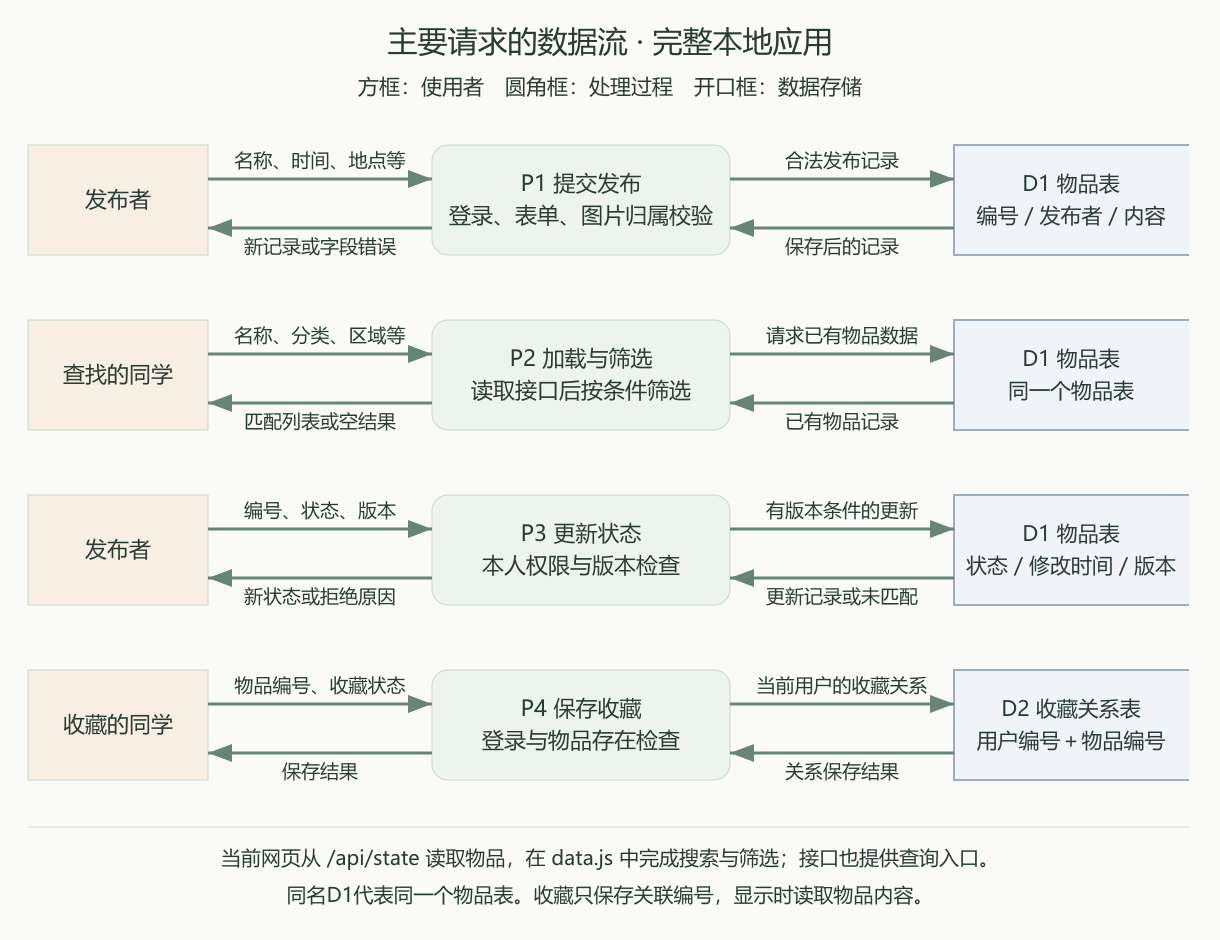
账号、资料、图片与公告的数据流:
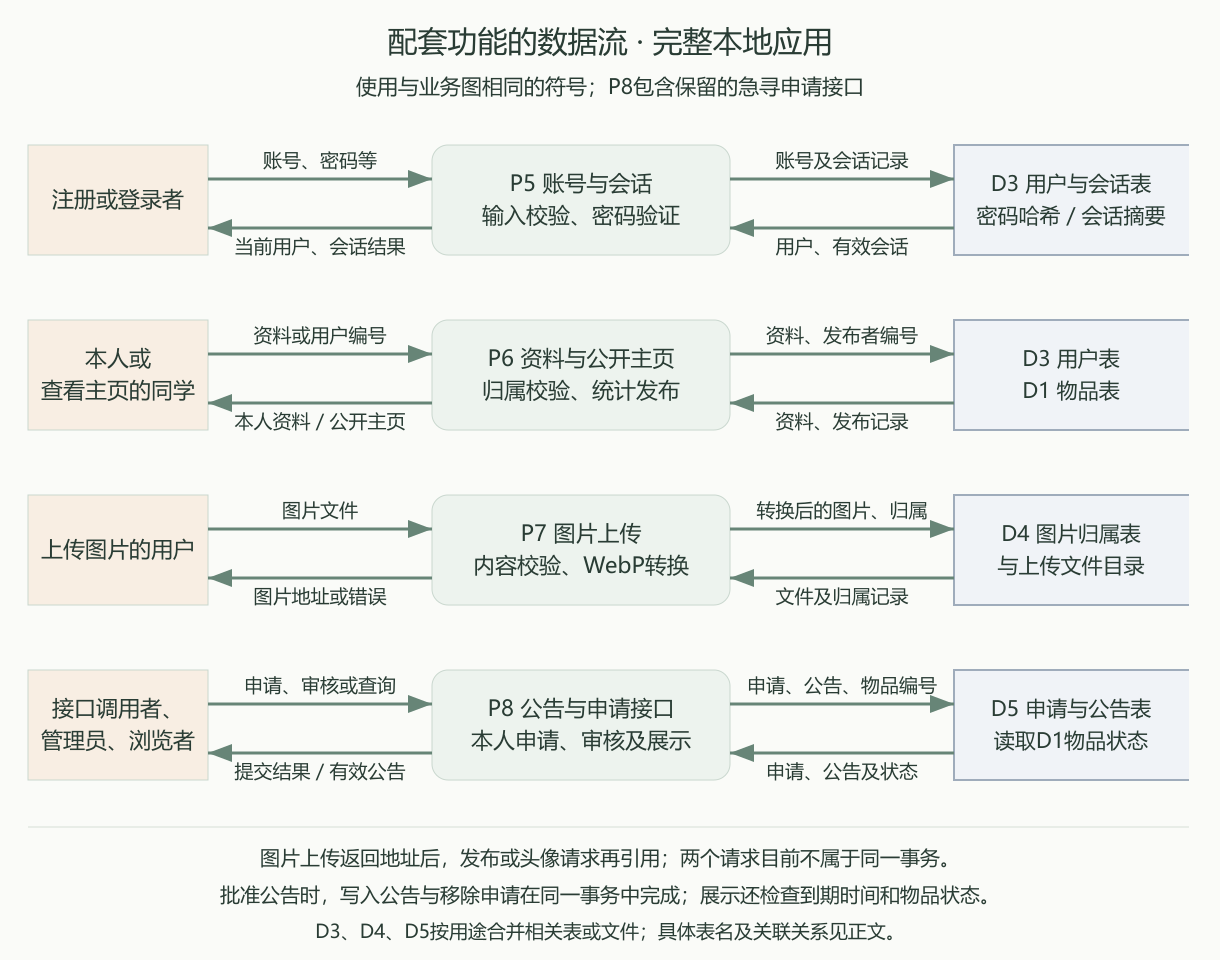
数据之间怎样关联
| 数据 | 关键字段与用途 |
|---|---|
| 物品发布 | id 识别物品,ownerId 确定发布者;type 和 status 决定类型、文字及配色 |
| 时间地点 | occurredAt 和 timePrecision 表达事件时间;区域列表表达可能范围,具体地点提供补充 |
| 修改记录 | createdAt 保留发布时间,updatedAt 记录修改;version 检查是否拿旧信息提交 |
| 收藏关系 | 用户编号与物品编号组成关系;展示时读取物品最新内容 |
| 图片 | 发布记录保存图片地址,实际文件放在上传目录;上传和引用都检查归属 |
| 数据表 | 保存内容 | 与其他数据的联系 |
|---|---|---|
users、sessions |
账号资料、密码及恢复码摘要、偏好、会话 | 会话关联用户;发布、收藏、图片以用户编号确定归属 |
items |
物品编号、发布者编号、内容、版本 | 发布者资料从用户表读取;完成数量从物品状态统计 |
favorites |
用户编号、物品编号 | 两个编号组成唯一关系;删除物品后级联删除 |
uploads 与图片目录 |
图片编号、所属用户、大小和文件 | 物品及头像引用地址;当前删除发布不会清理已上传文件 |
urgent_requests、notices |
申请或公告所关联物品、酬谢;公告另存到期时间 | 关联原发布;审核批准时写公告并删除申请 |
app_meta |
演示初始化及资料迁移标记 | 防止重启时重复导入、覆盖已经修改的数据 |
本次新增功能的数据流
搜索框输入「黑色 雨伞」
        │
        ▼
app.js  search(keyword)                    ← 记录最近搜索
        │
        ▼
filters.keyword = "黑色 雨伞"
        │
        ▼
data.js  queryItems(items, filters)
        │
        ├─ splitKeywords()                 ← 按空白拆词,兼容全角空格
        │        → ["黑色", "雨伞"]
        ├─ matchesKeywords()               ← 名称 + 描述 + 具体地点,逐词「与」匹配
        │
        ▼
data.js  paginate(list, homeLimit)         ← 只取本页 12 条
        │
        ▼
views.js home()  →  highlight()  把命中的词包成 <mark>
        │            渲染卡片 + 「加载更多(还有 N 条)」
        ▼
app.js  load-more  →  homeLimit += 12,重渲染并恢复滚动位置
4.3 关键代码及说明
一、后端更新接口的归属与版本检查(王智洋)
const user = auth(req);
const old = getItem(req.params.id, user);
const body = req.body || {};
if (old.ownerId !== user.id) fail(403, '只能管理本人发布的信息');
if (body.version !== old.version) fail(409, '信息已被修改,请刷新后重试');
第一步从登录信息确定用户,再检查这条发布属于谁。因此其他人即使直接调用接口,也不能修改别人的信息。version 用于检查页面中的信息是否已经过时。写入时再把版本条件放进更新语句:
const result = db.prepare(
  'UPDATE items SET data=?,version=version+1 WHERE id=? AND version=?'
).run(JSON.stringify(item), old.id, old.version);
if (!result.changes) fail(409, '信息已被修改,请刷新后重试');
例如同时打开两个页面修改同一条信息:第一页提交后版本加一,第二页的旧版本更新不到记录,接口返回 409 并提示刷新。这个检查既放在读取后,也放在实际写入时,防止检查与保存之间发生其他修改。
二、关键词高亮:转义顺序决定安全性(庄剑钇,PR #2)
// 把命中的关键词包成 <mark>,用于搜索结果高亮。
// 【安全要点】必须先按匹配位置切分「原文」,再对每一段单独 esc(),
// 绝不能在 esc() 之后的结果上做替换 —— 那样会把 & 这类实体从中间
// 切开,产生非法 HTML。全函数唯一不转义的,就是自己插入的 <mark> 标签。
function highlight(value, words) {
const raw = String(value ?? '');
if (!words || !words.length) return esc(raw);
const unique = [...new Set(words)].filter(Boolean).sort((a, b) => b.length - a.length);
if (!unique.length) return esc(raw);
const pattern = new RegExp(unique.map(word => word.replace(/[.*+?^${}()|[\]\\]/g, '\\$&')).join('|'), 'gi');
let out = '', last = 0;
for (const match of raw.matchAll(pattern)) {
out += esc(raw.slice(last, match.index)) + `<mark class="keyword-mark">${esc(match[0])}</mark>`;
last = match.index + match[0].length;
}
return out + esc(raw.slice(last));
}
这是本次开发里我认为最值得说明的一段代码,因为它踩到了「实现看起来对、安全性却是错的」这类问题。常见的写法是「先 esc() 整体转义,再对结果做替换」,但那样有两个反例:
| 输入 | 关键词 | 「先 esc 再替换」的结果 | 本实现的结果 |
|---|---|---|---|
<b>hello</b> |
b |
<b> 里的 b 也被替换,语义混乱 |
<[b]>hello</[b]> ✅ |
A&B |
amp |
A&B 含子串 amp,被切成 A&<mark>amp</mark>;,实体被破坏 |
A&B,不高亮 ✅ |
另外三处细节:按关键词长度降序排序,避免「伞」先把「雨伞」切碎;关键词里的正则元字符要转义,否则搜「3.5」会变成通配;大小写不敏感但保留原文拼写,搜 airpods 仍然高亮成 AirPods。
三、首页分页:两个容易被忽略的地方(庄剑钇,PR #2)
// 筛选条件签名:任何一项变化就自动回到第一页
const filterSignature = f => JSON.stringify([f.keyword, f.type, f.locations, f.categories, f.timeRange, f.dateStart, f.dateEnd, f.sort, f.favoritesOnly]);
// render() 开头:
const signature = filterSignature(filters);
if (signature !== homeFilterKey) { homeFilterKey = signature; homeLimit = HOME_PAGE_SIZE; }
如果用户在第 3 页把关键词从「雨伞」改成「校园卡」,结果集换了但页码还停在 3,就会看到一片空白,以为搜不到东西。这里没有去逐个动作里重置(容易漏),而是用签名统一判断。
case 'load-more': {
  const keep = main.scrollTop;      // 整页重渲染后 main 的 scrollTop 会被重置
  homeLimit += HOME_PAGE_SIZE;
  render();
  main.scrollTop = keep;
  document.querySelector('[data-action="load-more"]')?.focus({ preventScroll: true });
  break;
}
页面切换与状态更新都靠 main.innerHTML = V.home(...) 整体替换,点「加载更多」后若不处理,用户会被弹回页面顶部。
四、状态文字与配色由同一条记录决定(王智洋)
function statusLabel(item) {
  if (item.status === 'completed') {
    return item.type === 'lost' ? '已找到' : '已归还';
  }
  return item.type === 'lost' ? '寻找中' : '待认领';
}
不同页面不必各自猜状态,文字和配色一起变化。
五、附加特点的设计与展示
5.1 特点的目的与意义
项目原有三个主要特点,本次开发又新增了三个。它们分别解决不同的问题:
| 特点 | 为什么做 | 来源 |
|---|---|---|
| 收藏功能 | 看到可能相关的物品时先保存下来,之后回来核对或联系,减少反复搜索 | 原型阶段 |
| 紧急公告栏 | 把急需找回的物品放在首页显眼位置,先展示名称、丢失时间、地点和酬谢 | 原型阶段 |
| 颜色提示 | 通过卡片和爱心配色,帮助用户区分寻物、招领、已完成及已收藏状态 | 原型阶段 |
| 搜索结果关键词高亮 | 搜索接入描述与地点后,「搜到了」还得「看得见」——否则用户要在几十字描述里逐字找匹配 | 本次新增 |
| 首页信息流分页 | 信息一多就是无限长滚动,既看不到「一共多少条」,也影响首屏 | 本次新增 |
| 静态模式图片上传 | 作业要求「下载后直接用 Chrome 打开 .html 就能展现预期效果」,但此前直接打开 HTML 是传不了图的 | 本次新增 |
5.2 特点的设计实现
1. 收藏功能
首页卡片和详情都有收藏入口,点爱心就能保存,在首页「收藏」筛选或「我的收藏」中再次查看。收藏保存物品编号,查看时读取这条信息的最新内容。数据库把「用户编号+物品编号」设为唯一的一组关系,接口接收明确的收藏或取消状态:重复请求收藏不会多插入一份,取消只删除当前账号的关系,因此两个人收藏同一物品时不会互相影响。
2. 紧急公告栏
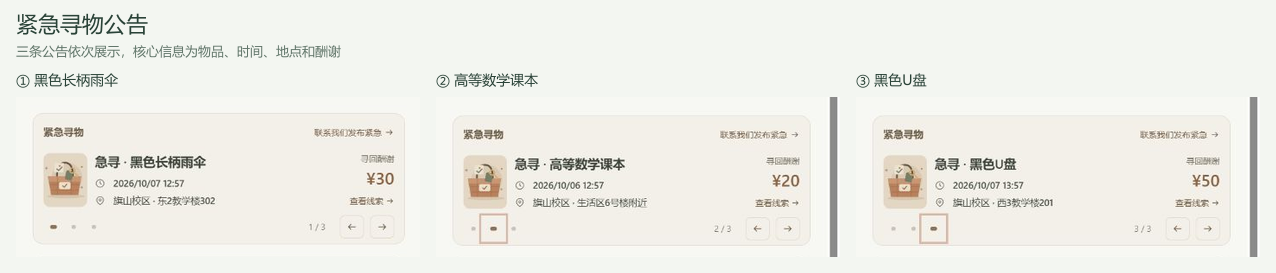
公告放在顶部栏下方,进入首页就能看到。每条突出物品名称、丢失时间、丢失地点和酬谢金额,配图帮助辨认。公告支持左右滑动,也能用箭头、圆点或键盘方向键切换。管理员可以选择进行中的寻物信息加入公告并设置酬谢和到期时间;首页只读取未到期、仍在寻找中的公告。
3. 颜色提示
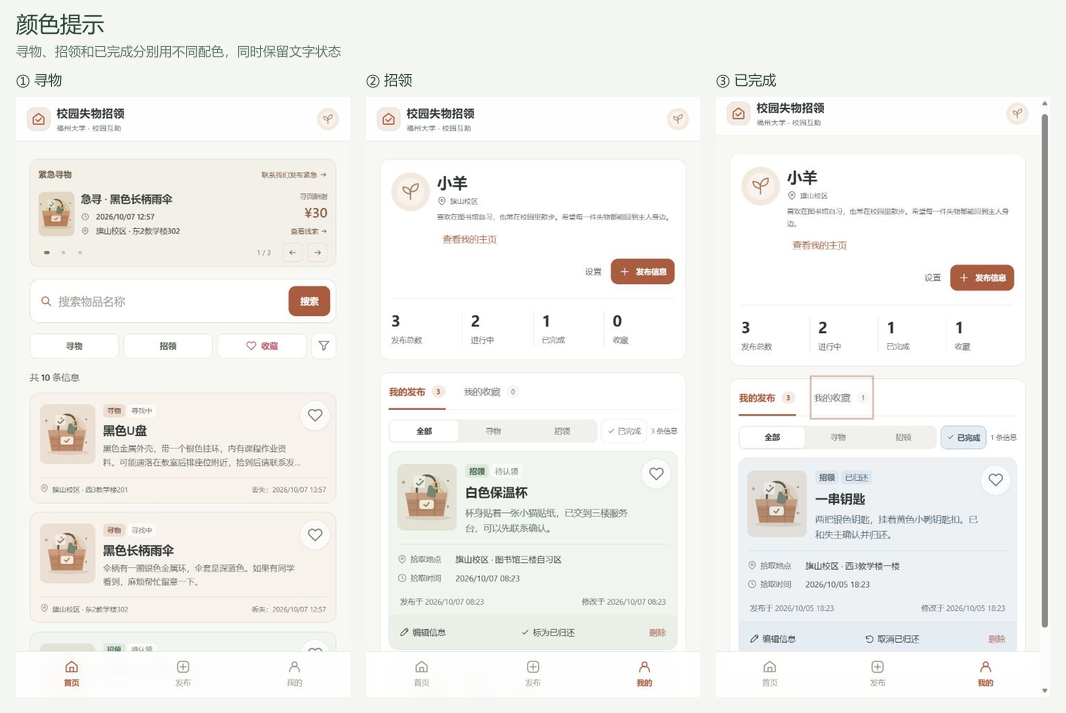
寻物卡片用暖棕色,招领卡片用浅绿色,已完成的卡片用灰蓝色。最初配色偏鲜艳,后来降低了饱和度,让不同类型能分清又不会过于花哨。颜色旁边保留「寻物、招领、寻找中、待认领、已找到、已归还」等文字,用户不用只靠颜色判断。
4. 搜索关键词高亮
高亮与筛选共用同一条分词链 D.splitKeywords()(由本次 PR 从 data.js 导出)。这一点是有意为之:如果两边各写一套分词逻辑,就会出现「筛选认为命中了、界面却没高亮」或者反过来的情况,用户会以为功能坏了。测试里有一条用例专门断言两者结果一致。
样式用荧光笔下划线,只改背景不动字重与行高,卡片不会因为高亮而跳动。
5. 首页信息流分页
每页 12 条,底部给出「加载更多(还有 N 条)」与「已显示 X / Y 条」;全部展示完后换成「已经到底啦」。结果计数区加了 aria-live="polite",翻页与筛选变化会被读屏播报。
分页的判断逻辑抽成了纯函数 D.paginate(list, limit),返回 shown / total / shownCount / remaining;limit 为 undefined、0、负数、NaN、Infinity、非整数都有兜底。抽成纯函数的好处是 views.js 不必自己算下标,也能直接写单元测试。
6. 静态模式图片上传
没有后端可上传时,图片在浏览器里用 canvas 缩放到长边 720px、以 WebP 质量 0.72 导出 data URL,随发布信息一起写进 localStorage。
参数是这样定下来的:手机拍的照片动辄 3~5 MB,原样转 base64 会立刻超过 localStorage 约 5 MB 的总额度;720px + WebP 0.72 一张约 4~8 万字符,够存十几张,也能看清物品特征。
5.3 值得展示的代码及说明
收藏切换:一个按钮完成两件事
function toggleFavorite(favorites, id) {
  return favorites.includes(id)
    ? favorites.filter(value => value !== id)
    : [...favorites, id];
}
编号已经在收藏中就移除,不在就加入,因此同一个按钮可以完成收藏与取消收藏,也不会反复添加相同编号。
图片格式白名单:刻意不放行 SVG
// 单张上限 20 万字符(约 150 KB)
const imageLimit = 200000;
// 只接受三种来源:默认占位图、后端上传的 WebP、以及本地压缩后的 WebP/JPEG/PNG。
// 刻意不支持 data:image/svg+xml —— SVG 可以内嵌脚本,没必要为一个图片字段开这个口子。
const imagePattern = /^(?:assets\/default-item\.svg|\/uploads\/[a-f0-9-]{36}\.webp|data:image\/(?:webp|jpeg|png);base64,[A-Za-z0-9+/]+=*)$/;
const validImage = value => typeof value === 'string' && value.length <= imageLimit && imagePattern.test(value);
这条白名单同时被 data.js(校验)和 views.js(imageUrl)复用,两处的规则不会各自漂移。
状态校验:不能因为新增字段把用户锁在门外
// ✅ 只拒绝「给了但非法」
|| (item.image ? !validImage(item.image) : false) ||
// ❌ 若写成 !validImage(item.image),老版本写入的、没有 image 字段的数据
//    会被整体判为非法,用户直接进不去应用,看到「无法读取浏览器保存的数据」
写测试时才发现的坑:validState() 一旦写严,缺失 image 字段的历史数据会让整个本地状态被判定为非法。这条有专门的兼容性用例守着。
5.4 特点展示截图
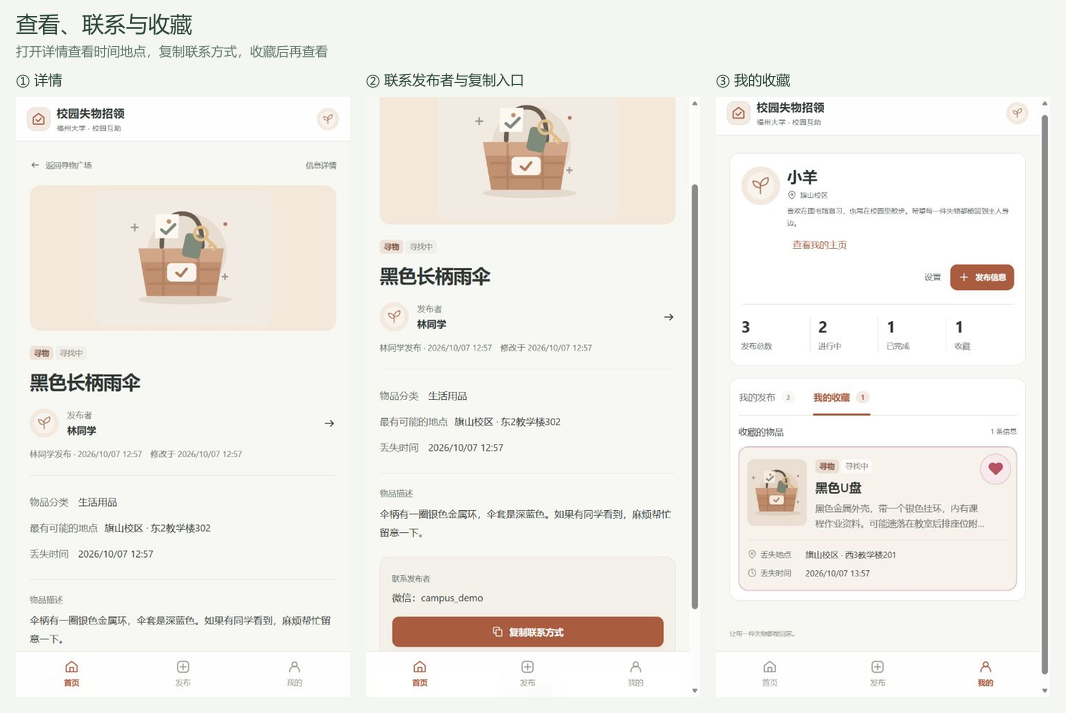
每张拼图从左向右查看。
收藏功能:详情中的物品信息、联系入口和收藏列表。
紧急公告栏:三条公告切换后展示的核心信息。
颜色提示:暖棕色寻物、浅绿色招领、灰蓝色已完成。
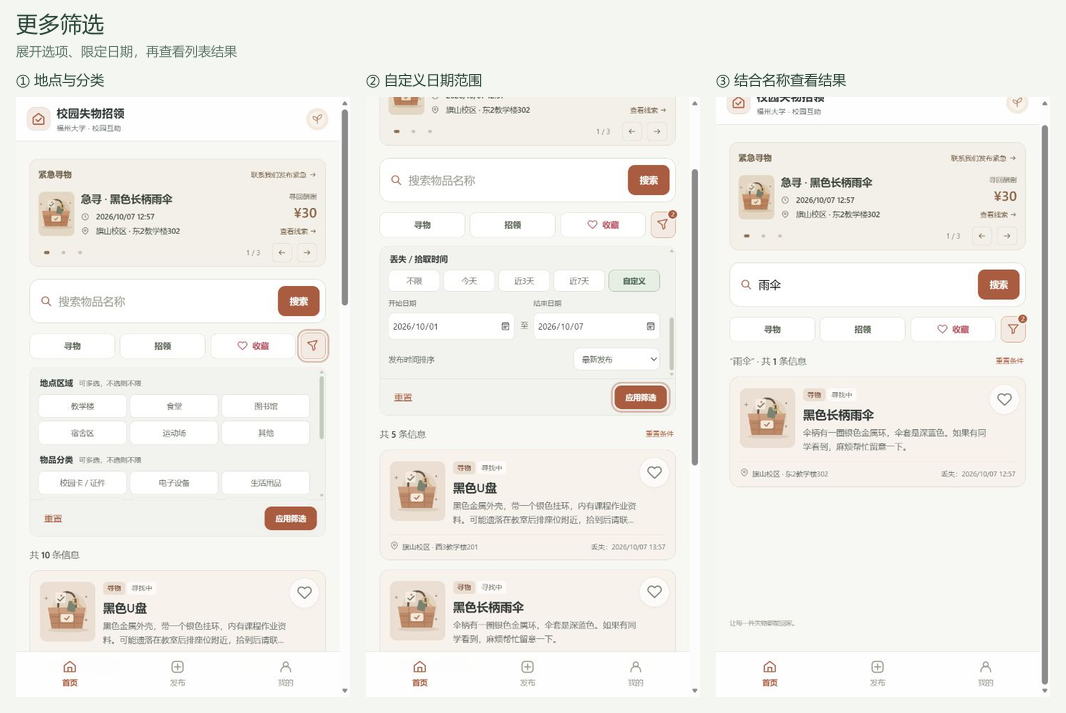
多选筛选面板(分类 + 地点 + 事件日期):
首页、发布信息与个人中心总览:
六、目录说明与使用说明
6.1 项目目录说明
.
├── index.html          页面入口、导航与弹窗容器
├── assets/             默认图片与静态资源
├── css/
│   └── styles.css      样式、动画和响应式布局
├── js/
│   ├── app.js          页面路由、表单和交互
│   ├── views.js        界面渲染与用户文本转义
│   ├── data.js         业务规则和本地存储
│   ├── api.js          后端请求与登录校验
│   ├── seed.js         静态体验初始数据
│   └── feedback.js     点击反馈
├── server/             接口、数据库、初始化、管理员及备份
├── tests/              业务、视图、接口与演示数据测试
├── e2e/                Chrome 页面流程测试
├── docs/               使用、接口、设计和验证文档
├── package.json        依赖与运行命令
└── var/                运行时生成的数据,不纳入版本管理
分层原则:业务规则(data.js)不依赖 DOM、不依赖网络,因此可以被 Node 直接 require 做单元测试;页面渲染(views.js)只做字符串拼接和转义;交互(app.js)负责把两者连起来。本次开发的三个功能都落在前两层,改动可以被独立测试,不必启动后端或打开浏览器。
6.2 使用说明
方式一:静态体验(推荐给测试同学,零依赖)
- 下载完整项目,保持目录结构不变;
- 用 Chrome 直接打开根目录的
index.html; - 无需安装 Node.js,即可体验发布、搜索、筛选、详情、收藏、编辑和状态管理。
- 数据保存在浏览器
localStorage,使用固定本地用户,不含账号系统。
请注意
js/*.js是相对路径引用,不要只拷贝单个 HTML 文件,否则脚本加载不到。
图片上传在静态模式下同样可用:选图后会自动压缩并保存在本机浏览器。
方式二:完整本地应用(含账号、多用户、图片上传)
环境要求:Node.js 版本不低于 24.19.0。
git clone https://github.com/MieSheeeep/102402136-102402152.git
cd 102402136-102402152
npm.cmd ci
npm.cmd start
打开 http://127.0.0.1:3000,可自行注册账号,或使用演示账号:
| 账号 | 密码 | 初始内容 |
|---|---|---|
demo_student |
CampusDemo123! |
叶同学:三条发布,含一条已完成;两条收藏 |
demo_lin |
CampusDemo123! |
林同学:雨伞寻物;一条收藏 |
测试命令
npm.cmd test              # 业务 / 视图 / 接口单元测试
npm.cmd run test:browser  # Chrome 页面流程测试
npm.cmd run check         # 语法检查
七、单元测试与测试评价
7.1 测试工具与简易教程
项目用的是 Mocha + Node 内置的 node:assert/strict。选它的理由很简单:Mocha 只负责「发现测试、组织用例、输出报告」,断言用 Node 标准库就够,不需要额外再学一套断言库。
一份最小可用的 Mocha 教程:
- 安装:
npm install --save-dev mocha - 在
tests/中编写以.test.cjs结尾的文件,导入 Mocha、断言库和被测模块:
const { describe, it } = require('mocha');
const assert = require('node:assert/strict');
const D = require('../js/data.js');       // 被测模块

describe('数据校验、筛选与状态管理', () => {   // describe 分组
  it('valid form has no field errors', () => {  // it 一个用例
    assert.deepEqual(D.validateItem(input), {});
  });
});
- 执行
npm.cmd test;开发时用npm.cmd run test:watch,只跑某一类用例用npm.cmd test -- --grep "search"。
| 常用写法 | 在本项目中怎样用 |
|---|---|
assert.equal(actual, expected) |
比较状态、数量或 HTTP 状态码等单个值 |
assert.deepEqual(actual, expected) |
比较收藏数组、匹配编号列表和错误对象 |
assert.ok(value) |
检查编号是否生成、错误字段是否存在 |
assert.throws(fn, /正则/) |
检查非法输入是否被正确拦下 |
beforeEach 与 afterEach |
每个接口用例建立临时数据库,结束后关闭服务并清理 |
it('说明', async () => { ... }) |
先 await 接口请求,再判断结果,避免请求没结束就算通过 |
运行失败时先看用例名称,再看实际值和预期值的差异。测试中的预期来自功能规则,不能为了让测试变绿而直接改成当前错误的结果。
7.2 测试代码与测试功能
原有测试
业务与视图部分保留了十项单元测试,另有九项接口及演示数据测试、七项 Chrome 页面测试。后来随本地后端验收扩展到 84 项自动测试 + 14 项 Chrome 流程(见 docs/2026-10-07-backend-verification.md)。
本次新增的测试
我在 tests/data.test.cjs 里补充了用例,并新建了 tests/views.test.cjs。其中高亮部分是对我改动最关键的一组:
it('escaping is safe even when the keyword is a tag name', () => {
// 关键回归:如果实现是「先 esc 再替换」,<b> 会被还原成真正的标签,
// 页面就会把 hello 渲染成粗体,等于用高亮功能打开了 XSS 的口子。
const html = V.highlight('<b>hello</b>', ['b']);
assert.ok(!html.includes('<b>'), '不应出现未转义的 <b> 标签');
assert.equal(plain(html), '<[b]>hello</[b]>');
});
it('does not break HTML entities when the keyword matches inside one', () => {
// A&B 转义后是 A&B,其中含有子串 amp。
// 「先 esc 再替换」的实现会把实体切成 A&<mark>amp</mark>; 而破坏它。
const html = V.highlight('A&B', ['amp']);
assert.equal(html, 'A&B');
assert.equal(MARKS(html), 0);
});
收藏与日期这类用例也值得一提,它们比单纯检查一条正常数据更容易发现边界问题:
it('event date range is inclusive, independent of publication, and excludes unknown dates', () => {
  const list = [
    item({ id: 'first', occurredAt: '2026-10-01', timePrecision: 'date' }),
    item({ id: 'last', occurredAt: '2026-10-06T23:59' }),
    item({ id: 'old', occurredAt: '2026-09-30T12:00' }),
    item({ id: 'unknown', occurredAt: '', timePrecision: 'unknown' })
  ];
  const ids = D.queryItems(list, {
    timeRange: 'custom', dateStart: '2026-10-01', dateEnd: '2026-10-06'
  }).map(x => x.id);
  assert.deepEqual(ids, ['first', 'last']);
});
测试的函数:D.queryItems()、D.paginate()、D.validImage()、V.highlight()、V.home()、V.imageUrl()。
7.3 测试数据、白盒设计与测试评价
构造测试数据的思路
不追求字段齐全,而是让每个用例只区分一个变量。基础样本固定为「黑色雨伞 / 生活用品 / 教学楼 / A区302 / 银色金属环」,其他用例只覆盖需要变化的字段(item({ ...overrides }) 这个工厂函数就是为此设计的)。
白盒视角的分支覆盖(以本次新增的两个函数为例):
| 函数 | 分支 | 对应测试 |
|---|---|---|
highlight |
无关键词(提前返回) | 空白关键词、undefined、空数组 |
| 命中位置 | 名称、描述、具体地点各一条 | |
| 大小写 | 搜 airpods 高亮 AirPods |
|
| 长词优先 | 关键词 ['伞', '雨伞'] 应整体高亮「雨伞」 |
|
| 正则元字符 | 搜 3.5、+、a|b |
|
| 空词与重复词 | ['', ' ']、['雨伞','雨伞'] |
|
| 非字符串入参 | undefined、null、123 |
|
| 安全性 | 标签名关键词、实体内部命中 | |
paginate |
正常分页 | 30 条取 12 → remaining 18 |
| 非法 limit | undefined、null、0、负数、NaN、Infinity、'abc' |
|
| 空列表与小数 | []、2.9 向下取整 |
面对将来测试人员的「刁难」,我考虑了这些情况
- 空字符串 / 纯空白搜索:不能把列表过滤成空,必须是「不过滤」;
- 全角空格:中文输入法下
Shift+空格打出的是\u3000,只按\s拆词会漏掉,用户会以为搜索坏了; - 跨字段假命中:名称尾部和描述首部可能拼出实际不存在的关键词,用
\n分隔字段防住; - 老数据字段缺失:
description为undefined时不能抛异常,也不能把"undefined"当成可搜内容;image缺失时不能让整个本地状态失效; - 非法图片格式:
data:image/svg+xml、javascript:、超长字符串、非 base64 字符都应被拒绝。
对测试设计的评价
能保证的:本次新增的 25 个用例覆盖了三个功能的主要分支和安全性边界;原有 11 个用例全部保持通过,没有回归。
还没覆盖到的(如实说明):
- 组合场景:关键词 + 地点多选 + 日期范围同时生效的情况没有专门用例,现在是分别验证关键词、地点/分类、日期。
- 界面层没有自动断言:placeholder 文案改了、图片选择框渲染出来了,这些改动目前只能通过「调用
V.home()/V.form()后检查输出 HTML」的集成脚本来验证,没有纳入npm test。真正的浏览器行为(点击选图、压缩、localStorage写入)需要 Playwright,而e2e/依赖 Playwright 浏览器,本地没有跑通。 - 没有做代码覆盖率统计,所以不能声称「所有分支都已覆盖」。
现有测试没有证明实际用户能更快找回物品,这一点需要后续真实使用反馈。
八、Git 代码签入记录
8.1 仓库与提交量
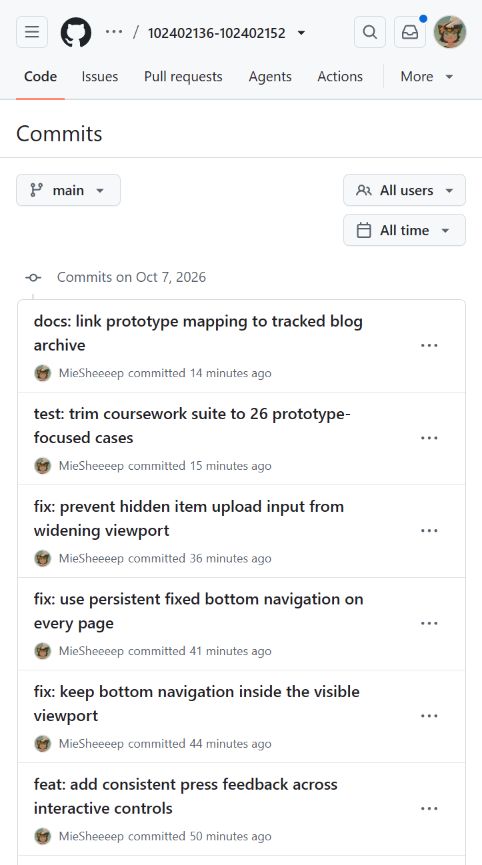
仓库 MieSheeeep/102402136-102402152 按功能和修复逐步提交,main 分支共 47 笔提交,包括 MVP、筛选和收藏动效、本地后端、图片上传、底栏修复及测试整理。可从提交历史查看每次改动。
8.2 结对记录:fork 与 Pull Request
仓库由王智洋创建,庄剑钇 fork 到自己的账号(always123-11/102402136-102402152),在自己的 fork 上拉分支开发,再向上游仓库提交 Pull Request。两次 PR 都已合并。
| PR | 标题 | 改动 | 状态 |
|---|---|---|---|
| #1 | feat(search): 扩展关键词搜索范围并支持多关键词 | 3 文件,+36 / −3 | 已合并 |
| #2 | feat(search+home+publish): 关键词高亮、首页分页、静态模式图片上传 | 6 文件,+340 / −22 | 已合并 |
PR #2 包含三笔功能提交,合计 +343 / −25 行,新增 25 个单元测试:
5182755  feat(search): 搜索结果关键词高亮                 5 文件  +118 / -11
4f89a9b  feat(home): 首页信息流分页与「加载更多」          6 文件  +108 /  -6
7d8dfde  feat(publish): 静态模式下也能上传物品图片         5 文件  +117 /  -8
commit 信息采用 type(scope): 摘要 的写法,并在正文里分行说明「改了什么、为什么改、怎么验证」,这样队友在 review 时不用读 diff 就能判断改动意图。
8.3 双方互审的具体改动
庄剑钇审王智洋:走查 js/data.js 的 queryItems() 时发现搜索只比对了 item.name,而作业正文写的是「物品名称等关键词」。进一步读 tests/data.test.cjs 确认「只按名称搜」是当时的有意设计(用例名里写着 by name),因此改动不能默默改变语义,必须在 PR 描述里说明理由。
王智洋审庄剑钇:PR #1 合并时对多关键词采用「与」而非「或」的语义做了确认;PR #2 的重点是 highlight() 的转义顺序,需要确认「先按匹配位置切分原文、再对每段单独 esc()」这一写法不会破坏 HTML 实体。
九、代码模块的困难、解决过程与收获
9.1 遇到的问题
问题一(王智洋):图片上传区域调整后,进入发布页时底部导航看起来不见了。
最开始从定位入手,试着根据可视区域调整底栏位置,但没有解决根因,反而出现底栏位置变化。
问题二(庄剑钇):搜索范围与作业要求不一致。
通读作业正文后发现原话是「通过物品名称等关键词进行搜索」,而代码里只比对了 item.name。用户记得住「银色金属环」这样的特征,但未必记得住完整名称。
问题三(庄剑钇):给 validState() 加图片校验时差点把用户锁在门外。
第一版写成了 !validImage(item.image),跑测试时发现原有夹具全部失败——因为测试构造的 item 根本没有 image 字段。这在真实场景里意味着:老版本写入的、没有 image 字段的本地数据会被整体判为非法,用户打开应用只会看到「无法读取浏览器保存的数据」。
9.2 排查与解决过程
问题一:后来检查了页面实际宽度,发现一个隐藏的文件输入框被普通表单的 width: 100% 样式覆盖。控件虽然看不见,却把页面撑宽了,浏览器因此重新计算视口,底栏也跟着跑出可见范围。最后保留底栏的固定定位,为上传区域增加相对定位,并明确限制隐藏控件的尺寸。测试也跟着修改:横向溢出改为比较 scrollWidth 和 documentElement.clientWidth(原先比较 innerWidth,它同样会被撑宽,导致测试漏报)。
问题二:先看 js/data.js 的 queryItems() 确认搜索只用了 item.name;再读 tests/data.test.cjs,发现有一条用例明确写着 matches case-insensitively by name——说明这是当时的有意设计,不是遗漏。所以改动不能默默改变语义,必须在 PR 描述里写清楚为什么改。改的时候还踩了一个自己没预料到的坑:最初把三个字段直接 join('') 拼接,写完测试才意识到名称尾部和描述首部可能拼出实际不存在的关键词,属于假命中,改成 join('\n') 后消除。
问题三:把校验从「必须合法」改成「给了才要求合法」:
|| (item.image ? !validImage(item.image) : false) ||
并补了一条兼容性用例锁住这个行为:a stored state without an image field is still readable。
另外一个环境问题:本机 git clone 一度报 Could not resolve host: github.com,重试三次都失败。用浏览器实测 github.com 可以正常打开,说明不是断网;改用 gh(GitHub CLI)操作则 fork 成功,说明 gh 走的通道和 git 的 HTTPS 不是一回事。于是改用 GitHub 的 Git Data API 提交——先读取 main 的最新 commit 与 tree,再为改动文件创建 blob,组合成新 tree 和新 commit,最后建分支引用并开 PR,全程不需要本地 git 仓库。(后来网络恢复,后续提交改回 git。)
9.3 收获与改进
- 看起来是 A 的问题,根因可能在 B(问题一)。一个看不见的控件把页面撑宽,表现却像底栏坏了。以后先测量布局,再改定位;发现一个漏测场景,就把它补进测试。
- 读需求要读到字(问题二)。「物品名称等关键词」这个「等」字是我这次最大的收获。第一遍读题完全没注意到,是回头逐条核对评分规则时才发现的。需求里的虚词往往比实词信息量更大。
- 改公共函数的语义,先看测试(问题二)。测试用例名本身就是一份「当初为什么这么写」的文档。看到
by name这三个词,我才知道要谨慎,也才知道要在 PR 里解释。 - 加字段校验要向后兼容(问题三)。凡是给
validState这类「总闸门」加限制,都要先问一句:老数据会不会因此进不来?加了限制就要配一条历史数据的回归用例。 - 工具链要准备 Plan B。
git clone不通不代表没法提交代码,GitHub 的 API 同样能完成一次规范的 PR。把「提交代码」和「git命令」绑定在一起是一种思维定式。
程序已经能走完「发布—浏览或搜索—详情—联系—更新状态」。这次反复修改的地方主要是信息摆放、筛选交互、图片和底部导航。原型能点通以后,实际页面仍需要用真实输入、不同屏幕宽度和错误情况检查。
下一步更需要让同学拿实际场景试用,看看名称、地点和时间是否够用,以及找到以后是否容易发现状态更新入口,再决定继续加什么功能。
十、队友评价
10.1 队友做得好的地方
王智洋的工程质量明显在我之上。 三个具体的例子:
- 分层清晰,直接降低了协作成本。
data.js(业务规则)不依赖 DOM、不依赖网络,views.js只做字符串拼接与转义,app.js负责把两者连起来。正因为这样,我第一次读代码就能确定「搜索应该改在queryItems()里」,改完之后只跑 Node 单元测试就能验证,完全不需要启动后端或打开浏览器。如果业务逻辑和 DOM 混在一起,我这次的改动面会大得多,测试也不可能跑得这么快。这是好设计带来的协作便利。 - 文档意识和自省意识强。
docs/homework-gap-checklist.md里把自己还没做完的事逐条列了出来,包括「仓库显示 0 fork、0 PR,尚无可核对的结对记录」这一条。这种把短板写清楚的坦诚,让我一眼就知道该从哪里接手。2026-10-07-backend-verification.md里连「首次npm ci失败是因为服务占用了 Sharp 原生库」这种细节都记下来了。 - 测试写得比我细。 原有的用例里已经包含了「重开一条已完成的信息要保留原内容与发布时间」「地点/分类多选的并集与交集语义」这类容易被忽略的边界,我是照着这个风格补写自己的用例的。
10.2 希望改进的地方
- 分工说明里缺少「谁负责哪一部分」。 仓库里的文档大多是从「项目」视角写的,读起来很清楚,但缺少从「人」视角的分工记录;作业明确要求给出具体分工,也需要能在仓库里核对。建议每完成一个模块就在 README 或
docs/里记一笔负责人。这次我补的 PR 描述算是补上了一部分。 - README 里已经写明的已知限制,建议同步开成 issue。 比如「首页尚未接入分页」(本次已解决)、「替换的旧图片暂时保留」这些,写在 README 里容易被略过,开成 issue 更容易跟踪,也方便下次结对时直接认领任务。
- 提交粒度的建议:部分提交把多个模块的改动放在一起,review 时不太好定位。如果按「一个提交只做一件事」来切分,我在做代码复审时会轻松很多。
附:本次开发的环境与命令速查
# 本地预览
npm.cmd ci && npm.cmd start        # http://127.0.0.1:3000
# 只跑业务与视图测试(无需 fastify / playwright)
npx mocha "tests/views.test.cjs" "tests/data.test.cjs"
# 全量语法检查
npm.cmd run check
| 测试范围 | 数量 | 本次是否本地跑通 |
|---|---|---|
tests/data.test.cjs + tests/views.test.cjs |
37 | ✅ 通过 |
接口与演示数据测试(backend / demo-seed / security) |
需 npm ci 安装 fastify |
未在本次环境运行 |
Chrome 页面流程(e2e/) |
需 Playwright 浏览器 | 未在本次环境运行 |
据 docs/2026-10-07-backend-verification.md 记录,完整环境下的结果为 84 项自动测试 + 14 项 Chrome 流程通过。

 浙公网安备 33010602011771号