
软件工程结对作业2
2026秋软件工程结对作业(第二次):校园失物招领程序实现
本篇是 庄剑钇(102402152) 的作业博客。结对同学为王智洋(102402136),项目由两人共同完成,本文侧重记录我负责的部分。
一、作业链接与结对信息
| 项目 | 内容 |
|---|---|
| 课程 | H202601 软件工程与软件工程实践 |
| 本次作业要求 | 2026秋软件工程结对作业(第二次之程序实现) |
| 作业目标 | 依据上次的需求分析与原型,实现可实际操作的校园失物招领程序,并完成单元测试 |
| 结对成员 | 王智洋(102402136)、庄剑钇(102402152) |
| 队友博客 | 王智洋的博客 |
| 我的博客 | 庄剑钇的博客 |
| GitHub 项目地址 | MieSheeeep/102402136-102402152 |
| 我的 fork | always123-11/102402136-102402152 |
| 本次 PR | Pull Request #1:扩展关键词搜索范围并支持多关键词 |
| 上次需求与原型 | 校园失物招领:需求分析与原型设计 |
二、两人工作分工
本次作业按「一人主实现、一人主走查与增强」的方式推进,两个人的产出都体现在仓库里。
| 成员 | 本次负责的具体工作 | 协作记录 |
|---|---|---|
| 王智洋 102402136 |
仓库创建与主体实现:前端页面与交互(js/app.js、js/views.js、css/styles.css)、业务规则(js/data.js)、本地后端与数据库(server/)、演示数据(js/seed.js)、大部分单元测试与项目文档 |
仓库 MieSheeeep/102402136-102402152 的历次提交;docs/ 下的设计与验证文档 |
| 庄剑钇 102402152 |
① fork 仓库并走通 PR 流程;② 对照作业正文做代码走查,定位搜索范围不足的问题;③ 实现「搜索范围扩展 + 多关键词」(js/data.js、js/views.js);④ 补充 3 个单元测试;⑤ 用 Chrome 直接打开 index.html 做验收;⑥ 编写本博客 |
PR #1(含改动说明与测试结果);tests/data.test.cjs 由 8 项增加到 11 项 |
说明:本次分工与上次原型阶段的分工不同。上次是「需求与原型 / 流程与文档」两条线,本次是「主体实现 / 走查与增强」两条线。我这边的工作量集中在走查、功能增强和验证上,代码规模小于王智洋,工作边界以 PR 记录为准。
三、PSP 表格与耗时分析
。
| PSP2.1 | 任务 | 预估耗时 | 实际耗时 |
|---|---|---|---|
| Planning | 计划 | 15 | 15 |
| Estimate | 估计这个任务需要多少时间 | 20 | 20 |
| Development | 开发 | — | — |
| Analysis | 需求分析(包括学习新技术) | 60 | 90 |
| Design Spec | 生成设计文档 | 30 | 25 |
| Design Review | 设计复审 | 20 | 30 |
| Coding Standard | 代码规范(为目前的开发制定合适的规范) | 15 | 15 |
| Design | 具体设计 | 40 | 45 |
| Coding | 具体编码 | 120 | 180 |
| Code Review | 代码复审 | 40 | 60 |
| Test | 测试(自我测试,修改代码,提交修改) | 50 | 70 |
| Reporting | 报告 | — | — |
| Test Report | 测试报告 | 30 | 35 |
| Size Measurement | 计算工作量 | 10 | 10 |
| Postmortem & Process Improvement Plan | 事后总结,并提出过程改进计划 | 20 | 25 |
| 合计 | 以上具体任务之和 | 470 | 620 |
耗时分析(原先怎么估计 → 实际多花多少 → 原因 → 下次怎么调整):
- 具体编码:预估 120 分钟,实际 180 分钟,超了 60 分钟(+50%)。 原本以为只是把
item.name.includes(keyword)换成多字段匹配,动手后才发现两个问题:一是要保留原有的大小写不敏感、首尾空白裁剪等既有行为,二是「多关键词」会改变queryItems的过滤语义,必须回头确认原来的 8 个测试用例不会被我改坏。真正花时间的是扩写测试和回归验证,而不是写业务代码本身。 - 需求分析:预估 60 分钟,实际 90 分钟,超了 30 分钟。 主要是把老师作业正文和评分规则通读了一遍,又对照仓库里的
docs/homework-gap-checklist.md逐条核对「已实现 / 还差什么」。这部分不能省——正是这一步才发现了搜索范围的缺口。 - 代码复审:预估 40 分钟,实际 60 分钟。 读别人的代码比写自己的慢,需要先理解
data.js里normalize、validState、createStore这套设计意图,才能判断改动应该加在哪一层。 - 测试报告与事后总结:基本符合预估。 因为测试是边写边记的,最后只是整理。
这次的教训:我们一开始把「改搜索」估成了一小时以内的小改动,忽略了它牵动的回归面。下次遇到改动公共函数语义的任务,应该把「回归验证 + 补测试」单独列成一项来估时,而不是混在 Coding 里。
四、设计实现过程
4.1 设计和实现过程
项目是网页(原生 HTML/CSS/JavaScript + 可选的 Fastify 本地后端),保留了上次原型「首页 / 发布 / 我的」三个入口。核心链路是:
发布信息 → 浏览或搜索 → 查看详情 → 联系发布者 → 更新状态
代码按职责分层,这是我能在不认识全部代码的情况下快速定位改动点的前提:
| 层次 | 文件 | 负责什么 | 一个具体例子 |
|---|---|---|---|
| 页面与交互 | js/app.js、js/views.js |
收集输入、渲染界面、给出提示 | 必填地点为空时,在该字段旁说明问题 |
| 业务规则 | js/data.js |
校验、筛选、状态变化 | 寻物完成后显示「已找到」,招领完成后显示「已归还」 |
| 接口调用 | js/api.js |
登录校验、请求后端 | 完整模式下页面从接口读取数据 |
| 后端与存储 | server/、SQLite |
账号、权限、持久化、图片 | 只有发布者本人能标记完成 |
我这次的改动全部落在业务规则层和一处界面文案上,没有触碰后端,这也是它可以被单独验证的原因。
4.2 程序流程图与数据流图
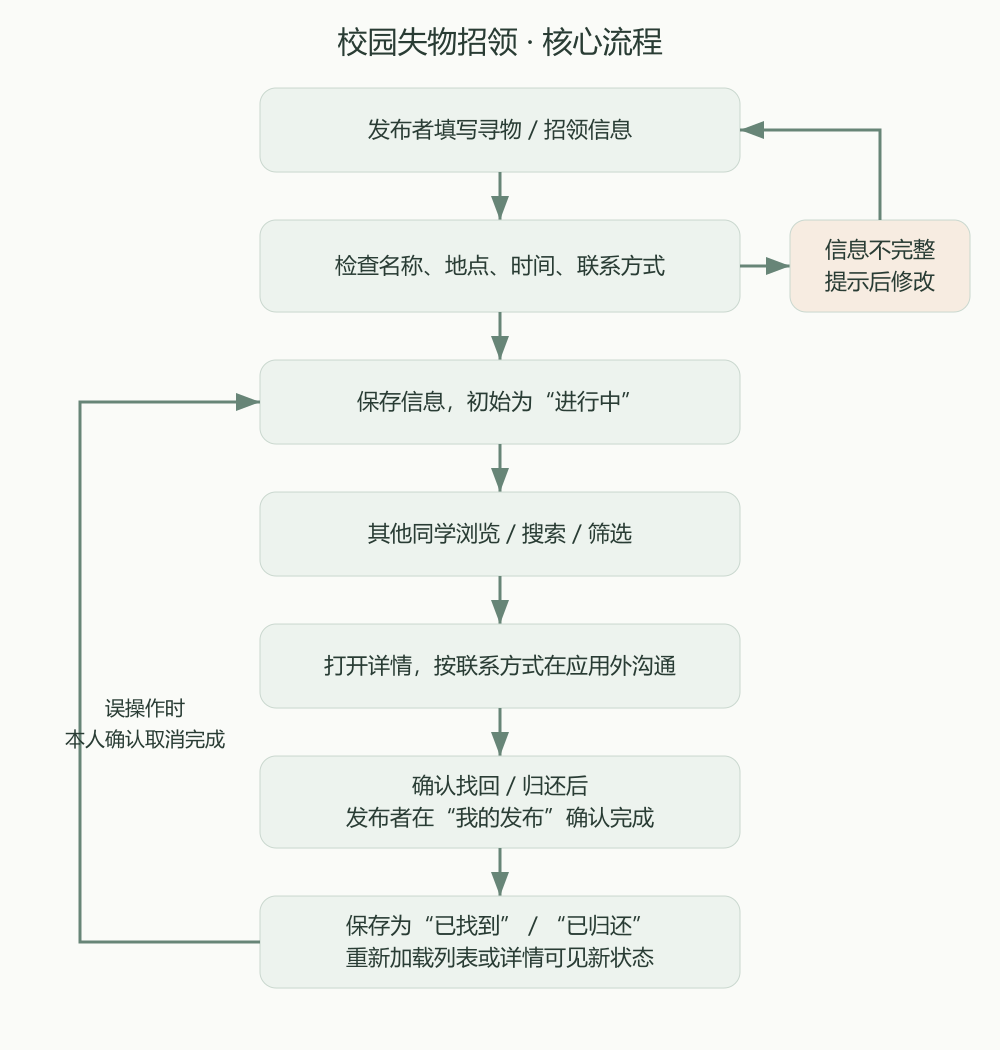
核心业务流程图(发布 → 浏览/搜索 → 详情 → 联系 → 更新状态):
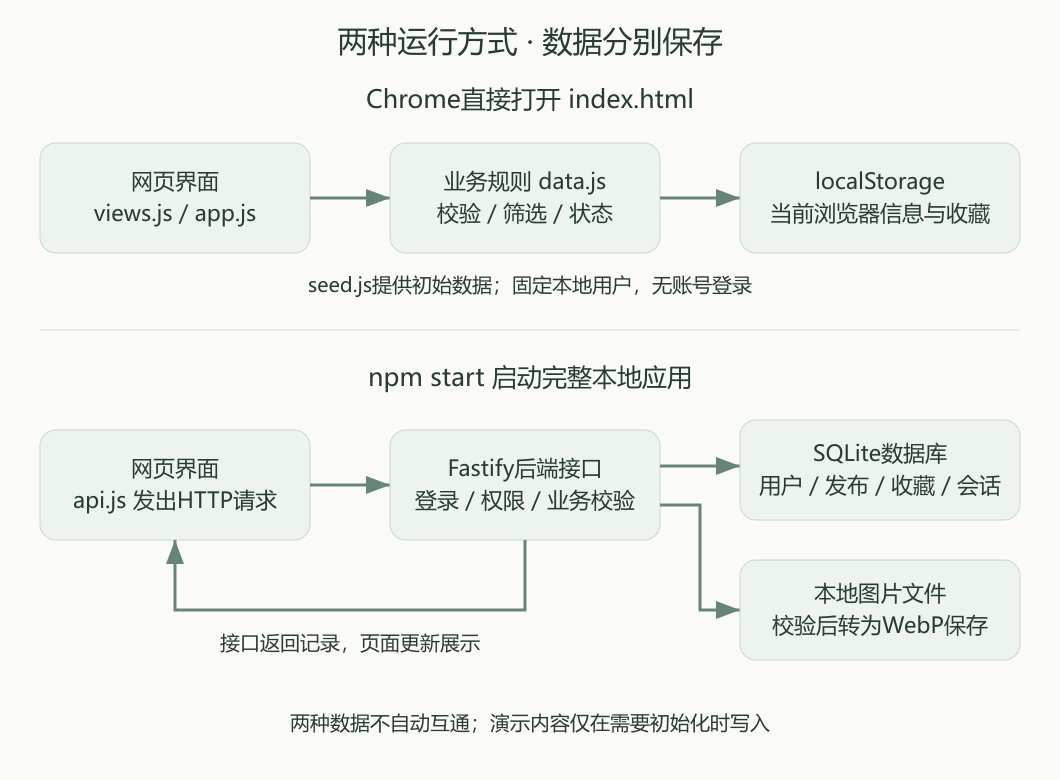
整体数据流图:
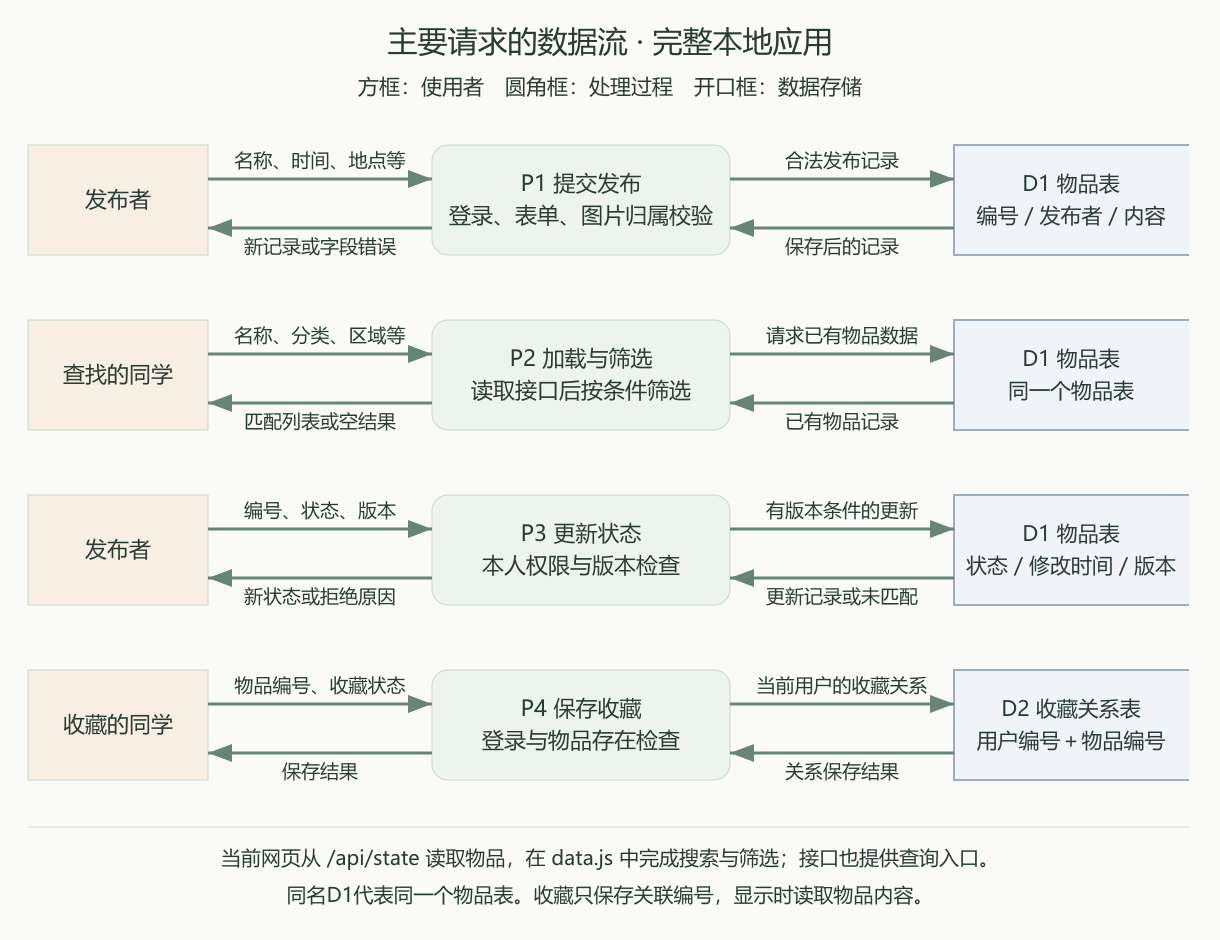
一次页面请求的数据流(完整模式):
我这次改动的数据流路径(关键词从输入框到筛选器):
搜索框输入「黑色 雨伞」
        │
        ▼
app.js  search(keyword)          ← 记录最近搜索
        │
        ▼
filters.keyword = "黑色 雨伞"
        │
        ▼
data.js  queryItems(items, filters)
        │
        ├─ splitKeywords()       ← 【新增】按空白拆词,兼容全角空格
        │        → ["黑色", "雨伞"]
        │
        ├─ matchesKeywords()     ← 【新增】名称 + 描述 + 具体地点,逐词「与」匹配
        │
        ▼
返回过滤后的列表 → views.js 渲染卡片
4.3 关键代码及说明
改前的代码(js/data.js,queryItems 内):
const keyword = text(filters.keyword).toLocaleLowerCase();
return items.filter(item =>
  (!keyword || item.name.toLocaleLowerCase().includes(keyword)) && ...
只比对 item.name。而作业正文的原话是「并通过物品名称等关键词进行搜索」——「等」字说明搜索不应该只限于名称。实际使用时,同学更可能记得的是物品特征(「银色金属环」「小猫贴纸」)或者具体地点(「图书馆三楼自习区」),而不是完整的物品名称。
改后的代码:
// 把搜索词按空白拆成多个关键词,兼容半角与全角空格
function splitKeywords(value) {
  return text(value).toLocaleLowerCase().split(/[\s\u3000]+/).filter(Boolean);
}

// 关键词匹配范围:物品名称 + 物品描述 + 具体地点。
// 作业要求「通过物品名称等关键词进行搜索」,只比对名称会漏掉
// 用户最常用来描述物品特征的描述与地点文字。
// 多个关键词之间是「与」的关系:必须全部命中,便于逐步缩小范围。
function matchesKeywords(item, words) {
  if (!words.length) return true;
  const haystack = [item.name, item.description, item.locationDetail]
    .map(text).join('\n').toLocaleLowerCase();
  return words.every(word => haystack.includes(word));
}

function queryItems(items, filters = {}, favorites = [], now = new Date()) {
  const words = splitKeywords(filters.keyword);
  const range = eventRange(filters, now);
  return items.filter(item =>
    matchesKeywords(item, words) && ...
三个设计决定及理由:
.map(text)而不是直接拼接。text()会把非字符串(老数据里description可能是undefined)统一转成'',避免出现"undefined"被搜到这种诡异情况。.join('\n')而不是join('')。 用换行分隔三个字段,防止跨字段拼出假命中——比如名称结尾是「黑色」、描述开头是「雨伞」,拼成黑色雨伞会让「黑色雨伞」这个本不存在的词被搜到。换行符不会被用户输入匹配到,可以彻底避免这种跨界拼接。- 多关键词用「与」而不是「或」。 「或」会让「黑色 雨伞」的结果比单搜「雨伞」还多,不符合用户「逐步缩小范围」的直觉。测试里专门验证了
保温杯 雨伞返回 0 条。
同时把搜索框的提示文案和信息同步更新,让用户知道可以搜描述和地点:
<!-- js/views.js:改前 -->
<label class="sr-only" for="keyword">搜索物品名称</label>
<input id="keyword" ... placeholder="搜索物品名称">

<!-- 改后 -->
<label class="sr-only" for="keyword">搜索物品名称、描述或地点</label>
<input id="keyword" ... placeholder="搜索名称、描述或地点">
五、附加特点的设计与展示
项目里有三个我自己用下来觉得最有价值的附加特点。
5.1 特点的目的与意义
| 附加特点 | 解决什么问题 | 为什么有意义 |
|---|---|---|
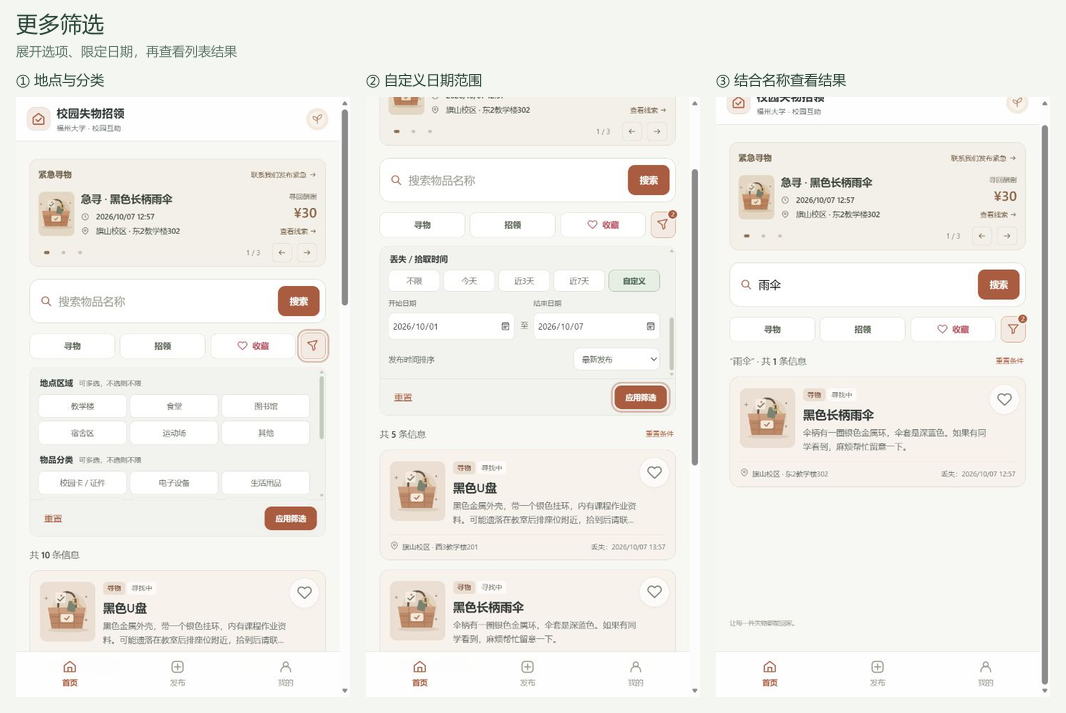
| 分类 / 地点多选 + 事件日期范围 | 只按名称搜,结果噪声大 | 寻物常常只记得「大概在哪几天、大概在哪个区域丢的」,按事件日期和区域筛选比按名称更贴近真实回忆方式 |
| 一键复制联系方式 | 手动记微信号容易抄错 | 失物招领的联系方式是一次性、易错的信息,复制比手抄可靠得多;复制失败时还提供「选中文本手动复制」的兜底 |
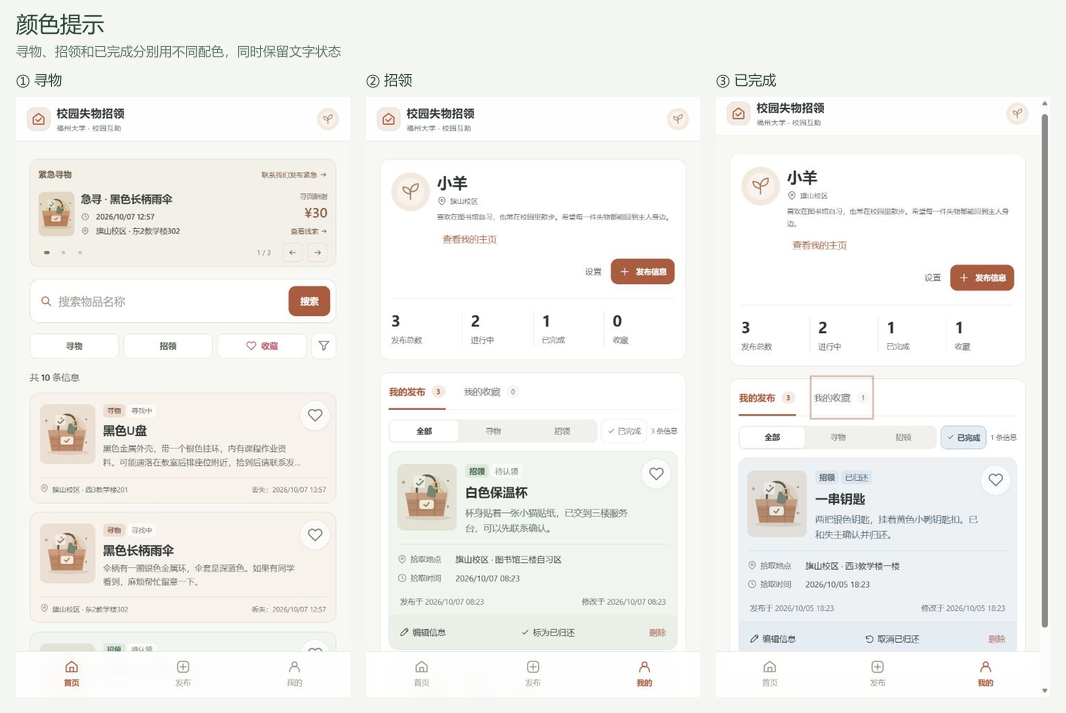
| 状态配色 + 文字标签双重标识 | 只看颜色分不清「已找到/已归还」 | 暖棕=寻物、浅绿=招领、灰蓝=已完成,颜色用于快速扫读,文字标签保证色觉障碍用户也能分辨 |
5.2 特点的设计实现
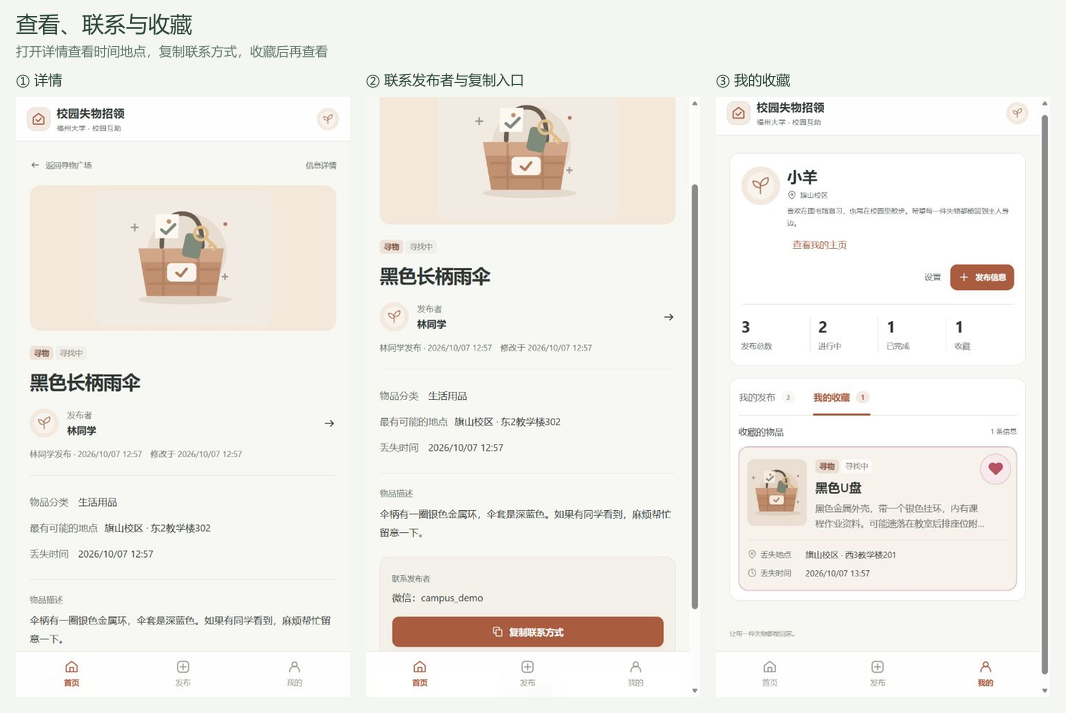
以「一键复制联系方式」为例:联系方式的展示是脱敏的(列表页不直接暴露完整联系方式),只有打开详情、由用户主动点击才复制到剪贴板。这样既方便又避免联系方式被批量抓取。
复制逻辑同时考虑了浏览器限制:navigator.clipboard 在非 HTTPS 或用户未授权时会失败,所以必须捕获异常并给出「手动复制」的提示,而不是静默失败——这是这类小功能最容易踩的坑。
5.3 值得展示的代码及说明
我在 js/data.js 里改的 matchesKeywords 只用了字符串处理,没有引入任何依赖,因此静态模式(直接打开 HTML)和完整模式(连后端)走的是同一套搜索逻辑。这一点很重要:如果搜索改成依赖后端 SQL 的 LIKE,两种运行方式的结果就会不一致。
5.4 特点展示截图
多选筛选面板(分类 + 地点 + 事件日期):
详情页的联系方式与收藏:
类型与状态的配色标识:
六、目录说明与使用说明
6.1 项目目录说明
.
├── index.html          页面入口、导航与弹窗容器
├── assets/             默认图片与静态资源
├── css/                样式、动画和响应式布局
├── js/
│   ├── app.js          页面路由、表单和交互
│   ├── views.js        界面渲染与用户文本转义
│   ├── data.js         业务规则和本地存储   ← 本次改动
│   ├── api.js          后端请求与登录校验
│   ├── seed.js         静态体验初始数据
│   └── feedback.js     点击反馈
├── server/             接口、数据库、初始化、管理员及备份
├── tests/              业务、视图、接口与演示数据测试  ← 本次改动
├── e2e/                Chrome 页面流程测试
├── docs/               使用、接口、设计和验证文档
├── package.json        依赖与运行命令
└── var/                运行时生成的数据,不纳入版本管理
分层原则:业务规则(data.js)不依赖 DOM、不依赖网络,因此可以被 Node 直接 require 做单元测试;页面渲染(views.js)只做字符串拼接和转义;交互(app.js)负责把两者连起来。我这次只改前两层,改动可以被独立测试。
6.2 使用说明
方式一:静态体验(推荐给测试同学,零依赖)
- 下载完整项目,保持目录结构不变;
- 用 Chrome 直接打开根目录的
index.html; - 无需安装 Node.js,即可体验发布、搜索、筛选、详情、收藏、编辑和状态管理。
- 数据保存在浏览器
localStorage,使用固定本地用户,不含账号系统和图片上传。
我按这个方式实测过:直接双击
index.html(file://协议)打开,搜索、筛选、发布、收藏、状态更新都正常。请注意js/*.js是相对路径引用,不要只拷贝单个 HTML 文件,否则脚本加载不到。
方式二:完整本地应用(含账号、多用户、图片上传)
环境要求:Node.js 版本不低于 24.19.0。
git clone https://github.com/MieSheeeep/102402136-102402152.git
cd 102402136-102402152
npm.cmd ci
npm.cmd start
打开 http://127.0.0.1:3000,可自行注册账号,或使用演示账号:
| 账号 | 密码 | 初始内容 |
|---|---|---|
demo_student |
CampusDemo123! |
叶同学:三条发布,含一条已完成;两条收藏 |
demo_lin |
CampusDemo123! |
林同学:雨伞寻物;一条收藏 |
测试命令:
npm.cmd test            # 业务/接口单元测试
npm.cmd run test:browser # Chrome 页面流程测试
npm.cmd run check       # 语法检查
七、单元测试与测试评价
7.1 测试工具与简易教程
项目用的是 Mocha + Node 内置的 node:assert/strict。选它的理由很简单:Mocha 只负责「发现测试、组织用例、输出报告」,断言用 Node 标准库就够,不需要额外再学一套断言库。
一份最小可用的 Mocha 教程(我自己是这么上手的):
- 安装:
npm install --save-dev mocha - 写测试文件,文件名以
.test.js(本项目是.test.cjs)结尾:
const { describe, it } = require('mocha');
const assert = require('node:assert/strict');
const D = require('../js/data.js');       // 被测模块

describe('数据校验、筛选与状态管理', () => {   // describe 分组
  it('valid form has no field errors', () => {  // it 一个用例
    assert.deepEqual(D.validateItem(input), {});
  });
});
- 运行:
npx mocha "tests/**/*.test.cjs",或用package.json里的npm test - 只想跑某一类用例:
npm test -- --grep "search"(按用例名过滤)
三个关键点:
describe可以嵌套,形成「模块 → 场景 → 用例」的层级;- 断言失败时 Mocha 会打印期望值与实际值的 diff,所以
assert.deepEqual比手写if好用得多; it的回调可以是async,Mocha 会等待 Promise,接口测试就靠这个。
7.2 测试代码与测试功能
tests/data.test.cjs 里原有的用例覆盖了表单校验、状态变更、筛选组合、事件日期范围、存储读写。我在这个文件里新增了 3 个用例,覆盖我改动引入的新行为:
it('search also matches the description and the detailed place', () => {
  const list = [item(),
    item({ id: 'two', name: '白色保温杯',
           description: '杯身贴有一只小猫贴纸',
           locationDetail: '图书馆三楼自习区' })];
  // 命中描述
  assert.deepEqual(D.queryItems(list, { keyword: '贴纸' }, []).map(x => x.id), ['two']);
  // 命中具体地点
  assert.deepEqual(D.queryItems(list, { keyword: '自习区' }, []).map(x => x.id), ['two']);
  // 仍然命中名称(回归保护)
  assert.deepEqual(D.queryItems(list, { keyword: '金属环' }, []).map(x => x.id), ['one']);
});

it('multiple keywords must all match, ignoring full-width spaces', () => {
  const list = [item(),
    item({ id: 'two', name: '白色保温杯', description: '杯身贴有小猫贴纸' }),
    item({ id: 'three', name: '黑色保温杯', description: '杯身贴有小猫贴纸' })];
  assert.deepEqual(D.queryItems(list, { keyword: '保温杯 贴纸' }, []).map(x => x.id), ['two', 'three']);
  // 全角空格(\u3000)也要能拆词
  assert.deepEqual(D.queryItems(list, { keyword: '保温杯\u3000黑色' }, []).map(x => x.id), ['three']);
  // 「与」语义:搜不到不存在的组合
  assert.equal(D.queryItems(list, { keyword: '保温杯 雨伞' }, []).length, 0);
});

it('a whitespace-only keyword does not filter anything', () => {
  const list = [item(), item({ id: 'two' })];
  assert.equal(D.queryItems(list, { keyword: '   ' }, []).length, 2);
  assert.equal(D.queryItems(list, { keyword: '\u3000' }, []).length, 2);
});
测试的函数:D.queryItems(items, filters, favorites, now) —— 项目筛选与搜索的唯一入口。它在静态模式和完整模式下都会被调用,所以这一处的行为正确性影响面最大。
运行结果:
  数据校验、筛选与状态管理
    √ valid form has no field errors
    √ whitespace-only required fields are rejected
    √ create trims fields and starts open
    √ search trims input and matches case-insensitively by name
    √ search also matches the description and the detailed place
    √ multiple keywords must all match, ignoring full-width spaces
    √ a whitespace-only keyword does not filter anything
    √ favorite toggle adds once then removes
    √ reopening preserves content and publication time for both types
    √ multiple locations and categories combine union within groups and intersection across groups
    √ event date range is inclusive, independent of publication, and excludes unknown dates

  11 passing (7ms)
由 8 项增加到 11 项,原有 8 项全部保持通过,没有回归。
7.3 测试数据、白盒设计与测试评价
构造测试数据的思路:不追求字段齐全,而是让每个用例只区分一个变量。
- 基础样本固定为「黑色雨伞 / 生活用品 / 教学楼 / A区302 / 银色金属环」,其他用例只覆盖需要变化的字段(
item({ ...overrides })这个工厂函数就是为此设计的); - 命中位置分散:新增用例里的关键词分别落在描述(
金属环、贴纸)和具体地点(自习区)上,名称的命中由原有用例(airpods)保证。这样能验证三个字段都被搜索到,而不是其中一个在工作、另外两个恰好也命中; - 多关键词的交集是有意设计的:
保温杯 贴纸命中 2 条、保温杯 黑色命中 1 条、保温杯 雨伞命中 0 条,三种情况分别验证「与」语义的多、单、空。
白盒视角的覆盖:拿 splitKeywords / matchesKeywords 两个新函数来说,我用例覆盖了这些分支——
| 分支 | 对应测试 |
|---|---|
words.length === 0(提前返回 true) |
a whitespace-only keyword does not filter anything(半角空格与全角空格各一次) |
| 单词命中、位于描述 | search also matches the description... 第一句 |
| 单词命中、位于地点 | 第二句 |
| 单词命中、位于名称 | 第三句(同时是回归保护) |
| 多词全命中 | 保温杯 贴纸 |
| 多词部分命中 → 应排除 | 保温杯 黑色 只返回 1 条 |
| 多词全不命中 → 空结果 | 保温杯 雨伞 返回 0 条 |
| 全角空格分词 | 保温杯\u3000黑色 |
面对将来测试人员的「刁难」,我考虑了这些情况:
- 空字符串 / 纯空白搜索:不能把列表过滤成空,必须是「不过滤」;
- 全角空格:中文输入法下
Shift+空格打出的是\u3000,如果只按\s拆词就会漏掉,用户会以为搜索坏了; - 大小写:
AirPods用小写airpods也要能搜到(这条原有测试已经覆盖,我保留不动); - 跨字段假命中:名称尾部与描述首部拼接出关键词,用
\n分隔字段防住; - 老数据字段缺失:
description为undefined时不能抛异常,也不能把"undefined"当成可搜内容。
对测试设计的评价:这套用例能保证「我改动的那部分逻辑是对的」,但还有两个没覆盖到的点,需要如实说明:
queryItems与其他筛选条件的组合(关键词 + 地点多选 + 日期范围同时生效)没有专门的用例。现在的测试是分别验证关键词、地点/分类、日期,组合场景只有一条multiple locations and categories combine...。- 界面层没有测试。搜索框的 placeholder 改了,但没有任何用例断言「界面上真的显示了新文案」——这类断言需要 Playwright 之类的浏览器测试,属于
e2e/的范畴,而e2e/依赖 Playwright 浏览器,本地没有跑通。
所以我的判断是:单元测试层面基本够用,但「搜索在真实界面里确实生效」这件事还没有被自动验证,只能靠手动打开页面确认。
八、Git 代码签入记录
本次改动通过 fork + PR 的方式提交,符合作业「另一位同学 fork 该项目,有进展时 pull request」的要求。
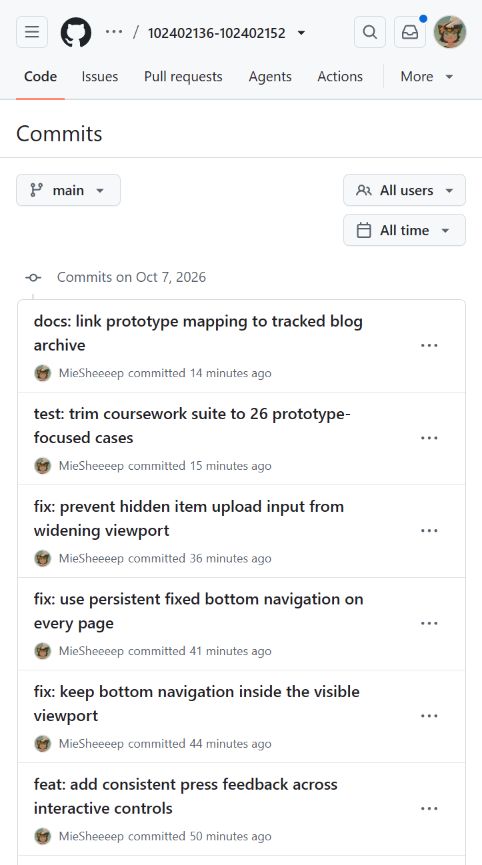
我的提交记录:
- fork:
always123-11/102402136-102402152 - 分支:
feat/search-keyword-scope - PR:Pull Request #1
- commit message:
feat(search): 扩展关键词搜索范围并支持多关键词
commit 信息采用 type(scope): 摘要 的写法,并在正文里分行说明「改了什么、为什么改、怎么验证」,这样队友在 review 时不用读 diff 就能判断改动意图。
九、代码模块的困难、解决过程与收获
9.1 问题描述
问题一:搜索范围与作业要求不一致。 通读作业正文后发现原话是「通过物品名称等关键词进行搜索」,而代码里只比对了 item.name。用户记得住「银色金属环」这样的特征,但未必记得住完整的物品名称。
问题二:本机 git clone 一直失败。 走到 fork 这一步时,git clone 报 Could not resolve host: github.com,连重试三次都失败。
9.2 排查与解决过程
问题一:
- 先看
js/data.js的queryItems(),确认搜索只用了item.name; - 再去读
tests/data.test.cjs,发现有一条用例明确写着matches case-insensitively by name——说明「只按名称搜」是当时的有意设计,不是遗漏。所以我的改动不能默默改变语义,必须在 PR 描述里写清楚为什么改; - 改的时候踩了一个自己没预料到的坑:最初把三个字段直接
join('')拼接,写完测试才意识到名称尾部和描述首部可能拼出实际不存在的关键词,属于假命中。改成join('\n')后消除。
问题二:
- 先怀疑是网络问题,重试了三次,仍然失败;
- 用浏览器实测
github.com可以正常打开,说明不是断网; - 换
gh(GitHub CLI)命令行操作,fork 成功——说明gh走的通道和git的 HTTPS 不是一回事; - 于是改写方案:既然 clone 不通,就用 GitHub 的 Git Data API 直接提交——先读取 main 的最新 commit 与 tree,再为改动文件创建 blob,组合成新 tree 和新 commit,最后建分支引用并开 PR。全程不需要本地 git 仓库。
9.3 收获与改进
- 读需求要读到字。 「物品名称等关键词」这个「等」字是我这次最大的收获。第一遍读作业时我完全没注意到,是回头逐条核对评分规则时才发现的。需求里的虚词往往比实词信息量更大。
- 改公共函数的语义,先看测试。 测试用例名本身就是一份「当初为什么这么写」的文档。看到
by name这三个词,我才知道要谨慎,也才知道要在 PR 里解释。 - 工具链要准备 Plan B。
git clone不通不代表没法提交代码,GitHub 的 API 同样能完成一次规范的 PR。这次经历让我意识到,把「提交代码」和「git命令」绑定在一起是一种思维定式。 - 测试能暴露设计问题。
join('\n')那个坑不是写代码时想到的,是写测试时逼自己想「什么情况下这个实现会错」才发现的。
十、队友评价
10.1 队友做得好的地方
王智洋的工程质量明显在我之上。 几点具体的:
- 分层清晰,降低了协作成本。
data.js(业务规则)/views.js(渲染)/app.js(交互)分得很干净,业务规则不依赖 DOM 和网络。正因如此,我第一次读代码就能确定「搜索应该改在queryItems里」,改完也只需要跑 Node 单元测试就能验证,不必启动整个应用。这是好设计带来的协作便利。 - 文档意识强。
docs/下有设计规格、验证记录、差距清单。特别是docs/homework-gap-checklist.md,把自己还没做完的事(包括「仓库显示 0 fork、0 PR,尚无可核对的结对记录」)明确写出来——这种坦诚让我一眼就知道自己该从哪里接手。 - 测试写得比我细。 原有的用例里已经包含了「重开一条已完成的信息要保留原内容与发布时间」「地点/分类多选的并集与交集语义」这类容易被忽略的边界,我是照着这个风格补写自己的用例的。
10.2 希望改进的地方
- 分工说明里没有把「谁负责哪一部分」写清楚。 仓库里的文档大多是从「项目」视角写的,缺少从「人」视角的分工记录。作业明确要求给出具体分工,也需要能在仓库里核对,建议每完成一个模块就在 README 或
docs/里记一笔负责人。这次我补的 PR 描述算是补上了一部分。 README.md里已经提到的已知限制,建议同步记到 issues 里。 比如「首页尚未接入分页」「替换的旧图片暂时保留」这些,写在 README 里容易被忽略,开成 issue 更容易跟踪,也方便下次结对时直接认领任务。- 提交粒度的建议:部分提交把多个模块的改动放在一起,review 时不太好定位。如果按「一个提交只做一件事」来切分,我在做代码复审时会轻松很多。
附:本次改动的完整 diff
--- a/js/data.js
+++ b/js/data.js
+  // 把搜索词按空白拆成多个关键词,兼容半角与全角空格
+  function splitKeywords(value) {
+    return text(value).toLocaleLowerCase().split(/[\s\u3000]+/).filter(Boolean);
+  }
+
+  // 关键词匹配范围:物品名称 + 物品描述 + 具体地点。
+  // 多个关键词之间是「与」的关系:必须全部命中,便于逐步缩小范围。
+  function matchesKeywords(item, words) {
+    if (!words.length) return true;
+    const haystack = [item.name, item.description, item.locationDetail]
+      .map(text).join('\n').toLocaleLowerCase();
+    return words.every(word => haystack.includes(word));
+  }
+
   function queryItems(items, filters = {}, favorites = [], now = new Date()) {
-    const keyword = text(filters.keyword).toLocaleLowerCase();
+    const words = splitKeywords(filters.keyword);
     const range = eventRange(filters, now);
     return items.filter(item =>
-      (!keyword || item.name.toLocaleLowerCase().includes(keyword)) &&
+      matchesKeywords(item, words) &&
       (!filters.type || filters.type === 'all' || item.type === filters.type) &&
--- a/js/views.js
+++ b/js/views.js
-<label class="sr-only" for="keyword">搜索物品名称</label>
-<input id="keyword" ... placeholder="搜索物品名称">
+<label class="sr-only" for="keyword">搜索物品名称、描述或地点</label>
+<input id="keyword" ... placeholder="搜索名称、描述或地点">
--- a/tests/data.test.cjs
+++ b/tests/data.test.cjs
+  it('search also matches the description and the detailed place', () => { ... });
+  it('multiple keywords must all match, ignoring full-width spaces', () => { ... });
+  it('a whitespace-only keyword does not filter anything', () => { ... });

 浙公网安备 33010602011771号