
Python 字符串
前言
本章节将针对于Python3的字符串,关于Python2的字符串将在其他文章中指出。
字符串
Python中的字符串,类型是str。
基本声明
以下是使用类的形式进行声明:
string = str("HELLO,WORLD")
print("值:%s,类型%s"%(string,type(string)))
# 值:HELLO,WORLD,类型<class 'str'>
也可以选择使用更方便的字面量形式:
string = "HELLO,WORLD"
print("值:%s,类型%s"%(string,type(string)))
# 值:HELLO,WORLD,类型<class 'str'>
关于字面量形式声明,你可以使用英文状态下的单引号,也可以使用双引号。
此外,虽然单三引号与双三引号都可以进行字符串声明,但是并不推荐,因为它们还具有注释的语义存在。
类型转换
字符串支持与bool和int以及float进行转换:
string = "100"
i_string = int(string) # 整形
b_string = bool(string) # 布尔类型
f_string = float(string) # 浮点型

print("值:%s,类型%s"%(i_string,type(i_string)))
print("值:%s,类型%s"%(b_string,type(b_string)))
print("值:%s,类型%s"%(f_string,type(f_string)))

# 值:100,类型<class 'int'>
# 值:True,类型<class 'bool'>
# 值:100.0,类型<class 'float'>
需要注意的是,如果一个字符串不是纯数字,那么将其转换为整形或浮点型时将会出现异常:
string = "非纯数字:100"
i_string = int(string) # 整形
f_string = float(string) # 浮点型

print("值:%s,类型%s"%(i_string,type(i_string)))
print("值:%s,类型%s"%(f_string,type(f_string)))

# ValueError: invalid literal for int() with base 10: '非纯数字:100'
此外,字符串也支持转换为list以及set:
string = "一零二四"
set_string = set(string)  # 集合类型
list_string = list(string)  # 列表类型

print("值:%s,类型%s"%(set_string,type(set_string)))
print("值:%s,类型%s"%(list_string,type(list_string)))

# 值:{'二', '零', '一', '四'},类型<class 'set'>
# 值:['一', '零', '二', '四'],类型<class 'list'>
四则运算
字符串支持与字符串相加,做到拼接的效果:
s1 = "字符串1"
s2 = "字符串2"
print(s1 + s2)
# 字符串1字符串2
字符串支持与整形相乘,做到重复打印的效果:
s1 = "*"
print(s1 * 3)
# ***
除此之外的运算均不支持:
print("--- " - "222")
# TypeError: unsupported operand type(s) for -: 'str' and 'str'
其他特性
字符串是原子类型,即字符串无法修改。这是由于字符串底层是连续存储导致的。
此外字符串虽然是属于容器类型,可以容纳多个单字符,但字符串的传递更多的并非引用传递,而是值传递。
索引切片
概念介绍
底层是顺序存储的容器类型都具有索引的概念:
---------------------------------------|
| A | B | C | D | E | F | G |
---------------------------------------|
| 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|-7 |-6 |-5 |-4 |-3 |-2 |-1 |
正向索引都是从0开始,负向索引都是从-1开始。
slice()函数
slice()函数有三个参数。
| 参数介绍 | 描述 |
|---|---|
| start | 索引开始的位置 |
| stop | 索引结束的位置 |
| step | 步长间距 |
使用方法如下示例,先规定切的范围,然后使用[]进行包裹:
s1 = "abcdefg"
# 取出 a
s = slice(0, 1, None)
print(s1[s]) # a 取索引0,到1结束,取头0,不取尾1
注意:所有的切片都是顾头不顾尾。
如果我们想从s1中拿到子串bcde则可以进行下面这样切:
s1 = "abcdefg"
s = slice(1, 5, None)
print(s1[s]) # bcde
如果想隔着切,如aceg,则可以指定步长:
s1 = "abcdefg"
s = slice(0, None, 2) # 比如:a开始,b是第一个,c是第二个,拿c ,以此类推
print(s1[s]) # aceg
[::]形式
使用slice()函数会比较繁琐,直接使用[::]的形式会比较简单。
使用签名如下:
[start:stop:step]
参数描述和slice()相同,当某一参数不设置时可省略前面的:。
需要注意的是,如果使用[:]则代表将当前容器重新进行拷贝。
s1 = "abcdefg"
s2 = s1[:]
print("值:%s,地址:%s"%(s1,id(s1)))
print("值:%s,地址:%s"%(s2,id(s2)))

# 值:abcdefg,地址:1240503058984
# 值:abcdefg,地址:1240503058984

# 如果是str使用[:]将不会生成新对象,而是引用原本对象。如果是其他数据类型进行[]则会生成新对象
正向切片
正向切片即使用正向索引,索引从0开始进行切片。
如下示例:
s1 = "abcdefg"
print(s1[1:3]) # bc
反向切片
反向切片即使用反向索引,索引从-1开始进行切片。
s1 = "abcdefg"
print(s1[-3:-1]) # ef
混合使用
反向和正向切片可以混合使用,下面是一些高级切片的用法。
# --- str 除开 [:] 其他的取值都是生成新对象,list和tuple的取值不管怎样都是生成新对象

s1 = "hello,world"

# hello,world 如果对str类型使用这种操作.等同于 s2 = s1 ,内存地址引用都是相同的.而对于list和tuple来说则是浅copy.生成新对象。
s2 = s1[:]

s3 = s1[3:7]  # lo,w 取头不取尾,生成新的一段字符串(list,tuple同理)

s4 = s1[::2]  # hlowrd 隔一个取一个,步长为2。

s5 = s1[::-1]  # dlrow,olleh 反取,步长为负数

s6 = s1[::-2]  # drwolh 倒过来,隔一个取一个.

s7 = s1[:-6:-2]  # drw  倒过来.截至 -6 结束,隔着位置取。

s8 = s1[0::-1]  # h  倒着取,正着数到第零个开始取,也就是h,唯一 一个就是这个h了,取到头了,就拿出h。没啥好说的。

s9 = s1[5::-2]  # ,le 倒着取,开始位置是正着数到第五个 也就是,开始。再看结束位置,没有代表取到头。跳着来
常用方法
获取长度
使用len()来进行长度的获取。
返回int类型的值。
s1 = "abcdefg"
print(
    len(s1) # 7
)
移除空白
使用strip(str)移除字符串两侧指定的字符,如不进行指定,则默认移除\n、\t以及空格。
返回str类型的值。
s1 = "   abcdefg   $$$"
res = s1.strip(" $")
print(res)
拆分列表
使用split(char,int)按照指定字符进行从左到右的分割,以列表形式返回。可指定maxslipt限制切分次数。
使用rsplit(char,int)按照指定字符进行从右到左的分割,以列表形式返回。可指定maxslipt限制切分次数。
返回list类型的值。
s1 = "ab,cd,ef,gh"
res = s1.split(",",maxsplit=1)
print(res)
# ['ab', 'cd,ef,gh']
s1 = "ab,cd,ef,gh"
res = s1.rsplit(",",maxsplit=1)
print(res)
# ['ab,cd,ef', 'gh']
列表合并
使用join(li)将一个列表中的元素以指定字符拼接成新的字符串。
返回str类型的值。
l1 = ["a","b","c"]
res = "-".join(l1)
print(res)
# a-b-c
替换操作
使用replace(str,str)将字符串中的指定子串替换成另一个子串。
返回str类型的值。
s1 = "ABCDEFG"
res = s1.replace("BCD","bcd")
print(res)
# AbcdEFG
统计子串
使用count(str)统计子串在父串中出现的次数。
返回int类型的值。
s1 = "HELLO"
res = s1.count("L")
print(res)
# 2
词首大写
使用title()令字符串中的每一个单词首字母大写。
返回str类型的值。
s1 = "hello world"
res = s1.title()
print(res)
# Hello World
句首大写
使用capitalize()令字符串中的句首单词变为大写。
返回str类型的值。
s1 = "hello world"
res = s1.capitalize()
print(res)
# Hello world
查找位置
使用find(str)查找子串出现在父串中的索引值,若存在则返回索引,若不存在则返回-1。
返回int类型的值。
s1 = "hello world"
res = s1.find("w")
print(res)
# 6
小写转大写
使用upper()令字符串中所有的小写字母转换为大写。
返回str类型的值。
s1 = "hello world"
res = s1.upper()
print(res)
# HELLO WORLD
大写转小写
使用lower()令字符串中所有的大写字母转换为小写。
返回str类型的值。
s1 = "HELLO WORLD"
res = s1.lower()
print(res)
# hello world
指定开头
使用startswith(str)判断字符串是否以子串开头。
返回bool类型的值。
s1 = "HELLO WORLD"
res = s1.startswith("HE")
print(res)
# True
指定结尾
使用endswith(str)判断字符串是否以子串结束。
返回bool类型的值。
s1 = "HELLO WORLD"
res = s1.endswith("LD")
print(res)
# False
数字串
使用isdigit()判断该字符串是否是一个数字串。
返回bool类型的值。
s1 = "100"
res = s1.isdigit()
print(res)
# True
其他方法
以下是一些其他不太常用的方法:
| 方法名 | 描述 |
|---|---|
| index(str) | 同find(),唯一区别找不到抛出异常,find()是返回-1 |
| center(int,str) | 指定宽度,指定字符。若字符串的长度不够则将字符串放在中间,两侧使用指定字符填充 |
| ljust(int,str) | 指定宽度,指定字符。若字符串的长度不够则将字符串放在左边,右侧使用指定字符填充 |
| rjust(int,str) | 指定宽度,指定字符。若字符串的长度不够则将字符串放在右边,左侧使用指定字符填充 |
| zfill(int) | 同rjust(),但是不可指定填充字符。按0进行填充 |
| swapcase() | 字符串中大小进行翻转。大写转小写,小写转大写。 |
| expandtabs(int) | 指定字符串中的tab长度,\t代表制表符 |
| isdecimal() | 查看字符串是否由数字组成。只支持unicode并且没有bytes的使用 |
| isnumeric() | 查看字符串是否由数字组成。只支持unicode,中文数字,罗马数字并且没有bytes的使用 |
| isalnum() | 字符串中既可以包含数字也可以包含字母 |
| isalpha() | 字符串中只包含字母 |
| islower() | 判断字符串是否纯小写 |
| isupper() | 判断字符串是否纯大写 |
| istitle() | 判断字符串中的单词是否首字母大写 |
| isspace() | 判断字符串是否全是空格 |
# ==== str的了解操作 ====

# === 以下方法均不会改变原本str中的值,而是生成一个新的对象返回 ===

s2 = "hello,world"
print(s2.index("hel"))  # 0 同find(),唯一区别找不到抛出异常,find()是返回-1
print(s2.center(20, "+"))  # ++++hello,world+++++ center代表居中,算上原本的hello,world一共要凑齐20的长度,如果不够则在两边添加符号 + 。原本的字符占中间
print(s2.ljust(20, '+'))  # hello,world+++++++++ ljust,l代表left,同上。left规定原本字符占左边
print(s2.rjust(20, '+'))  # +++++++++hello,world rjust,r代表right,同上。right规定原本字符占右边
print(s2.zfill(20))  # 000000000hello,world 同rjust,但是自动填充0而不是指定的字符。
print(s2.swapcase())  # HELLO,WORLD 字符串中的大小写翻转


s3 = "hello,\tyunya!" # \t 代表 tab  制表符。
print(s3)  # hello,    yunya! 默认tab宽度为1个空格
print(s3.expandtabs(6))  # hello,      yunya!  修改字符串中的tab宽度为6个空格。

# ======= Python3 中 is系列之 判断纯数字组成的str三种方法 推荐:isdigt()=======

num1 = b'4' #bytes 代表字节。
num2 = u'4' #unicode,python3中无需加u就是unicode。
num3 = '四' #中文数字
num4 = 'Ⅳ' #罗马数字

#isdigt()查看字符串是否是由数字组成。只支持bytes和unicode
print(num1.isdigit()) # True

print(num2.isdigit()) # True

print(num3.isdigit()) # False

print(num4.isdigit()) # False

#isdecimal()查看字符串是否由数字组成。只支持unicode并且没有bytes的使用。
print(num2.isdecimal()) # True

print(num3.isdecimal()) # False

print(num4.isdecimal()) # False

#isnumeric()。只支持unicode,中文数字,罗马数字并且没有bytes的使用。
print(num2.isnumeric()) # True

print(num3.isnumeric()) # True

print(num4.isnumeric()) # True

# ======= 以上3种方法均不支持浮点型str的判断,全部为False =======

# ======= is 系列其他的一些方法 =======
name = 'yunya696969'

print(name.isalnum()) # True 字符串中既可以包含数字也可以包含字母
print(name.isalpha()) # False 字符串中只包含字母
print(name.isidentifier()) # True 判断字符串是否是符合Python变量命名标准。(数字字母下划线)
print(name.islower()) # True 判断字符串是否纯小写
print(name.isupper()) # False 判断字符串是否纯大写
print(name.istitle()) # False 判断字符串中的单词是否首字母大写
print(name.isspace()) # False 判断字符串是否全是空格
转义输出
特殊的\
在普通的声明字符串中,\后面一般都会跟上一个特殊字符。
该字符表示特殊的意义,如\n代表换行,\t代表制表符等。
| 转义字符 | 意义 | ASCII码值(十进制) |
|---|---|---|
| \a | 响铃(BEL) | 007 |
| \b | 退格(BS) ,将当前位置移到前一列 | 008 |
| \f | 换页(FF),将当前位置移到下页开头 | 012 |
| \n | 换行(LF) ,将当前位置移到下一行开头 | 010 |
| \r | 回车(CR) ,将当前位置移到本行开头 | 013 |
| \t | 水平制表(HT) (跳到下一个TAB位置) | 009 |
| \v | 垂直制表(VT) | 011 |
| \ | 代表一个反斜线字符''' | 092 |
| \' | 代表一个单引号(撇号)字符 | 039 |
| \" | 代表一个双引号字符 | 034 |
| ? | 代表一个问号 | 063 |
| \0 | 空字符(NUL) | 000 |
| \ddd | 1到3位八进制数所代表的任意字符 | 三位八进制 |
| \xhh | 十六进制所代表的任意字符 | 十六进制 |
如果你还是不能理解,那么可看一下下面这个示例:
# 我想打印  hello"world
# 并且我的字符串声明采用 “

print("hello\"world")
# 必须进行转义,否则将会抛出语法错误
r字符串
如果在声明字符串的前面加上字符r,则代表该字符串中不会存在转义字符,所有字符将按照普通的方式进行解读。
s1 = r"\n\t\b"
print(s1)
# \n\t\b
格式化输出
如果我们想在字符串中加入一个变量值,则需要用到格式化输出。
%
%格式化的历史悠久,很多码龄较长的程序员都喜欢用它进行格式化输出。
我们来看一个例子:
name = "云崖先生"
age = 19
s1 = "姓名是:%s,年龄是:%d"%(name,age) # ①
print(s1)
# 姓名是:云崖先生,年龄是:19
其中,①处注释在字符串中的%s、%d等都是占位符,学习%的格式化输出首先要了解占位符的使用。
| 占位符 | 描述 |
|---|---|
| %s | 接收任意类型的值,以字符串形式显示 |
| %r | 接收任意类型的值,以r字符串形式显示 |
| %c | 只接收单个字符 |
| %b | 接收int类型的值,二进制整数形式显示 |
| %d | 接收int类型的值,十进制整数形式显示 |
| %i | 接收int类型的值,十进制整数形式显示 |
| %o | 接收int类型的值,八进制整数形式显示 |
| %x | 接收int类型的值,十六进制整数形式显示 |
| %e | 接收float类型的值,指数形式显示 (基底写为e) |
| %E | 接收float类型的值,指数形式显示 (基底写为E) |
| %f | 接收float类型的值,浮点数形式显示 |
| %F | 接收float类型的值,浮点数形式显示 |
| %g | 接收float类型的值,指数(e)或浮点数 (根据显示长度) |
| %G | 接收float类型的值,指数(E)或浮点数 (根据显示长度) |
位置传参
一个%对应一个变量名。
当变量名有多个时便需要%后面跟上括号做解包,如若只有一个则不需要加上括号,% 和后面的 %(a,b,c)位置一一对应:
name = "云崖先生"
age = 19
s1 = "姓名是:%s,年龄是:%d"%(name,age)
关键字传参
变量名存储变量值内存地址引用。关键字传参打破位置顺序必须统一的限制:
name = "云崖先生"
age = 19
s1 = "姓名是:%(name)s,年龄是:%(age)d"%{"age":age,"name":name}
格式化%分号
如果想打印%多少,则可以使用下面的方式
%%百分号代表一个% 。放在 %d 后面的%则代表格式化出后的结果是3%:
s1 = "%d%%"%3
print(s1) # 3%
format()
%虽然能够满足基本需求。但是其位置传参还是显得太过麻烦,故在Python2.6中新增format() 方法,它更加强大以及速度更快。
推荐今后使用format()的方法进行字符串格式化 。
注意:format()中的s只接受str类型的传值而不接受全部类型
位置传参
name = "yunya"
age = 18
s1 = "姓名是{:s},年龄是{:d}".format(name,age)
# 采用{}进行占位,需要注意的是format中的s不是接收全部类型的参数,而是指定str

# s1 = "姓名是{:s},年龄是{:d}".format(name,age)
# 也可不指定类型。默认接收全部类型参数

# 姓名是yunya,年龄是18
索引传参
name = "yunya"
age = 18
s1 = "姓名是{1:d},年龄是{0:s}".format(name, age)
# 采用{}进行占位,无法使用s接收age。且format()中没有i

# s1 = "姓名是{1},年龄是{0}" .format(name,age)

# 姓名是yunya,年龄是18
关键字传参
name = "yunya"
age = 18
s1 = "姓名是{name:s},年龄是{age:d}".format(name=name, age=age)
# 采用{}进行占位,无法使用s接收age。且format()中没有i

# s1 = "姓名是{name},年龄是{age}" .format(name=name,age=age)

# 姓名是yunya,年龄是18
字符填充
print('{0:*<10}'.format('|||'))  # < 代表字符 ||| 在左边,填充符号为 * 排在右边 一共10 个( 算上字符三个 | )
print('{0:%>10}'.format('|||'))  # > 代表字符 ||| 在右边,填充符号为 % 排在左边 一共10 个 ( 算上字符三个 | )
print('{0:$^10}'.format('|||'))  # ^ 代表字符 ||| 在中间,填充符号为 $ 排在两侧 两侧加起来共10个 ( 算上字符三个 | )
print('{0:$=10}'.format(123))    # = 代表数字 123 在右边,填充符号为 $ 排在左边 一共10个 Ps: = 只针对数字 ( 算上字符123 )

# |||*******
# %%%%%%%|||
# $$$|||$$$$
# $$$$$$$123
精度控制与格式转换
print('{0:.2f}'.format(3.1415926535))  # f代表接收值类型为float类型,.2代表小数点后保留2位
print('{0:b}'.format(10))  # 转换为二进制 b
print('{0:x}'.format(10))  # 转换为十六进制 x
print('{0:o}'.format(10))  # 转换为八进制 o
print('{0:,}'.format(1000000))  # 千分位表示 ,
print('{0:.2%}'.format(1))  # 百分号表示  2代表2位数,转换数据1 为 百分之百
print('{0:.2%}'.format(0.3))  # 百分号表示
print('{{{0}}}'.format('笑脸')) # 显示大括号。 外部套2层大括号

# 3.14
# 1010
# a
# 12
# 1,000,000
# 100.00%
# 30.00%
# {笑脸}
f
尽管format()已经非常方便了。但是如果传入的参数值太多依旧会看着十分混乱,于是Python3.6中新增了 f 格式字符串的操作。
这种方法的速度最快,但是却不推荐使用,因为程序还要考虑一个向下兼容性的问题。
name = "yunya"
age = 18

s1 = f'我的名字叫做{name},我的年龄是{age}岁。'  # f 开头。 {} 为占位符用于存放变量名。
print(s1)
# 其他的关于高级操作如填充字符,精度控制与格式转换等等均与format()操作方式一样。
底层存储
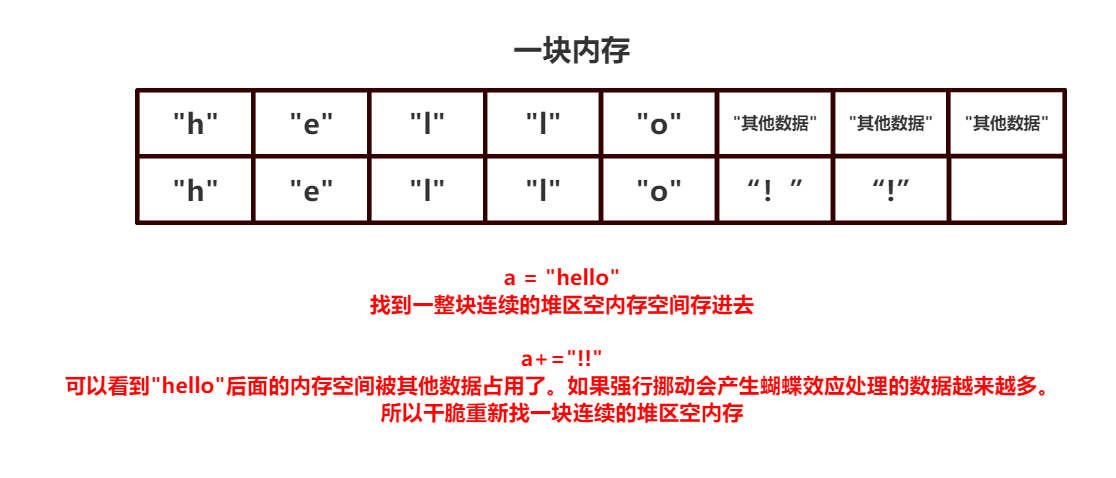
字符串本身是属于原子容器类型,即不可被修改。
当尝试修改一个字符串时,它始终会返回给你一个新的字符串,而其他的容器类型如list等都不会重新返回新的。
这是由于字符串底层的排列方式导致的。
s1 = "abc"
print(id(s1))  # 2601680846048
s1 += "def"
print(id(s1))  # 2601681784032
如果修改一个字符串的子串,比如添加或者删除。
因为字符串是连续的一块内存存放,被看做为一个整体,修改其中某一个元素那么必定会导致后面的内存发生变化,链式反应滚起雪球需要处理的数据量很庞大,于是Python干脆不支持使用index为字符串进行修改。
s1 = "abc"
print(id(s1))
s1[1] = "B"
print(id(s1))
# TypeError: 'str' object does not support item assignment

 浙公网安备 33010602011771号