
大模型是外部依赖:一次 5 小时中断后的降级设计笔记
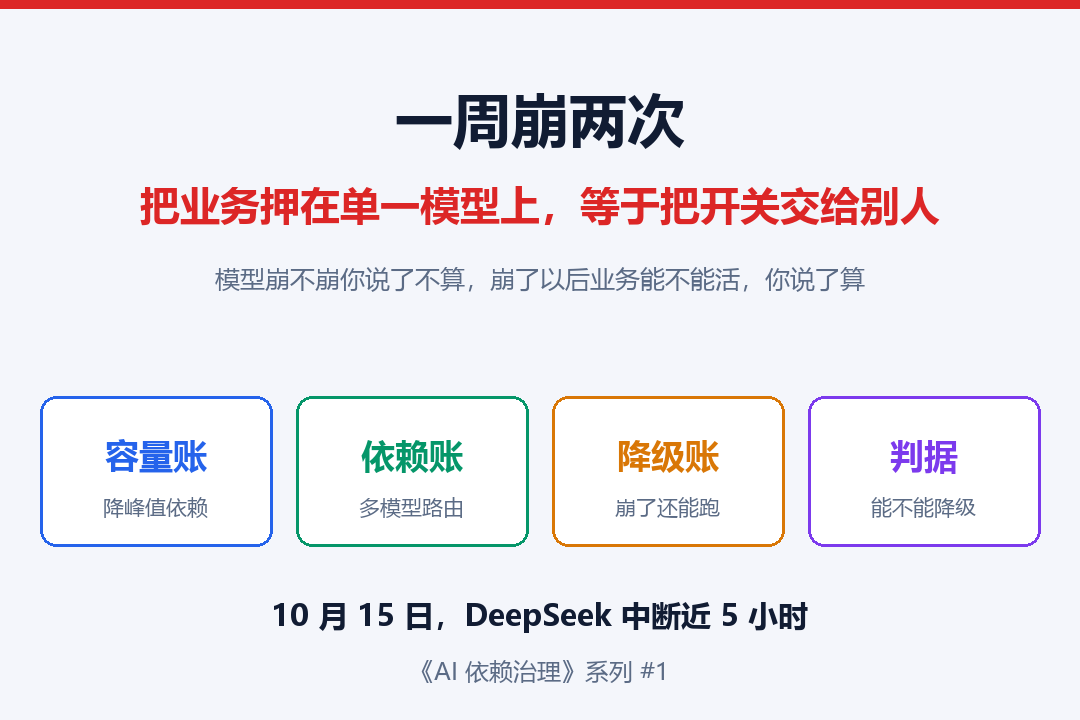
2026 年 10 月 15 日 8:11—13:04,DeepSeek 服务中断近 5 小时,网页、App 与 V4.1 Flash API 部分不可用;10 月 12 日另有一次对话服务中断。公开报道显示,2026 年以来该平台至少出现过 18 次大面积异常。
本文不讨论新闻,只记录一件事:当我们把一个外部服务接进核心链路时,架构上应该预留什么。
结论先行
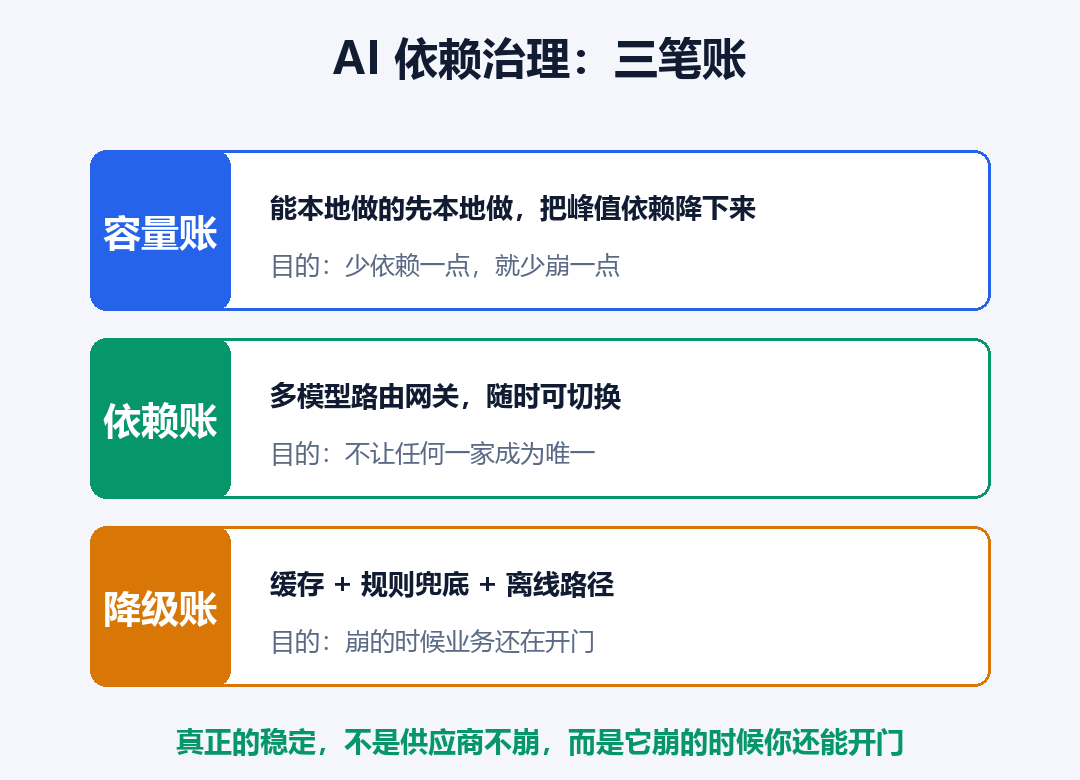
大模型是外部依赖,而外部依赖必须假设它会消失。 治理分三层:容量层(降低依赖强度)、路由层(消除单点)、降级层(保证可用性下限)。判据只有一句:模型不可用时,核心链路有没有一条"降级但可用"的路径。
一、把"不可控"显式化
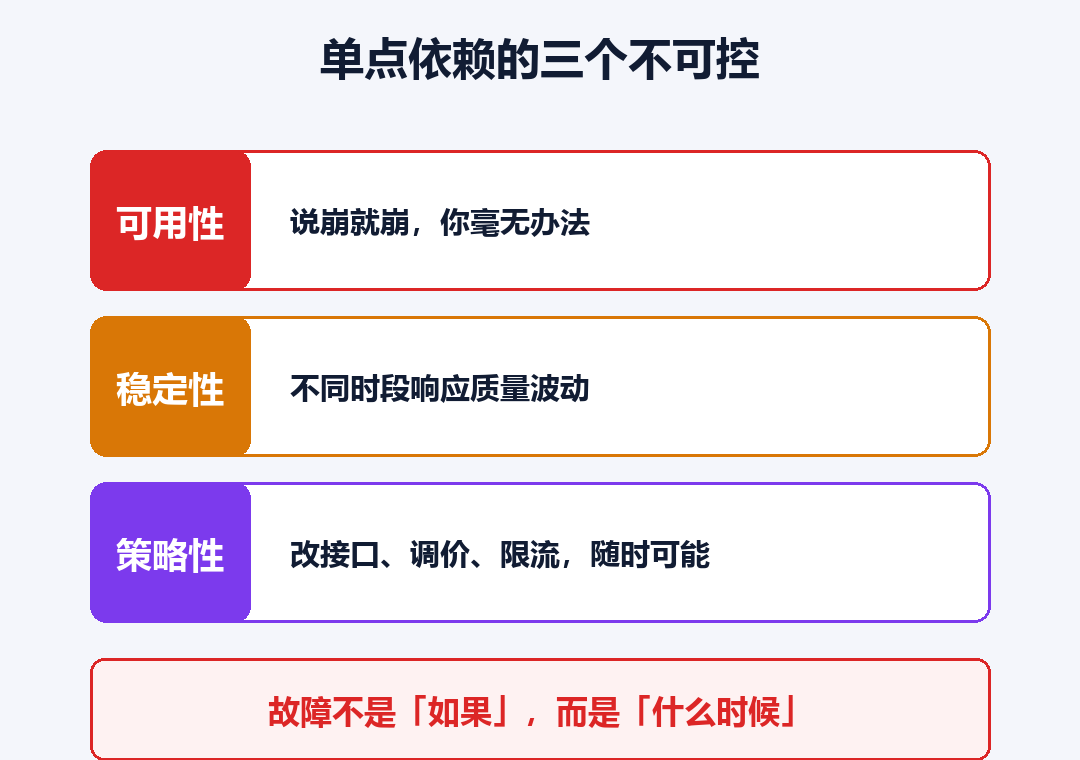
外部服务有三个维度是使用者无法控制的:
| 维度 | 表现 | 工程后果 |
|------|------|---------|
| 可用性 | 服务中断,无预警 | 核心链路 5xx |
| 稳定性 | 响应质量/延迟波动 | 结果不可复现 |
| 策略性 | 接口变更、限流、调价 | 架构与成本被动 |
把这三个维度写进架构文档,比写进复盘报告更有用。
二、容量层:调用分级
工程上第一步不是换服务,而是给每一次模型调用分级:
- 强依赖:开放生成、复杂推理、多轮规划。
- 弱依赖:分类、抽取、意图识别、格式校验 → 本地小模型或规则引擎。
- 伪依赖:规则能判、字典能查、模板能套 → 从模型调用中移除。
调用分级同时带来两个收益:故障面缩小 + 单位任务成本下降。
三、路由层:两个硬约束
引入模型路由网关后,真正决定"能不能切"的不是网关本身,而是下面两点:
① 统一输出契约。 业务层只依赖结构化契约(字段 + 格式),不依赖任何模型的原始输出。否则每接一个模型就要写一套适配层,"可切换"是伪命题。
② 路由可配置化。 模型选择、权重、超时、重试策略作为配置项,故障时改配置即可切换,而不是重新发版。
配套细节:重试必须带退避与熔断。 上游不可用时盲目重试,会把局部故障放大成雪崩。
四、降级层:分级可用
降级不是"整个系统降级",而是按功能分级。设计前先做一张"功能 × 降级目标"对照表,然后落地三板斧:
缓存降级——精确缓存(键 = 模型 + prompt 指纹 + 参数)、语义缓存(带阈值)、故障时放宽 TTL。缓存命中率必须上监控面板,否则故障时无法判断能否顶住。
规则降级——用确定性替代概率性。规则表准确率可能只有 70%,但它保证"有结果"而非"报错"。降级开关必须是配置项,不是发版。
离线降级——本地缓存可作业数据集、本地记录操作流水、恢复后异步补传、服务端幂等 + 冲突消解。接受短暂不一致,换取现场不中断。
第三点有长期实证:一套服务一百四十多所学校的本地部署系统,断网时本地继续记账与凭证输出,恢复后自动补传,稳定运行十年。"最终一致 + 本地可用"往往比"强依赖上游"更可靠。
五、可观测性:治理是否成立的判据
错误率、超时率、P95 延迟、缓存命中率、降级开关状态,都必须在面板上实时可见。
如果一次故障是靠用户投诉发现的,说明可观测性建设落后于依赖引入。
六、6 项降级自查
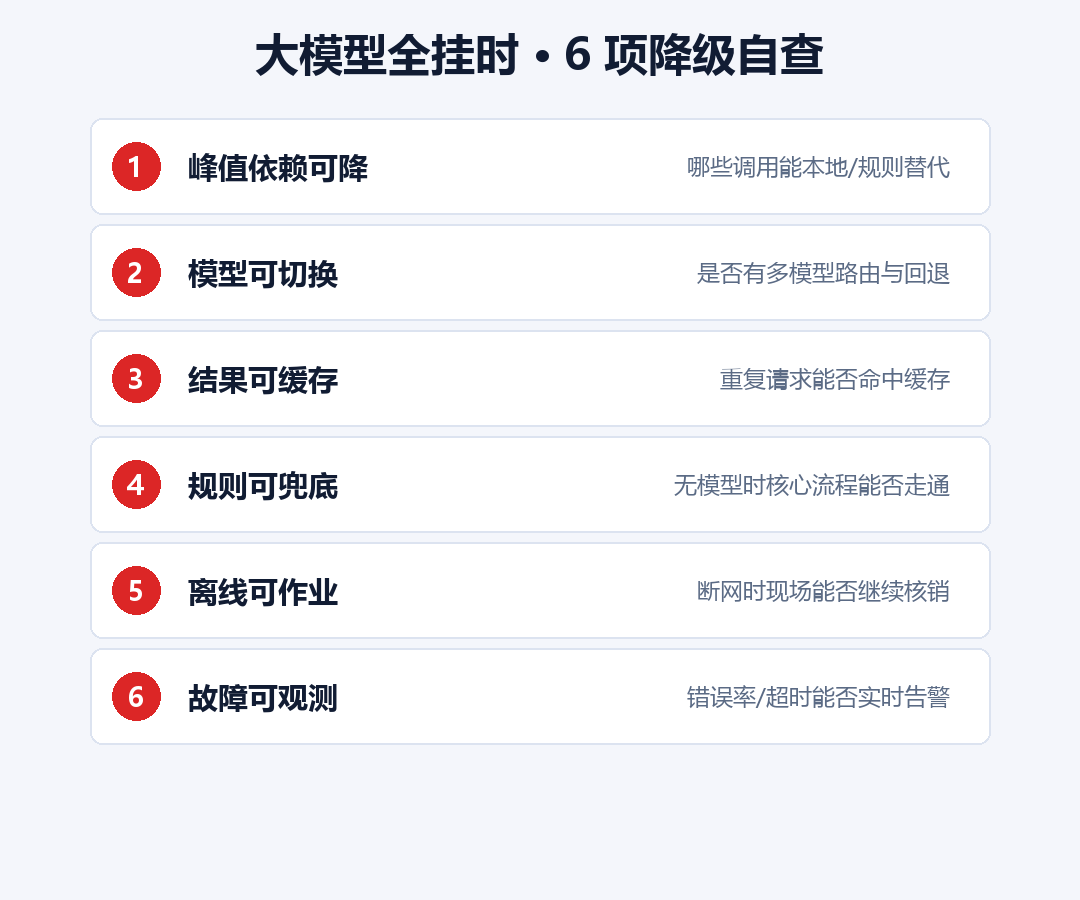
| # | 自查项 | 工程判据 |
|---|--------|---------|
| 1 | 峰值依赖可降 | 已完成调用分级,伪依赖已移除 |
| 2 | 模型可切换 | 存在路由网关,输出契约统一 |
| 3 | 结果可缓存 | 缓存命中率与 TTL 已定义 |
| 4 | 规则可兜底 | 核心链路有确定性降级分支 |
| 5 | 离线可作业 | 支持本地作业 + 恢复后补传 |
| 6 | 故障可观测 | 有错误率/超时/延迟告警 |
七、小结
降级设计不是"多加几行 if",而是在架构阶段就承认外部依赖会失败,并为每条核心链路预留退路。
模型崩不崩你说了不算,崩了以后业务能不能活,你说了算。
降级不是技术退步,而是给业务留的一条命。
算力是别人的,降级预案才是自己的。

 浙公网安备 33010602011771号